登录社区云,与社区用户共同成长
邀请您加入社区
AI Agent 是当前大模型应用领域最受关注的方向,但同时也是概念最混乱的方向。市面上讨论 Agent 的文章,一半在畅想"数字员工替代人类",另一半在教 Prompt 话术,真正把 Agent 的技术架构讲清楚的内容少之又少。这篇文章站在工程师视角,把 Agent 的核心架构拆开:它的工作循环是什么、为什么有效、工具怎么设计、上下文怎么管理、记忆系统怎么搭,以及一个完整的 Agent 系统由哪
用AI Agent / OpenAI 节点。提示词是成败的关键——不要让模型"总结一下",要约束输出结构你是会议纪要助手。基于以下转写文本,只输出三段,不要寒暄:## 决议(本次会议真正拍板的事,逐条列出,没有就写"无")## 待办(格式:负责人 — 事项 — 截止时间。缺任何一项标注"待确认")## 待确认(提出但没有结论的问题)转写文本:为什么必须约束结构:不加约束,模型会给你一大段好看的废话
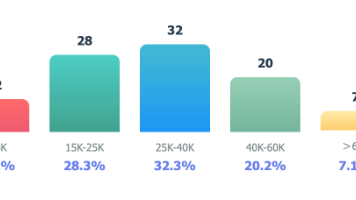
我经常在各种平台上看到有人说想转AI Agent方向的工作,我们组有一个"AI Application Developer"岗位从今年年初招聘至今还没有找到合适的候选人,而且我自己也在做这个岗位,于是就从技能、薪资、地域等角度分析了一下目前市场上AI Agent相关的岗位。
AI行业迎来前所未有的爆发式增长:从DeepSeek百万年薪招聘AI研究员,到百度、阿里、腾讯等大厂疯狂布局AI Agent,再到国家政策大力扶持数字经济和AI人才培养,所有信号都在告诉我们:AI的黄金十年,真的来了!
本章讲解语音识别(ASR)的核心原理与工程实践。首先通过百度 API、Whisper、SpeechRecognition 三种技术路线的快速演示建立直观认知;随后介绍语音识别的概念、技术难点与基础理论(语音信号处理、声学模型与语言模型);接着对比 GMM-HMM 传统方法、深度学习端到端方法与云服务 API 三类主流方案;最后是一个完整的会议录音转写系统案例。
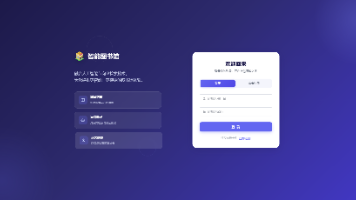
基于AI Agent的智能图书馆管理系统,集成DeepSeek大模型与Qdrant向量数据库。读者通过智阅助手以自然语言完成语义检索、借书还书、收藏图书,同时支持智能推荐、借阅记录与藏书书架管理。管理员可进行用户管理、图书维护、借阅审核与运营统计,覆盖图书馆日常运营全流程。
8G显存近乎流畅运行的AI语音聊天助手(ubuntu24.04:Qwen3-ASR-0.6B Q8_0(语音识别)+ DeepSeek-R1-7B-Q4-K-M(自然语言推理) + Qwen3-TTS(语音合成))
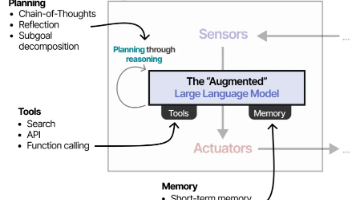
AI Agent 是能够自主感知环境、做出决策、执行行动的人工智能系统。感知 (Perception):观察环境状态、接收用户输入、读取工具结果推理 (Reasoning):分析信息、规划任务、做出决策行动 (Action):执行工具调用、操作环境、生成响应Agent = LLM + 工具 + 记忆 + 规划Agent 是一个有"目标感"的 LLM,它不仅能思考,还能主动采取行动。LangGrap
本文面向正在准备AI面试的求职者,解决「被AI面试刷了但不知道为什么」的困惑。本文拆解AI面试系统的三大核心评分引擎——计算机视觉(CV)、自然语言处理(NLP)、语音识别(ASR)——详解每个引擎的具体评分指标、权重分配和加分/扣分机制。结合北森、牛客等主流AI面试平台的评分逻辑差异,给出12个提分技巧和3个常见扣分陷阱。读完你将彻底理解AI面试官到底在看什么、听什么、分析什么。
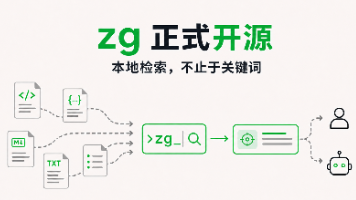
🚀 zg(zvec-grep)正式开源! 我们打磨了一款面向人与 AI Agent 的「本地检索工具」——默认在本机完成索引与检索,既能理解模糊意图,也保留 rg 的精确与高效。
ReAct 是 "Reasoning + Acting"(推理 + 行动)的缩写,由研究人员在 2022 年提出。让模型交替地"想"和"做"。想象一下:你要做一道没做过的菜。你不是一次性想清楚所有步骤再动手,而是——看一眼菜谱(想)→ 拿出食材(做)→ 发现少了盐(观察)→ 想想怎么办(想)→ 去楼下买盐(做)→ 回来继续(观察)……Agent 干活的方式,和这个过程几乎一模一样。思考(Thoug
2025年是AI Agent落地的"大考之年"。文章解析了企业AI Agent落地的四种典型形态:技术编排流(灵活需自建)、模型生态流(通用但业务浅)、独立极客流(快速但风险高)和业务底座流(原生集成)。企业需根据研发能力、业务需求和IT现状选择合适路径。AI转型应从小切口入手,静水深流,将智能融入业务流程,成为组织肌体的一部分,而非简单叠加。
文章介绍AI Agent的概念、工作流程和核心技术。AI Agent以大语言模型为"大脑",能感知环境、自主决策、执行动作,弥补了大模型的四大局限性。文章详细拆解了Agent"感知-规划-执行-监控-总结"的工作流程,并深入解析了Function Calling、MCP协议和A2A协议三大核心技术,展示了AI Agent如何从"只会聊天"升级为"能动手做事"的数字助手。
用 Go 语言从零构建各类 AI Agent,覆盖 ReAct、Plan-and-Execute、Multi-Agent、Super Agent 等核心设计模式的完整工程实现。
用 Go 语言从零构建各类 AI Agent,覆盖 ReAct、Plan-and-Execute、Multi-Agent、Super Agent 等核心设计模式的完整工程实现。:第 08 篇我们搭好了工具注册框架,但工具还是空的。一个 Agent 能不能真正干活,取决于它手里有没有趁手的工具。本篇我们实现 5 个生产可用的内置工具,每一个都包含——因为 Agent 会自主调用这些工具,任何一个设计
本文介绍了如何在星图GPU平台上自动化部署中文NLP综合分析系统 (RexUniNLU零样本通用自然语言理解) 镜像,并利用其进行电商评论情感分析等任务。通过该平台,用户可快速搭建NLP分析环境,结合Python脚本实现从Gradio界面获取JSON结果到自动化后处理的完整工作流,显著提升文本数据处理效率。
在了解了LLM智能体的基本概念后,本篇我们将深入剖析其内部核心机制,其核心机制主要包括记忆(Memory)、工具(Tools)和规划(Planning) 三大关键组件,本篇将详细解释前两大关键组件,它们如何协同工作完成任务。
本文介绍了如何在星图GPU平台上自动化部署GTE中文文本嵌入模型,并快速实现Python API调用与批量文本向量生成。该模型能将中文文本转换为富含语义的向量,广泛应用于智能客服、文档检索和内容推荐等场景,显著提升文本语义理解与处理效率。
BM25 保住精确词向量召回补语义RRF 合并多路名次reranker 重排候选answerable gate 决定是否该答citation verifier 阻止无来源答案直接播报如果这条链路仍然答错,日志能告诉我们问题发生在 ASR、召回、排序、阈值还是生成,而不是笼统归因于“大模型幻觉”。上一篇《Voice Agent 如何实现自然插话?从 VAD 到 Barge-in 完整拆解》处理的是用
【清华代码熊】Agent Harness 工程实践之(2):ToolUse设计
基于此,我们借鉴人类企业的组织分工模式,设计了多智能体协作架构:将电商客服的全流程任务拆解为“意图解析”“商品查询”“订单处理”等子任务,每个子任务由专属的智能体负责,智能体之间通过标准化的工具调用完成协作。该框架是国内可正常访问的开源工具,提供了智能体、工具、记忆等抽象层,无需重复开发基础逻辑,是构建LLM应用的主流选择,国内暂无完全同质化的替代品,但有AgentScope等自研框架可实现类似功
本文详细介绍了如何使用Python从零实现Skip-Gram模型,包括环境配置、文本预处理、模型架构解析和训练优化。通过实战代码演示,帮助读者掌握词向量技术,理解Skip-Gram模型的核心原理及其在自然语言处理中的应用。
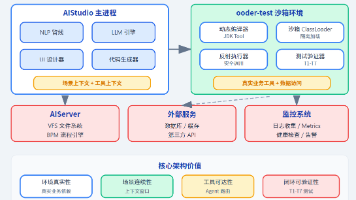
价值维度具体体现架构意义环境真实性访问真实数据库、文件系统、外部服务AI 生成的代码在首次运行就面对真实约束场景连续性场景上下文窗口 + 知识注入AI 在调试过程中保持对业务语义的理解工具可达性ToolContext + Agent 路由AI 能够自主选择和使用业务工具闭环可验证性T1-T7 测试维度从生成到验证的完整质量保障调试可达性远程调试 + 诊断信息返回AI 能够分析和修复运行时问题一句话
让 AI 记住、会查、能规划、能做事。理解这个,你就不会被十几种框架绕晕。下面整理了最常见的Agent框架和选择攻略,新手、中手、高手都能对号入座~
本文介绍了如何在星图GPU平台上自动化部署AI股票分析镜像daily_stock_analysis,实现智能投资分析功能。该镜像通过Agent技能扩展,能够理解自然语言指令并自动生成股票分析报告,帮助用户快速获取个股技术面、基本面和市场情绪等多维度分析结果,提升投资决策效率。
本文介绍了如何在星图GPU平台上自动化部署“BERT文本分割-中文-通用领域”镜像,快速配置Python环境并运行模型。该平台简化了部署流程,用户可轻松利用此镜像实现中文文本的智能分割,典型应用于新闻摘要、文档结构分析等自然语言处理任务,提升文本信息处理效率。
本文介绍了如何在星图GPU平台上自动化部署bert-base-chinese预训练模型,并详细解析了其核心应用。该模型作为经典的中文自然语言处理工具,能够高效完成文本语义相似度计算、完型填空等任务,是构建智能文本处理应用的理想起点。
在。
📌 本期带来2026年上半年的 Agentic RL 开源项目推荐(简历项目可以基于此实现)筛选了几个方向:🌟 奖励建模改进(Reward Modeling)🌟 上下文压缩与管理(Context Compression)🌟 算法改进(RL Optimization)🌟 探索与数据供给(RL Training Data)
本文详细介绍了如何使用Python实现CKY算法进行自然语言处理中的句法分析,包括算法基础、核心实现、解析树可视化及性能优化。通过动态规划方法,CKY算法能够将句子转化为清晰的树状结构,适用于机器翻译、文本摘要等多种应用场景。附带的可视化代码帮助直观理解算法工作原理。
本文介绍了一种基于YAML+Python Factory模式的CrewAI最佳实践方案。主要内容包括: 推荐目录结构:按agent/tool分类,采用YAML配置文件 动态加载机制:通过config_loader.py实现YAML到Python对象的转换 核心实现: Agent配置使用YAML定义角色、目标等 Tool通过Python类实现具体功能 工厂模式动态加载配置和工具 扩展能力:支持sou
本文用一个可运行的 FastAPI + WebRTC + RAG 最小 Demo,把 Voice Agent 的实时连接、信令、DataChannel、知识库检索、回答引用和转人工预留口串成闭环,并说明从 Demo 扩展到生产级智能客服平台时需要补齐的 ASR、VAD、TTS、日志和权限能力。
本文提出了一种基于Python的电影NLP情感分析与协同过滤算法的学习推荐系统。系统通过分析电影评论情感倾向,结合用户学习需求,采用NLP技术和LSTM模型处理评论数据,融合基于内容的推荐和协同过滤算法,为学生提供个性化电影学习资源推荐。实验表明,该系统在推荐准确性、用户满意度和学习效果上优于传统方法,有效提升了学习兴趣。研究还探讨了系统未来改进方向,包括实时反馈机制和个性化学习路径设计等。该系统
📌 本期解析字节、淘天的面试题:🌟 如何理解 SFT、RL 在Agentic训练中的作用?🌟 工具调用本身 vs 基于工具结果的后续生成,哪个对 SFT 依赖更大?
所以这道题的核心是:用真实的项目经验把选型决策过程和评估体系讲通,展示出你做过、踩过坑、有自己的判断标准。
本文介绍了在星图GPU平台上自动化部署🔥 FireRedASR Pro语音识别工具镜像,并对其识别结果进行后处理的方法。通过Python自然语言处理技术,可对语音转文本内容进行清洗、纠错和格式化,典型应用于会议记录、访谈转录等场景,将原始音频快速转化为高质量、可读性强的文字稿件。