登录社区云,与社区用户共同成长
邀请您加入社区
Loop 工程这个说法值得拆开看。公开描述把 AI 编程的当前阶段概括为:AI Agent 可以自主完成触发、执行、评估与重试构成的闭环。这四个词其实是一份现成的检查表——任何一个宣称支持 Agent 编程的工具,都可以放进这四个环节里逐项核对,看它覆盖了哪一段,又在哪一段交还给人和流程。
2026 年 AI Agent 的发展,已经从“模型能不能调用工具”进入“系统能不能在生产环境稳定运行”的阶段。十大趋势背后有一条共同主线:标准化、工程化、可观测、可控制。无论是多智能体协同、MCP 工具协议,还是长程记忆与安全对齐,最终目标都是让 Agent 从炫酷 Demo 变成可靠生产力。对于开发者和企业来说,与其追逐每一个新概念,不如围绕自身业务构建一条最小可用的 Agent 链路:明确任
OpenAI 将AI Agent(智能体)定义为,以大语言模型为大脑驱动,具有自主理解感知、规划、记忆和使用工具的能力,能自动化执行完成复杂任务的系统。它不像传统工具只会“被动干活”,而是可以像“数字员工”一样,自己接任务、做规划、找方法,还能不断自我优化。想象你招了个“超级员工”:它自己会拆解任务,主动调用工具,持续进化不摆烂。简单来说,它具备三个“核心技能”:👁️ 能看懂:能感知客户行为、文
学术界和工业界对术语“智能体”提出了各种定义。大致来说,一个智能体应具备类似人类的思考和规划能力,拥有记忆甚至情感,并具备一定的技能以便与环境、智能体和人类进行交互。可以将智能体想象成环境中的数字人,其中:智能体 = 大语言模型(LLM) + 观察 + 思考 + 行动 + 记忆。这个公式概括了智能体的功能本质。为了理解每个组成部分,让我们将其与人类进行类比:1. 大语言模型(LLM):LLM 作为
(一组固定的权重:因为每个神经元的多个权重固定,所以又可以看做一个恒定的滤波器filter)做内积(逐个元素相乘再求和)的操作就是所谓的『卷积』操作,也是卷积神经网络的名字来源。3,池化层:如最大池化、平均池化,用于降维、减少计算量,并增强一定的平移不变性。图像分类、目标检测、语义分割、实例分割、人脸识别、OCR、医学影像、遥感、视频分析、语音识别、文本分类等。2,激活函数:引入非线性,常用 Re
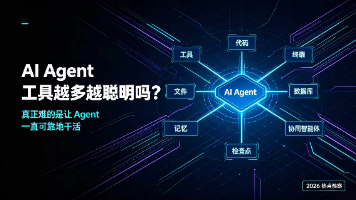
随着 AI Agent 从简单的工具调用逐渐发展到长时间、自主化的任务执行,Agent 的技术重点正在从“模型有多聪明”转向“系统能不能稳定地把事情做完”。本文结合近期人工智能领域的热点,围绕 Agent 工具膨胀、上下文管理、长任务执行、Checkpoint、Harness、Multi-Agent、模型路由以及安全治理等问题展开分析。通过多个实际场景,用通俗易懂的方式讲清楚为什么工具并不是越多越
过去一年,AI Agent从技术概念走向工程落地。但很多人仍然把注意力集中在“用哪个模型”上——换更强的模型、写更长的提示词,仿佛模型就是Agent的全部。但实际开发过Agent 的人,大概率会认识到,这并非事实。一个在业界已形成共识的公式是:Agent = Model + Harness。模型负责“思考”,Harness负责让这份思考变得有用。长程Agent对Harness的依赖,超过它对任何单
反过来,如果希望一套代码快速切模型,网关的字符串路由方式降低了接入成本,但也引入了对网关可用性和配置的依赖。使用时要安装对应框架包,例如。从选型角度,这意味着「Agent 循环控制权」是必须进一步查文档或源码的点:循环次数、终止条件、并行工具调用、人工确认、超时与取消,都会影响生产可用性。需要进一步验证的则包括:Provider 直连与网关的行为差异、模型串映射规则、Agent 循环的终止和错误策
每年这种盘点满天飞,大部分的筛选逻辑是"Star 排序 + 简介复制粘贴"。范式价值—— 它是不是在改变"软件应该怎么做"这个问题的答案本身;生态位—— 它卡住的位置,未来两年会不会越来越重要(还是三个月后就被替代);工程含金量—— 扒开源码看,是真东西,还是一层 prompt 包着的 shell 脚本。AI Agent 基础设施。去年我们还在争论"用不用 AI 写代码",今年整个开源社区在解决的
本文系统解析8大主流AI Agent架构(如ReAct、Plan-and-Execute、Multi-Agent Hierarchical等)核心原理,提出技术选型决策树与避坑指南,聚焦状态管理、工具调用、成本控制与可观测性等工程挑战。对比主流框架与自研Runtime,展望MCP协议标准化、Agent Mesh及端侧Small Language Model趋势,强调AI Agent的未来在于工程架
互联网锁住的是用户的关系链,Agent 锁住的是用户的工作上下文,这也是行业争相布局入口的核心原因:抢的不只是流量,更是上下文的原始积累。AI Agent 经济对传统经济最深的冲击,并不是市场上多出了一类AI产品,而是原本分散在网站、App和软件中的用户入口,正在被一批新的任务代理层重新争夺。用户越多,不一定意味着利润越高;过去,广告可以在搜索排序、信息流原生、网红推荐、品牌内容等多种场景中嵌入用
2026年5月至8月,GitHub涌现以“省Token”为核心的开源浪潮,推动AI Agent工作流深度产品化。头部项目如Headroom(可逆压缩)、caveman(输出精简)、pxpipe(视觉偷渡)等,通过智能中间件、行为优化、多模态降本等六大学派路径,实现90%以上Token节省。这些技术融合学术成果与工程创新,将压缩从算法层延伸至流程、接口与计费策略,形成低成本、高效率的AI开发新范式。
单纯调用大模型 API 只能实现问答能力,而 AI Agent 可以自主规划任务、调用外部工具完成复杂工作。本文基于 2026 年 9 月最新的 Python 3.14.7 与 OpenAI Agents SDK,从零搭建可运行的工具调用智能体;通过对比普通大模型与 Agent 的本质差异,拆解 Agent「思考‑选工具‑执行‑汇总结果」的闭环运行机制,提供完整可直接运行的实战代码,实现版本查询、
总结:先分清 token、算力和工作流次数分别限制什么,再优化提示词、拆分任务和复用模板,最后再判断是否需要升级版本。AI 平台算力额度分层本质上是按照任务复杂度、使用频率和协作需求划分的,入门分层对应轻量试用和低频任务,专业分层对应高频稳定的内容创作和工作流,团队分层对应多成员协作和项目沉淀。AI 平台版本选择不是越贵越好,而是要看任务频率、任务长度、流程复杂度和协作需求。扣子这类 AI Age
智能体(Agent)作为先进的人工智能实体,通过持续感知外部环境、自主决策并执行行动来达成预设目标。其架构具备环境感知、动态决策、行为执行等核心功能模块,并集成记忆存储机制、多层级规划策略及工具调用能力。其规划模块整合了思维链推演、自我反思机制及目标分解技术,形成闭环式认知增强系统。区别于传统AI系统,智能体展现出三大核心特性:在独立运作层面具有无需人工干预的决策自主性;在时间维度上支持长期运行与
8G显存近乎流畅运行的AI语音聊天助手(ubuntu24.04:Qwen3-ASR-0.6B Q8_0(语音识别)+ DeepSeek-R1-7B-Q4-K-M(自然语言推理) + Qwen3-TTS(语音合成))
AI Agent 是能够自主感知环境、做出决策、执行行动的人工智能系统。感知 (Perception):观察环境状态、接收用户输入、读取工具结果推理 (Reasoning):分析信息、规划任务、做出决策行动 (Action):执行工具调用、操作环境、生成响应Agent = LLM + 工具 + 记忆 + 规划Agent 是一个有"目标感"的 LLM,它不仅能思考,还能主动采取行动。LangGrap
从找到合适的数据集和教程,到创建开发环境、调用 GPU、运行项目,再到管理自己的算力资源,一个完整的 AI 工作流往往需要在多个页面和工具之间不断切换。一直以来,所以,除算力资源外,我们还构建了包含优质数据集、热门模型 Notebooks、海量前沿论文、多维度基准测试在内的高质量资源站。同时,随着 AI Agent、MCP 等技术的发展,HyperAI 也在持续优化、升级,以期为广大开发者提供更加
本文介绍一个开源的 AI Agent 协作系统,采用执行者 + 监督者双 Agent 架构,支持插话引导、AI 自主学习、Headroom 上下文压缩等高级特性。完整代码 + Docker Compose 一键部署,适合中高级 AI 应用开发者学习参考。
删掉邮箱后,Trace 仍可能通过工具结果/内部文档/secret/准标识符组合泄密;删得过多又会破坏失败重放。真正的问题不是把更多字符串替换成 ***,而是做可验证转换——删掉不该进入评测资产的内容,同时保留失败复现需要的实体关系、状态变化、工具 Schema、判定条件。风险在 Trace 生成时就出现。OpenAI Agents SDK tracing 默认启用。关闭一个开关不会机械清空其他副
循环神经网络 RNN 专门处理**序列数据**,依靠内部循环与隐藏状态记忆历史时序信息,多用于 NLP、时间序列预测、语音识别等任务。
总结:先分清token、算力和工作流次数分别限制什么,再优化提示词、拆分任务和复用模板,最后再判断是否需要升级版本。AI工作流工具选型不是越贵越好,而是要看任务频率、任务长度、流程复杂度、自身技术学习成本。扣子这类AI Agent工作台适合从轻量任务逐步进阶到工作流和项目空间,但具体是否升级、选择哪一类工具,仍要以官方最新权益和个人真实使用频率为准。优先用入门资源验证自动化想法,再决定是否付费,是
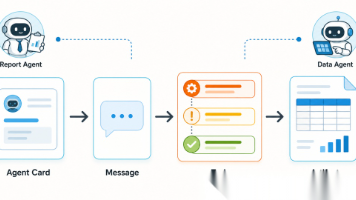
只回答「调接口、传 JSON」,大概率下一句就接不住了。比如报告 Agent 把取数任务交给数据 Agent。十分钟后连接断了,报告 Agent 该重试,还是继续等?数据 Agent 是没收到、正在处理、等人补充时间范围,还是已经生成了报表?如果直接重试,会不会把同一份数据又算一遍?
深度学习(Deep Learning)是机器学习的一个子领域,它被设计用来模拟人类学习的层次化过程,通过构建具有多个隐藏层的神经网络模型,从大量数据中自动学习有用的特征表示。这种技术极大地提升了机器学习模型在图像识别、语音识别、自然语言处理等任务上的性能。深度学习的核心是神经网络,特别是深度信念网络、循环神经网络和YOLO11等。这些网络通过大量的训练数据学习输入到输出的复杂映射,从而能够执行诸图
本文观察 Agentic AI 背后的计算架构变化,重点解析生产级 AI Agent 的训练逻辑:为什么 Agent Demo 进入真实工厂后难度骤增,以及如何通过 Knowledge、Skills、Trajectory、Rollout、Policy 构建任务能力。进一步结合工业场景,围绕设备知识与运维、生产协同、系统调用及多 Agent 协同等实际场景,讨论 AI Agent 如何从“回答问题”
智能体的风险常出现在多个工具串联之后:它是否用了正确的身份、是否重复调用、遇到超时会不会停止。单元测试依然必要,但还应在隔离环境中检查调用轨迹、权限拒绝和异常降级,避免把自然语言回答看成唯一结果。在传统的软件工程中,写好单元测试(Unit Test)往往能覆盖 80% 以上的代码缺陷。但在 AI Agent 和多模态交互系统的开发里,仅仅依靠单元测试去校验单个 Tool 函数或者单个 Prompt
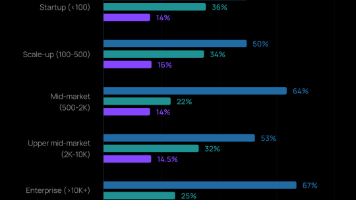
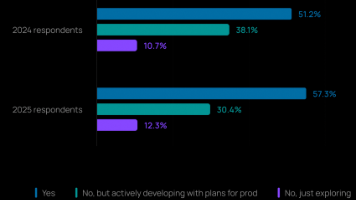
2025 年,让 Agent 实际投产、落地应用的最大障碍已经不再是成本问题了,而是「质量」。如何让 Agent 输出可靠、准确的内容,仍然是最难的部分。近期,LangChain 通过对工程师、产品经理、企业高管等 1300 名行业人士进行调查,深度调研了 AI Agent 目前最真实的应用情况。进入 2026 年,企业对于 Agent 的讨论焦点,已经从「要不要做」全面转向了「如何规模化、可靠且
2025年是AI Agent落地的"大考之年"。文章解析了企业AI Agent落地的四种典型形态:技术编排流(灵活需自建)、模型生态流(通用但业务浅)、独立极客流(快速但风险高)和业务底座流(原生集成)。企业需根据研发能力、业务需求和IT现状选择合适路径。AI转型应从小切口入手,静水深流,将智能融入业务流程,成为组织肌体的一部分,而非简单叠加。
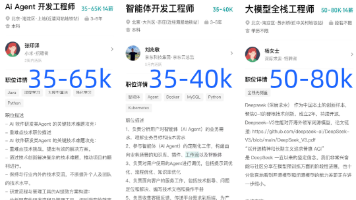
2025年,IT行业的分化已成定局。一些岗位因自动化、流程化而价值降低,另一些则因稀缺性和高门槛而水涨船高。AI工程与应用:不一定要懂算法,但会部署大模型、做AI Agent开发、优化推理效率的人,成了企业争抢的香饽饽。
2026年AI Agent进入工程化落地阶段,57%企业已实现生产部署。应用从内部提效转向外部创收,面临质量、延迟和安全等新挑战。开发者需构建包括架构升级、高级检索、多模型协作、全链路观测、评估驱动开发和零信任安全在内的完整工程体系,才能实现AI Agent的规模化应用。工程纪律将决定AI Agent的成败。
在构建自动化 AI Agent 时,开发者往往希望智能体拥有极高的自主决策能力。但当 Agent 被赋予在长链条下自主选择 Tool Calling 的权限时,系统往往会在特定多模态场景下陷入预期之外的闭环陷阱。一个典型的故障场景是:智能体在处理一张模糊的文本图片时,由于 OCR 提取失败,便不断尝试更换参数重试 API,最终在没有任何阻断的情况下运行数百轮,在几个小时内消耗掉上千美元的 API
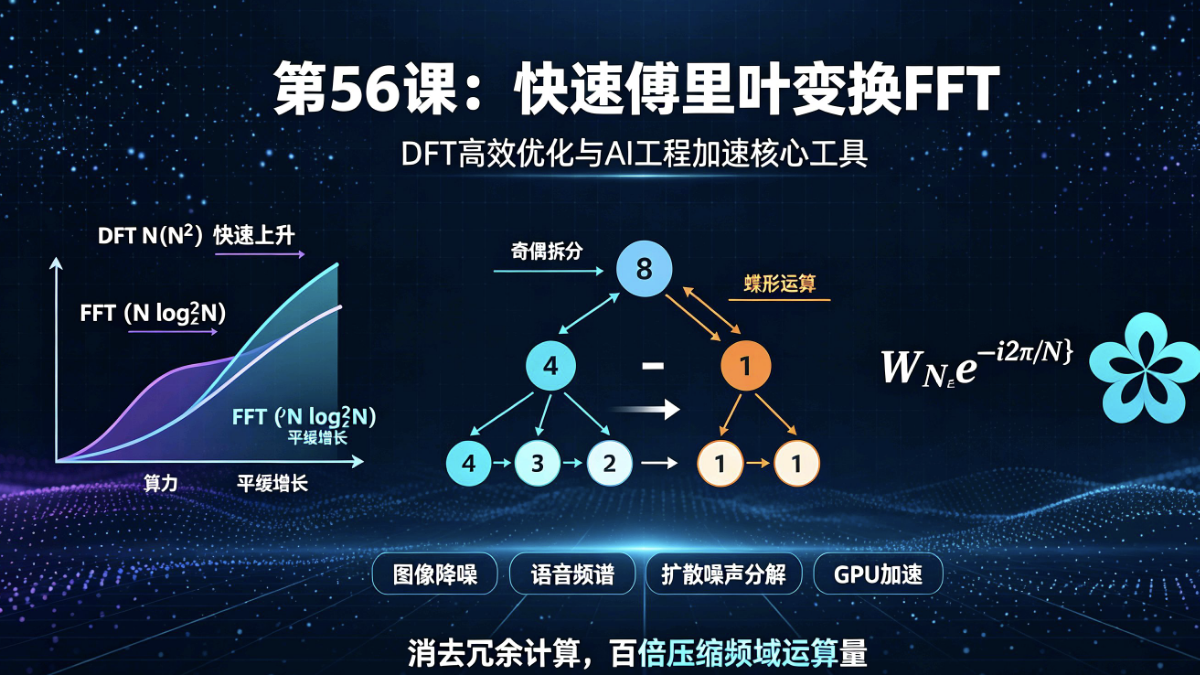
本文介绍了快速傅里叶变换(FFT)的算法原理及其在AI工程中的应用。FFT通过利用旋转因子的周期性和对称性,采用分治策略将离散傅里叶变换(DFT)的时间复杂度从O(N²)优化至O(NlogN),显著提升了计算效率。文章详细推导了基2-FFT的分治过程,解释了蝶形运算这一核心计算单元,并对比了FFT与DFT的性能差异。在应用层面,FFT已成为图像处理(降噪、压缩)、语音识别、扩散模型和时序预测等AI
在开发 AI Agent 系统或多模态交互应用时,许多团队在前期的接口定义上踩过大坑。最常见的做法是按照传统 RESTful API 的思路,定义一个接口,入参传入用户 Prompt,响应体定义为一个简单的。这种“一次性同步返回结果”的接口设计,一旦遇到多轮 Tool Calling、长推理耗时或网络中途抖动,前端界面就会长时间陷入空白死等。更糟的是,当 Agent 中途需要前端用户二次确认(Hu
多模态 Agent 在引入视觉理解能力后,能够处理图表、网页截图和现场照片,大幅拓宽了应用边界。但在架构评审时,团队如果只停留在“能不能识别图片内容”的演示效果上,很容易忽视多模态接入后带来的计算资源暴涨与安全性漏洞。与纯文本 Agent 相比,视觉输入的非确定性与计算复杂度高出一个数量级。评审阶段必须把显存开销、图像 Prompt 注入和状态机死锁等隐性风险搬到桌面上。
检测技术(事实核查、一致性验证)是"安全网",实时拦截错误;抑制技术(RAG、微调、提示工程)是"预防针",从源头减少幻觉。金融与医疗两个工程模拟案例证明,这套双轨体系能显著提升准确率、降本增效,并规避合规风险。未来,结合 AI Agent 架构(Multi-Agent 系统)的协作校验、动态学习与跨模态融合,幻觉控制将走向更智能的形态。幻觉控制不只是技术选项,更是伦理责任——只有通过严谨的工程实
Travel 项目总结:从旅行规划到可治理 AI Agent 的工程化实践
拆解 AI Agent 背后的核心概念:LLM 本质上只是在做文字接龙,Prompt、Context、Memory 是人为发明的信息包装方式;Agent 只是一个由 while(true) 循环驱动的调度器,真正的工作靠循环之外的权限、上下文压缩、工具执行等 95% 工程能力支撑。梳理 RAG、MCP、Skill、API 以及 LangChain/Workflow/Skill 三代流程编排的定位与
在设计 AI Agent 系统时,很多团队刚立项就试图构建一个复杂的 Multi-Agent 协作网络。他们把系统拆分成规划者(Planner)、执行者(Worker)、批评者(Critic)等五六个不同的智能体角色,甚至设计了繁琐的图状态路由。然而在工程落地的初期,盲目增加 Agent 数量往往带来难以控制的非确定性与极高的 Token 耗费。真正的工程之道,是从一个单圈 ReAct 循环的最小