登录社区云,与社区用户共同成长
邀请您加入社区
本实验完整搭建 FPGA 音频采集存储回放系统。硬件层面熟悉 AN831 音频扩展模块、WM8731 编解码芯片,理解 I2C 配置总线、Right Justified 右对齐数字音频协议;软件层面掌握状态机控制、串并转换、异步 FIFO 跨时钟域处理、AXI 总线操作 DDR3 存储器。实验打通模拟音频、数字串行音频、FPGA 逻辑、片外存储整个链路,是 FPGA 语音识别、语音回放、音频处理等
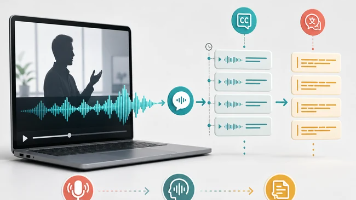
视频转脚本需经过音视频解析、音频提取、预处理、VAD检测、ASR识别、时间戳对齐与文本清洗等环节。仅靠语音识别(ASR)无法直接生成可编辑脚本,还需断句、去冗余、校正专有名词及结构化整理。最终脚本质量取决于全流程技术协同,而非单一模型性能。
做 AI 自动剪视频,最难的不是"剪",是让机器先"听懂"。本文记录了为剪辑工具挑选语音识别方案的真实过程:Whisper 与 Paraformer 的实测对比、字级时间戳的关键作用、从本地到云端的取舍,以及最终把验证过的本地链路开源的原因。
最近接了个跨境电商的推广项目,客户要求视频配音必须覆盖日语、韩语和泰语,而且对发音的地道程度要求极高。说实话,一开始我挺头疼的——国内大部分配音平台主打中文和英语,小语种资源要么少得可怜,要么价格高得离谱。为了找到靠谱的解决方案,我花了整整一周时间,把市面上能接触到的小语种配音渠道都测了一遍,包括专业配音平台、自由职业者社区,还有几家主打AI语音合成的工具,最终总结出下面这些经验,希望能帮到同样有
视频转脚本需跨越“语音识别”与“内容重构”两关。核心流程为:转写→纠错→删口语→分段→结构化→人工校对。关键在于识别准确度与后续整理效率,最终脚本质量取决于对口语化文本的深度优化。
维度Remotion创作语言构建步骤无,index.html打开即预览需要打包器(bundler)动画时序暂停动画并 seek 到精确时刻再截帧,帧级确定代码按帧号返回画面,依赖帧驱动现有 Web 素材HTML/CSS、GSAP、Lottie 动画基本可直接复用需要改写成 React 组件AI Agent 上手写纯 HTML,可直接生成与修改需理解 JSX/React 工程与构建许可证Apache
本文聚焦企业语音识别系统选型,摒弃排行榜思维,从私有化部署、系统集成、国产化适配、项目交付与成本控制等维度,对比科大讯飞、百度智能云、阿里云、云知声及灵声智库五类方案。强调“无最好ASR,只有最适合”:大型政企重品牌与生态,云架构优先标准API,系统集成商关注接口开放与二次开发,国产化项目需真机POC验证并发与稳定性,百路级以上需求应以目标硬件压测为准。最终建议以统一真实音频、环境与业务场景进行多
国产化ASR项目易陷误区:仅迁移模型而忽视硬件架构、推理运行时、算子兼容与链路性能。真正难点在于目标真机适配,需从环境确认、模块逐项验证、完整链路压测到真实业务POC全流程验证。切忌以非目标环境数据承诺性能,应以阶梯测试、一致性回归和长稳并发为准,确保功能、准确率、延迟与稳定性全面达标。
handdrawn‑architecture‑video是MIT协议开源的AI Agent Skill,完全本地零云端依赖,可将SVG系统架构图转换为草稿纸手绘速写风格,自动生成CSS+SMIL自包含动画HTML,一键导出4K MP4视频,非常适合科创比赛、项目路演、技术分享。本文包含完整安装教程、双模式使用方法以及常见报错排查。
它把语音识别、翻译、AI配音、声音克隆、字幕编辑、背景音处理、画面文字翻译集中在一套工作流中。生成后,用户还可以修改原文、译文、声音、语速和时间轴,发现问题时只调整对应片段,不需要重新制作整条视频。•**同时处理短视频、长视频和课程:**VMEG AI 的工作流覆盖更完整。系统可以完成大部分转写、翻译、配音和合成工作,但品牌名、数字、价格、网络用语和CTA仍应抽查。真正的自动化,不只是同时上传多个
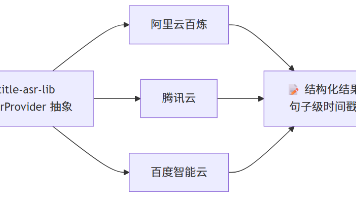
subtitle-asr-lib 是一个纯 Rust 编写的跨云语音识别工具库,仅需一行代码即可将音频转为带时间戳的 SRT、WebVTT 或 ASS 字幕。它封装了阿里云、腾讯云、百度智能云的 API 差异,支持自动轮询、重试、超时处理与零系统依赖的 rustls TLS,实现厂商无感切换。通过统一 TranscribeRequest 接口,用户可轻松对接多云服务,且支持本地文件上传与多种字幕格
方案成本适合谁海外母语真人配音几十美元/分钟大品牌精品片叮叮配音0元试水、测节奏、东南亚小语种起步媒小三配音39元/月包月正式投放、带货转化、多语种放量对口型/全自动译配平台订阅制或几元~十几元/分钟数字人、百集连更团队翻译配音这件事,2026年真的已经没有门槛了——难的从来不是工具,是你愿不愿意先动起来。
<think>我们需要根据用户提供的长内容生成一篇不超过150字的文章摘要。用户给的是一篇关于Timeline Studio中时间线标记功能开发的技术文章。摘要需要简洁,概括核心内容。要控制字数,不超过150字。中文摘要。需要提取关键点:开发视频编辑器时标记功能的重要性,实现四种标记类型,React交互,以及Agent通过CLI/MCP操作,共享命令引擎,注意点如吸附、浮点精度等。摘要要精简,用几
收到短剧后先不要整批上传或改名。先保存原始交付包,核对剧名、版本、总集数、缺集重号和文件可读性;再确认是净版、软字幕还是硬字幕,有没有匹配的带时间码字幕文件(如SRT)、台词表与独立音轨;随后抽查运动背景、人物遮挡、多人对白和低声台词。检查结果应明确哪些集可直接翻译,哪些要做光学字符识别(OCR)、自动语音识别(ASR)或字幕擦除,哪些必须补源或人工处理。
前面三篇分别讲了中文 ASR 选型、本机搭 FunASR 和长音频实测。这篇进入真正的内网生产环境:一台不通外网的 Ubuntu + NVIDIA GPU 服务器,把 FunASR 跑成稳定服务,再对接工作流编排实现会议纪要。读完这篇你能得到四样东西:一套可一次性导入的离线交付物清单;业务拓扑、软件结构和请求时序三张图;7 个内网部署常见踩坑及解法;配套镜像、依赖、脚本、工作流 DSL 的网盘资源
随着 AI 应用的普及,语音交互已成为终端设备的核心能力之一,本文推荐一款低成本高效的语音识别方案。
语音交互系统。说实话,我做了这么多年音频系统,语音交互这块是最让我头疼,也最有成就感的。你想想看,用户坐进车里,第一句话可能就是“你好,小X”,如果这个唤醒没反应,或者识别错了,那体验直接归零。我早期参与的一个项目,就因为唤醒词在高速风噪下频频误触发,被用户骂惨了。嗯,从那以后,我对语音交互的每一个环节都格外较真。。这四个东西,说白了就是“听到你、听懂你、回答你、不打架”。语音交互不是简单的“录音
实际项目中,ADSP Core 0和Core 1是音频的主力,另外两个核心偶尔也会参与,比如做语音识别时,NPU会辅助处理。我在项目中遇到过,有些方案用CPU做音频处理,结果导航卡顿、音乐断断续续,用户体验极差。我记得有一次调试车载KTV功能,延迟要求小于30ms,用CPU方案死活做不到,换成DSP直通路径,一下子就过了。我曾经尝试把完整的杜比全景声解码器跑在DSP上,结果内存不够,系统直接崩溃。
ComfyUI v0.34.0实测:HDR视频直接导出+FishAudio本地语音合成+TRELLIS2三维生成,RTX 4060 8G显存全搞定,含完整工作流模板下载。
涉密或高敏感企业使用AI会议助手时,需要关注的问题并不限于语音识别和会议纪要。从实际使用角度看,比较容易被忽略的几个方面包括:会议数据实际流向、私有化部署是否覆盖完整处理链路、多人会议下的识别表现、检测指标的测试条件,以及后续权限和资料管理。如果产品提供了CNAS认可实验室的检测结果,或者相关检测结果处于ILAC MRA国际互认体系下,可以作为技术评估中的一个参考,但仍然需要结合检测范围、测试方法
从技术角度来看,视频转脚本可以理解为“语音识别 + 文本后处理 + 内容结构化”的组合过程。
下载视频↓提取字幕↓自己看视频↓截几张图↓整理问题↓再问 AI而 Claude Video 把这套流程自动化了。/watch 视频链接你想知道什么这个视频讲了什么?哪里出现了 Bug?2 分 30 秒发生了什么?主播用了什么软件?这个教程完整流程是什么?这个产品发布视频到底发布了哪些新功能?AI 会自己处理视频、字幕、音频和关键帧。对于经常使用AI Agent 正在从“只能阅读文本和代码”,逐渐变
视频转文字教程:2026年批量提取视频文案的完整工作流拆解,对比鲸剪 WhaleClip、剪映、度加剪辑、Descript、万兴喵影五款工具在语音识别、批量处理、工程化接入上的差异,帮助创作者与矩阵团队选对方案。
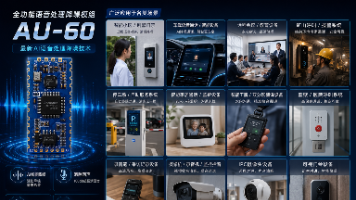
AU-60全功能AI语音处理模组是一款37.5×16mm的超紧凑音频处理方案,集成了ADC、DSP、AI降噪、波束成形、AEC回声消除(100dB抑制能力)等核心技术。该模组通过AI神经网络实现45-90dB环境降噪,支持双麦波束定向拾音,提供模拟/I2S数字/USB多接口兼容,硬件可切换四种拾音模式(0.1-8米覆盖)。适用于会议系统、车载设备、智能工牌等场景,实现"即插即用"
根据奈奎斯特采样定理:当采样率大于等于连续信号最高频率的 2 倍时,采样信号就能无差别还原出原始信号。例如采样深度为 16bit,则声音有 2 的 16 次方个振幅等级;本文将从 PCM 原理出发,系统讲解音频数据的生成过程、核心参数与存储格式,并结合 AI 模块(语音识别、AI 降噪等)的实战应用,帮助读者建立从底层数据到上层智能处理的完整认知。采样率指每秒钟采样的个数,即 1 秒内采集声音的频
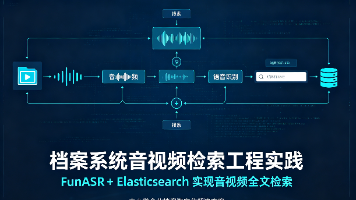
音视频档案内容级检索,并不是简单调用一个语音识别 API 就可以完成,是一整套媒体处理‑语音识别‑结构化存储‑检索‑前端播放器联动的工程体系。在档案行业,该能力很多时候被归为高阶付费模块。成都中禁创科基于 FunASR 开源模型结合 Elasticsearch、Redis 构建完整本地化管线,可以低成本完成音视频档案从 “只能存储播放” 升级为 “可检索、可定位、可复用” 的声像数字资产,补齐档案
没有字幕,不代表视频无法翻译。只要视频里有可辨认的外语对白,就能先通过 ASR 语音识别生成原文字幕,再翻译成中文。下面从素材检查、语音转写、字幕翻译到导出成片,说明一套可以直接照着做的流程。
它不是单点翻译工具,而是把语音识别、翻译、配音、字幕和混音整合起来,降低多语言视频的重复制作成本。
这个项目展示了AI Agent 在垂直内容创作领域端到端自动化:从内容理解到播客输出,全流程 AI 驱动多模态融合:文字、图片、音频、视频统一处理专业级音频质量:音色设计 + 智能混音,输出广播级品质低门槛使用:可视化配置 + 自然语言交互,无需技术背景。
当前AI语音转写工具的能力,已经可以满足大部分办公场景下的会议视频文字提取、内容复盘需求,不同工具的功能定位、适配场景存在明显差异,不存在万能通用的工具,按需选型是提升办公效率的核心。百度网盘综合功能较为全面,兼具存储与基础AI转写能力,适配普通用户日常综合办公需求;飞书妙记、通义听悟、剪映、OpenAI‑Whisper均有各自的场景局限性与专属适配领域,分别对应团队生态办公、个人轻量化转写、视频
本文对比了5种AI视频转思维导图工具(百度网盘、Mapify、BibiGPT、GitMind、XmindAI),分析了各自特点:百度网盘适合已用户实现存储-笔记闭环,Mapify专注YouTube时间戳索引,BibiGPT支持多平台汇总,GitMind提供多模型切换,XmindAI继承专业排版优势。文章指出这类工具通过语音识别、文本结构化、时间戳对齐和可视化渲染四步实现内容自动化整理,建议根据存储
本文对会议转写工具(百度网盘「简单听记」、飞书妙记、通义听悟、讯飞听见、腾讯会议AI纪要、钉钉AI听记)进行了实测对比。测试基于45分钟技术评审会议音频,从转写准确率、智能纪要质量、存储安全和使用流程等维度评估。各工具特点鲜明:百度网盘存储空间大且安全认证完善,飞书/钉钉/腾讯会议与其生态深度集成,通义听悟适合个人轻量使用,讯飞听见专业度突出。建议根据存储需求、会议平台偏好和使用频率选择,并注意提
AI配音工具性能评估显示,逗哥配音在高并发场景下表现出色,500字文本渲染速度控制在8秒内,稳定性优于市场同类产品。其核心优势在于支持SSML语音标记语言,可精确控制停顿、重音等参数,满足专业有声书、网课等高级场景需求。开发者评价其算力投入和接口开放性具有工程价值,特别适合批量音频产出和API对接需求。常见问题解答证实其快速渲染和代码级调整能力,是追求高效稳定AI语音解决方案的理想选择。(149字
FunASR 仓库里挂着一整族模型,我最后选了 Paraformer-zh 加 VAD 加标点,理由就一条:中文场景下它是"稳稳跑通"的默认选项,社区资料最全,坑都有人替你踩过了。Paraformer 是达摩院语音实验室的模型,2022 年发表在 INTERSPEECH 上,非自回归架构,解码单步完成,所以快。三个模型的分工是这样:FSMN-VAD 先把长音频切成"有人说话"的段落,Parafor
在2026年回看大语言模型(LLM)的发展,我们不得不承认一个事实:即便参数规模达到万亿级别,训练数据覆盖了截至2025年底的大部分公开文本,大模型依然存在天然的“知识截止日期”短板。更棘手的是,对于金融行情、突发新闻、实时天气、本地商户信息、产品价格变动等动态数据,大模型完全无能为力——它只能“回忆”,不能“观察”。这正是AI Agent(智能体)范式兴起的核心驱动力之一。一个真正有用的Agen
日常音乐压缩:使用pydub+ MP3,128kbps是音质与体积的最佳平衡无损归档:使用soundfile+ FLAC,完整保留原始音质语音/电话应用:使用A-law/μ-law压缩,节省带宽同时保持语音可懂度播客制作:配合动态范围压缩,让听感更舒适极致压缩比:尝试神经网络编解码器(DAC/EnCodec)选择合适的技术方案,可以在存储空间和音频质量之间找到最佳平衡点。
我选的是横屏 16:9、克制的屏幕放大、轻科技 MG、分段 Lo-fi 音乐、中文字幕,并且每个阶段都先让我验收。**能拖的,我自己拖一下;它没有把我变成专业剪辑师,只是让我不需要花大量的时间去干重复的劳动,我觉得有了codex,我的时间可以拿去做更有价值的事情。对了,ai粗剪完,一定要自己再听一遍,当时我发现有些重复的语句没被剪掉,所以我人工又过了一遍,千万不要觉得ai做完就行了。,可以自动一键
本文介绍了一个基于Python和ttk的现代化音乐播放器开发项目。该项目针对当前播放器存在的界面同质化、功能臃肿等问题,采用Python+ttk技术栈,实现了美观实用的播放器功能,并具备自由换肤能力。系统采用分层架构设计,包含皮肤引擎、播放控制、音频处理等核心模块。其中皮肤系统支持通过JSON配置文件实现界面主题切换,播放控制器采用状态机模式管理播放流程,音频可视化引擎提供多种显示效果。项目还实现
本文介绍了基于Python的音频处理与MIDI制作技术,包含12个实验项目,从中国传统音乐理论到现代语音合成技术。主要内容包括: 系统架构:在华为云服务器上搭建Python 3.12.3环境,使用mido、numpy、scipy和edge-tts等核心库进行音频处理。 节奏基础: 通过《弹歌》实例分析中国最古老歌谣 探索竹林七贤与中国传统音乐的关系 实现WAV波形生成功能,模拟竹笛音色 五声调式:
视频混剪器
适用范围:不适用范围:我最初把 TTS 接到 Voice Agent 时,链路看起来很顺:真正跑起来后,问题集中出现在两头。第一种情况是“假流式”。TTS 接口确实逐块返回音频,但程序一直等 LLM 把整段话生成完,才一次性把全文送去合成。TTS 首包可能只有 200 ms,用户却先等了 1~2 秒文本。第二种情况是“包到了,声音仍然断”。如果每收到一个 PCM 包就立即播放一次,浏览器会创建许多
正是为了解决这些真实痛点而生的一款桌面应用。它专门针对 TeslaCam / Sentry Mode 视频做了体验优化,让你像浏览“时间轴”一样轻松查看和管理行车/哨兵录像。
长期交互中的 agent 记忆问题,表面上是上下文窗口不够长,实际更接近一个检索策略问题。用户问的问题往往不会直接命中某条历史记录,而是需要先找到一个线索,再从这个线索推到时间、人物、主题或另一个事件。传统记忆系统通常先按 query 做一次 top-k 检索,再把结果交给模型推理;如果第一轮检索没有拿到关键证据,后面的推理很难补救。
摘要: 本文不谈理想化的全自动 Agent,只讲一套实际能上线、能止损、能复盘的半自动营销闭环流水线设计思路——适合想用 AI 做内容营销但踩过坑的开发者和产品人。
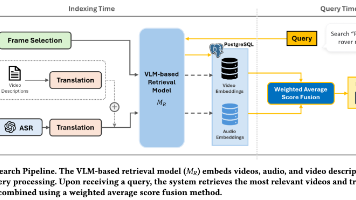
训练一个视频表征模型,用于query文本检索召回视频。文本、视频画面、ASR 文本处于同一个向量空间中的跨模态表征。因为GME模型没有经过图像/视频训练,所以这里的对比中GME是对帧图emb进行mean pooling处理multi-agent:Routing Agent:判断该聊天还是搜索。Search Agent:调用检索模型召回 Top-10,再调用 LLM 重排。Chat Agent:基于