万字讲透AI知识图谱:设计思想、企业ROI与轻量级落地实践
这几年我们一直在深耕 AI Agent 与大模型应用,比如 JitKnow AI 知识库、JitWord协同AI文档、Pxcharts 超级表格,同时也持续在给大家分享 GitHub 上真正能落地、能解决实际问题的优质AI开源项目。
接下来我会和大家深度拆解企业级AI知识库的现状,最佳技术实践以及我们这3年踩过的坑,帮助大家更好的落地企业级知识库系统。
全文约 1w 字,有需要的可以仔细阅读本文。
开篇:为什么 2026 年,知识图谱又被重新捧上神坛?
如果大家在 2023 年问一个 AI 团队"怎么做企业知识库",十有八九的答案是:切分 → Embedding → 向量库 → 检索 → 塞给大模型。
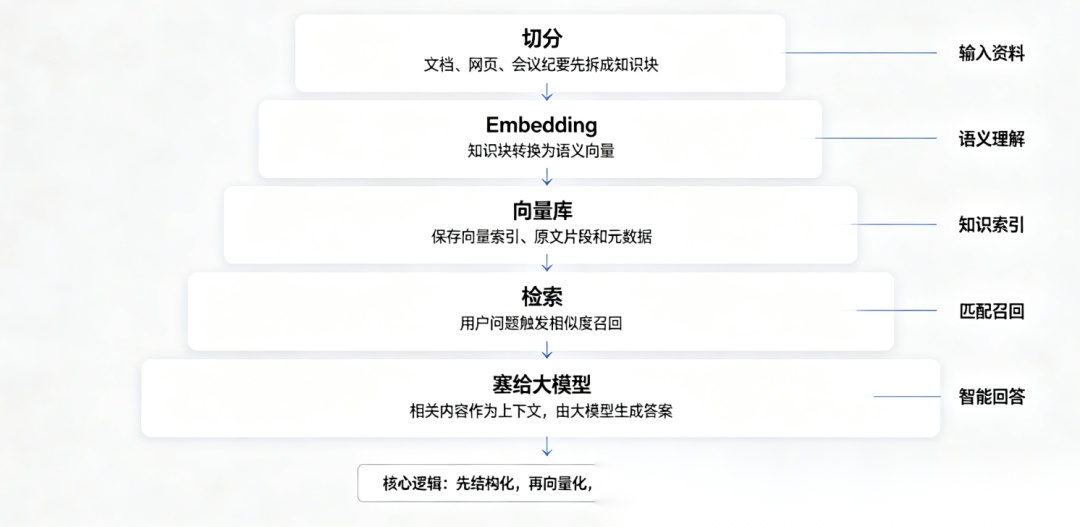
这套 RAG 流水线在过去两年几乎成了行业标准答案。
但到了 2026 年,我发现越来越多团队开始踩同一个坑:纯向量检索在"跨文档关联推理"上几乎是残废的。
分享一个典型场景:法务要查"A 公司的实控人 B 曾经任职的 C 公司有没有被 D 监管机构处罚过",这个问题横跨 4 份文档、3 条关系,向量相似度检索能把相关文档捞回来,但它不会帮我们把关系串起来,最终大模型要么漏信息,要么开始"幻觉式补全"。
这就是知识图谱重新回到舞台中央的根本原因:向量库解决的是"语义相似",知识图谱解决的是"结构关联"。前者是模糊匹配,后者是精确推理。两者不是替代关系,而是互补关系。
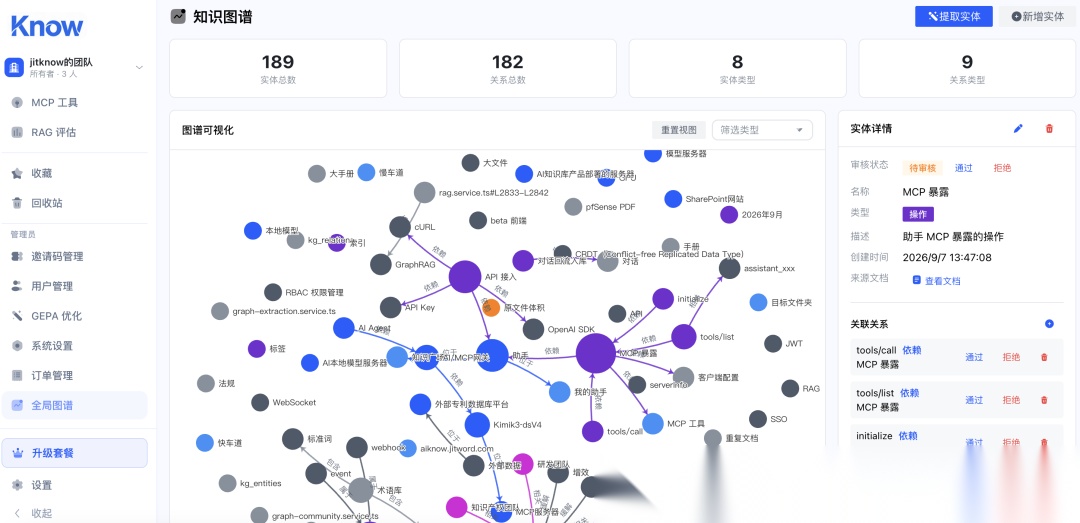
我们团队在做 JitKnow 企业知识库产品的过程中,深度踩过纯 RAG 的坑,也完整走过从"向量优先"到"图谱+向量混合"的演进路线。
这篇文章,我们把知识图谱的技术实现、设计思想、企业落地的真实账本、轻量级方案、以及主流开源选型,一次性讲透。
文中提到的产品:JitKnow AI 知识库
体验地址:know.jitword.com
设计思想:从"存数据"到"存知识"的范式跃迁
2.1 本质:图不是目的,语义关联才是
很多人对知识图谱的第一印象是"画一堆节点和边的炫酷图"。这是对知识图谱最大的误解。图只是知识的表现形式,真正的核心是"语义化的关联结构"。
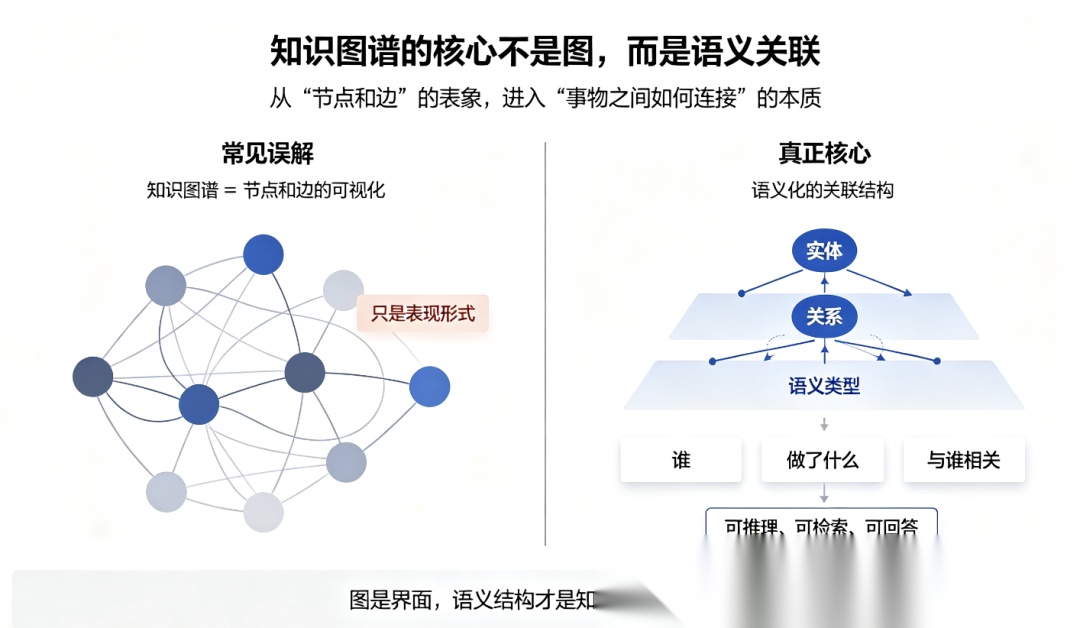
传统关系型数据库里,“张三"和"李四"如果不在同一张表的同一行,它们之间就没有任何关系。而在知识图谱里,(张三, 同事, 李四) 这样一条三元组,就把两个人的关系显式地编码进了数据结构。这种"关系即一等公民"的设计,让机器第一次能够像人一样理解"谁和谁有关、通过什么路径有关”。
用一句话概括知识图谱的设计哲学:把隐性的知识显性化,把分散的知识关联化,把静态的知识可推理化。
2.2 两大数据模型之争:RDF 三元组 vs 属性图
知识图谱的底层数据模型,业界长期存在两条路线,这直接决定了我们后续的技术选型和生态绑定。
路线一:RDF(资源描述框架)——语义网的正统血脉
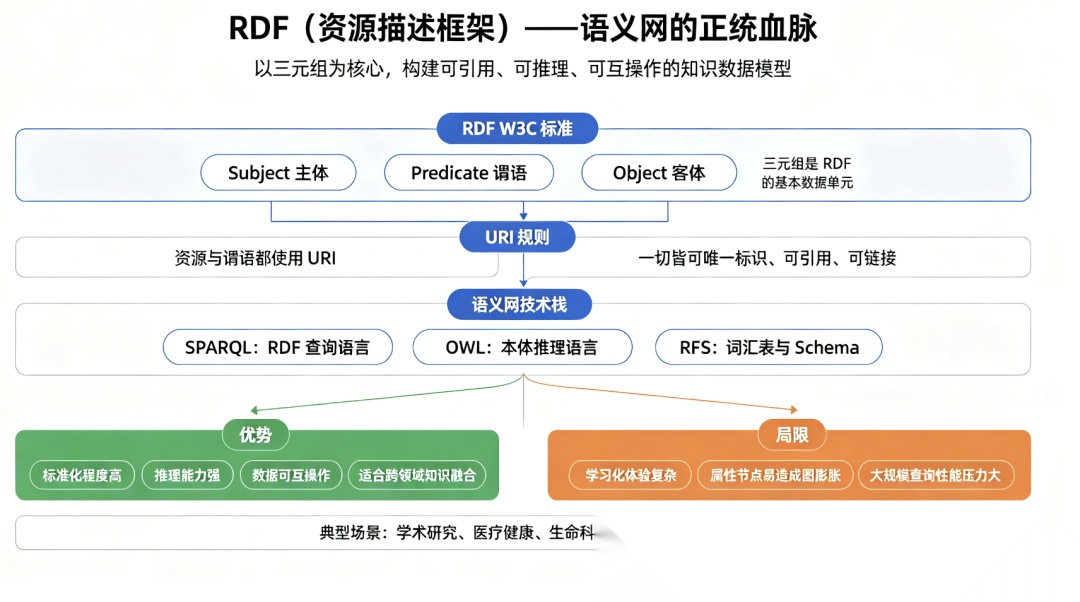
RDF 是 W3C 标准,核心是三元组(Subject-Predicate-Object)。每个资源都有 URI,谓语也是 URI,一切皆可引用、可推理。RDF 的查询语言是 SPARQL,配套有 OWL 本体语言、RDFS 词汇表,形成了完整的语义网技术栈。
RDF 的优势在于标准化程度极高、推理能力强、数据可互操作。学术圈、医疗、生命科学、政府开放数据等领域大量使用 RDF。但它的缺点也很明显:学习曲线陡峭、工程化体验差、属性必须建模为节点导致图膨胀、查询性能在大规模下堪忧。
路线二:属性图(Property Graph)——工业界的务实选择
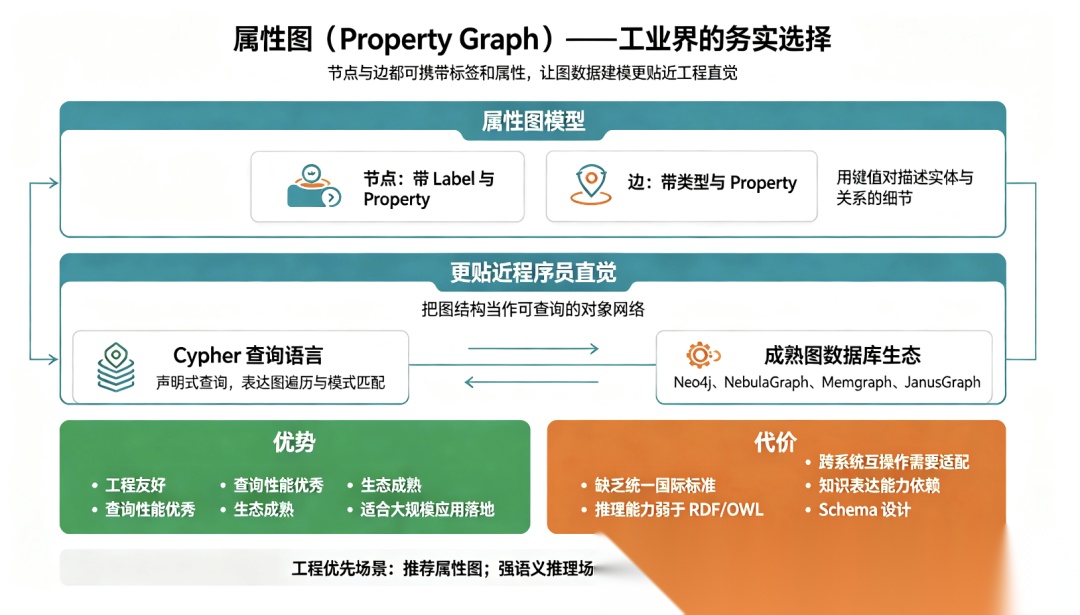
属性图是 Neo4j 带火的模型,节点和边都可以带标签(Label)和属性(Property,键值对)。它更贴近程序员的直觉,查询语言 Cypher 也比 SPARQL 好写得多。
属性图的优势是工程友好、性能优秀、生态成熟,几乎所有新生代图数据库(Neo4j、NebulaGraph、Memgraph、JanusGraph)都采用属性图模型。它的代价是缺乏统一的国际标准、推理能力弱于 RDF/OWL、跨系统互操作需要额外适配。
下面我画了一张对比图,方便大家参考研究:
| 维度 | RDF 三元组 | 属性图(Property Graph) |
|---|---|---|
| 核心结构 | SPO 三元组,一切皆 URI | 节点+边,均可带标签和属性 |
| 查询语言 | SPARQL(W3C 标准) | Cypher / nGQL / Gremlin |
| 推理能力 | 强(OWL/RDFS 规则推理) | 弱(需外挂规则引擎) |
| 标准化 | 极高,W3C 国际标准 | openCypher 社区标准,非官方 |
| 工程体验 | 陡峭,概念多 | 直观,贴近开发者 |
| 大规模性能 | 一般,三元组存储开销大 | 优秀,原生图存储优化 |
| 典型场景 | 学术、医疗、生命科学、开放数据 | 企业应用、风控、推荐、社交 |
| 代表系统 | Apache Jena、RDF4J、GraphDB、Stardog | Neo4j、NebulaGraph、JanusGraph、Memgraph |
**我们的判断:**对于 90% 的企业知识库场景,属性图是更务实的选择。RDF 的推理能力听起来很美,但企业里真正需要 OWL 级推理的场景不到 5%,而属性图的工程效率和性能优势是实打实的。除非大家在医疗/生命科学/学术领域,否则不必为 RDF 的"标准正统"买单。
2.3 本体(Ontology):图谱的"宪法"
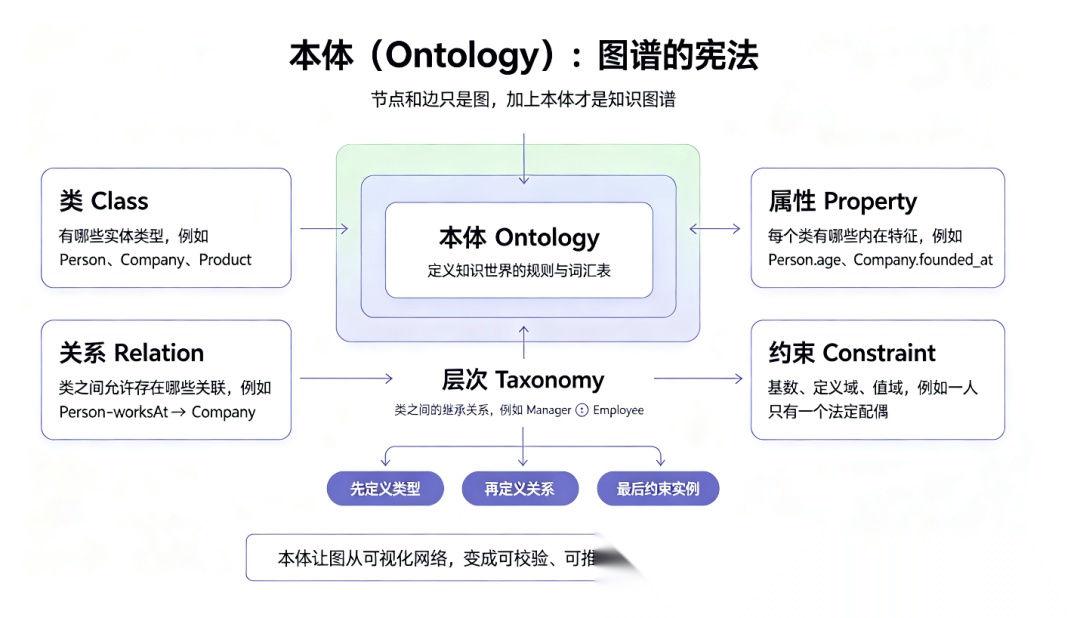
一堆节点和边只是"图",加上了本体(Ontology)才叫"知识图谱"。这块知识也是我们最近在做AI知识库一直在研究的思想,下面给大家介绍一下它的几个核心定义:
-
类(Class)
有哪些实体类型,如 Person、Company、Product
-
属性(Property)
每个类有哪些内在特征,如 Person.age、Company.founded_at
-
关系(Relation)
类之间允许存在哪些关联,如 Person -worksAt→ Company
-
约束(Constraint)
关系的基数、定义域、值域,如"一人只有一个法定配偶"
-
层次(Taxonomy)
类之间的继承关系,如 Manager ⊑ Employee
没有本体约束的图谱会出现荒唐结论:“地球是太阳的配偶”“A 是 B 的父亲,B 是 C 的母亲 → A 是 C 的祖母”(连性别都没判断)。本体就是图谱世界的宪法,它保证知识的一致性和可推理。
在工程实践中,我们建议采用 Schema-as-Code 的方式管理本体:用 YAML/JSON 定义实体类型和关系类型,版本化管理,CI 校验。这比在图数据库里手工建约束可靠得多,也方便团队协作和审计。
技术实现全链路:五层架构拆解
一个完整的企业级知识图谱系统,从数据接入到上层应用,可以清晰地拆分为五层。下面我来给大家逐层拆解:
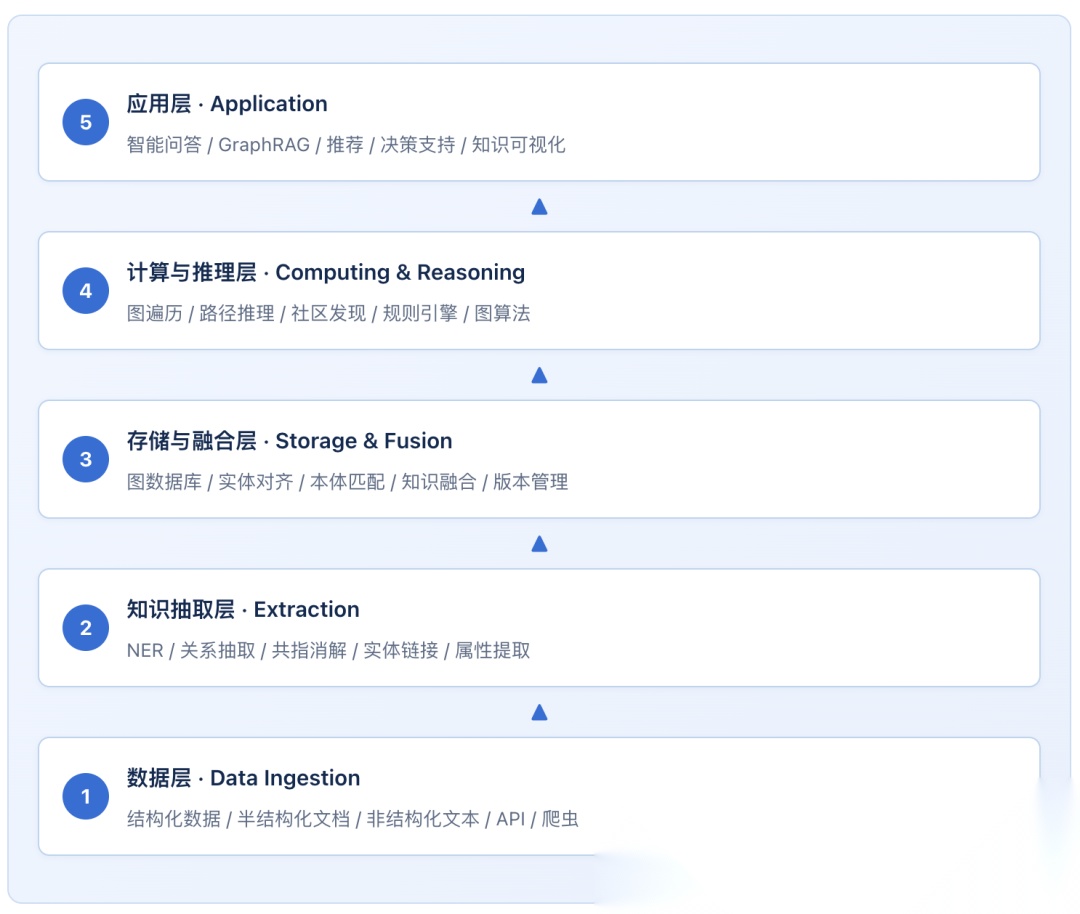
3.1 数据层:多源异构的标准化接入
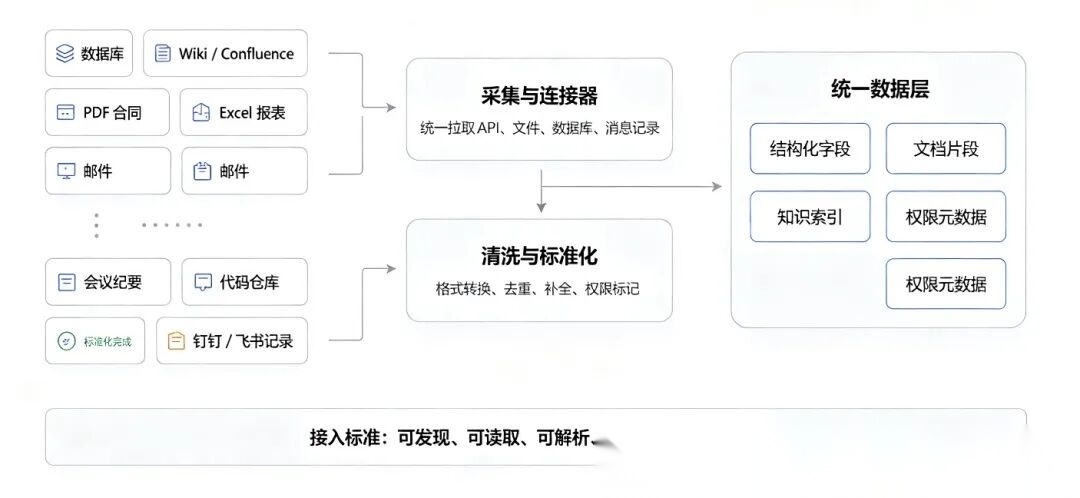
企业知识散落在各个角落:数据库里的结构化数据、Wiki/Confluence 里的文档、PDF 合同、Excel 报表、邮件、会议纪要、代码仓库、甚至钉钉/飞书的聊天记录。数据层的核心任务是全类型数据的标准化接入。
下面我总结了3条关键设计原则,供大家参考:
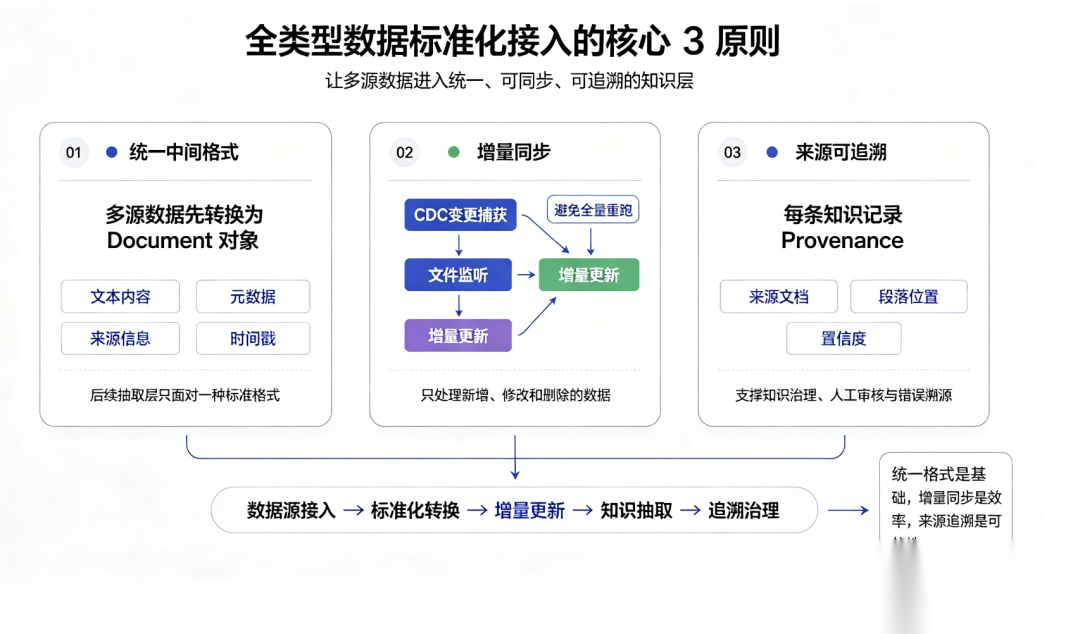
详细描述如下:
-
统一中间格式
所有数据源先转换为统一的 Document 对象(含文本、元数据、来源、时间戳),后续抽取层只面对一种格式
-
增量同步
通过 CDC(变更数据捕获)或文件监听实现增量更新,避免全量重跑
-
来源可追溯
每条知识必须记录 provenance(来源文档、段落、置信度),这是后续知识治理和纠错的基础
3.2 知识抽取层:LLM 时代的范式变革
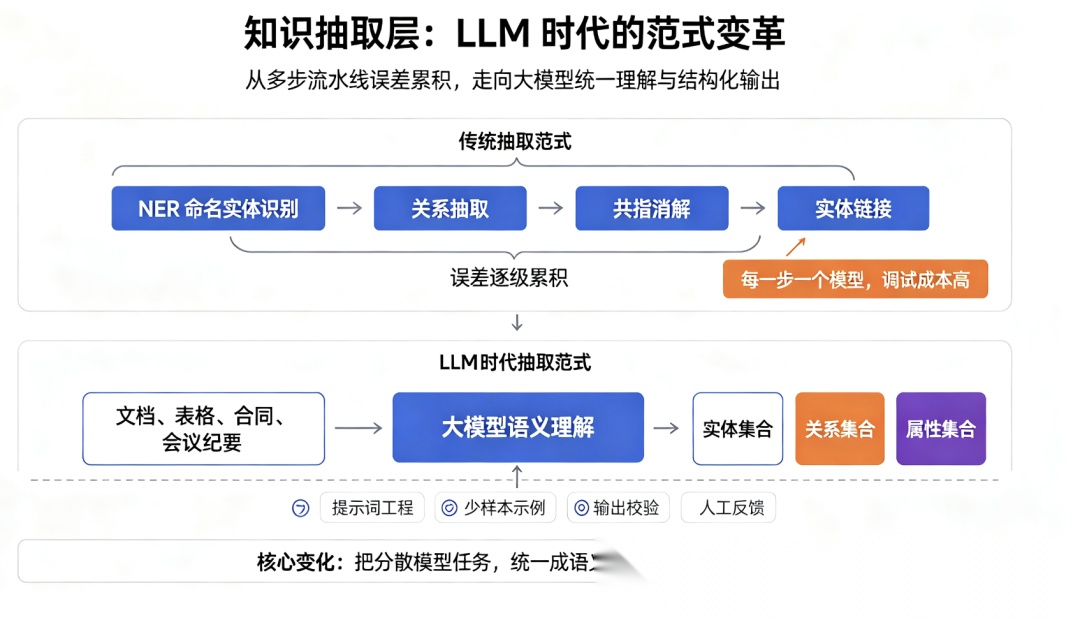
知识抽取是整个图谱构建中成本最高、质量最关键的环节。传统方案是流水线式的:NER(命名实体识别)→ 关系抽取 → 共指消解 → 实体链接,每一步一个模型,误差逐级累积。
LLM 的出现彻底改变了这一格局。现在主流的做法是 Schema-Guided LLM 抽取:把本体定义(实体类型、关系类型)作为 prompt 的一部分,让大模型直接输出符合 schema 的三元组。这种方式的优势是:
-
零样本/少样本即可启动
不需要为每个领域标注训练数据
-
联合抽取
实体和关系一次完成,避免流水线误差累积
-
可处理复杂语义
包括隐式关系、长距离依赖
但 LLM 抽取也有明显问题:幻觉、格式不稳定、成本高、长文本处理困难。工程上的应对策略,我们经过实践,总结了以下一些低成本方案,供大家参考:
-
结构化输出约束
使用 Function Calling / JSON Schema / 正则约束,强制输出格式
-
分块+上下文窗口
长文档按语义分块,跨块共指消解单独处理
-
置信度过滤
低置信度三元组进入人工审核队列,不直接入库
-
小模型蒸馏
用 LLM 生成标注数据,微调领域小模型(如 Qwen-7B),降低推理成本
-
Ontology-Guided 抽取
只抽取本体中定义的实体和关系类型,避免开放式抽取的噪声爆炸
💡 我们的实战经验
在 JitKnow 的实践中,我们发现"LLM 直接抽取 + 规则后处理"的混合方案性价比最高。LLM 负责语义理解(识别"张三在阿里巴巴担任技术总监"),规则负责标准化(把"阿里"“阿里巴巴集团”"Alibaba"统一为实体 ID)。纯 LLM 方案成本是混合方案的 5-8 倍,而准确率提升不到 10%。
3.3 存储与融合层:图数据库是核心引擎
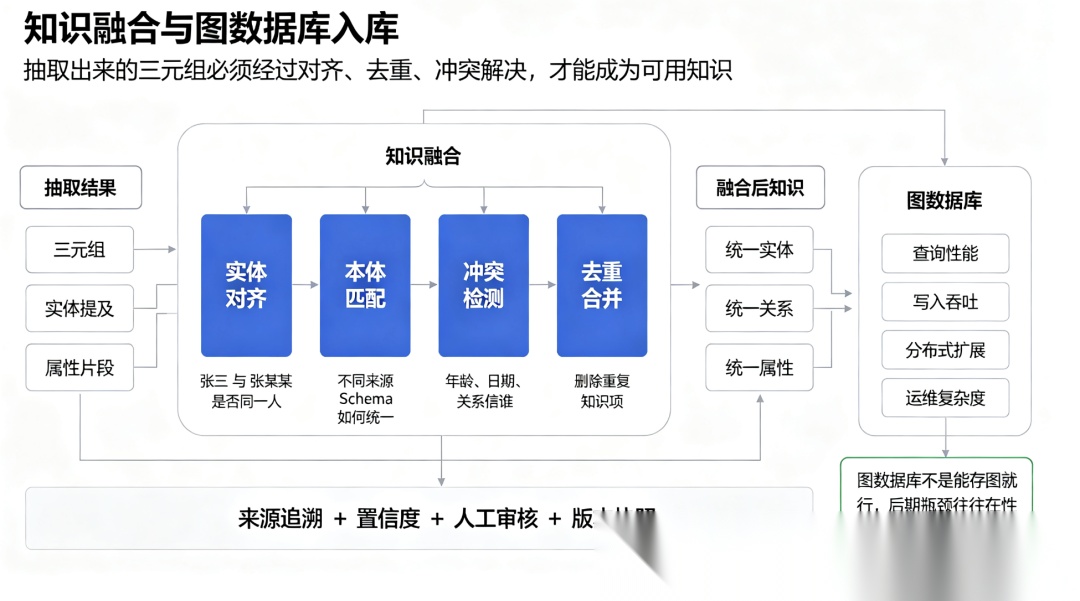
抽取出来的三元组不能直接用,必须经过知识融合:实体对齐("张三"和"张某某"是不是同一个人)、本体匹配(不同来源的 schema 如何对齐)、冲突检测(A 说张三 35 岁,B 说 36 岁,信谁)、去重合并。
融合后的知识存入图数据库。图数据库的选择是整个架构中最关键的技术决策,我们在第六章会详细对比。这里只强调一点:图数据库不是"能存图就行",查询性能、写入吞吐、分布式扩展、运维复杂度,每一项都可能成为后期瓶颈。
3.4 计算与推理层:从"查得到"到"推得出"
存储解决的是"查得到",计算层解决的是"推得出"。常见的图计算模式我整理了一个思维导图,供大家参考:
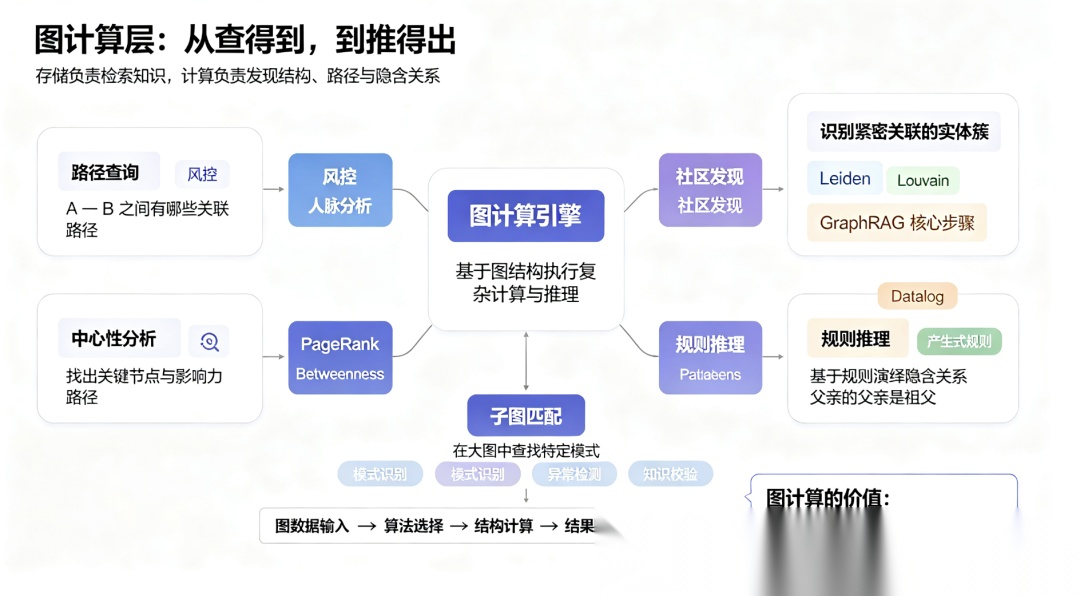
需要注意的是,图算法和图查询是两回事。
图查询(Cypher)是在线的、毫秒级的点查和遍历;
图算法(PageRank、社区发现)是离线的、批量的全图计算。
前者走图数据库的查询引擎,后者往往需要 Spark/Gelly 或图数据库内置的算法模块。大家可以针对实际的应用场景来采用更合适的技术方案。
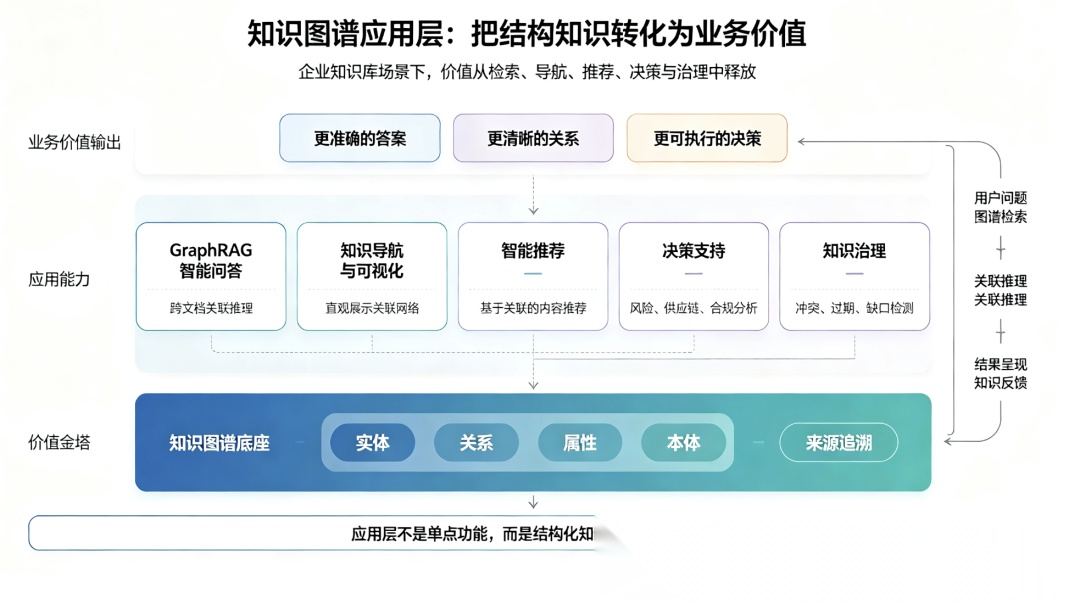
3.5 应用层:让知识真正被用起来
我一贯的产品设计原则是:知识图谱的最终价值体现在应用层。
企业知识库场景下,结合我们探索3年多的经验,给大家分享几个我认为最有价值的应用形态:
企业落地:价值与成本的策略考量
4.1 价值维度:知识图谱到底能带来什么?
我们把企业知识库落地知识图谱的价值,归纳为四个可量化的维度。
维度一:检索准确率与幻觉抑制
纯向量 RAG 的核心痛点是"检索到了但没串起来"。知识图谱通过显式的关系结构,让多跳推理成为可能。
下面给大家分享几个行业内的公开案例,这样大家会有一个更好的认知:
- 某头部制造企业(具体暂不公开)图纸审核场景,纯 LLM+RAG 的规范匹配准确率仅 72.3%,引入 KG+LLM 后提升至 98.7%,日均拦截 270+ 次 LLM 幻觉篡改规范行为
- 腾讯云知平台通过知识图谱+大模型,一年节省 3 亿元开支(含差旅、场地、知识传递提速及人力减少)
维度二:知识复用率与经验传承
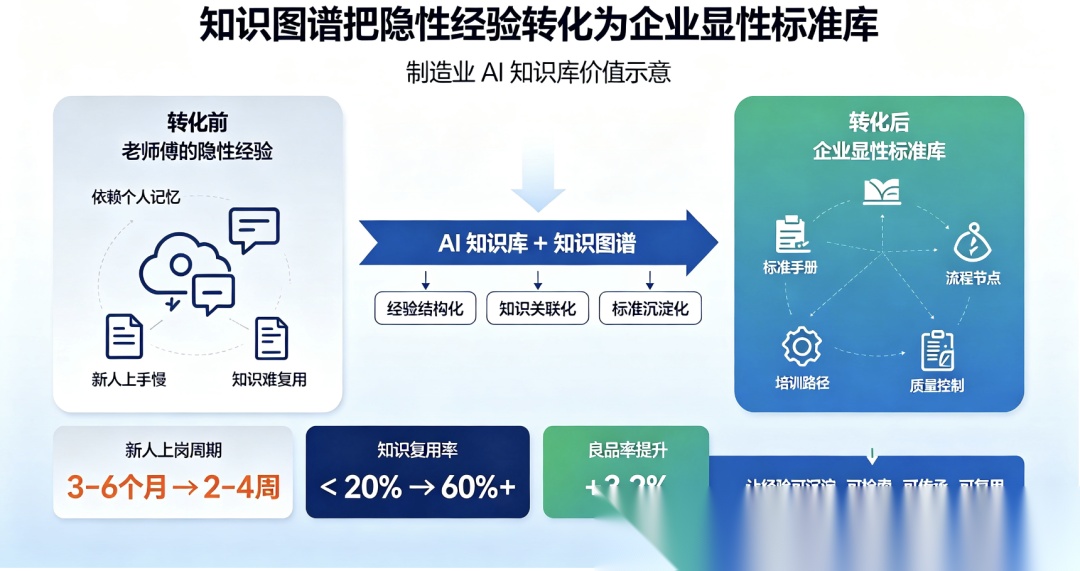
如上图所示,知识图谱把"老师傅的隐性经验"转化为"企业的显性标准库"。
比如拿制造业举例:企业通过采用AI知识库,新人独立上岗的周期可以从 3-6 个月缩短至 2-4 周,知识复用率从不足 20% 可以提升至 60% 以上,良品率提升 3.2%。
维度三:运营效率与决策速度
这块的价值我还是举几个例子,让大家更能感受其价值:
- 三一重工通过 AI 运维知识库整合 10 万台设备故障数据,设备停机时间从平均 4 小时缩短至 1.2 小时,年节省超 2 亿元
- 证券公司通过知识图谱处理股权公告,尽调资料审核从 3 天缩短至 3 小时,数据提炼效率提升 700%
- 企业采用"技术+质量+客服"三位一体知识库后,工程师查找资料时间从 120 分钟降至 10 分钟,效率提升 92%
维度四:合规与风险管控
金融、医疗、法律等强监管行业,知识图谱的关系网络可以做风险传导分析:
比如一笔交易的对手方的实控人的关联公司有没有被处罚?
这种多跳查询是关系型数据库和向量库都做不好的。
4.2 成本拆解:知识图谱到底有多贵?
价值很美好,但成本必须算清楚。我们把知识图谱的落地成本拆为五项,大家可以参考一下:
| 成本项 | 说明 | 占比估算 | 降低策略 |
|---|---|---|---|
| 本体建模成本 | 领域专家梳理实体类型、关系、约束,通常需要 2-4 周密集工作 | 15-20% | 从最小本体起步,迭代扩展;复用行业本体 |
| 知识抽取成本 | LLM 推理费用、标注审核人力、抽取 pipeline 开发 | 30-40% | 小模型蒸馏、混合抽取、置信度过滤减少人工审核 |
| 基础设施成本 | 图数据库服务器、存储、向量库、GPU(如需本地模型) | 15-25% | 轻量级方案、云托管、按需扩缩 |
| 人力成本 | 图工程师、算法工程师、领域专家、运营人员 | 20-30% | 低代码工具、自动化 pipeline、SaaS 化 |
| 运维与治理成本 | 知识质量监控、冲突处理、版本管理、持续更新 | 10-15% | 自动化质量评估、来源追溯、告警机制 |
⚠️ 最容易被低估的成本:知识治理
我们发现大多数团队只算了"建图谱"的成本,没算"养图谱"的成本。知识是有保质期的——组织架构会变、产品会迭代、制度会更新。如果没有持续的知识治理机制,图谱在上线 6 个月后就会变成"知识垃圾场":过期的关系、冲突的实体、无人维护的孤立节点。
我们的建议是:把知识治理的人力预算,按建设成本的 30% 逐年列支。
4.3 ROI 测算框架
这里给大家分享一个简单的 ROI 测算公式:
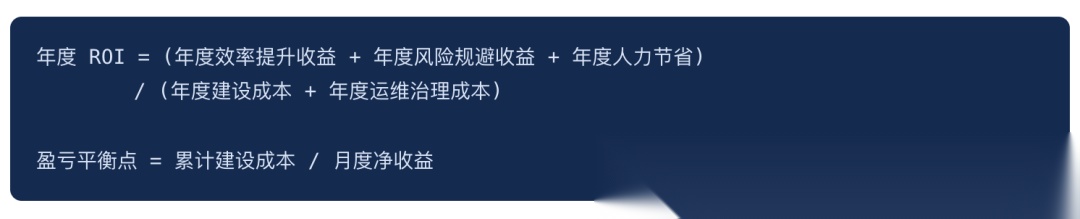
根据公开案例和我们的实践经验,中等规模企业(500-2000 人)的知识图谱项目,典型盈亏平衡点在 8-14 个月。如果超过 18 个月还没看到回报,大概率是选型过重或场景不对。
五、高性能轻量级模式:中小团队的首选
5.1 什么时候不需要重型图数据库?
不是所有知识图谱都需要上分布式集群。在以下场景,重型图数据库我认为是过度设计:
- 实体规模在 100 万以下、关系在 500 万以下
- 查询以点查和 2-3 跳遍历为主,不需要全图算法
- 团队没有专职图数据库运维人员
- 项目处于 POC 或早期验证阶段
- 数据可以放在单机内存中(通常 16GB 内存可容纳千万级节点)
对于这些场景,嵌入式图存储 + 内存图计算是性价比极高的选择。
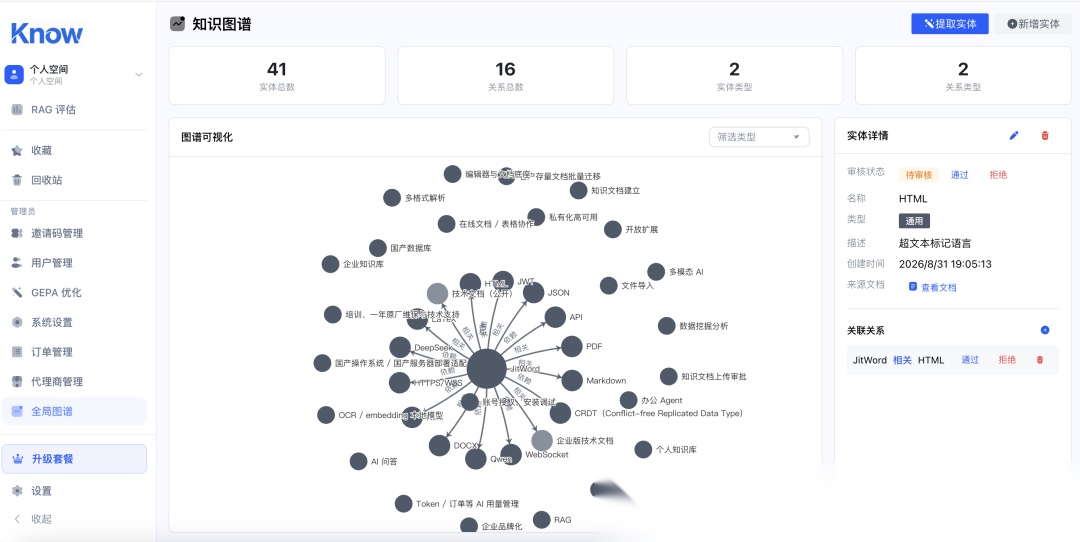
我们 JitKnow AI 知识库前期也是采用的这种模式,效果还不错,给大家分享一下:
5.2 嵌入式轻量方案盘点
方案一:NetworkX + SQLite(最轻量也最可靠)
NetworkX 是 Python 生态最成熟的图算法库,纯内存操作,API 友好。配合 SQLite 做持久化,可以覆盖绝大多数中小规模场景。
import networkx as nxG = nx.DiGraph()G.add_node("张三", type="Person", age=35)G.add_node("阿里巴巴", type="Company")G.add_edge("张三", "阿里巴巴", relation="worksAt", since=2020)# 2跳查询for neighbor in G.neighbors("张三"): for n2 in G.neighbors(neighbor): print(n2)
优点:零依赖、零运维、图算法丰富(最短路径、中心性、社区发现全有)、开发速度极快。
局限:纯内存,不支持并发写入,数据量超过内存后性能急剧下降,不适合多用户在线查询。
方案二:LeanGraph / GrafitoDB(SQLite + Cypher)
这是 2025-2026 年涌现的新一代嵌入式图数据库,核心思路是用 SQLite 做存储引擎,上层实现完整的 Cypher 查询支持。
下面我画了一张原理流程图,大家可以参考一下:
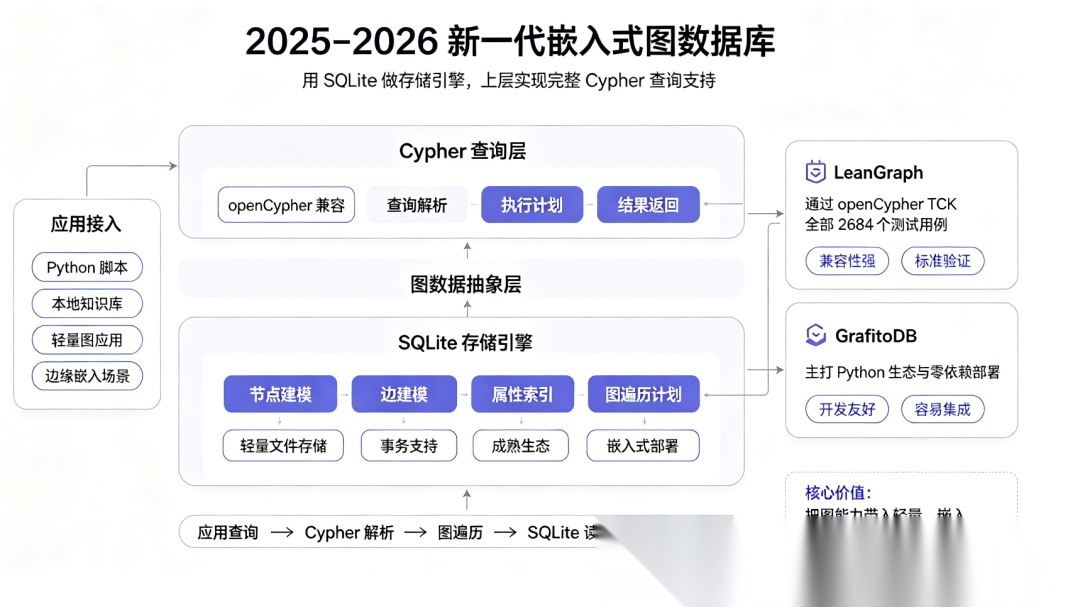
LeanGraph 宣称通过了 openCypher TCK 全部 2684 个测试用例,GrafitoDB 则主打 Python 生态和零依赖部署。
下面客观的分享一下这个方案的优缺点,供大家参考:
优点:嵌入式部署(一个文件就是一个数据库)、支持 Cypher 查询、ACID 事务、零运维。
局限:项目较新,生态不成熟,大规模性能未经充分验证,不支持分布式。
方案三:LightRAG(香港大学开源的轻量 GraphRAG)
LightRAG 是香港大学团队开源的轻量级 GraphRAG 框架,定位是"Microsoft GraphRAG 的轻量替代品"。它默认使用 NetworkX 做图存储、NanoVectorDB 做向量存储,全部可以本地运行,也支持切换到 Neo4j / PGVector / Milvus 等后端。
下面是我画的架构图,可以参考一下:
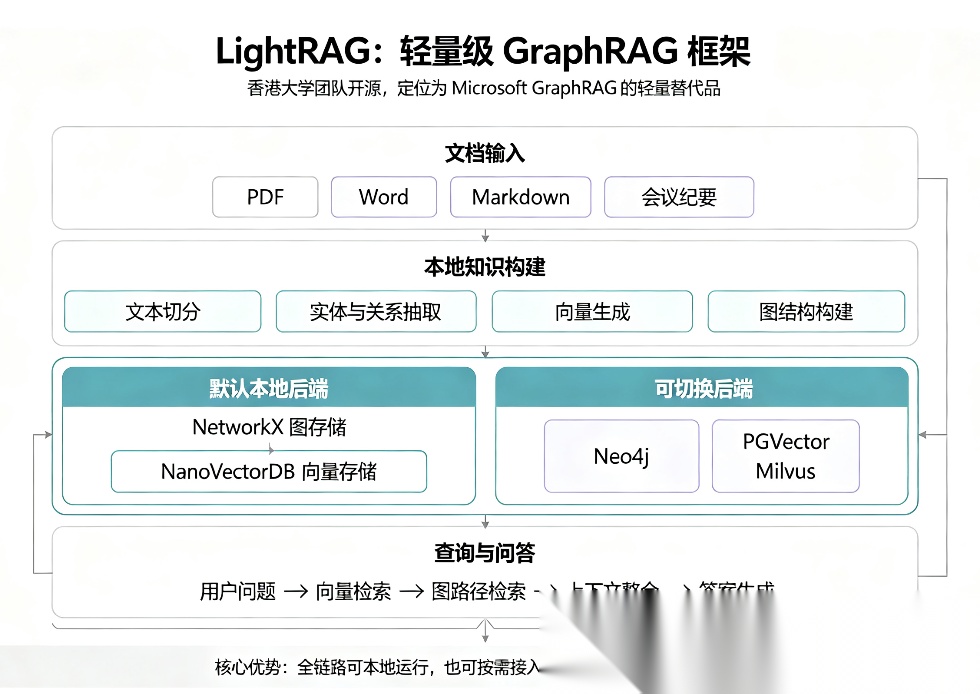
LightRAG 的核心设计哲学是**“轻量、高效、灵活、易用”**:资源消耗低、部署门槛低、支持增量更新,目前已达到生产级稳定状态。对于中小团队做知识库问答,这是我们最推荐的起点。
方案四:Memgraph(内存级图数据库,轻量但不嵌入式)
Memgraph 用 C++ 编写,纯内存架构,亚毫秒级多跳遍历延迟,支持 Cypher,Docker 一键启动。它比 Neo4j 轻量得多(内存占用约为 Neo4j 的 1/3),但性能更强,特别适合实时图查询场景。
5.3 混合架构:向量库 + 轻量图的最佳实践
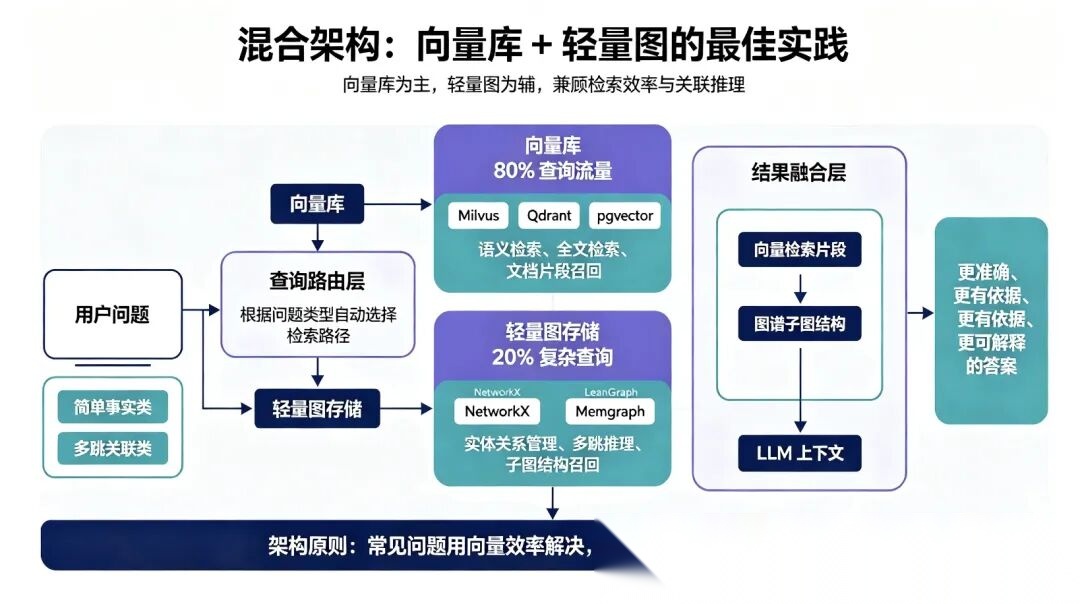
我们推荐的中小团队知识图谱架构是**“向量库为主、轻量图为辅”**的混合模式:
-
向量库
(Milvus / Qdrant / pgvector)负责语义检索和全文检索,承载 80% 的查询流量
-
轻量图存储
(NetworkX / LeanGraph / Memgraph)负责实体关系管理和多跳推理,承载 20% 的复杂关联查询
-
查询路由层
根据问题类型自动选择检索路径——简单事实类问题走向量,多跳关联类问题走图谱
-
结果融合层
向量检索的文档片段 + 图谱检索的子图结构,一起作为上下文喂给 LLM
这种架构的好处是:既享受了向量检索的成熟生态,又获得了图谱的结构化推理能力,同时避免了重型图数据库的运维负担。
由于篇幅原因,我暂时分享到这里,大家可以消化研究一下。还有很多高价值的落地实践,比如:
- 成熟开源方案全景对比
1.1 重型分布式:NebulaGraph / JanusGraph / HugeGraph
1.2 单机原生:Neo4j Community / Memgraph
1.3 RDF / 语义网:Apache Jena / RDF4J / Blazegraph
1.4 新型方案:TypeDB / Dgraph / FalkorDB
1.5 全景对比表
- LLM + KG 融合:GraphRAG 的新范式
2.1 Microsoft GraphRAG:"局部-全局"分层架构
2.2 LightRAG:轻量化路线
2.3 我们的判断:KG 不是替代向量,而是补全结构
学AI大模型的正确顺序,千万不要搞错了
🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!
有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!
就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋
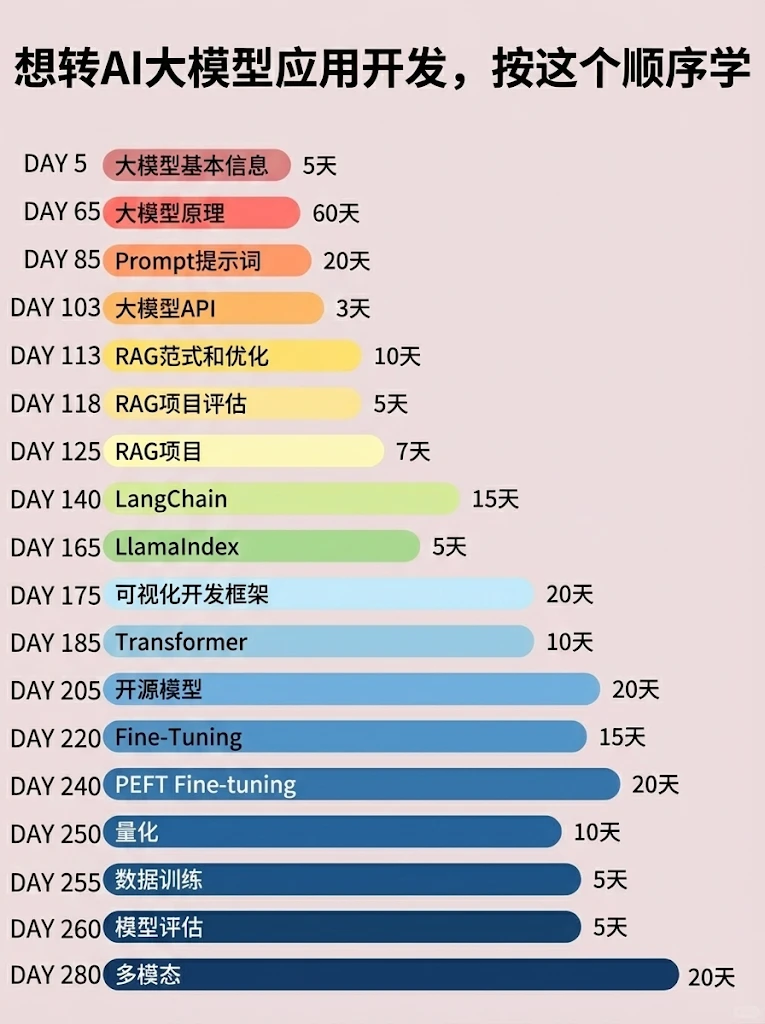
📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇
学习路线:
✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经
以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!
我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】


Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 2
 0
- 0


 已为社区贡献228条内容

所有评论(0)