90%的人认为RAG和Agent分开做都不难,合在一起就废?可写简历:RAG+Agent合体全链路方案
RAG和Agent,你是不是分开做的?
RAG就是检索+生成,Agent就是大模型+工具调用,各玩各的。但真要做一个能用的知识库问答Agent,问题就来了:Agent怎么知道什么时候该检索知识库?检索结果怎么传给Agent的推理上下文?多轮对话中用户追问,怎么保证检索的是最新上下文而不是第一句话?
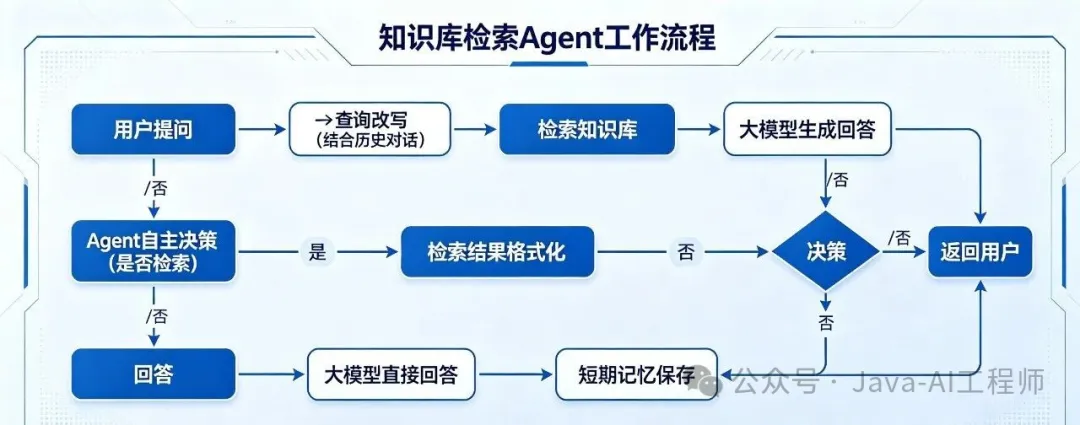
很多人的做法是硬拼接:用户提问→检索→把检索结果塞到Prompt里→调用大模型。这不是Agent,这是带检索的ChatGPT。真正的检索Agent,应该是Agent自主决策——判断需不需要检索、检索什么、检索结果怎么用,而不是每次都无脑检索。
今天我们用Java实现一个完整的知识库检索Agent,包含检索工具封装、Agent自主决策检索、多轮上下文检索、记忆系统集成,全链路可运行,做完直接写进简历。
本文属于Java+AI Agent落地系列,之前讲了多Agent协作和SpringBoot整合大模型,检索Agent是这些能力的综合应用。
一、检索Agent的核心架构
检索Agent和普通RAG的本质区别是:检索是Agent的一个工具,由Agent自主决定何时调用,而不是每次都强制检索。
核心四个组件:
1. 检索工具(RetrievalTool)
封装向量检索能力,作为Agent的一个工具。Agent通过Function Calling决定是否调用这个工具,传入查询词,返回检索结果。
2. Agent推理引擎
大模型根据用户问题,自主判断:这个问题需要检索知识库吗?如果需要,调用检索工具;如果不需要(比如闲聊、常识问题),直接回答。
3. 上下文管理器
多轮对话中,用户追问时,把历史对话和当前问题一起做查询改写,生成更准确的检索查询词,而不是直接用当前问题检索。
4. 记忆系统
短期记忆保存对话历史,长期记忆保存用户偏好和重要事实,检索时结合记忆上下文,提高检索准确率。
核心判断:普通RAG是"先检索后生成"的固定流水线,检索Agent是"Agent自主决策是否检索"的智能系统。前者简单但不灵活,后者复杂但体验更好。生产环境根据业务场景选择:FAQ类固定问答用普通RAG就行,开放式对话用检索Agent。
二、Java完整实现
1. 检索工具封装(Function Calling工具)
package com.aiproject.ragagent.tools;

import com.aiproject.ragagent.service.VectorSearchService;
import org.springframework.stereotype.Component;

import javax.annotation.Resource;
import java.util.List;
import java.util.Map;

/**
 * 知识库检索工具
 * 作为Agent的Function Calling工具,由Agent自主决定是否调用
 */
@Component
public class KnowledgeBaseRetrievalTool {

    @Resource
    private VectorSearchService vectorSearchService;

    /**
     * 工具名称(大模型通过这个名字识别工具)
     */
    public static final String TOOL_NAME = "search_knowledge_base";

    /**
     * 工具描述(大模型根据描述决定是否调用,写清楚适用场景)
     */
    public static final String TOOL_DESCRIPTION = """
            搜索企业知识库,获取相关的政策、制度、技术文档等信息。
            当用户询问公司内部政策、规章制度、技术文档、业务流程等需要内部知识的问题时调用。
            不要用于回答常识问题、闲聊、数学计算等不需要内部知识的问题。
            参数:query - 搜索查询词,字符串类型
            """;

    /**
     * 执行检索
     * @param query 搜索查询词
     * @return 检索结果(格式化后的文本,供大模型阅读)
     */
    public String execute(String query) {
        // 调用向量检索服务
        List<Map<String, Object>> results = vectorSearchService.search(query, 5);

        if (results == null || results.isEmpty()) {
            return "知识库中未找到相关内容。";
        }

        // 格式化为大模型易读的文本
        StringBuilder sb = new StringBuilder("知识库检索结果:\n");
        for (int i = 0; i < results.size(); i++) {
            Map<String, Object> doc = results.get(i);
            sb.append("[").append(i + 1).append("] ")
                    .append(doc.get("title")).append("\n")
                    .append(doc.get("content")).append("\n\n");
        }
        return sb.toString();
    }
}
2. 查询改写(多轮上下文检索的关键)
package com.aiproject.ragagent.service;

import com.alibaba.fastjson2.JSON;
import com.alibaba.fastjson2.JSONArray;
import com.alibaba.fastjson2.JSONObject;
import okhttp3.*;
import org.springframework.beans.factory.annotation.Value;
import org.springframework.stereotype.Service;

import java.io.IOException;
import java.util.List;
import java.util.concurrent.TimeUnit;

/**
 * 查询改写服务
 * 多轮对话中,把历史对话和当前问题一起交给大模型,生成更准确的检索查询词
 *
 * 为什么需要:用户第一句问"年假怎么休",第二句追问"那病假呢",
 * 直接用"那病假呢"检索,召回效果很差。
 * 查询改写会把它改成"公司病假政策规定",检索准确率大幅提升。
 */
@Service
public class QueryRewriteService {

    @Value("${llm.api-key}")
    private String apiKey;

    @Value("${llm.base-url}")
    private String baseUrl;

    private final OkHttpClient client = new OkHttpClient.Builder()
            .connectTimeout(10, TimeUnit.SECONDS)
            .readTimeout(30, TimeUnit.SECONDS)
            .build();

    /**
     * 改写查询词
     * @param currentQuestion 当前用户问题
     * @param history 历史对话(最近3-5轮)
     * @return 改写后的查询词
     */
    public String rewrite(String currentQuestion, List<String> history) throws IOException {
        // 只有一轮对话时不需要改写
        if (history == null || history.isEmpty()) {
            return currentQuestion;
        }

        String historyText = String.join("\n", history);

        String prompt = """
                你是一个查询改写专家。根据对话历史和当前问题,生成一个适合用于知识库检索的查询词。

                要求:
                1. 结合上下文,把指代不明的问题补全(如"那病假呢"→"公司病假政策")
                2. 提取核心关键词,去掉语气词、客套话
                3. 输出一个查询词,不要输出解释,不要输出多个
                4. 如果当前问题不需要检索(如闲聊、常识),输出"NO_RETRIEVAL"

                对话历史:
                %s

                当前问题:%s

                改写后的查询词:
                """.formatted(historyText, currentQuestion);

        String result = callLlm(prompt).trim();
        // 如果大模型判断不需要检索,返回标记
        if (result.contains("NO_RETRIEVAL")) {
            return null;
        }
        return result;
    }

    private String callLlm(String prompt) throws IOException {
        JSONObject requestBody = new JSONObject();
        requestBody.put("model", "qwen-turbo");
        requestBody.put("messages", JSONArray.of(
                JSONObject.of("role", "user", "content", prompt)
        ));
        requestBody.put("temperature", 0.1);

        Request request = new Request.Builder()
                .url(baseUrl + "/chat/completions")
                .addHeader("Authorization", "Bearer " + apiKey)
                .addHeader("Content-Type", "application/json")
                .post(RequestBody.create(requestBody.toJSONString(),
                        MediaType.parse("application/json")))
                .build();

        try (Response response = client.newCall(request).execute()) {
            return JSON.parseObject(response.body().string())
                    .getJSONArray("choices")
                    .getJSONObject(0)
                    .getJSONObject("message")
                    .getString("content");
        }
    }
}
3. 检索Agent核心(自主决策是否检索)
package com.aiproject.ragagent.agent;

import com.aiproject.ragagent.memory.ShortTermMemory;
import com.aiproject.ragagent.service.QueryRewriteService;
import com.aiproject.ragagent.tools.KnowledgeBaseRetrievalTool;
import com.alibaba.fastjson2.JSON;
import com.alibaba.fastjson2.JSONArray;
import com.alibaba.fastjson2.JSONObject;
import okhttp3.*;
import org.springframework.beans.factory.annotation.Value;
import org.springframework.stereotype.Service;

import javax.annotation.Resource;
import java.io.IOException;
import java.util.ArrayList;
import java.util.List;
import java.util.concurrent.TimeUnit;

/**
 * 知识库检索Agent
 * 核心:Agent通过Function Calling自主决定是否检索知识库
 * 不是每次都检索,而是根据问题判断需不需要内部知识
 */
@Service
public class RetrievalAgent {

    @Value("${llm.api-key}")
    private String apiKey;

    @Value("${llm.base-url}")
    private String baseUrl;

    @Resource
    private KnowledgeBaseRetrievalTool retrievalTool;

    @Resource
    private QueryRewriteService queryRewriteService;

    private final OkHttpClient client = new OkHttpClient.Builder()
            .connectTimeout(10, TimeUnit.SECONDS)
            .readTimeout(60, TimeUnit.SECONDS)
            .build();

    // 最大工具调用轮次,防止无限循环
    private static final int MAX_TOOL_CALLS = 3;

    /**
     * Agent对话入口
     * @param question 用户问题
     * @param sessionId 会话ID(用于记忆)
     * @return Agent回答
     */
    public String chat(String question, String sessionId) throws Exception {
        // 1. 获取或创建短期记忆
        ShortTermMemory memory = MemoryManager.getMemory(sessionId);

        // 2. 查询改写(多轮上下文)
        List<String> history = memory.getRecentMessages(3);
        String rewrittenQuery = queryRewriteService.rewrite(question, history);

        // 3. 构建消息列表
        List<JSONObject> messages = new ArrayList<>();
        messages.add(JSONObject.of("role", "system", "content", buildSystemPrompt()));
        // 加入历史对话
        messages.addAll(memory.buildMessageList());
        messages.add(JSONObject.of("role", "user", "content", question));

        // 4. Agent循环:大模型推理→可能调用工具→把结果回传→继续推理
        for (int round = 0; round < MAX_TOOL_CALLS; round++) {
            // 4.1 调用大模型(带工具定义)
            String responseJson = callLlmWithTools(messages);
            JSONObject message = JSON.parseObject(responseJson)
                    .getJSONArray("choices")
                    .getJSONObject(0)
                    .getJSONObject("message");

            // 4.2 判断大模型是否要调用工具
            JSONArray toolCalls = message.getJSONArray("tool_calls");
            if (toolCalls == null || toolCalls.isEmpty()) {
                // 没有工具调用,说明Agent已经给出最终答案
                String answer = message.getString("content");
                // 保存到记忆
                memory.addUserMessage(question);
                memory.addAssistantMessage(answer);
                return answer;
            }

            // 4.3 有工具调用,先把assistant消息加入历史
            messages.add(message);

            // 4.4 执行工具调用(这里只有检索工具,实际可以有多个)
            for (int i = 0; i < toolCalls.size(); i++) {
                JSONObject toolCall = toolCalls.getJSONObject(i);
                String toolName = toolCall.getJSONObject("function").getString("name");
                String arguments = toolCall.getJSONObject("function").getString("arguments");
                String toolCallId = toolCall.getString("id");

                String toolResult;
                if (KnowledgeBaseRetrievalTool.TOOL_NAME.equals(toolName)) {
                    // 解析查询词,用改写后的查询词检索
                    String query = JSON.parseObject(arguments).getString("query");
                    if (rewrittenQuery != null) {
                        query = rewrittenQuery;  // 用改写后的更准确
                    }
                    toolResult = retrievalTool.execute(query);
                } else {
                    toolResult = "未知工具: " + toolName;
                }

                // 把工具结果加入消息(role=tool)
                messages.add(JSONObject.of(
                        "role", "tool",
                        "tool_call_id", toolCallId,
                        "content", toolResult
                ));
            }
            // 回到循环开头,大模型根据工具结果继续推理
        }

        // 达到最大轮次,返回兜底回答
        return "抱歉,问题处理复杂度超出能力,请简化问题后重试。";
    }

    /**
     * 系统Prompt:定义Agent角色和行为规范
     */
    private String buildSystemPrompt() {
        return """
                你是企业智能客服助手,负责回答员工关于公司政策、制度、技术文档的问题。

                行为规范:
                1. 对于需要内部知识的问题(政策、制度、业务流程),先调用search_knowledge_base工具检索知识库,再根据检索结果回答
                2. 对于常识问题、闲聊、数学计算,不需要检索,直接回答
                3. 检索结果中没有相关内容时,明确告知"暂无相关信息",不要编造
                4. 回答要简洁准确,引用检索结果时标注来源
                5. 不确定的内容要说明,不要猜测
                """;
    }

    /**
     * 调用大模型(带Function Calling工具定义)
     */
    private String callLlmWithTools(List<JSONObject> messages) throws IOException {
        // 构建工具定义
        JSONArray tools = new JSONArray();
        tools.add(JSONObject.of(
                "type", "function",
                "function", JSONObject.of(
                        "name", KnowledgeBaseRetrievalTool.TOOL_NAME,
                        "description", KnowledgeBaseRetrievalTool.TOOL_DESCRIPTION,
                        "parameters", JSONObject.of(
                                "type", "object",
                                "properties", JSONObject.of(
                                        "query", JSONObject.of(
                                                "type", "string",
                                                "description", "搜索查询词"
                                        )
                                ),
                                "required", JSONArray.of("query")
                        )
                )
        ));

        JSONObject requestBody = new JSONObject();
        requestBody.put("model", "qwen-turbo");
        requestBody.put("messages", messages);
        requestBody.put("tools", tools);
        requestBody.put("tool_choice", "auto");
        requestBody.put("temperature", 0.3);

        Request request = new Request.Builder()
                .url(baseUrl + "/chat/completions")
                .addHeader("Authorization", "Bearer " + apiKey)
                .addHeader("Content-Type", "application/json")
                .post(RequestBody.create(requestBody.toJSONString(),
                        MediaType.parse("application/json")))
                .build();

        try (Response response = client.newCall(request).execute()) {
            return response.body().string();
        }
    }
}
4. 记忆管理器(会话级短期记忆)
package com.aiproject.ragagent.memory;

import java.util.Map;
import java.util.concurrent.ConcurrentHashMap;

/**
 * 记忆管理器:管理每个会话的短期记忆
 * 生产环境用Redis存储,这里用内存Map演示
 */
public class MemoryManager {

    // key: sessionId, value: 短期记忆
    private static final Map<String, ShortTermMemory> memories = new ConcurrentHashMap<>();

    public static ShortTermMemory getMemory(String sessionId) {
        return memories.computeIfAbsent(sessionId, k -> new ShortTermMemory());
    }

    public static void removeMemory(String sessionId) {
        memories.remove(sessionId);
    }
}
package com.aiproject.ragagent.memory;

import com.alibaba.fastjson2.JSONObject;

import java.util.ArrayDeque;
import java.util.ArrayList;
import java.util.Deque;
import java.util.List;

/**
 * 短期记忆:保存最近N轮对话
 */
public class ShortTermMemory {

    private static final int MAX_ROUNDS = 6;
    private final Deque<Message> history = new ArrayDeque<>();

    public void addUserMessage(String content) {
        history.offerLast(new Message("user", content));
        while (history.size() > MAX_ROUNDS * 2) {
            history.pollFirst();
        }
    }

    public void addAssistantMessage(String content) {
        history.offerLast(new Message("assistant", content));
        while (history.size() > MAX_ROUNDS * 2) {
            history.pollFirst();
        }
    }

    /**
     * 获取最近N条消息的文本(用于查询改写)
     */
    public List<String> getRecentMessages(int n) {
        List<String> result = new ArrayList<>();
        int count = 0;
        for (Message msg : history) {
            if (count >= n * 2) break;
            result.add(msg.role() + ": " + msg.content());
            count++;
        }
        return result;
    }

    /**
     * 构建大模型消息列表
     */
    public List<JSONObject> buildMessageList() {
        List<JSONObject> messages = new ArrayList<>();
        for (Message msg : history) {
            messages.add(JSONObject.of("role", msg.role(), "content", msg.content()));
        }
        return messages;
    }

    public record Message(String role, String content) {}
}
三、生产落地最佳实践
1. 检索不是必须的,让Agent自主决策
不要每次都检索,常识问题、闲聊不需要检索,强制检索反而会引入无关内容干扰回答。让Agent通过Function Calling自主判断,检索准确率和回答质量都会提升。
2. 查询改写是多轮检索的关键
用户追问时直接用当前问题检索,效果很差。一定要做查询改写,把历史上下文和当前问题结合,生成完整的查询词。这一步能把检索准确率提升30%以上。
3. 检索结果要做相关性过滤
向量检索返回的TopK结果,不一定都相关。设置相似度阈值,低于阈值的结果不要传给大模型,否则会引入噪声,导致回答跑偏。
4. 工具调用轮次要有上限
Agent可能反复调用工具陷入循环,设置最大轮次(建议3次),超过就返回兜底回答。同时记录每次工具调用的输入输出,排查问题用。
5. 记忆和检索要结合
短期记忆保存对话历史,用于查询改写和上下文连贯;长期记忆保存用户偏好,用于个性化检索。两者结合,检索Agent的体验才会好。
四、生产踩过的3个坑
- 检索结果太长,token爆炸:早期把Top5检索结果全部传给大模型,每个结果几千字,token消耗巨大。解决方式:检索结果做摘要,每个结果只保留最相关的2-3句话,总长度控制在2000字以内。
- 查询改写把问题改偏了:大模型改写查询词时,有时候会过度解读,把简单问题改复杂,反而检索不到。解决方式:查询改写用低温(0.1),Prompt里明确要求"只补全指代,不改变原意",同时保留原始问题作为备选。
- Agent反复调用检索工具:Agent第一次检索结果不满意,又调用第二次,反复循环。解决方式:最大轮次限制+检索结果缓存,相同查询词的检索结果缓存1小时,避免重复检索。同时在系统Prompt里明确"检索一次即可,不要反复检索"。
📦 落地资源推荐
跑检索Agent和向量数据库,推荐阿里云轻量应用服务器,2核4G跑Milvus+SpringBoot完全够用,有部署需求点击文末「阅读原文」了解阿里云开发者特惠,无需求直接忽略。
💡 领取完整源码
关注图片上水印即Java-AI工程师,打出【agents】领取完整知识库检索Agent工程源码,包含检索工具、查询改写、Agent推理引擎、记忆系统、完整pom.xml。
下期预告
很多人朋友都焦虑是不是应该转型去做AI呢?要不要学Python?岁数大了还来不来得及去转了等等的相关问题,所以下一篇讲:Java 转 AI 最常问的 5 个问题,一次性说透(附学习路线)
本文属于「Java AI Agent实战」合集

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐
 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)