Agent实战 #04:多Agent编排引擎-五步流水线、DAG调度与工程落地(含核心源码)
Agent实战 #04:多Agent编排引擎——五步流水线、DAG调度与工程落地(含核心源码)
从单 Agent 到多 Agent 协作,核心挑战不是"让 LLM 干活",而是怎么拆、怎么调度、怎么合并、怎么兜底。本文基于 Dream-SaaS 编排引擎的实际源码,拆解一套生产级多 Agent 编排方案——有架构图,也有核心 Java 代码。
CSDN 标签建议:多Agent编排 DAG调度 LLM任务分解 Java架构 Spring AI 人机协作
导读:本文从源码层面拆解一个生产级多 Agent 编排引擎,覆盖五步流水线(分解→路由→DAG调度→合并→持久化)、三级降级策略、轮询拓扑排序、四种合并策略、SPI 零配置接入、输出质量双防线、两层 HITL 等核心设计。适合有 Java 基础、正在或准备落地多 Agent 系统的工程师阅读。
一、单 Agent 不够用的时刻
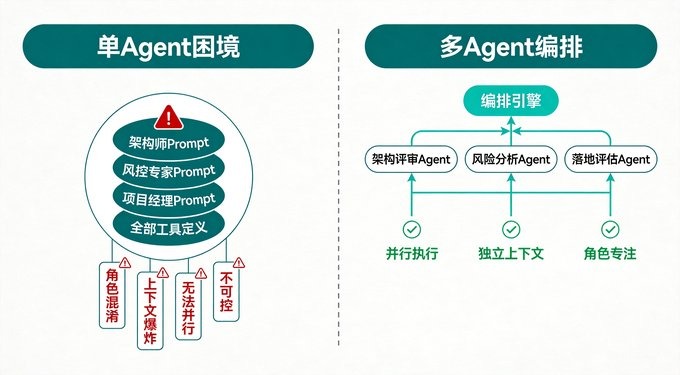
一个 ReAct Agent 能搞定大部分单步任务:查 RAG、调工具、生成回答。但当你面对这样的需求时——
"帮我评审这个技术方案,从架构合理性、风险点、落地可行性三个角度分别给意见,最后合成一份综合评审报告"
单 Agent 的问题就暴露了,如上图所示:
- 角色混淆:一个 Prompt 同时扮演架构师、风控专家、项目经理,每个角色都浅尝辄止
- 上下文爆炸:三个角色的 system prompt + 工具定义 + 中间结果,塞进一个上下文窗口,模型注意力被稀释
- 无法并行:三个角色本可以同时工作,串行执行白白浪费时间
- 不可控:没有中间状态、没有 checkpoint、没有人工审批的入口
这些问题的本质是:编排问题不应该用 Prompt 工程来解决。需要一个专门的编排层——负责任务拆解、Agent 调度、结果合并、异常兜底。
二、架构定位:Supervisor 和 Orchestrator 的边界
很多文章把"路由"和"编排"混为一谈,但在实际工程中,这两件事的职责边界必须清晰:
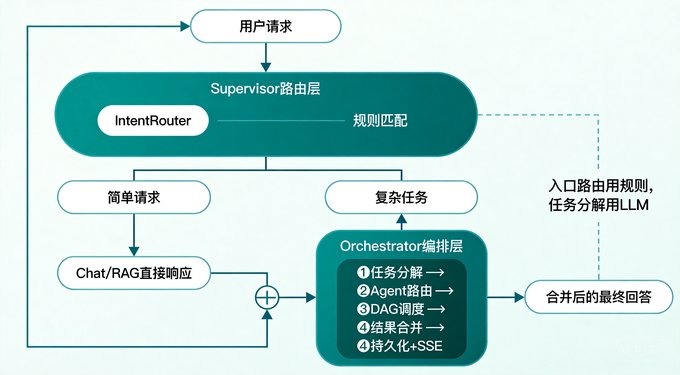
如上图所示,整个请求处理分为两层:
Supervisor 路由层(左侧):解决"这条请求该走哪条路"。通过 IntentRouterNode 做条件边路由,简单请求(闲聊、单步查询)直接走 Chat/RAG,只有复杂任务才进入 Orchestrator。入口路由用规则匹配,不用 LLM 动态路由——延迟低、行为可控、在高频入口场景下更稳定。
Orchestrator 编排层(右侧):解决"这条请求怎么拆、怎么并行、怎么合并"。进入编排层后才交给 LLM 做任务分解——分解比路由更适合 LLM,因为分解需要理解语义和依赖关系。
| 维度 | Supervisor(路由层) | Orchestrator(编排层) |
|---|---|---|
| 核心问题 | 这条请求该走哪条路? | 这条请求怎么拆、怎么并行、怎么合并? |
| 决策方式 | 规则/启发式 | LLM 任务分解 + DAG 调度 |
| 复杂度 | 低 | 高(容错+持久化+可观测) |
两者通过 OrchestrateRouteNode 桥接。
三、五步流水线:一次编排请求的完整生命周期
编排引擎的核心流程可以拆解为五步。理解这五步,就理解了整个编排引擎:
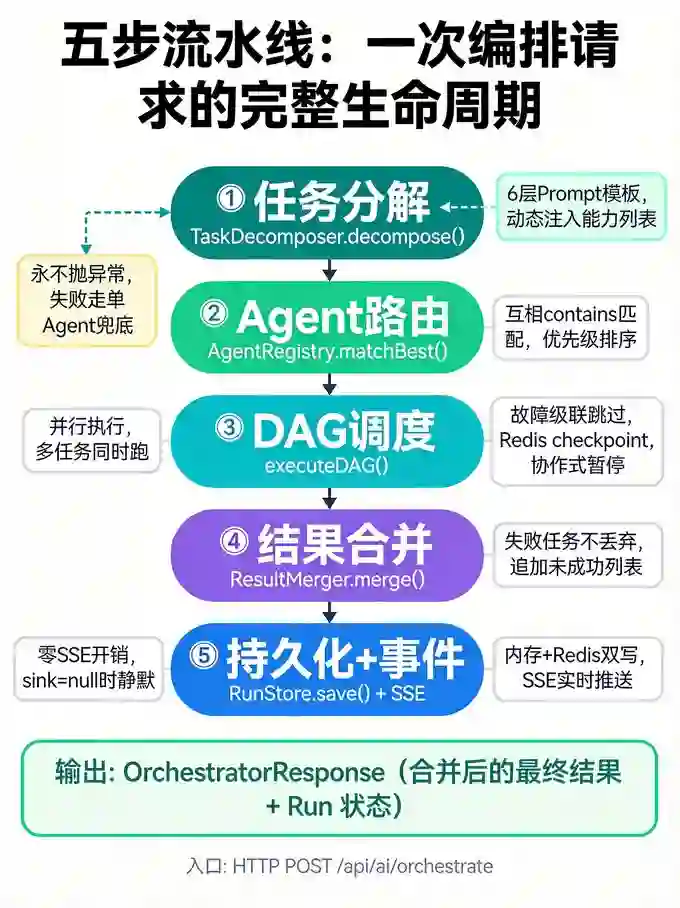
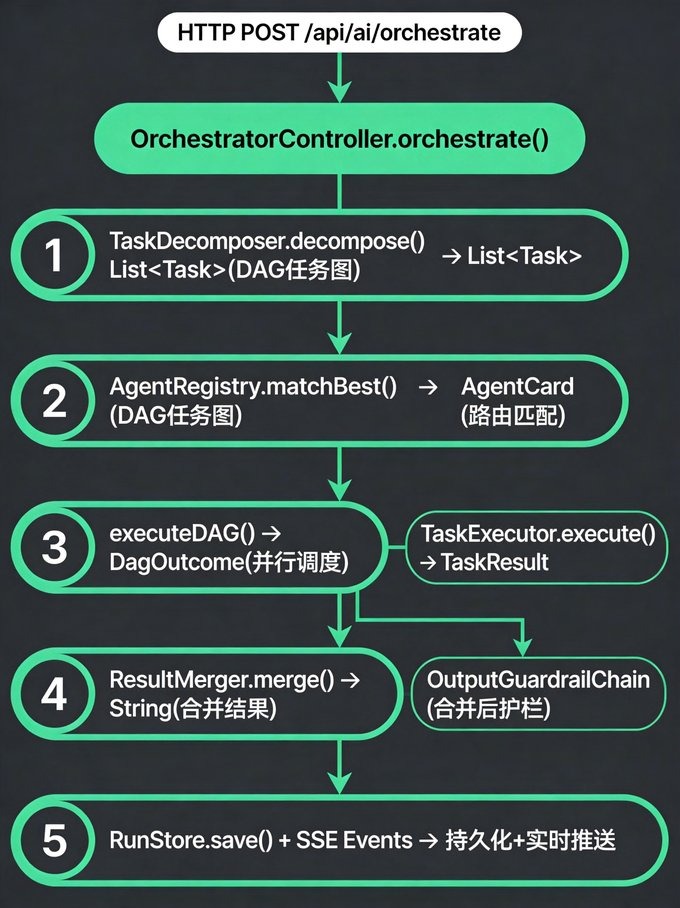
① 任务分解:LLM 拆任务,失败就降级
TaskDecomposer 把用户请求 + 可用 Agent 能力列表喂给 LLM,让它输出一个带依赖关系的 JSON 任务数组(DAG)。
核心设计原则:分解器永远不向上抛异常。 三级降级策略保证编排永不因 LLM 抽风而 500:
- LLM 返回空数组 → 任务简单无需拆解,走单 Agent 兜底
- JSON 解析失败 → 同上,走兜底
- LLM 调用异常 → catch 后返回空列表,走兜底
源码中,这个设计原则直接体现在 catch 块的返回值上:
@Component
public class TaskDecomposer {
    public List<Task> decompose(String userRequest, Set<String> capabilities, ...) {
        String systemPrompt = OrchestratorDecomposePromptBuilder.assembleSystemPrompt(capabilities);
        String userMessage = buildUserMessage(userRequest, decomposeHint, maxTasks);
        try {
            String response = chatClient.prompt()
                    .system(systemPrompt).user(userMessage).call().content();
            return parseTasks(response);  // 容忍 markdown 围栏,提取 JSON 数组
        } catch (Exception e) {
            log.error("[TaskDecomposer] decomposition failed: {}", e.getMessage(), e);
            return List.of();  // ★ 核心:失败不抛异常,返回空列表走 Fallback
        }
    }
}
这个 try-catch 是整个降级链的最后一道保险——LLM 超时、限流、返回乱码,都不会导致整个请求 500。parseTasks 内部还会做 JSON 容错(剥离 markdown 围栏、截取 [...] 数组片段),解析失败同样返回空列表。
分解 Prompt 不是随便写的一段话,而是通过 OrchestratorDecomposePromptBuilder 按 6 层标准组装:Role → CanDo → CannotDo → InteractionRules → SafetySupplement → ContextBlock。其中 L6 的可用能力列表是运行时从 AgentRegistry.allCapabilities() 动态注入的——Registry 注册了哪些 Agent,分解器就只能用哪些能力标签,从 Prompt 层面杜绝了 LLM 编造不存在的能力。
② Agent 路由:关键词模糊匹配
AgentRegistry 维护所有 Agent 的能力卡片(AgentCard),路由时用互相 contains 做模糊匹配——capability 标签 "政策" 可以匹配到关键词 "退换货政策",多关键词场景天然加权。
// AgentRegistry.matchBest() — 模糊匹配,关键词计数最大者胜
public Optional<AgentCard> matchBest(List<String> keywords, Collection<String> allowedAgentNames) {
    return agents.values().stream()
            .filter(card -> allowedAgentNames.isEmpty() || allowedAgentNames.contains(card.name()))
            .max(Comparator.comparingInt(a -> (int) keywords.stream()
                    .filter(k -> a.capabilities().stream()
                            .anyMatch(c -> c.contains(k) || k.contains(c)))  // ★ 互相包含
                    .count()));
}
为什么用互相 contains 而不是精确匹配?因为 LLM 生成的 capability 标签不需要和 Registry 完全一致——"政策" 能匹配 "退换货政策" 提高了路由容错性。代价是 capability 设计时要尽量互斥清晰,避免误匹配。
③ DAG 调度:并行执行 + 故障级联 + Checkpoint
这是编排引擎最核心的部分。没有用传统的"建执行树"方式,而是采用轮询拓扑排序——每一轮扫描所有未完成任务,挑出"依赖都已满足"的就绪任务,通过 CompletableFuture.supplyAsync() 并行执行。
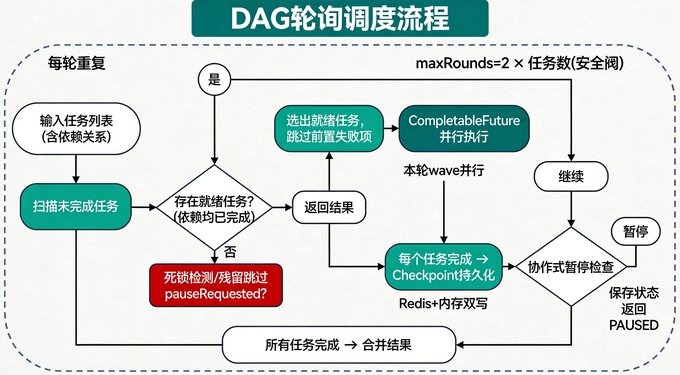
如上图所示,调度核心是一个循环:每轮扫描就绪任务 → 并行执行 → Checkpoint 持久化 → 检查暂停标志 → 回到扫描。循环设有安全阀(maxRounds = 2×任务数),防止依赖环导致死锁。
executeDAG() 是整个编排引擎最精妙的方法,看它的核心循环:
// OrchestratorService.executeDAG() — 轮询拓扑排序核心循环
private DagOutcome executeDAG(List<Task> tasks, String runId, ...) {
    DagState state = DagState.fromPrior(priorResults);
    int maxRounds = tasks.size() * 2;  // ★ 安全阀,防死锁

    while (state.remaining(tasks) && round < maxRounds) {
        // ① 协作式暂停检查
        if (pauseRequested.get(runId)) {
            checkpoint(snapshot, state.allResults, pendingIds(...));
            return new DagOutcome(state.allResults, pending, true);
        }

        // ② 选就绪任务:依赖均已 completed/skipped,且自身未结束
        List<Task> ready = selectReadyTasks(tasks, state);
        if (ready.isEmpty()) { break; }  // 无就绪任务 = 死锁

        // ③ 前置任务失败的 ready 项直接标 SKIPPED(故障级联)
        List<Task> toRun = skipFailedDependencies(ready, tasks, ...);

        // ④ 本轮 CompletableFuture 并行执行
        runReadyWave(toRun, tasks, runId, snapshot, state, timeoutMs, sink);
    }

    markUnreachableSkipped(tasks, state);  // ⑤ 残留任务标 SKIPPED
    checkpoint(snapshot, state.allResults, List.of());
    return new DagOutcome(state.allResults, List.of(), false);
}
三个设计细节值得展开:
🔧 故障级联:前置失败,下游自动跳过
skipped也视为"已处理",可以解锁下游依赖检查。如果 T1 失败、T2 依赖 T1,T2 会被直接跳过而不是死等。判断依据是!dep.success()——不区分 FAILURE、TIMEOUT、SKIPPED,只要不是 SUCCESS 就级联跳过。简单但有效。
// skipFailedDependencies — 前置失败直接 SKIPPED,不浪费 Agent 调用
private List<Task> skipFailedDependencies(List<Task> ready, ...) {
    List<Task> toRun = new ArrayList<>();
    for (Task task : ready) {
        boolean depFailed = task.dependencies().stream().anyMatch(depId -> {
            TaskResult dep = state.completedResults.get(depId);
            return dep != null && !dep.success();  // ★ 不区分失败类型
        });
        if (!depFailed) {
            toRun.add(task);
        } else {
            state.recordSkipped(TaskResult.skipped(task.id(), "none", "前置任务失败,跳过"));
            events.thinking(runId, "跳过任务 " + task.id() + "(前置失败)", sink);
            checkpoint(snapshot, ...);  // 每次跳过都做 checkpoint
        }
    }
    return toRun;
}
🔧 Checkpoint:每个任务完成都持久化
每个任务完成或跳过后,触发checkpoint()写入 Redis + 内存双写。resume 时从 checkpoint 还原priorResults,继续调度。有个工程权衡:toSummaries()会截断 output 以节省 Redis 存储,resume 后下游拿到的上下文可能不完整——大输出场景需要调大checkpointOutputMaxChars配置。用上下文精度换存储成本,这是有意的取舍。
🔧 协作式暂停:不是强制掐断
pause()只设标志位,不 cancel CompletableFuture。DAG 主循环在每轮开头检查标志——当前并行波结束后不再开新任务,以 PAUSED 状态返回。续跑时根据来源决定行为:从 WAITING_HITL resume 只做合并,从 PAUSED resume 继续 DAG 调度。
④ 结果合并:四种策略覆盖不同场景
| 策略 | 逻辑 | 适用场景 |
|---|---|---|
| CONCAT | 按成功列表顺序 Markdown 拼接 | 通用场景(默认) |
| VOTE | 规范化后多数票(trim+去空白+转小写分桶) | 一致性判断 |
| PRIORITY | 按白名单顺序取第一个成功者 | "风控说了算"场景 |
| SYNTHESIZE | 总览要点 + 分角色详情(确定性合成,不调 LLM) | 技术方案评审 |
看两个最有代表性的策略实现。VOTE 策略的亮点是规范化——先 trim + 合并空白 + 转小写分桶计票,但最终返回的是原文而非规范化后的字符串:
// VOTE:规范化后投票,返回原文
private String mergeVote(List<TaskResult> results) {
    Map<String, List<TaskResult>> buckets = new LinkedHashMap<>();
    for (TaskResult r : results) {
        String key = normalizeVoteKey(r.output());  // trim + 去空白 + toLowerCase
        buckets.computeIfAbsent(key, k -> new ArrayList<>()).add(r);
    }
    return buckets.entrySet().stream()
            .max(Comparator.comparingInt(e -> e.getValue().size()))
            .orElseThrow().getValue().getFirst().output();  // ★ 返回原文,非规范化版
}
SYNTHESIZE 策略用于技术方案评审——先做总览(各角色首段摘要),再输出分角色详情。它是确定性合成,不调用 LLM:
// SYNTHESIZE:总览 + 分角色详情(确定性合成,不调 LLM)
private String mergeSynthesize(List<TaskResult> results, List<String> priorityAgentNames) {
    List<TaskResult> ordered = orderByPriority(results, priorityAgentNames);
    StringBuilder sb = new StringBuilder();
    sb.append("## 综合结论\n\n");
    for (TaskResult r : ordered) {
        sb.append("- **").append(r.agentName()).append("**:")
                .append(summarize(r.output(), 160)).append("\n");
    }
    sb.append("\n## 分角色详情\n\n");
    for (TaskResult r : ordered) {
        sb.append("### ").append(r.agentName()).append("...");
        sb.append(r.output()).append("\n\n---\n\n");
    }
    return sb.toString();
}
所有策略统一行为:失败的任务在合并结果后追加"未成功任务"列表,而不是被忽略。用户看到的不只是"好结果",还有"哪些任务没跑成、为什么没跑成"。
⑤ 持久化 + SSE 事件:可观测性
OrchestratorEventPublisher 把编排生命周期节点统一转成 SSE 事件,前端可实时看到执行进度:
| 事件 | 含义 |
|---|---|
run.start | 编排开始 |
thinking | 中间状态("正在分解任务…"、"跳过任务 T3") |
tool.call | 子任务即将执行 |
tool.result | 子任务执行结束 |
message.done | 最终合并正文就绪 |
run.end | run 正常收尾(含耗时) |
run.error | run 失败 |
当 sink == null 时(同步 HTTP 路径和异步 submitAsync 路径),所有事件只打 debug 日志,零 SSE 开销。
RunStore 采用 Redis + 内存双写策略:内存必写,Redis 写失败只 warn 不抛。Redis 宕机不影响编排引擎可用性——只是 pause/resume 在多实例部署时可能跨节点丢状态。
四、Agent 接入:一个 SPI 搞定零配置
编排核与业务域之间通过 LocalAgentAdapter SPI 隔离——编排核只依赖这个接口,不反向依赖任何业务模块:
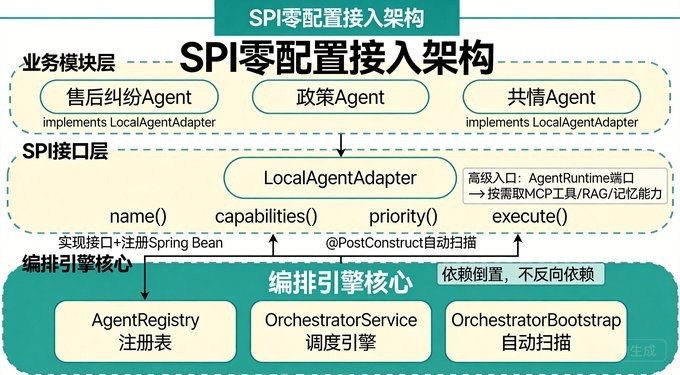
如上图所示,整个接入架构分三层:
业务模块层(顶部):每个 Agent 只需实现 LocalAgentAdapter 接口,注册为 Spring Bean 即可。
SPI 接口层(中间):LocalAgentAdapter 是编排核与业务域之间的唯一契约。编排核只依赖这个接口,不反向依赖任何业务模块。高级入口 execute(AgentInvocation, AgentRuntime) 可访问 AgentRuntime(MCP工具、RAG、记忆等能力端口),业务侧按需取能力——缺什么自己降级,编排核完全不知道也不关心。
// LocalAgentAdapter — 编排核与业务域的唯一契约
public interface LocalAgentAdapter {
    String name();                        // Registry 键
    List<String> capabilities();          // 供分解器与 matchBest 匹配
    default int priority() { return 100; } // 数值越小越高
    String execute(String input, Map<String, String> context);  // 基础入口

    // ★ 高级入口:可访问 AgentRuntime(MCP工具、RAG、记忆等能力端口)
    default String execute(AgentInvocation invocation, AgentRuntime runtime) {
        return execute(invocation.input(), invocation.context());
    }
}

// AgentRuntime — 可选能力包端口,编排核不依赖任何具体实现
@FunctionalInterface
public interface AgentRuntime {
    <T> Optional<T> capability(Class<T> type);  // 按类型取能力
    static AgentRuntime empty() { return Empty.INSTANCE; }
}编排引擎核心(底部):OrchestratorBootstrap 在 @PostConstruct 时自动扫描所有 LocalAgentAdapter Bean,写入 AgentRegistry——不需要改 Registry 代码、不需要配置文件。
// OrchestratorAgentBootstrap — 零代码接入
@PostConstruct
public void register() {
    for (LocalAgentAdapter adapter : adapters) {
        registry.register(AgentCard.of(
                adapter.name(), adapter.description(),
                adapter.capabilities(), adapter.priority()));
    }
}
以售后纠纷场景为例,三个角色 Agent(政策/共情/结案)各实现一个 Bean 就完成了接入,总共不到 30 行配置代码。技术方案评审场景的三个角色(架构/风险/落地)使用高级入口,还能注入 MCP 工具并按角色白名单裁剪工具集。
五、输出质量:两道防线
多 Agent 协作有一个隐性风险——Agent 输出不可控。比如角色 Agent 可能"学坏",把分解器的任务数组原样吐回,或者输出空数组 []。Dream-SaaS 用两道防线应对:
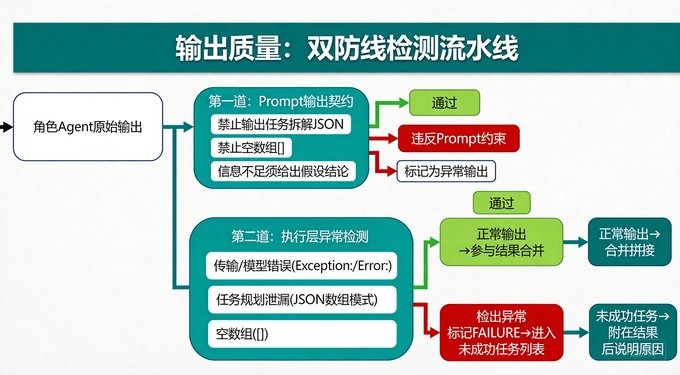
如上图所示,每个角色 Agent 的输出都要经过两道检测流水线:
第一道:Prompt 输出契约(Prompt 层)
在 system prompt 中写死输出硬约束:
- 你是执行角色,不是任务规划器
- 直接给出对本角色职责的结论/话术/清单,使用中文
- 禁止输出任务拆解 JSON(禁止 id/capabilities/dependencies 数组)
- 禁止空数组
[];信息不足时说明缺什么,并给出可执行的假设结论
第二道:执行层异常检测(代码层)
AgentOutputFailureDetector 在 TaskExecutor 中检测三类异常输出——这段代码是防止 LLM 输出"脏数据"污染下游的关键:
// AgentOutputFailureDetector — 识别不应记为 SUCCESS 的 Agent 输出
static Optional<String> detectFailure(String output) {
    // ① 传输/模型错误:输出以 Exception:/Error: 开头,含 HTTP 4xx/5xx 等
    if (looksLikeTransportOrModelFailure(output)) {
        return Optional.of(failureMessage(output));
    }
    // ② 任务规划泄漏:输出匹配 [{"id":..., "capabilities":..., "dependencies":...}]
    if (looksLikeTaskPlanLeak(output)) {
        return Optional.of("角色输出疑似任务规划 JSON(非本职结论),已标失败");
    }
    // ③ 空数组:output.equals("[]")
    return Optional.empty();
}
发现异常后标记为 FAILURE 而非 SUCCESS——下游合并时该任务不会参与结果拼接,而是出现在"未成功任务"列表中。
Prompt 约束防君子,执行检测防小人。 两道防线配合,保证进入合并环节的每个结果都是"正常输出"。
六、HITL:两层人机协作,不要混
HITL(Human-In-The-Loop)是生产级编排的必备能力——某些场景需要人工审批后才能继续。Dream-SaaS 有两层 HITL,职责完全不同:
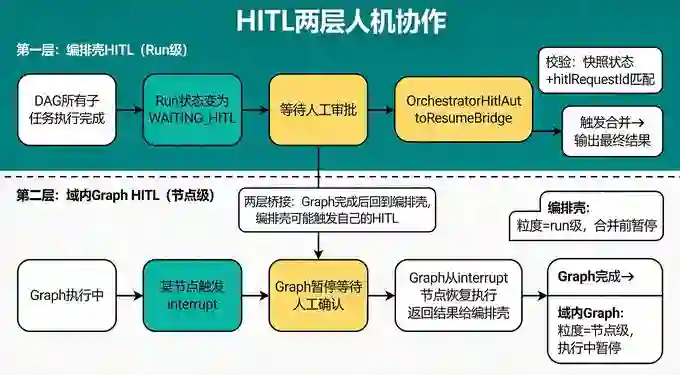
如上图所示,两层 HITL 的区别在于粒度和触发时机:
第一层:编排壳 HITL(Run 级)
- 粒度:所有子任务跑完后、合并前暂停
- 状态:RunStatus.WAITING_HITL
- 场景:售后纠纷"同意退款500元"需要人工确认后才能出最终报告
第二层:域内 Graph HITL(节点级)
- 粒度:Graph 内某个节点执行中 interrupt
- 状态:Graph 自己的恢复路径
- 场景:Graph 工作流中某个需要人工确认的审批节点
桥接机制:OrchestratorHitlAutoResumeBridge 通过监听 HitlDecisionEvent 实现自动 resume,并做了两层安全校验——快照状态必须为 WAITING_HITL,且 hitlRequestId 必须匹配(防止一个 run 的审批事件误 resume 另一个 run):
// OrchestratorHitlAutoResumeBridge — 安全校验 + 自动 resume
@EventListener
public void onHitlDecision(HitlDecisionEvent event) {
    if (!properties.isAutoResumeOnHitlApprove()) return;  // ★ 默认关闭

    String runId = event.request().sessionId();
    String requestId = event.request().requestId();

    // 校验 1:快照状态必须为 WAITING_HITL
    OrchestratorRunSnapshot snapshot = runStore.get(runId).orElse(null);
    if (snapshot == null || snapshot.getStatus() != RunStatus.WAITING_HITL) return;

    // ★ 校验 2:requestId 必须匹配,防串单
    if (!requestId.equals(snapshot.getHitlRequestId())) {
        log.warn("[OrchestratorHitl] hitlRequestId mismatch");
        return;
    }

    if (decision == HitlStatus.APPROVED) {
        orchestratorService.resume(runId);  // → finishMerge()
    }
    if (decision == HitlStatus.REJECTED) {
        orchestratorService.markFailedFromHitl(runId, "HITL rejected: " + reason);
    }
}
自动 resume 默认关闭,需要显式配置开启。
七、几个关键的工程决策
任务分解的 DAG 粒度怎么定?
LLM 做任务分解时,粒度直接影响后续所有环节。拆太细:Agent 调用次数爆炸,延迟和成本线性增长;拆太粗:退化成单 Agent 串行,编排失去意义。
Dream-SaaS 的做法是在 Prompt 中设置 maxTasks 上限(默认 4),同时让分解器看到完整的 Agent 能力列表——LLM 只能从已有能力中组合,不能凭空发明任务。如果用户请求确实简单,分解器直接返回空数组,走 SingleAgentFallback 一步到位。本质上是让 LLM 在"有约束的解空间"里做决策,而不是开放式生成。
合并策略该不该用 LLM?
直觉上,"把多个 Agent 的输出合成一份最终报告"这件事应该让 LLM 来做。但 Dream-SaaS 的四种合并策略里没有一种调用 LLM——包括看起来最像"综合"的 SYNTHESIZE,也只是确定性的摘要拼接。
这个决策背后的考量是:合并层不应该引入不可控因素。LLM 合并意味着最终输出又多了一次随机性——前面 N 个 Agent 的输出都是确定的,最后合并时 LLM 可能丢信息、改语义、甚至幻觉。SYNTHESIZE 的策略是把每个角色的首段摘要做总览,完整输出做详情,结构确定、可追溯。如果确实需要 LLM 做更深度的综合,应该作为一个新的 Agent 角色参与编排,而不是藏在合并层。
HITL 为什么默认关闭?
auto-resume-on-hitl-approve 默认 false,意味着审批通过后不会自动继续——需要手动 resume。这在开发阶段看似麻烦,但在生产环境是必要的安全边界。
考虑一个场景:售后纠纷 Agent 给出了"同意退款 500 元"的建议,编排壳触发 HITL 等待人工审批。如果自动 resume 默认开启,而审批服务配置有误(比如 requestId 映射错乱),可能导致一个 run 的审批事件意外 resume 了另一个 run——OrchestratorHitlAutoResumeBridge 的 hitlRequestId 校验是防串单的第二道保险,但第一道保险应该是"默认不自动通过"。信任是逐步建立的,不是默认开启的。
输出质量检测 vs Prompt 约束:为什么需要两道?
RoleAgentOutputContract 在 Prompt 中写了硬约束——"禁止输出任务拆解 JSON""禁止空数组"。但 Prompt 约束的本质是"请求",不是"强制"。模型在边界 case 下仍然可能违反。
所以 AgentOutputFailureDetector 在执行层做了第二道检测。这不是对 Prompt 的不信任,而是工程上的纵深防御思维——你不能假设上游的任何输出都是正确的。尤其是 LLM 的输出:它不是 API 响应,没有 schema 强制,没有类型系统保护。任何依赖 LLM 输出格式正确的代码,都应该有一个兜底的格式校验。这个原则在多 Agent 场景中更加重要——一个 Agent 的错误输出会被下一个 Agent 当作上下文输入,错误会级联放大。
八、总结
多 Agent 编排的核心不是"让多个 Agent 一起干活",而是构建一套可拆解、可调度、可容错、可观测、可审批的工程体系。Dream-SaaS 的实现路径是:
- 五步流水线:LLM 分解 → Registry 匹配 → DAG 并行调度 → 多策略合并 → 持久化 + SSE
- DAG 调度:轮询拓扑排序 + CompletableFuture 并行 + 故障级联 + Redis checkpoint
- 零配置接入:LocalAgentAdapter SPI + Bootstrap 自动扫描
- 输出质量:Prompt 硬约束 + 执行层异常检测,双防线
- 生产级能力:两层 HITL、协作式暂停、断点续跑、SSE 实时事件
从 MiniOrchestrator(已废弃的迷你版)到 OrchestratorService(产品级引擎),中间差的就是 checkpoint、SSE、HITL、输出护栏、异步受理、Agent 白名单这些"看起来不起眼但少了就挂"的工程细节:
| 能力 | MiniOrchestrator | OrchestratorService |
|---|---|---|
| DAG 调度 | ✅ 基本轮询 | ✅ + 协作式暂停 + 故障级联 |
| Checkpoint | ❌ | ✅ Redis + 内存双写 |
| SSE 事件 | ❌ | ✅ 完整事件族 |
| HITL | ❌ | ✅ 两层 + 自动 resume |
| 输出质量检测 | ❌ | ✅ AgentOutputFailureDetector |
| 多合并策略 | CONCAT only | CONCAT/VOTE/PRIORITY/SYNTHESIZE |
这就是多 Agent 编排从 demo 到生产的真实距离。
九、在线体验
上面拆解的分解、调度、合并、SSE 事件流——不是纸面设计,在 Dream-SaaS 的编排台上都能直接跑。
选一个预设模板(售后纠纷、技术方案评审、订单查询等),点运行就能看到 DAG 分解结果、每个 Agent 的执行时间线、以及最终合并输出。跟源码对着看,比读文档直观得多。
系列导航:
| 编号 | 标题 | 核心内容 |
|---|---|---|
| #00 | 从0到上线14个Agent,4C8G部署全记录 | 14个AI工具上线、极简部署、避坑清单 |
| #01 | Dream-SaaS 整体架构拆解 | 28个Java模块 + 5个独立部署App的宏观架构 |
| #02 | 一个Agent的5层工程化能力 | Code Review Agent从Demo到生产的工程细节 |
| #03 | RAG模块:从理论到工程落地 | 混合检索、分块策略、四路分数设计 |
| #04 | 多Agent协作:Supervisor DAG编排 | 任务分解→并行调度→checkpoint→HITL→Reflexion自反思 |
| #05 | 生产级Agent:可观测+评估+Guardrails | OpenTelemetry链路追踪、评估体系、输出守卫链(规划中) |
| #06 | 多模态Agent实战 | Vision LLM截图理解→Bug工单/设计Token/结构化JSON(规划中) |
关注「Java宋转AI」,持续更新中。
有问题评论区见,欢迎交流~

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 5
 0
- 0


 已为社区贡献23条内容

所有评论(0)