AI Agent智能体从入门到精通
不知你有没有发现一个挺普遍的现象:
去年大家刚接触各类大模型时,兴奋得不行,觉得各行各业都要被颠覆了。但大半年用下来,很多人手里的 AI 会员,最终沦落成了“帮我润色一下这封邮件”、“把这段会议纪要改成周报格式”的高级打字机。
为什么会这样?
说句大实话:单纯的对话式大模型,智商再高,也只是个“被关在玻璃房里的超级顾问”。
你问它一句,它答你一句。它没办法主动拿起电话帮你订机票,没办法登录公司内网把本周的销售数据导成 Excel,更没办法在半夜两点发现服务器报错时自动跑去排查修复。
上周我和一位做财务数据分析的前辈聊天,他就深有感触:“以前我让 AI 帮我分析十几家供应商的报价单,它在对话框里分析得头头是道。但接下来,我还得花整整两个小时,把它的文字一条条复制出来,手动贴到 Excel 里,再人肉算一遍公式、核对有没有遗漏。我当时就想:到底是我在用 AI,还是我在给 AI 打杂?”
直到上个月,他换了一套真正具备 Agent 能力的桌面工作台。他把整个供应商文件夹授权给系统,AI 自己跑去读取各个表格、调用内置脚本算同比环比、把结果写入一张崭新的汇总表,最后还重新打开表格逐行核验了一遍空值。
他感叹:“那一刻我才明白,以前我只是在和 AI 聊天,现在它才真正像个雇来的数字化员工。”
真正把大模型从“动嘴皮子的聊天玩具”,变成“能扛事、能交付的生产力工具”的技术,就是 AI Agent(智能体)。
今天这篇文章,我想彻底剥掉那些学术论文公式和玄虚的名词包装,像坐在白板前跟你喝茶聊技术一样,把 Agent 的底层思考机理、宿主外骨骼架构、工作现场演进、多智能体协同,一直到真实的工程落地与避坑经验,由浅入深彻底讲透。
01认知的蜕变:从“出谋划策”到“把事情闭环干完”
要搞懂 Agent,首先要彻底厘清它和传统 Chatbot(聊天机器人)的本质鸿沟。
我们用一个最经典的办公场景来对比:
业务需求:盘点当前目录下近一周的所有客户投诉邮件,汇总出高频投诉点,生成一张排版规范的 Markdown 报告,存到交付文件夹。
- 传统 Chatbot 会怎么做?
你把邮件内容一段段复制进网页对话框,它在屏幕里吐出一长串文字总结:“根据您提供的信息,主要投诉点集中在物流延迟与包装破损……建议优化仓储流程。”
交付结果:对话框里的一堆字符。后续的创建文件、格式排版、归档归类,所有体力活依然要由你人肉完成。 - AI Agent 会怎么做?
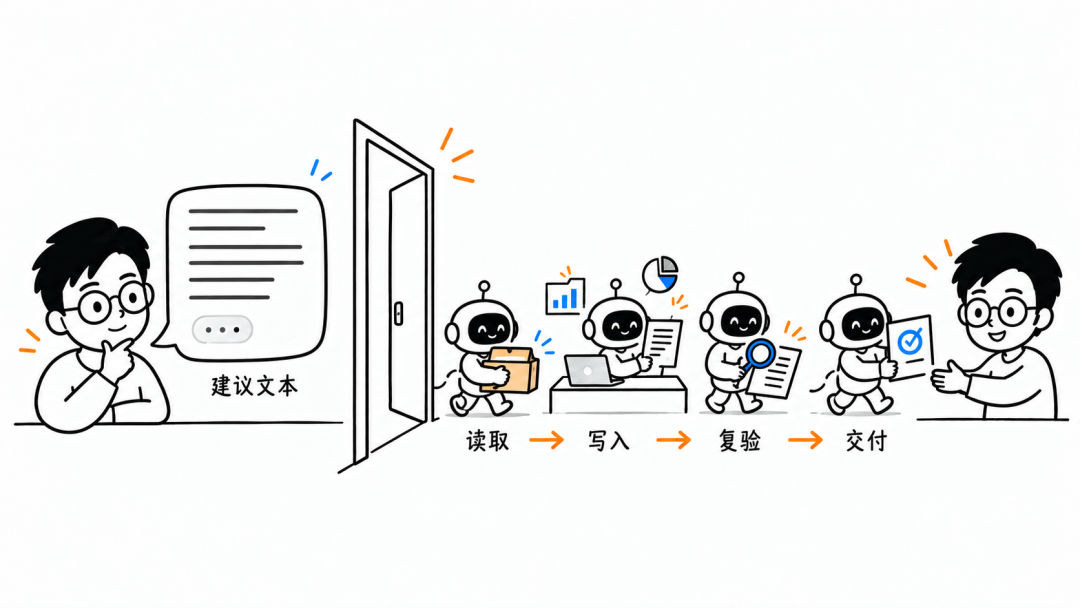
它接收到任务指令后,根本不会急着在屏幕上打字,而是进入一套自驱运转流程:
- 访问现场:自己找到邮件存储目录,遍历读取未处理文件;
- 提取分析:抓取关键信息,识别核心投诉归因;
- 调用工具:启动本地文件写入工具,按照指定模板生成报告;
- 自我复验:重新打开刚才写好的报告,检查有没有遗漏的邮件编号或排版错乱;
- 反馈交付:在屏幕上留下清晰的审计记录:“已处理 18 封邮件,已生成报告于
output/09-13-complaints.md,无缺失字段。”
这就是最本质的区别:
Chatbot 给出的是“建议与文本”,而 Agent 交付的是“确定的物理动作与完整结果”。
02核心认知刷新:决定能力的不仅是模型,更是“外骨骼”(Harness)
很多初学者存在一个极大的误区,以为做 Agent 就是找一个最聪明的大模型(比如 Claude 4.6 Sonnet 或 GPT-5.6),然后写一段几千字的牛逼提示词。
这就像把一台上千匹马力的 F1 赛车发动机,直接扔在路边水泥地上。发动机再轰鸣,它也没有底盘、没有变速箱、没有轮胎和方向盘,它根本跑不起来。
在工业界,工程师们把大模型外面的这一整套配套软硬件系统,形象地称为 Harness(马具 / 动力外骨骼)。
同一个大模型:
- 放在网页版对话框里,它的 Harness 只有输入框和输出气泡,所以它只能陪你聊天;
- 放在现代 Agent 工作台里(例如 Claude Code、桌面级智能体环境),它的 Harness 包含:文件读写权限、命令行终端、工具调用接口、权限审核栅栏和自检报错回路。
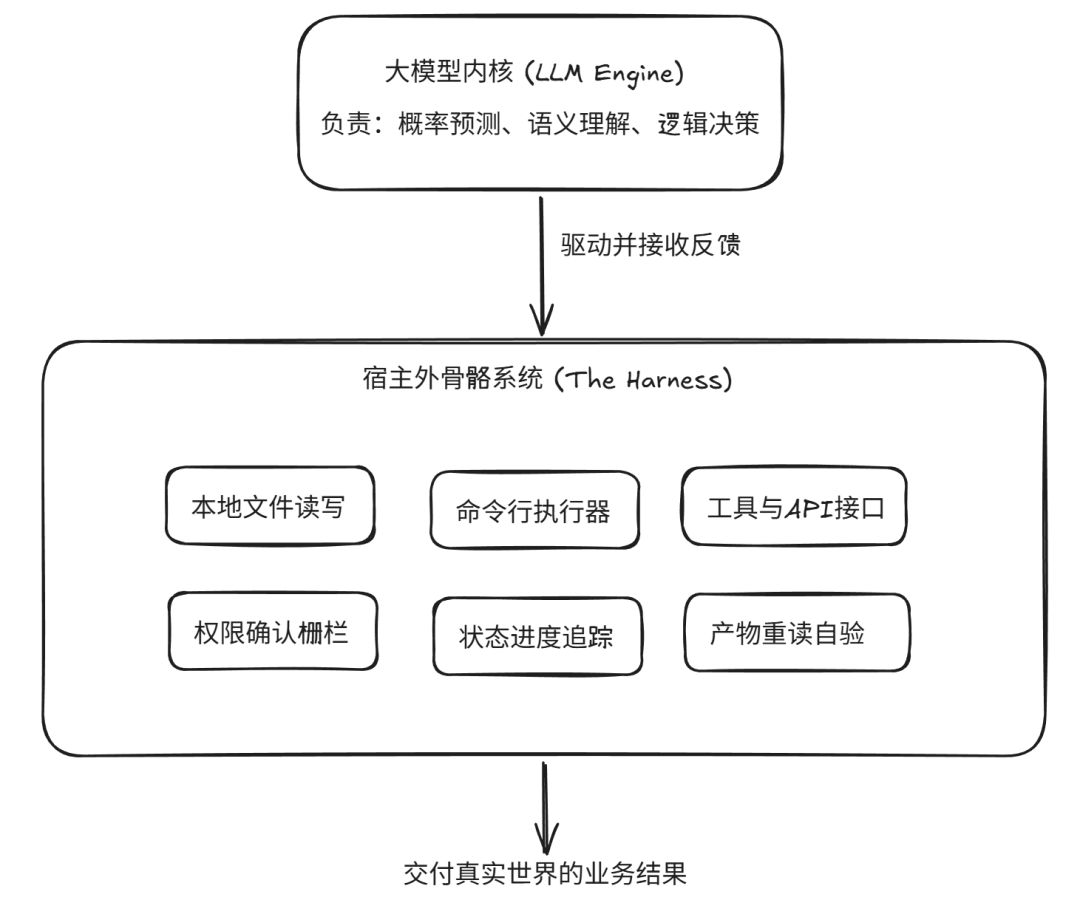
决定一个 Agent 到底能不能把活干漂亮的,一半取决于大模型的智商,另一半完全取决于这套 Harness 能给它提供怎样的操作权限、工具链与容错反馈。
03底层推演机理:Agent 到底是怎么“思考”并长出双手的?
理解了 Harness,我们再深入到代码和算法层:Agent 内部到底是在怎样运转的?
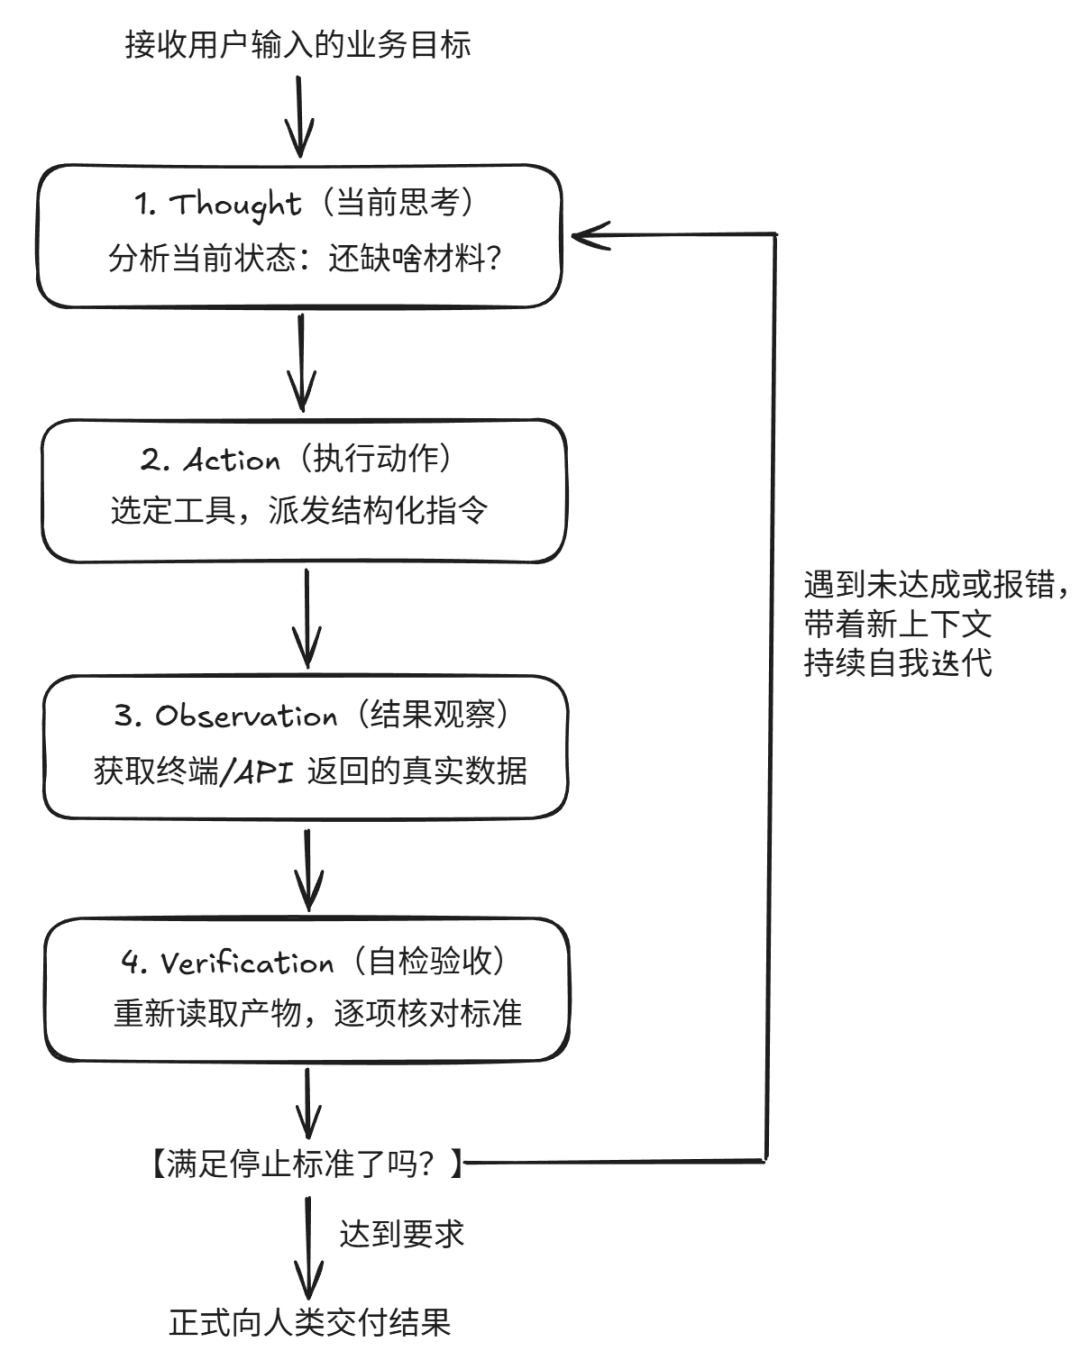
目前全球前沿的 Agent 运行逻辑,核心都是围绕经典的 ReAct(Reasoning + Acting,推理与行动交替) 演进而来。但一个真正能用于工业生产的完整 Agent Loop,必须包含一个很多学术文章避而不谈的关键环节——自校验与停止判据(Verification & Stop Condition)。
关键环节 1:大模型怎么调用工具?(Function Calling 与 MCP)
大模型自己不会运行 Python,也不会发送 HTTP 请求,它是怎么“长出双手”的?
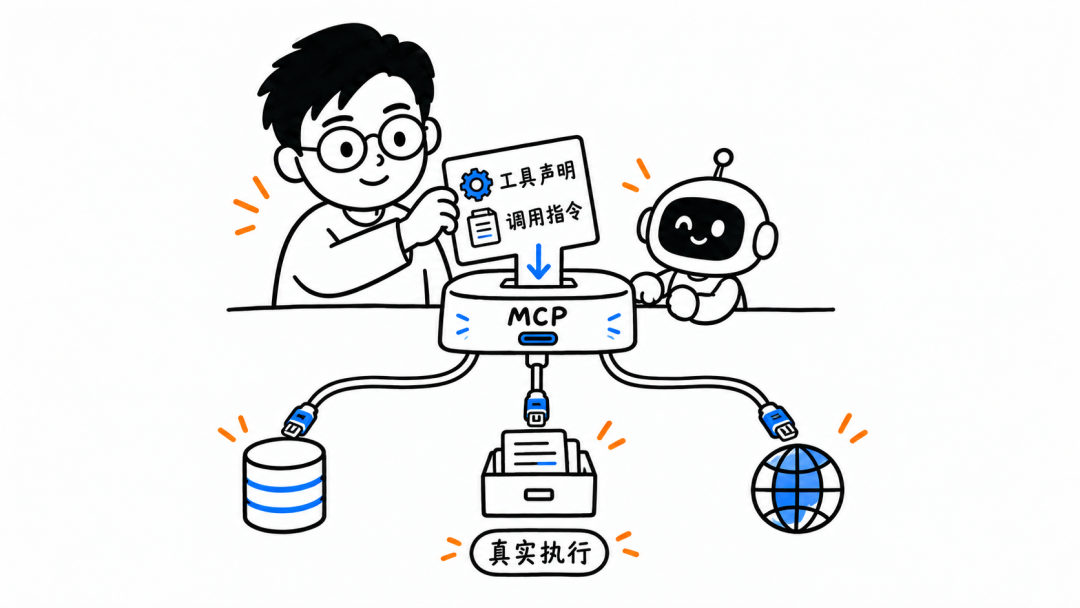
答案是 Function Calling(函数调用) 规范:
- 工具声明:宿主环境给大模型提供一份清单(如
{"name": "query_db", "description": "查询库存数据", "parameters": {...}}); - 生成指令而非文本:当用户提问“A商品还有多少件”时,大模型在内部抑制了说废话的冲动,直接输出一段标准的 JSON 格式调用指令;
- 物理环境接单执行:外部程序接手这段 JSON,真正向数据库发起查询,拿到返回数据后,重新喂入模型上下文;
- 统一插头协议(MCP,Model Context Protocol):近来开源界推行的 MCP 标准,就像给所有外部软件(Notion、GitHub、Postgres)做了一套通用的 Type-C 接口,任何 Agent 只要接上同一个 MCP Server,就能瞬间获得控制该软件的能力,不必重复开发适配代码。
关键环节 2:为什么很多 Agent 会“人工智障”?缺少了自校验回路!
市面上很多粗制滥造的 Agent,之所以经常把事情办砸,就是因为它们的逻辑是:调用完写入工具 = 任务结束。
但真实工程完全不是这样:
- 网页抓取可能返回了“403 Forbidden”或者空页面,模型却以为抓到了;
- 写入 Excel 时可能漏掉了两列,模型直接提示“保存成功”。
高阶 Agent 的核心标志,是在 Action 之后必须有 Verification(回读自验):
生成完文件后,Agent 必须自己再次调用读取工具,重新打开该文件,检查行数是否吻合、关键字段是否为空。如果发现问题,立刻原地打补丁重做;只有当全部校验项亮绿灯时,才能触发 Stop Condition(停止条件) 退出循环。
04工作现场的演化:Agent 是在哪里“干活”的?
如果把 Agent 比作工人,那它的“办公工位”经历过三个极为清晰的进化阶梯。了解这三个阶段,能帮你避开绝大多数选型陷阱:
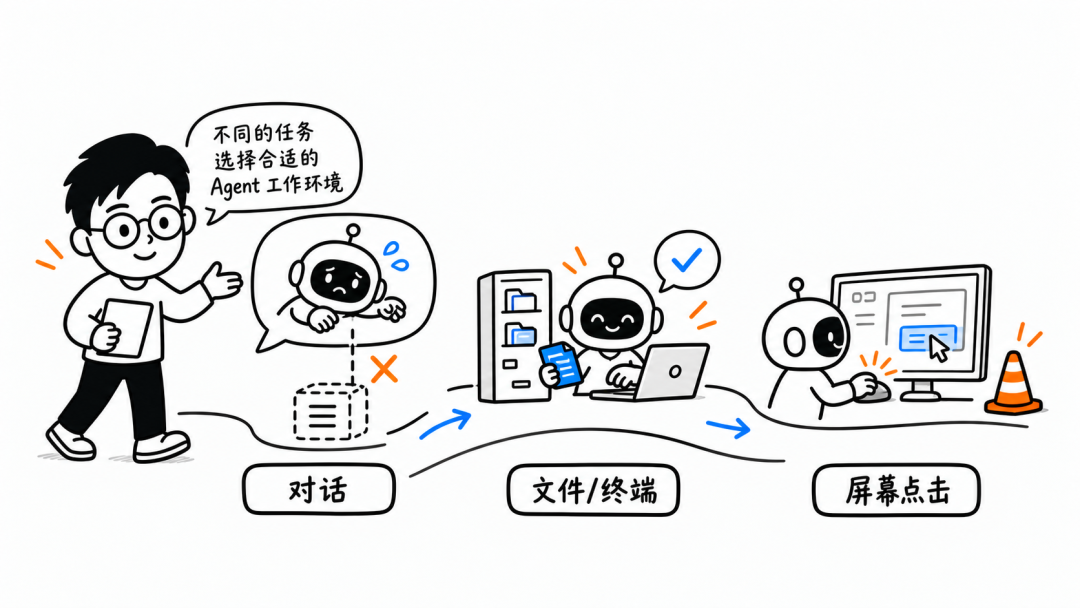
第 1 阶:纯文本对话框(云端悬空)
- 特征:输入框打字,输出气泡展示。
- 致命痛点:信息悬浮在浏览器内存中,没有任何本地持久化能力,属于典型的“动嘴不动手”。
第 2 阶:文件系统与命令行终端(工业落地的黄金中枢)
- 特征:Agent 被赋予了特定目录的文件读写权限和受控终端运行权限。
- 为什么这是最可靠的现场?
- 确定性极高:终端里的每一行命令都有标准的输出(stdout)、报错(stderr)和退出状态码(Exit Code 0 代表成功,非 0 代表失败),AI 根本不用靠猜,报错信息就是它最好的纠错向导;
- 安全且可逆:配合 Git 版本控制,Agent 哪怕改崩了一百行代码,敲一行
git checkout就能瞬间恢复现场。
第 3 阶:屏幕视觉交互(Computer Use / 视觉点击)
- 特征:模型通过截屏分析当前显示器画面,模拟人类移动鼠标、敲击键盘、点击 UI 按钮。
- 现实评价:虽然看似炫酷、能操作那些没有 API 接口的古老行业软件,但目前在生产环境中稳定性极差。一个突如其来的网页弹窗、分辨率缩放不一致、或者按钮换了个皮肤,都可能导致整套自动化流程当场卡死。
💡 资深架构师的工具选型铁律:
有 API 绝不上终端,有终端绝不上屏幕点击。优先在文件与代码层解决问题,屏幕操作只作为最后的兜底手段。
05解剖四大核心支柱:撑起工业级 Agent 的底座
撇开具体业务,任何成熟 Agent 架构底层都是由这四根支柱搭建起来的:
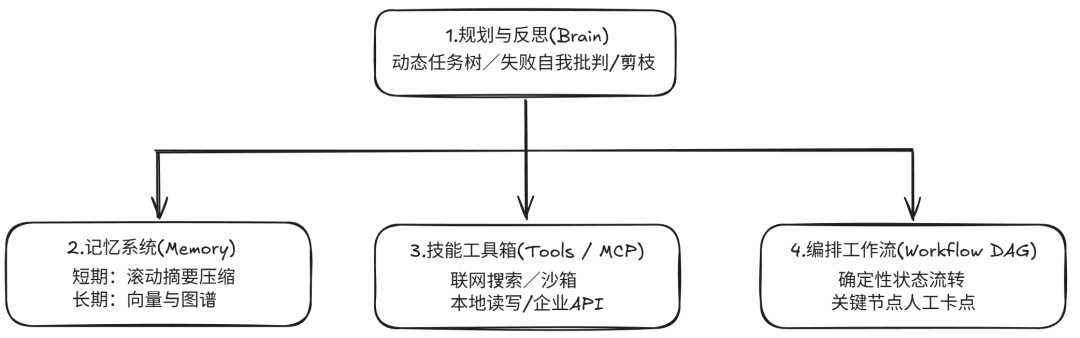
处理复杂任务不能靠一根筋走到黑。
- 动态任务分解:遇到多步骤需求,先输出思维树(Tree of Thoughts),将大问题拆成可验证的微型阶段;
- 批判机制(Critic Pattern):生成方案后,唤起内部自检:“这个方案有没有越权访问不该碰的数据?有没有包含未经确认的假设?”
支柱 2:记忆系统(Memory)
大模型上下文窗口再大,也不代表可以无限塞入。
- 工作记忆(短期):不能把所有历史对话硬塞。成熟做法是用轻量模型在后台异步运行,把超过 5 轮的旧对话不断压缩成带有实体和结论的“精简卡片”;
- 领域记忆(长期 / RAG):把企业私有资料做向量化切片。
- 关键避坑:绝不能按机械字数切分(如每 500 字一刀),必须按业务语义、Markdown 标题或章节切分,否则一段完整的逻辑被切成两半,大模型召回后直接变成断章取义。
支柱 3:工具箱(Tools / MCP)
工具是 Agent 改变物理世界的扳手。
- 只给必要的工具:不要一股脑给 Agent 装上 50 个插件。工具越多,大模型在选择调用时的幻觉率越高(通常超过 8 个工具,参数拼错率就会显著上升);
- 说明书必须极其精准:工具的 description 必须写明“何时用、输入参数边界、输出数据类型”。
支柱 4:确定性工作流(Workflow DAG)
这是学术界和工业界最大的分水岭。
在实际商业落地中,绝不允许让 Agent 完全凭感觉自由发挥。
最稳固的架构永远是:用确定性的有向无环图(DAG)把主干流程固定下来(Step 1 必须完成后才能走 Step 2),大模型只在每个节点内部充当“语义理解和文本处理”的微处理器。
06进阶跨越:多智能体(Multi-Agent)协同流水线
单个 Agent 的上下文承载力和多任务专注度存在天然物理极限。当你要做一套完整业务时,多智能体分工是唯一的破局点。
目前工业界最稳定高效的 3 种协同拓扑模式:
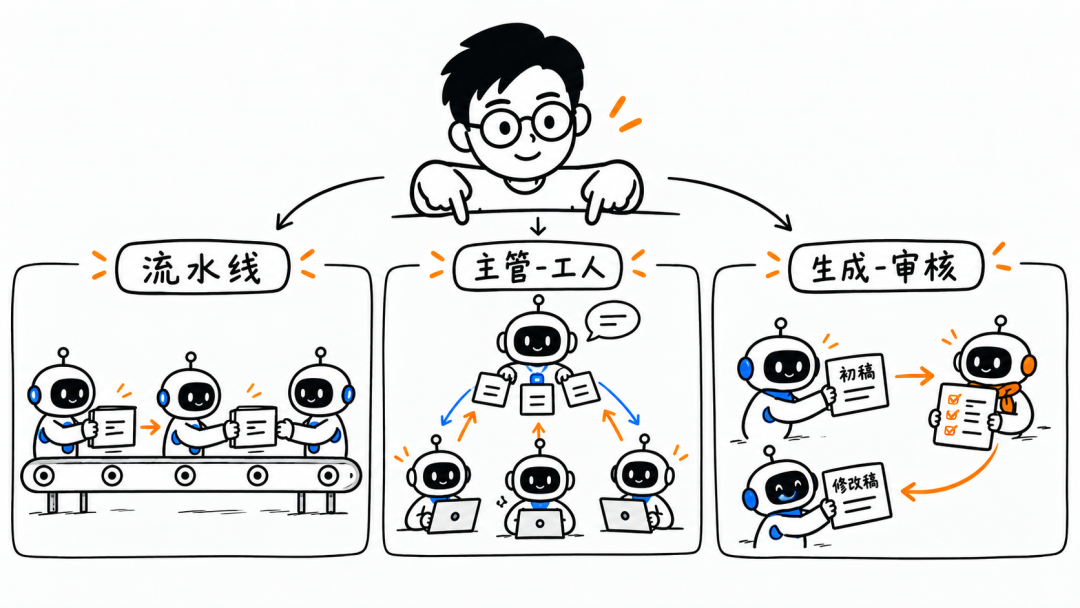
1.流水线模式(Sequential Pipeline)
-
场景:输入输出标准固定的业务。
-
流程:上一岗位的交付物直接作为下一岗位的原材料。
Agent A(爬取清洗数据) ➔ Agent B(撰写结构化研报) ➔ Agent C(提取社媒短文并排版)。 各自保留独立的上下文,互不干扰,Token 消耗极小。
2.主管-工人模式(Orchestrator-Workers)
- 场景:跨领域、需动态并行的复杂任务。
- 流程:中心总控 Agent 负责拆解总目标,下发工单给并行的多个 Worker Agent(数据工、图表工、法律核验工), Worker 完成后向总控汇报,总控做全局合并与冲突消解。
3.红蓝对抗与审核模式(Evaluator-Optimizer)
- 场景:对交付质量要求极高的代码编写、合同审查与深度内容输出。
- 流程:
- 生成 Agent(蓝军):快速拿出第一版成果;
- 质检 Agent(红军):设定为挑剔苛刻的审查员,拿着 Checklist 逐项挑刺打分;
- 两者在后台自我博弈 2~3 轮,直到打分超过 90 分才正式交付给人类。这一招能直接把大模型产出的可用率拉升一个档次。
07资产沉淀:从“临时闲聊”到“个人规则库与专属 Skill”
很多人玩 Agent,最大的痛点就是“不可沉淀”:今天教了它一套规矩,明天新开一个对话窗口,它又忘得一干二净,你又得把那几百字提示词复制一遍。
老手玩 Agent,核心看两项数字资产的沉淀:
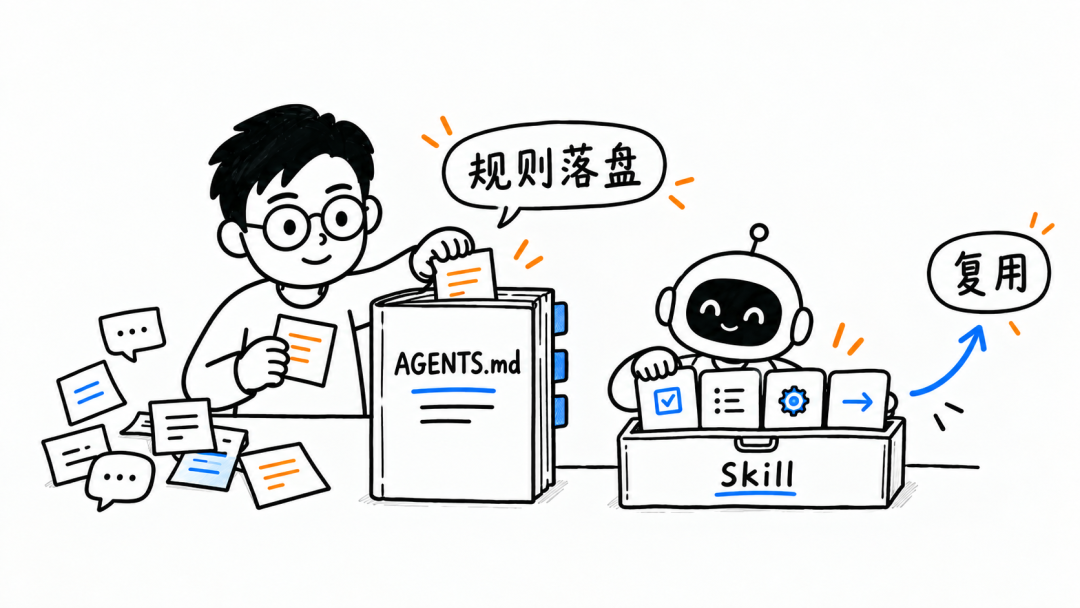
1.项目长期规则落盘:AGENTS.md 规范
不要把规矩散落在聊天记录里。
在你的工作项目根目录下,建立一个名为 AGENTS.md(或全局规则配置文件)。在这份文件里用简洁的语言写明:
- 本项目的数据存放目录规则;
- 输出文件命名规范(如
YYYY-MM-DD-主题.md); - 绝不允许踩踏的红线(如“遇到不确定的数据严禁捏造,必须标注 [待核实]”)。
现代 Agent 每次在这个文件夹启动新任务时,都会首先自动加载并执行这份文件中的铁律。规矩改一次,全局终身受用。
2.跑顺的 SOP 固化为可复用的 Skill
当一条“抓取数据 ➔ 格式清洗 ➔ 写入表格 ➔ 重新校验”的复杂流程跑顺之后,不要把它扔掉。
在平台中将这一串工具调用和 Prompt 封装成一个 Skill(专属技能包)。
下周换了一个新的行业课题,或者导入了一批新的财报数据,只需输入一条 $调用财报分析Skill,整套自动化机器立刻精准复刻,这就是个人生产力实现“复利”的真正秘密。
08老兵复盘:生产环境中血淋淋的 3 个工程教训
最后,聊聊几个真金白银踩出来的实战大坑,希望能帮你少走几个月弯路:
1.警惕“上下文无限膨胀”与账单黑洞
多轮工具调用时,很多新手会把爬下来的整篇几万字网页 HTML 或未清洗的臃肿 JSON,一股脑全部塞回模型上下文。
结果不出两轮,单次运行的 Token 就会暴涨到十几万,响应速度变成龟速,月底 API 账单让人肉痛。
- 工程解法:在工具返回端与大模型之间,必须加一层轻量清洗逻辑(甚至可以用低成本小模型),把冗余网页代码过滤为纯净文本摘要后再喂给主脑。
2.人在回路(Human-in-the-loop):设立最后的物理安全阀
不管 Agent 表现得多聪明,都必须记住:大模型的底层是概率,概率就意味着一定存在出错的可能。
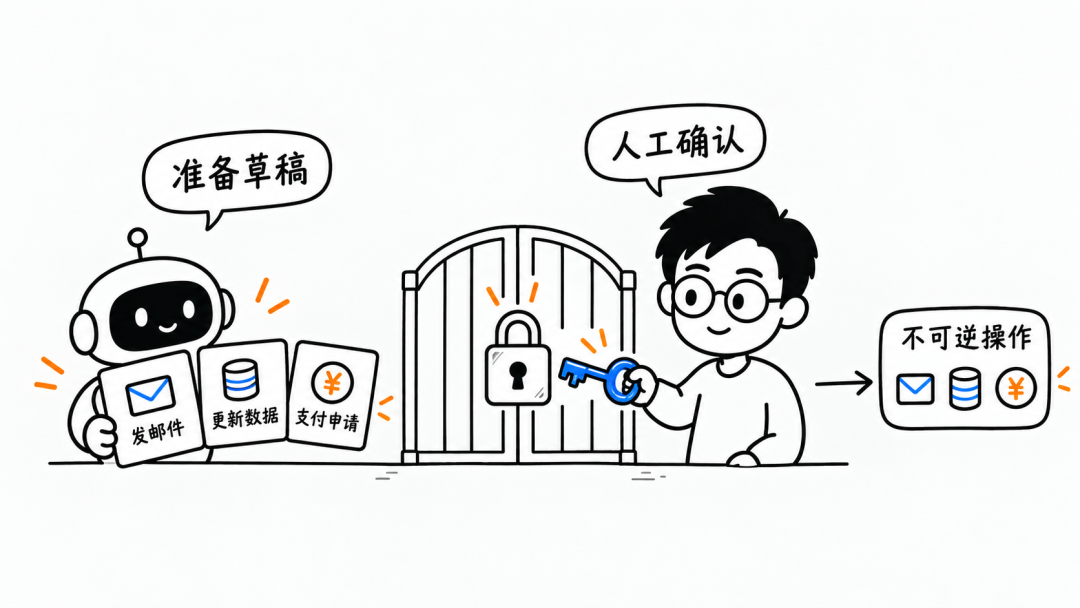
在涉及“对外发送邮件”、“向数据库写入关键记录”、“发起付款”等具有不可逆破坏性的节点上,必须强制暂停并弹出人类确认框。机器负责把方案和草稿准备到 95%,最后这 5% 的放行权永远握在人类手里。
3.单个 Prompt 的“指令边际效应递减”
很多人喜欢写长篇大论的“万字神级 Prompt”,列出 30 条要求。
实际测试表明:大模型对一条 Prompt 中的指令数量是有注意力上限的。要求超过 10 条,中间的规则往往会被大面积忽略。
- 工程解法:模块化拆解。把长篇大论拆成两个接力运作的 Agent:第一个只负责把内容逻辑写深,第二个只负责对照格式规范做合规清洗。分工越单一,执行力越稳健。
最后
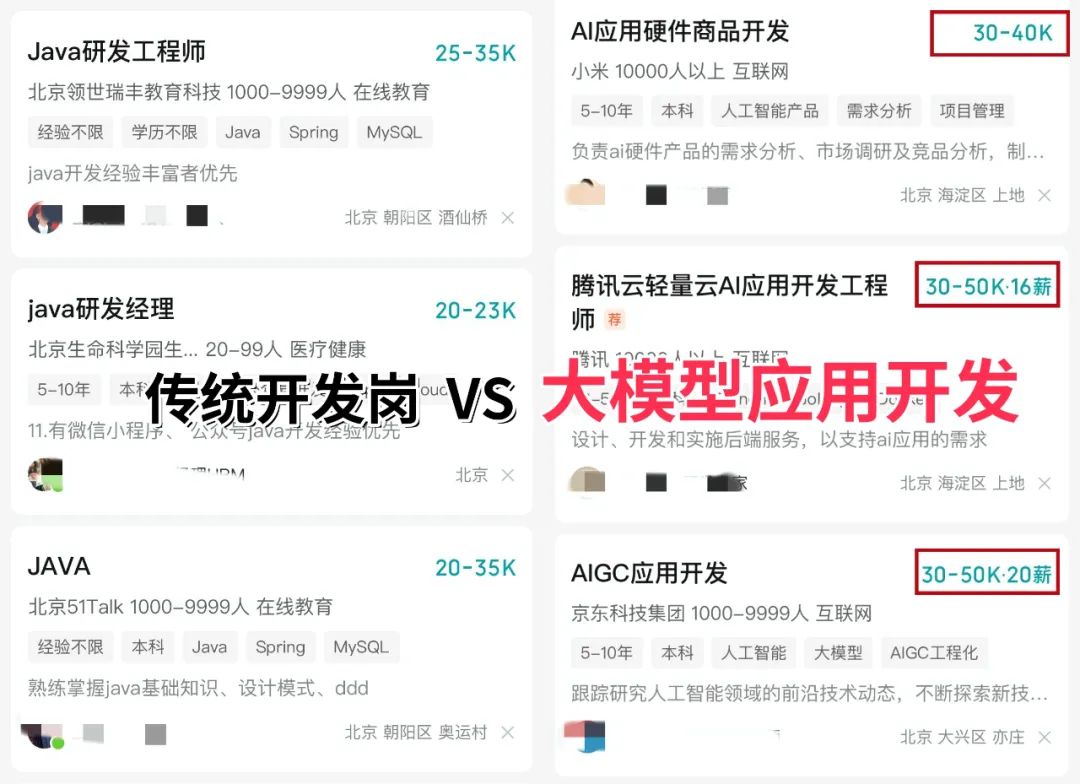
对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?
答案只有一个:人工智能(尤其是大模型方向)
当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应聘者,月基础工资也能稳定在4万元左右。
再看阿里、腾讯两大互联网大厂,非“人才计划”的AI相关岗位应聘者,月基础工资也约有3万元,远超其他行业同资历岗位的薪资水平,对于程序员、小白来说,无疑是绝佳的转型和提升赛道。
如果你还不知道从何开始,我自己整理一套全网最全最细的大模型零基础教程,我也是一路自学走过来的,很清楚小白前期学习的痛楚,你要是没有方向还没有好的资源,根本学不到东西!
下面是我整理的大模型学习资源,希望能帮到你。
👇👇扫码免费领取全部内容👇👇

最后
1、大模型学习路线
2、从0到进阶大模型学习视频教程
从入门到进阶这里都有,跟着老师学习事半功倍。
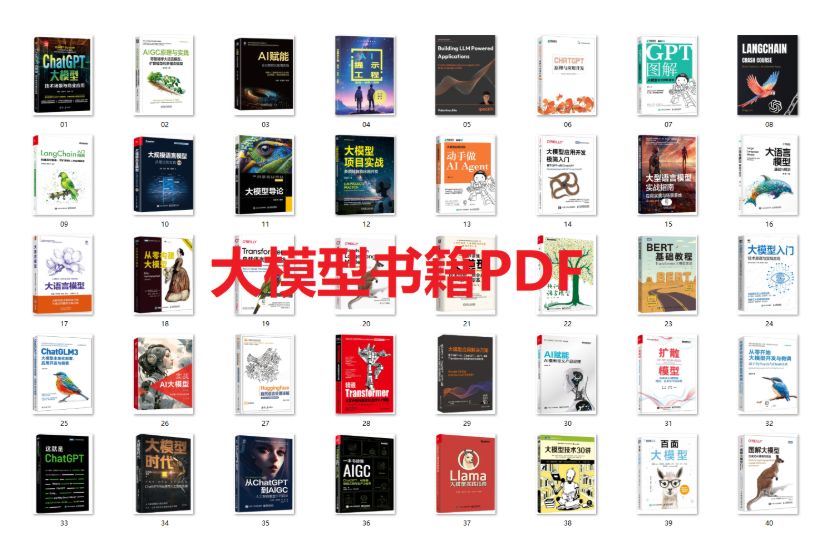
3、 入门必看大模型学习书籍&文档.pdf(书面上的技术书籍确实太多了,这些是我精选出来的,还有很多不在图里)
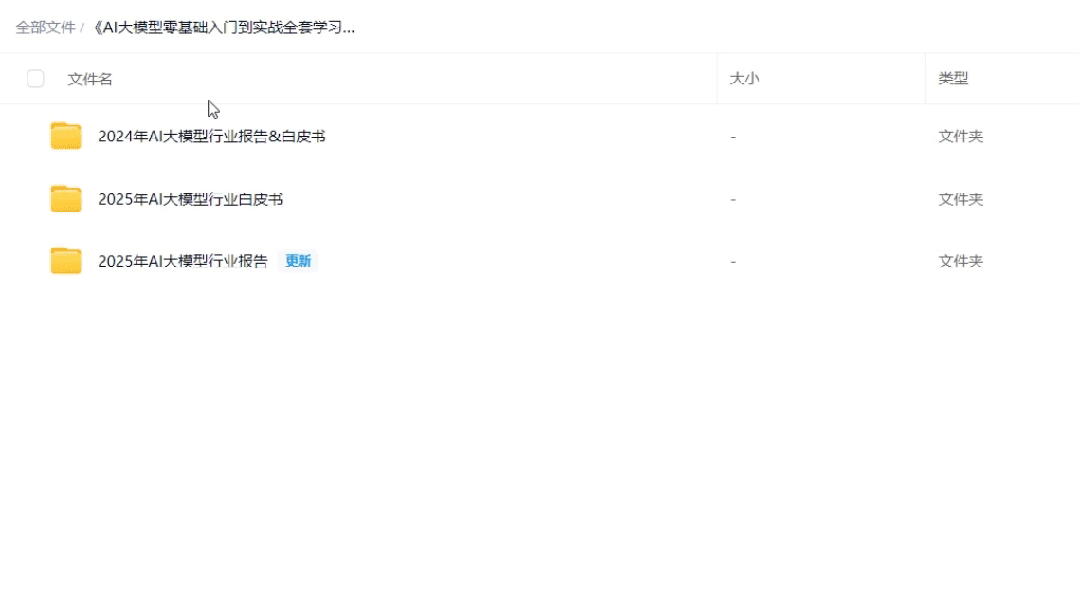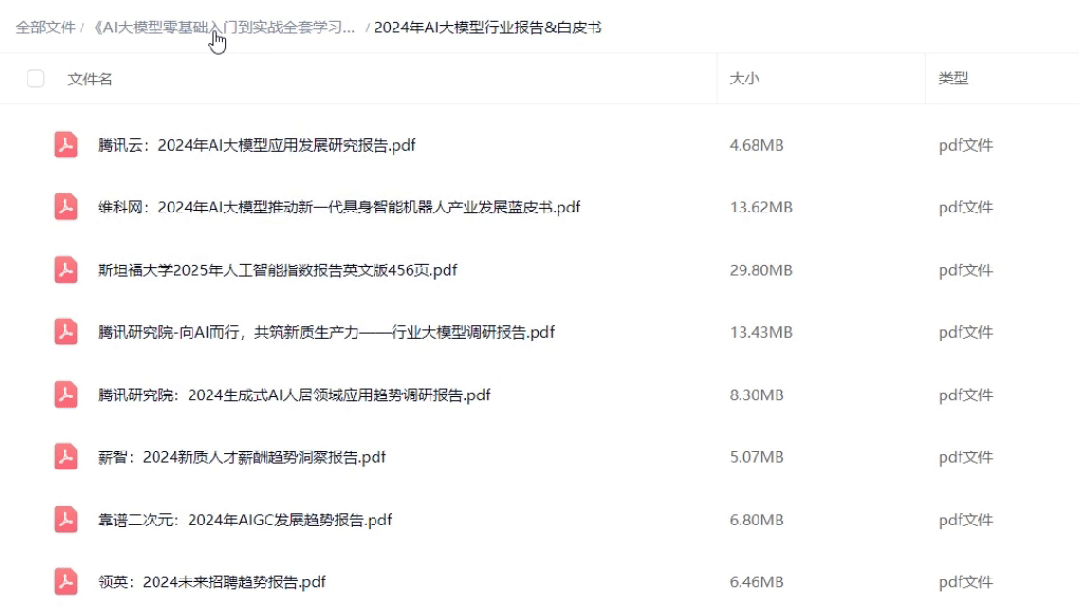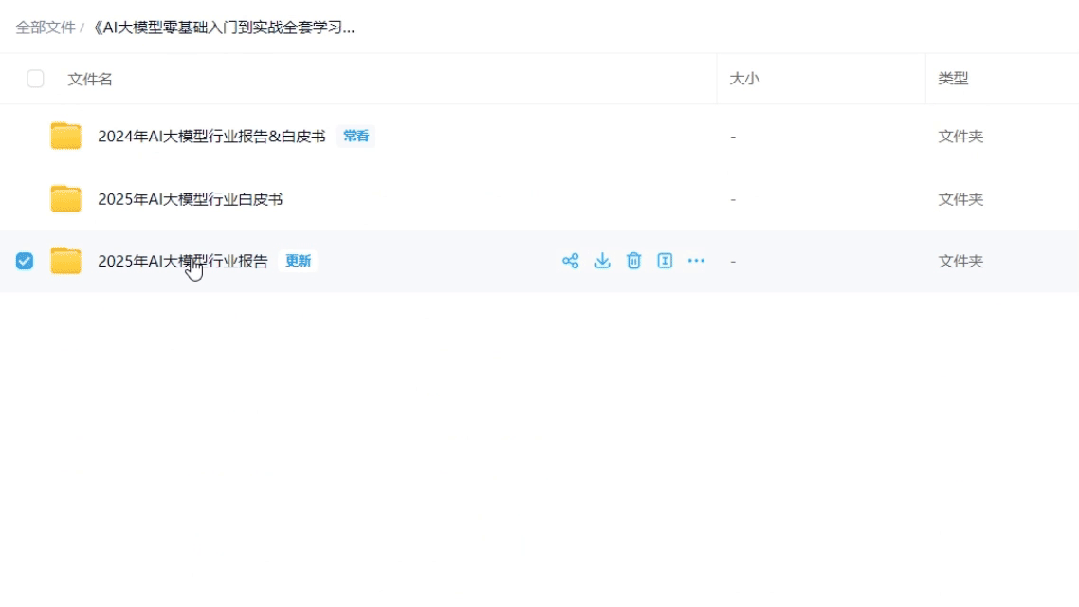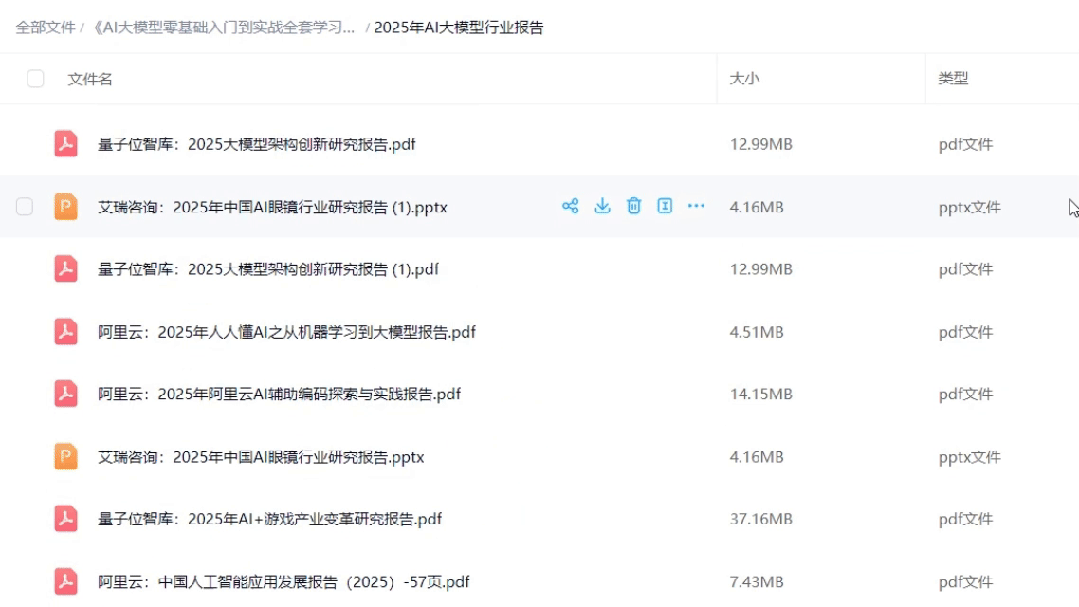
4、 AI大模型最新行业报告
2026最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。
5、面试试题/经验
【大厂 AI 岗位面经分享(107 道)】
【AI 大模型面试真题(102 道)】
【LLMs 面试真题(97 道)】
6、大模型项目实战&配套源码
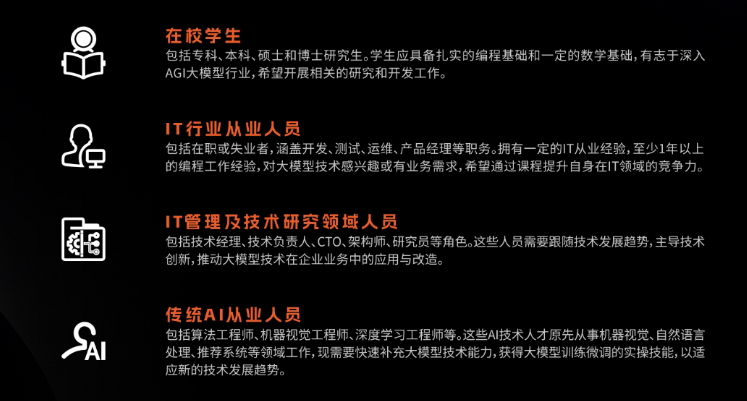
适用人群
四阶段学习规划(共90天,可落地执行)
第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
-
硬件选型
-
带你了解全球大模型
-
使用国产大模型服务
-
搭建 OpenAI 代理
-
热身:基于阿里云 PAI 部署 Stable Diffusion
-
在本地计算机运行大模型
-
大模型的私有化部署
-
基于 vLLM 部署大模型
-
案例:如何优雅地在阿里云私有部署开源大模型
-
部署一套开源 LLM 项目
-
内容安全
-
互联网信息服务算法备案
-
…
👇👇扫码免费领取全部内容👇👇

3、这些资料真的有用吗?
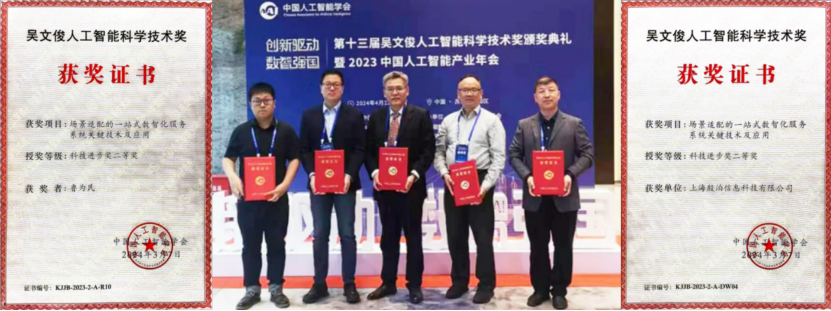
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】


Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐

 0
 0
- 0


 已为社区贡献197条内容

所有评论(0)