精通LangChain:AI开发工程师进阶AI应用高手的必经之路!
本文深入探讨了AI大模型在实际应用中的局限性,如数据及时性、复杂任务处理、代码生成与下载以及企业应用场景集成等问题。文章提出AI智能体(Agent)作为解决方案,详细介绍了LangChain框架,包括其四大组件:LangChain、LangSmith、LangServe和LangGraph。LangChain作为AI应用开发平台,支持模型I/O、检索、代理、链条、内存和回调等核心功能,通过LCEL(LangChain表达式)实现复杂链条构建。文章还介绍了RAG(检索增强生成)技术,使大模型能够利用实时数据或企业内部数据进行推理。最后,文章展望了LangChain未来的发展方向,并提出了可能的扩展组件,如LangMonitor、LangFiles和LangExchange等。
根据作者的提示词章节,让AI大模型更精准高效地输出我们需要的内容,我们已经体验过了,但AI大模型在使用的过程中是有一些局限的:
-
数据的及时性: 大部分AI大模型都是预训练的,也就是说我们问的最新的信息,大模型可能还没有拿到最新数据去训练,它是不知道的.
-
复杂任务处理: 虽然AI大模型在问答方面出色,但它们并不总是能够处理复杂的任务,比如直接编辑或优化Word文档或PDF文件,这些任务通常需要特定的软件工具和用户界面,而大模型主要是基于文本的交互(多模态除外).(我:用过claudecode的对文档word的格式优化是可以的,作者这里应该特指web端的大模型,非多模态的,agent和mcp对接不到本地的问答模型入口产品)
-
代码生成与下载: 我们希望大模型根据需求描述生成对应的代码,并提供下载链接,大模型也是不支持的.(我:这里作者应该也是特指web端大模型,作者这个课程也是在2024年前左右的,作者这里特指的是非AI编辑器的那种AI大模型,虽然能也能生成代码,但是不能下载是真的,只能自己复制,这里的代码生成作者应该也是说的整体代码,可能不是指代码片段,因为从2022年末的chatgpt就可以生成代码片段了,但是准确度能用度很低)
-
与企业应用场景的集成: 在和企业应用场景打通的时候,我们希望大模型读取关系型数据库里的数据,并根据提示进行任务处理,同样大模型也是不支持的.
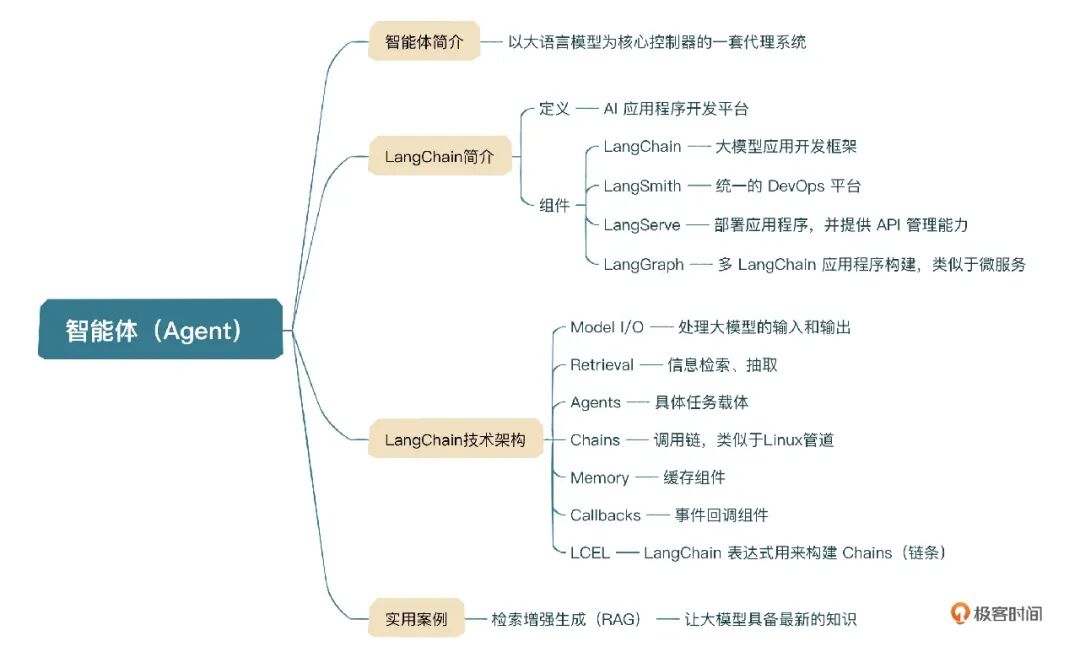
这样的场景非常多,因为大模型的核心能力是意图理解与文本生成,而在我们实际应用过程中,输入数据和输出数据不仅仅是纯文本.很多时候我们需要解析用户的输入,比如把Word或PDF文件转化为纯文本,从一个关系型数据库读取数据转化为大模型的输入数据,将大模型的输出内容进行压缩打包并上传至网站供用户下载等等.那这一类任务的由谁来做呢?那就是AI智能体,也叫AI Agent.
AI Agent
AI Agent就是以大预言模型为核心控制器的一套代理系统.
举个形象的例子: 如果把人的大脑比作大模型的话,眼睛,耳朵,鼻子,嘴巴,四肢等联合起来叫做Agent,眼睛,耳朵,鼻子感知外界信号作为大脑的输入;嘴巴,四肢等根据大脑处理结果形成反馈进行输出,形成以大脑为核心控制器的一套系统.
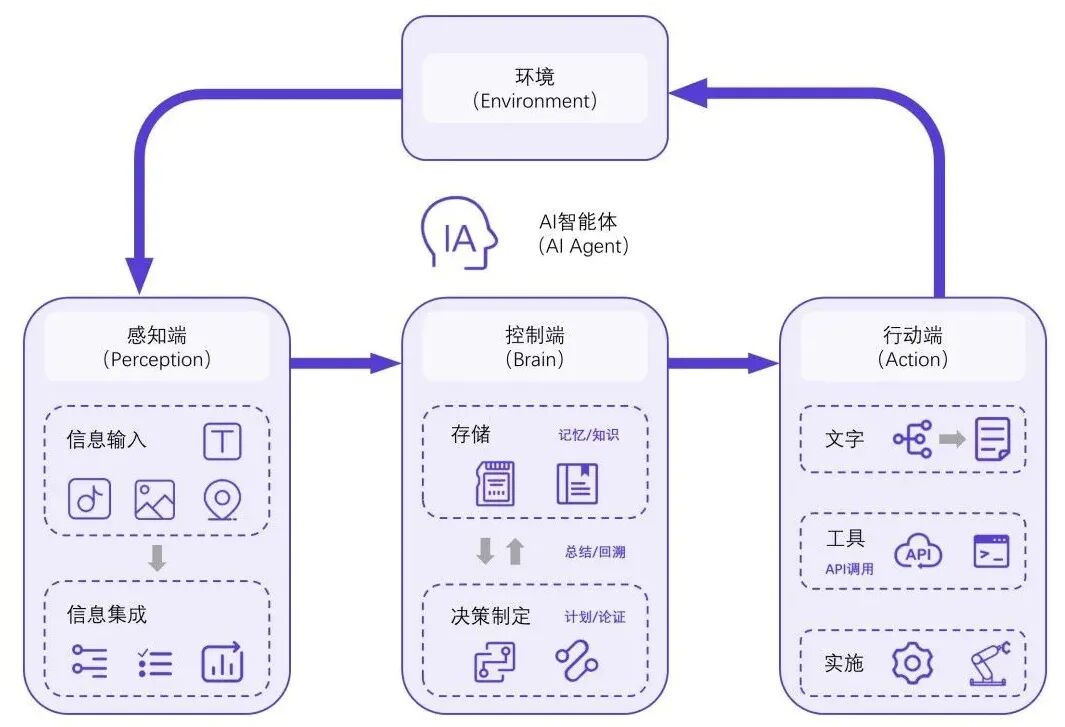
控制端处于核心地位,承担记忆,思考以及决策制定等基础工作,感知模块则负责接收和处理来自外部环境的多样化信息,如声音,文字,图像,位置等,最后行动模块通过生成文本,API调用,使用工具等方式来执行任务以及改变环境.
相信通过这样的介绍,你就明白智能体的概念和结构了,接下来我给你介绍一些常见的智能体技术,下面我们统称为Agent,目前比较流行的Agent技术有AutoGen,LangChain等,因为LangChain既是开源的,又提供了一整套围绕大模型的Agent工具,可以说使用起来非常方便,而且从设计到构建,部署,运维等多方面都提供支持,所以下面我们主要介绍一下LangChain的应用场景.
LangChain 介绍
起初,LangChain只是一个技术框架,使用这个技术框架可以快速开发AI应用程序.这可能是软件开发工程师最容易和AI接触的一个点,因为我们不需要储备太多算法层面的知识,只需要知道如何和模型进行交互,也就是熟练掌握模型暴露的API接口和参数,就可以利用LangChain进行应用开发了.
LangChain发展到今天,已经不再是一个纯粹的AI应用开发框架,而是成为了一个AI应用程序开发平台,它包含4大组件:
-
LangChain: 大模型应用开发框架.
-
LangSmith: 统一的DevOps平台,用户开发,协作,测试,部署和监控大模型应用程序,同时,LangSmith是一套Agent DevOps规范,不仅可以用于LangChain应用程序,还可以用在其他框架下的应用程序中.
-
LangServe: 部署LangChain应用程序,并提供API管理能力,包含版本回退,升级,数据处理等.
-
LangGraph: 一个用于使用大模型构建有状态,多参与者应用程序的库,是2024年1月份推出的.
放到我们传统软件开发场景中,我认为LangChain就类似于SpringCloud; LangSmith类似于Jenkins+Docker+K8s+Prometheus; LangServe类似于API网关; LangGraph类似于Nacos; 当然只是简单比拟.(我:起初学Python以及Python的相关框架,基本上我也是对照Java的技术栈去学的,我觉得学AI,去这样对比一样挺好的,一下就明白了)
LangChain可以说是当前最火的AI Agent技术框架,GitHub上拥有超过80k stars,另外使用MIT开源协议,非常友好,自己研究或公司拿来商用都没有问题.
不过一切还在快速发展中,相信很快就会有更多的技术出来.为什么这么说呢?就拿软件开发举例,现在的开发流程是: 开发工程师在IDE里编写代码,然后打包部署,测试工程师进行测试,然后发布上线.
目前看,大模型已经具备代码编写的能力,理想场景不太可能是由大模型把代码写好,我们下载到本地,用IDE打开,然后打包部署,测试,这说白了只是替换了目前代码编写的场景.我觉得如果AI颠覆软件开发行业,一定是从编码到测试,再到部署一整套流程的颠覆.(我:跟我之前的构思有的一拼,https://www.processon.com/view/link/5b7fd86be4b08faf8c33f429,但是现在的tasksaas这个工具,在融合多种语言或者只是Java语言的多方面测试AI化还是欠缺的,只能大概让AI生成自动化测试脚本,测试,然后脚本记录到工具里,其他的一些如单元测试,或者页面点击黑盒测试等,接入情况还需要看不同语言来分别处理,比较麻烦,而CICD我用的一个框架还没有完全加入进来,就算加入进来,其实还是有些手工的部分,比如CICD的server端的处理等).到那个时候,我们的开发流程可能就变成我上节课讲的那样了.
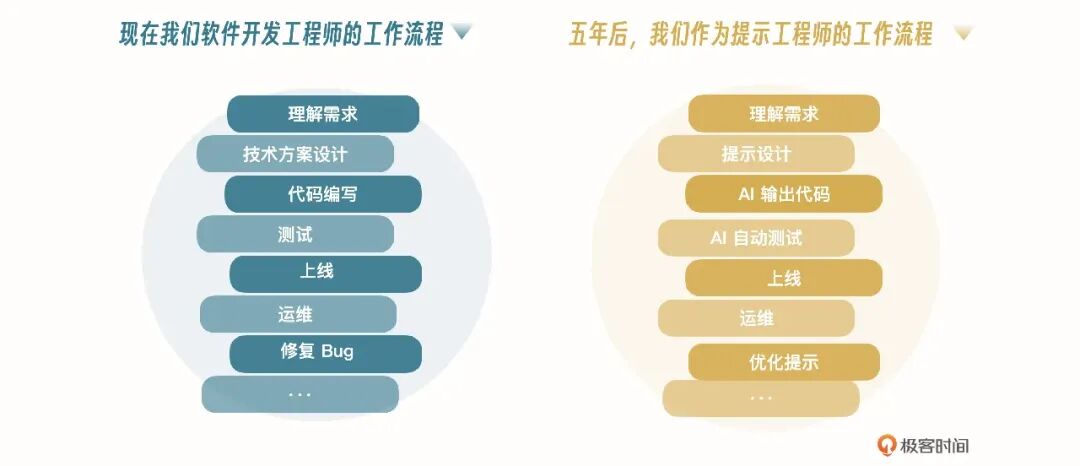
当然,也必须要配套相关的技术框架,管理工具来支撑(我:比如tasksaas:https://moocstudent.github.io/TASKSAAS_BOOK/),比如Prompt管理是否还会用Git?会不会有另一套类似于Git用来管理Prompt的工具?代码还会不会存在?大模型可否直接生成可执行程序?还会有Jenkins吗?
你可以畅想一下,未来一整套的技术架构都有可能会被颠覆.
LangChain 技术架构
接下来我们看一下目前LangChain整个平台技术体系,不包含LangGraph,LangChain框架本身包含三大模块.
-
LangChain-Core: 基础抽象和LangChain表达式语言.
-
LangChain-Community: 第三方集成.
-
LangChain: 构成应用程序认知架构的链,代理和检索策略.
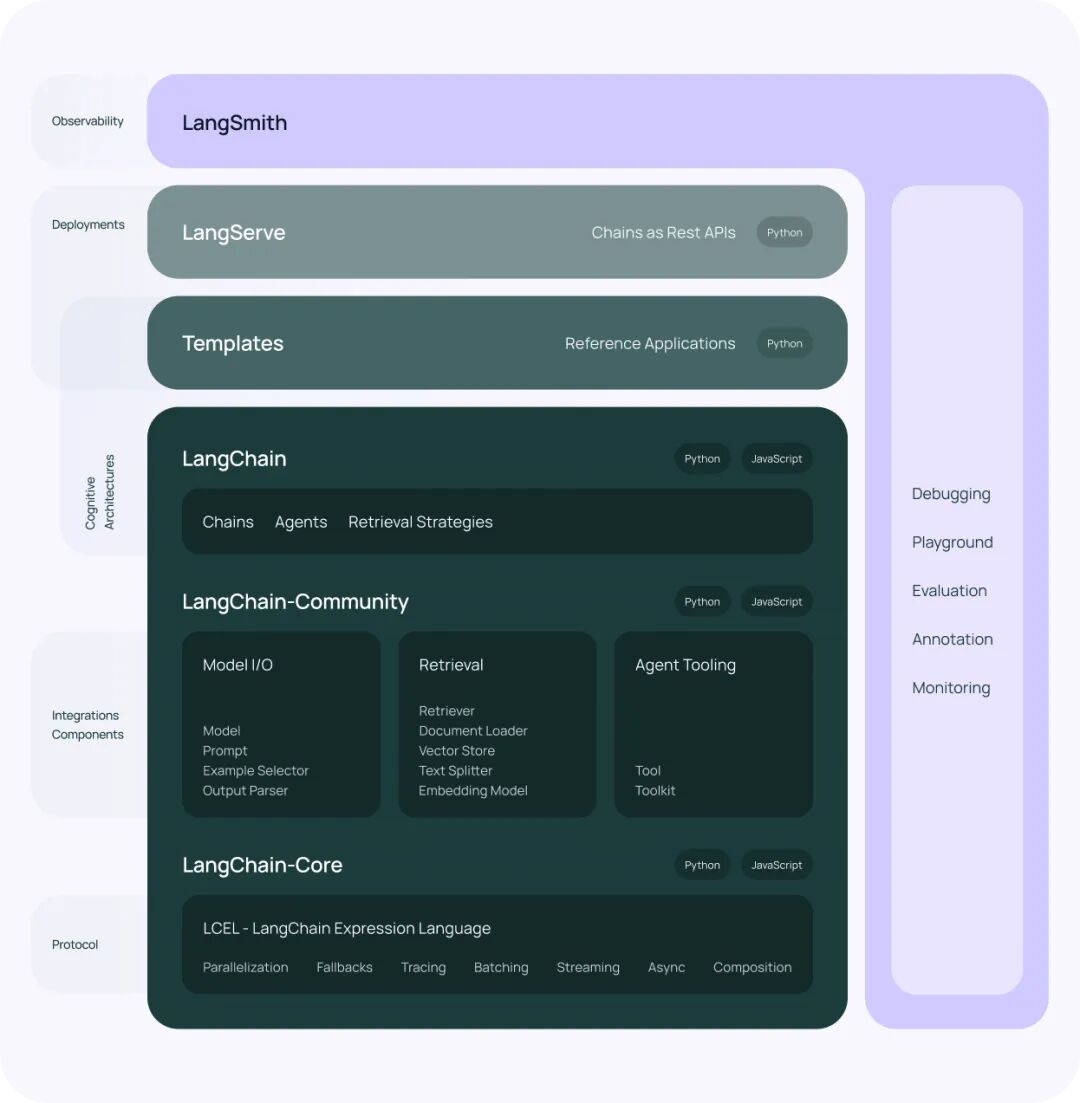
下面我们介绍一下其中的重要模块.
模型 I/O (Model I/O)
模型I/O模块主要由三部分组成: 格式化(Format),预测(Predict),解析(Parse).顾名思义,模型I/O主要是和大模型打交道,前面我们提到过,大模型其实可以理解为只接受文本输入和文本输出的模型.
此处注意: 目前LangChain里的大模型是纯文本补全模型,不包含多模态模型.
在把数据输入到AI大模型之前,不论它来源于搜索引擎,向量数据库还是第三方系统接口,都必须对数据进行格式化,转化成大模型能理解的格式.这就是格式化部分做的事情.
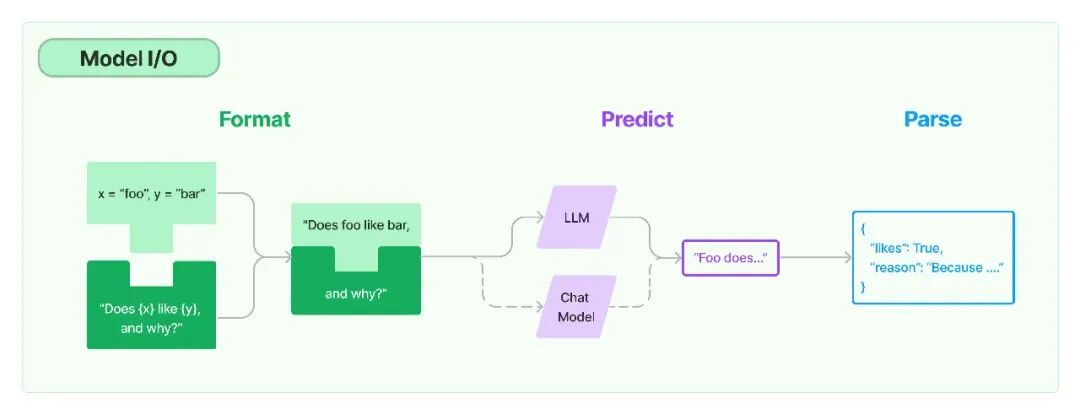
预测是指LangChain原生支持的丰富API,可以实现对各个大模型的调用.
解析主要是对大模型返回的文本内容的解析,随着多模态模型的日益成熟,相信很快就会实现对多模态模型输出结果的解析.
Retrieval
Retrieval可以翻译成检索,抽取,就是从各种数据源中将数据抓取过来,进行词向量化Embedding(Word Embedding),向量数据存储,向量数据检索的过程.结合图片理解整个过程:
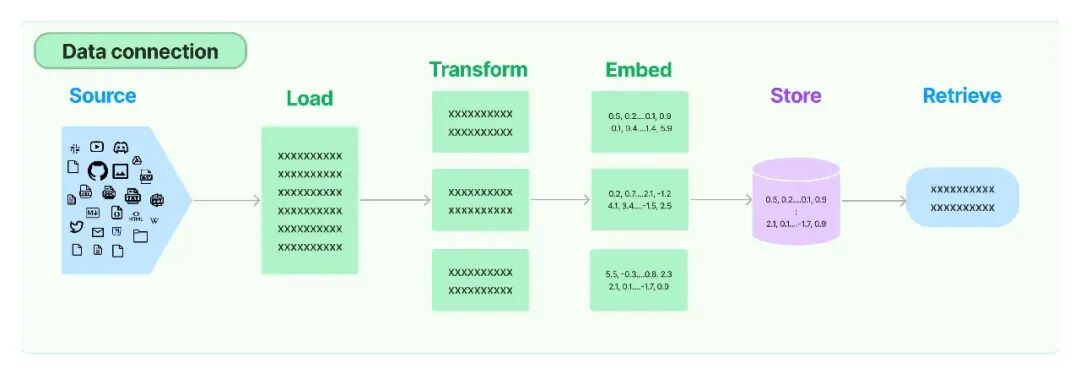
之后会有代码演示各个阶段含义.
Agents
Agents(代理)就是指实现具体任务的模块,比如从某个第三方接口获取数据,用来作为大模型的输入,那么获取数据这个模块就可以称为XXX代理,LangChain本身支持多个类型的代理,当然也可以根据实际需要进行自定义.
Chains
链条就是各种各样的顺序调用,类似于Linux命令里的管道.可以是文件处理链条,SQL查询链条,搜索链条等.LangChain技术体系里链条主要通过LCEL(LangChain表达式)实现.既然是主要使用LCEL实现,那说明还有一部分不是使用LCEL实现的链条,也就是LegacyChain,一些底层的链条,没有通过LCEL实现.
Memory
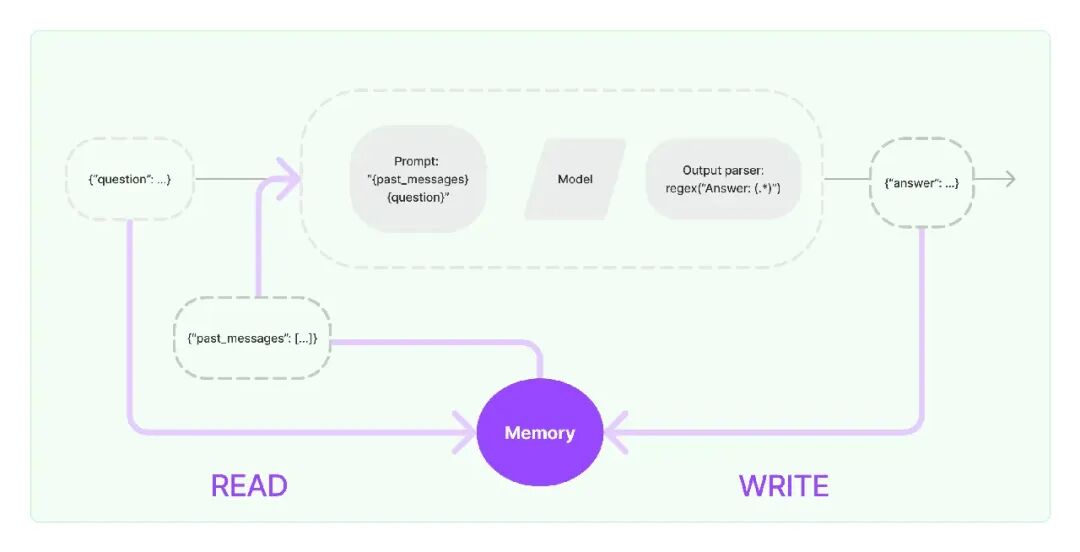
内存是指模型的一些输入和输出,包含历史对话信息,可以放入缓存,提升性能,使用流程和我们软件开发里缓存的使用一样,在执行核心逻辑之前先查询缓存,如果查询到就可以直接使用,在执行完核心逻辑,返回给用户前,将内容写入缓存,方便后面使用.
Callbacks
LangChain针对各个组件提供回调机制,包括链,模型,代理,工具等.回调的原理和普通开发语言里的回调差不多,就是在某些事件执行后唤起提前设置好的调用.LangChain回调有两种: 构造函数回调和请求回调.构造函数回调只适用于对象本身,而请求回调适用于对象本身及其所有子对象.
LCEL
LangChain表达式,前面我们介绍Chains(链)的时候讲过,LCEL是用来构建Chains的,我们看官方的一个例子:
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI
prompt = ChatPromptTemplate.from_template("tell me a short joke about {topic}")
model = ChatOpenAI(model="gpt-4")
output_parser = StrOutputParser()
chain = prompt | model | output_parser
chain.invoke({"topic": "ice cream"})
就像我前面讲到的一样,这里的链和Linux里的管道很像,通过特殊字符|来连接不同组件,构成复杂链条,以实现特定的功能.
chain = prompt | model | output_parser
每个组件的输出会作为下一个组件的输入,直到最后一个组件执行完.当然,我们也可以通过LCEL将多个链关联在一起.
chain1 = prompt1 | model | StrOutputParser()
chain2 = (
{"city": chain1, "language": itemgetter("language")}
| prompt2
| model
| StrOutputParser()
)
chain2.invoke({"person": "obama", "language": "spanish"})
以上就是LangChain技术体系里比较重要的几个核心概念,整个设计思想还是比较简单的,你只要记住两个核心思想.
-
大模型是核心控制器,所有的操作都是围绕大模型的输入和输出在进行.
-
链的概念,可以将一系列组件串起来进行功能叠加,这对于逻辑的抽象和组件复用是非常关键的.
(我:一般还没完全去理解这块的,其实我也理解你,其实就像我们熟悉的编程语言或范式或业务一样,只有手动把这块东西用于demo或使用,才能说明白)
Agent 使用案例–RAG
就像前面讲的,大模型是基于预训练的,一般大模型训练周期1~3个月,因为成本过高,所以大模型注定不可能频繁更新知识.正是这个训练周期的问题,导致大模型掌握的知识基本上都是滞后的,如果我们想要大模型能够理解实时数据,或者把企业内部数据喂给大模型进行推理,我们必须进行检索增强,也就是RAG,检索增强生成.
我们可以通过RAG技术让大模型支持最新的知识索引,先看下技术流程图:
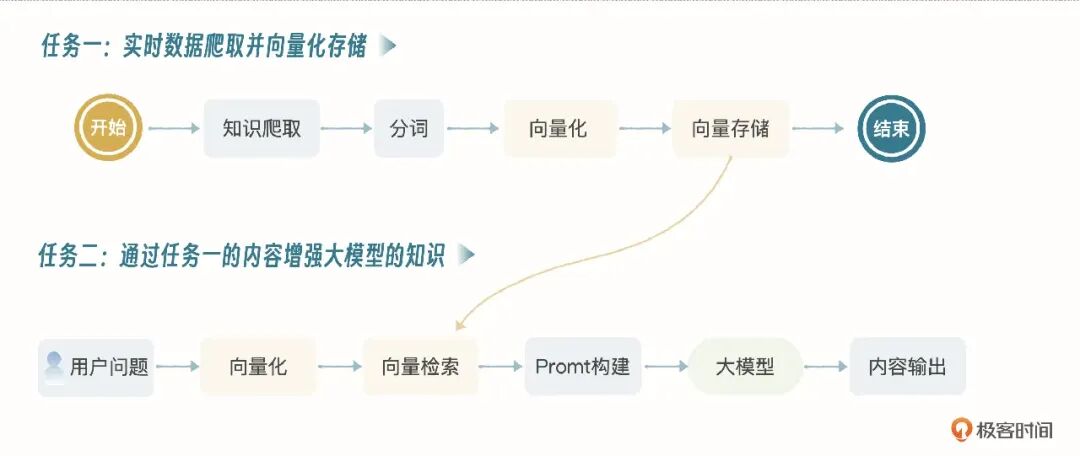
任务一: 先通过网络爬虫,爬取大量的信息,这个和搜索引擎数据爬取过程一样,当然这里不涉及PR(Page Rank)*,只是纯粹的知识爬取,并向量化存储,为了保障我们有最新的数据.
PageRank 是由谷歌创始人拉里·佩奇和谢尔盖·布林在斯坦福大学开发的
一种算法,用于衡量网页的重要性。它是谷歌搜索早期成功的核心基础。
核心思想
PageRank 基于一个简单的假设:重要网页更可能被其他重要网页链接。
可以把它理解为学术引用系统的网络版——一篇论文被越多重要论文引用,
它就越重要。
任务二: 用户提问时,先把问题向量化,然后在向量库里检索,将检索到的信息构成提示,喂给大模型,大模型处理完进行输出.
整个过程涉及两个新的概念,一个叫向量化,一个叫向量存储,先简单理解,向量化就是将语言通过数学的方式进行表达,比如男人这个词,通过某种模型向量化后就变成了类似于下面这样的向量数据:
[0.5,−1.2,0.3,−0.4,0.1,−0.8,1.7,0.6,−1.1,0.9]
注意:此处只是举例,实际使用过程中男人这个词生成的向量数据取决于我们使用的Embedding模型,这个之后会讲解.
向量存储就是将向量化后的数据存储在向量数据库里,常见的向量数据库有Faiss,Milvus,之后实战部分用到Faiss.
通过任务一,二的结合,大模型就可以使用最新的知识进行推理了,当然不一定只有这一种思路,比如我们不采取预先爬取最新的数据的方式,而是实时调用搜索引擎的接口,获取最新数据,然后向量化后喂给大模型,同样也可以获取结果.实际项目中,要综合成本,性能等多方面因素去选择最合适的技术方案.
这节学习了智能体以及LangChain技术体系.智能体很可能在未来一段时间成为AI发展的重要方向,因为大模型实际上是大厂商的游戏(除非未来开发出能够低成本训练和推理的模型),而智能体不一样,普通玩家一样可以入局,而而且现在基本上是一片蓝海.
最后
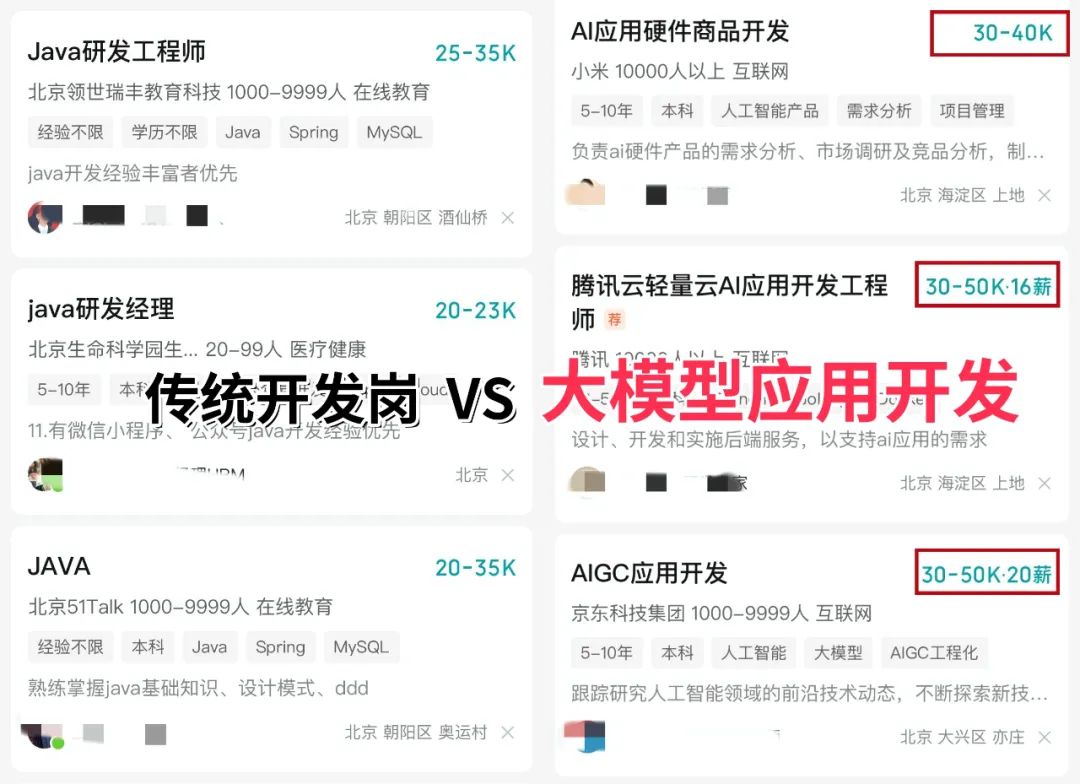
对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?
答案只有一个:人工智能(尤其是大模型方向)
当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应聘者,月基础工资也能稳定在4万元左右。
再看阿里、腾讯两大互联网大厂,非“人才计划”的AI相关岗位应聘者,月基础工资也约有3万元,远超其他行业同资历岗位的薪资水平,对于程序员、小白来说,无疑是绝佳的转型和提升赛道。
如果你还不知道从何开始,我自己整理一套全网最全最细的大模型零基础教程,我也是一路自学走过来的,很清楚小白前期学习的痛楚,你要是没有方向还没有好的资源,根本学不到东西!
下面是我整理的大模型学习资源,希望能帮到你。
👇👇扫码免费领取全部内容👇👇

最后
1、大模型学习路线
2、从0到进阶大模型学习视频教程
从入门到进阶这里都有,跟着老师学习事半功倍。
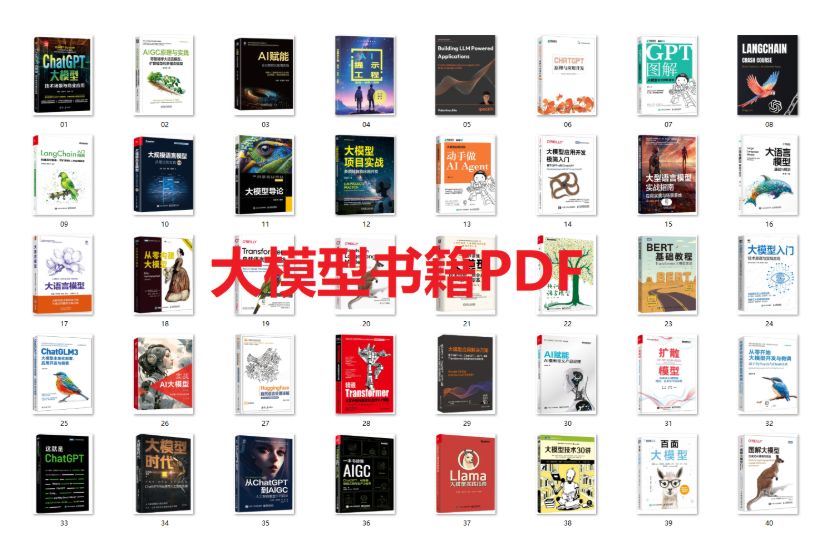
3、 入门必看大模型学习书籍&文档.pdf(书面上的技术书籍确实太多了,这些是我精选出来的,还有很多不在图里)
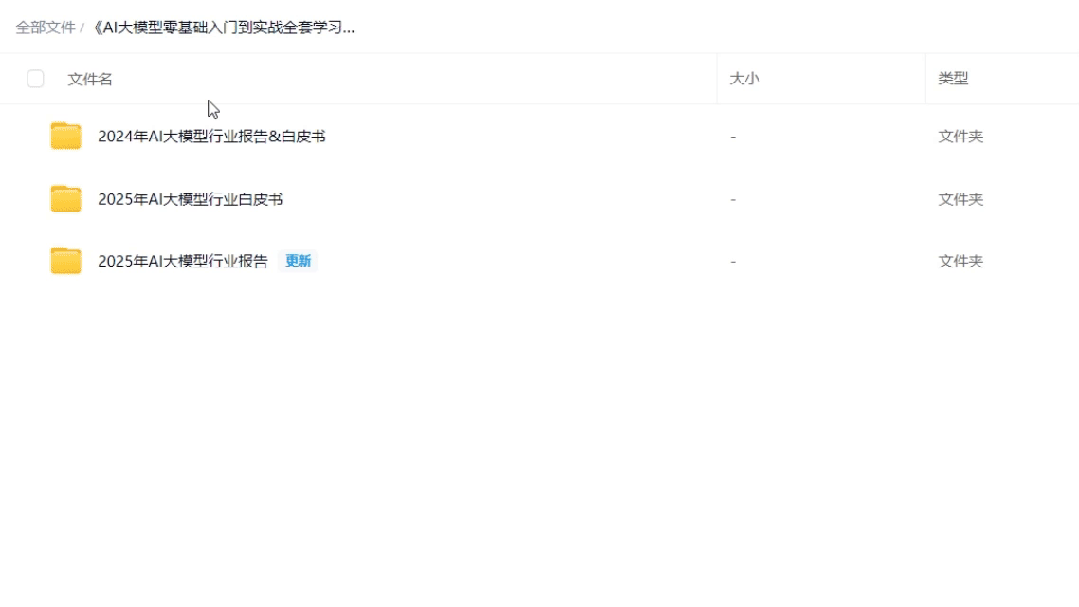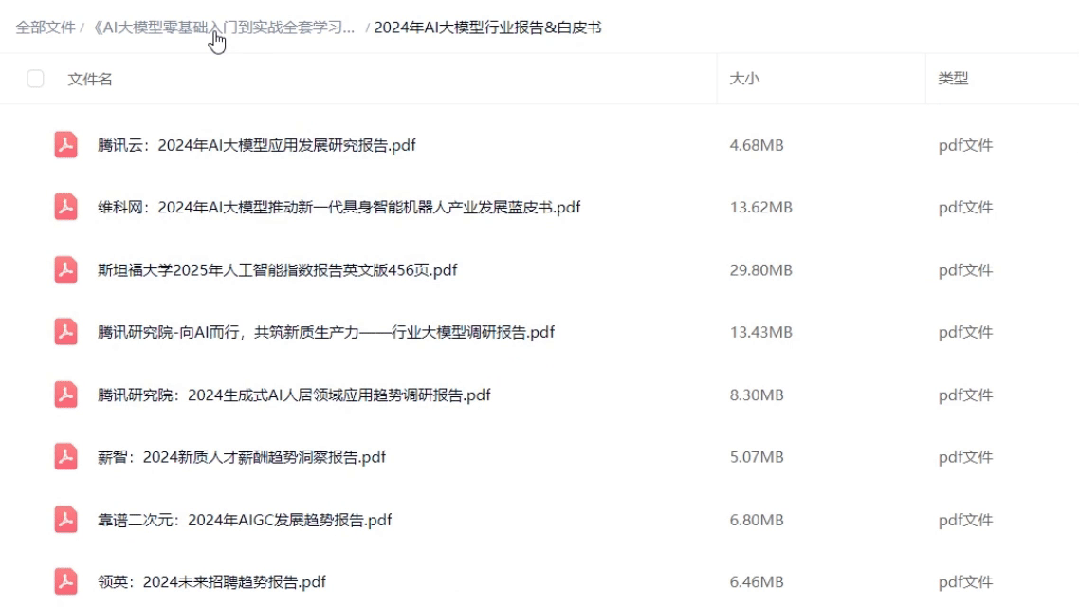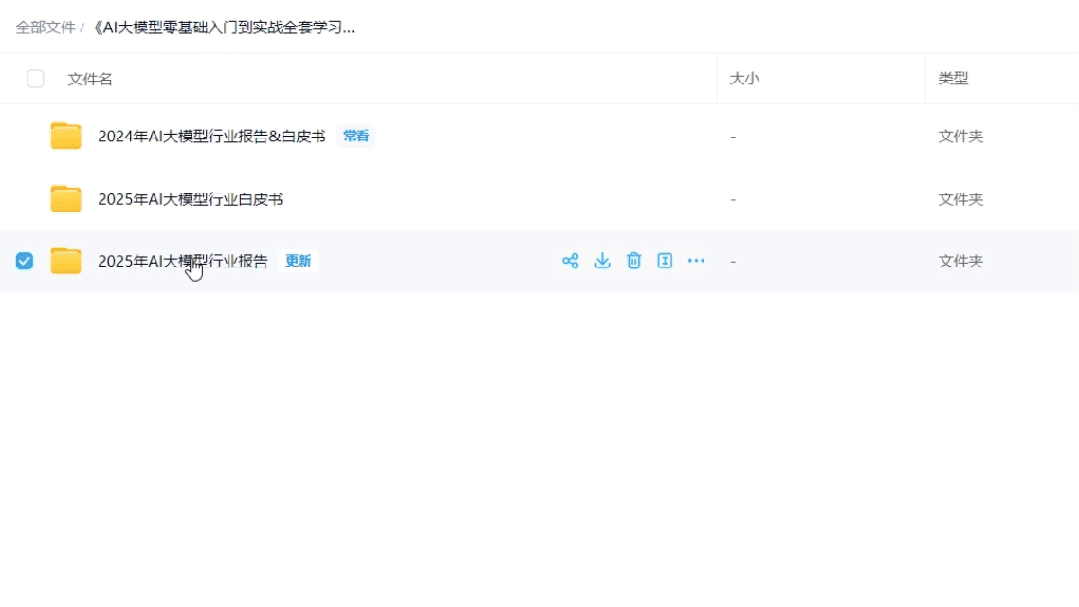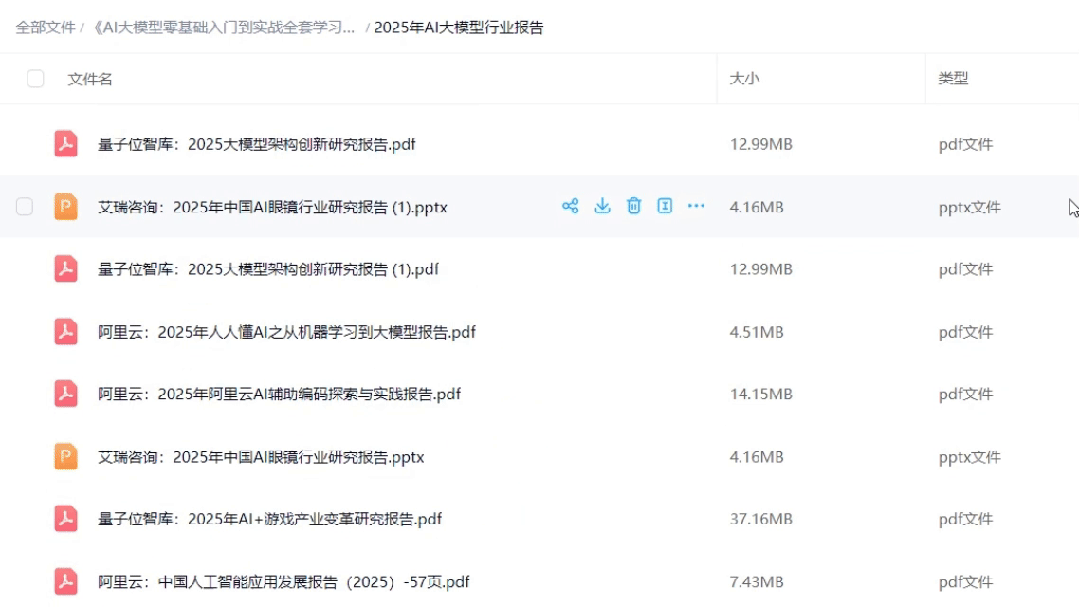
4、 AI大模型最新行业报告
2026最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。
5、面试试题/经验
【大厂 AI 岗位面经分享(107 道)】
【AI 大模型面试真题(102 道)】
【LLMs 面试真题(97 道)】
6、大模型项目实战&配套源码
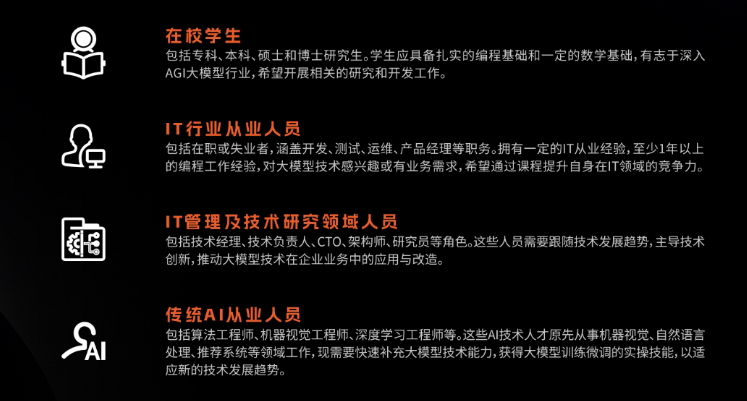
适用人群
四阶段学习规划(共90天,可落地执行)
第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
-
硬件选型
-
带你了解全球大模型
-
使用国产大模型服务
-
搭建 OpenAI 代理
-
热身:基于阿里云 PAI 部署 Stable Diffusion
-
在本地计算机运行大模型
-
大模型的私有化部署
-
基于 vLLM 部署大模型
-
案例:如何优雅地在阿里云私有部署开源大模型
-
部署一套开源 LLM 项目
-
内容安全
-
互联网信息服务算法备案
-
…
👇👇扫码免费领取全部内容👇👇

3、这些资料真的有用吗?
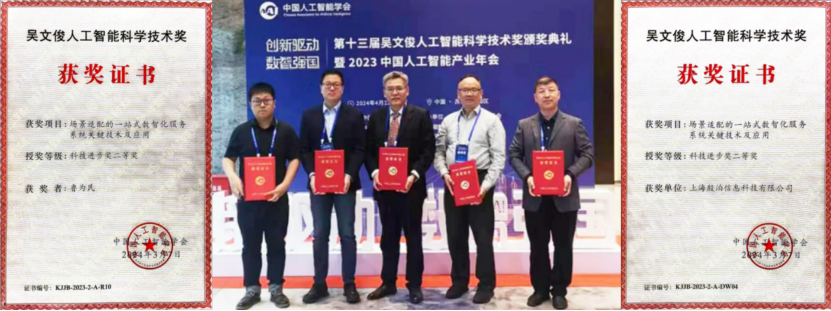
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】


Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 0
 0
- 0


 已为社区贡献165条内容

所有评论(0)