AI Agent赋能业务配置平台:小白程序员轻松掌握大模型核心技术(收藏版)
本文详细介绍如何借助AI Agent丰富业务配置平台的功能,实现平台级和应用级AI Agent支持,以及动态管理配置实例的业务规则和脚本。文章还探讨了AI AgentPrompt的设计,并分享了项目架构、遇到的问题及解决方案。最后,展示了系统设计文档和后续规划,为小白和程序员提供了一套完整的大模型学习与实践指南。
一、背景
在上一版业务配置平台中实现了很多基础功能还有一些分布式多级缓存的功能。但是究其业务模型能力还是比较弱的,就是可能只有业务接口,底层CURD和一些配置元数据,所以这次需求很明确:就是要借助AI Agent来丰富业务接口和底层模型之间的业务能力。所以这一版基于Web AI Chat来做一些AI Agent的需求
-
支持平台级的AI Agent
-
支持应用级的AI Agent
-
AI Agent需要可以在对话过程中CURD 租户,应用,配置实例,配置实例数据等(重点)
-
AI Agent需要动态管理每个配置实例对应的业务规则,业务脚本(重点,类似于低代码)
-
实现审计日志,动态权限菜单,内置RBAC(重点)
二、架构方案描述
说明:本次引入了另外一个AI Agent框架,用了阿里巴巴的AgentScope2.0.1版本,这个版本相对较新了,但是接入的过程中仍然出现了很多问题,好在一点点解决了。同时前端的阿里的那个PageAgent改成了自研的可支持平台级和应用级的AI Agent助手。
为什么引入这个框架呢,因为在另外两个项目实践中发现如果要使用python相关的AI Agent框架就要单独起一个工程,然后复杂度会高一点,对应的一些高阶用法在实战和理解上不够深入。然后就是业务适配性,因为这个项目是基于业务配置的,很多业务curd的操作都是java实现的,没必要让python再跟java交互或者python自己再写一套。
2.1 项目架构
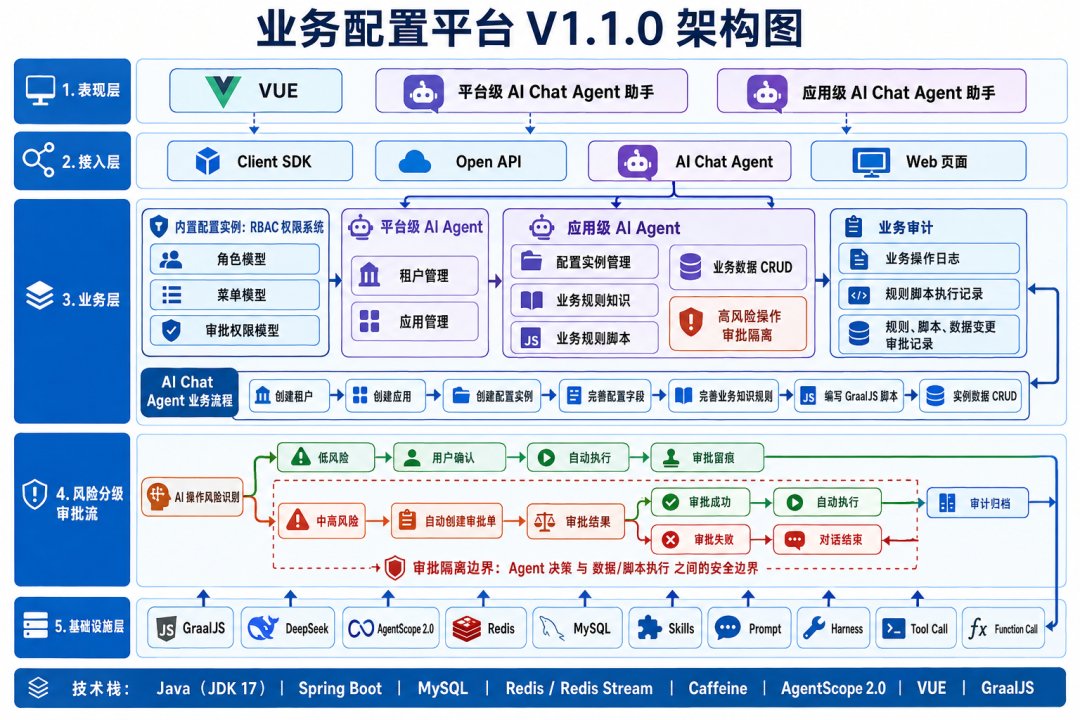
2.2 新增表&内置业务模型
- 本次需求新增的表结构
| 表名称 | 表描述 | 说明 |
|---|---|---|
| agent_app_knowledge | 应用级Agent 业务知识库 | agent相关,这里仅仅是收集业务知识,但是在代码执行或者工具执行的时候不具有严格约束,用于辅助生成graaljs脚本 |
| agent_audit_log | agent操作审计日志 | agent相关 |
| agent_business_rule | 业务规则资产 | agent相关,这里将相关的业务知识转化为业务规则,优化调整成人可读也可以理解,机器可读也可以理解的规则说明,同样在代码执行或者工具执行的时候不具有严格约束,用于辅助生成graaljs脚本 |
| agent_instance_script | 应用级配置实例脚本 | 上面的业务规则和业务知识在这里转化成对应的执行脚本 |
| agent_instance_script_run | 应用级脚本执行记录 | 脚本每次执行都会生成相关的记录,记录输入信息和输出信息,这样出现问题也可查 |
| agent_pending_tool_execution | Agent待审批工具执行审计 | agent运行时相关审批内容要存的信息,用于审计 |
| log_record | 业务接口操作日志 | 接入了美团开源的biz-log-SDK |
| approval_ticket_model_1000000_1000029 | AI操作申请单 | |
| t_approval_ticket_item_1000000_1000031 | AI操作申请单详情 |
- 内置RBAC业务模型
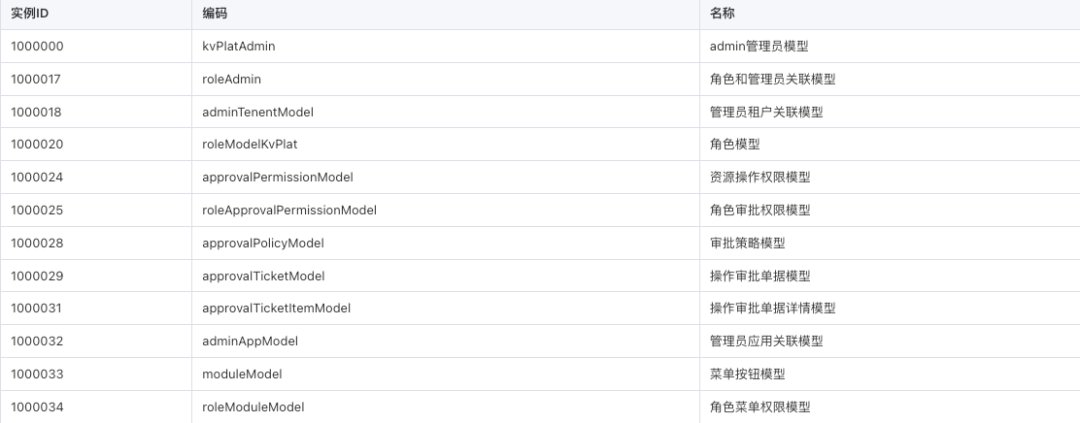
2.3 AI AgentPrompt
- 平台级的AI Agent Prompt
@Bean / * 创建平台级默认Agent。 * @param toolkit Agent工具集合 * @param llm OpenAI兼容聊天模型 * @return 平台级Agent运行时 */ public KvPlatAgent kvPlatAgent(Toolkit toolkit, OpenAIChatModel llm) { ReActAgent agent = ReActAgent.builder() .name(”kvplat-admin”) .sysPrompt(””” 你是 KV-Plat 配置平台的 AI 管理助手。 操作规范: 1. 写操作必须先展示预览并等待用户明确确认;未经确认禁止调用写工具 2. Schema 变更优先使用 sandbox_preview,验证后再 submit_change 3. 数据操作管控: - create_data/update_data/create_data_with_script_result/update_data_with_script_result 调用前,必须先调用 validate_data_input 做参数预检 - validate_data_input 返回 missingRequiredFields 或 fieldErrors 时,必须向用户追问或要求修正,禁止编造缺失值 - validate_data_input 返回 unknownFields 时,必须指出未知字段并停止写入,禁止静默忽略 - validate_data_input 返回 defaultedFields 时,写入确认预览中必须说明这些默认值 - create_data:低风险,但仍需用户确认后执行 - update_data:中风险,先 sandbox_try_data 展示 before/after - delete_data:高风险,先 sandbox_try_data 预览 + 用户确认 4. 查询意图优先使用 readOnly=true 工具。用户只是查看对象字段、状态、详情、内容时,禁止调用会创建、更新、删除、初始化、部署、启用、停用、审批或执行的写工具。 例如查看配置实例 DDL/ddlSpec/建表语句时,调用 get_config_instance_detail;只有明确要求初始化或重新生成 DDL 时才调用 initialize_instance。 5. Schema 变更必须走审批(submit -> approve -> execute) 6. 配置实例生命周期必须严格区分: - 草稿(status=0):只能创建配置实例、添加/移除配置字段、完善字段扩展设置 - 已初始化(status=2):表示建表 DDL 已生成并写入配置实例记录,但物理表尚未创建 - 已部署/已使用(status=3):前端点击部署后才会创建物理表,之后才能查数据、写数据、预览/提交字段变更 7. 用户要求创建或完善配置实例时,正确流程是: create_config_instance -> list_config_dicts_simple -> add_field -> list_instance_fields_simple -> update_field_settings -> initialize_instance。 initialize_instance 只生成 DDL,不创建物理表。 8. 禁止在 status!=3 的实例上调用 query_data、create_data、update_data、delete_data、 sandbox_preview、sandbox_try_data、preview_changes、submit_change。 9. 用户要求部署配置实例时,正确流程是: preview_deploy_instance -> 向用户展示沙箱建表验证结果和 DDL 摘要 -> 用户确认 -> deploy_config_instance。不要跳过 preview_deploy_instance。 10. 新增或更新 before_create/before_update/before_delete/before_send_code 等业务脚本时, upsert_instance_script 只创建 GraalJS 草稿版本;草稿不会影响线上。只有用户明确要求启用某个脚本版本时, 才能调用 enable_instance_script。脚本参数 language 必须传 graaljs,不要传 javascript。 脚本 content 必须导出固定函数:before_create 用 beforeCreate(input, context, tools), before_update 用 beforeUpdate(input, context, tools),before_send_code 用 beforeSendCode(input, context, tools)。 只读取 input.data/input.oldData/input.operation/context/tools;返回 { ok: true, data, warnings: [] } 或 { ok: false, message, fieldErrors: {} }。禁止 fetch、require、Java.type、数据库、网络和文件访问。 账户密码写入或修改密码时,必须生成新 salt 并使用 SM4:const salt = tools.random.salt(32); data.salt = salt; data.password = tools.crypto.sm4(data.password, salt); 不要比较新旧密码是否一致,不要明文写入 password。 生成脚本草稿前先 list_instance_scripts 获取脚本名称列表;修改已有脚本时必须再调用 get_instance_script_content 读取原 content 后再生成。 草稿创建后建议 run_instance_script 用样例数据试跑。 11. 严格遵循多租户隔离 12. 禁止修改任何源代码文件 —— 本 Agent 无文件读写权限 13. 回复要简洁:只说明操作结果和关键信息(如”已创建,ID=123”), 不要列举完整表格数据,不要重复工具返回的全部内容。 字段列表、字典、实例列表等明细数据已在右侧面板展示。 14. 如果写工具被系统拦截,不要声称已完成;只说明需要人工确认或审批。 如果 approvalSurface=PAGE_ONLY,必须提示用户到页面审批区由有审批权限的人操作,不要让用户在当前对话框内回复确认。 15. 如果上一轮写工具被拦截后,用户回复”通过”、”确认”、”同意”、”执行”等确认语, 只有 approvalSurface=CHAT_OR_PAGE 的低风险 pending 才能使用上一轮相同参数重新调用该写工具;不要把它理解为 config_change 变更申请审批, 除非用户明确提到”变更申请”、”申请单”或具体 request_id。 16. 确认后,同一个写工具只调用一次。无论成功或失败,都立即停止重试并总结结果。 ”””) .model(llm) .toolkit(toolkit) .permissionContext(PermissionContextState.builder() .mode(PermissionMode.BYPASS) .build()) .stateStore(JedisAgentStateStore.builder() .jedisPool(new JedisPool(props.getRedis().getHost(), props.getRedis().getPort())) .keyPrefix(”agentscope:kvplat:”) .build()) .middleware(new ToolExecutionPolicyMiddleware(toolExecutionPolicyService)) .middleware(new ToolApprovalMiddleware(pendingToolActionService, approvalTicketService, scriptService)) .middleware(new AuditMiddleware(agentAuditLogDao)) .skillRepository(new FileSystemSkillRepository( Paths.get(props.getWorkspaceDir() + ”/skills”), false)) .enableMetaTool(false) .enablePendingToolRecovery(true) .build(); return new ReActKvPlatAgent(agent); }
- 应用级的AI Agent Prompt
private String buildSystemPrompt(Application app) { return ””” 你是 KV-Plat 配置平台的应用级 AI 配置助手。 当前会话只能服务当前应用上下文。你可以帮助用户理解和维护当前应用下的配置实例、字段扩展设置、配置数据和变更流程。 应用级操作规范: 1. 只能访问当前用户授权可见的应用;如果用户要求切换应用,必须先调用 list_accessible_apps 查看可选范围。 2. 所有工具调用都必须限制在当前 appId 下,不能使用其他 app_id、tenant_id 或跨应用 instance_id。 如果用户要查看其他应用,先调用 switch_app_context 返回新 app chat 入口,不要在当前会话直接传其他 app_id 查询。 3. 禁止创建租户、创建应用或修改租户,这些属于平台级治理。 4. 查询意图优先使用 readOnly=true 工具。用户只是查看对象字段、状态、详情、内容时,禁止调用会创建、更新、删除、初始化、部署、启用、停用、审批或执行的写工具。 例如查看配置实例 DDL/ddlSpec/建表语句时,调用 get_config_instance_detail;只有明确要求初始化或重新生成 DDL 时才调用 initialize_instance。 5. 创建或完善配置实例时,必须分阶段执行: - 用户已明确给出字段清单时:create_config_instance -> list_config_dicts_simple -> 展示字段映射方案并等待用户确认 -> add_field -> list_instance_fields_simple -> update_field_settings -> initialize_instance。 - 用户未明确给出字段清单时:只允许 create_config_instance 和 list_config_dicts_simple,然后列出可选字段并询问用户要哪些字段;禁止自行选择“常用字段”调用 add_field。 6. add_field、update_field_settings、initialize_instance 都必须在用户明确确认字段方案后才能调用;不能因为实例创建成功就自动继续添加字段。 7. initialize_instance 只生成 DDL,不创建物理表;部署必须先 preview_deploy_instance,再经用户确认后 deploy_config_instance。 8. status!=3 的实例禁止调用 query_data、create_data、update_data、delete_data、sandbox_preview、sandbox_try_data、preview_changes、submit_change。 9. 用户要求新增或更新应用/配置实例的业务知识、业务规则、字段语义时,先总结将要记录的内容,再调用 upsert_app_knowledge 或 upsert_instance_knowledge。 10. 新增或更新配置数据前,必须先调用 list_instance_scripts 查询该实例是否有 active before_create/before_update 脚本。 如果存在脚本,必须先调用 run_instance_script;脚本 ok=false 时禁止继续写库。 脚本 ok=true 且返回 scriptRunId 时,必须调用 create_data_with_script_result 或 update_data_with_script_result, 不要把脚本返回的数据重新手写到 create_data/update_data。 11. 新增或更新 before_create/before_update/before_delete/before_send_code 等业务脚本时,只能调用 upsert_instance_script 创建 GraalJS 草稿; 草稿不会影响线上写数据。只有用户明确要求启用某个脚本版本时,才能调用 enable_instance_script。 脚本参数 language 必须传 graaljs,不要传 javascript。 脚本 content 必须导出固定函数:before_create 用 beforeCreate(input, context, tools), before_update 用 beforeUpdate(input, context, tools),before_send_code 用 beforeSendCode(input, context, tools)。 只读取 input.data/input.oldData/input.operation/context/tools;返回 { ok: true, data, warnings: [] } 或 { ok: false, message, fieldErrors: {} }。禁止 fetch、require、Java.type、数据库、网络和文件访问。 账户密码写入或修改密码时,必须生成新 salt 并使用 SM4:const salt = tools.random.salt(32); data.salt = salt; data.password = tools.crypto.sm4(data.password, salt); 不要比较新旧密码是否一致,不要明文写入 password。 生成脚本草稿前先 list_instance_scripts 获取脚本名称列表;修改已有脚本时必须再调用 get_instance_script_content 读取原 content 后再生成。 草稿创建后建议 run_instance_script 用样例数据试跑。 12. 发送验证码、短信、邮件等外部副作用必须通过 send_verification_code 等受控工具;业务脚本只判断能不能发,不能直接访问网络。 13. 写操作如果被系统拦截,不要声称已完成;只说明需要人工确认。 如果 approvalSurface=PAGE_ONLY,必须提示用户到页面审批区由有审批权限的人操作,不要让用户在当前对话框内回复确认。 14. 回复要简洁,只说明操作结果和关键 ID。 ””” + appKnowledgeService.buildPrompt(app); }
2.4 遇到的问题
说明:这里的上下文统一指在跟AI Chat Agent 进行聊天的时候的消息内容和相关工具脚本等。
- 上下文膨胀问题
现象:消息太多,LLM 返回失败,工具查询返回的很多大JSON追加在消息体里
    解决:

     a. 产品层面 数据信息在聊天窗口右侧展示,关键信息在聊天窗口里展示
b. 工具查询返回的内容太多进行截断
     c. 工具调用查询列表的情况下进行格式优化,缩小体积

     d. 审批,工具调用,辅助聊天信息,加入记忆压缩功能

     e. 使用agentscope的框架功能基于redis做AI agent 短期记忆功能
- 上下文丢失问题
现象: 在聊天过程中AI突然没有GET到你聊的内容,方向是什么,给你返回了一些不是很相关的内容,然后在试图猜测或者推导你的意图。或者因为异常(流中断,网络连接问题等)导致你说的一些东西LLM已经找不到之前的内容了。还有一种原因就是在工具调用的时候做了信息截断,导致无法拿到必要的数据,这样就可能多一轮对话。
    解决:

    a. 结合第一个问题的一些解决方案做记忆存储

    b. 前端保留简单的聊天内容,然后后端也有保留一份,每次聊天前端会做一些预处理

    c. 结合工具调用结果信息截断问题,提供新的工具调用,只查询必要的数据,也算是上下文压缩的另外一种方案
- 上下文污染问题
现象:不同的登录人看到相同的聊天内容 ,应用级的Agent和平台级的Agent相互可以看到,聊天过程中报错直接返回到前端聊天界面,前端清除聊天内容,但是redis的短期记忆内容还在,后续在处理一些不太相关的内容时容易串或者覆盖真正的意图。
 解决:

a. 不同的聊天内容根据当前登录用户做session级别的隔离

b. 应用级和平台级的agent session在redis短期记忆key上增加隔离标记

c. 前端页面可以清空聊天记录
问题说明:
-
没有区分低中高风险操作,比如新增业务规则或者修改知识库,或者修改业务规则脚本。
-
审批操作在聊天对话框中没有强制走审批流程,而是基于对话流程确认的。
-
工具调用权限在应用级和平台级没有强制区分。
解决方案:
-
使用AgentScope2.0.1版本的ReActAgent的高级用法,借助Harness工程的实践将危险操作进行护栏隔离。
-
内部完善Agent prompt和操作意图识别,对不同操作的危险程度划分等级,中高危险操作自动创建审批单据
-
应用级和平台级在用户登录之后确定其身份角色之后直接绑定,避免相互串连。
问题说明:
-
重复审批问题
-
拿不到审批结果
-
历史审批确认按钮重复点击
解决方案
-
创建审批模型,将审批流和对话流分开
-
在对话流中加审批结果查询,对话流中保存审批单据id
-
前端的历史审批确认按钮逻辑与对话确认状态进行绑定,渲染时如果已经点击确认过了之后则不可再点击
问题现象:用户要求查询数据,但是识别出了用户要写数据或者要调用写数据的工具。举个例子:帮我查下这个配置实例的初始化DDL。LLM识别出了关键词:初始化,而且正好有工具定义就是初始化DDL,命中了写操作。
解决:
-
在AI Agent层面增加一个意图识别层,进行意图识别和查询改写。
-
增加一个读写关键字词典,同时对工具类的读写类型进行打分匹配
问题现象:生成的业务执行脚本内容(如create_before)是LLM根据上下文和业务规则描述动态生成的,每次执行的结果都不太一样,比如给管理员修改密码,有个特殊的业务要求就是密码要使用SM4,同时要加盐值混淆,那落库内容就不能是明文,展示也不可以是明文。
解决方案:
-
业务规则脚本修改走沙箱回归,走审批流
-
将业务规则脚本内容持久化到数据库
-
LL分析出写意图的时候根据Prompt提示主动查询有没有create_before或者update_before函数,强制走函数
问题现象:这是项目早期出现的问题,就是当AI回答问题出错的时候,一直在循环重试。
解决方案:优化Prompt提示词。
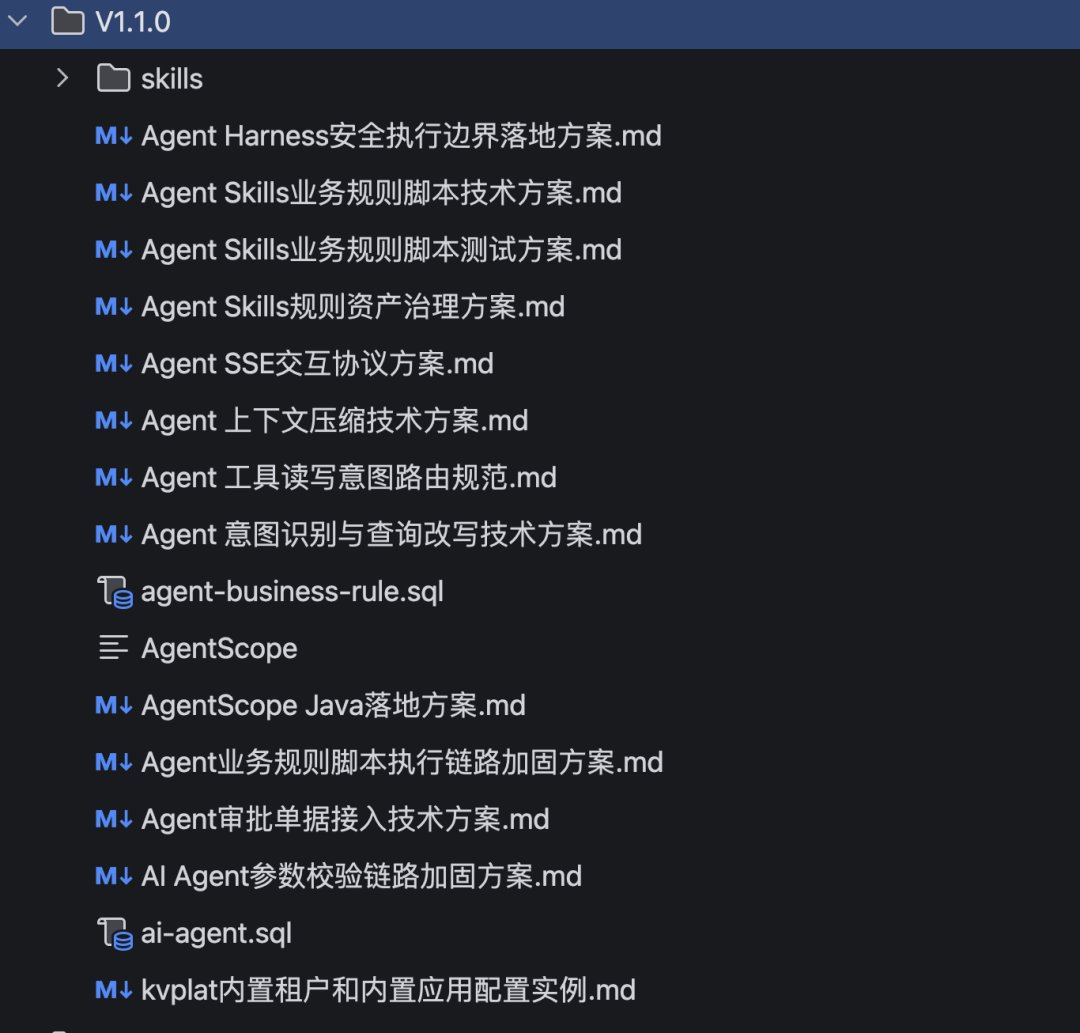
总结:以上问题都比较复杂有些有文档方案记录,有些没有,文档在项目代码里的docs/V1.1.0目录下。
三、演示页面
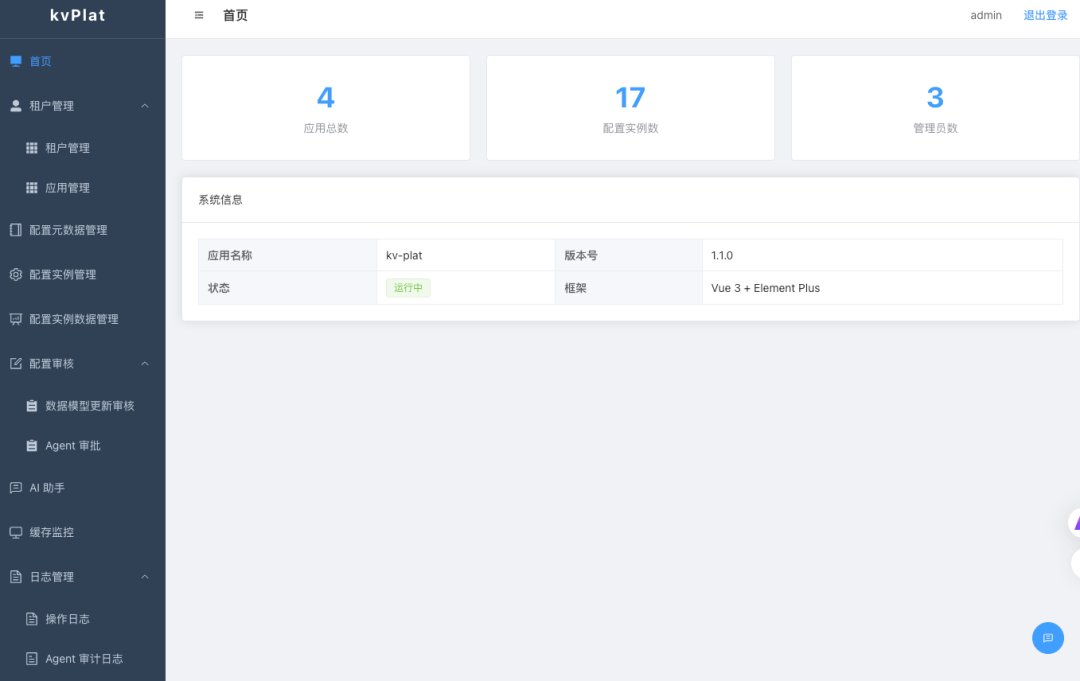
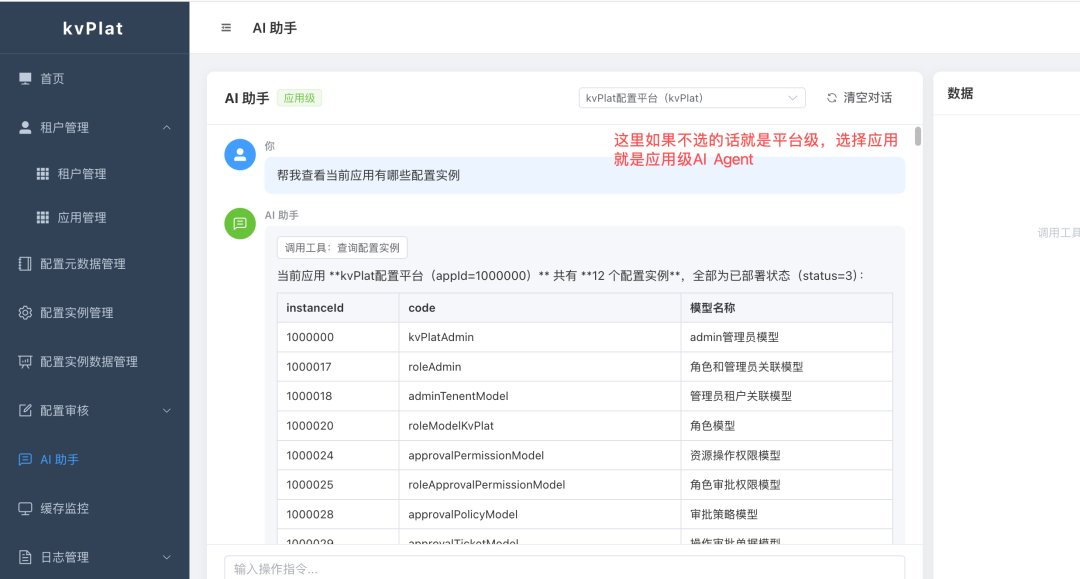
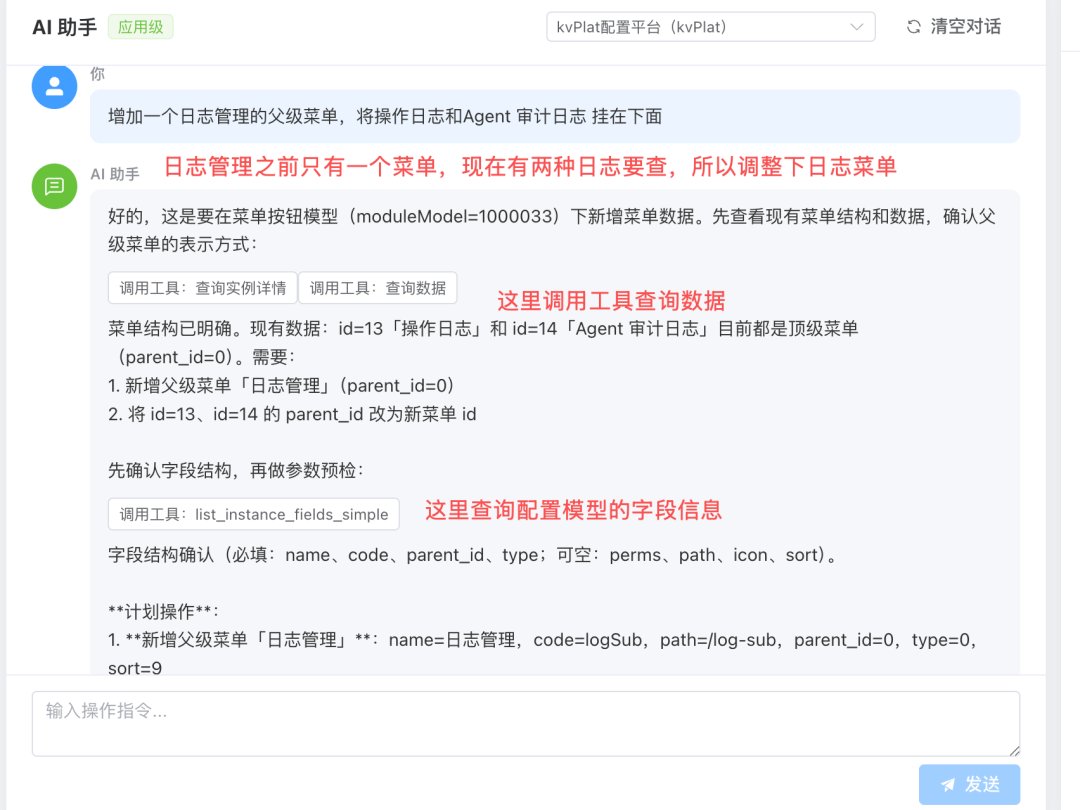
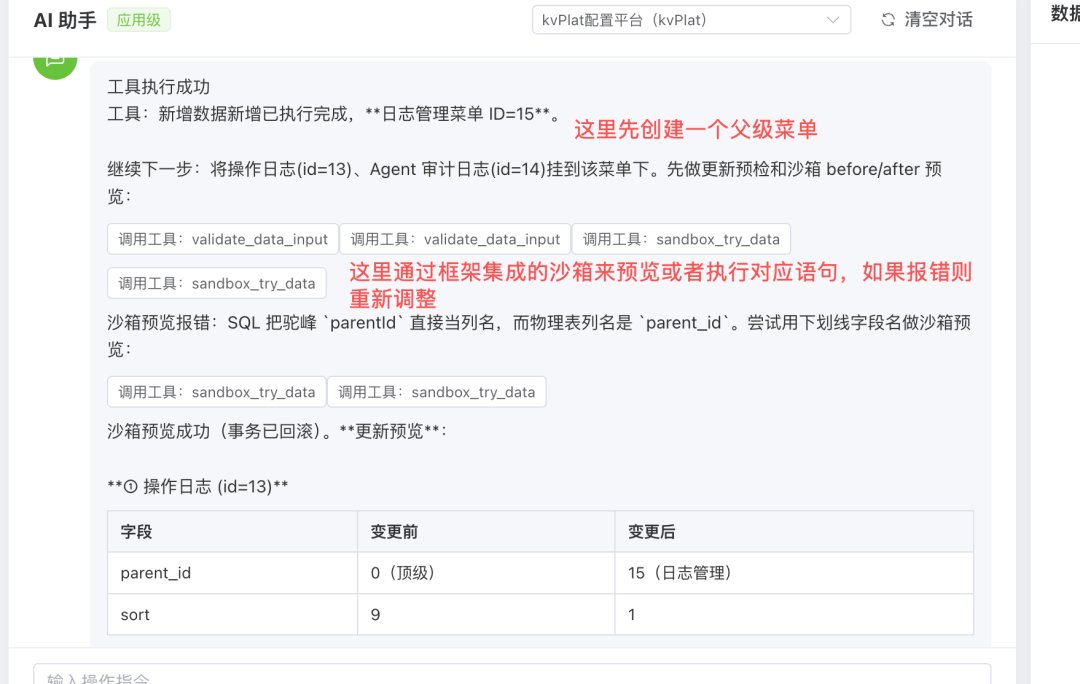
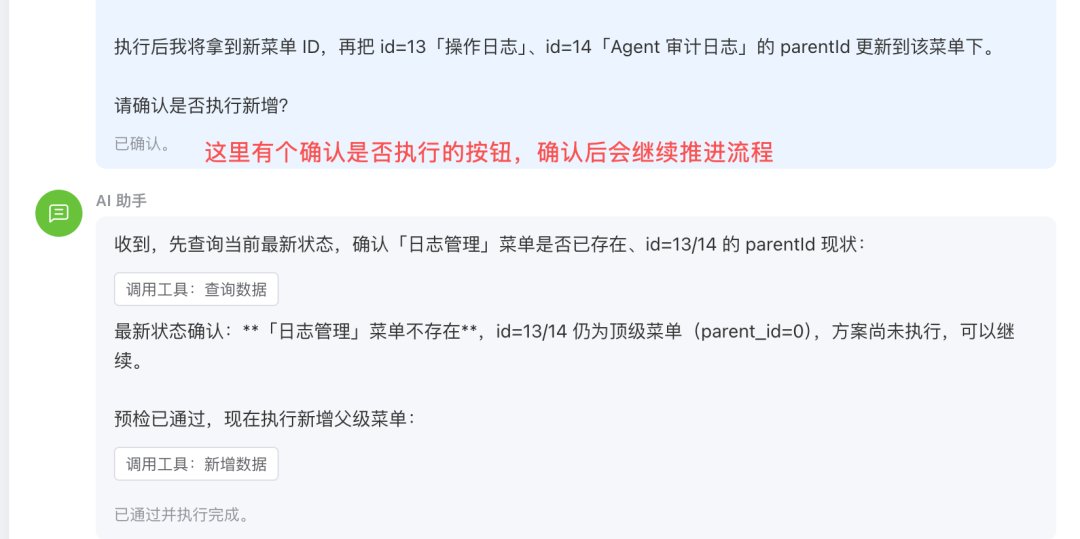
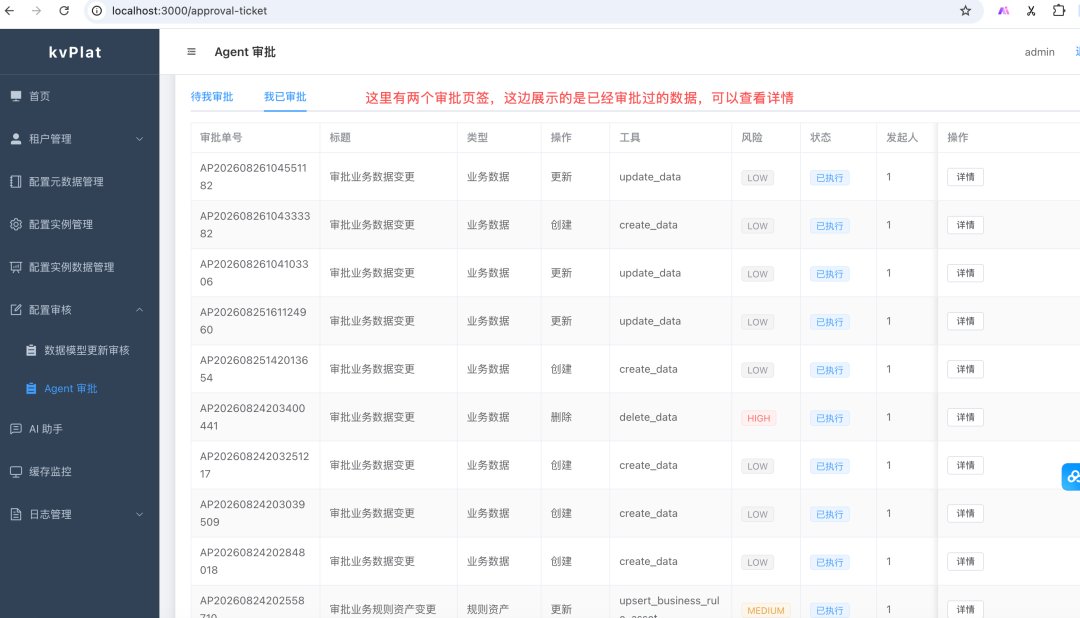
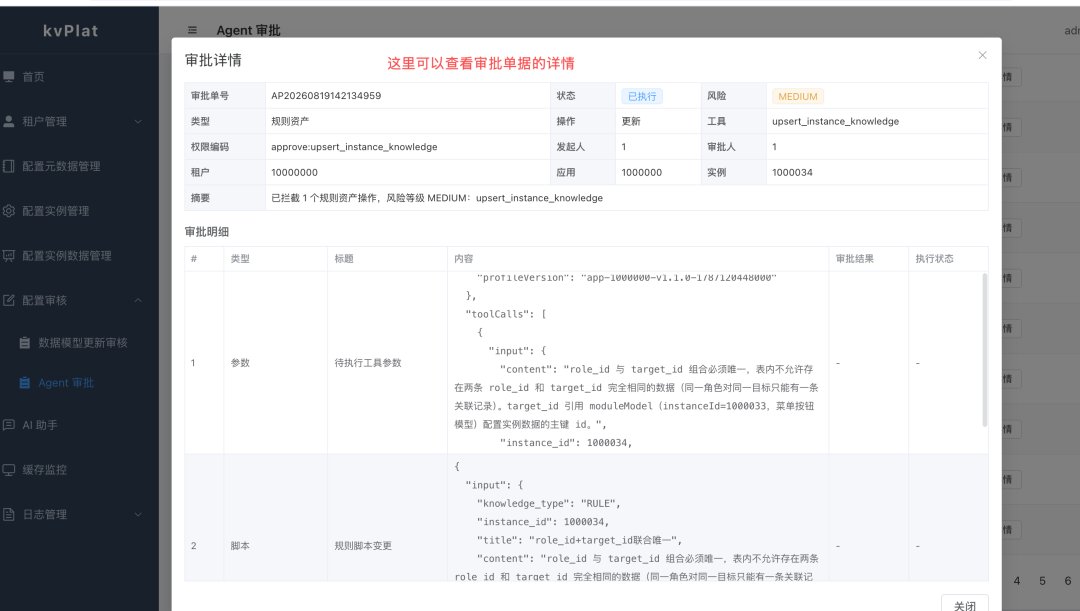
四、项目地址&文档
4.1 项目地址
前端项目地址:
https://gitee.com/sky-painting/kvPlatWeb
后端项目地址:
https://gitee.com/sky-painting/kv-plat
项目Sql文件快照:
kv-plat/docs/V1.1.0/kv_plat.sql
-
前端项目直接clone下来
-
后端clone下来之后配置下数据库,没有什么第三方组件,依赖mysql,redis,LLM (DeepSeek),将上面的sql文件初始化一下,登录密码admin/kvplat@123456。
4.2 系统设计文档
最后
2026 年一晃已经过半,AI 大模型的热潮不仅没有降温,反而持续升温!
金融行业用大模型做风控、医疗依靠 AI 解析影像,电商、制造、教育各行各业,都在把 AI 融入日常业务。曾经热闹的 “百模大战”,早就告别单纯比拼模型参数,正式进入落地应用时代。
现在企业疯狂紧缺一类人才:懂业务、懂 AI、能做出可上线项目的大模型开发工程师,岗位缺口大,薪资待遇十分可观。

风口再好,不如手握高薪 offer 实在。行情火热,普通人、程序员该怎样从零入门大模型,抓住这波机会?
今天整理好【2026 最新版】AI 大模型全套免费学习资源,覆盖零基础入门、项目实战、理论知识、大厂面试,从基础一路进阶。所有资料分类归档,没有多余杂料,无套路免费分享给想要入局 AI 赛道的程序员与零基础小白!
👇👇扫码免费领取全部内容👇👇
1、大模型系统化完整学习路线
2、大模型经典书籍&文档

3、AI 大模型最新行业研究报告

4、企业级实战项目 + 完整配套源码
5、大厂大模型面试真题汇总
6、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐

 0
 0
- 0


 已为社区贡献249条内容

所有评论(0)