2026年AI Agent开发从入门到精通:小白必学收藏版学习路线图
本文详细介绍了AI Agent开发的学习路线,分为四个阶段:AI基础与编程入门、Agent框架入门、生产级Agent工程和架构设计。内容涵盖了Python编程、LLM基本原理、主流Agent框架如LangChain、CrewAI等的使用,以及生产级Agent开发的可靠性工程、上下文管理、MCP协议集成、多Agent协作等关键技术。文章还提供了实战项目路线和推荐工具栈,旨在帮助读者从零基础成长为AI Agent开发专家。
AI Agent 是 2025-2026 年最热门的技术方向。本文提供一条从零基础到专家的系统学习路径,涵盖理论基础、工程实践、架构设计和生产部署四大阶段。
一、为什么是现在?
AI Agent(智能体)正在从实验性技术走向生产级应用。不仅仅是聊天机器人,Agent 是能自主感知环境、做出决策、执行行动的智能系统。
2025-2026 年的关键变化:
- 工具调用(Tool Calling)成为模型标配:Claude、GPT、DeepSeek 等主流模型原生支持函数调用
- MCP(Model Context Protocol)协议标准化:Anthropic 推出的开放协议让 Agent 与外部工具的连接标准化
- 多智能体协作框架成熟:从单 Agent 到多 Agent 协作,复杂度可控
- 生产级可靠性提升:检查点恢复、错误重试、观察性等基础设施完善
这个领域不再只是科研方向,而是有明确工程落地路径的技能方向。
二、学习路线总览
整条路径分为 四个阶段,每个阶段都有明确的目标和产出物:
| 阶段 | 名称 | 周期 | 目标产出 |
|---|---|---|---|
| 一 | AI 基础与编程入门 | 2-3 周 | 能用 Python 调 LLM API |
| 二 | Agent 框架入门 | 3-4 周 | 能搭建一个能用的单 Agent 工具 |
| 三 | 生产级 Agent 工程 | 4-6 周 | 能构建可靠的多 Agent 系统 |
| 四 | 架构设计与专家之路 | 持续 | 能设计企业级 Agent 架构 |
三、阶段一:AI 基础与编程入门(2-3 周)
3.1 编程基础
虽然 AI Agent 开发有多语言选择,Python 是绝对的主流。
需要掌握的 Python 知识:
- 基础语法:变量、函数、类、装饰器、生成器
- 异步编程:
async/await、asyncio事件循环 - 网络请求:
requests、httpx、WebSocket - 数据格式:JSON、YAML、Markdown
推荐资源:
- Python 官方教程(快速过一遍基础)
- Real Python 网站的异步编程系列
3.2 理解 LLM 基本原理
你不需要训练模型,但需要理解它们的工作原理:
- Token 与上下文窗口:理解 token 的概念、上下文长度对 Agent 的限制
- System Prompt 与指令遵循:这是 Agent 行为的核心控制手段
- Temperature 与采样参数:控制输出的随机性和创造性
- 结构化输出(JSON mode):让模型返回可解析的结构化数据
3.3 初次调用 LLM API
从最简单的调用开始:
from openai import OpenAI

client = OpenAI(api_key="your-key")

response = client.chat.completions.create(
    model="gpt-4o",
    messages=[
        {"role": "system", "content": "你是一个智能助手。"},
        {"role": "user", "content": "写一个 Python 函数来计算斐波那契数列。"}
    ]
)

print(response.choices[0].message.content)
练手项目:
- 一个简单的聊天机器人
- 一个能格式化输出 JSON 的数据提取工具
- 一个通过 system prompt 控制角色风格的对话系统
3.4 理解 Tool Calling(函数调用)
Tool Calling 是 Agent 的核心能力。模型不是直接调用函数,而是输出一个函数调用的描述,由你的代码来实际执行。
tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "获取指定城市的天气",
        "parameters": {
            "type": "object",
            "properties": {
                "city": {"type": "string", "description": "城市名称"}
            },
            "required": ["city"]
        }
    }
}]

response = client.chat.completions.create(
    model="gpt-4o",
    messages=[{"role": "user", "content": "北京今天天气怎么样?"}],
    tools=tools
)
关键理解:
- 模型输出
tool_calls→ 你的代码解析参数 → 调用实际函数 → 返回结果给模型 - 这就是 Agent “行动” 的本质:推理 → 调用 → 观察 → 继续推理
阶段一产出:一个能用自然语言调用自定义工具的对话程序。
四、阶段二:Agent 框架入门(3-4 周)
4.1 了解主流 Agent 框架
| 框架 | 特点 | 适合场景 |
|---|---|---|
| LangChain / LangGraph | 生态最丰富,文档最全 | 入门学习、原型开发 |
| CrewAI | 多 Agent 协作开箱即用 | 团队协作类场景 |
| AutoGen (Microsoft) | 多 Agent 对话 | 研究型多 Agent 交互 |
| Semantic Kernel (Microsoft) | .NET 生态 | 企业 .NET 环境 |
| Hermes Agent | 开源、轻量、生产级 | 个人 AI 助理、生产部署 |
| Claude Code / Codex | IDE 集成 | 编程辅助场景 |
推荐从 LangChain 入门,因为生态最大、教程最多、踩坑资料也最全。
4.2 LangChain 入门
from langchain_openai import ChatOpenAI
from langchain.agents import create_tool_calling_agent, AgentExecutor
from langchain.tools import tool

@tool
def search_knowledge_base(query: str) -> str:
    """搜索知识库"""
    return f"关于 '{query}' 的搜索结果..."

llm = ChatOpenAI(model="gpt-4o")
agent = create_tool_calling_agent(llm, [search_knowledge_base])
agent_executor = AgentExecutor(agent=agent, tools=[search_knowledge_base])

result = agent_executor.invoke({"input": "帮我查一下最新的 AI Agent 框架"})
print(result["output"])
核心概念:
- Tool:Agent 能使用的工具
- Agent:决定下一步做什么的推理引擎
- Executor:执行循环的运行时
- Memory:对话记忆管理
- Callback:事件回调用于监控和日志
4.3 Prompt Engineering 精要
Agent 的性能很大程度上取决于 Prompt 设计:
你是一个智能助手,拥有以下工具:
{tools}

你的工作流程:
1. **分析用户输入,理解意图**

2. **如果需要工具,输出工具调用**

3. **收到工具结果后,综合回答用户**

重要规则:
- 不要编造工具返回的数据
- 如果工具返回空结果,如实告知用户
- 每一步都要输出你的思考过程
核心原则:
- 给予角色:明确告诉 Agent 它是什么、能做什么
- 提供示例:Few-shot 示例显著提升工具调用准确率
- 约束边界:明确告诉 Agent 不能做什么
- Chain of Thought:让 Agent 输出推理过程再行动
4.4 构建你的第一个完整 Agent
从做一个个人助手 Agent 开始:
- 天气查询工具
- 日程管理工具(增删改查)
- 记事本工具
- 简单记忆功能
练手项目:
- 一个能管理 Todo List 的 Agent
- 一个能查询知识库并回答问题的 RAG Agent
- 一个能定时提醒的 Agent
阶段二产出:一个运行在本地的、有 3-5 个工具的完整 Agent。
五、阶段三:生产级 Agent 工程(4-6 周)
这是最有价值也最容易被忽视的阶段。写一个 demo Agent 很简单,但做一个生产可用的 Agent 非常难。
5.1 可靠性工程
问题:LLM 天然不可靠,同样的输入可能给出不同的输出。
解决方案:
a. 重试与退避
import time
from tenacity import retry, stop_after_attempt, wait_exponential

@retry(stop=stop_after_attempt(3), wait=wait_exponential(multiplier=1, min=2, max=10))
def call_llm_with_retry(messages, tools=None):
    return client.chat.completions.create(
        model="gpt-4o",
        messages=messages,
        tools=tools
    )
b. 结构化输出校验
import json
from pydantic import BaseModel, ValidationError

class ToolCallOutput(BaseModel):
    tool_name: str
    arguments: dict

def parse_tool_call(raw: str) -> ToolCallOutput:
    try:
        return ToolCallOutput(json.loads(raw))
    except (json.JSONDecodeError, ValidationError) as e:
        # 让模型重新输出
        return retry_parse(raw)
c. 检查点与状态恢复
Agent 运行过程中可能随时中断(网络超时、API 错误、服务器重启)。检查点系统是生产级 Agent 的必备基础设施:
import json, os
from datetime import datetime

class CheckpointManager:
    def __init__(self, agent_id: str):
        self.agent_id = agent_id
        self.dir = f"./checkpoints/{agent_id}"
        os.makedirs(self.dir, exist_ok=True)

    def save(self, step: int, state: dict):
        path = f"{self.dir}/step_{step}.json"
        state["saved_at"] = datetime.now().isoformat()
        with open(path, "w") as f:
            json.dump(state, f)

    def load(self, step: int) -> dict:
        path = f"{self.dir}/step_{step}.json"
        with open(path) as f:
            return json.load(f)
5.2 上下文管理
Agent 的核心挑战之一是上下文窗口有限。优雅的上下文管理直接决定 Agent 的可用性。
策略:
1. **滑动窗口:保留最近的 N 轮对话**

2. **摘要压缩:对早期对话做总结**

3. **分层记忆:**

- 短期记忆:当前对话
   - 工作记忆:当前任务相关
   - 长期记忆:持久化知识库
4. **向量检索:用 embedding 检索相关历史**
class HierarchicalMemory:
    def __init__(self, max_short_term: int = 20):
        self.short_term = []  # 当前对话
        self.working = {}  # 当前任务状态
        self.long_term = []  # 持久化知识

    def add_to_short_term(self, message: dict):
        self.short_term.append(message)
        if len(self.short_term) > self.max_short_term:
            # 压缩早期对话
            summary = self.summarize(self.short_term[:-10])
            self.long_term.append(summary)
            self.short_term = self.short_term[-10:]
5.3 MCP 协议集成
MCP(Model Context Protocol)正在成为 Agent 工具集成的标准方式。它定义了一套统一的协议,让 Agent 能动态发现和使用工具。
MCP Server 示例:
from mcp.server import Server

server = Server("my-tools")

@server.tool()
async def get_stock_price(symbol: str) -> dict:
    """获取股票实时价格"""
    return {"symbol": symbol, "price": 100.0}

server.run()
优势:
- 工具发现(Tool Discovery)是动态的
- 类型安全的参数校验
- 统一的认证和错误处理
- 支持远程工具调用
5.4 多 Agent 协作
当单个 Agent 能力不足时,引入多 Agent 协作:
- 主管-员工模式:一个主管 Agent 分配任务给多个专业 Agent
- 评委模式:多个 Agent 对同一问题投票
- 流水线模式:Agent A 的输出作为 Agent B 的输入
class SupervisorAgent:
    """主管 Agent:接收任务,分配子任务,汇总结果"""
    def __init__(self):
        self.workers = {
            "researcher": ResearchAgent(),
            "writer": WriteAgent(),
            "reviewer": ReviewAgent()
        }

    async def run(self, task: str):
        plan = await self.plan_task(task)
        results = {}
        for step in plan:
            worker = self.workers[step.agent]
            result = await worker.execute(step.task)
            results[step.name] = result
        return await self.synthesize(results)
5.5 可观测性与调试
Agent 的"黑盒"特性让调试变得困难。必须建立完整的可观测性体系:
import logging

class AgentTracer:
    def __init__(self):
        self.logger = logging.getLogger("agent")

    def trace(self, step: str, input_data: dict, output_data: dict):
        self.logger.info(json.dumps({
            "step": step,
            "input": input_data,
            "output": output_data,
            "tokens": output_data.get("usage", {}),
            "timestamp": datetime.now().isoformat()
        }))
追踪什么:
- 每轮 LLM 调用的输入/输出
- 工具调用的参数和结果
- 决策路径(为什么选这个工具)
- Token 消耗和延迟
- 错误和重试记录
5.6 安全与防护
生产级 Agent 必须考虑安全:
- 权限控制:Agent 只能访问授权的工具和数据
- Prompt 注入防护:用户输入的恶意内容不能劫持 Agent
- 速率限制:防止 Agent 在循环中狂调 API
- 审核日志:所有 Agent 操作都可审计
class SecurityGuard:
    def validate_tool_call(self, tool_name: str, args: dict) -> bool:
        allowed_tools = ["search", "read_memo", "add_event"]
        if tool_name not in allowed_tools:
            self.log_violation(tool_name, args)
            return False

        sensitive_args = ["password", "token", "key"]
        for key in args:
            if any(s in key.lower() for s in sensitive_args):
                self.log_violation(tool_name, args)
                return False

        return True
5.7 本地模型与部署
不是所有场景都适合调用云端 API。本地部署模型可以降低成本、保护隐私、提供离线能力。
- Ollama:个人使用最简单的方式
- vLLM:生产级高性能推理引擎
- llama.cpp:极致优化的本地运行
混用策略:简单任务用本地小模型(如 Qwen2.5-7B),复杂推理用云端大模型。
阶段三产出:一个具备重试、检查点、日志、多 Agent 协作的生产级 Agent 系统。
六、阶段四:架构设计与专家之路(持续)
6.1 深入理解 Agent 背后的理论
- ReAct 模式:Reasoning + Acting 循环,Agent 的基础范式
- Plan-and-Execute:先计划再执行,适合复杂任务
- Reflexion:Agent 反思自身错误并改进
- Tree of Thoughts:多路径探索推理
推荐阅读论文:
- “ReAct: Synergizing Reasoning and Acting in Language Models”
- “Reflexion: Language Agents with Verbal Reinforcement Learning”
- “Tree of Thoughts: Deliberate Problem Solving with Large Language Models”
6.2 企业级架构设计
典型企业 Agent 架构:
┌─────────────────────────────────┐
│         用户交互层               │
│  (飞书/Discord/Telegram/Web)    │
└──────────────┬──────────────────┘
               ▼
┌─────────────────────────────────┐
│         Agent 路由层            │
│  (意图识别 → Agent 分配)         │
└──────────────┬──────────────────┘
               ▼
┌─────────────────────────────────┐
│          Agent 运行时           │
│  主管 Agent → 子 Agent 池       │
│  (检查点/记忆/工具调度)          │
└──────┬──────────────┬───────────┘
       ▼              ▼
┌──────────┐  ┌──────────────┐
│ 工具层    │  │ 知识库层     │
│ MCP/API  │  │ 向量数据库   │
└──────────┘  └──────────────┘
6.3 核心设计模式
模式 1:Guardrails(护栏模式)
在 Agent 行动之前和之后设置验证点:
User Input → Input Guard → Agent → Output Guard → User
Input Guard 检查注入和安全,Output Guard 检查格式和质量。
模式 2:Human-in-the-Loop(人在回路)
高风险操作需要人工确认:
async def execute_with_approval(tool_call, approver_channel):
    # 发送审批请求
    await approver_channel.send(
        f"需要审批:调用 {tool_call.name}({tool_call.args})"
    )
    # 等待审批(超时则拒绝)
    approval = await wait_for_approval(timeout=300)
    if approval:
        return await execute(tool_call)
    return {"error": "操作被拒绝"}
模式 3:Agent-as-a-Service
将 Agent 封装为微服务:
Agent Service API:
  POST /agent/run     — 运行一次任务
  GET  /agent/status  — 查询运行状态
  POST /agent/cancel  — 取消运行
  GET  /agent/logs    — 获取运行日志
6.4 评估与持续改进
如何衡量你的 Agent 在变好?
评估维度:
- 任务完成率:给定 100 个测试任务,完成多少
- 工具调用准确率:选错工具的比例
- 平均轮次:完成一个任务需要多少轮对话
- Token 效率:每完成一个任务消耗多少 token
- 延迟 P95:95% 的任务在多少秒内完成
测试框架:
class AgentEvaluator:
    def __init__(self, test_cases: list[dict]):
        self.test_cases = test_cases

    async def evaluate(self, agent) -> dict:
        results = []
        for case in self.test_cases:
            result = await agent.run(case["input"])
            success = self.check_result(result, case["expected"])
            results.append({
                "case": case["name"],
                "success": success,
                "latency": result["latency"],
                "tokens": result["token_usage"],
                "steps": result["steps"]
            })
        return self.summarize(results)
6.5 保持前沿
AI Agent 领域发展极快,保持学习的习惯:
- 关注 GitHub 趋势:Agent 框架、工具库的更新
- 订阅技术博主:Anthropic、OpenAI 的官方博客
- 参与开源:给 Hermes Agent、LangChain 等项目提 PR
- 动手实践:每个季度做一个新的 Agent 项目
七、推荐的实战项目路线
从易到难,每个项目都能放进简历:
| 难度 | 项目 | 技术栈 |
|---|---|---|
| ⭐ | 个人知识库问答 Robot | LangChain + ChromaDB |
| ⭐⭐ | 自动化客服 Agent | LangGraph + MCP |
| ⭐⭐⭐ | 多 Agent 研究助手 | CrewAI + Web Scraper |
| ⭐⭐⭐⭐ | 个人 AI 助理(飞书/微信集成) | Hermes Agent + MCP |
| ⭐⭐⭐⭐⭐ | 企业级 Agent 平台 | 自研框架 + 微服务 |
八、推荐工具栈总结
LLM API:     OpenAI / Anthropic / DeepSeek / 本地 Ollama
Agent 框架:   LangChain / Hermes Agent / CrewAI
记忆存储:    ChromaDB / Redis / SQLite / PostgreSQL
工具协议:    MCP (Model Context Protocol)
部署运行:    Docker / Railway / 本地服务器
监控调试:    LangSmith / 自建日志
编程语言:    Python (首选) / TypeScript
九、写在最后
AI Agent 开发是一个宽而深的领域,宽在涉及自然语言处理、系统工程、架构设计,深在每个子领域都有大量需要沉淀的知识。
最重要的三件事:
-
动手:看一百篇文章不如写一个 Agent 跑起来
-
迭代:先做一个能用的,再做好的
-
分享:写技术文章、开源项目、参与社区 — 这是最好的学习方式
记住:每个 Agent 开发专家都从第一条 prompt 开始。你现在就可以开始。
最后
2026 年一晃已经过半,AI 大模型的热潮不仅没有降温,反而持续升温!
金融行业用大模型做风控、医疗依靠 AI 解析影像,电商、制造、教育各行各业,都在把 AI 融入日常业务。曾经热闹的 “百模大战”,早就告别单纯比拼模型参数,正式进入落地应用时代。
现在企业疯狂紧缺一类人才:懂业务、懂 AI、能做出可上线项目的大模型开发工程师,岗位缺口大,薪资待遇十分可观。

风口再好,不如手握高薪 offer 实在。行情火热,普通人、程序员该怎样从零入门大模型,抓住这波机会?
今天整理好【2026 最新版】AI 大模型全套免费学习资源,覆盖零基础入门、项目实战、理论知识、大厂面试,从基础一路进阶。所有资料分类归档,没有多余杂料,无套路免费分享给想要入局 AI 赛道的程序员与零基础小白!
👇👇扫码免费领取全部内容👇👇
1、大模型系统化完整学习路线
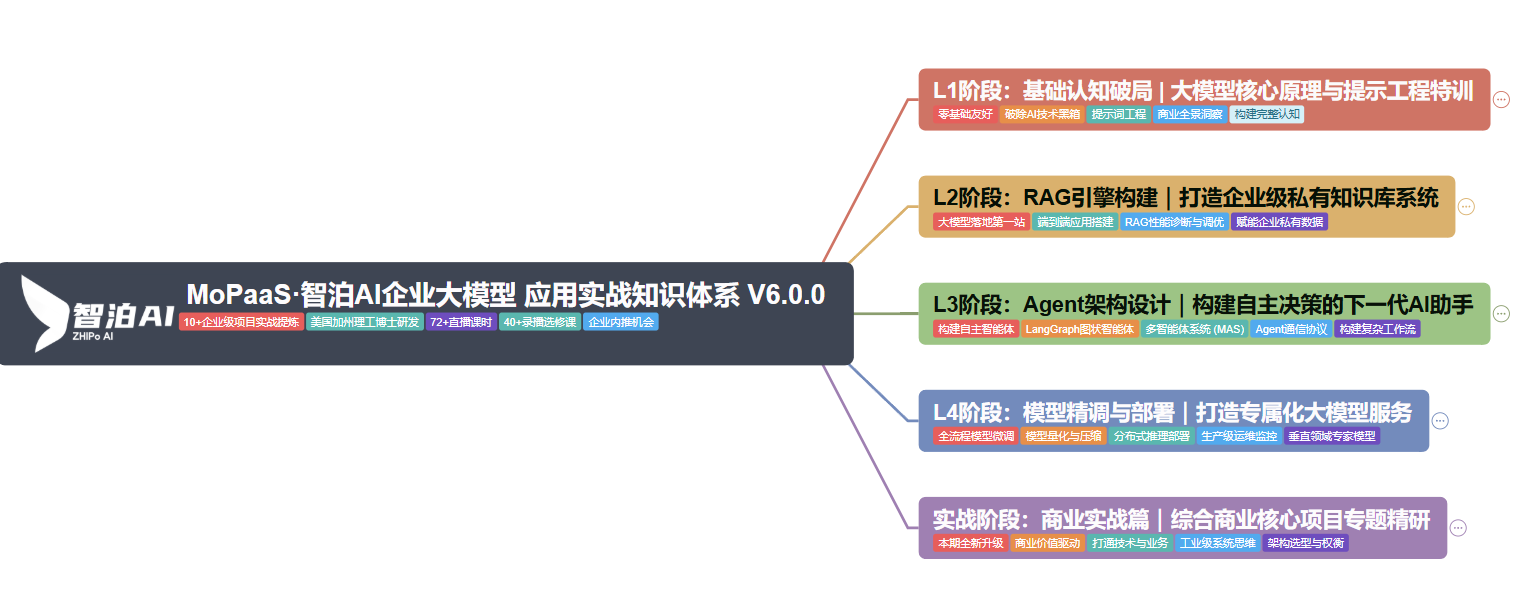
2、大模型经典书籍&文档

3、AI 大模型最新行业研究报告

4、企业级实战项目 + 完整配套源码
5、大厂大模型面试真题汇总
6、这些资料真的有用吗?
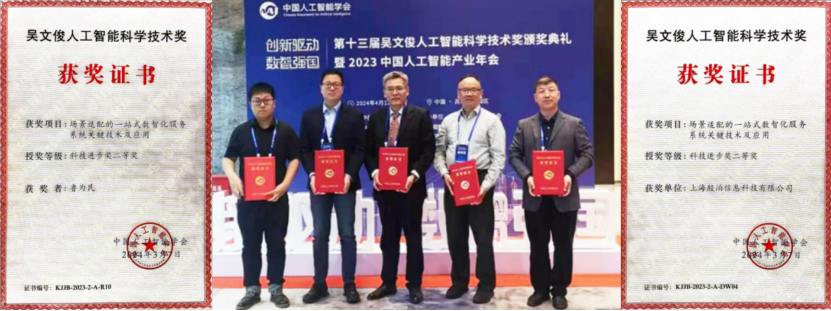
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐

 1
 0
- 0


 已为社区贡献229条内容

所有评论(0)