基于声纹识别的实时会议录音转写系统-Python
本项目为前几天收费帮学妹做的一个项目,在工作环境中基本使用不到,但是很多学校把这个当作编程入门的项目来做,故分享出本项目供初学者参考。
一、项目描述
基于声纹识别的实时会议录音转写系统
本项目是一套实时会议录音转写系统,系统通过浏览器采集参会人员的语音,经 WebSocket 实时传输到本地服务器,由部署在本机的中文语音识别模型完成语音转文字,并结合声纹技术自动区分不同说话人。会议结束后可将带说话人标注和时间信息的内容整理导出为会议纪要。整个识别过程在本地运行,不依赖外部云服务,适合对会议内容保密性有要求的场景。
二、项目功能
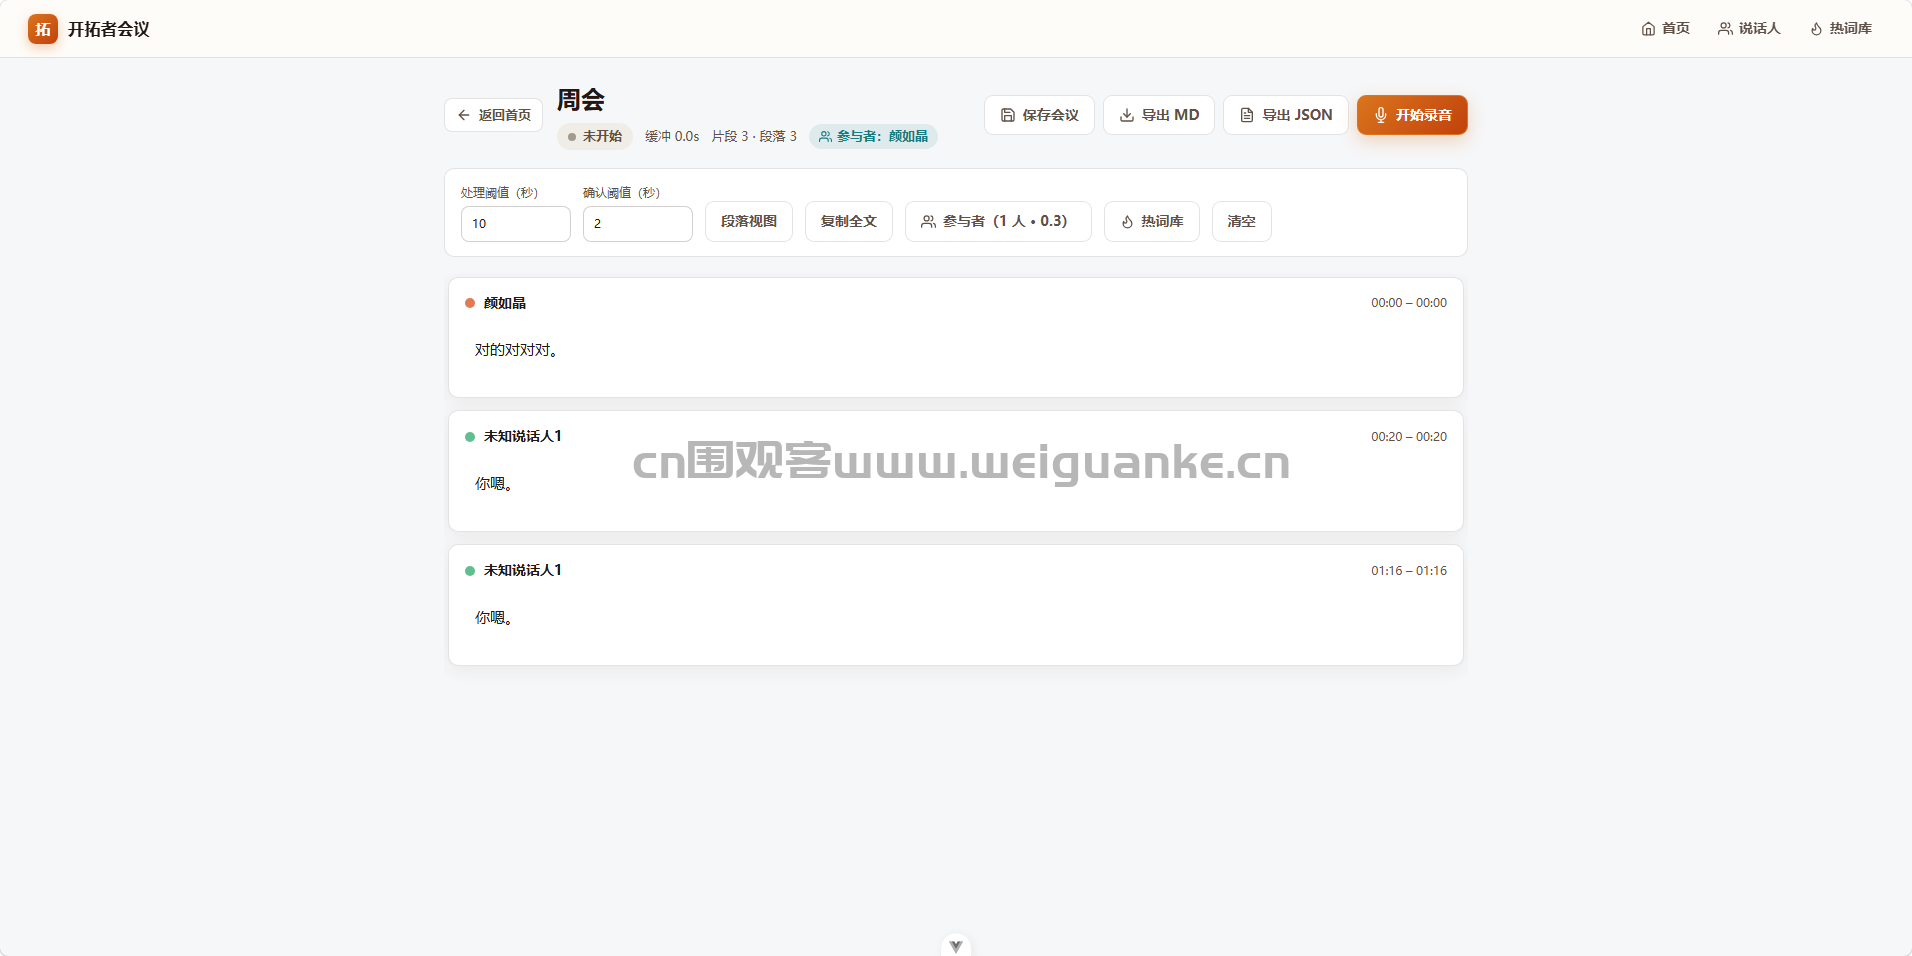
实时录音转写:网页端通过麦克风采集音频,在浏览器内降采样为 16 千赫单声道格式后实时上传,服务器边接收边识别,屏幕上按句滚动显示识别结果,并为每句话标注起止时间。
断句与标点:系统利用语音活动检测自动切分语音片段,识别结果经过标点恢复模型处理,输出带逗号、句号等标点的完整中文语句。
说话人区分:系统对每段语音提取声纹特征,自动对会议中的说话人进行聚类分组;同时支持提前录入参会人员声纹,将识别到的声音与已注册人员匹配,直接显示发言人姓名。
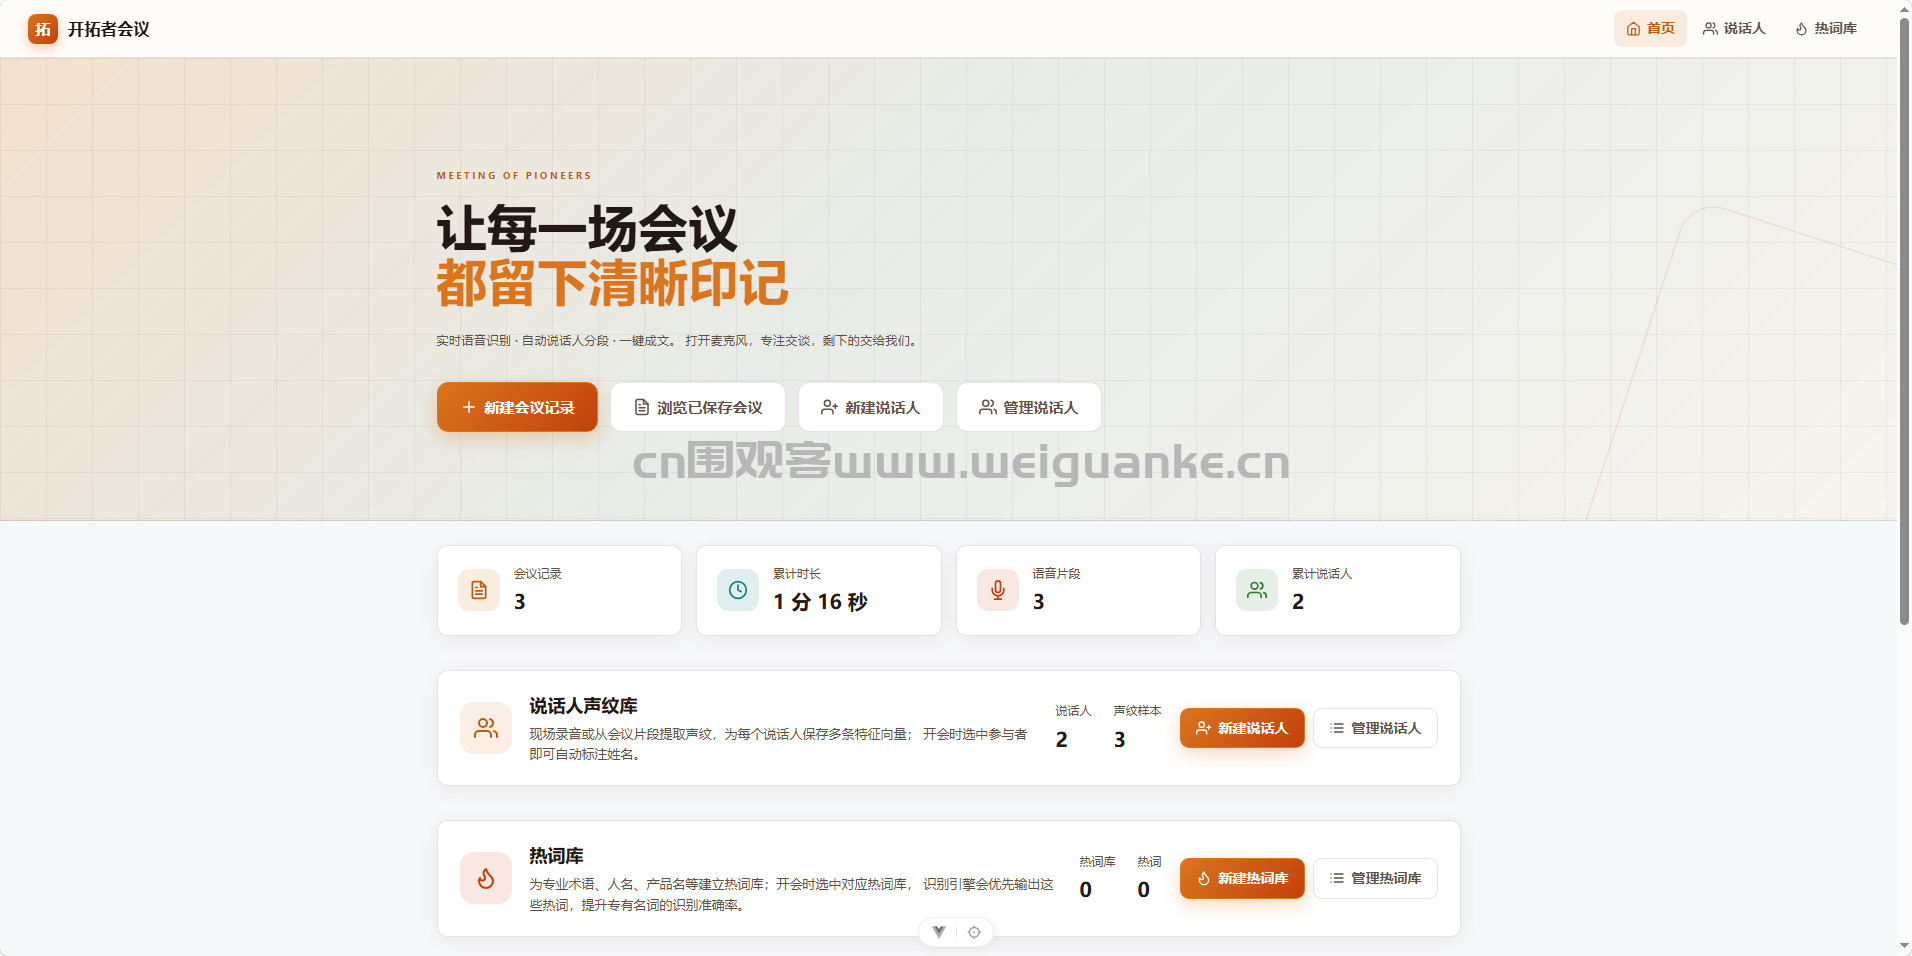
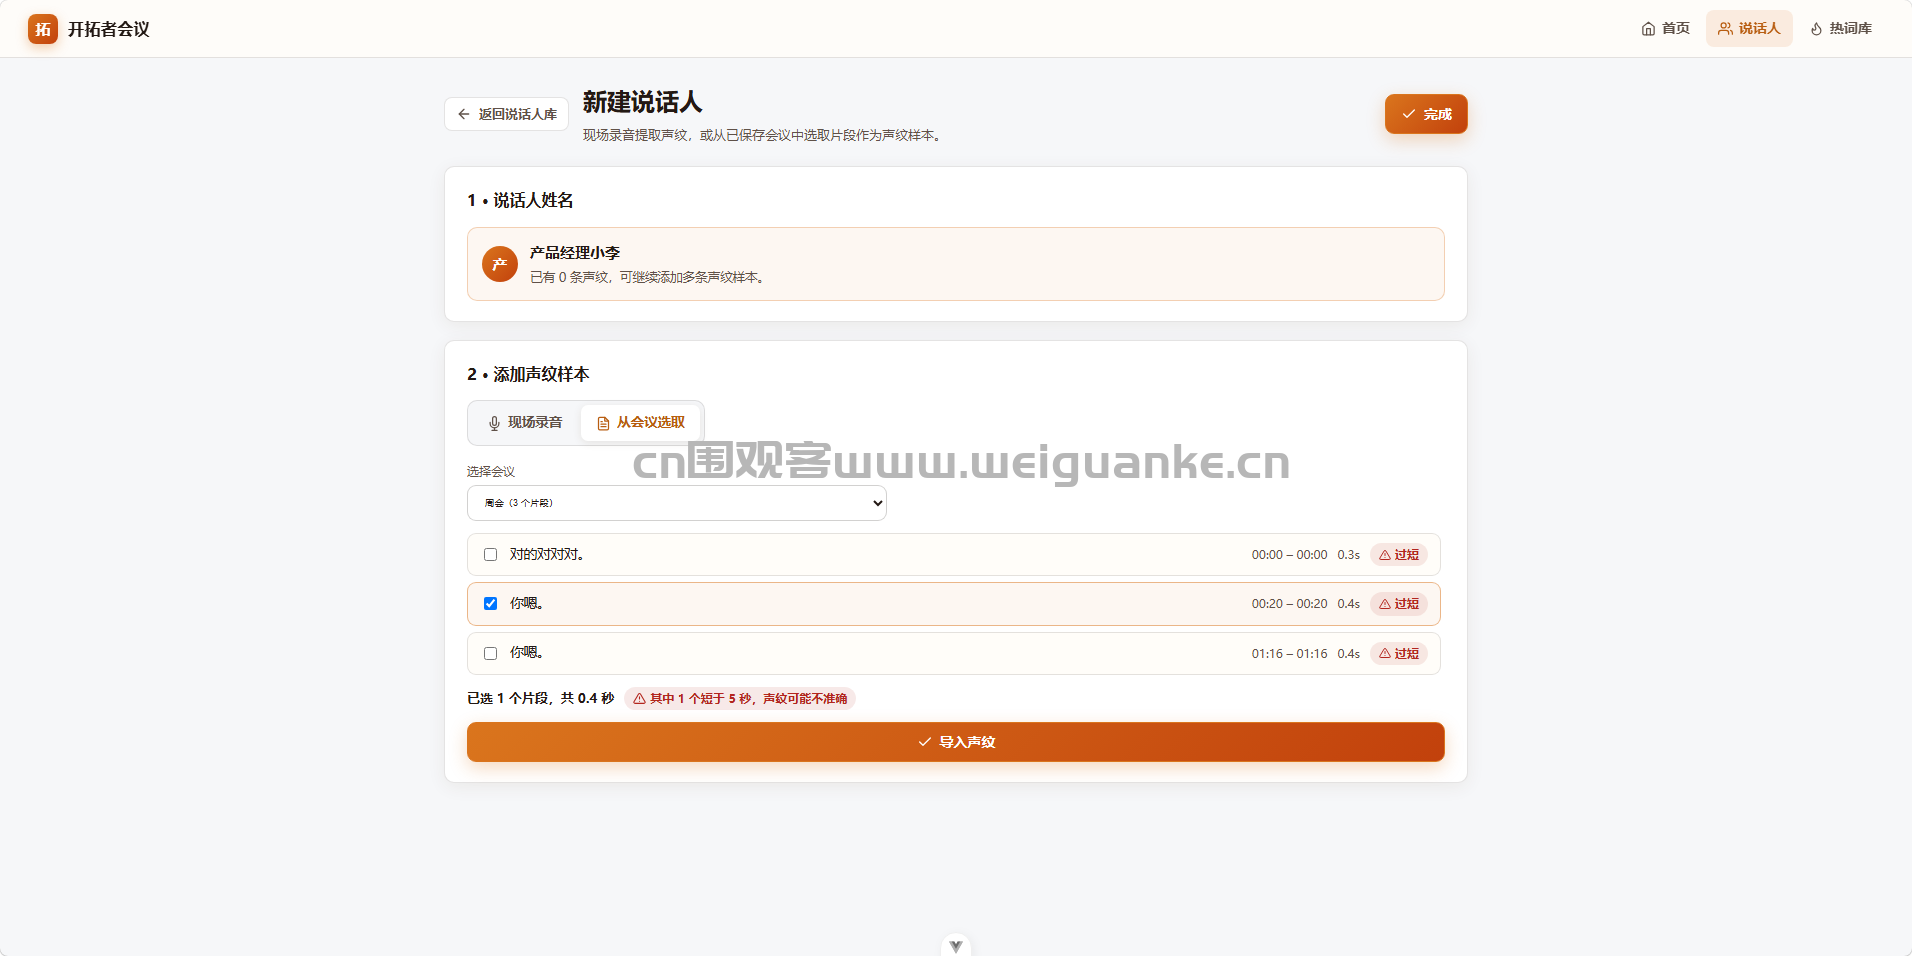
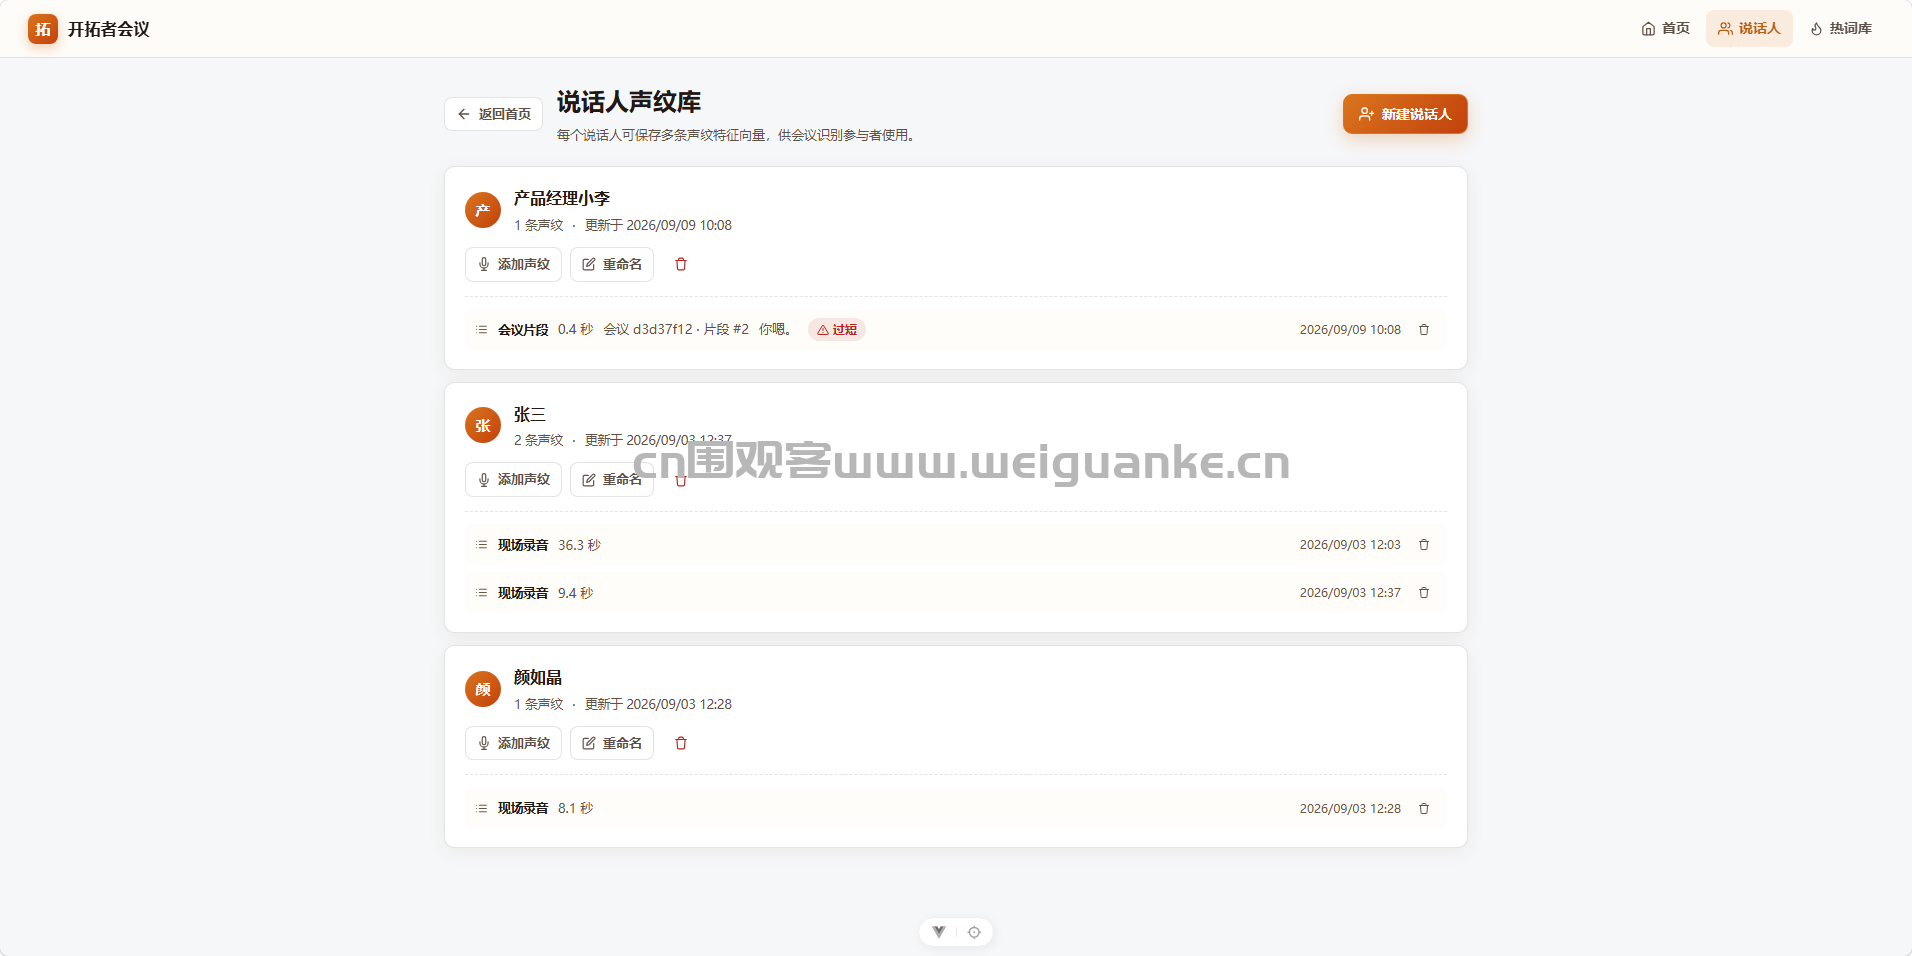
声纹库管理:可以通过现场录音或从已有会议片段两种方式为人员建立声纹档案,档案保存在本地并可在会议中重复使用。
热词管理:支持维护热词库,将人名、专业术语等加入热词后可提高相关词汇的识别准确率。
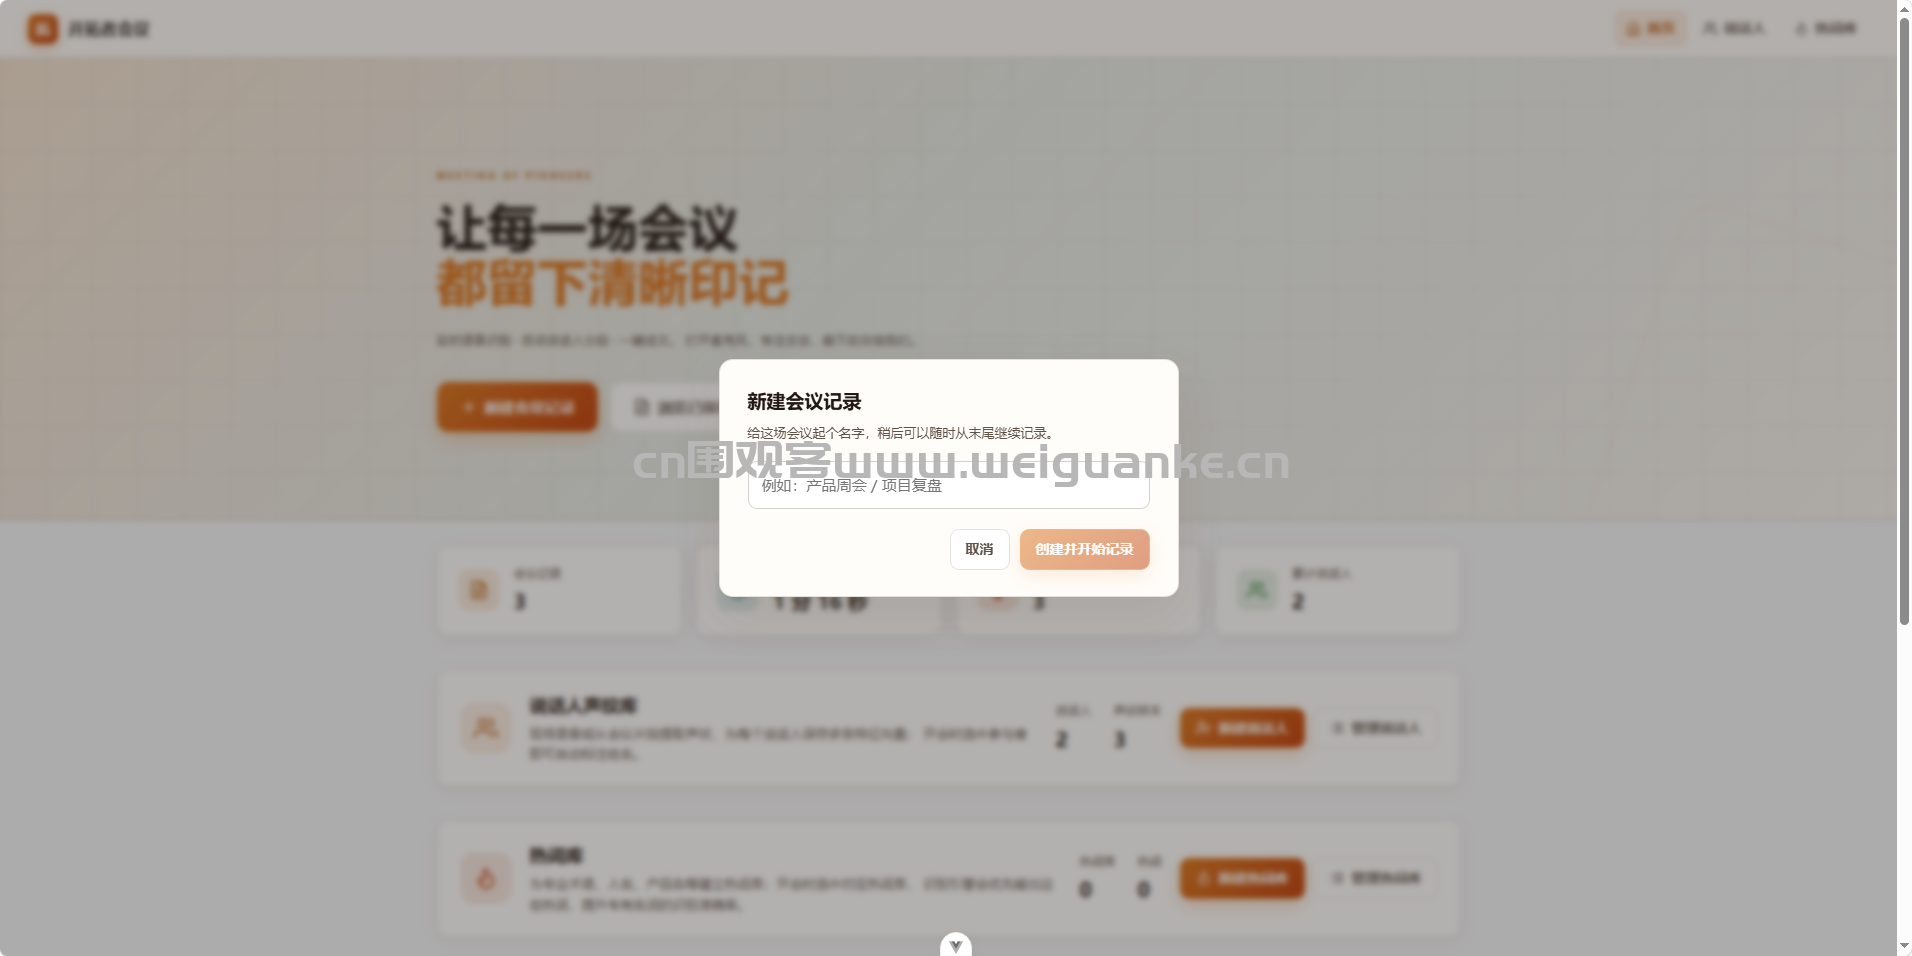
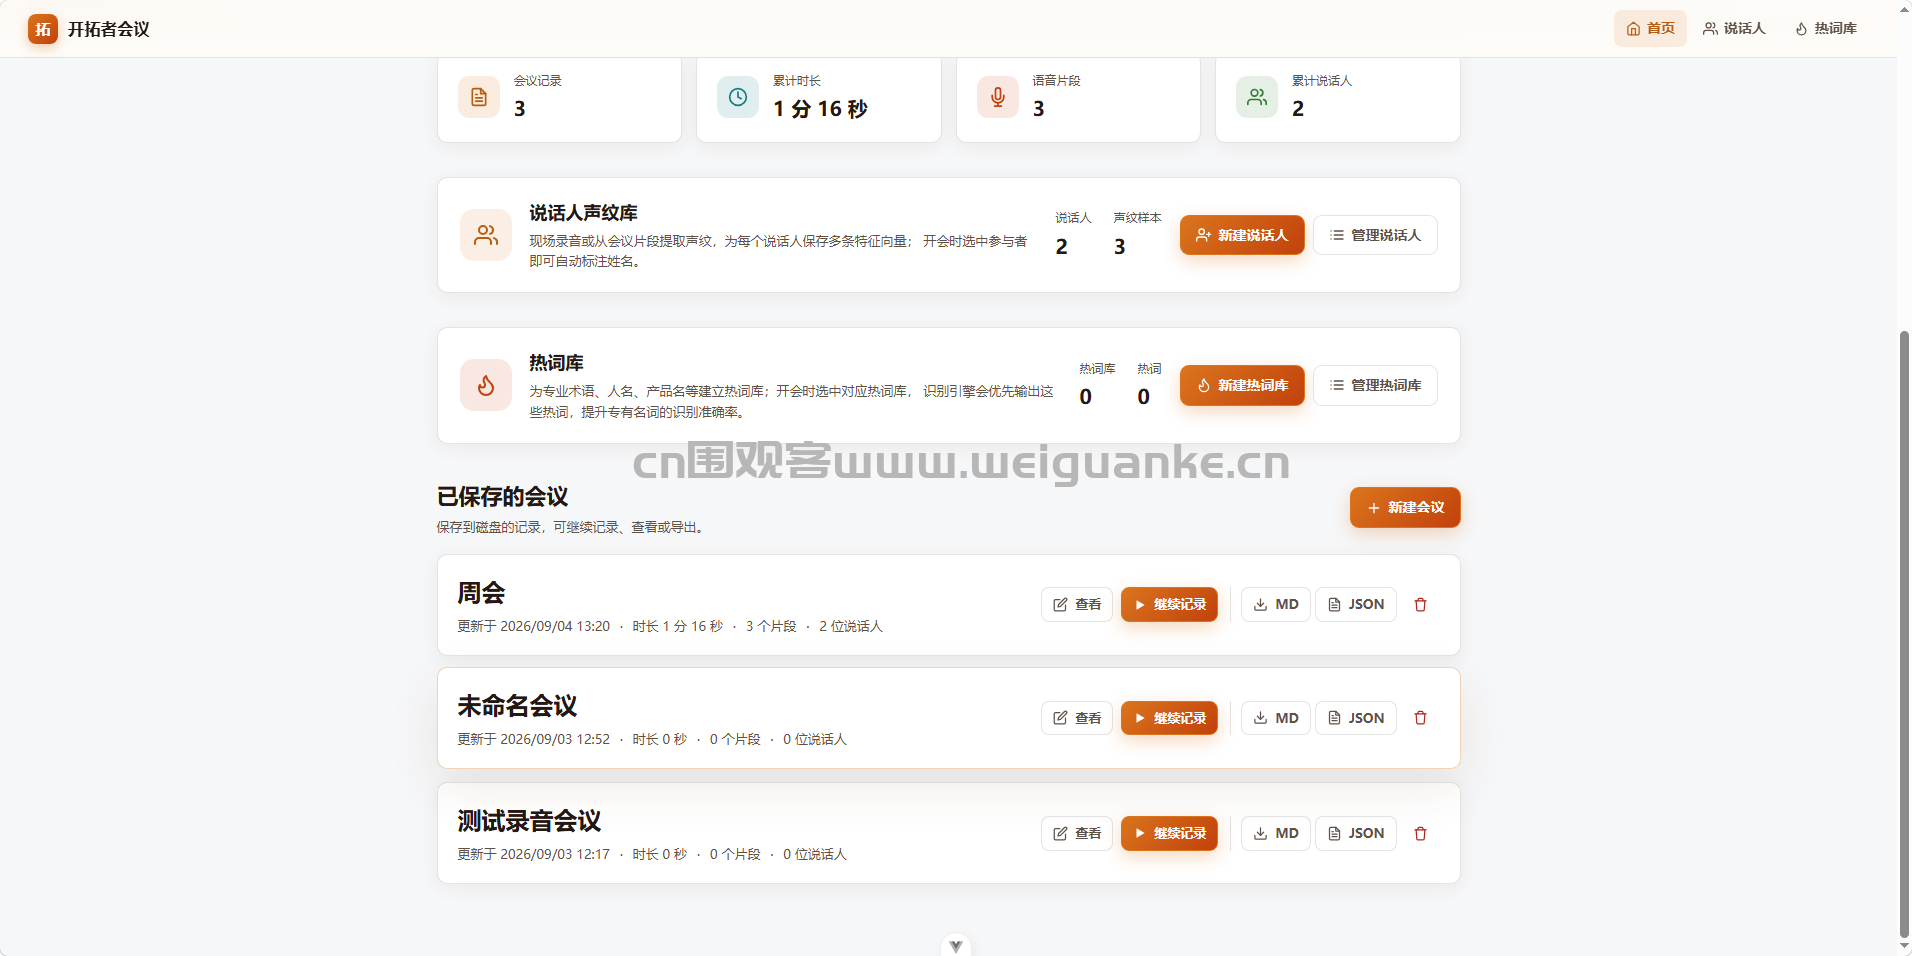
会议管理与导出:支持创建会议、指定参会人员、调整识别灵敏度等参数;会议过程中自动保存,结束后可导出为 Markdown 格式的会议纪要,内容包含会议标题、时长、说话人列表和按时间排列的发言记录。
三、运行环境
系统运行于 Windows 环境,采用前后端分离架构,后端和前端均在本机启动。后端要求 Python 3.12 以上版本(实测使用 Python 3.13),通过 uv 管理依赖;前端要求 Node.js 22 以上版本,使用 pnpm 管理依赖。语音模型文件通过 ModelScope 下载并缓存在本地,首次运行需联网下载,之后可完全离线使用。后端服务监听 8000 端口,前端开发服务监听 5173 端口,用户通过浏览器访问前端页面即可使用。
四、项目技术
后端使用 Python 语言开发,基于 FastAPI 框架提供 HTTP 接口和 WebSocket 服务,使用 uvicorn 作为应用服务器。语音识别核心采用 FunASR 开源框架与 PyTorch 深度学习框架,具体由四个模型协同完成:Paraformer 中文语音识别模型负责语音转文字,FSMN-VAD 模型负责语音活动检测与断句,CT-Transformer 标点模型负责恢复标点,CAM++ 声纹模型负责提取说话人声纹向量并进行相似度匹配与聚类。
前端使用 Vue 3 框架与 TypeScript 语言开发,基于 Vite 构建,使用 Vue Router 管理页面路由。音频采集采用浏览器原生的 AudioWorklet 技术,在独立音频线程中完成 48 千赫到 16 千赫的降采样和 16 位 PCM 量化,保证音频处理不阻塞页面。前端与后端之间通过 WebSocket 长连接传输二进制音频数据,并通过 HTTP 接口完成会议、说话人、热词等数据的管理。数据以文件形式存储在本地,包括会议记录、声纹向量库和热词库,无需额外部署数据库。
以上系统源码经过技术整理与调试,确保能正常运行
五、项目截图
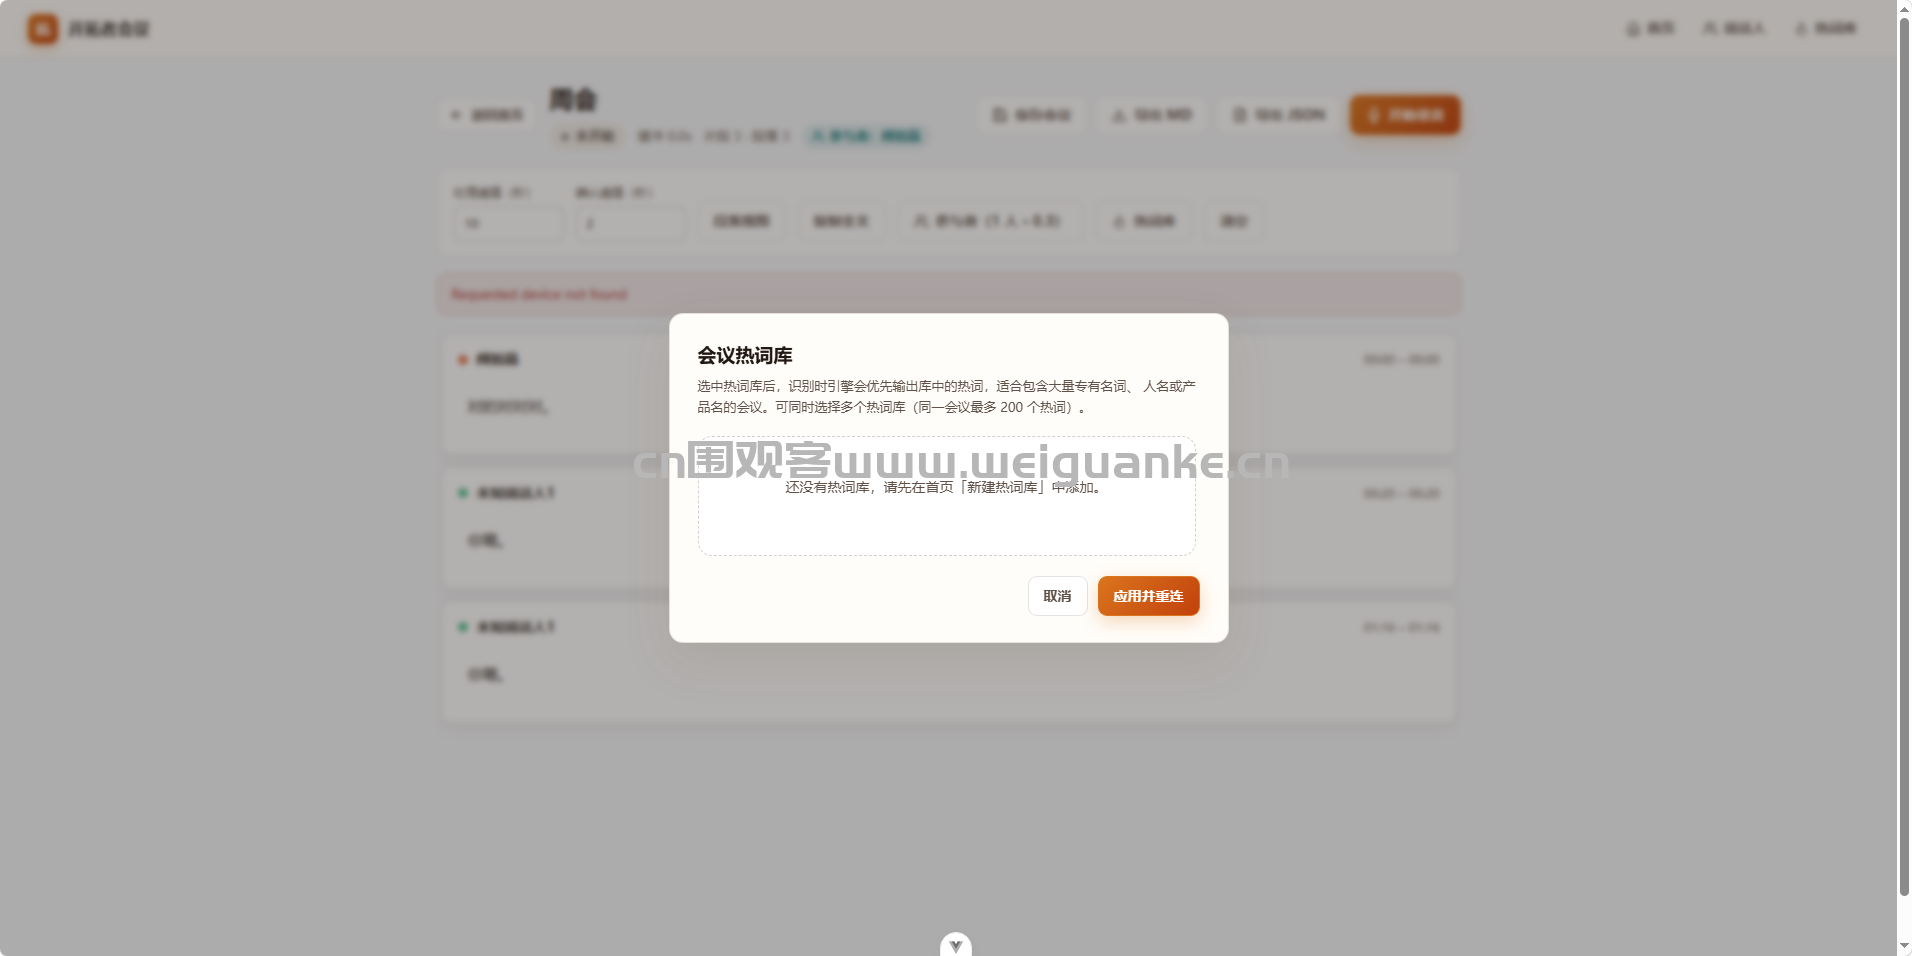
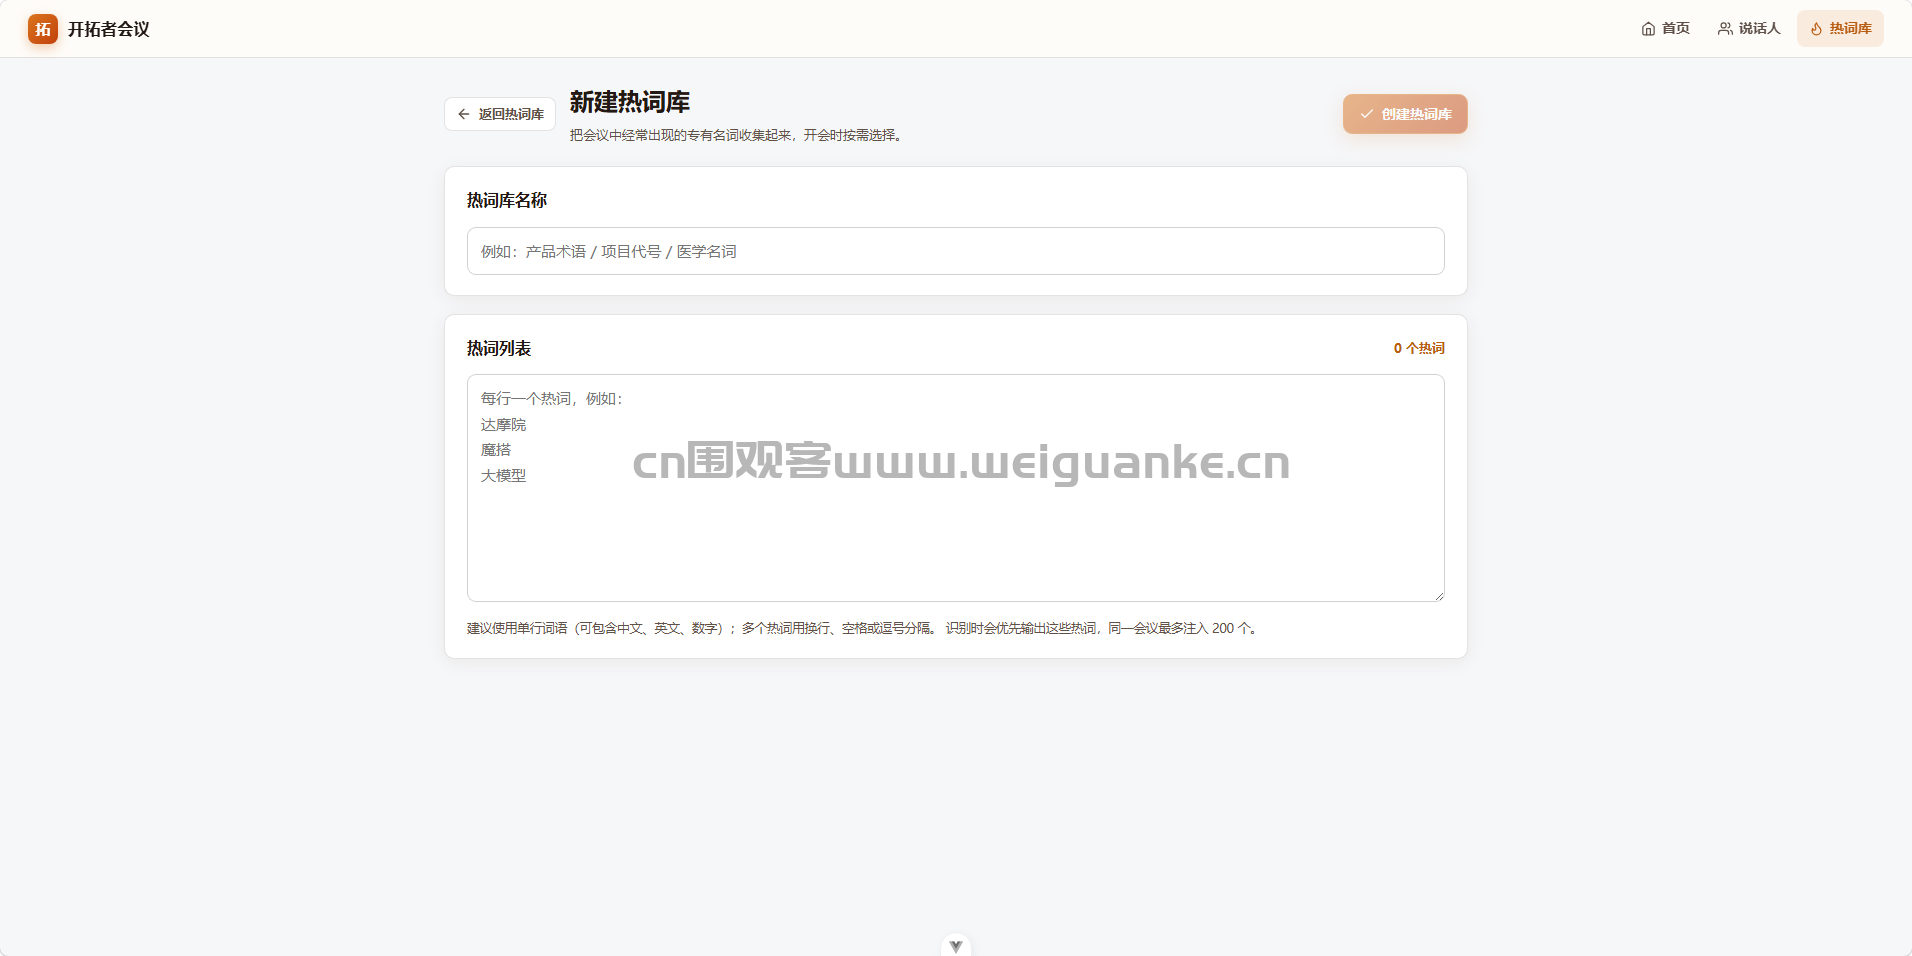
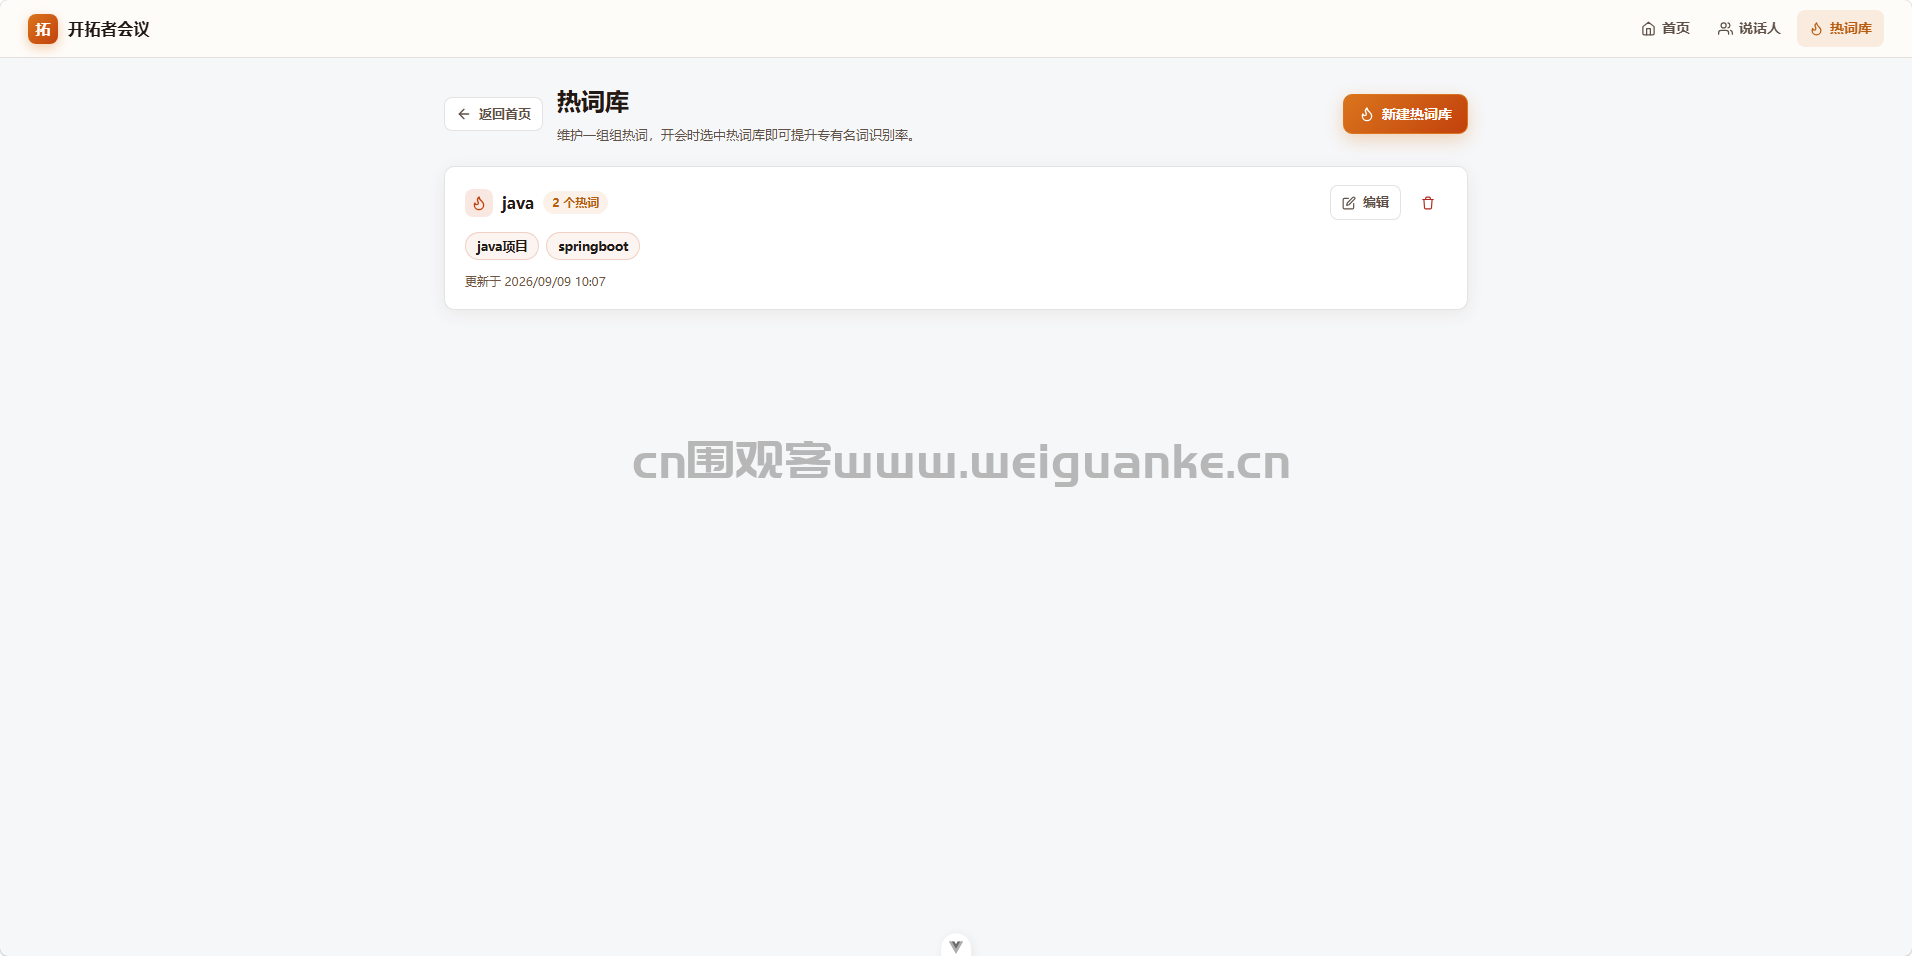
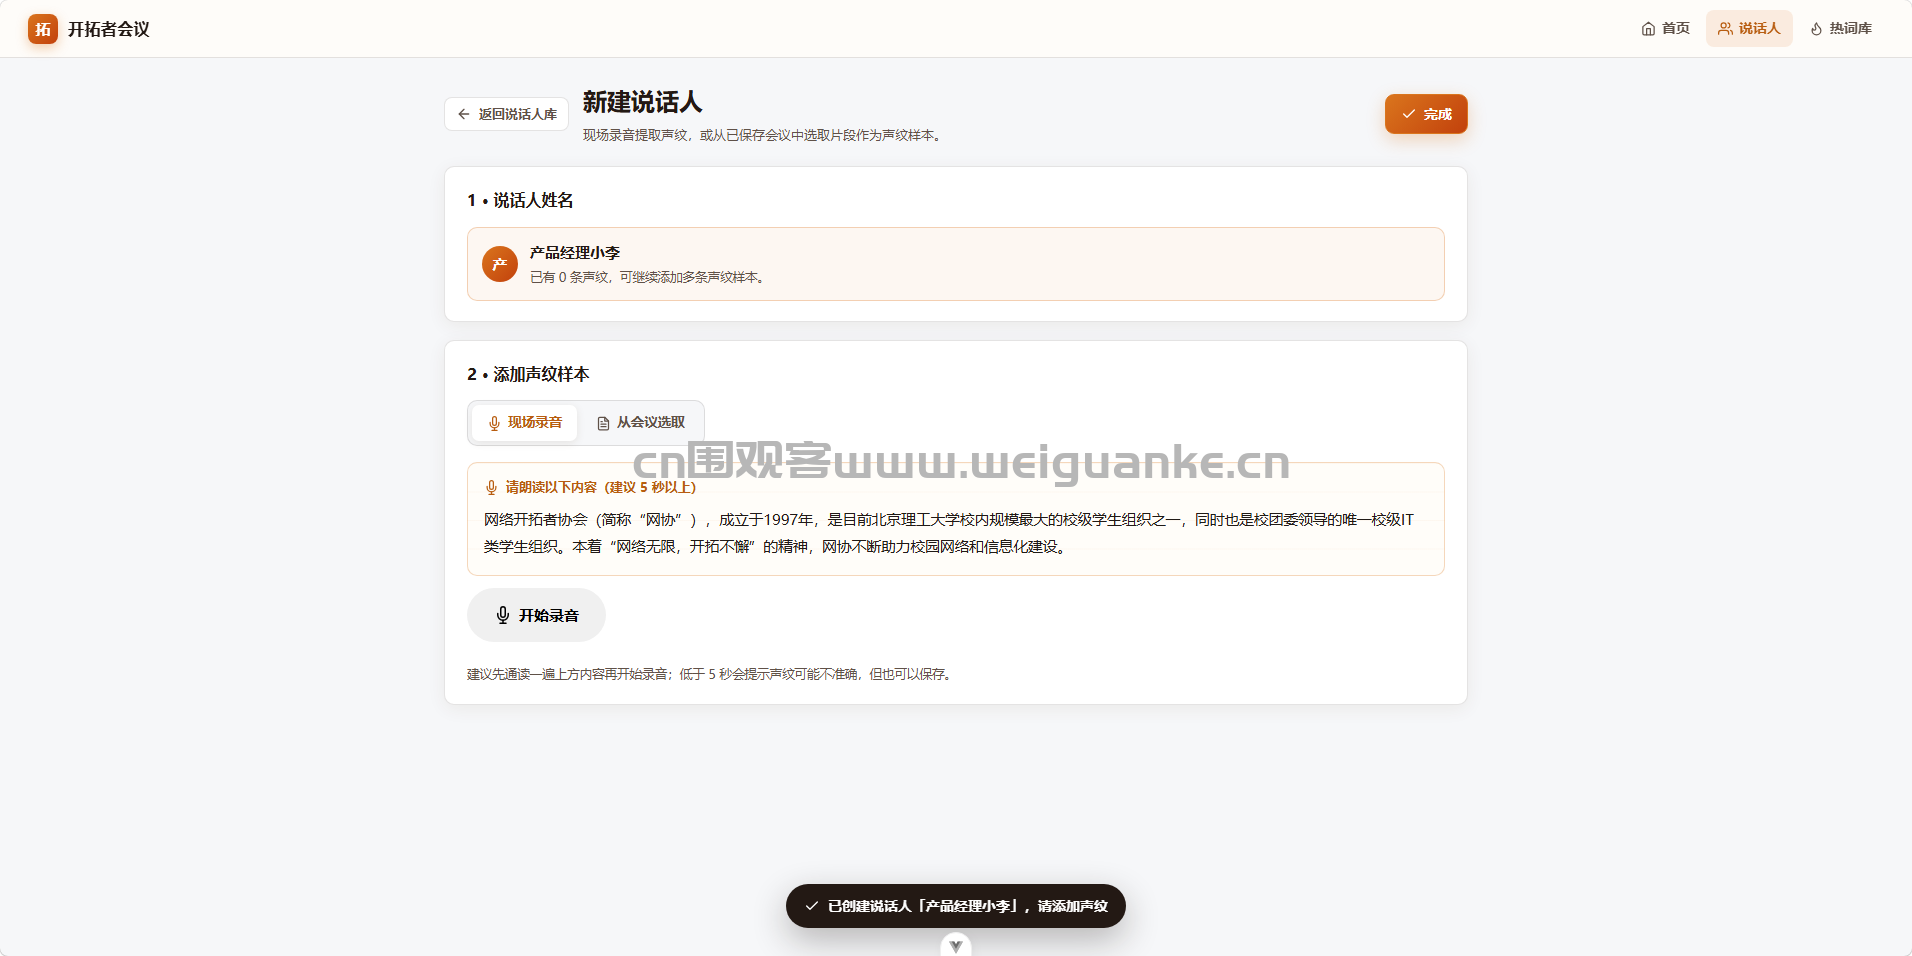

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 0
 0
- 0


 已为社区贡献245条内容

所有评论(0)