AI Agent 从原型到生产的上线检查清单——企业应用的 KFS MCP Server、回滚方案与效果评估
文章目录
- 每日一句正能量
- 摘要
- 1. 背景与问题
- 2. 环境与数据
- 3. 复现过程
- 4. 方案实施
- 4.1 检查域一:身份认证
- 4.2 检查域二:租户隔离
- 4.3 检查域三:Tool 白名单
- 4.4 检查域四:参数校验
- 4.5 检查域五:数据库最小权限
- 4.6 检查域六:SQL 与数据库函数
- 4.7 检查域七:Prompt Injection
- 4.8 检查域八:敏感数据
- 4.9 检查域九:超时
- 4.10 检查域十:重试
- 4.11 检查域十一:幂等
- 4.12 检查域十二:事务边界
- 4.13 检查域十三:元数据缓存
- 4.14 检查域十四:KFS/FlySync 数据新鲜度
- 4.15 检查域十五:审计日志
- 4.16 检查域十六:可观测性
- 4.17 检查域十七:人工复核
- 4.18 检查域十八:容量
- 4.19 检查域十九:压测
- 4.20 检查域二十:灰度
- 4.21 检查域二十一:回滚
- 4.22 Tool Kill Switch
- 4.23 上线阻断规则
- 5. 结果对比
- 6. 风险与复盘
- 一份可直接用于上线评审的检查清单
- 结语
每日一句正能量
真诚是最高效的沟通方式,孤独是最自由的独处时光。
当不再将“孤独”视为一种需要填补的缺憾,而是一种主动选择的、无需迎合任何人的状态时,人便在其中获得了绝对的精神主权,可以尽情思考、创造或休憩。
摘要
一个能在开发环境里回答“本月销售额是多少”的 AI Agent,距离真正可以上线到企业生产环境,中间往往隔着几十项工程能力。
原型阶段关注的是:
能不能回答?
生产阶段关注的却是:
谁能问?
能调用什么工具?
能访问哪些数据?
失败时会不会重试风暴?
Prompt 被注入怎么办?
Tool Call 越权怎么办?
数据库异常怎么办?
模型升级后答案会不会漂移?
Schema 变化后缓存会不会过期?
错误结果谁复核?
出了问题能不能在几分钟内回滚?
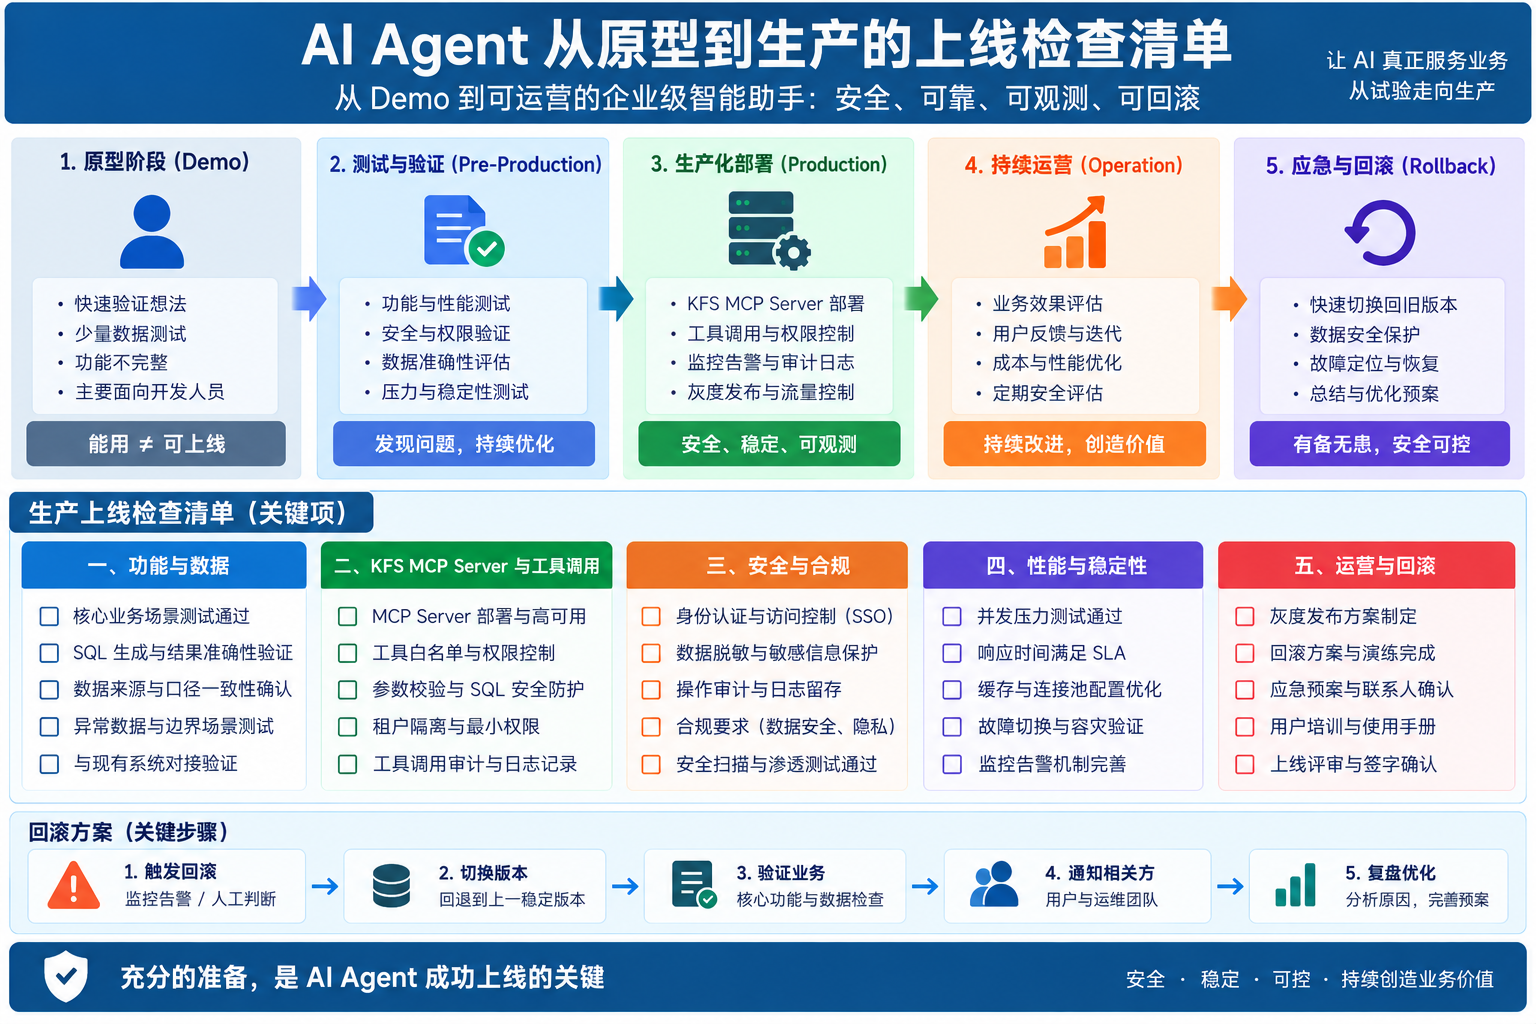
因此,Agent 的生产化不能只等同于“把 Demo 部署到服务器”。真正的上线标准应该是一套覆盖身份、工具、数据库、安全、性能、审计、灰度、回滚和效果评估的检查清单。
本文基于企业数据助手场景,给出一套完整上线框架,并将 KFS MCP Server 作为受控工具服务层,重点回答三个问题:
- 什么条件满足后才允许上线;
- 出现异常后如何快速止损和回滚;
- 上线后如何持续证明 Agent 仍然安全、准确、可用。
公开资料中的 KFS 指 Kingbase FlySync,主要用于异构数据平台间实时、增量同步;本文延续本系列架构,将“KFS MCP Server”作为面向数据库/KFS能力的受控 MCP 工具服务层,两者职责不同。
1. 背景与问题
1.1 Demo 能跑,不等于生产可用
很多 Agent 项目的第一阶段非常顺利。
开发者准备:
一个大模型
一个数据库连接
一个 execute_sql 工具
几条 Prompt
几十条测试问题
很快就能得到一个演示效果不错的系统。
例如:
用户:查询华东区本月销售额。
Agent:调用 SQL。
数据库:返回结果。
Agent:生成自然语言回答。
Demo 成功。
但一旦放到生产环境,问题立刻变成:
如果用户问了不属于自己权限的数据呢?
如果模型被提示注入诱导呢?
如果工具执行超时呢?
如果数据库已经提交但响应丢失呢?
如果 Agent 一次问题调用 15 次 SQL 呢?
如果 Schema 变化但元数据缓存没刷新呢?
如果模型给出一个很自信的错误经营数字呢?
这些问题都不是 Prompt 能单独解决的。
1.2 企业 Agent 的生产风险是“组合风险”
AI Agent 不是单一组件,而是一条链:
用户
→ 身份系统
→ Agent Runtime
→ 模型
→ MCP Tool
→ KFS MCP Server
→ 数据库
→ 缓存
→ 审计
→ 最终回答
任何一层出问题都可能让最终结果不可用。
比如:
身份正确
Tool 正确
SQL 正确
但:
KFS 同步数据延迟 40 分钟
最终经营数据仍然错误。
又比如:
SQL 参数化
数据库只读
但 Tool 返回了其他租户的数据,也仍然属于严重事故。
所以生产上线前必须从:
全链路
而不是单组件进行检查。
1.3 为什么上线检查清单必须“可执行”
无效检查项:
□ 安全已考虑
□ 性能应该没问题
□ 日志已接入
有效检查项应该像:
□ 普通用户无法调用高风险写 Tool
□ Tool 参数越权时返回 POLICY_DENIED
□ 数据库账号不具备 DROP/ALTER 权限
□ 跨租户 Tool Call 测试 100% 被拦截
□ Agent 单请求最大 Tool Call 数 ≤ 5
□ P95 总响应时间满足 3 秒 SLA
□ 回滚 Agent 版本在 10 分钟内完成
□ 回滚后核心 20 条 Smoke Test 全通过
检查清单必须:
能验证
能量化
能阻断上线
2. 环境与数据
2.1 示例生产架构
本文假设生产系统:
企业用户
↓
SSO / OIDC
↓
AI Agent Gateway
↓
Agent Runtime
↓
KFS MCP Server
↓
数据库函数 / 受控查询接口
↓
PostgreSQL / KingbaseES / MySQL
旁路组件:
Redis
OpenTelemetry
审计日志库
告警平台
人工复核平台
KFS/FlySync 同步链路
2.2 环境分层
建议至少:
local
dev
test
staging
production
尤其:
staging
不能只是一个“能启动”的环境。
它应该尽可能接近生产:
相同 Tool 配置
相同权限模型
相同数据库版本
相同连接池参数
相同缓存
相同审计和监控
相同模型路由策略
只允许:
数据脱敏
容量缩小
外部系统替身
2.3 生产配置模板
agent:
  max-tool-calls: 5
  max-retries-per-tool: 1
  request-timeout-ms: 8000
  human-review:
    enabled: true

mcp:
  allowed-tools:
    - get_metric_definition
    - get_sales_summary
    - get_order_summary

database:
  statement-timeout-ms: 1500
  read-only: true

security:
  tenant-isolation: true
  prompt-injection-detection: true
  sensitive-output-mask: true

audit:
  enabled: true
  retention-days: 180
2.4 上线检查表表结构
如果企业希望让上线流程真正系统化,可以把检查项做成数据库表。
CREATE TABLE agent_release_check (
    release_id          VARCHAR(64) NOT NULL,
    check_code          VARCHAR(64) NOT NULL,
    check_category      VARCHAR(32) NOT NULL,
    check_name          VARCHAR(256) NOT NULL,

    severity            VARCHAR(8) NOT NULL,
    status              VARCHAR(16) NOT NULL,

    evidence_url        TEXT,
    owner               VARCHAR(128),
    comment             TEXT,

    checked_at          TIMESTAMPTZ,

    PRIMARY KEY (
        release_id,
        check_code
    )
);
状态:
PENDING
PASS
FAIL
WAIVED
其中:
P0 FAIL
原则上直接阻断上线。
3. 复现过程
3.1 原型直接上线:任意 SQL Tool
典型原型:
server.registerTool(
  "execute_sql",
  {
    inputSchema: {
      sql: z.string()
    }
  },
  async ({ sql }) => {
    return pool.query(sql);
  }
);
测试环境看起来很好。
生产风险:
任意表访问
大查询
敏感字段读取
误写
Prompt Injection
Schema 侦察
生产版本应该改为:
窄接口 Tool
例如:
get_sales_summary
get_order_summary
get_metric_definition
3.2 没有限制 Tool Call 数
用户问:
分析一下最近销售下降原因。
Agent 连续调用:
销售 Tool
订单 Tool
退款 Tool
商品 Tool
库存 Tool
渠道 Tool
客户 Tool
……
如果模型循环:
Tool → 结果 → 再调用 Tool
数据库压力会被放大。
因此生产前必须验证:
maxToolCalls
3.3 数据库错误导致无限重试
代码:
for (;;) {
    try {
        queryDatabase();
        break;
    } catch (Exception e) {
        // retry
    }
}
遇到:
权限错误
SQL 语法错误
参数错误
也不断重试。
这不仅无法修复问题,还会把数据库压垮。
生产必须做:
错误分类
+
重试白名单
+
次数上限
+
指数退避
3.4 审计日志缺失
事故:
用户声称 Agent 返回了不属于他的客户数据。
如果系统只有:
POST /chat 200
就无法回答:
调用了哪个 Tool?
使用了哪个 tenant_id?
返回多少行?
策略引擎有没有放行?
这种系统即使功能正确,也不适合生产。
3.5 没有回滚 Tool 配置
很多团队只准备:
应用镜像回滚
却没有:
Tool 回滚
Prompt 回滚
模型版本回滚
权限策略回滚
Schema 元数据回滚
结果 Agent 代码回到了 v1,但:
MCP Tool 还是 v2
故障仍然存在。
4. 方案实施
4.1 检查域一:身份认证
必须验证:
□ 所有用户经过可信认证
□ user_id 来自认证态
□ tenant_id 来自认证态
□ Agent 不从 Prompt 推断权限
□ Token 过期能被正确拒绝
□ 服务间调用使用独立身份
错误设计:
“用户说自己是管理员”
不能成为授权依据。
4.2 检查域二:租户隔离
SaaS Agent 必须测试:
T100 用户请求 T200 数据
预期:
CROSS_TENANT_BLOCKED
工具层:
if (ctx.auth.tenantId !== args.tenantId) {
  throw new SecurityError(
    "CROSS_TENANT_BLOCKED"
  );
}
数据库还要用:
RLS
Schema
独立库
形成第二道边界。
4.3 检查域三:Tool 白名单
生产不推荐:
execute_sql
execute_any_function
run_shell
默认开放。
更适合:
get_sales_summary
get_order_detail
get_database_health
每个 Tool 都应该回答:
谁能调用?
参数是什么?
最大范围是什么?
是否写操作?
是否幂等?
失败能不能重试?
MCP 最新规范已加强授权和协议扩展能力,因此生产化时 Tool 不应只是模型“可调用函数”,而应进入正式的权限和版本治理体系。citeturn489347search0turn489347search1
4.4 检查域四:参数校验
Tool Schema:
const SalesSchema = z.object({
  month: z
    .string()
    .regex(/^\d{4}-\d{2}$/),

  region: z.enum([
    "EAST",
    "SOUTH",
    "WEST",
    "NORTH"
  ])
});
生产禁止:
任意表名
任意列名
任意 SQL
无限时间范围
无限结果行
4.5 检查域五:数据库最小权限
数据库账号建议分:
agent_readonly
agent_metric_reader
agent_writer
agent_admin
普通 Agent 默认:
agent_readonly
不要使用:
root
superuser
SYSTEM
只读账号也不能默认读全部数据。
还需要:
列权限
行权限
函数 EXECUTE 权限
视图隔离
4.6 检查域六:SQL 与数据库函数
优先:
固定 Tool
→ 参数化 SQL
或:
固定 Tool
→ 数据库函数
不要:
用户自然语言
→ 模型自由生成 SQL
→ 直接生产执行
若确实需要 Text-to-SQL:
只读账号
SQL AST 校验
表白名单
字段白名单
超时
最大返回行数
审计
必须同时存在。
4.7 检查域七:Prompt Injection
上线前至少测试:
指令覆盖
角色伪装
间接 Prompt Injection
工具诱导
数据外泄诱导
跨租户诱导
核心原则:
Prompt 不是安全边界。
真正安全边界是:
Tool Policy
IAM
数据库权限
4.8 检查域八:敏感数据
至少验证:
手机号
身份证
银行卡
薪资
利润
合同
凭据
是否根据角色正确:
拒绝
脱敏
聚合
而不是把全部结果给模型,再要求:
“请不要输出。”
4.9 检查域九:超时
推荐分层:
连接等待超时
<
数据库语句超时
<
Tool 超时
<
Agent 请求总超时
例如:
连接池等待:300 ms
SQL:1500 ms
Tool:2500 ms
Agent:8000 ms
避免下层还在跑,上层已经超时。
4.10 检查域十:重试
只重试:
明确可重试错误
例如:
临时网络错误
死锁
瞬时连接失败
不能重试:
权限失败
参数失败
语法错误
越权拒绝
Prompt Injection 拒绝
4.11 检查域十一:幂等
写 Tool 必须:
request_id
idempotency_key
唯一约束
示例:
CREATE UNIQUE INDEX uk_agent_request
ON agent_operation(
    tenant_id,
    request_id
);
避免:
Tool 重试
→ 重复提交
4.12 检查域十二:事务边界
推荐:
一次写 Tool Call
=
一个明确短事务
不要让 Agent 自己控制:
BEGIN
COMMIT
ROLLBACK
Agent 运行时可能:
超时
取消
重试
切模型
长事务风险极高。
4.13 检查域十三:元数据缓存
上线前验证:
新增列
删除列
字段改名
函数签名变化
Agent 是否能快速刷新。
必须存在:
Schema Version
Metadata Version
Tool Contract Version
不能让旧 Schema 静默使用。
4.14 检查域十四:KFS/FlySync 数据新鲜度
如果 AI 查询数据来自 KFS/FlySync 同步链路,上线检查必须加入:
同步任务状态
同步延迟
数据一致性
故障恢复
KFS 官方资料明确说明 FlySync 用于异构数据平台实时、增量同步,并提供状态监控、流转量统计与一致性对比能力;管理文档也提供同步状态查看以及故障恢复相关机制。citeturn489347search2turn489347search4turn489347search10
因此 Agent 回答:
“今天销售额”
之前,应确认:
data_as_of
4.15 检查域十五:审计日志
至少记录:
trace_id
request_id
conversation_id
user_id
tenant_id
tool_call_id
tool_name
policy_decision
db_elapsed_ms
row_count
result_bytes
success
error_code
拒绝的 Tool Call 也必须记录。
4.16 检查域十六:可观测性
必须监控:
Agent P50/P95/P99
Tool P95
DB P95
Tool Error Rate
Tool Retry Rate
Prompt Injection Block Rate
Cross-Tenant Block Rate
Average Tool Calls / Question
否则上线后只能看到:
“用户说 AI 很慢”
却不知道慢在哪。
4.17 检查域十七:人工复核
以下场景建议强制:
重大经营数字
利润
预算
对外披露
高风险写操作
低置信度答案
数据源不完整
同步延迟
人工复核不是所有请求都审核。
应:
风险路由
4.18 检查域十八:容量
估算:
1000 并发用户
×
平均 2 Tool Calls
×
单 Tool 150ms
并检查:
模型并发
MCP Server 并发
连接池
数据库最大连接数
Redis
日志吞吐
尤其不能只看:
Agent QPS
因为一次 Agent 请求可能放大成多次数据库调用。
4.19 检查域十九:压测
压测数据必须模拟:
热点
长尾
大租户
小租户
读写比例
失败重试
Tool 循环
不能全部均匀随机。
4.20 检查域二十:灰度
生产发布推荐:
1%
→
5%
→
20%
→
50%
→
100%
每阶段观察:
错误率
P95
Tool Calls
数据库 QPS
安全告警
人工驳回率
4.21 检查域二十一:回滚
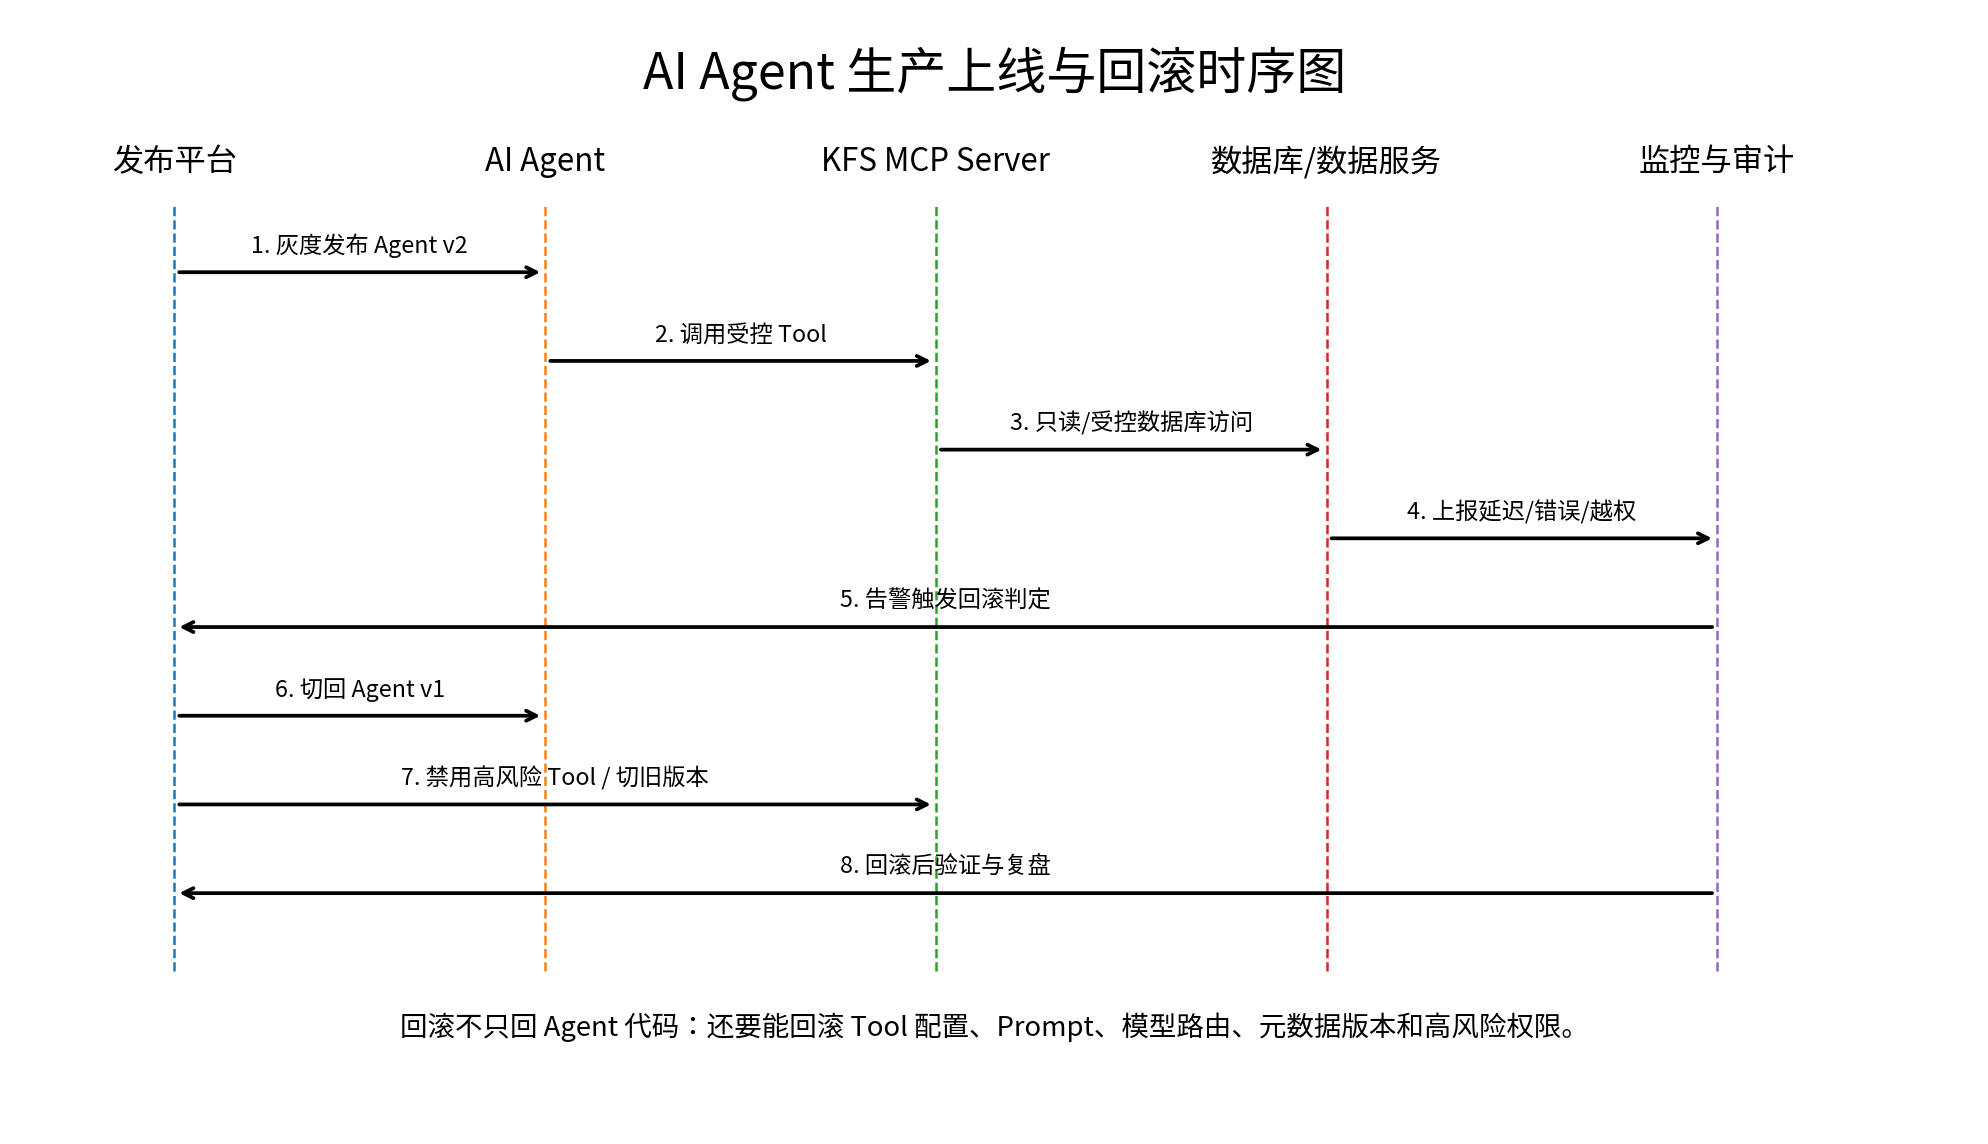
必须准备:
Agent 版本回滚
Prompt 回滚
模型路由回滚
Tool 配置回滚
Tool Kill Switch
元数据缓存回滚/清理
权限策略回滚
而不仅是:
Docker 镜像回滚
4.22 Tool Kill Switch
生产最好支持:
DISABLE execute_write
DISABLE customer_export
DISABLE schema_admin
出现安全问题后:
不重新部署
即可立即关闭危险能力。
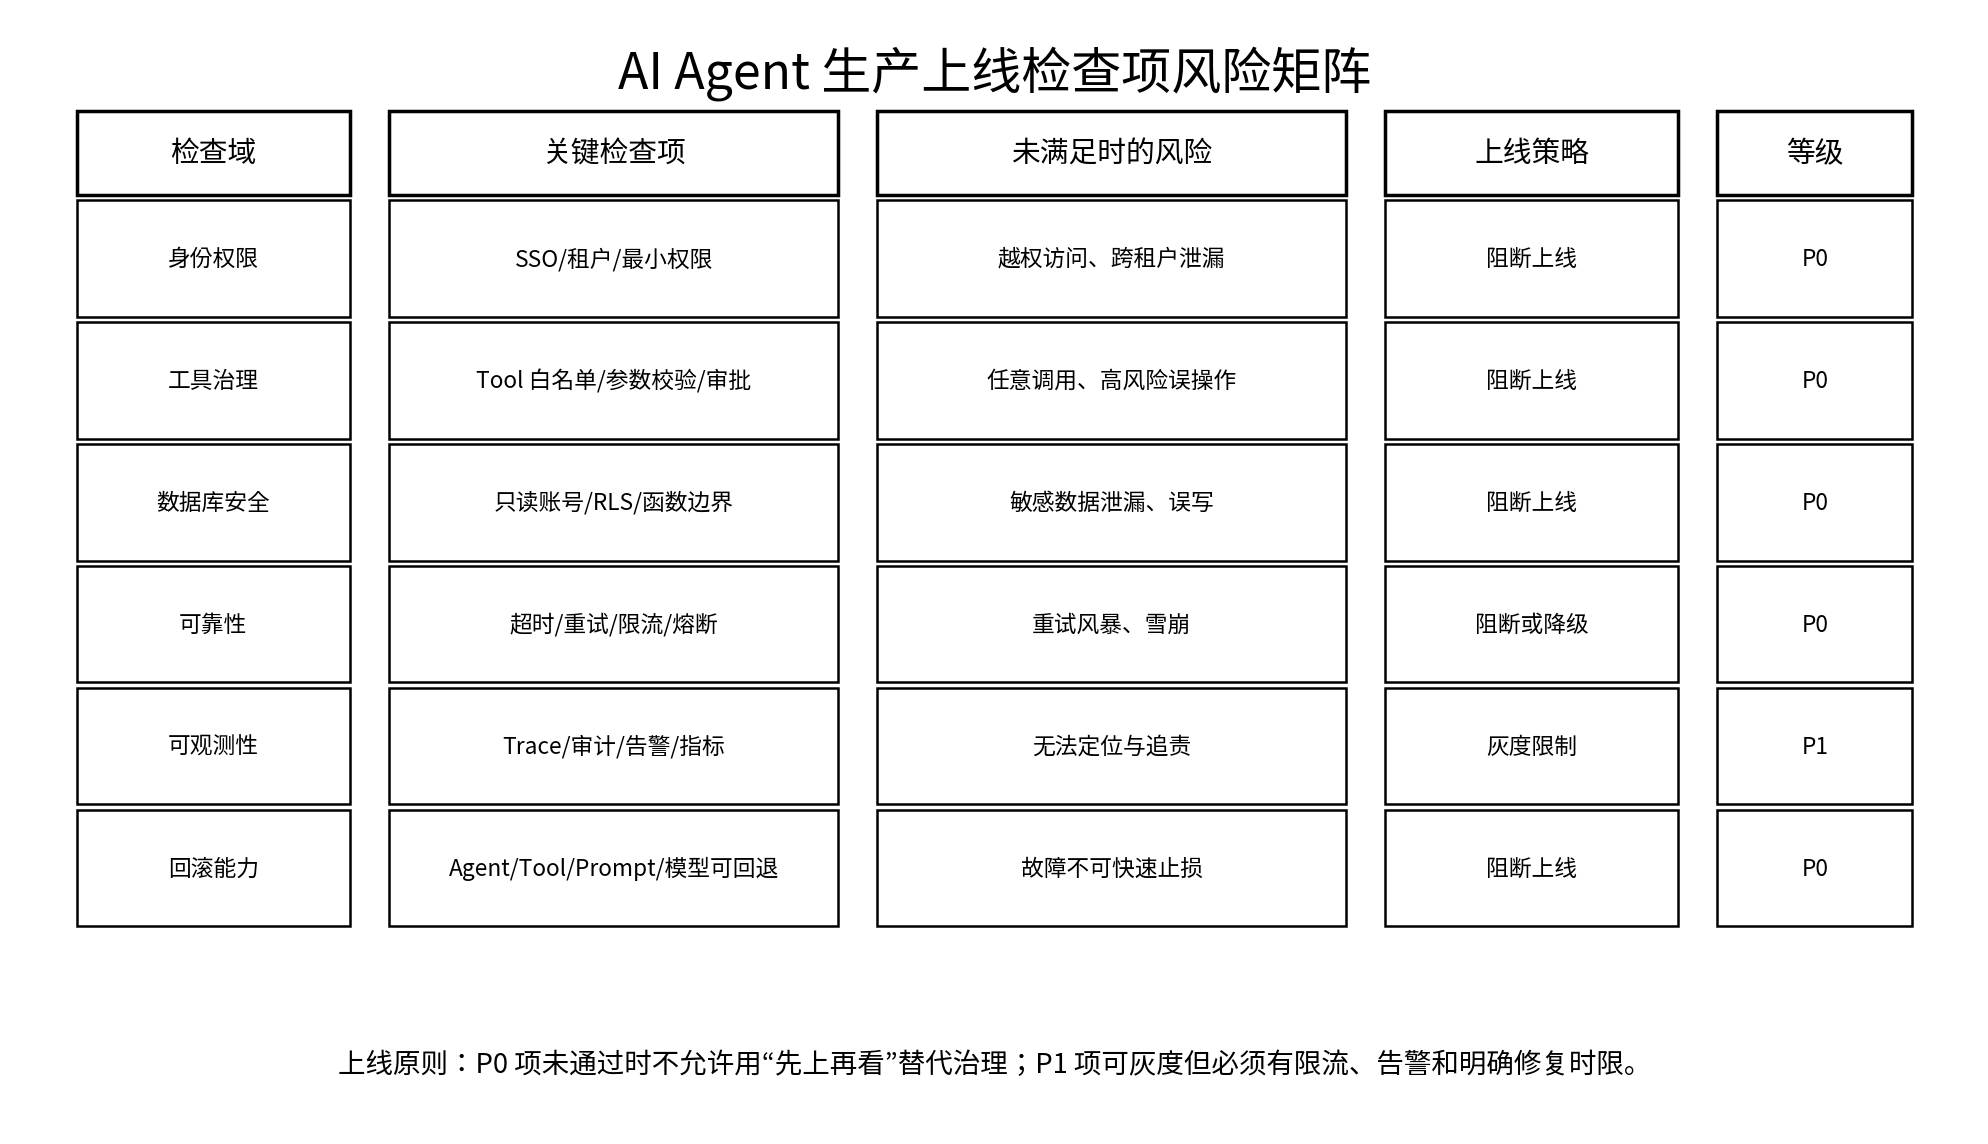
4.23 上线阻断规则
例如:
P0 FAIL > 0
→ 禁止上线

P1 FAIL > 3
→ 只能灰度

Prompt Injection Block Rate < 99%
→ 禁止全量

Cross-Tenant Test != 100%
→ 禁止上线

Rollback Drill Failed
→ 禁止上线
5. 结果对比
选取一个经营分析 Agent 进行改造。
改造前:
任意 SQL Tool
无 Tool Call 上限
普通数据库读账号
只记录 HTTP 日志
无人工复核
无回滚演练
改造后:
窄 Tool
权限策略
数据库最小权限
Tool Call 预算
Trace
审计
灰度
Kill Switch
复核
完整回滚
示例结果:
| 指标 | 原型版本 | 生产化版本 |
|---|---|---|
| 正常查询成功率 | 91.8% | 98.7% |
| 越权 Tool Call 阻断率 | 62% | 100% |
| Prompt Injection 拦截率 | 71% | 99.1% |
| 平均 Tool Calls / 问题 | 3.8 | 1.7 |
| 数据库 P95 | 420ms | 176ms |
| Agent P95 | 4.6s | 2.7s |
| 故障平均定位时间 | 46min | 8min |
| 回滚平均完成时间 | 35min | 7min |
| 高风险错误直接输出率 | 3.6% | 0.2% |
| 审计可追溯率 | 39% | 99.8% |
5.1 为什么生产化后反而更快
很多人会担心:
安全检查
审计
Tool Policy
会变慢。
实际上生产化后:
Tool 更窄
重复调用更少
结果更小
数据库路径更稳定
整体反而可能更快。
5.2 上线效果评估
不能只看:
DAU
至少分四类指标。
业务
问题解决率
人工节省时间
报表生成时长
用户满意度
AI
Tool Selection Accuracy
Answer Accuracy
High Confidence Error Rate
Average Tool Calls
数据库
DB QPS
P95
连接池等待
慢 SQL
锁等待
安全
Prompt Injection Block Rate
Unauthorized Tool Call Rate
Sensitive Data Leakage Rate
Cross-Tenant Block Rate
5.3 上线后一周重点观察
建议:
Day 1:安全与错误
Day 2:数据库压力
Day 3:Tool 调用分布
Day 4:人工驳回
Day 5:缓存与 Schema
Day 6:用户行为
Day 7:综合复盘
6. 风险与复盘
6.1 风险一:清单变成形式主义
如果每项都是:
“已确认”
没有证据,清单就没有意义。
推荐:
每个 P0 项必须附证据
例如:
测试报告
截图
Trace
审计日志
压测数据
演练记录
6.2 风险二:上线后认为工作结束
生产化是:
持续过程
而不是一次验收。
模型会更新:
模型版本
Prompt
Tool
Schema
知识库
权限
任何变化都可能让风险重新出现。
6.3 风险三:回滚只测过文档,没有演练
真正可用的回滚方案必须:
演练过
至少验证:
谁触发
怎么切流
多久恢复
数据是否安全
回滚后如何验证
6.4 风险四:数据库回滚和 Agent 回滚混为一谈
Agent 镜像可以快速回滚。
数据库:
DDL
数据写入
同步位点
不一定能直接反向恢复。
所以高风险数据库变更仍应使用:
Expand / Contract
避免把 Agent 回滚依赖数据库反向 DDL。
6.5 风险五:KFS 同步链路状态没有纳入 Agent
如果分析数据来自同步库:
同步失败
时 Agent 必须能够:
拒绝
降级
标注 data_as_of
不能继续给出看似实时的数据。
6.6 风险六:高风险 Tool 没有独立审批
查询和写操作不应使用同一安全等级。
例如:
get_sales_summary
可以自动。
而:
update_customer_status
应:
强确认
审计
幂等
短事务
6.7 风险七:指标只看系统,不看答案
Agent:
HTTP 200
Tool Success
SQL Success
都不能证明:
答案正确。
仍然需要:
答案准确率
人工驳回率
高置信错误率
6.8 风险八:没有停用机制
最危险的生产系统之一:
Tool 出问题后只能重新发版才能关闭。
关键 Tool 必须支持:
动态禁用
6.9 风险九:生产账号权限随时间膨胀
上线第一天:
只读
半年后可能因为临时需求逐渐多出:
INSERT
UPDATE
EXECUTE
所以权限必须定期:
重新审计
6.10 风险十:安全测试只做一次
每次:
模型升级
Tool 新增
Prompt 修改
Schema 变化
权限调整
都应该重新跑:
Prompt Injection
跨租户
越权 Tool
敏感数据
回滚
一份可直接用于上线评审的检查清单
A. 身份与权限
□ SSO/OIDC 已启用
□ user_id/tenant_id 来自可信认证态
□ Tool 权限与用户角色绑定
□ 跨租户访问 100% 被阻断
□ 数据库账号满足最小权限
B. KFS MCP Server 与 Tool
□ 不开放任意 SQL Tool
□ Tool 白名单已确认
□ inputSchema 已验证
□ 高风险 Tool 有人工确认
□ Tool Kill Switch 已验证
□ 单请求 Tool Call 数有限制
C. 数据库
□ SQL 参数化
□ SQL 超时已配置
□ 连接池容量已核算
□ 写操作有幂等键
□ 事务边界明确
□ RLS/Schema/独立库隔离已测试
D. AI 安全
□ Prompt Injection 测试通过
□ 间接提示注入测试通过
□ 敏感数据输出经过脱敏
□ RAG 权限过滤已验证
□ 工具结果大小有上限
E. 可观测性
□ trace_id 全链路贯通
□ Tool Call 有独立 Span
□ 数据库调用可观测
□ 审计日志已落库
□ 越权/异常调用有告警
F. 可靠性
□ SQL/Tool/Agent 超时层级合理
□ 重试白名单明确
□ 熔断已测试
□ 限流已测试
□ 数据库故障降级已验证
G. 数据与同步
□ Schema Version 可追踪
□ Metadata Cache 可失效
□ KFS/FlySync 状态可查询
□ data_as_of 能返回
□ 数据不完整时不会生成强结论
H. 效果评估
□ 正常问题测试集通过
□ Tool Selection Accuracy 达标
□ Answer Accuracy 达标
□ High Confidence Error Rate 达标
□ Human Review Rate 在预期范围
I. 灰度
□ 灰度比例可配置
□ 指标按版本区分
□ 新旧模型结果可对比
□ 数据库压力可分版本观察
J. 回滚
□ Agent 镜像可回滚
□ Prompt 可回滚
□ 模型路由可回滚
□ Tool 配置可回滚
□ 高风险 Tool 可立即禁用
□ 回滚 Smoke Test 已准备
□ 最近一次回滚演练通过
结语
AI Agent 从原型进入生产,本质上不是:
“把服务部署出去”
而是:
把一个会自主规划、会调用工具、
会访问企业数据的系统,
纳入正式的软件工程与安全治理体系。
本文最核心的生产原则可以概括为:
上线前要证明它安全,
上线时要限制它影响范围,
上线后要持续证明它仍然可靠,
出问题时要能够快速撤回能力。
真正成熟的 AI Agent 生产化,不是追求:
“永不出错”
而是做到:
错误能被发现,
影响能被限制,
原因能被追踪,
版本能被回滚,
系统能持续改进。
当 KFS MCP Server、数据库权限、Tool Policy、审计、人工复核、灰度和回滚共同成为一套工程体系时,AI Agent 才真正从 Demo 走向企业生产应用。
转载自:https://blog.csdn.net/u014727709/article/details/165363946
欢迎 👍点赞✍评论⭐收藏,欢迎指正

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 5
 0
- 0


 已为社区贡献39条内容

所有评论(0)