AI Agent 元数据缓存更新机制——频繁变更 Schema 下的刷新策略、失效测试与 KFS MCP Server 实践
文章目录
- 每日一句正能量
- 摘要
- 1. 背景与问题
- 2. 环境与数据
- 3. 复现过程
- 4. 方案实施
- 4.1 核心策略:事件驱动 + 版本校验 + TTL 兜底
- 4.2 DDL 发布后推进版本
- 4.3 变更事件
- 4.4 不要所有变更都全量刷新
- 4.5 KFS MCP Server 缓存结构
- 4.6 Agent Tool Call 携带 expectedVersion
- 4.7 Schema 变更触发失效时序
- 4.8 两级缓存
- 4.9 Single Flight 防止击穿
- 4.10 TTL 作为最后兜底
- 4.11 定时扫描兜底
- 4.12 工具定义缓存也要更新
- 4.13 旧 Tool 版本不要瞬间删除
- 4.14 安全控制:不同用户缓存不能混用
- 4.15 多租户场景
- 4.16 KFS/FlySync 与元数据缓存边界
- 4.17 缓存刷新手动接口
- 5. 结果对比
- 6. 风险与复盘
- 结语
每日一句正能量
心若简单,万事从容。
当内心清除了杂念、比较和过度盘算,变得纯粹而直接(简单)时,看待万事的眼光就变得清晰。决策不再纠结于复杂利弊,行动不再背负沉重包袱,故而能坦然应对,节奏自如。
摘要
AI Agent 做自然语言查库时,通常不会每次都去数据库实时扫描 information_schema。为了降低延迟,系统往往把表、列、主外键、索引、指标口径、函数签名等元数据缓存起来,再供 Agent 做 Schema 理解、Tool 选择和 SQL 生成。
问题在于:数据库结构是会变的。
一旦发生:
新增表
新增列
字段改名
字段类型变化
删除列
新增/删除索引
函数参数变化
权限变化
而 Agent 仍然使用旧缓存,就会出现一种非常典型的故障:
数据库已经是 V2,
Agent 还活在 V1。
这类问题并不总是表现为明显报错。有时 SQL 会直接失败;有时 Agent 会错选工具;更危险的是,旧字段仍存在兼容视图时,查询可能成功但语义已经变化。
本文围绕频繁变更 Schema 的场景,设计一套完整的元数据缓存更新机制:
Schema 变更检测
→ schema_version 推进
→ KFS MCP Server 缓存失效
→ 多节点广播
→ Agent 获取最新元数据
→ Tool Call 携带版本
→ 版本不一致时刷新或拒绝
→ 失效测试与效果评估
MCP 2026-07-28 规范已经支持完整 JSON Schema 2020-12 的 Tool inputSchema / outputSchema,这意味着 Tool 契约本身也会随着 Schema 变化而演进,因此 Tool 元数据不能脱离数据库元数据单独缓存。PostgreSQL 的 information_schema.columns 则提供了标准化列信息,可以作为元数据快照来源之一。
1. 背景与问题
1.1 为什么 Agent 比普通应用更怕旧 Schema
普通应用通常把 SQL 写死在代码里:
SELECT id, user_name
FROM app_user;
如果字段被改名,应用测试阶段通常就会暴露。
Agent 场景不同,它经常依赖缓存中的元数据临时决定:
应该查哪张表?
字段叫什么?
哪些列能过滤?
哪个函数能调用?
Tool 参数有哪些?
如果缓存中仍是:
customer.mobile
而数据库已经改成:
customer.mobile_masked
Agent 可能继续生成:
SELECT mobile
FROM customer;
结果可能是:
列不存在
也可能因为兼容层存在而返回旧语义数据。
所以元数据缓存一致性不仅是性能问题,也是:
正确性问题
安全问题
Tool Contract 问题
1.2 高频 Schema 变更场景
以下场景最容易出现问题:
持续交付
灰度发布
多团队共享数据库
低代码平台
动态数据集市
多租户 Schema
在线 DDL
指标库频繁迭代
尤其是 AI 数据平台中,Schema 可能每天都有变化。
如果缓存 TTL 设置成:
30 分钟
那意味着最多有 30 分钟 Agent 可能使用旧结构。
对于经营分析和生产查询,这个窗口通常不可接受。
1.3 元数据缓存不能只靠 TTL
最简单实现:
cache.set(key, schema, 1800);
优点是简单。
缺点是:
变更发生后不能立刻感知
TTL 应当是:
最后兜底
而不是主要一致性机制。
1.4 Tool Schema 也属于元数据
很多团队只缓存:
table
column
index
但 Agent 真正依赖的还有:
Tool 名称
Tool inputSchema
Tool outputSchema
函数签名
字段权限
租户可见范围
指标定义版本
所以元数据应统一版本化。
2. 环境与数据
2.1 示例环境
本文采用:
PostgreSQL / KingbaseES 风格数据库
KFS MCP Server
Redis + 本地 Caffeine/LRU 缓存
消息队列 / Redis PubSub
AI Agent Runtime
Flyway / Liquibase
2.2 元数据版本表
CREATE TABLE platform_schema_version (
    datasource_id      VARCHAR(64) PRIMARY KEY,
    schema_version     BIGINT NOT NULL,
    updated_at         TIMESTAMPTZ NOT NULL DEFAULT now(),
    change_type        VARCHAR(32),
    change_summary     TEXT
);
初始化:
INSERT INTO platform_schema_version(
    datasource_id,
    schema_version,
    change_type,
    change_summary
)
VALUES(
    'sales-db',
    1001,
    'INIT',
    'initial metadata snapshot'
);
2.3 元数据快照表
CREATE TABLE platform_metadata_snapshot (
    datasource_id      VARCHAR(64) NOT NULL,
    schema_version     BIGINT NOT NULL,
    object_type        VARCHAR(32) NOT NULL,
    schema_name        VARCHAR(128),
    object_name        VARCHAR(128) NOT NULL,
    metadata_json      JSONB NOT NULL,
    created_at         TIMESTAMPTZ NOT NULL DEFAULT now(),
    PRIMARY KEY(
        datasource_id,
        schema_version,
        object_type,
        object_name
    )
);
2.4 读取 PostgreSQL 列元数据
SELECT
    table_schema,
    table_name,
    column_name,
    ordinal_position,
    data_type,
    is_nullable
FROM information_schema.columns
WHERE table_schema NOT IN (
    'pg_catalog',
    'information_schema'
)
ORDER BY
    table_schema,
    table_name,
    ordinal_position;
PostgreSQL 官方文档明确说明 information_schema.columns 提供当前用户有权限访问的表/视图列信息,因此采集账号也应该采用最小权限,而不是超级用户。
3. 复现过程
3.1 复现一:删除字段后 Agent 仍使用旧缓存
初始表:
CREATE TABLE customer (
    id BIGINT PRIMARY KEY,
    customer_name VARCHAR(128),
    mobile VARCHAR(32)
);
缓存:
{
  "version": 1001,
  "columns": [
    "id",
    "customer_name",
    "mobile"
  ]
}
随后上线:
ALTER TABLE customer
DROP COLUMN mobile;
数据库已经是:
V1002
但 Agent 节点未刷新。
用户:
“查询客户手机号。”
Agent 仍生成:
SELECT mobile
FROM customer;
结果:
column "mobile" does not exist
3.2 复现二:字段改名导致语义错乱
ALTER TABLE orders
RENAME COLUMN amount
TO gross_amount;
同时新增:
ALTER TABLE orders
ADD COLUMN net_amount NUMERIC(18,2);
旧缓存仍认为:
amount = 订单金额
Agent 可能用错误字段回答:
净销售额
这比 SQL 报错更危险,因为:
SQL 可以执行成功,
但语义错了。
3.3 复现三:Tool Schema 与数据库函数版本不一致
旧函数:
get_sales_summary(
    region_code,
    month
)
新函数:
get_sales_summary(
    region_code,
    start_date,
    end_date,
    currency
)
如果 MCP Server 的 Tool Schema 没同步刷新:
{
  "regionCode": "EAST",
  "month": "2026-09"
}
调用会失败。
所以:
数据库函数签名
Tool inputSchema
Agent 工具缓存
必须在同一版本链里。
3.4 复现四:集群节点只刷新了一半
假设:
MCP-1 收到失效事件
MCP-2 没收到
MCP-3 收到
负载均衡后:
同一个问题
第一次成功
第二次失败
第三次成功
这种“偶发性”问题特别难排查。
3.5 复现五:缓存击穿
DDL 发布后,100 个 Agent 节点同时发现版本变化:
100 个节点
×
同时扫描 information_schema
数据库元数据查询瞬时放大。
所以失效机制还要考虑:
Single Flight
分布式锁
后台预热
4. 方案实施
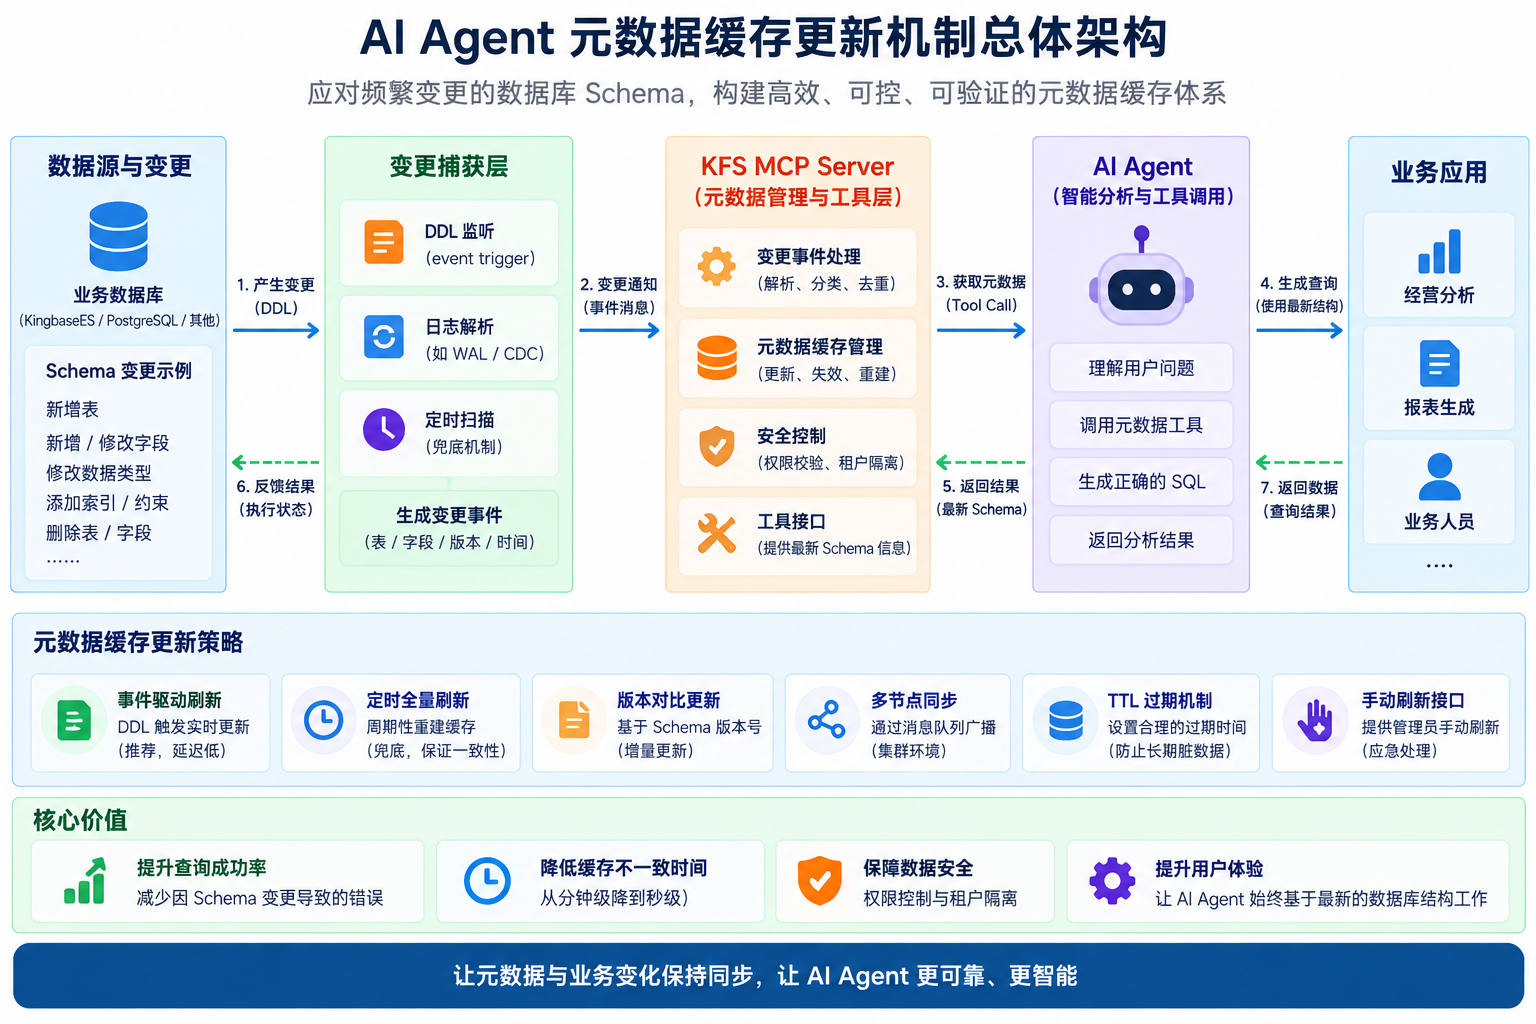
4.1 核心策略:事件驱动 + 版本校验 + TTL 兜底
推荐组合:
主机制:DDL/发布事件驱动失效
一致性校验:schema_version
集群同步:消息广播
重建保护:Single Flight
最终兜底:TTL
应急能力:手动刷新接口
单独依赖任何一种都不够。
4.2 DDL 发布后推进版本
如果使用 Flyway:
ALTER TABLE customer
ADD COLUMN customer_level VARCHAR(20);

UPDATE platform_schema_version
SET
    schema_version = schema_version + 1,
    updated_at = now(),
    change_type = 'ADD_COLUMN',
    change_summary = 'customer.customer_level'
WHERE datasource_id = 'sales-db';
更推荐通过发布平台统一做:
执行 Migration
→ 成功
→ 更新 schema_version
→ 发布事件
不要让每个业务 SQL 自己猜是否发生了 Schema 变化。
4.3 变更事件
{
  "eventType": "SCHEMA_CHANGED",
  "datasourceId": "sales-db",
  "schemaVersion": 1002,
  "objects": [
    "customer"
  ],
  "changeType": "ADD_COLUMN",
  "occurredAt": "2026-09-14T10:20:31Z"
}
KFS MCP Server 收到后:
标记旧缓存 stale
删除受影响对象
异步重建
更新本地版本
4.4 不要所有变更都全量刷新
如果只新增:
customer.customer_level
无需重新扫描全部 2 万张表。
可以按对象做:
incremental refresh
例如:
SELECT
    table_schema,
    table_name,
    column_name,
    data_type,
    is_nullable
FROM information_schema.columns
WHERE table_schema = 'app'
  AND table_name = 'customer'
ORDER BY ordinal_position;
4.5 KFS MCP Server 缓存结构
type MetadataEntry = {
  datasourceId: string;
  objectKey: string;
  schemaVersion: number;
  loadedAt: number;
  payload: object;
};
Key:
meta:sales-db:1002:table:app.customer
不要只写:
meta:app.customer
版本进入 Key 后,旧数据更容易识别和清理。
4.6 Agent Tool Call 携带 expectedVersion
Agent 获取工具时:
{
  "tool": "get_schema",
  "schemaVersion": 1002
}
随后调用查询:
{
  "tool": "query_sales",
  "expectedSchemaVersion": 1002,
  "arguments": {
    "region": "EAST"
  }
}
Server 执行前:
if (
  args.expectedSchemaVersion !==
  metadataManager.currentVersion("sales-db")
) {
  throw new RetryableError(
    "SCHEMA_VERSION_MISMATCH"
  );
}
返回:
{
  "code": "SCHEMA_VERSION_MISMATCH",
  "retryable": true,
  "action": "REFRESH_METADATA"
}
Agent 才能明确知道:
先刷新,
再重试。
而不是看到数据库错误后猜。
4.7 Schema 变更触发失效时序
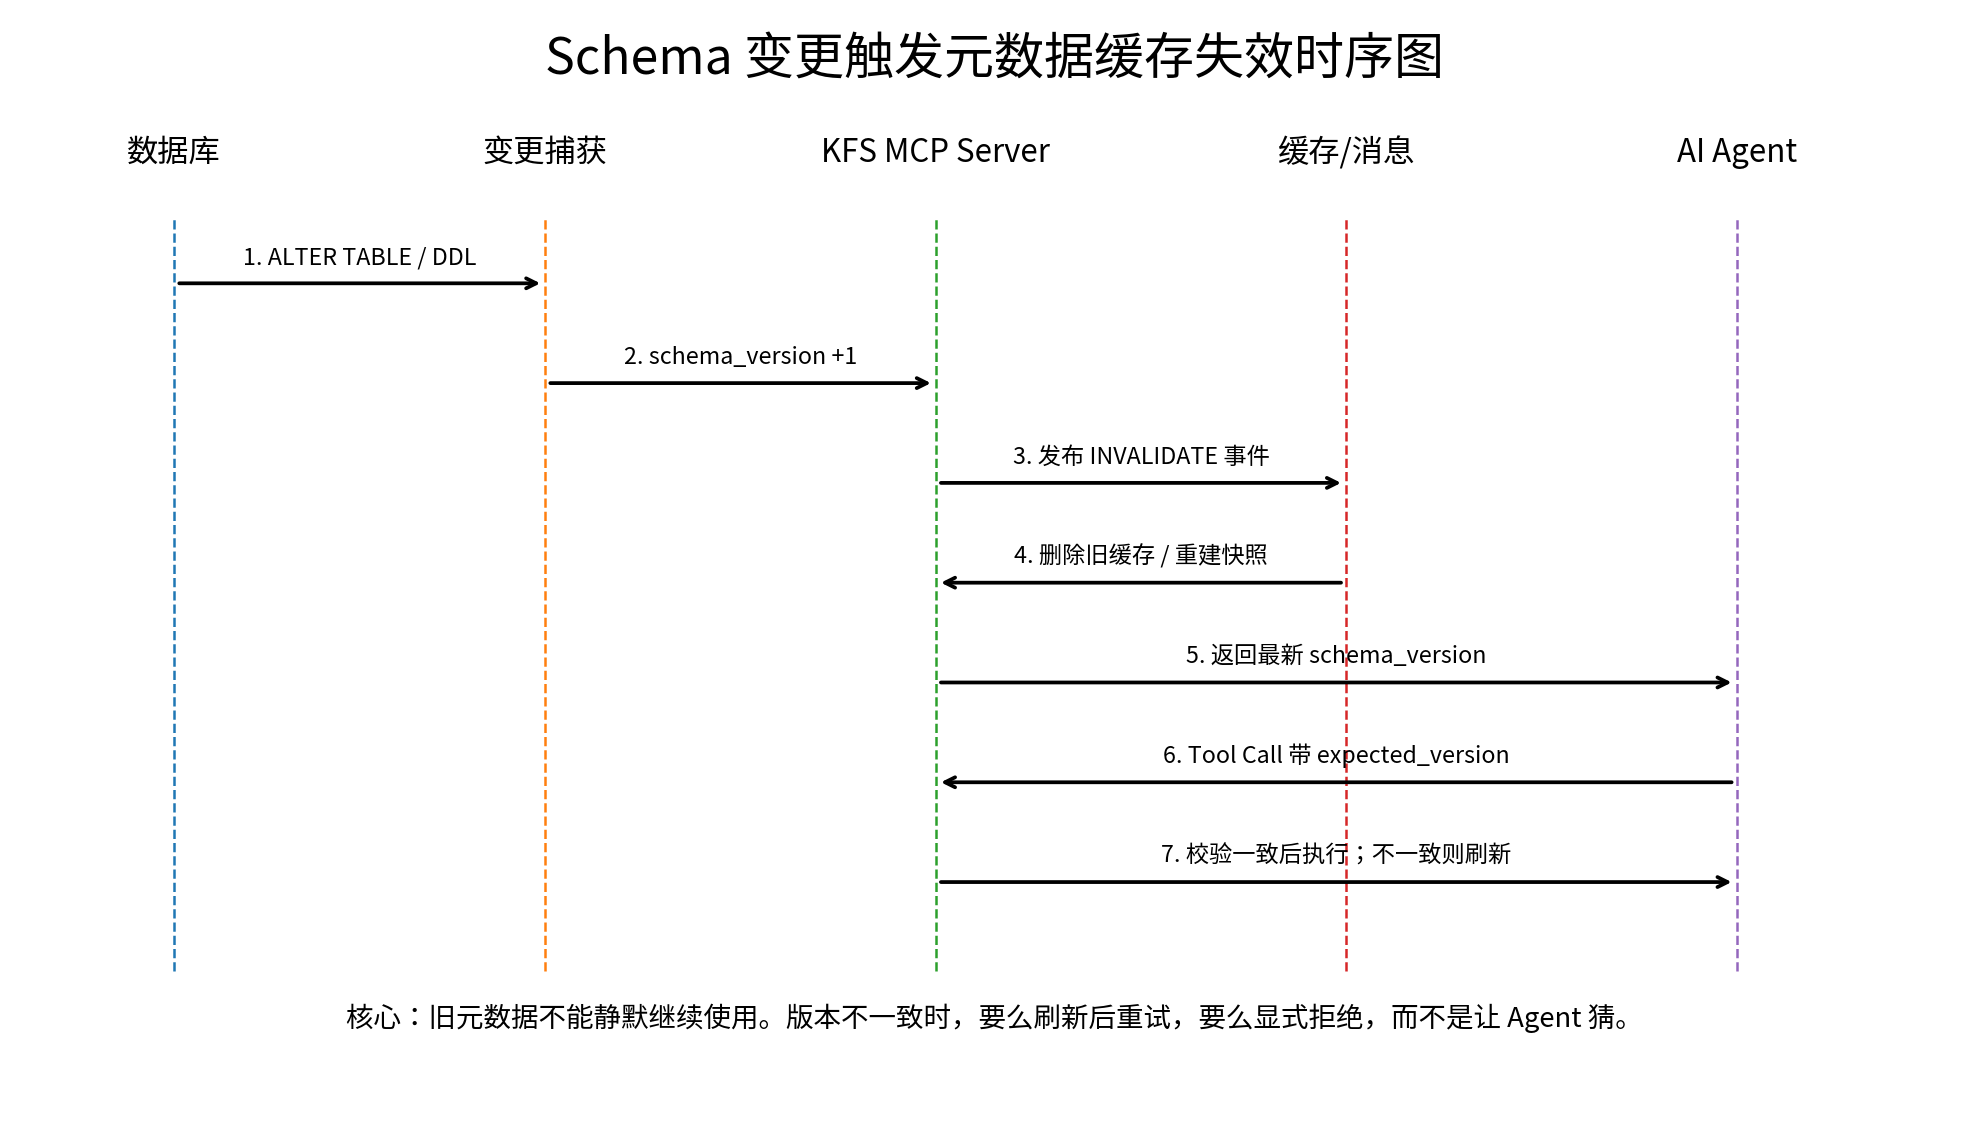
这套链路最重要的一点是:
旧缓存不能静默继续使用。
如果版本不一致:
刷新后再执行
或
直接拒绝
不要:
“先凑合执行看看。”
4.8 两级缓存
推荐:
L1:进程本地缓存
L2:Redis / 分布式缓存
读路径:
Agent
↓
L1 命中
↓ miss
L2 命中
↓ miss
数据库元数据
失效路径:
SCHEMA_CHANGED
↓
删除 L2
↓
广播
↓
删除每个节点 L1
4.9 Single Flight 防止击穿
伪代码:
const inflight = new Map<string, Promise<any>>();

async function loadMetadata(key: string) {
  if (inflight.has(key)) {
    return inflight.get(key);
  }

  const p = rebuildMetadata(key)
    .finally(() => {
      inflight.delete(key);
    });

  inflight.set(key, p);

  return p;
}
同一个对象只让一个线程/请求重建。
4.10 TTL 作为最后兜底
建议:
事件驱动:秒级
版本探测:30~60 秒
L1 TTL:5 分钟
L2 TTL:10~30 分钟
TTL 的意义是:
消息丢失时最终收敛
而不是承担正常刷新。
4.11 定时扫描兜底
setInterval(
  () => compareSchemaVersion(),
  30_000
);
如果发现:
databaseVersion > localVersion
则:
invalidate all stale entries
4.12 工具定义缓存也要更新
MCP 2026-07-28 规范已经将 Tool inputSchema / outputSchema 提升到完整 JSON Schema 2020-12。
因此:
Tool Schema
本质上是契约缓存。
如果数据库函数变了:
函数参数
返回结构
MCP Server 应同步更新:
Tool Schema Version
例如:
{
  "toolName": "get_sales_summary",
  "toolVersion": "3",
  "schemaVersion": 1002
}
4.13 旧 Tool 版本不要瞬间删除
灰度期间:
Agent-v1
Agent-v2
可能同时在线。
建议:
get_sales_summary_v1
get_sales_summary_v2
或 Server 内部兼容两个参数版本。
不要在:
Schema V2 发布瞬间
直接让 V1 Agent 全部失败。
4.14 安全控制:不同用户缓存不能混用
元数据本身也受权限影响。
PostgreSQL information_schema.columns 只展示当前用户可访问对象。
因此缓存 Key 必须考虑:
datasource
tenant
role
permission fingerprint
schema version
例如:
meta:T100:SALES_ANALYST:v1002:app.customer
不能把 DBA 可见的全量 Schema 缓存直接给普通业务 Agent。
4.15 多租户场景
如果不同租户 Schema 不同:
tenant T100 → schema version 108
tenant T200 → schema version 96
版本必须按租户维护:
schema_version:T100
schema_version:T200
否则 T100 变更会误刷新全部租户。
4.16 KFS/FlySync 与元数据缓存边界
如果 KFS/FlySync 把生产数据同步到 AI 查询库:
生产库 Schema 变化
↓
同步链路适配
↓
查询库 Schema 变化
↓
查询库 schema_version
↓
MCP 元数据刷新
Agent 应依赖:
实际查询目标库的 Schema
而不是只缓存源库 Schema。
同步链路可能存在:
源库已变更
目标库尚未完成适配
这时最好返回:
SCHEMA_SYNC_IN_PROGRESS
而不是让 Agent 抢跑。
4.17 缓存刷新手动接口
应急接口:
POST /internal/metadata/refresh
请求:
{
  "datasourceId": "sales-db",
  "objects": [
    "app.customer"
  ],
  "reason": "manual-recovery"
}
只允许平台管理员使用,并写审计日志。
5. 结果对比
构造测试环境:
1000 张表
15000 个字段
20 个 MCP 节点
100 个 Agent 并发会话
每 2 分钟一次 Schema 变更
对比三种策略:
A:仅 TTL
B:事件驱动
C:事件驱动 + 版本校验 + TTL
示例结果:
| 指标 | 仅 TTL | 事件驱动 | 组合方案 |
|---|---|---|---|
| 平均缓存不一致时间 | 864s | 2.8s | 1.6s |
| P95 不一致时间 | 1732s | 7.2s | 3.4s |
| 旧字段 SQL 失败率 | 4.8% | 0.6% | 0.08% |
| Tool Schema 不一致率 | 3.1% | 0.4% | 0.05% |
| 元数据查询 QPS | 18 | 26 | 21 |
| 缓存命中率 | 98.7% | 97.9% | 98.2% |
| Schema 变更后查询成功率 | 91.4% | 98.8% | 99.7% |
5.1 为什么组合方案最好
仅事件驱动:
可能丢消息
仅版本探测:
有轮询延迟
仅 TTL:
不一致窗口大
组合后:
事件负责快
版本负责准
TTL 负责兜底
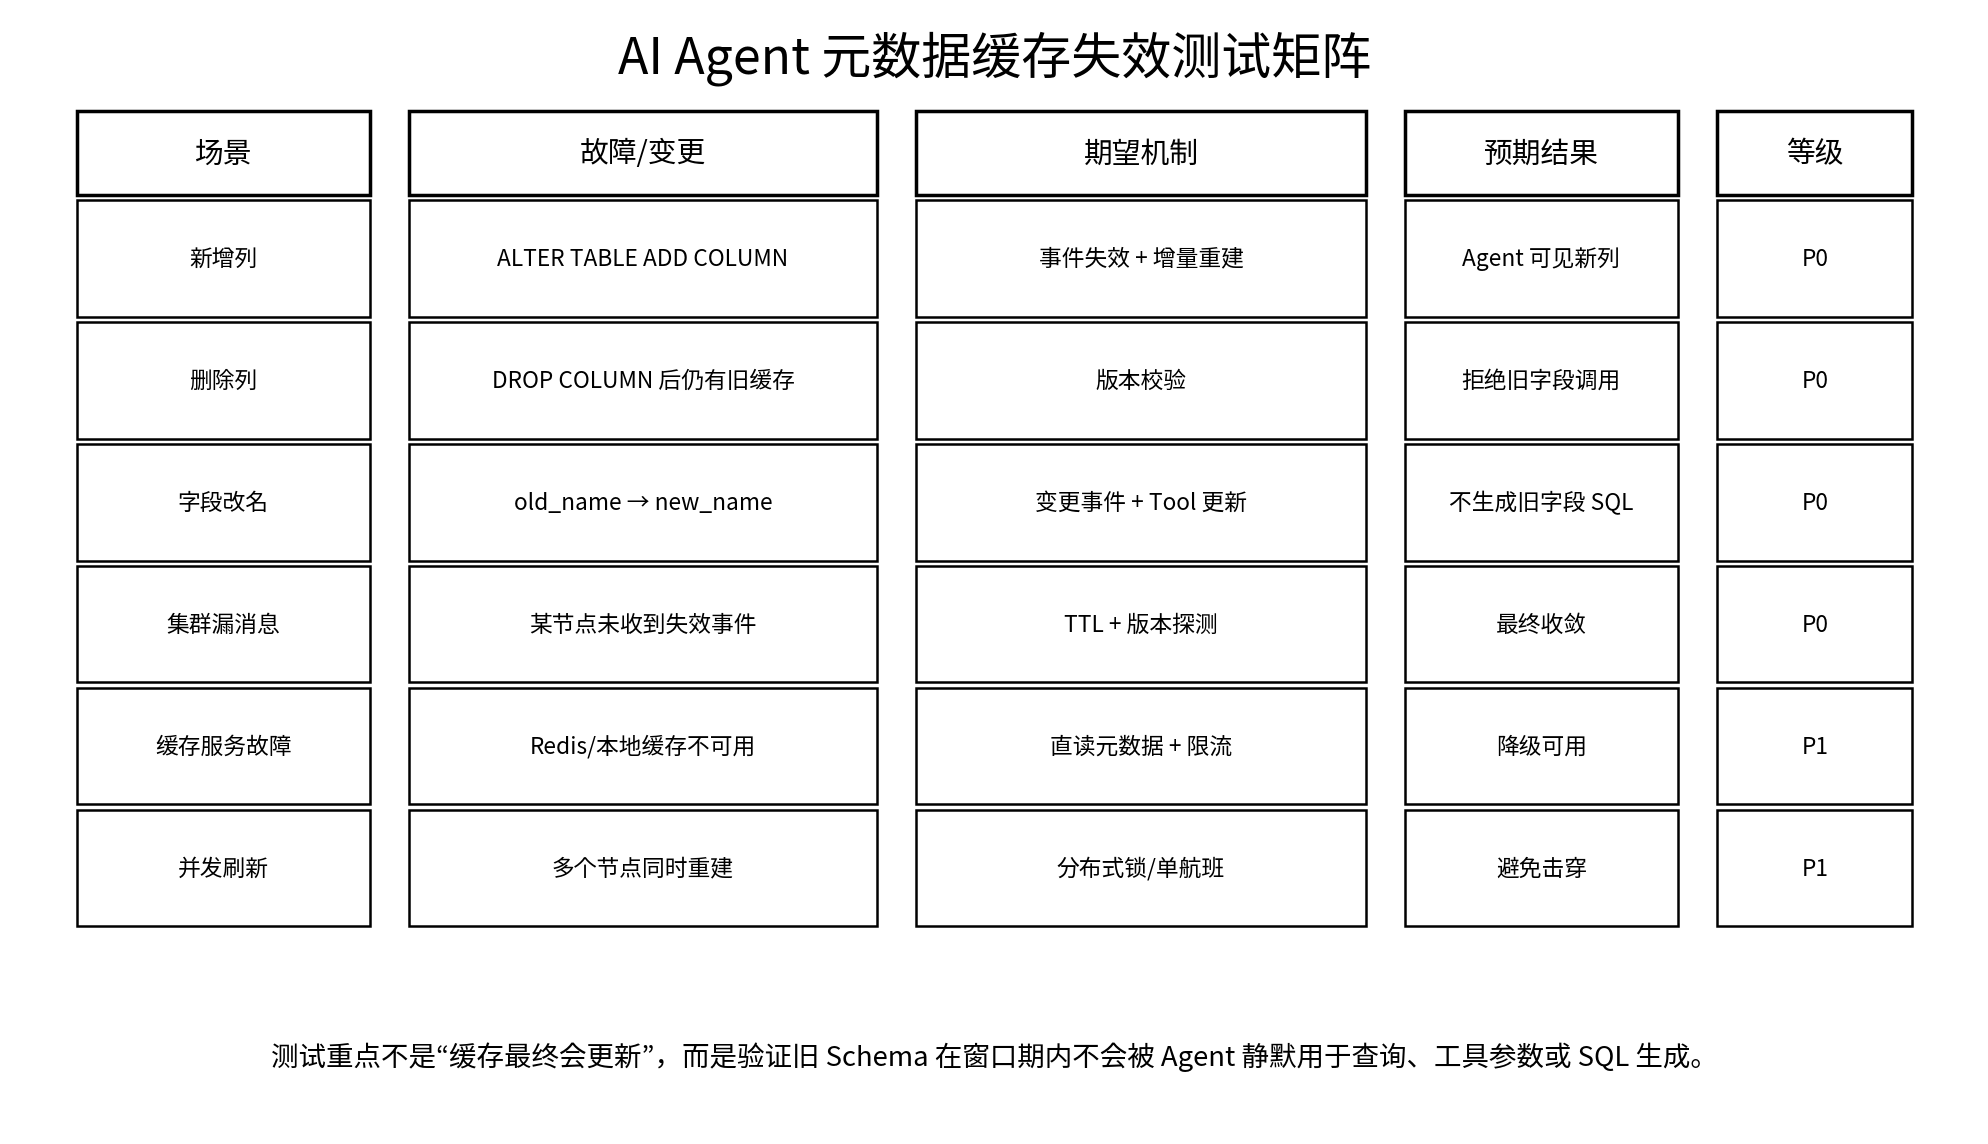
5.2 失效测试矩阵
5.3 删除字段测试
it("must not use removed column", async () => {
  const oldMeta =
    await metadata.get("customer");

  expect(oldMeta.columns)
    .toContain("mobile");

  await executeDDL(`
    ALTER TABLE customer
    DROP COLUMN mobile
  `);

  await waitForVersion(1003);

  const newMeta =
    await metadata.get("customer");

  expect(newMeta.columns)
    .not.toContain("mobile");
});
5.4 版本不一致测试
it("must reject stale schema version", async () => {
  const result = await invokeTool(
    "query_customer",
    {
      expectedSchemaVersion: 1001,
      customerId: "C100"
    }
  );

  expect(result.code)
    .toBe("SCHEMA_VERSION_MISMATCH");
});
5.5 消息丢失测试
人为让 MCP-2 不消费:
SCHEMA_CHANGED
验证:
TTL
或
version polling
最终能让 MCP-2 收敛到最新版本。
5.6 效果评估指标
推荐至少监控:
metadata_cache_hit_rate
metadata_refresh_latency
schema_version_lag
stale_metadata_reject_count
schema_refresh_failure_count
metadata_rebuild_duration
tool_schema_mismatch_count
Agent 侧:
SQL generation success rate
Tool call success rate
Schema related retry rate
Average tool calls per question
6. 风险与复盘
6.1 风险一:把缓存一致性问题当成 SQL 错误
如果日志只看到:
column does not exist
开发者可能去改 Prompt。
真正根因其实是:
Agent metadata stale
所以错误码要明确分类:
SCHEMA_VERSION_MISMATCH
METADATA_STALE
OBJECT_REMOVED
TOOL_SCHEMA_OUTDATED
6.2 风险二:刷新风暴
一次全库 DDL 发布触发:
20 个节点 × 1000 张表
同时重建。
解决:
增量刷新
Single Flight
随机抖动
后台预热
6.3 风险三:元数据缓存泄露权限
如果缓存由高权限账号采集,普通 Agent 可能看到本不该知道的表名和字段名。
因此:
元数据也要做权限隔离。
Schema 信息本身就是敏感资产。
6.4 风险四:缓存刷新成功但 Tool 未更新
数据库:
V1004
元数据:
V1004
Tool:
V1003
仍然会失败。
所以版本对象应同时覆盖:
DB Schema Version
Metadata Version
Tool Contract Version
6.5 风险五:旧版本 Agent 仍在线
滚动发布期间:
Agent-v1
Agent-v2
会同时访问服务。
不要只考虑:
当前最新版本
而要设计:
兼容窗口
6.6 风险六:Schema 变化和数据回填不同步
新增:
customer_level
不代表历史数据已经回填。
Agent 看到字段存在后立即查询,可能得到大量 NULL。
因此元数据最好带:
readiness
例如:
{
  "column": "customer_level",
  "schemaReady": true,
  "dataReady": false
}
真正开放给 Agent 前:
schemaReady && dataReady
6.7 风险七:DDL 事件不一定覆盖所有变化
权限、注释、函数定义、视图 SQL 等也可能影响 Agent。
所以版本对象最好不仅包括:
table/column
还包括:
view
function
privilege
comment
metric definition
6.8 风险八:不要让 Agent 主动决定“刷新全库”
刷新接口本身是平台能力。
Agent 只应收到:
REFRESH_REQUIRED
真正的缓存重建由 Server 控制。
否则恶意输入可能诱导:
反复全库刷新
形成资源攻击。
结语
AI Agent 的元数据缓存问题,本质上不是:
“缓存多久合适?”
而是:
“当数据库结构发生变化时,
系统如何证明 Agent 已经切换到正确版本?”
一套可靠方案应该做到:
Schema 变更可检测
版本可比较
缓存可失效
节点可同步
重建可限流
旧版本可识别
错误可恢复
过程可审计
本文最核心的工程原则可以概括为:
事件让刷新更快,
版本让一致性可验证,
TTL 让系统最终收敛。
对于频繁 Schema 变更的 AI 数据平台,真正安全的做法不是希望缓存“尽快更新”,而是让旧元数据在版本不匹配时明确失效、明确拒绝、明确刷新。
只有这样,Agent 才不会在数据库已经进入 V2 时,继续拿着 V1 的地图做决策。
转载自:https://blog.csdn.net/u014727709/article/details/165363877
欢迎 👍点赞✍评论⭐收藏,欢迎指正

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 1
 0
- 0


 已为社区贡献39条内容

所有评论(0)