AI Agent 输出错误数据时的人工复核机制——经营分析中的置信度、KFS MCP Server 与人机协同闭环
每日一句正能量
一念放下,万般自在。
当这最沉重的“一念”被卸下,心灵不再被其占据和消耗,内在的空间便被释放,从而体验到一种如释重负、海阔天空的“自在”。
摘要
企业助手真正进入经营分析之后,风险不再只是“模型会不会胡说”。更现实的问题是:Agent 可能调用了正确工具,却使用了错误口径;也可能 SQL 执行成功,但查询时间范围错误;还可能数据本身延迟、缓存过期、同步链路未追平,最终生成一个形式完整但业务上错误的数字。
这种问题最危险,因为它不像数据库报错那样显眼。一个返回 500 的接口会被立刻发现,但一个“看起来合理的错误销售额”很可能被直接复制到周报、经营会和预算决策里。
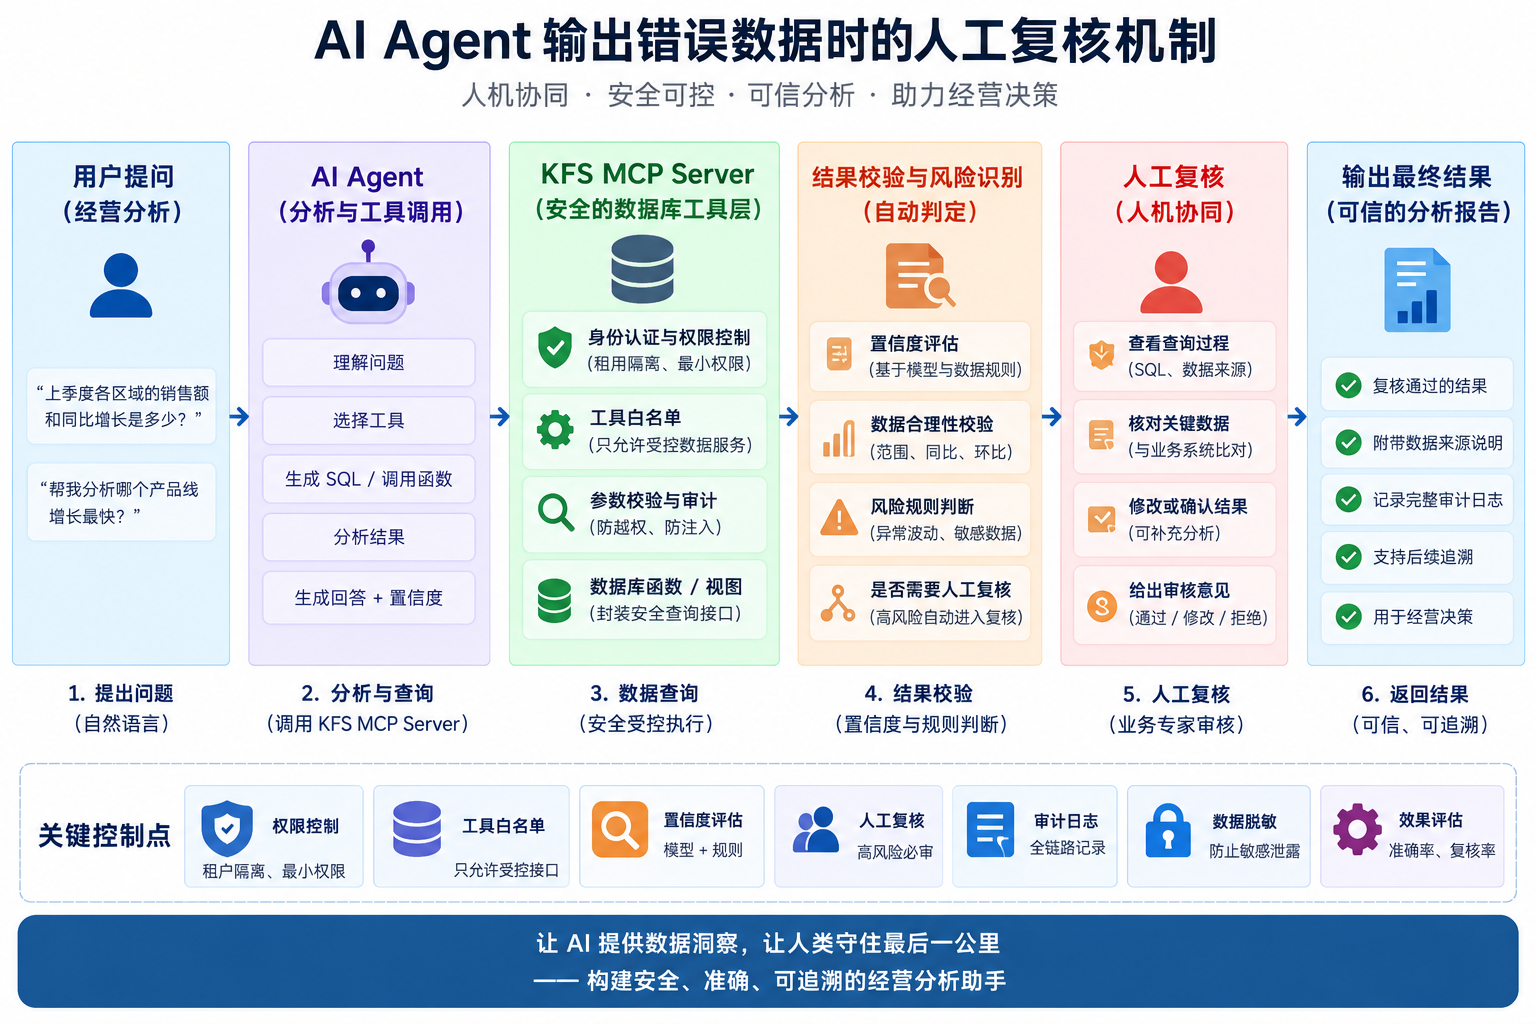
因此,生产级经营分析 Agent 不能把“模型给出答案”视为流程终点,而应该建立一套人机协同机制:
Agent 生成分析
→ 证据完整性检查
→ 数据一致性校验
→ 综合置信度计算
→ 风险分级
→ 判断是否需要人工复核
→ 专家确认 / 修改 / 驳回
→ 审核结果进入评测集
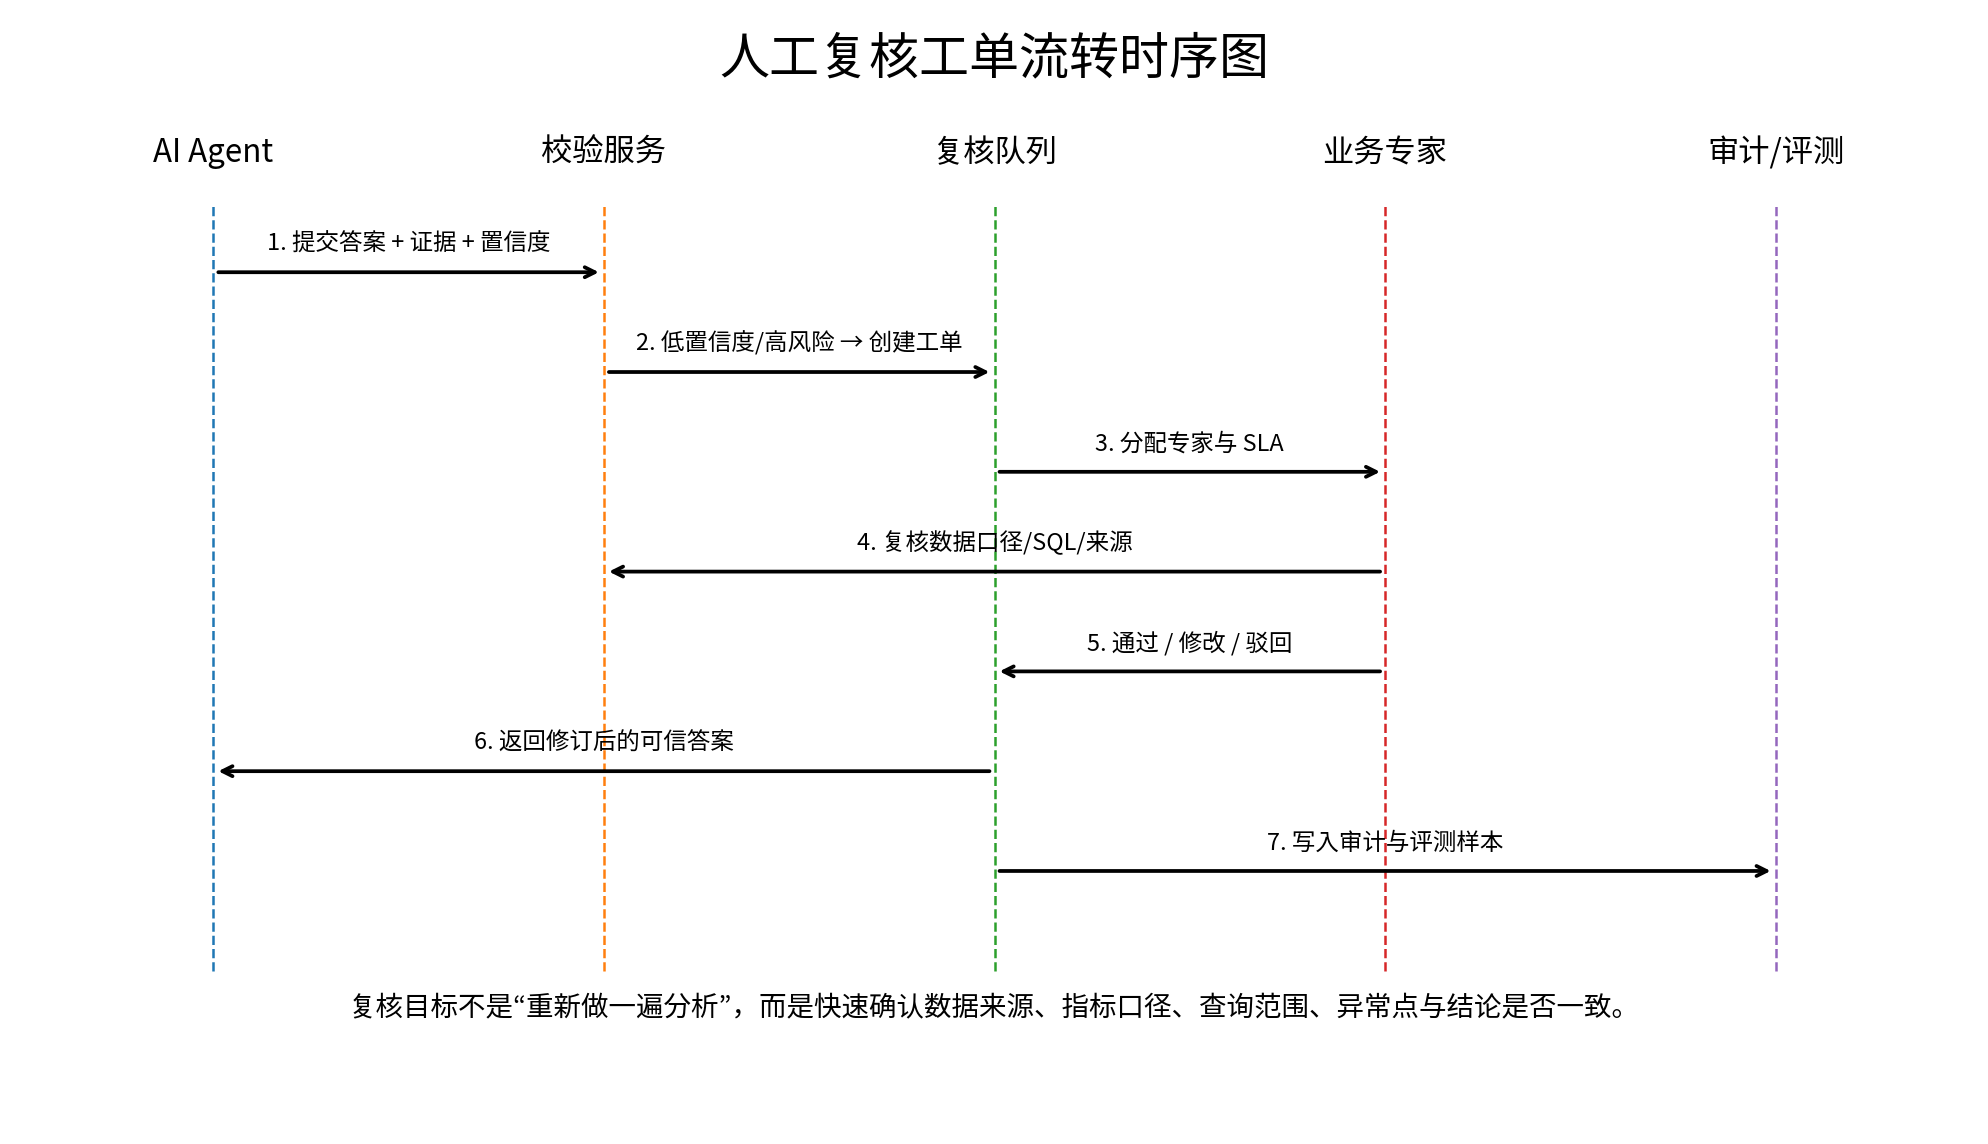
本文重点讨论如何把人工复核做成系统能力,而不是“感觉不对就找个人看一下”。具体包括置信度计算、KFS MCP Server 的工具证据、数据库查询留痕、复核工单、审核 SQL、指标口径核验、安全控制、复核 SLA 以及效果评估。
需要先说明术语边界:公开产品资料中的 KFS 是 Kingbase FlySync,用于异构数据平台间的实时、增量数据同步。本文延续本系列的架构称呼,将“KFS MCP Server”定义为面向数据库/KFS能力的受控 MCP 工具服务层,两者并不等价。
1. 背景与问题
1.1 AI 输出“错误数据”比输出“无答案”更危险
假设经营负责人询问:
“上季度华东区域销售额是多少,同比增长多少?”
Agent 返回:
上季度华东区销售额为 1.28 亿元,同比增长 17.6%。
主要增长来自企业客户和渠道业务。
结果看起来非常完整,但实际上可能存在以下问题:
- 查询使用的是“下单金额”,而管理层口径要求“已支付且扣除退款金额”;
- “上季度”被模型解析成自然季度,而报表采用财务季度;
- KFS 同步链路延迟 40 分钟,查询库数据尚未追平;
- 同比去年数据使用了旧指标口径;
- 退款数据 Tool Call 失败后,Agent 使用了部分结果继续计算;
- Agent 为了生成“原因分析”,把相关性写成了因果关系。
这些问题中,大部分 SQL 都可能执行成功。
所以:
SQL 成功
≠
数据正确
≠
口径正确
≠
结论可靠
1.2 经营分析为什么必须引入 Human-in-the-Loop
技术团队常见两种极端方案。
第一种:
所有答案都自动返回
优点是快,缺点是高风险结论也直接流向用户。
第二种:
所有答案都人工审核
安全但失去了 Agent 提效价值,而且审核团队会迅速变成瓶颈。
更合理的模式是:
低风险 + 高置信度
→ 自动返回

中风险 / 中置信度
→ 返回并标记限制,抽样复核

高风险 或 低置信度
→ 强制人工复核
人工复核应该集中在真正值得人看的 5%~15% 高风险结果上。
1.3 “模型置信度”不能直接当可信度
最容易犯的错误是让模型自己输出:
{
  "answer": "...",
  "confidence": 0.96
}
这个数字并不能证明答案真的正确。
经营分析场景中的置信度应该更多来自系统证据,例如:
指标口径是否命中唯一版本
Tool Call 是否全部成功
数据是否新鲜
查询范围是否符合授权
结果是否通过同比/环比异常检测
是否发生降级或缓存兜底
关键数据源是否一致
所以本文后面使用的是:
系统综合置信度
而不是:
模型自报概率
2. 环境与数据
2.1 示例架构
本文假设经营分析助手采用:
用户
↓
AI Agent
↓
KFS MCP Server
↓
指标定义工具 / 数据查询工具 / 同步状态工具
↓
数据库函数 / 数据服务库
↓
人工复核平台
同时保留:
Tool Call 审计
SQL / 函数调用记录
数据版本
指标口径版本
复核工单
最终审核结果
MCP 官方规范支持服务器暴露结构化 Tool,并定义 inputSchema、可选 outputSchema 和结构化结果;同时官方建议高风险工具场景保留 human-in-the-loop 的拒绝/确认能力。这为“工具证据 + 人工审核”的组合提供了很好的工程基础。
2.2 示例经营指标表
CREATE TABLE metric_definition (
    metric_code      VARCHAR(64) NOT NULL,
    metric_version   INTEGER NOT NULL,
    metric_name      VARCHAR(128) NOT NULL,
    formula_desc     TEXT NOT NULL,
    effective_from   DATE NOT NULL,
    effective_to     DATE,
    status           VARCHAR(20) NOT NULL,
    PRIMARY KEY(metric_code, metric_version)
);
销售事实表:
CREATE TABLE sales_daily (
    biz_date          DATE NOT NULL,
    tenant_id         VARCHAR(32) NOT NULL,
    region_code       VARCHAR(32) NOT NULL,
    order_amount      NUMERIC(18,2) NOT NULL,
    paid_amount       NUMERIC(18,2) NOT NULL,
    refund_amount     NUMERIC(18,2) NOT NULL,
    PRIMARY KEY(biz_date, tenant_id, region_code)
);
2.3 复核记录表
CREATE TABLE agent_review_task (
    review_id              BIGSERIAL PRIMARY KEY,
    trace_id               VARCHAR(64) NOT NULL,
    request_id             VARCHAR(64) NOT NULL,
    user_id                VARCHAR(128) NOT NULL,

    question_summary       TEXT NOT NULL,
    answer_summary         TEXT NOT NULL,

    confidence_score       NUMERIC(5,4) NOT NULL,
    risk_level             VARCHAR(16) NOT NULL,
    review_reason          VARCHAR(128) NOT NULL,

    metric_code            VARCHAR(64),
    metric_version         INTEGER,

    tool_evidence          JSONB,
    validation_result      JSONB,

    review_status          VARCHAR(20) NOT NULL,
    reviewer_id            VARCHAR(128),
    reviewer_comment       TEXT,

    created_at             TIMESTAMPTZ NOT NULL DEFAULT now(),
    reviewed_at            TIMESTAMPTZ
);
状态可以设计为:
PENDING
IN_REVIEW
APPROVED
MODIFIED
REJECTED
3. 复现过程
3.1 场景一:口径正确、SQL 正确,但同步数据未追平
用户询问:
“今天截至 10 点的全国销售额是多少?”
Agent 调用:
get_sales_summary
SQL 执行正常。
但数据服务库的数据同步位置只到:
09:42
如果 Agent 不检查同步状态,返回数字本身没有数据库错误,却属于业务错误。
正确流程应多一次:
get_data_freshness
如果:
数据延迟 > 业务允许阈值
则置信度下降,答案中必须明确:
当前数据截至 09:42
高风险场景则直接进入人工复核。
3.2 场景二:指标版本错配
今年 7 月开始,公司把 GMV 口径从:
订单创建金额
调整为:
支付成功金额 - 已完成退款金额
用户问:
“今年 8 月 GMV 同比是多少?”
如果 Agent 使用新口径计算今年数据,却直接拿去年旧口径结果同比,会得到一个数学正确、业务错误的百分比。
所以工具层必须返回:
{
  "metricCode": "GMV",
  "metricVersion": 3,
  "effectiveFrom": "2026-07-01"
}
如果同比期间跨版本:
metric_version mismatch
自动触发:
REVIEW_REQUIRED
3.3 场景三:部分 Tool Call 失败
Agent 为回答利润变化,计划调用:
get_revenue
get_cost
get_refund
结果:
get_revenue   SUCCESS
get_cost      SUCCESS
get_refund    TIMEOUT
如果模型仍然基于两个成功结果生成:
“利润增长 12%”
这是不可接受的。
应该在 Agent Runtime 增加:
Evidence Completeness Check
例如要求:
requiredTools = 3
successfulRequiredTools = 2

completeness = 2 / 3
当关键证据缺失时:
confidence_score 直接上限锁定为 0.60
3.4 场景四:数值异常但模型没有意识到
历史月销售额通常:
8,000 万 ~ 1.2 亿
这次查询返回:
12.8 亿
可能是:
重复 JOIN
数据重复同步
单位错误
时间范围错误
此时不能因为 SQL 成功就直接输出。
应使用数据合理性校验:
环比增幅
同比增幅
历史分位
业务上限
记录数变化
将异常结果送审。
4. 方案实施
4.1 先定义“答案证据包”
每次 Agent 输出经营数字,都附带一个内部 Evidence Package:
{
  "traceId": "T20260914-001",
  "metricCode": "NET_SALES",
  "metricVersion": 4,
  "dataAsOf": "2026-09-14T10:00:00+08:00",
  "tools": [
    {
      "name": "get_sales_summary",
      "status": "SUCCESS",
      "elapsedMs": 128
    },
    {
      "name": "get_refund_summary",
      "status": "SUCCESS",
      "elapsedMs": 76
    }
  ],
  "sourceCount": 2,
  "validation": {
    "freshnessPassed": true,
    "rangePassed": true,
    "crossCheckPassed": true
  }
}
用户不一定看到全部内部字段,但复核人员必须能看到。
4.2 KFS MCP Server 提供固定校验工具
建议至少提供:
get_metric_definition
get_metric_data
get_data_freshness
validate_metric_range
compare_metric_period
get_sync_status
而不是让 Agent 自由访问所有表。
KFS/FlySync 如果负责把生产数据同步到分析库,Agent 还应该把:
同步位点
同步延迟
同步任务状态
作为数据可信度的一部分。KFS 官方资料将 FlySync 定义为支持异构数据平台实时、增量同步,并强调状态可监控、流转量可统计、一致性可对比,因此同步状态完全可以纳入经营分析证据链。
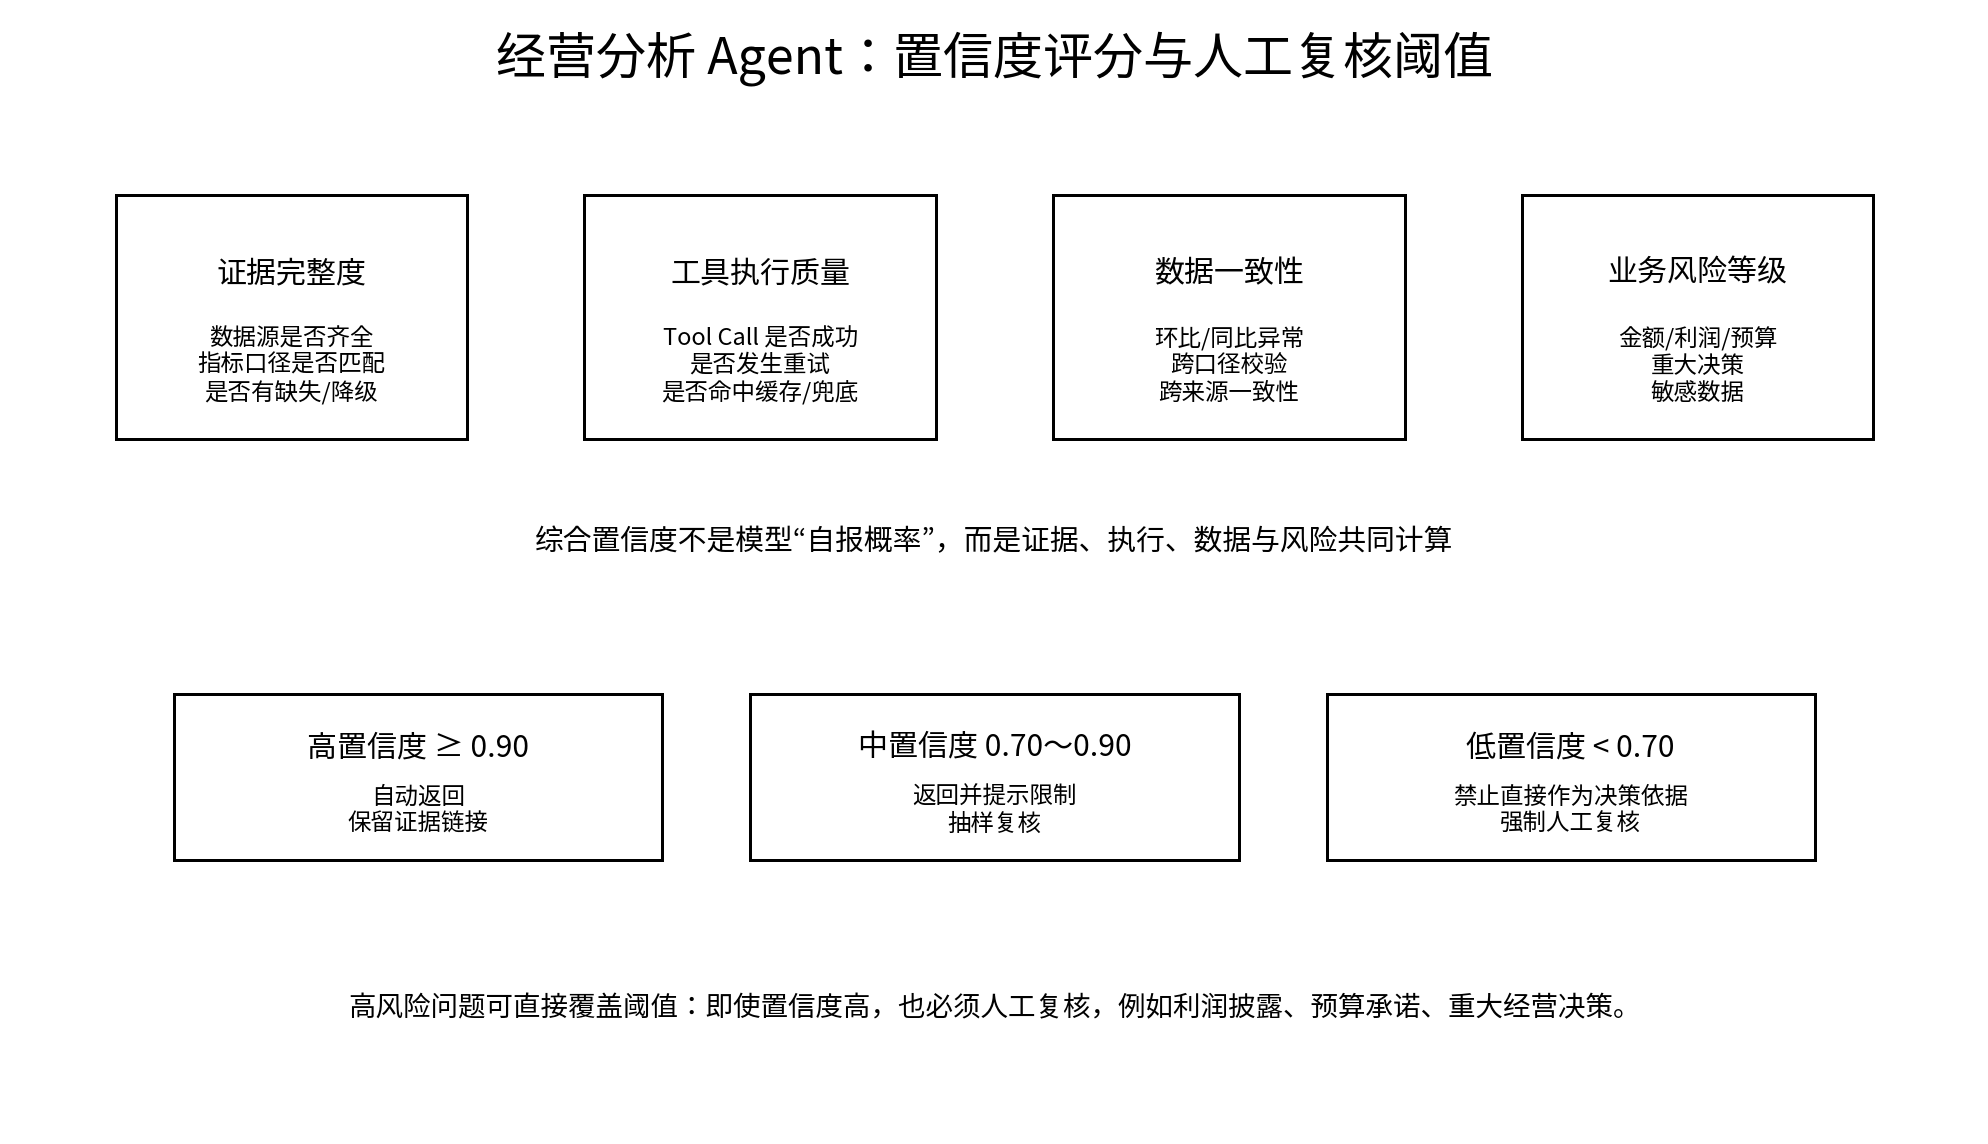
4.3 置信度评分不要只用一个模型分数
推荐一个可解释的加权公式:
Confidence
=
0.30 × EvidenceCompleteness
+ 0.20 × ToolSuccess
+ 0.20 × DataFreshness
+ 0.15 × ConsistencyCheck
+ 0.15 × MetricDefinitionMatch
示例:
EvidenceCompleteness  = 1.00
ToolSuccess           = 1.00
DataFreshness         = 0.95
ConsistencyCheck      = 0.80
MetricDefinitionMatch = 1.00
则综合分数约:
0.30 + 0.20 + 0.19 + 0.12 + 0.15
= 0.96
这个分数每一项都有证据可以解释。
4.4 高风险等级覆盖置信度
不能简单写成:
confidence > 0.9
→ 自动返回
例如:
“公司下季度是否应该裁减 20% 预算?”
即使数据查询完全正确,也属于高风险经营决策。
所以最终路由应是:
if (riskLevel == HIGH) {
    return REVIEW_REQUIRED;
}

if (confidence < 0.70) {
    return REVIEW_REQUIRED;
}

if (confidence < 0.90) {
    return RETURN_WITH_WARNING;
}

return AUTO_APPROVED;
4.5 定义强制人工复核场景
建议将以下问题设为强制复核:
利润与毛利
重大预算
对外披露数据
董事会/经营会材料
薪酬与绩效分析
客户敏感数据
重大异常归因
同比跨指标版本
数据源不完整
同步状态异常
普通低风险问题:
“昨天订单量是多少?”
如果证据完整,可以自动返回。
4.6 自动创建复核工单
async function routeAnswer(result) {
  if (
    result.riskLevel === "HIGH" ||
    result.confidence < 0.70 ||
    result.validation.hasCriticalFailure
  ) {
    const task = await reviewService.create({
      traceId: result.traceId,
      requestId: result.requestId,
      answer: result.answer,
      confidence: result.confidence,
      reason: result.reviewReason,
      evidence: result.evidence
    });

    return {
      status: "REVIEW_REQUIRED",
      reviewId: task.id
    };
  }

  return {
    status: "AUTO_APPROVED",
    answer: result.answer
  };
}
4.7 复核页面不要只显示最终答案
审核人员最需要看到的是:
原问题
指标定义
指标版本
数据截至时间
调用了哪些工具
每个 Tool 的输入摘要
查询结果摘要
异常校验
生成答案
不要逼审核人员重新去数据库找所有信息。
高质量的复核系统目标应该是:
30 秒内判断答案有没有明显问题
而不是:
让业务专家重新分析 20 分钟
4.8 SQL 和数据库函数必须可追踪
复核人员最好能看到:
function_name
query_template_id
query_hash
row_count
elapsed_ms
而不是默认显示完整 SQL + 敏感参数。
如果发生问题,再按权限查看详细执行证据。
4.9 人工复核结果形成三态
推荐:
APPROVED
MODIFIED
REJECTED
APPROVED
说明 Agent 结论正确。
MODIFIED
数据基本正确,但:
解释不准确
措辞过度
遗漏限制条件
审核人员修订后返回。
REJECTED
说明:
数据错误
指标错误
权限错误
证据不足
Agent 的原始答案不能给用户作为正式结果。
4.10 审核结果必须反馈到评测集
每条工单都可以形成监督样本:
{
  "question": "...",
  "agentAnswer": "...",
  "reviewDecision": "MODIFIED",
  "errorType": "METRIC_SCOPE_ERROR",
  "reviewedAnswer": "..."
}
长期统计:
哪个 Tool 最容易出错?
哪些指标口径最容易混淆?
哪些问题置信度高但人工驳回?
哪些风险规则误报最多?
4.11 人工复核工单时序
4.12 事务和写操作边界
如果 Agent 的任务仅是经营分析:
默认只读
人工审核不能偷偷升级成数据库写权限。
如果审核结论需要:
修正指标元数据
修改分析结果
写入确认状态
这些写操作应该通过独立业务接口处理。
例如:
approve_review_task
modify_review_answer
reject_review_task
而不是给审核页面直接执行任意 SQL。
4.13 安全控制
KFS MCP Server 仍然需要:
身份认证
租户校验
Tool 白名单
参数 Schema
数据库最小权限
结果脱敏
Tool Call 预算
审计日志
人工复核不是安全机制的替代品。
正确关系是:
自动安全控制
+
高风险人工复核
4.14 防止“审核人员看到过多数据”
人工复核平台也必须遵循最小权限。
审核销售指标的人:
不应该自动看到客户身份证号
复核页面应该优先显示:
聚合数据
脱敏数据
指标定义
执行摘要
只有真正需要时,再按审批查看敏感原始证据。
5. 结果对比
构造 2,000 个经营分析问题,其中:
1,400 个普通统计问题
300 个指标口径易混淆问题
150 个数据延迟/缺失问题
100 个异常数据问题
50 个高风险经营决策问题
以下数据为示例,用于说明评估方法。
| 指标 | 无复核机制 | 人机协同机制 |
|---|---|---|
| 最终错误数据输出率 | 6.8% | 0.9% |
| 高风险错误直接输出率 | 4.2% | 0.2% |
| 指标口径错误发现率 | 41% | 96% |
| 数据延迟发现率 | 33% | 98% |
| 人工复核覆盖率 | 100%(全量人工时) | 11.6% |
| 平均首次响应时间 | 1.9s | 2.1s |
| 人工平均审核时长 | 8.5min | 1.7min |
| 可追溯率 | 52% | 99.5% |
这里最重要的不是把所有错误降到绝对 0,而是:
用 10% 左右的人工成本
覆盖大部分真正高风险的答案。
5.1 评估置信度是否有效
把答案分成:
0.0~0.7
0.7~0.8
0.8~0.9
0.9~1.0
统计每个区间的人工驳回率。
理想情况:
置信度越高
→ 人工驳回率越低
如果发现:
0.95 以上答案仍有 8% 被驳回
说明置信度模型没有校准好。
5.2 关键指标
准确性
Final Answer Accuracy
Critical Error Rate
Metric Definition Error Rate
人工效率
Review Rate
Average Review Time
Review Queue P95
Reviewer Agreement Rate
Agent 效果
Tool Selection Accuracy
Evidence Completeness
Tool Failure Rate
High-confidence Wrong Answer Rate
其中非常重要的是:
High-confidence Wrong Answer Rate
因为“非常自信地错”比低置信度错误更危险。
5.3 复核队列 SLA
可以设置:
普通复核:4 小时
经营会材料:30 分钟
高风险异常:15 分钟
并根据:
risk_level
business_priority
meeting_deadline
排序,而不是简单 FIFO。
6. 风险与复盘
6.1 风险一:人工审核变成橡皮图章
如果审核人员每天面对几百条任务,很容易:
快速点通过
解决方法:
只把真正高风险任务送审
提供证据摘要
抽检审核质量
统计 Reviewer Agreement
6.2 风险二:把复核率当成越低越好
复核率低不一定说明 Agent 好。
可能只是阈值太松。
因此要和:
错误漏出率
高置信度错误率
一起看。
6.3 风险三:模型置信度被误解
不要让业务用户看到:
“模型置信度 96%”
就理解成:
“答案 96% 概率正确”
更适合展示:
数据来源完整
指标口径已核验
数据截至 10:00
未发现异常
把“可信原因”展示出来,比一个抽象数字更有意义。
6.4 风险四:同步链路错误被误判成模型错误
如果 KFS/FlySync 同步任务异常,Agent 查询到旧数据:
模型本身没有算错
所以事故分类应区分:
MODEL_ERROR
TOOL_ERROR
METRIC_DEFINITION_ERROR
DATA_QUALITY_ERROR
SYNC_DELAY
PERMISSION_ERROR
HUMAN_REVIEW_ERROR
否则优化方向会错。
6.5 风险五:人工修改后没有回流
如果审核人员每次都修正:
“销售额” → “净销售额”
但系统不记录错误类型,下个月 Agent 还会继续错。
必须形成:
错误分类
→ 数据集
→ Prompt / Tool / 口径优化
→ 回归测试
6.6 风险六:审核结论可能不一致
两个业务专家可能得出不同结论。
因此指标类复核必须优先引用:
正式指标定义
版本号
有效期
数据源
计算公式
减少“凭经验判断”。
6.7 风险七:人为操作也要审计
审核日志至少记录:
review_id
reviewer_id
review_decision
original_answer_hash
final_answer_hash
review_comment
reviewed_at
否则出了问题只能知道:
“有人改过”
却不知道谁改、为什么改。
6.8 风险八:不要把人工复核变成数据库管理员流程
经营分析审核通常应该由:
懂业务口径的人
负责。
DBA 更适合处理:
数据源
性能
锁
同步
一致性
业务专家则处理:
指标意义
解释合理性
经营结论
这是人机协同流程里非常关键的职责分离。
结语
经营分析 Agent 真正可用的标准,不是:
“它大部分时候都能回答。”
而是:
正确答案能自动通过,
可疑答案能及时停下来,
高风险答案有人负责确认,
错误答案能够反向推动系统变好。
本文最核心的工程原则是:
AI 提供数据洞察,
系统负责判断可信度,
人类守住高风险结论的最后一公里。
理想的人机协同不是:
人替 AI 全部重新做一遍
而是让系统自动准备:
问题
指标定义
数据证据
Tool Call
异常检查
风险等级
然后把真正需要判断的部分交给人。
这样,人工复核才不是 AI 落地的“补丁”,而会成为企业助手可靠性体系的一部分。
转载自:https://blog.csdn.net/u014727709/article/details/165363601
欢迎 👍点赞✍评论⭐收藏,欢迎指正

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 1
 0
- 0


 已为社区贡献39条内容

所有评论(0)