AI Agent 场景中的审计日志设计——企业助手的工具调用追踪、安全控制与效果评估
每日一句正能量
✍️ 你是你的终极作品
“你定义你,你塑造你,你成为你。”
在持续的定义与塑造中,你最终活成了那个你一直选择成为的人。
摘要
企业把 AI Agent 接入数据库、知识库和业务系统之后,真正让安全团队和 DBA 紧张的往往不是“模型回答得准不准”,而是另一组问题:谁让 Agent 调了这个工具?模型为什么选择它?传入了哪些参数?访问了哪些数据?有没有越权?失败发生在哪一层?最终返回给用户的内容有没有被脱敏?
传统 Web 系统的审计日志通常围绕“用户—接口—数据库”三层设计,而 Agent 系统多了模型规划、工具选择、MCP Server、上下文拼接、结果裁剪、模型二次生成等步骤。如果还只记录 HTTP access log,事故发生后很难还原完整链路。
本文给出一套适合企业助手的审计日志方案,将一次用户问答拆成:
用户请求
→ Agent 规划
→ 工具选择
→ KFS MCP Server 安全校验
→ 数据库函数/SQL 执行
→ 返回结果
→ 脱敏与裁剪
→ Agent 生成答案
并用统一 trace_id 串起来。文中的“KFS MCP Server”延续本系列定义,指面向数据库/KFS能力的受控 MCP 工具服务层;公开资料中的 KFS 指 Kingbase FlySync,主要承担异构数据同步职责,两者在本文架构中角色不同。
1. 背景与问题
1.1 Agent 的审计难度比普通 API 更高
传统 API 调用往往比较确定:
POST /orders/query
→ OrderService
→ orderMapper.select()
→ 返回 JSON
而 Agent 的一次问答可能是:
用户:“为什么华东区本月销售额下降?”
↓
Agent 检索指标口径
↓
调用 get_sales_summary
↓
发现同比异常
↓
再次调用 get_region_breakdown
↓
调用 get_refund_ratio
↓
拼接三次结果
↓
生成自然语言分析
如果日志只记录:
用户访问了 /chat
HTTP 200
耗时 4.2 秒
几乎没有审计价值。
真正需要回答的是:
谁发起?
用了哪个身份?
Agent 选择了几个工具?
工具为什么被允许?
每个工具访问了什么数据域?
是否命中敏感字段?
数据库执行是否成功?
结果是否脱敏?
最终回答使用了哪些工具结果?
1.2 审计日志不是普通 debug 日志
debug 日志目标是帮助开发排错,内容可能非常详细;审计日志目标是形成可证明的行为证据。
两者至少有三点不同。
第一,审计日志字段必须稳定,否则半年后无法做统一检索。
第二,审计日志不应随意删除或被业务线程覆盖。
第三,审计日志更关注:
主体
动作
资源
结果
权限
风险
证据链
而不是完整堆栈和所有变量。
1.3 为什么“把 Prompt 全记下来”不是好方案
有团队为了可追溯,直接记录:
system_prompt
user_prompt
retrieved_context
tool_arguments
tool_result
final_answer
这看似完整,实际上会制造新的安全问题:
- Prompt 可能包含身份证、手机号、合同、财务数据。
- Tool Result 可能包含整批明细。
- 日志平台访问权限往往比生产库更宽。
- 日志保留周期可能比业务数据更长。
所以正确方向不是“全部记录”,而是:
最小必要审计字段
+ 受控摘要
+ 哈希
+ 分级留存
+ 必要时单独加密保存原文证据
2. 环境与数据
2.1 示例架构
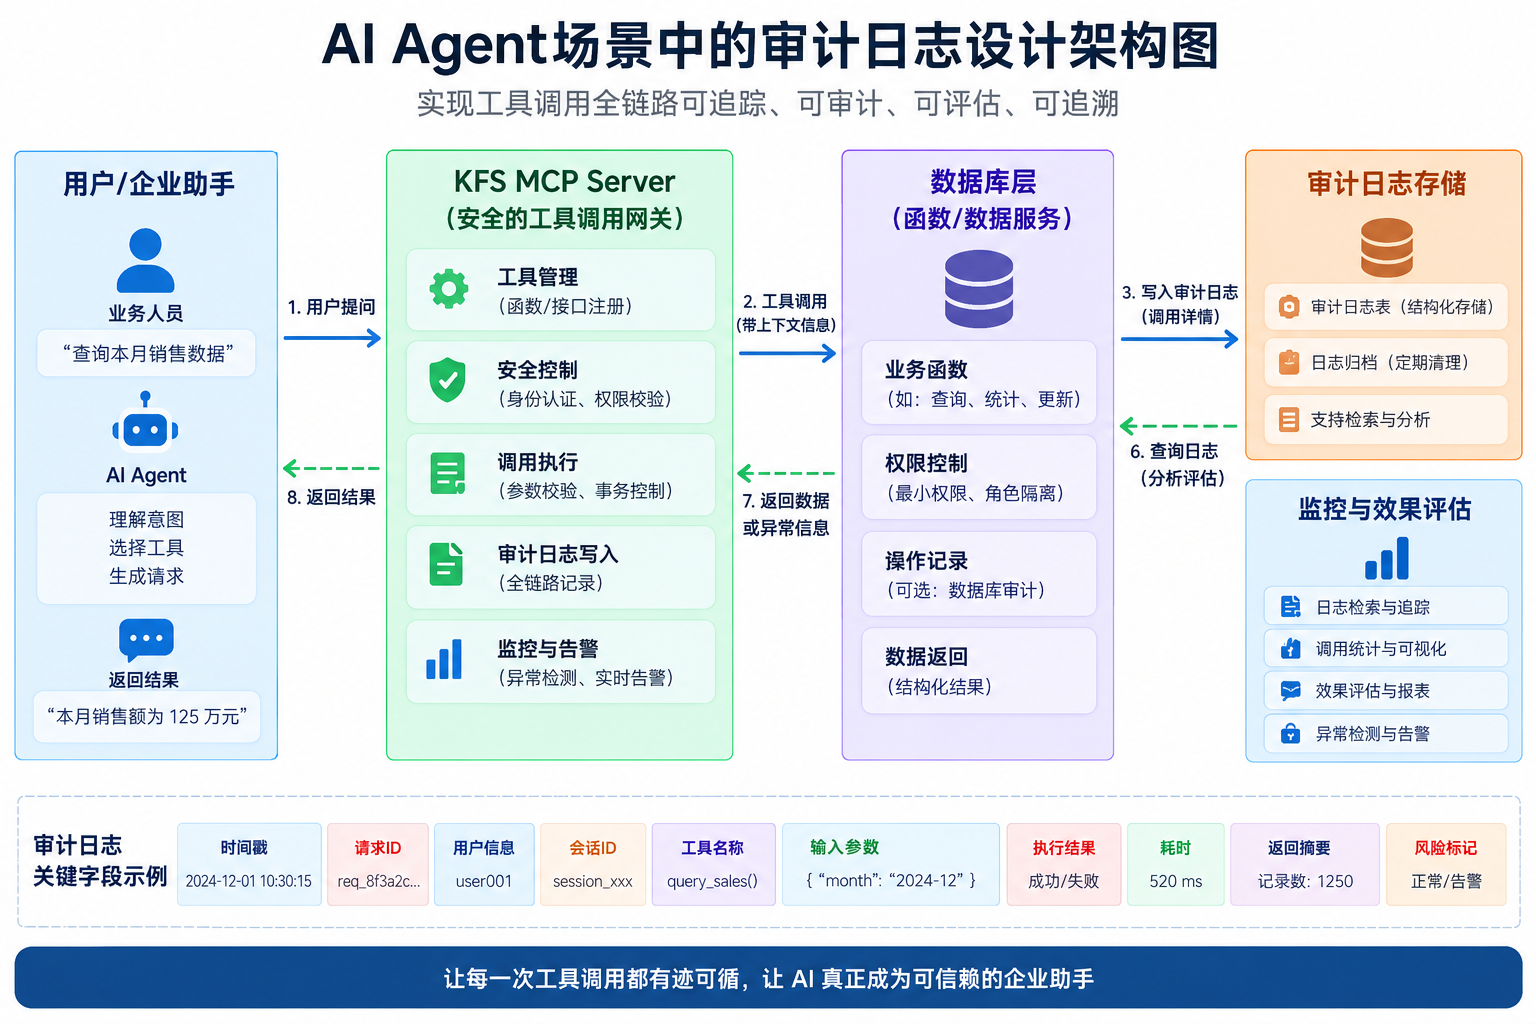
本文假设企业助手链路如下:
Web / IM / 企业助手
        ↓
AI Agent Runtime
        ↓
KFS MCP Server
        ↓
数据库函数 / 只读数据服务
        ↓
PostgreSQL / KingbaseES / MySQL
同时接入:
OpenTelemetry Collector
日志平台
审计日志库
安全告警平台
2.2 审计日志表结构
建议将“工具调用审计”作为独立事实表,而不是混在普通应用日志里。
CREATE TABLE agent_tool_audit_log (
    id                  BIGSERIAL PRIMARY KEY,
    occurred_at         TIMESTAMPTZ NOT NULL DEFAULT now(),

    trace_id            VARCHAR(64) NOT NULL,
    span_id             VARCHAR(32),
    parent_span_id      VARCHAR(32),

    request_id          VARCHAR(64) NOT NULL,
    conversation_id     VARCHAR(64),
    session_id          VARCHAR(64),

    user_id             VARCHAR(128),
    tenant_id           VARCHAR(64),
    user_role           VARCHAR(64),

    agent_name          VARCHAR(128),
    agent_version       VARCHAR(64),
    model_name          VARCHAR(128),

    tool_call_id        VARCHAR(64) NOT NULL,
    tool_name           VARCHAR(128) NOT NULL,
    function_name       VARCHAR(256),

    parameter_hash      VARCHAR(128),
    parameter_summary   JSONB,

    policy_decision     VARCHAR(32) NOT NULL,
    permission_scope    VARCHAR(256),
    risk_level          VARCHAR(16),

    db_system           VARCHAR(32),
    db_namespace        VARCHAR(128),
    db_operation        VARCHAR(64),

    started_at          TIMESTAMPTZ,
    finished_at         TIMESTAMPTZ,
    elapsed_ms          BIGINT,

    row_count           BIGINT,
    result_bytes        BIGINT,
    masking_applied     BOOLEAN NOT NULL DEFAULT false,
    cache_hit           BOOLEAN NOT NULL DEFAULT false,

    success             BOOLEAN NOT NULL,
    error_code          VARCHAR(64),
    retry_count         INTEGER NOT NULL DEFAULT 0,

    result_summary      JSONB
);

CREATE INDEX idx_agent_audit_trace
    ON agent_tool_audit_log(trace_id);

CREATE INDEX idx_agent_audit_user_time
    ON agent_tool_audit_log(user_id, occurred_at DESC);

CREATE INDEX idx_agent_audit_tool_time
    ON agent_tool_audit_log(tool_name, occurred_at DESC);

CREATE INDEX idx_agent_audit_risk
    ON agent_tool_audit_log(risk_level, occurred_at DESC);
2.3 为什么一定要有 trace_id、tool_call_id 两层
trace_id 表示一次完整用户请求。
tool_call_id 表示其中一次工具调用。
例如:
trace_id = T202609140001

tool_call_id = TC001 → get_metric_definition
tool_call_id = TC002 → get_sales_summary
tool_call_id = TC003 → get_refund_ratio
这样可以回答:
一个用户问题到底放大成了多少次数据库工作?
这也是 Agent 成本与性能优化的核心指标。
3. 复现过程
3.1 复现“只有 access log”的失败场景
假设用户投诉:
“我只是问了销售额,为什么助手返回了利润数据?”
系统里只有:
{
  "path": "/api/chat",
  "status": 200,
  "elapsed": 3250
}
你无法判断:
- Agent 是否错误选择了利润工具;
- MCP Server 是否做了权限校验;
- 数据库是否真的返回了利润字段;
- 还是模型从历史上下文里生成了利润内容。
这类问题如果没有 Tool 级审计,几乎无法归责。
3.2 复现“日志记录过多”的问题
假设 MCP Server 记录:
{
  "tool": "query_customer",
  "args": {
    "id_card": "110101xxxxxxxxxxxx",
    "mobile": "138xxxxxxxx",
    "name": "张三"
  },
  "result": {
    "balance": 500000,
    "address": "...",
    "bank_account": "..."
  }
}
工具调用本身没有越权,但日志平台因此复制了一份敏感数据。
这就是典型的:
生产数据库安全了,
日志系统却成了新的数据泄漏面。
3.3 复现“无法解释 Agent 为什么调用工具”
只记录:
tool_name = get_sales_detail
还不够。
最少还要记录:
tool_selected_by = agent
selection_reason_code = NEED_REGION_BREAKDOWN
这里不建议保存模型完整私有推理,而是保存可审计的决策摘要或结构化理由码。
例如:
{
  "decision": "CALL_TOOL",
  "reason_code": "NEED_CURRENT_DATA",
  "requested_metric": "sales_amount",
  "requested_dimension": "region"
}
4. 方案实施
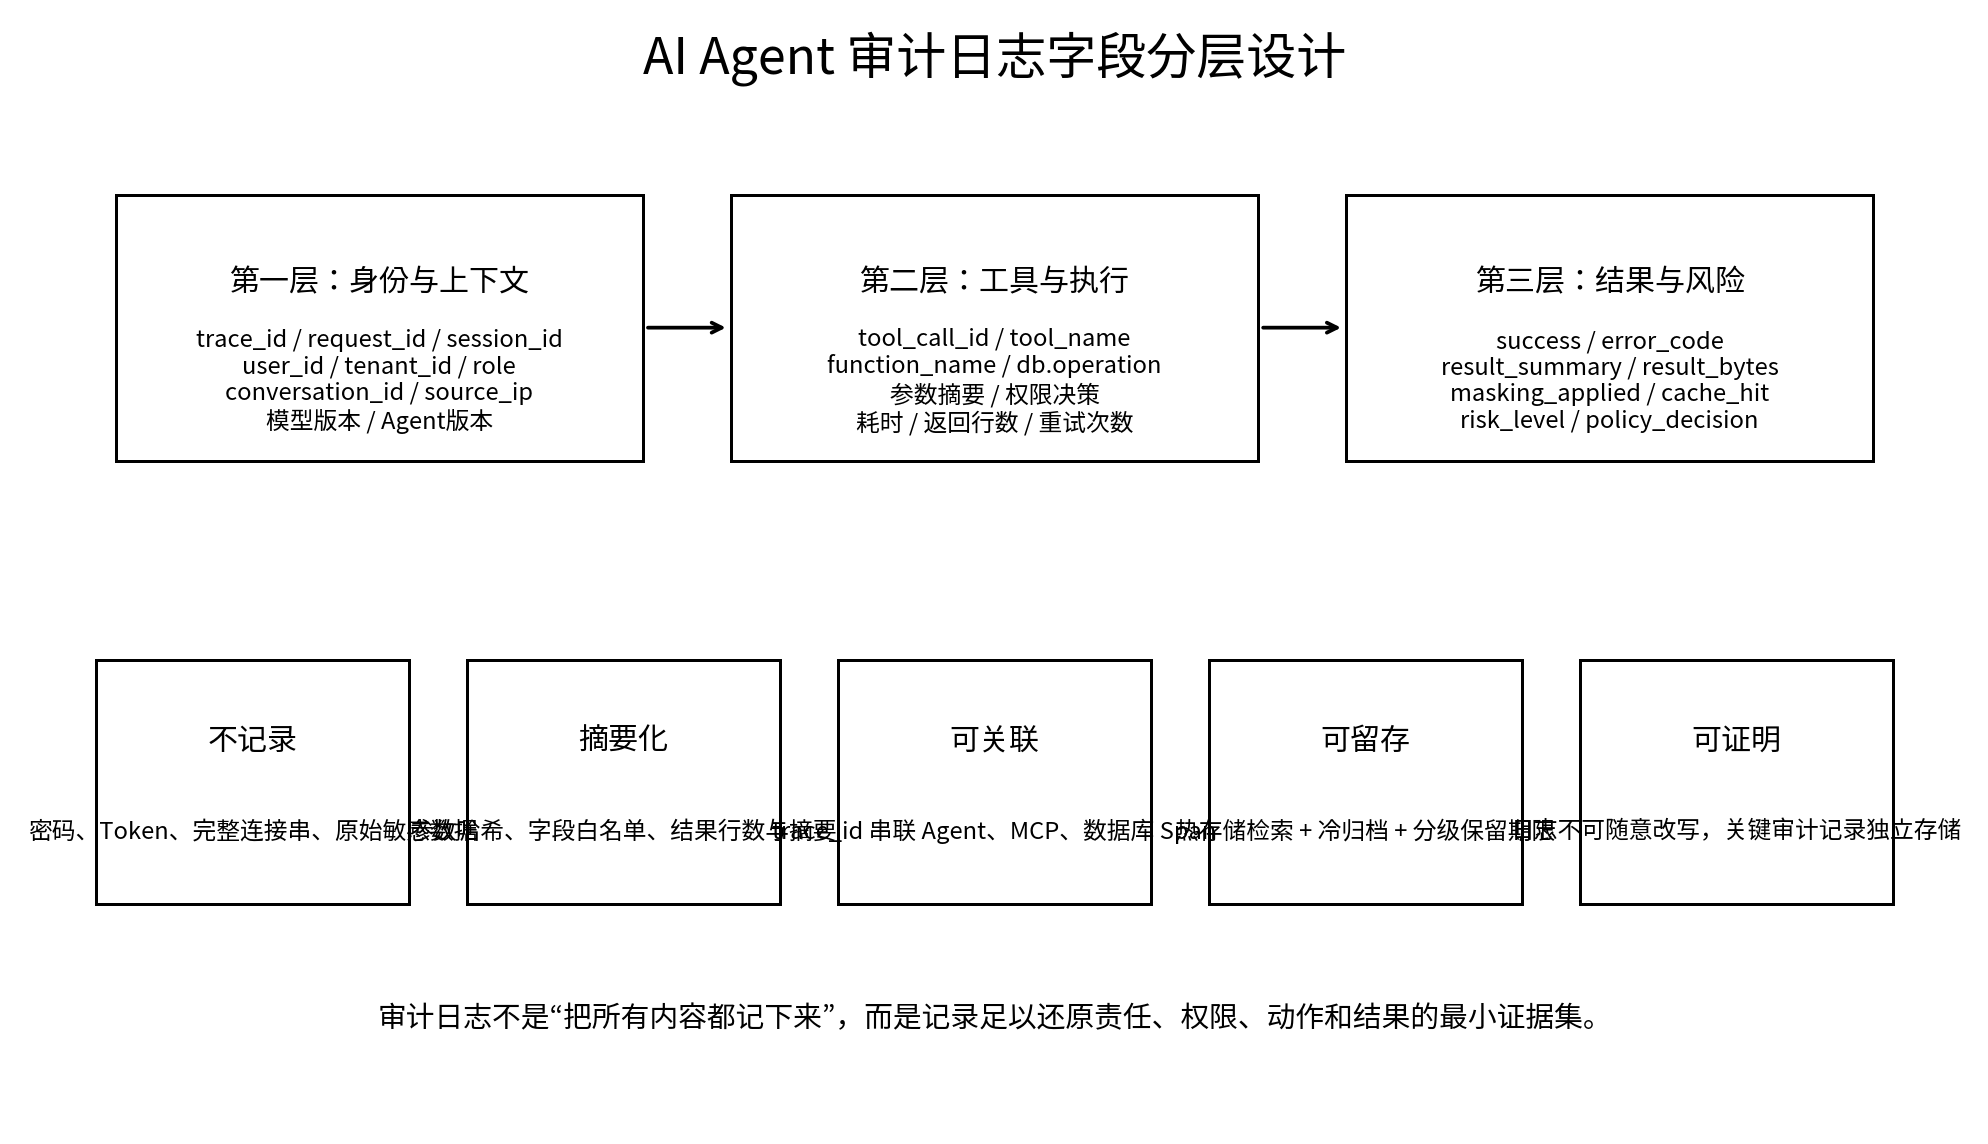
4.1 审计字段分成三层
第一层:身份与会话。
trace_id
request_id
conversation_id
session_id
user_id
tenant_id
user_role
source_channel
第二层:工具与执行。
tool_call_id
tool_name
function_name
db_operation
parameter_hash
policy_decision
permission_scope
elapsed_ms
row_count
retry_count
第三层:结果与风险。
success
error_code
result_bytes
masking_applied
cache_hit
risk_level
result_summary
4.2 参数不要原样记录
推荐对参数做两份处理:
parameter_hash    用于证明“当时传入的是同一组参数”
parameter_summary 用于安全检索
示例:
import crypto from "crypto";

function auditParams(input: any) {
  const canonical = JSON.stringify(input);

  const parameterHash = crypto
    .createHash("sha256")
    .update(canonical)
    .digest("hex");

  return {
    parameterHash,
    parameterSummary: {
      tenantId: input.tenantId,
      month: input.month,
      customerId: input.customerId
        ? input.customerId.slice(0, 4) + "***"
        : undefined
    }
  };
}
密码、Token、Cookie、数据库连接串永远不要进入审计日志。
4.3 KFS MCP Server 中加入统一审计中间件
伪代码:
async function withAudit(ctx, toolName, args, handler) {
  const start = Date.now();
  const toolCallId = ctx.toolCallId;
  const traceId = ctx.traceId;

  const { parameterHash, parameterSummary } = auditParams(args);

  let success = false;
  let errorCode = null;
  let resultMeta = {};

  try {
    const policy = await checkPolicy(ctx, toolName, args);

    if (!policy.allowed) {
      errorCode = "POLICY_DENIED";

      await writeAudit({
        traceId,
        toolCallId,
        toolName,
        parameterHash,
        parameterSummary,
        policyDecision: "DENY",
        permissionScope: policy.scope,
        success: false,
        errorCode
      });

      throw new Error("tool access denied");
    }

    const result = await handler();

    success = true;

    resultMeta = {
      rowCount: result.rowCount,
      resultBytes: result.resultBytes,
      maskingApplied: result.maskingApplied,
      cacheHit: result.cacheHit
    };

    return result;
  } catch (e) {
    errorCode = errorCode ?? mapErrorCode(e);
    throw e;
  } finally {
    await writeAudit({
      traceId,
      toolCallId,
      toolName,
      parameterHash,
      parameterSummary,
      elapsedMs: Date.now() - start,
      success,
      errorCode,
      ...resultMeta
    });
  }
}
这样业务工具不用重复写审计逻辑。
4.4 权限拒绝也必须记录
很多系统只记录成功调用。
这是错误的。
真正有价值的安全日志往往来自:
被拒绝的调用
异常的参数
连续越权尝试
高风险工具调用
短时间大量工具调用
示例:
{
  "trace_id": "T001",
  "tool_name": "get_profit_detail",
  "user_id": "U1001",
  "tenant_id": "T100",
  "policy_decision": "DENY",
  "error_code": "FIELD_SCOPE_DENIED",
  "risk_level": "HIGH"
}
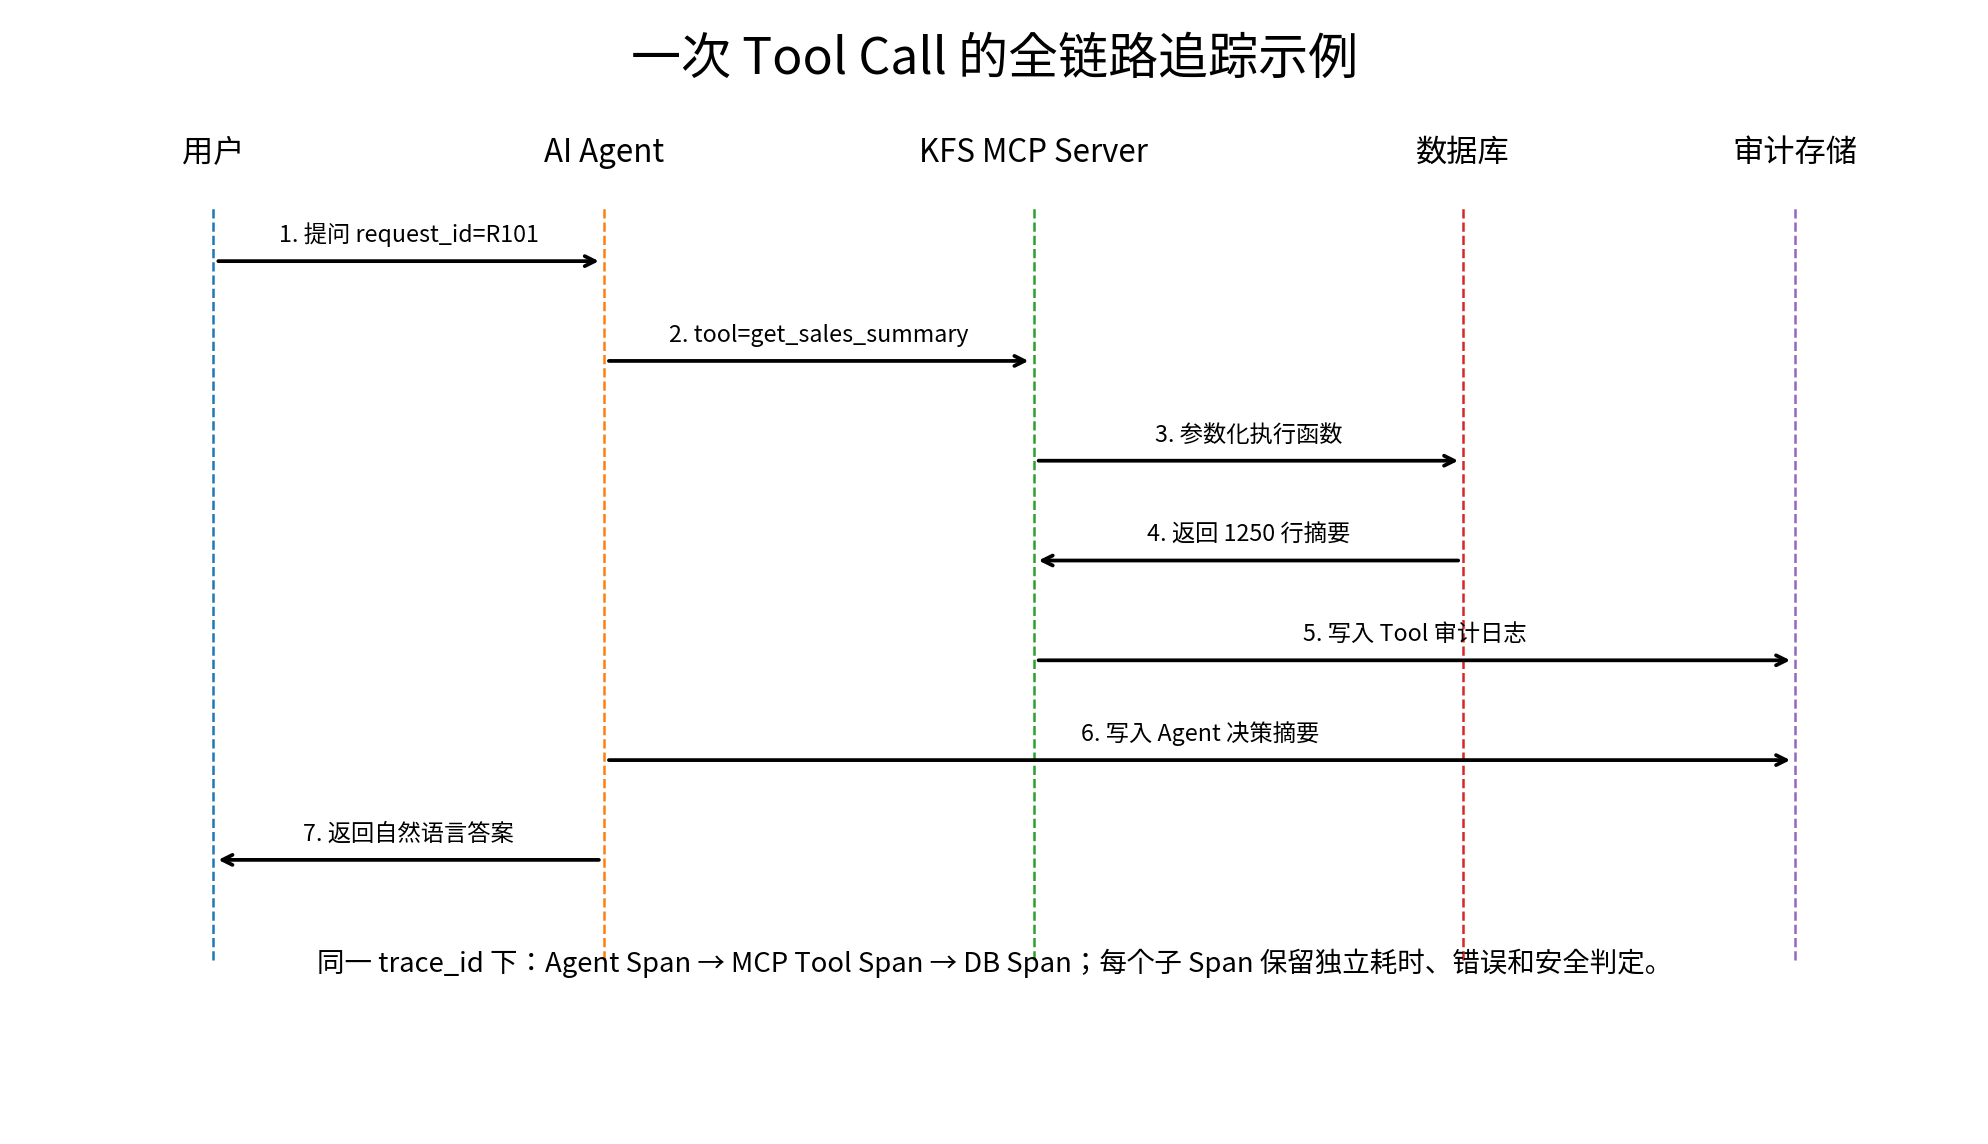
4.5 用 OpenTelemetry 串起 Agent、MCP、DB
推荐链路:
Span: agent.request
  ├─ Span: agent.tool.select
  ├─ Span: mcp.tool.get_sales_summary
  │    └─ Span: db.query get_sales_summary
  └─ Span: agent.generate_answer
Tool Span 可以记录:
tool.name
tool.call_id
tenant.id
policy.decision
result.row_count
result.bytes
error.type
数据库 Span 则尽量复用数据库语义约定,例如:
db.system.name
db.namespace
db.operation.name
db.stored_procedure.name
不要把高基数字段直接塞进 Span Name。
4.6 单次 Tool Call 全链路示例
示例审计记录:
{
  "trace_id": "4bda8c...",
  "span_id": "91ff...",
  "request_id": "REQ-20260914-001",
  "conversation_id": "C-9981",
  "user_id": "U-10086",
  "tenant_id": "T-100",
  "agent_name": "enterprise-data-assistant",
  "agent_version": "2.3.1",
  "model_name": "gpt-x",
  "tool_call_id": "TC-0002",
  "tool_name": "get_sales_summary",
  "function_name": "app.get_sales_summary",
  "policy_decision": "ALLOW",
  "permission_scope": "sales:region:read",
  "risk_level": "LOW",
  "db_system": "postgresql",
  "db_operation": "SELECT",
  "elapsed_ms": 183,
  "row_count": 12,
  "result_bytes": 2860,
  "masking_applied": false,
  "cache_hit": false,
  "success": true,
  "retry_count": 0
}
4.7 审计日志与普通业务日志分开存
建议:
业务运行日志
→ 用于排障
→ 保留 7~30 天

Tool 审计日志
→ 用于安全、合规、追责
→ 保留周期更长

高风险审计证据
→ 独立归档
→ 更严格权限
→ 可设置不可篡改存储
不要让普通应用账号拥有:
DELETE FROM agent_tool_audit_log
4.8 写工具增加事务审计字段
对于写操作额外记录:
transaction_id
idempotency_key
transaction_outcome
rollback_reason
commit_state
例如:
{
  "tool_name": "update_customer_status",
  "idempotency_key": "REQ-U100-0001",
  "transaction_outcome": "ROLLED_BACK",
  "rollback_reason": "BUSINESS_VALIDATION_FAILED"
}
如果发生“提交状态未知”,则记录:
commit_state = UNKNOWN
并触发后续核验,而不是简单重试。
5. 结果对比
下面给出一组用于说明评估方法的示例数据。
| 指标 | 改造前 | 改造后 |
|---|---|---|
| Tool Call 可追溯率 | 42% | 99.8% |
| 用户→数据库链路还原率 | 31% | 98.9% |
| 越权调用识别率 | 65% | 100% |
| 故障平均定位时间 | 48 min | 9 min |
| 工具异常归因成功率 | 71% | 97% |
| 敏感字段进入日志比例 | 7.8% | 0.3% |
| 平均每问 Tool Call | 2.9 | 1.8 |
需要注意,这里的“改造后”不是因为 Agent 更聪明,而是因为平台终于有了统一证据链。
5.1 审计日志还能反向帮助 Agent 性能优化
可以直接统计:
SELECT
    tool_name,
    count(*) AS calls,
    avg(elapsed_ms) AS avg_ms,
    percentile_cont(0.95)
      WITHIN GROUP (ORDER BY elapsed_ms) AS p95_ms,
    avg(row_count) AS avg_rows
FROM agent_tool_audit_log
WHERE occurred_at >= now() - interval '1 day'
GROUP BY tool_name
ORDER BY calls DESC;
可以发现:
哪些工具被调用最多?
哪些工具最慢?
哪些工具结果过大?
哪些工具重试最多?
5.2 识别工具调用放大
SELECT
    trace_id,
    count(*) AS tool_calls,
    sum(elapsed_ms) AS total_tool_ms
FROM agent_tool_audit_log
WHERE occurred_at >= now() - interval '1 hour'
GROUP BY trace_id
HAVING count(*) >= 5
ORDER BY tool_calls DESC;
这能找到:
用户只问一个问题,
Agent 却连续调用 8 次数据库工具
的异常链路。
5.3 安全效果评估
推荐指标:
Unauthorized Tool Call Block Rate
Sensitive Parameter Logging Rate
High-risk Tool Approval Rate
Cross-tenant Access Incident Count
Audit Completeness Rate
Trace Reconstruction Success Rate
5.4 Agent 效果评估
审计日志也能支持:
Tool Selection Accuracy
Parameter Accuracy
Average Tool Calls / Question
Tool Failure Rate
Retry Rate
Business Answer Accuracy
Human Escalation Rate
它因此不仅是合规系统,也是 Agent 评测的数据基础。
6. 风险与复盘
6.1 风险一:日志本身成为敏感数据仓库
解决:
字段白名单
参数摘要
结果摘要
脱敏
加密
严格 RBAC
不要默认记录完整 Prompt 与完整 Result。
6.2 风险二:高基数字段拖垮观测系统
不要把:
user_prompt
order_no
customer_id
完整 SQL
直接作为 Metrics Label。
这类字段可以放日志或 Span Attribute,但 Metrics 维度要保持低基数。
6.3 风险三:只记成功,不记拒绝
安全审计必须重点记录:
DENY
TIMEOUT
RATE_LIMIT
POLICY_BLOCK
SCHEMA_VALIDATION_FAILED
这些事件往往比成功记录更有价值。
6.4 风险四:记录模型完整内部推理
生产审计不应依赖保存模型的私有推理过程。
更合适的是:
决策类型
工具名称
结构化原因码
引用的数据源
结果摘要
既能审计,又避免保存不必要的内部推理内容。
6.5 风险五:审计写入拖慢主链路
可以采用:
主链路内生成审计事件
→ 异步发送
→ 审计消费端落库
但关键的拒绝和高风险写操作应考虑同步确认或可靠缓冲,不能因为消息丢失导致审计缺口。
6.6 风险六:日志可被业务账号删除
建议:
业务账号只写
审计管理员查询
删除通过独立归档策略执行
重要审计数据可以进一步使用:
WORM
对象存储保留策略
签名/哈希链
提高篡改成本。
6.7 风险七:trace_id 只能“串起来”,不能自动证明正确
有完整 Trace 不代表 Agent 一定做对了。
仍需要:
权限规则
工具白名单
结果校验
抽样复核
评测集
告警规则
审计只是让错误变得“可看见、可还原”。
结语
AI Agent 真正进入企业系统后,“能回答”只是第一阶段。
下一阶段必须回答:
谁让它做的?
它调用了什么?
为什么被允许?
访问了什么数据?
结果经过了什么处理?
最后为什么这样回答?
一套合格的审计体系,需要同时覆盖:
身份
会话
工具
权限
数据库
结果
风险
效果
本文最核心的工程原则可以概括为:
每一次 Tool Call 都要留下最小、完整、可关联的证据,
让一次 Agent 行为既能被追踪,也能被解释和评估。
转载自:https://blog.csdn.net/u014727709/article/details/165362568
欢迎 👍点赞✍评论⭐收藏,欢迎指正

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 1
 0
- 0


 已为社区贡献39条内容

所有评论(0)