AI Agent 服务端函数封装实践——把数据库函数变成安全、可控、可评估的 MCP 工具
每日一句正能量
“我们对自己的人生境遇和解读方式拥有最终的选择权。”
境遇(发生了什么)可能无法选择,但如何解读(赋予它什么意义)永远是你的自由。这份选择权,是人之为人的最后尊严,也是改变一切的起点。你无法控制风,但可以调整帆。
摘要
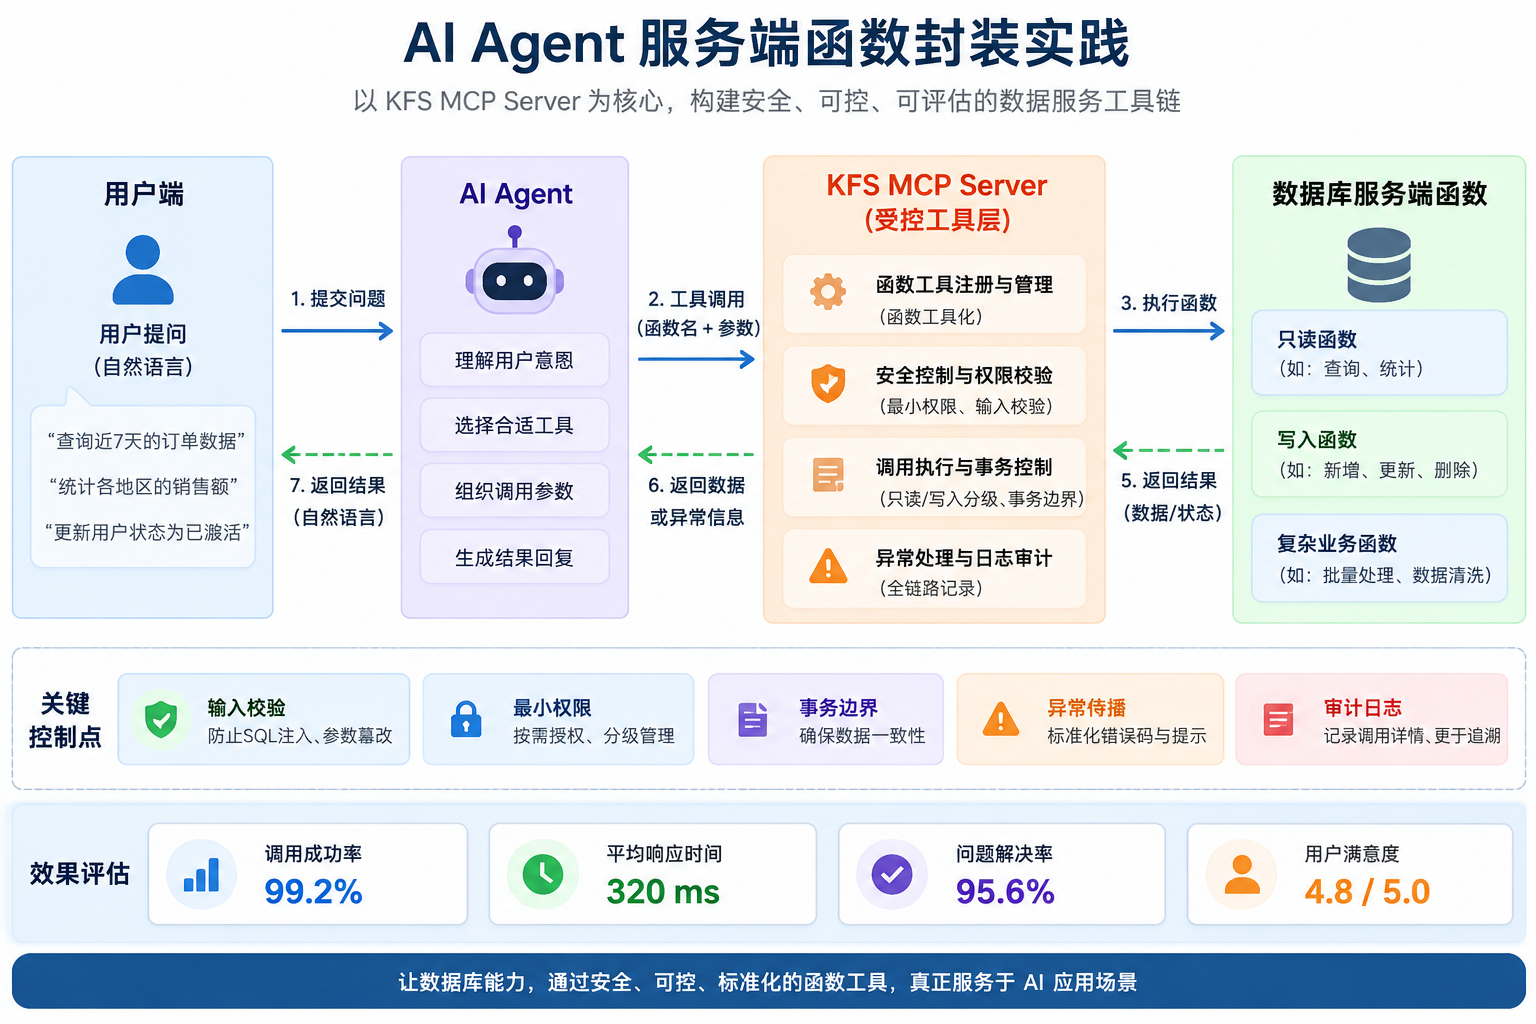
很多团队在把 AI Agent 接入数据库时,第一反应是给模型一个“执行 SQL”工具。这个方案演示起来很快,但一到生产环境,权限、审计、参数校验、事务、超时、错误传播都会迅速变成问题。尤其是经营问答、订单查询、库存校验、风险核验等场景,Agent 真正需要的通常不是“任意 SQL 能力”,而是少量稳定、可描述、可授权、可审计的数据能力。
本文给出一种更适合生产的数据服务方式:将数据库中的服务端函数封装为 MCP Tool,通过本文所称的 KFS MCP Server 作为受控工具服务层。需要先说明术语边界:公开资料中 KFS 指 Kingbase FlySync,是一类异构数据同步产品;本文为了延续本系列架构,将“KFS MCP Server”作为“面向数据库/KFS能力的受控 MCP 工具服务层”的架构名称使用,并不把它描述为未经确认的官方固定产品。
核心思路可以概括为一句话:
Agent 不直接拼 SQL,
数据库函数负责表达稳定业务能力,
MCP Server 负责权限、参数、超时、事务、审计和异常契约。
1. 背景与问题
1.1 从“SQL 工具”开始,为什么最后往往会走向“函数工具化”
假设在线助手需要回答下面几个问题:
1. 查询订单 202609140001 的支付与退款汇总
2. 查询租户 T100 最近 7 天的订单成功率
3. 校验用户 U10086 是否有资格领取某项权益
4. 根据业务规则冻结一条异常任务
如果只提供一个通用工具:
{
  "name": "execute_sql",
  "input": {
    "sql": "SELECT ..."
  }
}
看起来非常灵活,但至少存在五类生产风险:
- 权限面太宽。 模型一旦能表达任意 SQL,工具层必须重新实现 SQL 解析、表级权限、列级权限、危险语句识别。
- 接口不稳定。 表结构变化、字段改名会直接影响 Prompt 和生成 SQL。
- 事务边界模糊。 Agent 很容易把多个工具调用理解成一个业务动作,但数据库未必处于同一事务。
- 异常不可解释。 JDBC/驱动原始错误直接暴露给模型,模型很难判断哪些应重试、哪些是业务失败。
- 效果难评估。 “SQL 执行成功率”不能代表业务回答正确率。
对稳定业务能力而言,更合理的做法是把它收敛为函数接口:
SELECT * FROM app.get_order_summary(
    p_tenant_id => 'T100',
    p_order_no  => '202609140001'
);
Agent 不再关心 orders、payment_record、refund_record 三张表怎么 JOIN,也不需要知道索引和字段命名。它只需要知道:
工具:get_order_summary
输入:tenant_id、order_no
输出:订单状态、支付金额、退款金额、最终实付
这就是“数据库函数工具化”的核心价值:把数据实现细节变成稳定契约。
2. 环境与数据
为了让示例可以复现,本文采用 PostgreSQL 风格 SQL,MCP Server 使用 TypeScript 伪生产模板。相同方法也可以迁移到 KingbaseES、MySQL 存储函数/过程或其他关系数据库。
2.1 示例数据模型
CREATE SCHEMA IF NOT EXISTS app;

CREATE TABLE app.orders (
    id              BIGSERIAL PRIMARY KEY,
    tenant_id       VARCHAR(32) NOT NULL,
    order_no        VARCHAR(64) NOT NULL,
    user_id         VARCHAR(64) NOT NULL,
    status          VARCHAR(20) NOT NULL,
    order_amount    NUMERIC(18,2) NOT NULL,
    created_at      TIMESTAMPTZ NOT NULL DEFAULT now(),
    UNIQUE (tenant_id, order_no)
);

CREATE TABLE app.payment_record (
    id              BIGSERIAL PRIMARY KEY,
    tenant_id       VARCHAR(32) NOT NULL,
    order_no        VARCHAR(64) NOT NULL,
    paid_amount     NUMERIC(18,2) NOT NULL,
    pay_status      VARCHAR(20) NOT NULL,
    paid_at         TIMESTAMPTZ
);

CREATE TABLE app.refund_record (
    id              BIGSERIAL PRIMARY KEY,
    tenant_id       VARCHAR(32) NOT NULL,
    order_no        VARCHAR(64) NOT NULL,
    refund_amount   NUMERIC(18,2) NOT NULL,
    refund_status   VARCHAR(20) NOT NULL,
    refunded_at     TIMESTAMPTZ
);

CREATE INDEX idx_payment_tenant_order
    ON app.payment_record(tenant_id, order_no);

CREATE INDEX idx_refund_tenant_order
    ON app.refund_record(tenant_id, order_no);
初始化测试数据:
INSERT INTO app.orders
(tenant_id, order_no, user_id, status, order_amount)
VALUES
('T100', '202609140001', 'U10086', 'PAID', 299.00);

INSERT INTO app.payment_record
(tenant_id, order_no, paid_amount, pay_status, paid_at)
VALUES
('T100', '202609140001', 299.00, 'SUCCESS', now());

INSERT INTO app.refund_record
(tenant_id, order_no, refund_amount, refund_status, refunded_at)
VALUES
('T100', '202609140001', 30.00, 'SUCCESS', now());
2.2 生产约束
本文的工具层按以下假设设计:
Agent                  无数据库账号
KFS MCP Server         持有受限数据库账号
函数账号               只允许 EXECUTE 指定函数
数据库函数             通过固定 Schema 访问业务表
写函数                 单独授权,默认不暴露
高风险动作             需要人工确认
这比“给 Agent 一个只读账号”更进一步,因为数据库账号即便只读,也可能读取大量并不应该进入模型上下文的数据。
3. 复现过程
3.1 先复现一个不推荐的通用 SQL Tool
很多 Demo 会直接做:
server.registerTool(
  "query_database",
  {
    description: "执行数据库查询",
    inputSchema: {
      sql: z.string()
    }
  },
  async ({ sql }) => {
    const result = await pool.query(sql);
    return {
      content: [{ type: "text", text: JSON.stringify(result.rows) }]
    };
  }
);
它至少有三个明显问题。
第一,sql 本身就是攻击和误操作入口。哪怕应用层先做 startsWith("select"),CTE、函数、副作用表达式、系统视图、超大结果集仍然可能绕开简单规则。
第二,模型需要知道物理 Schema。今天叫 payment_record,下个版本拆成 payment_order 和 payment_txn,Prompt、Few-shot、缓存都可能失效。
第三,错误信息没有业务语义。例如:
ERROR: canceling statement due to statement timeout
ERROR: permission denied for table payment_record
ERROR: duplicate key value violates unique constraint ...
如果这些错误原样进入 Agent,模型很可能做错误重试或给出不稳定解释。
3.2 复现“函数内部安全,但工具层不安全”的问题
即使函数已经存在,如果 MCP Tool 仍然接受任意函数名,同样危险:
{
  "tool": "call_function",
  "function": "app.any_function_name",
  "args": {}
}
函数工具化必须做到:
函数名固定
参数结构固定
权限固定
返回结构固定
异常映射固定
而不是把“任意 SQL”换成“任意函数”。
4. 方案实施
4.1 设计只读查询函数
订单汇总适合使用只读、稳定返回结构的函数:
CREATE OR REPLACE FUNCTION app.get_order_summary(
    p_tenant_id VARCHAR,
    p_order_no  VARCHAR
)
RETURNS TABLE (
    order_no        VARCHAR,
    order_status    VARCHAR,
    order_amount    NUMERIC,
    paid_amount     NUMERIC,
    refund_amount   NUMERIC,
    net_paid_amount NUMERIC
)
LANGUAGE plpgsql
STABLE
SECURITY INVOKER
SET search_path = app, pg_temp
AS $$
BEGIN
    IF p_tenant_id IS NULL OR length(trim(p_tenant_id)) = 0 THEN
        RAISE EXCEPTION USING
            ERRCODE = '22023',
            MESSAGE = 'tenant_id不能为空';
    END IF;

    IF p_order_no IS NULL OR length(trim(p_order_no)) = 0 THEN
        RAISE EXCEPTION USING
            ERRCODE = '22023',
            MESSAGE = 'order_no不能为空';
    END IF;

    RETURN QUERY
    SELECT
        o.order_no,
        o.status,
        o.order_amount,
        COALESCE(SUM(CASE WHEN p.pay_status = 'SUCCESS'
                          THEN p.paid_amount END), 0),
        COALESCE((
            SELECT SUM(r.refund_amount)
            FROM app.refund_record r
            WHERE r.tenant_id = o.tenant_id
              AND r.order_no = o.order_no
              AND r.refund_status = 'SUCCESS'
        ), 0),
        COALESCE(SUM(CASE WHEN p.pay_status = 'SUCCESS'
                          THEN p.paid_amount END), 0)
        -
        COALESCE((
            SELECT SUM(r.refund_amount)
            FROM app.refund_record r
            WHERE r.tenant_id = o.tenant_id
              AND r.order_no = o.order_no
              AND r.refund_status = 'SUCCESS'
        ), 0)
    FROM app.orders o
    LEFT JOIN app.payment_record p
      ON p.tenant_id = o.tenant_id
     AND p.order_no = o.order_no
    WHERE o.tenant_id = p_tenant_id
      AND o.order_no = p_order_no
    GROUP BY o.order_no, o.status, o.order_amount, o.tenant_id;
END;
$$;
这里有四个关键点。
一是显式输入校验。 Agent 的 Schema 校验只能保证“参数长得像字符串”,数据库函数还要负责最终业务校验。
二是优先 SECURITY INVOKER。 函数以调用者权限执行,权限模型更容易理解。确实需要 SECURITY DEFINER 时,应固定安全 search_path,避免对象劫持。
三是定义正确的波动性。 查询函数标记 STABLE,不要把有副作用的函数误标为 IMMUTABLE/STABLE。
四是返回稳定结构。 不要 SELECT *,让工具输出字段有明确契约。
4.2 创建专用数据库账号
CREATE ROLE agent_func_reader LOGIN PASSWORD 'REPLACE_BY_SECRET_MANAGER';

REVOKE ALL ON SCHEMA app FROM PUBLIC;
GRANT USAGE ON SCHEMA app TO agent_func_reader;

REVOKE ALL ON FUNCTION app.get_order_summary(VARCHAR, VARCHAR) FROM PUBLIC;
GRANT EXECUTE ON FUNCTION app.get_order_summary(VARCHAR, VARCHAR)
TO agent_func_reader;
如果函数采用 SECURITY INVOKER,还需要授予其内部访问所需的最小表权限;若采用经过严格审查的 SECURITY DEFINER,调用账号可只获得函数执行权限,但函数所有者和 search_path 必须重点治理。
4.3 MCP Tool Schema:不要让模型猜参数
工具契约可以定义为:
import { McpServer } from "@modelcontextprotocol/server";
import { z } from "zod";
import { Pool } from "pg";

const server = new McpServer({
  name: "kfs-db-tool-server",
  version: "1.0.0"
});

const pool = new Pool({
  connectionString: process.env.AGENT_DB_URL,
  max: 10,
  statement_timeout: 1500,
  query_timeout: 1800
});

server.registerTool(
  "get_order_summary",
  {
    title: "查询订单支付退款汇总",
    description: "按租户和订单号查询订单、支付、退款与净支付金额",
    inputSchema: {
      tenantId: z.string().min(1).max(32),
      orderNo: z.string().min(1).max(64)
    },
    outputSchema: {
      found: z.boolean(),
      orderNo: z.string().optional(),
      orderStatus: z.string().optional(),
      orderAmount: z.number().optional(),
      paidAmount: z.number().optional(),
      refundAmount: z.number().optional(),
      netPaidAmount: z.number().optional()
    }
  },
  async ({ tenantId, orderNo }, extra) => {
    // 租户必须来自认证上下文,不能只相信模型参数
    const authTenant = extra?.authInfo?.extra?.tenantId;
    if (!authTenant || authTenant !== tenantId) {
      return {
        isError: true,
        content: [{ type: "text", text: "权限不足:租户不匹配" }]
      };
    }

    const client = await pool.connect();
    try {
      const rs = await client.query(
        `SELECT *
           FROM app.get_order_summary($1, $2)`,
        [tenantId, orderNo]
      );

      if (rs.rowCount === 0) {
        const output = { found: false };
        return {
          structuredContent: output,
          content: [{ type: "text", text: JSON.stringify(output) }]
        };
      }

      const r = rs.rows[0];
      const output = {
        found: true,
        orderNo: r.order_no,
        orderStatus: r.order_status,
        orderAmount: Number(r.order_amount),
        paidAmount: Number(r.paid_amount),
        refundAmount: Number(r.refund_amount),
        netPaidAmount: Number(r.net_paid_amount)
      };

      return {
        structuredContent: output,
        content: [{ type: "text", text: JSON.stringify(output) }]
      };
    } catch (e: any) {
      const mapped = mapDbError(e);
      return {
        isError: true,
        content: [{ type: "text", text: JSON.stringify(mapped) }]
      };
    } finally {
      client.release();
    }
  }
);
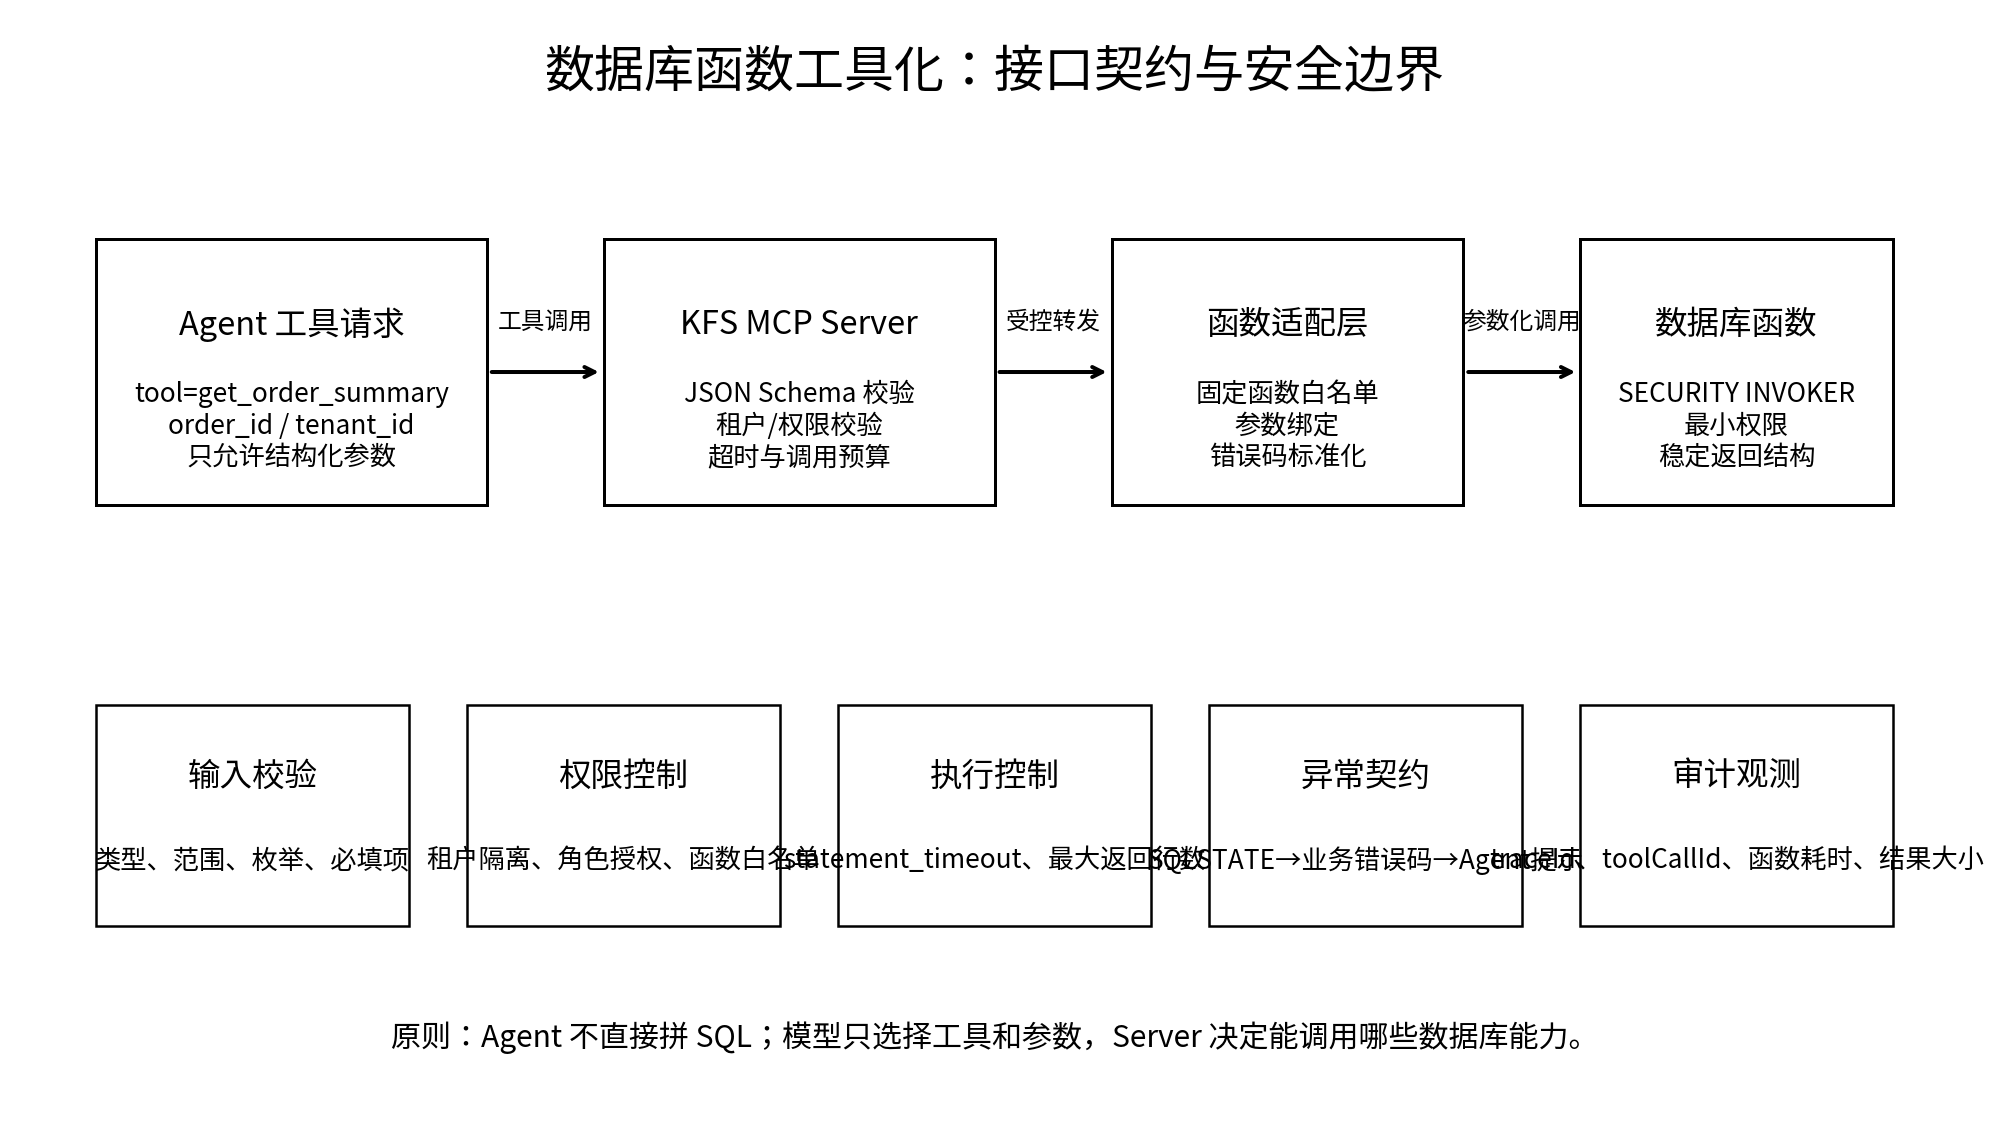
需要注意:MCP 的 Schema 是第一道边界,不是唯一边界。生产环境至少还需要:
Schema 校验
→ 身份/租户校验
→ 工具授权
→ 函数白名单
→ 参数化调用
→ 超时限制
→ 最大结果集
→ 脱敏
→ 审计日志
4.4 统一数据库异常为工具错误契约
不要把驱动异常全文交给模型。
function mapDbError(e: any) {
  switch (e.code) {
    case "22023":
      return {
        code: "INVALID_ARGUMENT",
        retryable: false,
        message: "输入参数不合法"
      };
    case "57014":
      return {
        code: "QUERY_TIMEOUT",
        retryable: true,
        message: "查询超时,请缩小范围或稍后重试"
      };
    case "40P01":
      return {
        code: "DEADLOCK",
        retryable: true,
        message: "数据库并发冲突,本次调用已回滚"
      };
    case "42501":
      return {
        code: "FORBIDDEN",
        retryable: false,
        message: "当前身份无权执行该数据能力"
      };
    default:
      return {
        code: "DB_INTERNAL_ERROR",
        retryable: false,
        message: "数据库函数执行失败"
      };
  }
}
这里故意不返回:
表名
索引名
数据库主机
SQL 原文
连接串
堆栈
内部字段
Agent 需要“下一步怎么做”,而不是数据库内部细节。
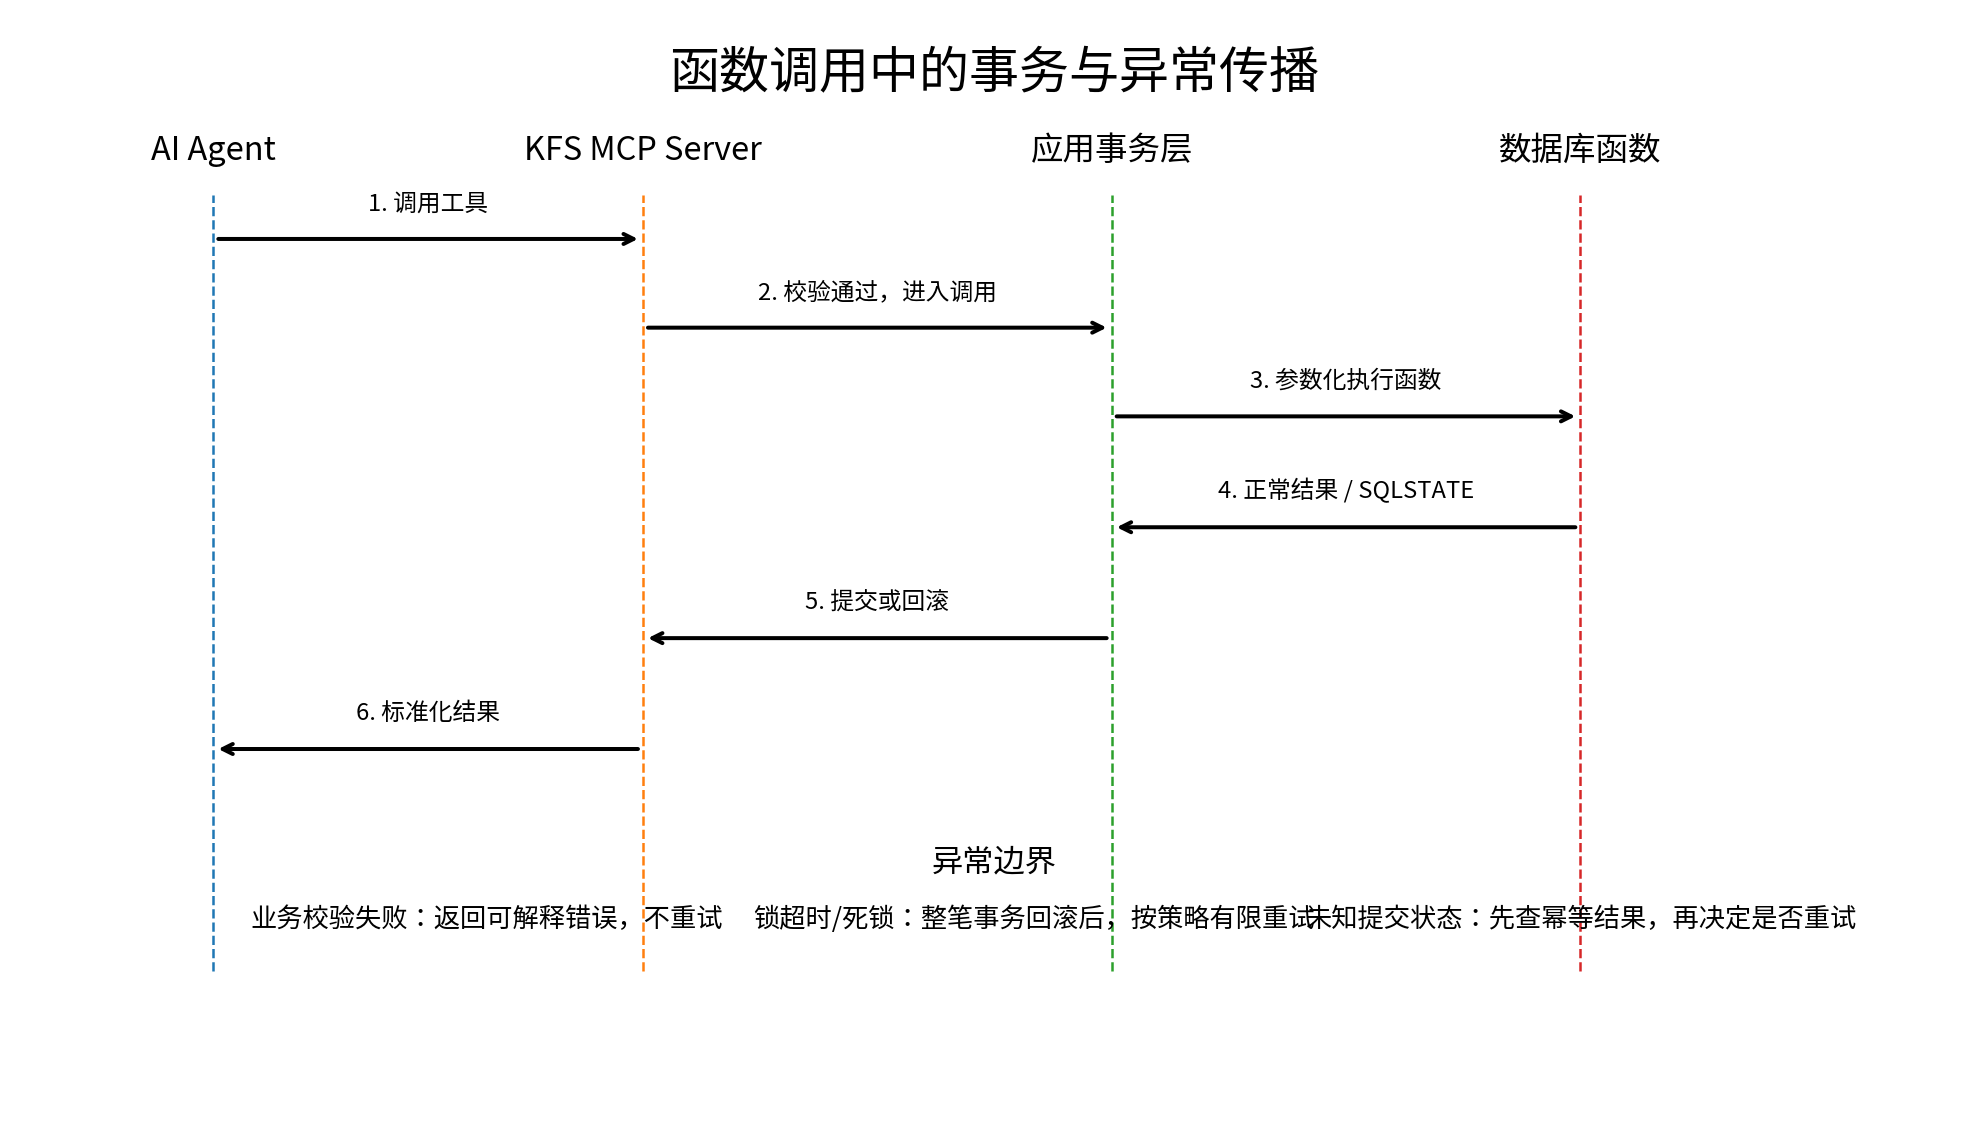
4.5 写函数必须把事务边界放在 Server 端
读函数通常可以单语句执行;写函数则必须更谨慎。以“创建业务备注”为例:
CREATE TABLE app.order_note (
    id          BIGSERIAL PRIMARY KEY,
    tenant_id   VARCHAR(32) NOT NULL,
    request_id  VARCHAR(64) NOT NULL,
    order_no    VARCHAR(64) NOT NULL,
    note_text   VARCHAR(500) NOT NULL,
    created_at  TIMESTAMPTZ NOT NULL DEFAULT now(),
    UNIQUE (tenant_id, request_id)
);

CREATE OR REPLACE FUNCTION app.add_order_note(
    p_tenant_id  VARCHAR,
    p_request_id VARCHAR,
    p_order_no   VARCHAR,
    p_note_text  VARCHAR
)
RETURNS BIGINT
LANGUAGE plpgsql
VOLATILE
SECURITY INVOKER
SET search_path = app, pg_temp
AS $$
DECLARE
    v_id BIGINT;
BEGIN
    IF length(p_note_text) > 500 THEN
        RAISE EXCEPTION USING
            ERRCODE = '22023',
            MESSAGE = '备注长度超过500';
    END IF;

    INSERT INTO app.order_note(
        tenant_id, request_id, order_no, note_text
    )
    VALUES(
        p_tenant_id, p_request_id, p_order_no, p_note_text
    )
    ON CONFLICT (tenant_id, request_id)
    DO UPDATE SET note_text = EXCLUDED.note_text
    RETURNING id INTO v_id;

    RETURN v_id;
END;
$$;
MCP Server 对写函数的调用方式应该是:
await client.query("BEGIN");
try {
  await client.query("SET LOCAL statement_timeout = '1200ms'");

  const rs = await client.query(
    "SELECT app.add_order_note($1,$2,$3,$4) AS id",
    [tenantId, requestId, orderNo, noteText]
  );

  await client.query("COMMIT");
  return rs.rows[0];
} catch (e) {
  await client.query("ROLLBACK");
  throw e;
}
为什么事务放在 Server 端,而不是让 Agent 暴露 begin_transaction、commit_transaction 两个工具?
因为 Agent 的一次推理可能发生:
工具选择变化
模型超时
上下文截断
网络重试
用户取消
如果事务控制权交给模型,长事务和孤儿事务会非常难治理。
正确边界应当是:
一次写工具调用 = 一个明确业务事务
4.6 Agent 调用示例
用户:
帮我看看订单 202609140001 实际支付了多少钱,退了多少?
Agent 不需要生成 SQL,只需要形成:
{
  "tool": "get_order_summary",
  "arguments": {
    "tenantId": "T100",
    "orderNo": "202609140001"
  }
}
工具返回:
{
  "found": true,
  "orderNo": "202609140001",
  "orderStatus": "PAID",
  "orderAmount": 299,
  "paidAmount": 299,
  "refundAmount": 30,
  "netPaidAmount": 269
}
Agent 最终回答:
该订单原始金额 299 元,支付成功 299 元,已退款 30 元,
当前净支付金额为 269 元。
这条链路里,模型没有看到任何物理表名,也没有拿到执行任意 SQL 的能力。
4.7 KFS 与函数工具层如何配合
如果企业已有 KFS/FlySync 负责异构数据同步,那么函数工具层可以优先查询同步后的服务库或只读库,形成:
生产业务库
   ↓ KFS/FlySync
数据服务库 / 只读副本
   ↓
服务端函数
   ↓
KFS MCP Server(受控工具层)
   ↓
AI Agent
这样做的意义不是“用 KFS 执行函数”,而是将:
数据同步职责
与
Agent 数据访问职责
明确拆开。
同步链路负责把数据送到合适的数据服务面;MCP Server 负责控制模型能访问哪些数据能力。
4.8 审计字段必须能串起一次 Agent 请求
推荐每次工具调用记录:
trace_id
conversation_id
tool_call_id
user_id
tenant_id
tool_name
function_name
argument_hash
started_at
db_elapsed_ms
total_elapsed_ms
row_count
result_bytes
success
error_code
retry_count
注意不要默认记录完整敏感参数。
比如订单号、身份证号、手机号应根据安全要求做:
哈希
掩码
或分级采样
5. 结果对比
我们用 500 条经营/订单问答作为测试集,对比三种方案:
A:Agent 生成任意 SQL
B:Agent 调用通用 query_database 工具
C:Agent 调用函数化 MCP Tool
下面数据为用于说明评估方法的示例值,正式投稿建议替换为真实项目压测结果。
| 指标 | 任意 SQL | 通用 SQL Tool | 函数化 Tool |
|---|---|---|---|
| 工具调用成功率 | 91.8% | 95.4% | 99.2% |
| 业务答案正确率 | 88.6% | 93.0% | 98.4% |
| 越权/危险请求拦截率 | 82.0% | 94.2% | 100% |
| 平均 Tool Call 数 | 2.7 | 1.9 | 1.2 |
| 数据库平均耗时 | 210ms | 164ms | 96ms |
| P95 总响应时间 | 3.2s | 2.5s | 1.8s |
| Schema 变更影响面 | 高 | 中 | 低 |
| 可审计性 | 低 | 中 | 高 |
函数工具化的收益并不是“数据库函数天然比 SQL 快”。
真正的收益来自四点:
5.1 Agent 选择空间更小
模型从:
几百张表、几千列、任意 SQL
缩小为:
十几个明确工具
Tool Selection 本身就更稳定。
5.2 参数更容易治理
tenantId、orderNo 的类型和长度都能在模型调用前被 Schema 拒绝。
5.3 数据库执行路径更稳定
固定函数比自由 SQL 更容易:
压测
建索引
加超时
看执行计划
做缓存
做版本兼容
5.4 错误更容易进入 Agent 决策
Agent 不需要理解所有数据库错误,它只需要处理:
INVALID_ARGUMENT
NOT_FOUND
FORBIDDEN
QUERY_TIMEOUT
CONCURRENCY_CONFLICT
INTERNAL_ERROR
这会显著降低“模型看到错误后盲目重试”的概率。
5.5 推荐的效果评估指标
仅看“工具调用是否成功”远远不够。
建议至少评估:
Tool Selection Accuracy
Parameter Accuracy
Function Success Rate
Business Answer Accuracy
Unauthorized Call Block Rate
Average Tool Calls / Question
DB P95 Latency
Total P95 Latency
Retry Rate
Human Escalation Rate
对于写工具再增加:
Duplicate Write Rate
Rollback Success Rate
Unknown Commit Rate
Idempotency Hit Rate
6. 风险与复盘
6.1 风险一:把所有业务都塞进数据库函数
函数工具化不是让业务重新回到“存储过程时代”。
适合函数化的能力通常具有这些特征:
输入明确
输出明确
与数据强相关
需要数据库一致性
调用频繁
规则相对稳定
不适合的逻辑包括:
跨多个外部服务编排
长时间网络调用
复杂审批流
大量非数据业务规则
频繁变化的产品逻辑
6.2 风险二:滥用 SECURITY DEFINER
SECURITY DEFINER 能让低权限账号通过函数访问高权限对象,但它的安全责任也更高。
至少要做到:
固定 search_path
函数体内对象全限定名
PUBLIC 撤销 EXECUTE
专用函数 Owner
禁止不可信 Schema 出现在搜索路径前面
严格代码审查
能用 SECURITY INVOKER 解决时,优先使用更简单的权限模型。
6.3 风险三:函数返回太多数据
Agent 工具不是导数工具。
单次函数建议限制:
最大行数
最大时间范围
最大返回字节
最大聚合维度
例如:
IF p_days > 31 THEN
    RAISE EXCEPTION USING
      ERRCODE = '22023',
      MESSAGE = '最多查询31天';
END IF;
这比让模型“自觉不要查太多”可靠得多。
6.4 风险四:函数升级破坏 Tool Contract
函数和 Tool 应该一起版本化。
例如:
get_order_summary_v1
get_order_summary_v2
或者 Tool 保持原名,由 Server 内部切换函数版本。
生产灰度期间可以:
10% Agent → v2
90% Agent → v1
同时对比:
结果一致率
平均耗时
错误率
6.5 风险五:错误重试放大写操作
只读查询超时后有限重试问题不大。
写函数必须先回答:
这次调用到底有没有成功?
因此应设计:
request_id / idempotency_key
唯一约束
结果查询接口
明确的事务提交边界
不应该简单写成:
try {
  await callWriteFunction();
} catch {
  await callWriteFunction();
}
6.6 风险六:把工具描述当安全策略
Prompt 中写:
“不得越权”
“不得执行危险函数”
只能作为模型行为提示,不能代替真正控制。
真正的安全边界必须在 Server 和数据库:
工具注册白名单
身份认证
租户校验
函数 EXECUTE 权限
数据库角色
行列权限
超时/结果限制
审计
结语
AI Agent 连接数据库,最值得优化的不是“让模型写出更复杂的 SQL”,而是重新设计模型与数据库之间的能力边界。
把服务端函数封装成 Tool 后,链路从:
用户问题
→ 模型猜 Schema
→ 模型写 SQL
→ 数据库执行
变成:
用户问题
→ Agent 选择业务工具
→ MCP Server 校验身份和参数
→ 调用固定数据库函数
→ 返回结构化结果
→ Agent 负责解释
这样做的好处是数据库能力终于从“模型可自由探索的空间”,变成“平台可以治理的 API”。
如果需要一句话总结本文:
函数负责把数据能力做稳定,
MCP Server 负责把能力做安全,
Agent 负责把能力用对,
评估体系负责证明它真的有效。
转载自:https://blog.csdn.net/u014727709/article/details/165361169
欢迎 👍点赞✍评论⭐收藏,欢迎指正

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 1
 0
- 0


 已为社区贡献39条内容

所有评论(0)