AI Agent辅助备份恢复演练——KFS MCP Server、步骤编排与风险控制
文章目录
- 每日一句正能量
- 前言
- 1. 背景与问题
- 2. 环境与数据
- 3. 复现过程
- 4. 方案实施
- 4.1 第一步:创建演练计划
- 4.2 工具一:list_backup_sets
- 4.3 工具二:verify_backup_integrity
- 4.4 工具三:verify_archive_continuity
- 4.5 自动中止条件
- 4.6 工具四:create_isolated_restore_target
- 4.7 为什么恢复环境必须隔离
- 4.8 工具五:restore_backup
- 4.9 `pg_restore` 场景
- 4.10 PITR 场景
- 4.11 KFS 在灾备体系中的位置
- 4.12 工具六:wait_restore_ready
- 4.13 工具调用预算
- 4.14 恢复后的数据库级校验
- 4.15 关键业务校验不能只看行数
- 4.16 验证目标恢复时间
- 4.17 应用 Smoke Test
- 4.18 JDBC 验证代码
- 4.19 MyBatis 验证
- 4.20 安全等级
- 4.21 工具层硬拒绝生产目标
- 4.22 恢复命令不能由模型自由拼接
- 4.23 凭据安全
- 4.24 日志脱敏
- 4.25 工具错误结构化
- 4.26 人工确认点
- 4.27 RPO 计算
- 4.28 RTO 计算
- 4.29 效果评估
- 4.30 Agent 效果不能只看“省了多少人力”
- 4.31 一个完整演练案例
- 5. 结果对比
- 6. 风险与复盘
- 结语
每日一句正能量
⚡ 行动:从焦虑剧本到作者觉醒
“最困难之时,就是我们离成功不远之日。”
最困难、最想放弃之时,往往正是积累即将完成、质变即将发生的前夜。它让你在至暗时刻,能多一份基于规律的笃定。
前言
备份最危险的错觉,是“文件存在,所以一定能恢复”。
很多团队每天都有备份任务:
01:00 全量备份成功
01:15 WAL/归档持续上传
02:00 监控显示备份文件存在
看起来一切正常,但真正发生故障时才发现:
归档日志中间缺了一段;
备份文件校验和失败;
恢复脚本依赖已经下线的对象存储路径;
目标版本和备份版本不兼容;
账号权限不足;
恢复可以启动,却无法达到要求的时间点;
数据库能启动,但关键业务表数据不完整。
所以灾备体系真正要验证的不是“有没有备份”,而是:
能不能恢复,
多久能恢复,
能恢复到哪个时间点,
恢复后的数据是不是可用。
这正是 AI Agent 可以发挥价值的地方。
但灾备演练与普通巡检不同:它包含大量潜在高风险动作。如果直接给 Agent 一个能够执行任意 shell、任意 SQL、任意存储命令的超级工具,风险会远大于收益。
更合理的架构是:
Agent 负责步骤编排、证据收集和结果解释;
KFS MCP Server 负责暴露受控灾备工具;
恢复动作只能落到隔离环境;
生产切换、覆盖、删除等不可逆动作必须人工批准。
本文继续采用前文的架构约定:KFS MCP Server 指面向 KFS/数据库能力的 MCP 工具服务层。公开资料中,KFS 官方产品 Kingbase FlySync 是异构数据同步产品,并面向本地/异地灾备、迁移等场景;MCP 官方规范则支持 Server 通过结构化 Schema 暴露工具。这里重点借用的是“受控工具调用”这一能力,而不是让模型直接获得数据库超级权限。
1. 背景与问题
假设生产数据库的灾备目标是:
RPO <= 5 分钟
RTO <= 30 分钟
也就是说:
最多接受丢失 5 分钟数据;
从确认故障到恢复业务,目标不超过 30 分钟。
如果团队只看:
备份任务成功率 100%
根本无法证明这两个目标能达到。
一次完整演练至少需要回答:
最近一个可用全量/基础备份是什么?
归档日志是否连续?
目标恢复时间点能否覆盖?
恢复耗时是多少?
恢复后的表、索引、约束是否存在?
关键业务数据是否一致?
应用能否以只读方式完成 Smoke Test?
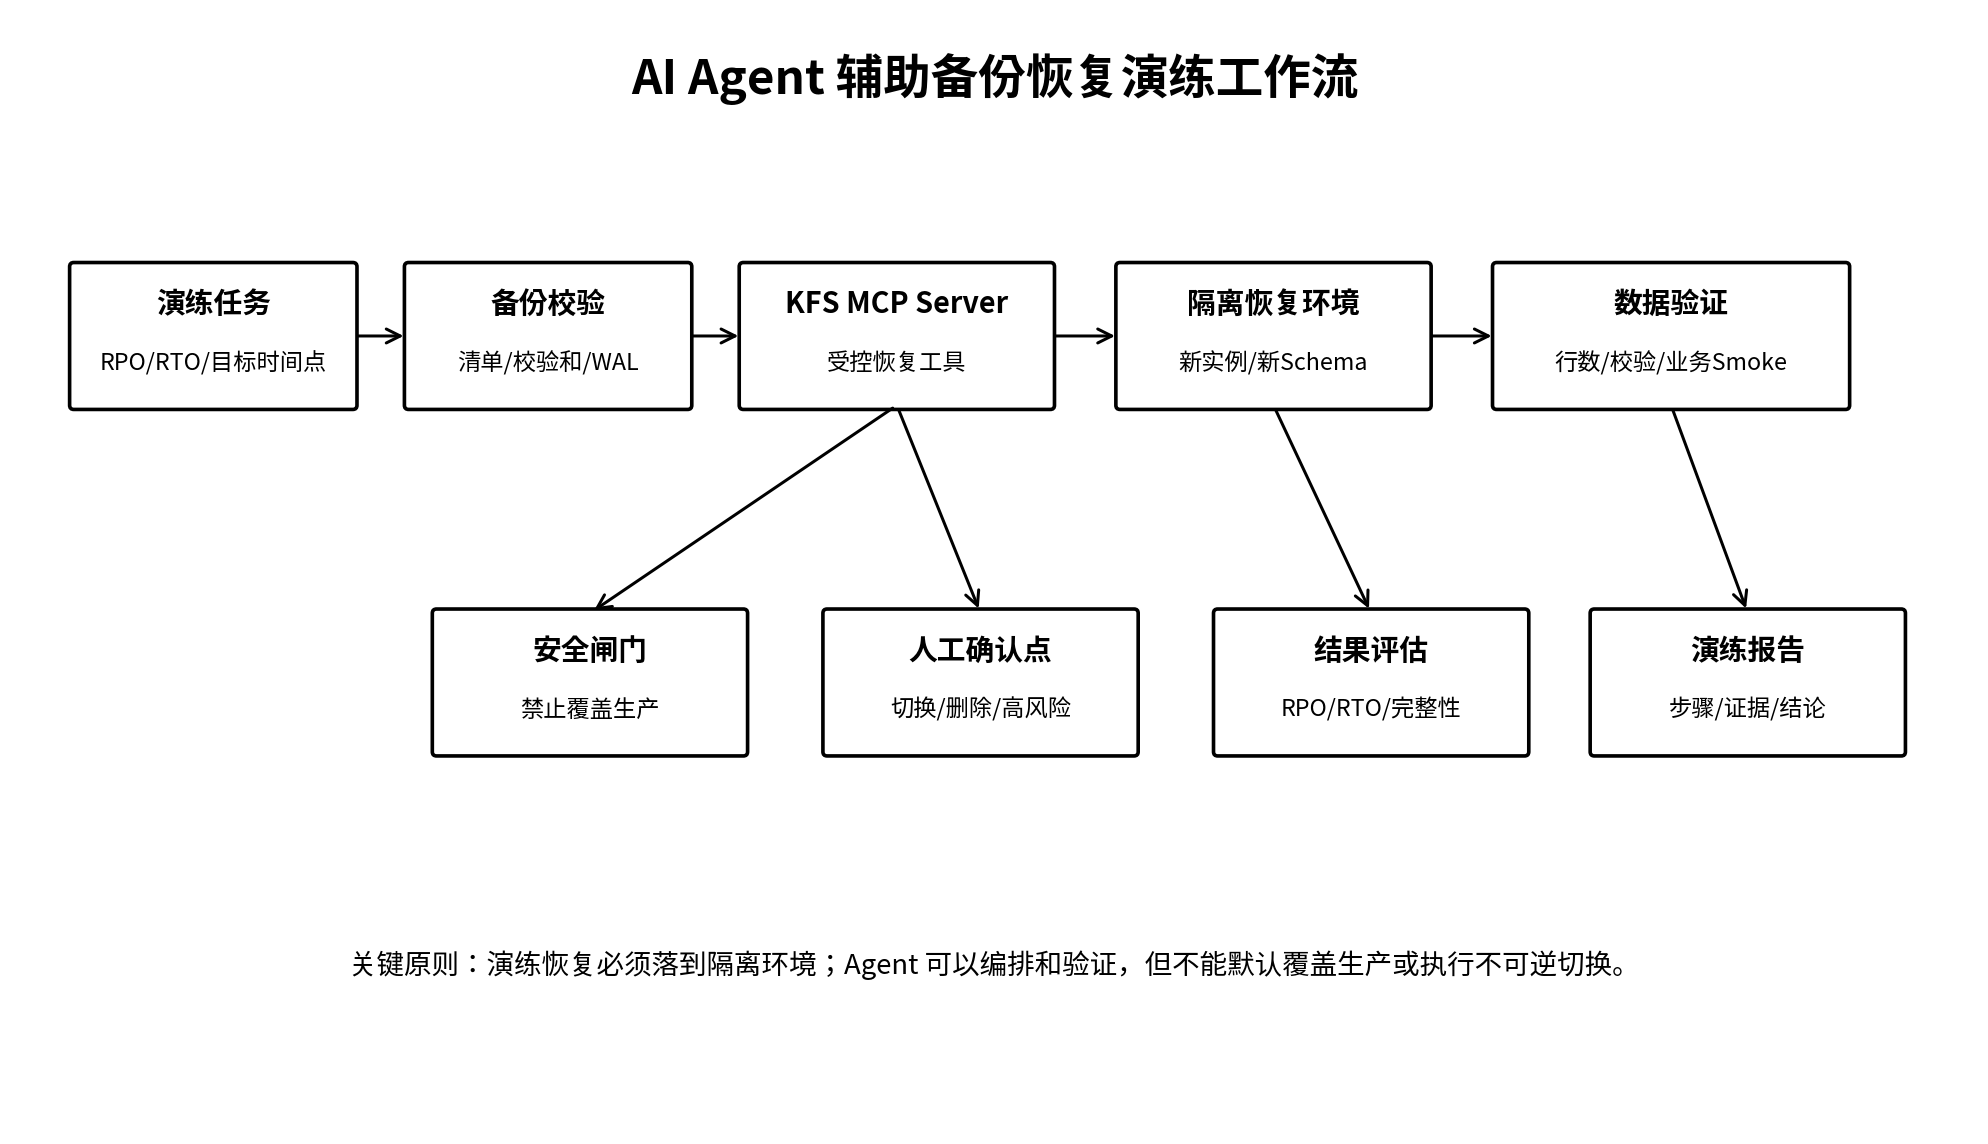
这条链路如果完全靠人工执行,步骤多、容易遗漏,而且每个人的操作顺序可能不同。
AI Agent 的价值,就是把流程编排标准化。
2. 环境与数据
示例环境:
JDK 21
Spring Boot 3.3+
KingbaseES / PostgreSQL 类数据库
KFS MCP Server
对象存储 / 备份仓库
JDBC / MyBatis
OpenTelemetry
演练任务表:
CREATE TABLE dr_drill_job (
    id BIGINT PRIMARY KEY,
    drill_no VARCHAR(64) NOT NULL UNIQUE,
    source_database VARCHAR(128) NOT NULL,
    target_environment VARCHAR(64) NOT NULL,
    target_restore_time TIMESTAMP NULL,
    expected_rpo_sec INT NOT NULL,
    expected_rto_sec INT NOT NULL,
    status VARCHAR(16) NOT NULL,
    started_at TIMESTAMP NOT NULL,
    finished_at TIMESTAMP NULL
);
步骤记录:
CREATE TABLE dr_drill_step (
    id BIGINT PRIMARY KEY,
    drill_no VARCHAR(64) NOT NULL,
    step_code VARCHAR(64) NOT NULL,
    step_status VARCHAR(16) NOT NULL,
    started_at TIMESTAMP NULL,
    finished_at TIMESTAMP NULL,
    evidence_json TEXT NULL,
    error_code VARCHAR(64) NULL,

    UNIQUE(drill_no, step_code)
);
验证结果:
CREATE TABLE dr_validation_result (
    id BIGINT PRIMARY KEY,
    drill_no VARCHAR(64) NOT NULL,
    check_code VARCHAR(64) NOT NULL,
    expected_value VARCHAR(256) NULL,
    actual_value VARCHAR(256) NULL,
    passed BOOLEAN NOT NULL,
    checked_at TIMESTAMP NOT NULL
);
3. 复现过程
3.1 最简单的“假演练”
很多所谓灾备演练实际只做:
确认备份文件存在。
甚至:
ls backup/
看到文件就结束。
这只能证明:
产生过文件。
不能证明:
文件完整
格式正确
日志连续
能够恢复
恢复后可用
3.2 只执行 pg_restore --list 也不够
对于 pg_dump 产生的非纯文本归档,pg_restore 可以用于恢复,也可以查看归档内容。
例如:
pg_restore --list backup.dump
这能验证归档可被识别,但仍然不代表:
所有对象可成功重建。
真正演练必须在隔离数据库上实际恢复。
3.3 PITR 最常见问题:WAL 不连续
基于连续归档做时间点恢复时,需要:
基础备份
+
从基础备份起到目标时间点之间连续的 WAL
如果中间缺一段:
即使基础备份完好,
也无法恢复到目标时间点。
所以恢复前必须先验证归档连续性。
3.4 “恢复成功”不等于业务可用
数据库能启动后,还可能出现:
缺索引
缺扩展
权限缺失
业务配置表不一致
序列值落后
关键数据时间点不符合预期
所以演练需要:
数据库级验证
+
业务级 Smoke Test。
4. 方案实施
4.1 第一步:创建演练计划
Agent 接收的不是:
“帮我恢复数据库。”
而是结构化任务:
{
  "drillNo": "DR-2026-0187",
  "database": "order_prod",
  "restoreMode": "PITR",
  "targetTime": "2026-08-08T01:30:00",
  "expectedRpoSec": 300,
  "expectedRtoSec": 1800,
  "targetEnvironment": "dr_isolated_01"
}
必须明确:
目标数据库
恢复方式
目标时间
隔离环境
RPO/RTO
4.2 工具一:list_backup_sets
MCP Tool:
{
  "name": "list_backup_sets",
  "inputSchema": {
    "type": "object",
    "properties": {
      "database": {
        "type": "string"
      },
      "beforeTime": {
        "type": "string"
      }
    },
    "required": [
      "database"
    ]
  }
}
输出:
{
  "backupSets": [
    {
      "backupId": "BKP-20260808-0100",
      "type": "BASE",
      "finishedAt": "2026-08-08T01:08:12",
      "sizeBytes": 182000000000,
      "checksumStatus": "PASS"
    }
  ]
}
4.3 工具二:verify_backup_integrity
这个工具只做:
校验和
文件可读性
归档元数据检查
不能直接恢复。
输出:
{
  "backupId": "BKP-20260808-0100",
  "checksum": "PASS",
  "manifest": "PASS",
  "readable": true
}
4.4 工具三:verify_archive_continuity
PITR 场景必须确认:
基础备份结束点
-> 目标恢复时间
之间的归档连续。
输出:
{
  "startLsn": "0/81000028",
  "targetTime": "2026-08-08T01:30:00",
  "archiveContinuous": true,
  "missingSegments": []
}
如果:
missingSegments
非空,Agent 应立即停止后续恢复。
4.5 自动中止条件
例如:
if (!archiveResult.continuous()) {
    throw new DrillBlockedException(
        "ARCHIVE_GAP"
    );
}
Agent 不应该“尝试一下再说”。
灾备流程的关键是:
有明确失败闸门。
4.6 工具四:create_isolated_restore_target
只能创建:
隔离恢复环境。
输入:
{
  "name": "dr_isolated_01",
  "cpu": 4,
  "memoryGb": 16,
  "networkPolicy": "NO_PRODUCTION_WRITE"
}
环境创建时强制:
无法连接生产业务写入口
禁止使用生产服务发现名称
独立数据库账号
独立存储
4.7 为什么恢复环境必须隔离
最危险的事故之一,是恢复出来的数据库:
仍然连接生产 MQ
仍然连生产缓存
仍然运行定时任务
仍然能够回调外部系统
所以不仅数据库要隔离,应用 Smoke Test 环境也必须:
关闭生产外部写。
4.8 工具五:restore_backup
MCP Tool 不接受 shell 字符串。
错误:
{
  "command": "pg_restore ..."
}
推荐:
{
  "backupId": "BKP-20260808-0100",
  "target": "dr_isolated_01",
  "mode": "PITR",
  "targetTime": "2026-08-08T01:30:00"
}
服务端由固定适配器生成实际恢复命令。
4.9 pg_restore 场景
非纯文本 pg_dump 归档可通过:
pg_restore \
  --dbname=dr_test \
  --jobs=4 \
  backup.dump
恢复到隔离库。
Agent 不能自由增加:
--clean
--create
等可能扩大影响范围的参数。
允许参数由 Server 白名单控制。
4.10 PITR 场景
基于物理备份和 WAL 的恢复,与逻辑 pg_restore 不同。
步骤通常类似:
准备基础备份
恢复数据目录
配置恢复目标
提供归档日志
启动恢复
等待达到目标时间点
Agent 应根据:
restoreMode
选择固定工作流,而不是把逻辑恢复和 PITR 混在一起。
4.11 KFS 在灾备体系中的位置
Kingbase FlySync 官方资料将 KFS 定位为异构数据同步产品,并明确覆盖本地/异地灾备、迁移等场景。
因此在完整灾备演练里,可以额外检查:
同步任务是否正常
目标端延迟
切换前数据追平程度
但要区分:
备份恢复
与:
数据同步/灾备复制
它们不是同一种恢复机制。
4.12 工具六:wait_restore_ready
恢复是长任务。
不要让 Agent:
不断轮询每秒一次。
服务端暴露:
jobId
status
progress
例如:
{
  "jobId": "RESTORE-001",
  "status": "RUNNING",
  "progress": 72
}
Agent 最多按合理间隔查询。
4.13 工具调用预算
例如:
list backups:1
verify backup:1
verify archive:1
create target:1
start restore:1
check status:<=6
validate:3~5
设置:
maxToolCalls = 20
防止模型出现无限循环。
4.14 恢复后的数据库级校验
首先检查:
SELECT version();
然后:
SELECT count(*)
FROM pg_catalog.pg_tables
WHERE schemaname NOT IN (
    'pg_catalog',
    'information_schema'
);
检查关键表:
SELECT COUNT(*)
FROM orders;
4.15 关键业务校验不能只看行数
更可靠的是:
行数
最大业务时间
金额汇总
关键状态分布
校验和
例如:
SELECT
    COUNT(*) AS cnt,
    MAX(created_at) AS latest_order,
    SUM(amount) AS total_amount
FROM orders;
4.16 验证目标恢复时间
如果目标:
01:30
恢复后最新订单:
01:29:58
可能合理。
如果最新只有:
01:15
说明:
实际 RPO 不符合预期。
4.17 应用 Smoke Test
使用只读账号运行:
查询订单
查询用户
查询库存
查询配置
禁止:
创建订单
支付
发送消息
外部回调
4.18 JDBC 验证代码
public ValidationResult
validateOrderSnapshot() {

    return jdbcTemplate.queryForObject(
        """
        SELECT
            COUNT(*) AS cnt,
            MAX(created_at) AS latest_time,
            SUM(amount) AS total_amount
        FROM orders
        """,
        (rs, rowNum) ->
            new ValidationResult(
                rs.getLong("cnt"),
                rs.getTimestamp(
                    "latest_time"
                ).toInstant(),
                rs.getBigDecimal(
                    "total_amount"
                )
            )
    );
}
4.19 MyBatis 验证
<select id="snapshot"
        resultType="OrderSnapshot">
    SELECT
        COUNT(*) AS row_count,
        MAX(created_at) AS latest_time,
        SUM(amount) AS total_amount
    FROM orders
</select>
演练工具只允许:
SELECT。
4.20 安全等级
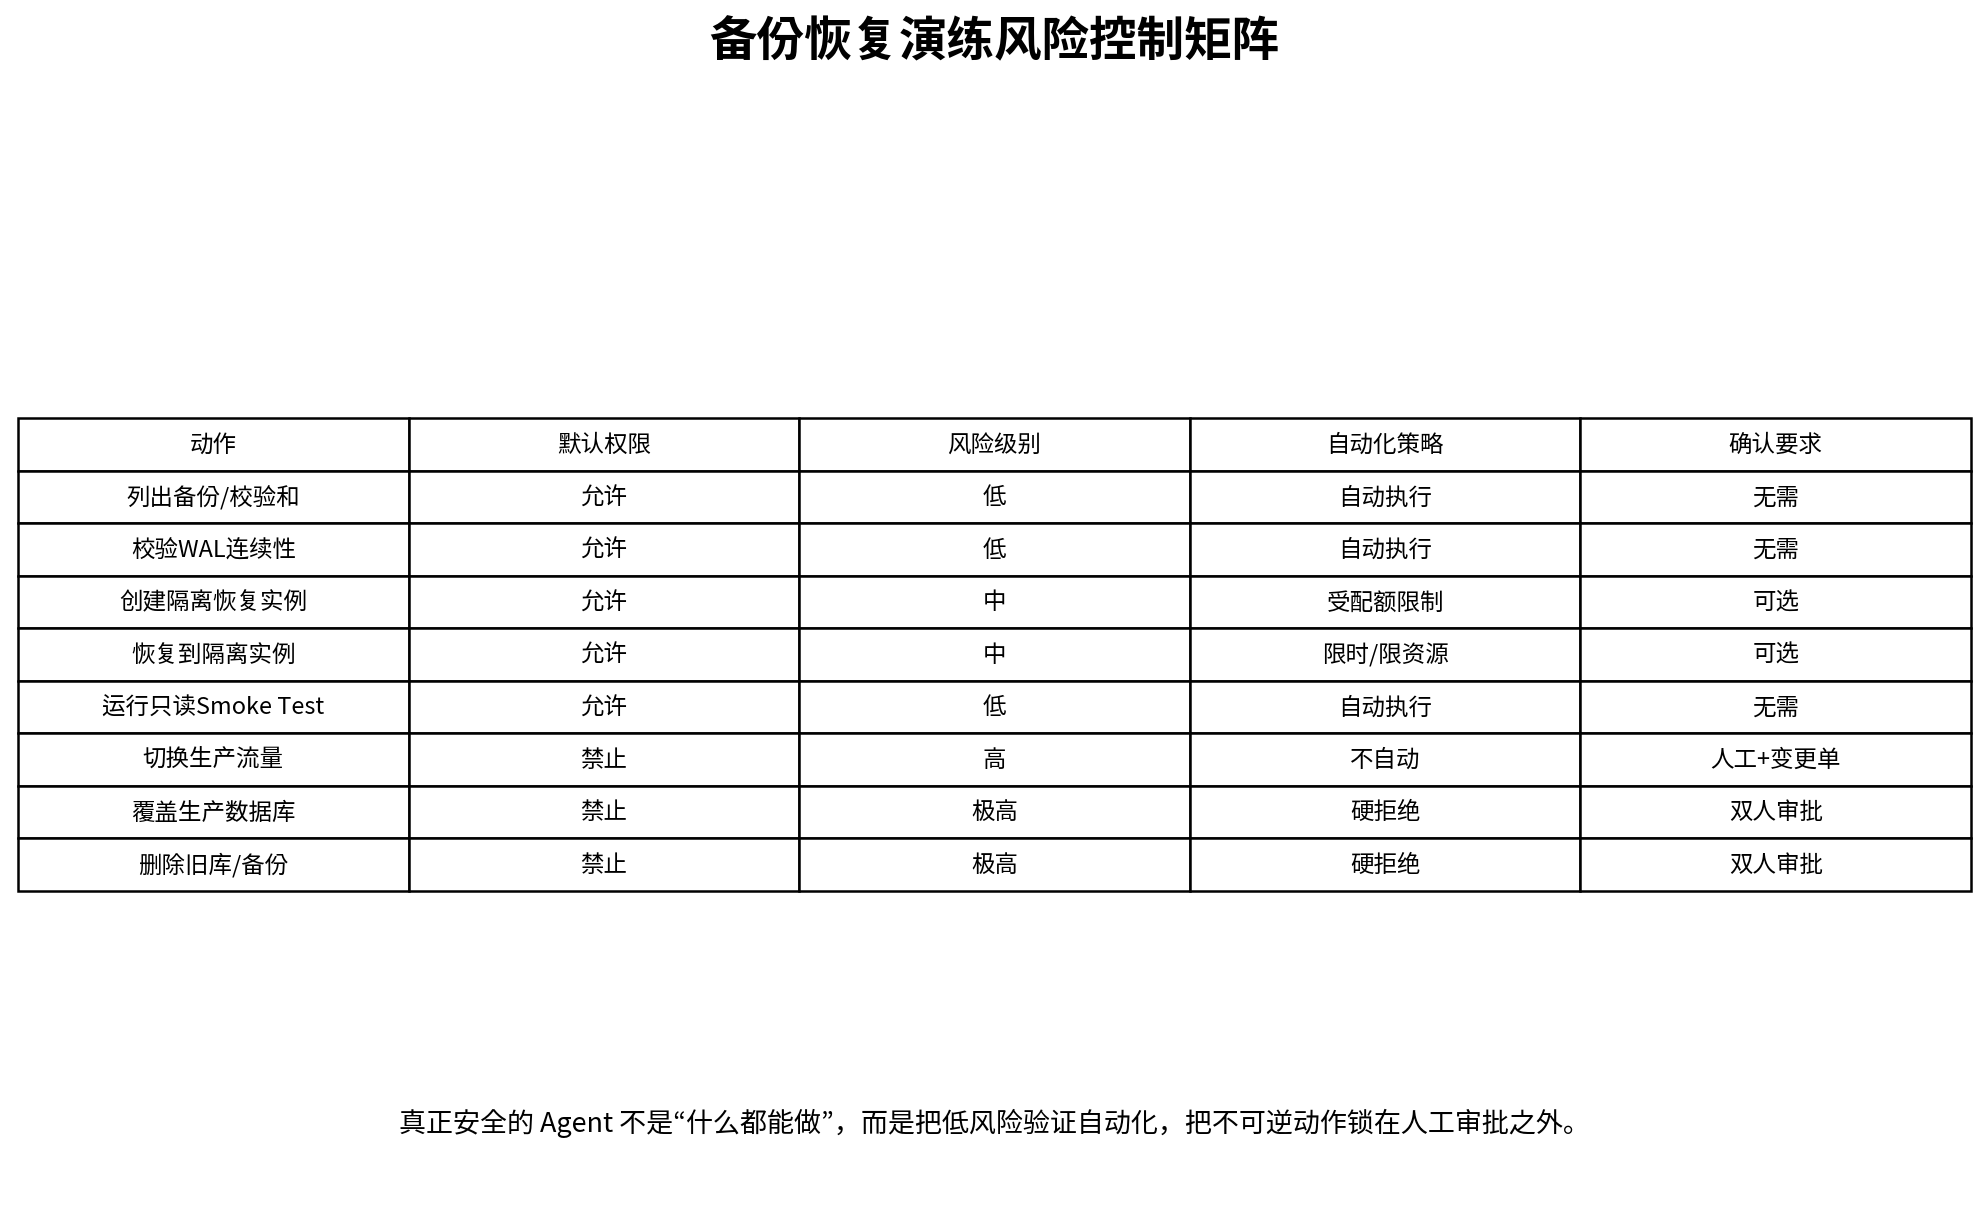
建议划分:
L1:
查询备份、校验、只读验证

L2:
创建隔离资源、启动隔离恢复

L3:
生产切换、停止主库

L4:
覆盖生产、删除数据库、删除备份
Agent 自动权限:
仅 L1/L2。
L3/L4:
默认禁止。
4.21 工具层硬拒绝生产目标
即使模型错误传:
{
  "target": "order_prod"
}
Server 也要硬拒绝:
if (environment.isProduction(target)) {
    throw new ToolDeniedException(
        "PRODUCTION_RESTORE_FORBIDDEN"
    );
}
不能靠 Prompt:
“请不要恢复生产。”
安全规则必须在工具服务端执行。
4.22 恢复命令不能由模型自由拼接
否则会产生:
命令注入
危险参数
路径覆盖
所有恢复命令应由:
typed arguments
+
server-side adapter
生成。
4.23 凭据安全
Agent 不应该看到:
数据库密码
对象存储 Secret
KMS Key
MCP Tool 接收:
credentialRef
由 Server 从密钥系统解析。
4.24 日志脱敏
恢复日志可能包含:
路径
账号
连接串
对象存储地址
进入模型前要清理敏感字段。
4.25 工具错误结构化
{
  "code": "BACKUP_CHECKSUM_FAILED",
  "retryable": false,
  "backupId": "BKP-..."
}
归档缺失:
{
  "code": "ARCHIVE_GAP",
  "retryable": false,
  "missingCount": 2
}
资源不足:
{
  "code": "RESTORE_TARGET_CAPACITY_LOW",
  "retryable": true
}
Agent 根据错误决定:
停止
重试
换目标资源
4.26 人工确认点
恢复到隔离环境:
可自动。
切换业务流量:
必须人工确认。
确认内容应包括:
演练编号
恢复点
校验结果
RPO
RTO
风险
回滚计划
4.27 RPO 计算
例如:
故障目标时间:01:30:00
恢复后最新事务:01:28:40
实际数据损失窗口:
80 秒
则:
RPO Actual = 80s
满足:
RPO <= 300s
4.28 RTO 计算
从:
演练启动
到:
数据库恢复 + Smoke Test 通过
总耗时:
24m 18s
则:
RTO Actual = 1458s
满足 30 分钟目标。
4.29 效果评估
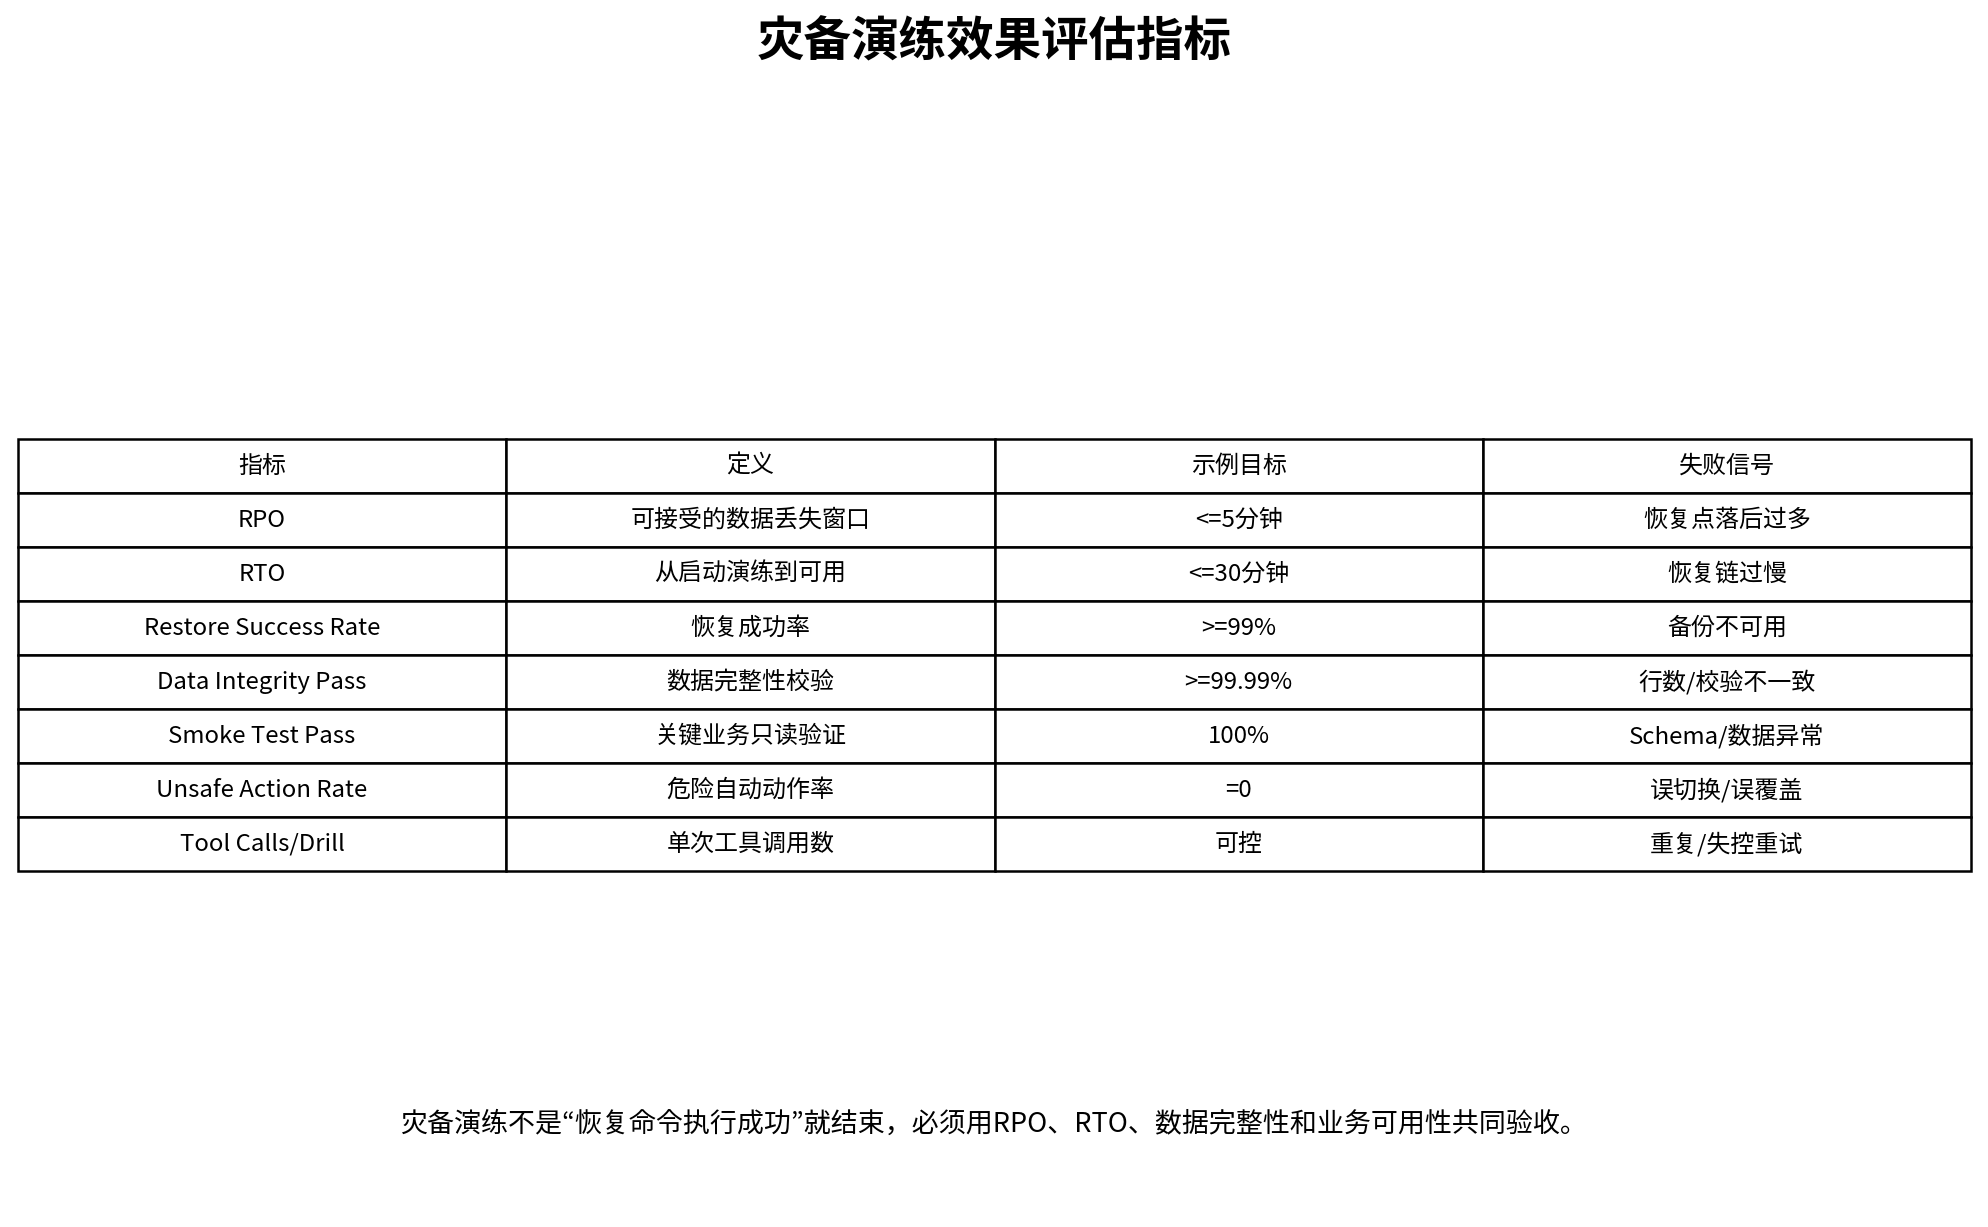
一次演练至少记录:
Restore Success Rate
RPO Actual
RTO Actual
Data Integrity Pass
Smoke Test Pass
Unsafe Action Rate
Tool Calls
Human Approval Count
4.30 Agent 效果不能只看“省了多少人力”
更重要的是:
有没有漏步骤
有没有误判恢复成功
有没有产生危险动作
有没有给出可追溯证据
4.31 一个完整演练案例
演练:
目标:
恢复 order_prod 到 01:30

备份:
01:00 基础备份

WAL:
连续到 01:42

恢复:
隔离环境 dr-order-01

实际 RTO:
24 分钟

最新订单:
01:29:53

实际 RPO:
7 秒

业务 Smoke:
18/18 通过
Agent 报告:
本次演练成功。

RPO:
7 秒,满足 5 分钟目标。

RTO:
24 分钟,满足 30 分钟目标。

风险:
恢复前发现对象存储下载阶段耗时占总 RTO 的 42%,
建议继续优化恢复介质就近缓存。

未执行任何生产切换或覆盖操作。
这类结论才真正能指导灾备建设。
5. 结果对比
传统人工演练
流程依赖:
Runbook
DBA 经验
手工命令
Excel 记录
问题:
步骤易遗漏
时间点记录不统一
证据分散
高风险命令依赖人工谨慎
Agent 辅助演练
流程:
结构化任务
-> 工具编排
-> 自动校验
-> 隔离恢复
-> 数据验证
-> RPO/RTO 计算
-> 自动报告
但高风险动作依然:
人工确认。
真正收益不是:
让 AI 一键恢复生产。
而是:
把灾备演练变成可重复、可审计、可量化的工程流程。
6. 风险与复盘
6.1 最大风险是恢复到错误目标
工具层必须:
白名单环境
生产硬拒绝
目标二次校验
6.2 备份可读不代表备份可恢复
必须定期执行:
真实隔离恢复。
6.3 PITR 依赖完整归档链
基础备份成功,但 WAL 缺失:
仍然无法达到目标恢复点。
6.4 恢复出来的应用环境也要隔离
否则测试环境可能:
发生产消息
调用生产接口
重复执行任务。
6.5 Agent 不能拥有云平台管理员权限
创建恢复环境应通过受限的:
resource template
quota
network policy
工具完成。
6.6 删除操作必须完全独立
删除恢复环境可以自动化到一定程度。
但:
删除生产备份
清理历史库
必须单独高权限流程。
6.7 KFS 同步与备份恢复不可互相替代
KFS 官方定位是异构数据同步,并可服务灾备场景;但:
同步链路
不能完全替代:
离线备份
PITR
历史恢复点。
同步错误也可能把错误数据同步过去。
成熟灾备体系需要多层保护。
6.8 演练频率比“有方案”更重要
没有定期验证的 Runbook:
很快会过期。
建议按业务等级:
月度
季度
半年
制定固定演练计划。
结语
备份恢复是数据库运维里最适合“流程自动化”,但最不适合“无限授权 AI”的场景之一。
成熟的实现应该是:
Agent 负责计划和编排,
KFS MCP Server 负责受控工具,
恢复始终进入隔离环境,
数据库和业务校验自动完成,
RPO/RTO 自动计算,
生产切换始终由人工批准。
可以把全文总结成一句话:
AI 可以把灾备演练变得更快、更标准、更可追溯,
但越接近生产切换和不可逆动作,自动化权限就应该越低。
只有把“自动化效率”和“不可逆风险”同时纳入设计,AI Agent 才真正适合进入数据库备份恢复这样的高风险智能运维场景。
转载自:https://blog.csdn.net/u014727709/article/details/165358890
欢迎 👍点赞✍评论⭐收藏,欢迎指正

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 1
 0
- 0


 已为社区贡献39条内容

所有评论(0)