AI Agent辅助锁等待分析的实现——KFS MCP Server、会话采集与并发故障诊断
文章目录
- 每日一句正能量
- 前言
- 1. 背景与问题
- 2. 环境与数据
- 3. 复现过程
- 4. 方案实施
- 4.1 工具一:inspect_waiting_sessions
- 4.2 工具二:inspect_lock_graph
- 4.3 使用 `pg_blocking_pids`
- 4.4 工具三:inspect_session_context
- 4.5 JDBC 采集
- 4.6 MyBatis 实现
- 4.7 自动重建阻塞图
- 4.8 为什么“根阻塞者”比“等待最久”更重要
- 4.9 Agent Prompt 应使用固定分析顺序
- 4.10 典型归因一:idle in transaction
- 4.11 典型归因二:长业务事务
- 4.12 典型归因三:热点行竞争
- 4.13 典型归因四:锁顺序不一致
- 4.14 工具四:inspect_transaction_age
- 4.15 工具五:inspect_lock_hotspots
- 4.16 KFS MCP Server 的安全边界
- 4.17 只读账号
- 4.18 “kill session” 必须独立工具
- 4.19 防止 PID 复用风险
- 4.20 数据脱敏
- 4.21 工具调用预算
- 4.22 快照一致性
- 4.23 工具错误结构化
- 4.24 一个案例
- 4.25 如果阻塞者是正常长操作
- 4.26 与 APM 关联
- 4.27 JDBC applicationName
- 4.28 效果评估
- 4.29 评估指标
- 4.30 不能用“是否自动解决”评价
- 5. 结果对比
- 6. 风险与复盘
- 结语
每日一句正能量
“当你站在山顶时,你的头顶还有星空。”
真正的伟大,是在抵达高处后,依然对深邃与崇高保持敬畏与向往。物理的顶峰之上,是精神的无限苍穹。
前言
数据库并发故障里,最容易被误诊的不是死锁,而是“锁等待”。
接口突然从 80ms 变成 8 秒,应用日志里只看到:
SQL execution timeout
开发人员第一反应通常是:
是不是 SQL 变慢了?
是不是索引失效了?
是不是数据库 CPU 满了?
但真正进入数据库后,经常会发现 SQL 本身只需要几十毫秒,剩下的大部分时间都在:
等待另一个事务释放锁。
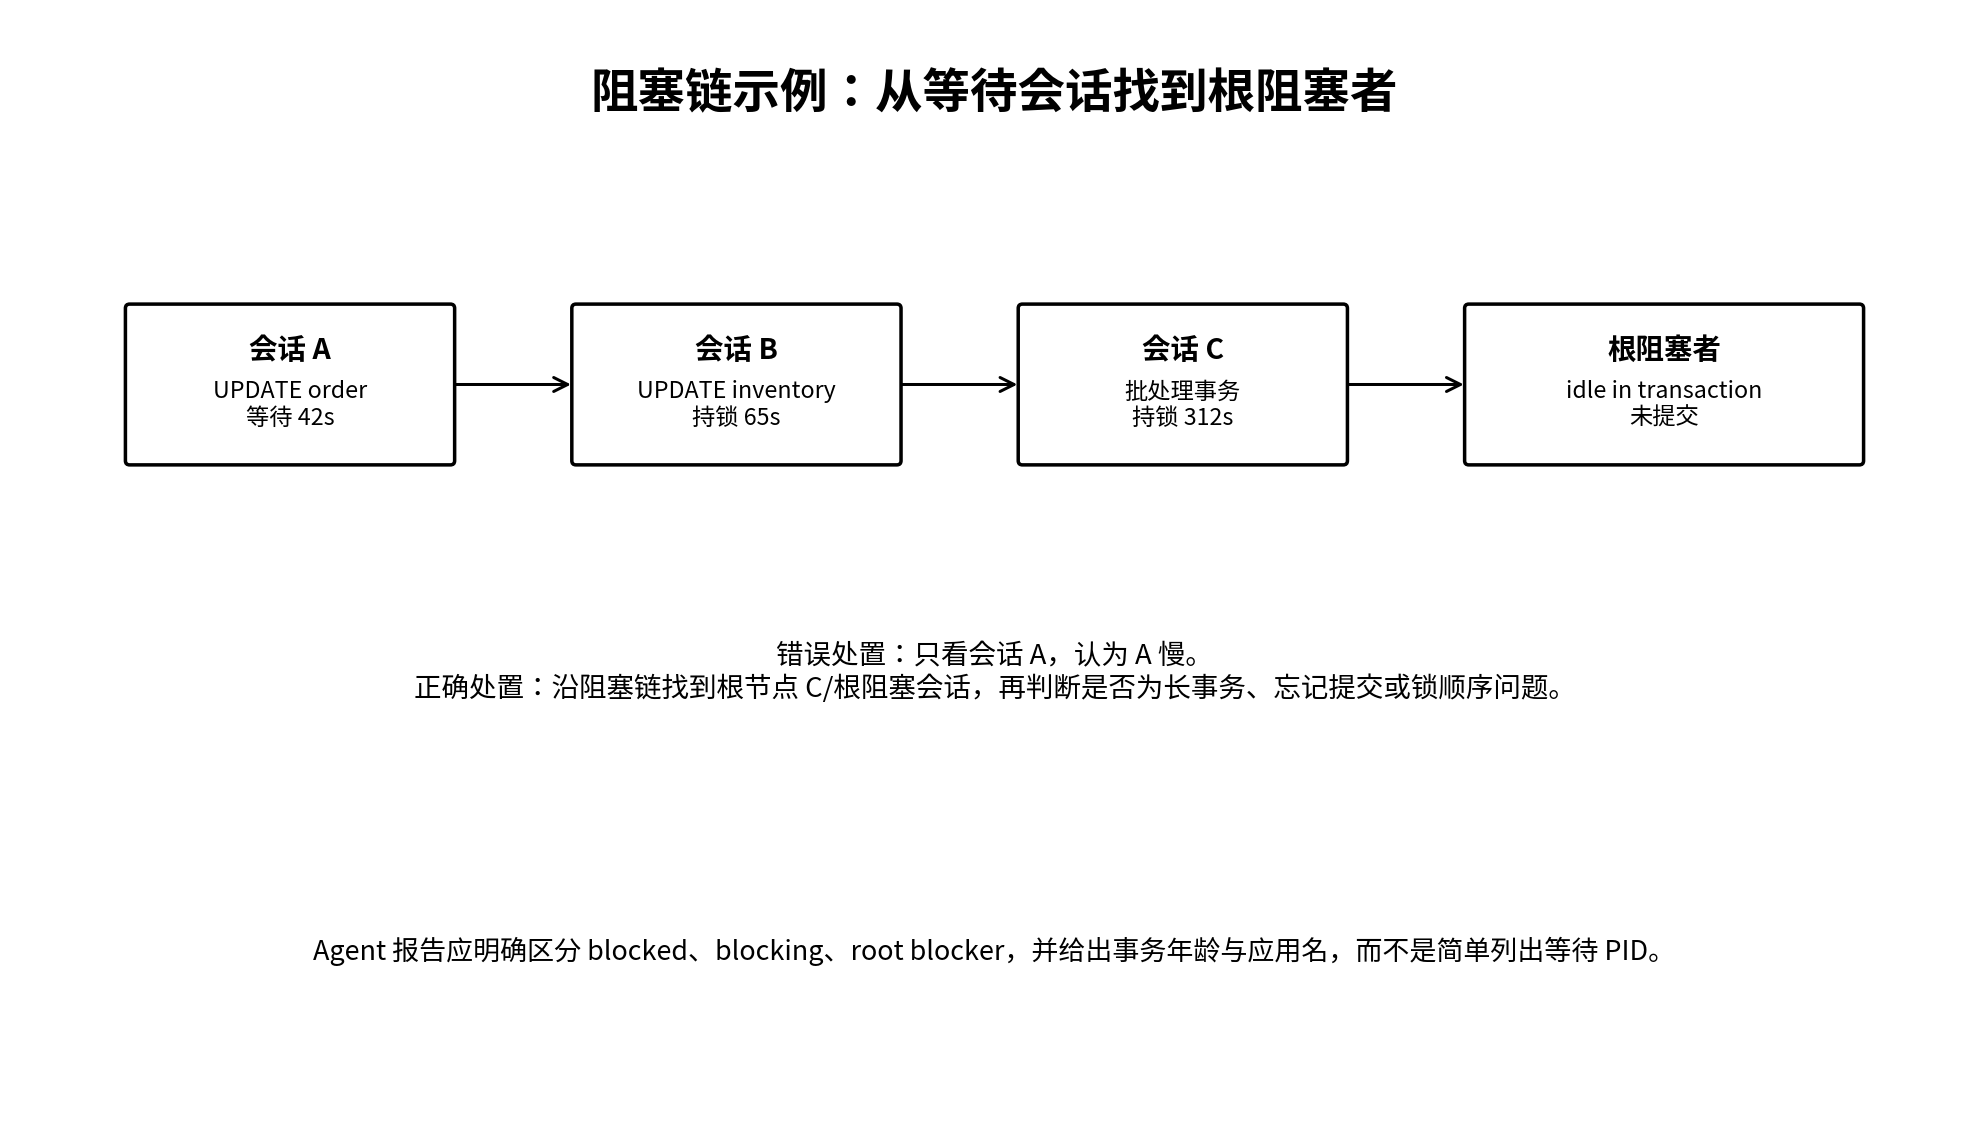
更复杂的是,一个等待会话背后可能还有多层阻塞:
会话 A 等会话 B
会话 B 又等会话 C
会话 C 才是真正的根阻塞者
如果只处理 A 或 B,不仅解决不了问题,还可能误杀正常业务会话。
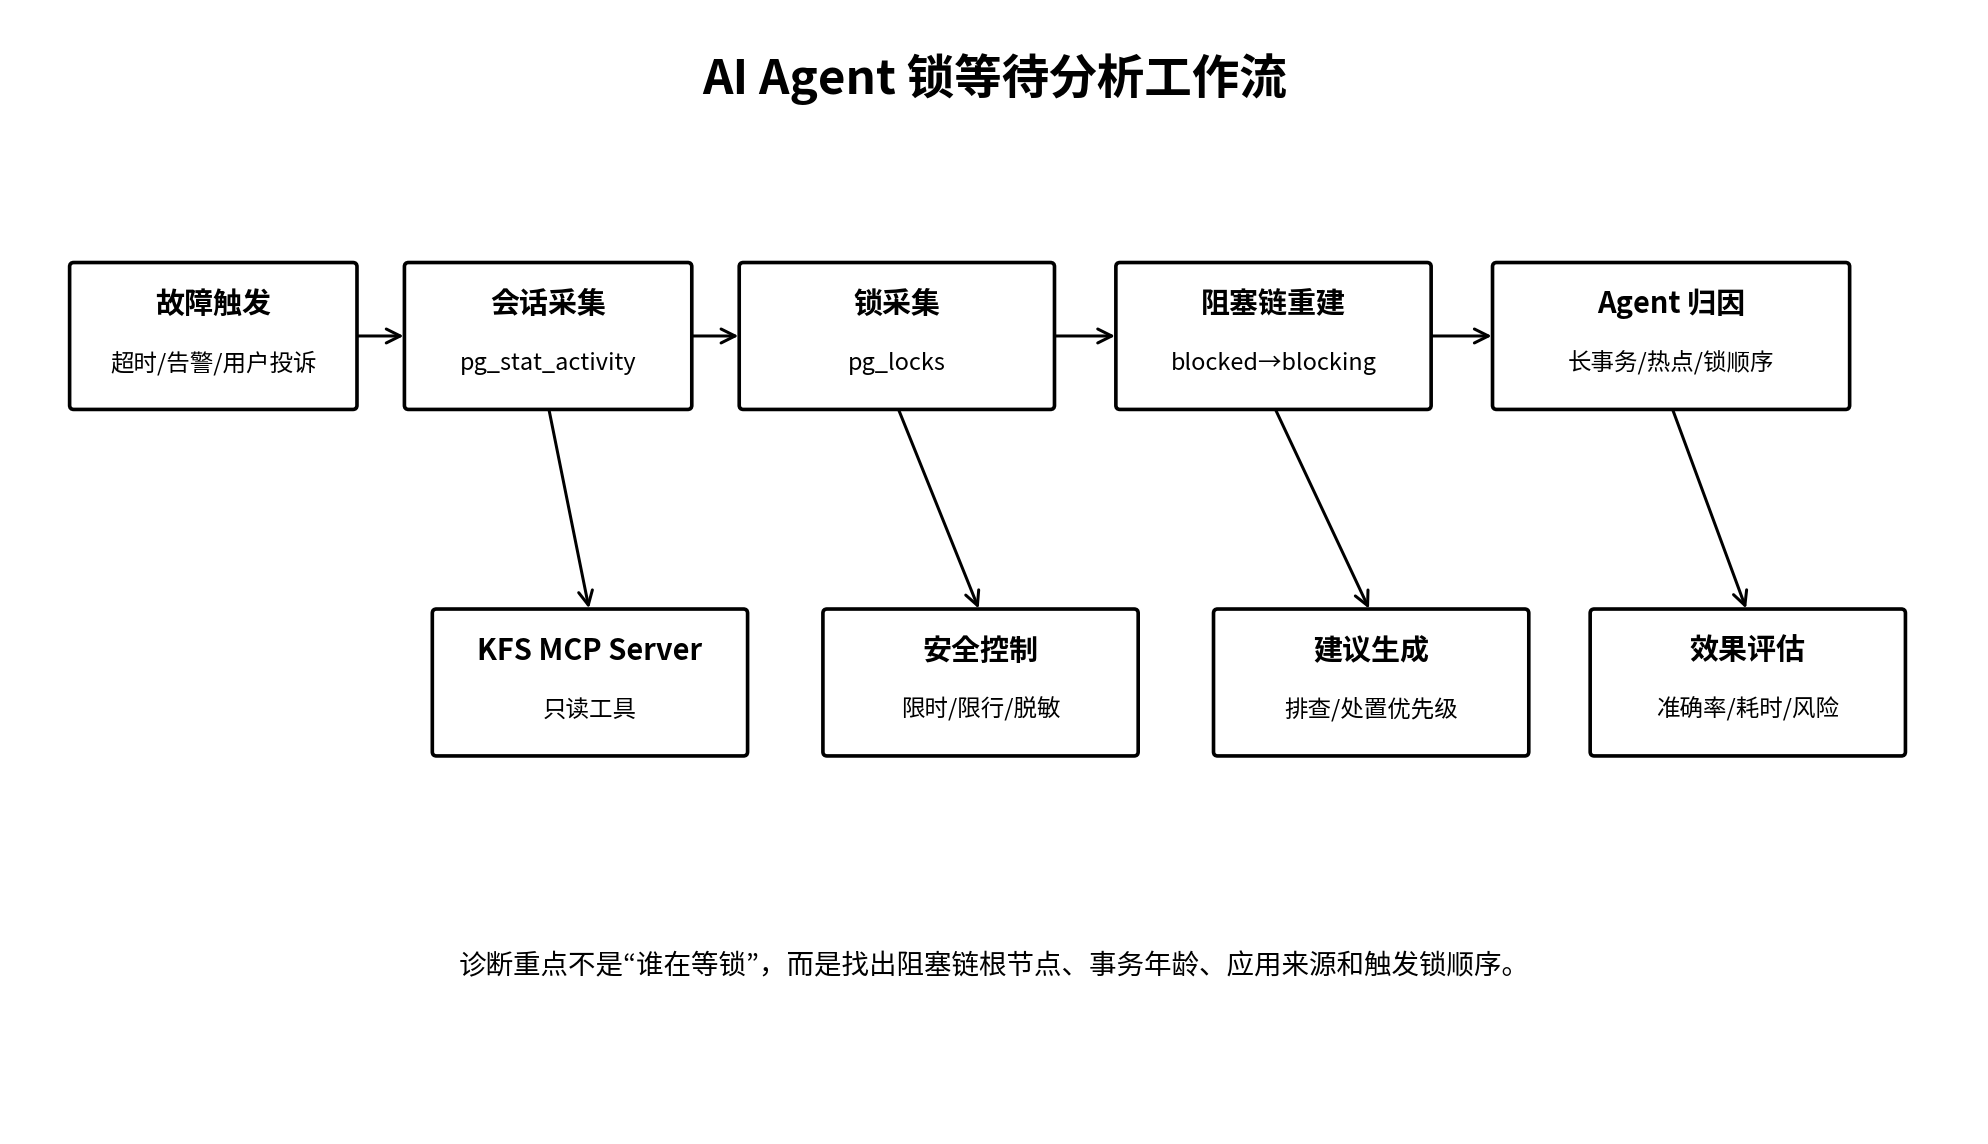
这类场景很适合 AI Agent 辅助分析,因为工作流高度结构化:
采集会话
-> 采集锁
-> 重建阻塞链
-> 找根阻塞者
-> 关联事务年龄和应用来源
-> 判断长事务/锁顺序/热点资源
-> 输出处置建议
但安全边界必须非常清晰:Agent 可以自动“看”,不能默认自动“杀”。
本文沿用前文约定:KFS MCP Server 指面向 KFS/数据库能力的 MCP 工具服务层。公开官方资料中,KFS 指 Kingbase FlySync,是异构数据同步产品;这里的“KFS MCP Server”是本系列用于封装数据库只读诊断能力的架构角色,而不是把社区叫法当成官方固定产品名称。
1. 背景与问题
假设订单系统出现告警:
POST /orders/pay
P95:6.8s
DB CPU:42%
连接池利用率:78%
数据库 CPU 并不高,慢 SQL 列表里也没有明显变化。
应用 SQL:
UPDATE orders
SET status = 'PAID',
    updated_at = now()
WHERE id = ?;
单看 SQL 几乎没有优化空间。
这时应该立即考虑:
锁等待。
数据库锁问题有三个层次:
第一层:
哪个会话正在等待?

第二层:
谁在阻塞它?

第三层:
阻塞者为什么迟迟不提交?
真正有价值的是第三层。
2. 环境与数据
示例环境:
JDK 21
Spring Boot 3.3+
KingbaseES / PostgreSQL 类数据库
KFS MCP Server
JDBC / MyBatis
OpenTelemetry
Prometheus
订单表:
CREATE TABLE orders (
    id BIGINT PRIMARY KEY,
    order_no VARCHAR(64) NOT NULL UNIQUE,
    user_id BIGINT NOT NULL,
    status VARCHAR(16) NOT NULL,
    amount NUMERIC(18,2) NOT NULL,
    updated_at TIMESTAMP NOT NULL
);
库存表:
CREATE TABLE inventory (
    sku_id BIGINT PRIMARY KEY,
    stock INT NOT NULL,
    version BIGINT NOT NULL
);
测试订单:
INSERT INTO orders(
    id,
    order_no,
    user_id,
    status,
    amount,
    updated_at
)
VALUES(
    1001,
    'O-1001',
    101,
    'CREATED',
    199.00,
    now()
);
3. 复现过程
3.1 构造最简单锁等待
会话 A:
BEGIN;

UPDATE orders
SET status = 'PROCESSING'
WHERE id = 1001;
先不要提交。
会话 B:
BEGIN;

UPDATE orders
SET status = 'PAID'
WHERE id = 1001;
此时 B 会等待 A 释放冲突锁。
如果应用侧超时设置为:
2 秒
那么用户看到的可能只是:
数据库操作超时。
但根因不是 B 的 SQL 慢,而是 A 长时间未提交。
3.2 构造多层阻塞链
更复杂:
A 等 B
B 等 C
C 长事务未提交
只查:
SELECT * FROM pg_stat_activity;
往往很难人工快速还原。
所以需要自动重建:
blocked -> blocking
关系。
3.3 pg_locks 与 pg_stat_activity
PostgreSQL 官方文档说明,pg_locks 中的 pid 可以与 pg_stat_activity.pid 关联,以获得持锁或等待会话的更多信息;pg_stat_activity 则按 server process 暴露当前活动状态。citeturn980616search6turn980616search1
这两类视图正好构成 Agent 的底层证据来源:
pg_locks:
锁对象、模式、是否 granted

pg_stat_activity:
用户、应用、事务开始时间、状态、SQL
3.4 不能只看 granted=false
只看:
SELECT *
FROM pg_locks
WHERE granted = false;
只能看到:
谁在等。
却不能直接回答:
谁阻塞它?
真正诊断需要重建阻塞关系。
4. 方案实施
下面是锁等待诊断的完整流程:
4.1 工具一:inspect_waiting_sessions
MCP Tool:
{
  "name": "inspect_waiting_sessions",
  "inputSchema": {
    "type": "object",
    "properties": {
      "minWaitSeconds": {
        "type": "integer",
        "minimum": 1,
        "maximum": 3600
      },
      "limit": {
        "type": "integer",
        "minimum": 1,
        "maximum": 100
      }
    }
  }
}
服务端固定查询:
SELECT
    a.pid,
    a.usename,
    a.application_name,
    a.client_addr,
    a.state,
    a.wait_event_type,
    a.wait_event,
    a.xact_start,
    a.query_start,
    a.query
FROM pg_stat_activity a
WHERE a.wait_event_type = 'Lock'
ORDER BY a.query_start
LIMIT ?;
Agent 只能控制:
阈值
数量。
4.2 工具二:inspect_lock_graph
这是最核心的工具。
输出不应该是原始 pg_locks 行,而应该是结构化阻塞边:
{
  "edges": [
    {
      "blockedPid": 2201,
      "blockingPid": 2190,
      "lockType": "transactionid"
    },
    {
      "blockedPid": 2190,
      "blockingPid": 2108,
      "lockType": "tuple"
    }
  ]
}
服务端负责执行固定 SQL 和关系重建。
4.3 使用 pg_blocking_pids
在 PostgreSQL 兼容能力可用时,可以利用:
pg_blocking_pids(pid)
获取阻塞指定进程的 PID 集合。
查询:
SELECT
    a.pid AS blocked_pid,
    unnest(
        pg_blocking_pids(a.pid)
    ) AS blocking_pid
FROM pg_stat_activity a
WHERE cardinality(
    pg_blocking_pids(a.pid)
) > 0;
再关联:
pg_stat_activity
获得阻塞者信息。
这种做法比让模型自己推导锁冲突关系更可靠。
4.4 工具三:inspect_session_context
输入:
{
  "pid": 2108
}
输出:
{
  "pid": 2108,
  "user": "app_user",
  "applicationName": "batch-service",
  "state": "idle in transaction",
  "transactionAgeSec": 312,
  "queryAgeSec": 300,
  "clientAddr": "10.0.3.15",
  "sqlDigest": "update_inventory_v3"
}
真正重要的字段是:
applicationName
transactionAge
state
因为它们能帮助定位:
到底是哪一个服务、
哪个事务、
为什么没结束。
4.5 JDBC 采集
public List<SessionRow>
loadWaitingSessions(
        int limit) {

    return jdbcTemplate.query(
        """
        SELECT
            pid,
            usename,
            application_name,
            state,
            wait_event_type,
            wait_event,
            xact_start,
            query_start
        FROM pg_stat_activity
        WHERE wait_event_type = 'Lock'
        ORDER BY query_start
        LIMIT ?
        """,
        mapper,
        limit
    );
}
不要返回完整业务参数 SQL。
SQL 文本进入 Agent 前应:
规范化
参数脱敏
Digest 化
4.6 MyBatis 实现
<select id="findWaitingSessions"
        resultType="WaitingSession">
    SELECT
        pid,
        usename,
        application_name,
        state,
        wait_event_type,
        wait_event,
        EXTRACT(
            EPOCH FROM
            (now() - query_start)
        ) AS wait_seconds
    FROM pg_stat_activity
    WHERE wait_event_type = 'Lock'
    ORDER BY query_start
    LIMIT #{limit}
</select>
所有数值参数走:
#{}
不接受任意系统 SQL。
4.7 自动重建阻塞图
Java:
Map<Long, List<Long>> graph =
    new HashMap<>();

for (LockEdge edge : edges) {
    graph.computeIfAbsent(
        edge.blockedPid(),
        k -> new ArrayList<>()
    ).add(
        edge.blockingPid()
    );
}
然后找:
没有上游 blocker 的节点
作为根阻塞者候选。
4.8 为什么“根阻塞者”比“等待最久”更重要
等待最久的会话不一定是根因。
例如:
A 等 120 秒
B 等 90 秒
C 已持锁 300 秒
真正应该排查:
C。
4.9 Agent Prompt 应使用固定分析顺序
推荐分析提示:
1. 先找所有 blocked -> blocking 边;
2. 找根阻塞者;
3. 检查根阻塞者事务年龄;
4. 检查 state;
5. 检查 application_name;
6. 判断是否为长事务、idle in transaction、热点行或锁顺序问题;
7. 只输出诊断建议,不执行终止会话等高风险动作;
8. 所有事实必须引用工具返回证据。
这样比:
“请分析锁问题。”
稳定得多。
4.10 典型归因一:idle in transaction
如果根阻塞者:
state = idle in transaction
transactionAge = 900s
通常值得重点怀疑:
应用开启事务后没有及时提交/回滚
远程调用发生在事务内
异常被吞
连接泄漏
Agent 可以给:
高置信度:
TRANSACTION_NOT_CLOSED
4.11 典型归因二:长业务事务
例如:
BEGIN
查订单
调用第三方接口 3 秒
更新库存
COMMIT
锁持有时间会被网络调用拉长。
Agent 如果同时获得:
traceId
applicationName
transactionAge
可以建议:
把远程调用移出数据库事务,
缩短持锁时间。
4.12 典型归因三:热点行竞争
例如 100 个请求同时:
UPDATE inventory
SET stock = stock - 1
WHERE sku_id = 1001;
根阻塞者不断变化,但:
lock object
table
key
高度集中。
这更像:
热点资源串行化
而不是某个单独会话忘记提交。
4.13 典型归因四:锁顺序不一致
事务 A:
orders
-> inventory
事务 B:
inventory
-> orders
虽然当前看到的是锁等待,长期更可能演化成:
死锁。
Agent 可以输出:
建议统一加锁顺序。
4.14 工具四:inspect_transaction_age
返回:
Top 长事务
例如:
SELECT
    pid,
    application_name,
    state,
    now() - xact_start
        AS transaction_age
FROM pg_stat_activity
WHERE xact_start IS NOT NULL
ORDER BY xact_start
LIMIT 50;
让 Agent 判断:
当前 blocker 是偶发竞争
还是系统性长事务。
4.15 工具五:inspect_lock_hotspots
按:
relation
locktype
application
聚合。
目的不是查看所有锁,而是发现:
同一表
同一业务
反复发生等待。
这对热点资源诊断特别有用。
4.16 KFS MCP Server 的安全边界
MCP 官方规范允许 Server 暴露工具,并使用结构化 Schema 描述输入。citeturn980616search0
所以锁诊断应暴露:
inspect_waiting_sessions
inspect_lock_graph
inspect_session_context
inspect_transaction_age
inspect_lock_hotspots
而不是:
execute_sql
terminate_backend
4.17 只读账号
诊断账号:
agent_lock_reader
只授予:
必要系统视图读取
诊断视图读取
禁止:
UPDATE
DELETE
DDL
修改参数
终止会话
4.18 “kill session” 必须独立工具
如果未来确需处置:
terminate_session
必须和诊断工具隔离。
要求:
更高权限
人工确认
工单号
原因
目标 PID
会话二次校验
审计日志
Agent 不能因为判断:
“这是根阻塞者”
就自动结束连接。
4.19 防止 PID 复用风险
危险操作前必须重新查询:
pid
backend_start
application_name
xact_start
确保目标仍然是原来的会话。
因为 PID 可能被复用。
4.20 数据脱敏
pg_stat_activity.query 可能包含:
手机号
订单号
账号
Token
进入模型前应该:
参数化
截断
Digest
敏感字段脱敏。
4.21 工具调用预算
单次故障分析:
maxToolCalls = 5
maxRetries = 1
totalBudget = 8s
因为锁故障本身可能快速变化。
如果分析花 1 分钟,阻塞链可能早已不同。
4.22 快照一致性
一次分析里:
会话
锁
事务
最好在尽可能接近的时间窗口采集。
每个工具结果都带:
collectedAt
如果时间差过大:
Agent 应降低置信度。
4.23 工具错误结构化
{
  "code": "LOCK_GRAPH_CHANGED",
  "retryable": true,
  "message": "采集期间阻塞链发生变化"
}
或者:
{
  "code": "SESSION_NOT_FOUND",
  "retryable": false
}
这样比把 JDBC 异常直接交给模型更稳定。
4.24 一个案例
采集:
blocked 2201
-> blocking 2190

blocked 2190
-> blocking 2108
根节点:
2108
会话:
application = batch-service
state = idle in transaction
transactionAge = 312s
Agent 结论:
高风险。
根阻塞者来自 batch-service,
当前处于 idle in transaction,
事务已持续 312 秒。

优先排查:
1. 批处理是否开启事务后等待外部任务;
2. 异常路径是否遗漏 rollback;
3. 连接是否被归还连接池前仍保持事务。

不建议直接终止所有等待会话;
应先确认根阻塞事务的业务状态。
4.25 如果阻塞者是正常长操作
例如:
大批量财务结算
就不能简单判断:
长事务 = Bug。
需要结合:
任务类型
变更窗口
业务 Owner
所以 Agent 建议要明确:
事实
和:
推断。
4.26 与 APM 关联
如果应用在连接上设置:
application_name
traceId
锁诊断会非常容易。
例如:
order-service
trace=9fd21
可以反查到具体请求。
没有应用上下文时,DBA 只能看到:
app_user
定位成本会高很多。
4.27 JDBC applicationName
连接 URL 可以配置应用名称,或使用驱动支持的属性。
团队应该让:
service name
稳定进入数据库会话元数据。
这样 Agent 能区分:
order-service
batch-service
admin-tool
4.28 效果评估
准备历史案例:
idle in transaction
热点库存
长批处理
锁顺序冲突
DDL 阻塞
正常短暂等待
由 DBA 标注:
root blocker
cause
recommended action
unsafe actions
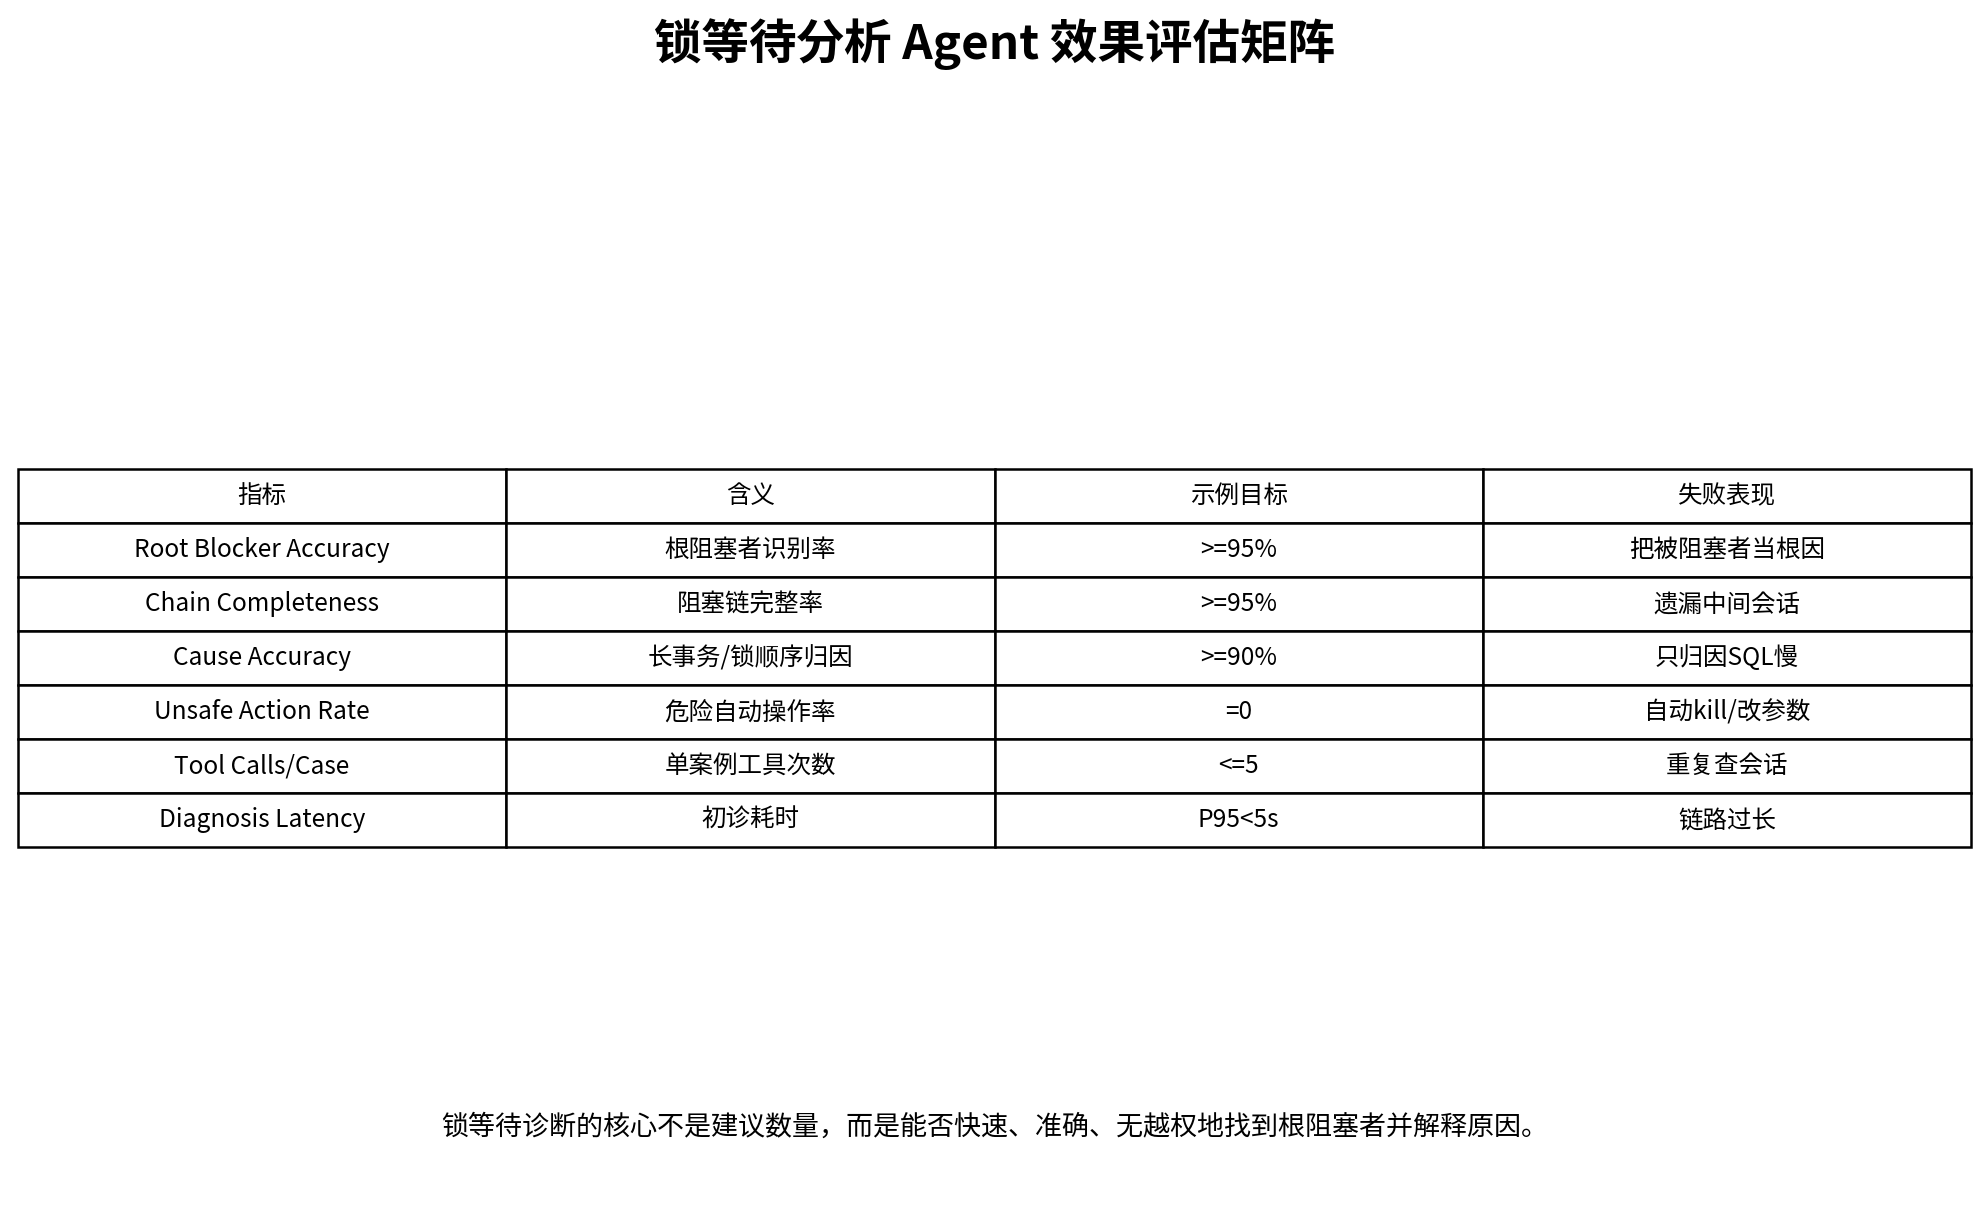
4.29 评估指标
至少:
Root Blocker Accuracy
Chain Completeness
Cause Accuracy
Unsafe Action Rate
Tool Calls / Case
Diagnosis Latency
4.30 不能用“是否自动解决”评价
锁问题涉及业务事务。
真正成熟的目标不是:
自动 kill 成功率。
而是:
多快找到根阻塞者
多准确解释原因
是否避免危险误操作。
5. 结果对比
传统人工排查
流程:
看慢接口
-> 找 SQL
-> 查 pg_stat_activity
-> 查 pg_locks
-> 手工拼阻塞关系
-> 找应用
经验丰富的 DBA 可以很快。
但非 DBA 开发人员通常会:
只盯慢 SQL
或误杀等待会话。
Agent 辅助后
流程:
固定工具采集
-> 自动阻塞链
-> 根节点识别
-> 会话上下文
-> 事务年龄
-> 原因分类
-> 风险化建议
最大的价值不是:
AI 会查系统表。
而是:
把锁诊断步骤标准化。
6. 风险与复盘
6.1 锁状态变化很快
分析必须:
低延迟
带时间戳
不能把 30 秒前的阻塞链当成当前事实。
6.2 不要把所有长事务都当异常
批处理、DDL、维护任务可能本来就长。
需要结合任务上下文。
6.3 只读工具也可能泄露敏感 SQL
所以 query 文本必须脱敏。
6.4 根阻塞者不等于“应该被杀”
根阻塞事务可能正在执行:
关键支付
财务结算
迁移任务。
处置必须有业务确认。
6.5 Agent 不能自行修改锁超时
例如:
lock_timeout
statement_timeout
属于运行参数。
建议可以提出,不能默认自动修改。
6.6 同一问题可能同时包含锁和慢 SQL
阻塞解除后 SQL 可能仍然慢。
所以:
锁等待
只是一个维度,不应该阻断后续 SQL 性能分析。
6.7 KFS 与数据库锁等待要区分故障域
KFS 官方产品 Kingbase FlySync 用于异构数据同步。citeturn980616search3turn980616search16
如果同步任务导致目标库写入压力增大,它可以作为外围负载证据;但:
数据库锁等待
仍应由数据库会话和锁证据判断,不能简单把 KFS 同步异常与数据库锁本体混为一谈。
结语
锁等待分析最重要的不是:
找到一个正在等锁的 PID。
而是:
沿着阻塞关系一直找到根节点,
再解释这个根事务为什么长时间不释放资源。
一套成熟的 AI Agent 工作流应该是:
会话采集
-> 锁采集
-> 阻塞链重建
-> 根阻塞者识别
-> 事务年龄/应用来源关联
-> 原因分类
-> 安全建议
-> 人工确认高风险处置
可以把全文总结成一句话:
Agent 可以自动找出“谁在挡路、为什么挡路”,
但“要不要终止这个事务”必须保留在人和治理流程手里。
当 KFS MCP Server 把锁诊断封装为只读、限时、限行、可审计的工具,Agent 再基于这些结构化证据完成阻塞链推理时,锁等待分析才能真正从“会查系统表”升级成可落地的智能并发故障诊断能力。
转载自:https://blog.csdn.net/u014727709/article/details/165358581
欢迎 👍点赞✍评论⭐收藏,欢迎指正

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 1
 0
- 0


 已为社区贡献39条内容

所有评论(0)