AI Agent辅助慢SQL诊断的工作流——KFS MCP Server、工具调用链与性能运维案例
文章目录
- 每日一句正能量
- 前言
- 1. 背景与问题
- 2. 环境与数据
- 3. 复现过程
- 4. 方案实施
- 4.1 工具一:find_slow_statements
- 4.2 工具二:get_query_plan
- 4.3 为什么参数样本必须分层
- 4.4 工具三:get_table_statistics
- 4.5 工具四:get_index_inventory
- 4.6 工具五:get_lock_context
- 4.7 工具六:get_io_context
- 4.8 Agent 的证据表
- 4.9 组合索引建议
- 4.10 为什么不能看到 Seq Scan 就一定建索引
- 4.11 统计信息问题
- 4.12 MyBatis 诊断入口
- 4.13 JDBC 参数不能被 Agent 直接注入 SQL 字符串
- 4.14 ORM 场景要看到真实 SQL
- 4.15 安全边界一:默认只读
- 4.16 安全边界二:EXPLAIN ANALYZE 默认关闭
- 4.17 安全边界三:SQL 文本脱敏
- 4.18 安全边界四:Tool Call 预算
- 4.19 工具错误结构化
- 4.20 归因分类
- 4.21 一个具体案例
- 4.22 为什么建议“先统计,后索引验证”
- 4.23 索引建议必须带副作用
- 4.24 回归验证
- 4.25 对照实验
- 4.26 诊断报告模板
- 4.27 Agent 必须给置信度
- 4.28 诊断评估
- 4.29 评估指标
- 4.30 不能用“生成建议数量”衡量 Agent
- 5. 结果对比
- 6. 风险与复盘
- 结语
每日一句正能量
🌌 谦卑:山顶与星空的永恒对话
“成就再高也要保持谦卑,因为总有更广阔的天地和更高的追求。”
任何成就,在更大的坐标系中可能只是起点。知识如圆,圆越大,接触的未知外围就越广。谦卑不是自我矮化,而是为未来的成长预留心理空间。骄傲让人封闭,谦卑让人保持开放与渴望,这是持续进化的内在动力。
前言
慢 SQL 诊断看起来很适合交给 AI Agent:找到慢 SQL、看执行计划、给索引建议,似乎几步就能完成。
真正做成在线能力以后,问题会复杂很多。
一条 SQL 变慢,原因可能来自:
索引缺失
索引选择错误
统计信息失真
参数分布倾斜
大范围回表
排序或哈希溢出
锁等待
长事务阻塞
连接池排队
缓存命中变化
数据量增长
SQL 改写
执行计划漂移
如果 Agent 只拿到 SQL 文本,就很容易给出一种“看起来合理但实际上错误”的建议,比如:
“建议增加索引。”
而真实问题可能是:
索引已经存在,
只是统计信息严重失真;
或者 SQL 本身并不慢,
真正耗时发生在锁等待。
因此,AI Agent 做慢 SQL 诊断时不能从“建议”开始,而要从“证据”开始。
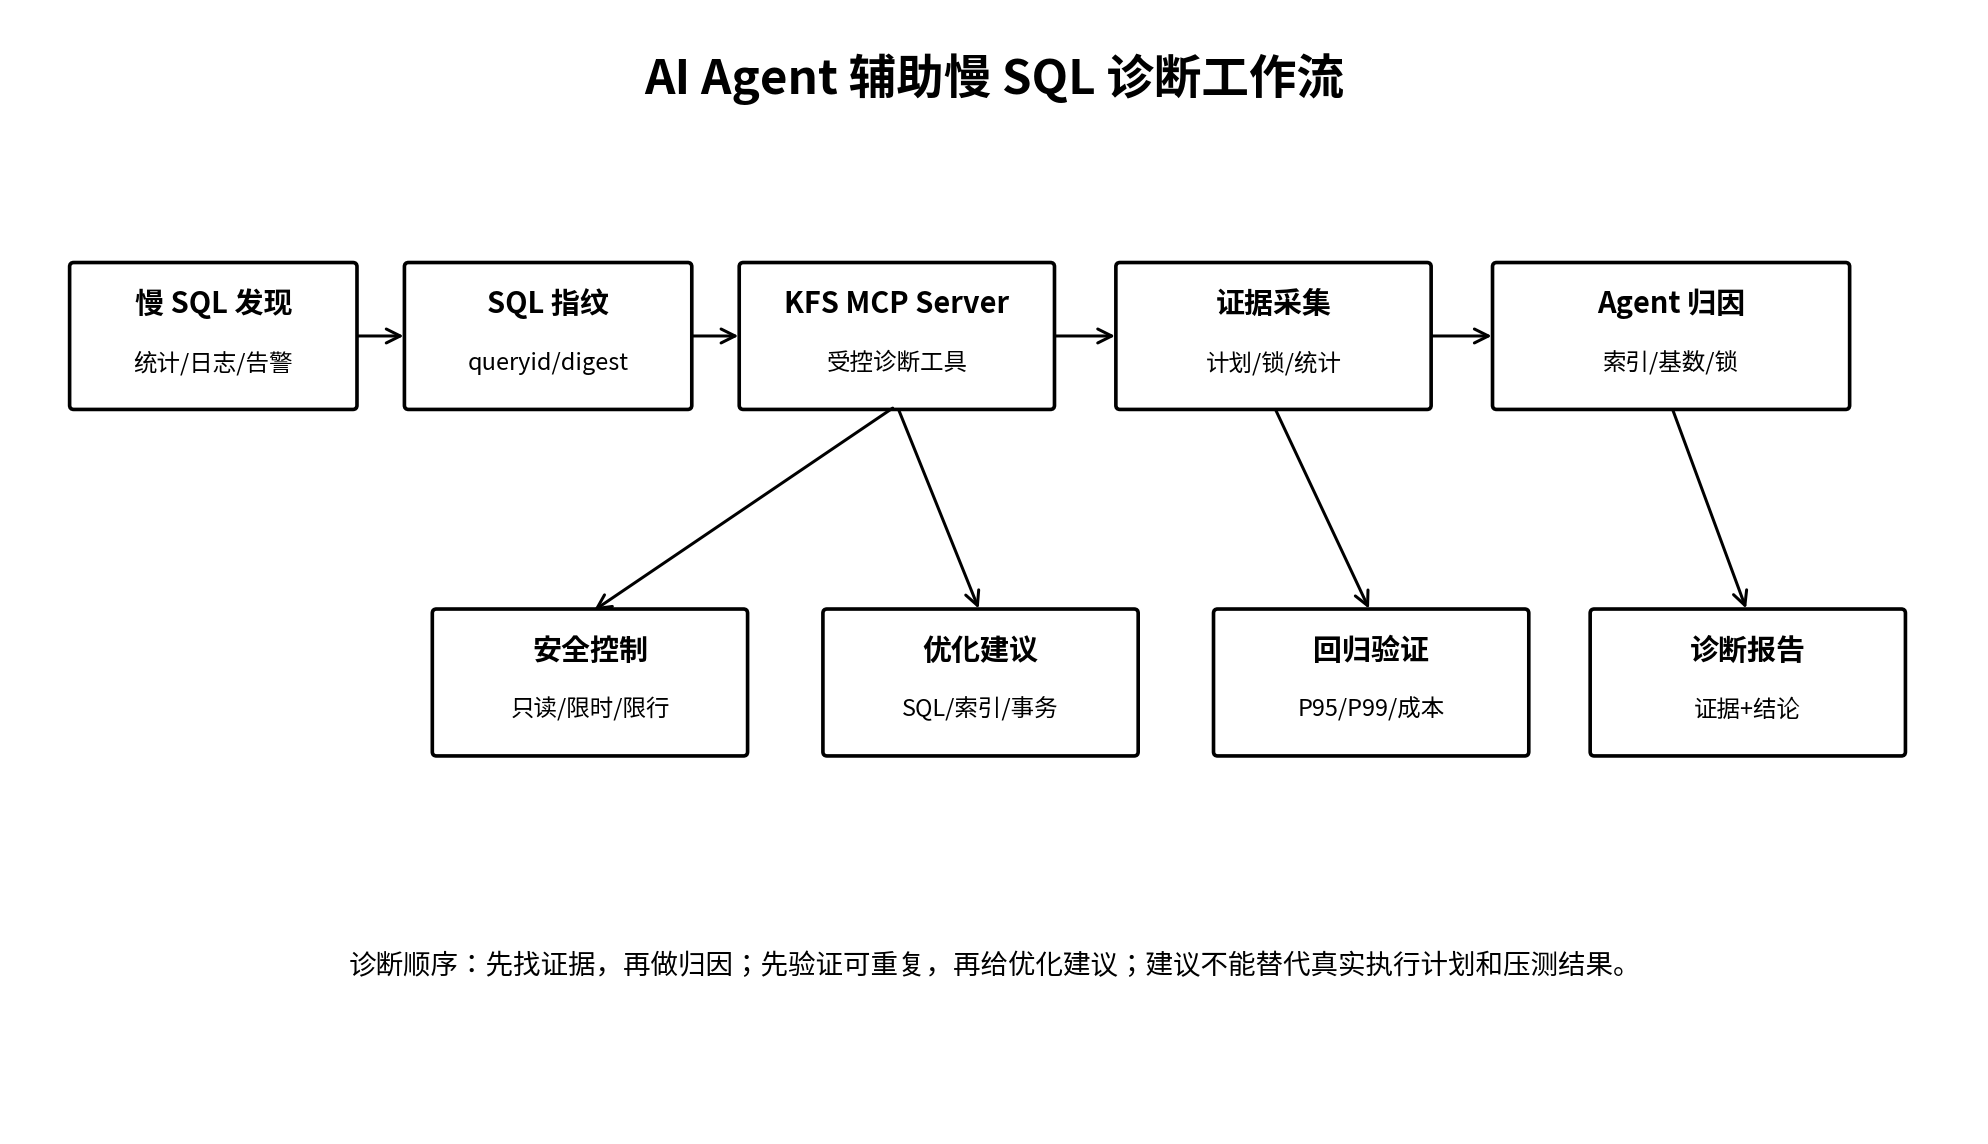
本文设计一条完整工作流:
发现慢 SQL
-> 识别 SQL 指纹
-> KFS MCP Server 调用受控诊断工具
-> 采集执行计划、统计信息、锁和表结构
-> Agent 做多证据归因
-> 输出优化建议
-> 回归压测
-> 生成诊断报告
这里继续采用前文约定:KFS MCP Server 指面向 KFS/数据库能力的 MCP 工具服务层。公开资料中,KFS 官方产品 Kingbase FlySync 是异构数据同步产品;MCP 官方规范明确支持 Server 暴露可被模型调用、具有输入 Schema 的工具。慢 SQL 诊断真正利用的是“受控工具层”这个架构思想,而不是把 Agent 直接变成 DBA 超级账号。
1. 背景与问题
假设订单查询接口最近 P95 从:
180ms
上升到:
1.2s
应用日志中的 SQL:
SELECT
    id,
    order_no,
    user_id,
    status,
    created_at
FROM orders
WHERE user_id = ?
  AND status = ?
  AND created_at >= ?
ORDER BY created_at DESC
LIMIT 50;
传统排查可能直接执行:
EXPLAIN ...
然后观察是否走索引。
但对于 Agent 来说,仅有执行计划仍不够。
它还应该知道:
这条 SQL 调用了多少次?
总耗时是多少?
慢是平均慢还是少数长尾?
有没有锁等待?
真实参数分布是什么?
表数据量增长了多少?
统计信息最近是否更新?
索引是否存在但没有被选择?
所以 Agent 的第一个任务不是:
“给优化建议。”
而是:
“构造完整诊断上下文。”
2. 环境与数据
示例环境:
JDK 21
Spring Boot 3.3+
KingbaseES / PostgreSQL 类数据库
KFS MCP Server
MyBatis / JDBC
pg_stat_statements 类统计能力
OpenTelemetry
Prometheus
订单表:
CREATE TABLE orders (
    id BIGINT PRIMARY KEY,
    order_no VARCHAR(64) NOT NULL UNIQUE,
    user_id BIGINT NOT NULL,
    status VARCHAR(16) NOT NULL,
    amount NUMERIC(18,2) NOT NULL,
    created_at TIMESTAMP NOT NULL
);
初始索引:
CREATE INDEX idx_orders_user
ON orders(user_id);

CREATE INDEX idx_orders_created
ON orders(created_at);
业务查询:
SELECT
    id,
    order_no,
    user_id,
    status,
    created_at
FROM orders
WHERE user_id = ?
  AND status = ?
  AND created_at >= ?
ORDER BY created_at DESC
LIMIT 50;
假设数据量已经增长到:
1200 万行
其中某些头部用户拥有:
20 万以上订单。
这正是参数分布导致执行计划差异的典型场景。
3. 复现过程
3.1 先从 SQL 统计找真正值得处理的语句
PostgreSQL 官方 pg_stat_statements 用于跟踪 SQL 的规划和执行统计,适合先回答:
到底哪些 SQL 消耗了最多数据库时间。
示例:
SELECT
    queryid,
    calls,
    total_exec_time,
    mean_exec_time,
    rows,
    query
FROM pg_stat_statements
ORDER BY total_exec_time DESC
LIMIT 20;
不要只按:
mean_exec_time
排序。
一条平均 300ms、每天执行 300 万次的 SQL,往往比一条平均 3 秒、每天只执行 10 次的 SQL 更值得优先处理。
3.2 SQL 指纹是 Agent 工作流的主键
不要直接使用完整 SQL 文本作为诊断主键。
建议记录:
queryid
SQL digest
normalized SQL
因为参数不同:
user_id=1001
user_id=900001
仍然应该属于同一个 SQL 模板。
诊断任务:
{
  "caseId": "slow-185-001",
  "queryId": "918273645",
  "sqlDigest": "orders_by_user_status_v1"
}
后续所有工具调用都关联这个 caseId。
3.3 错误做法:Agent 直接生成 EXPLAIN ANALYZE
如果给模型:
execute_sql(sql)
它可能自行执行:
EXPLAIN ANALYZE
UPDATE ...
或者对一个极重查询运行:
EXPLAIN ANALYZE
导致真实业务 SQL 被完整执行一次。
诊断工具必须把:
EXPLAIN
和:
EXPLAIN ANALYZE
区分开。
在线环境默认优先:
只读 EXPLAIN
需要实际执行的诊断必须有额外安全限制。
3.4 自动计划采集
PostgreSQL 官方 auto_explain 可以自动记录超过阈值语句的执行计划,这对难以手工复现的慢查询尤其有价值。
这意味着 Agent 不一定每次都要:
重新执行慢 SQL。
可以优先读取已经采集好的:
历史执行计划证据。
这是生产诊断中非常重要的一条安全原则:
能复用证据,就不要为了诊断再制造一次重查询。
4. 方案实施
4.1 工具一:find_slow_statements
MCP Tool:
{
  "name": "find_slow_statements",
  "inputSchema": {
    "type": "object",
    "properties": {
      "orderBy": {
        "type": "string",
        "enum": [
          "total_exec_time",
          "mean_exec_time",
          "calls"
        ]
      },
      "limit": {
        "type": "integer",
        "minimum": 1,
        "maximum": 30
      }
    }
  }
}
服务器内部使用固定 SQL。
模型只决定:
排序维度
结果数量。
4.2 工具二:get_query_plan
输入:
{
  "queryId": "918273645",
  "sampleProfile": "HEAD_USER"
}
服务端根据受控样例参数生成:
EXPLAIN (FORMAT JSON)
SELECT ...
不要让模型自由填 SQL。
输出只保留:
Plan Node
Relation
Index
Estimated Rows
Cost
Filter
Sort
4.3 为什么参数样本必须分层
SQL 对:
普通用户
可能很快。
对:
超大用户
可能很慢。
因此诊断样本至少分:
P50 用户
P95 用户
Top 用户
不要拿一个随机参数就下结论。
4.4 工具三:get_table_statistics
输出:
{
  "table": "orders",
  "estimatedRows": 12000000,
  "lastAnalyze": "...",
  "deadTupleRatio": 0.08,
  "columns": {
    "status": {
      "nDistinct": 5
    }
  }
}
Agent 可以判断:
统计信息是否可能过旧
基数估算是否异常
4.5 工具四:get_index_inventory
{
  "table": "orders",
  "indexes": [
    {
      "name": "idx_orders_user",
      "columns": ["user_id"]
    },
    {
      "name": "idx_orders_created",
      "columns": ["created_at"]
    }
  ]
}
这一步非常重要。
否则模型会反复建议:
“给 user_id 建索引。”
实际上索引早已存在。
4.6 工具五:get_lock_context
如果 SQL 当前正在执行:
是否有锁等待?
应该优先确认。
否则:
执行计划很漂亮
也不能解释 10 秒延迟。
返回:
{
  "waiting": false,
  "blockingPid": null,
  "transactionAgeSec": 0
}
这能排除锁因素。
4.7 工具六:get_io_context
如果数据库支持 I/O 统计视图,可补充:
buffer hit
read
write
temp
用于判断:
主要是 CPU
磁盘读取
还是临时文件。
4.8 Agent 的证据表
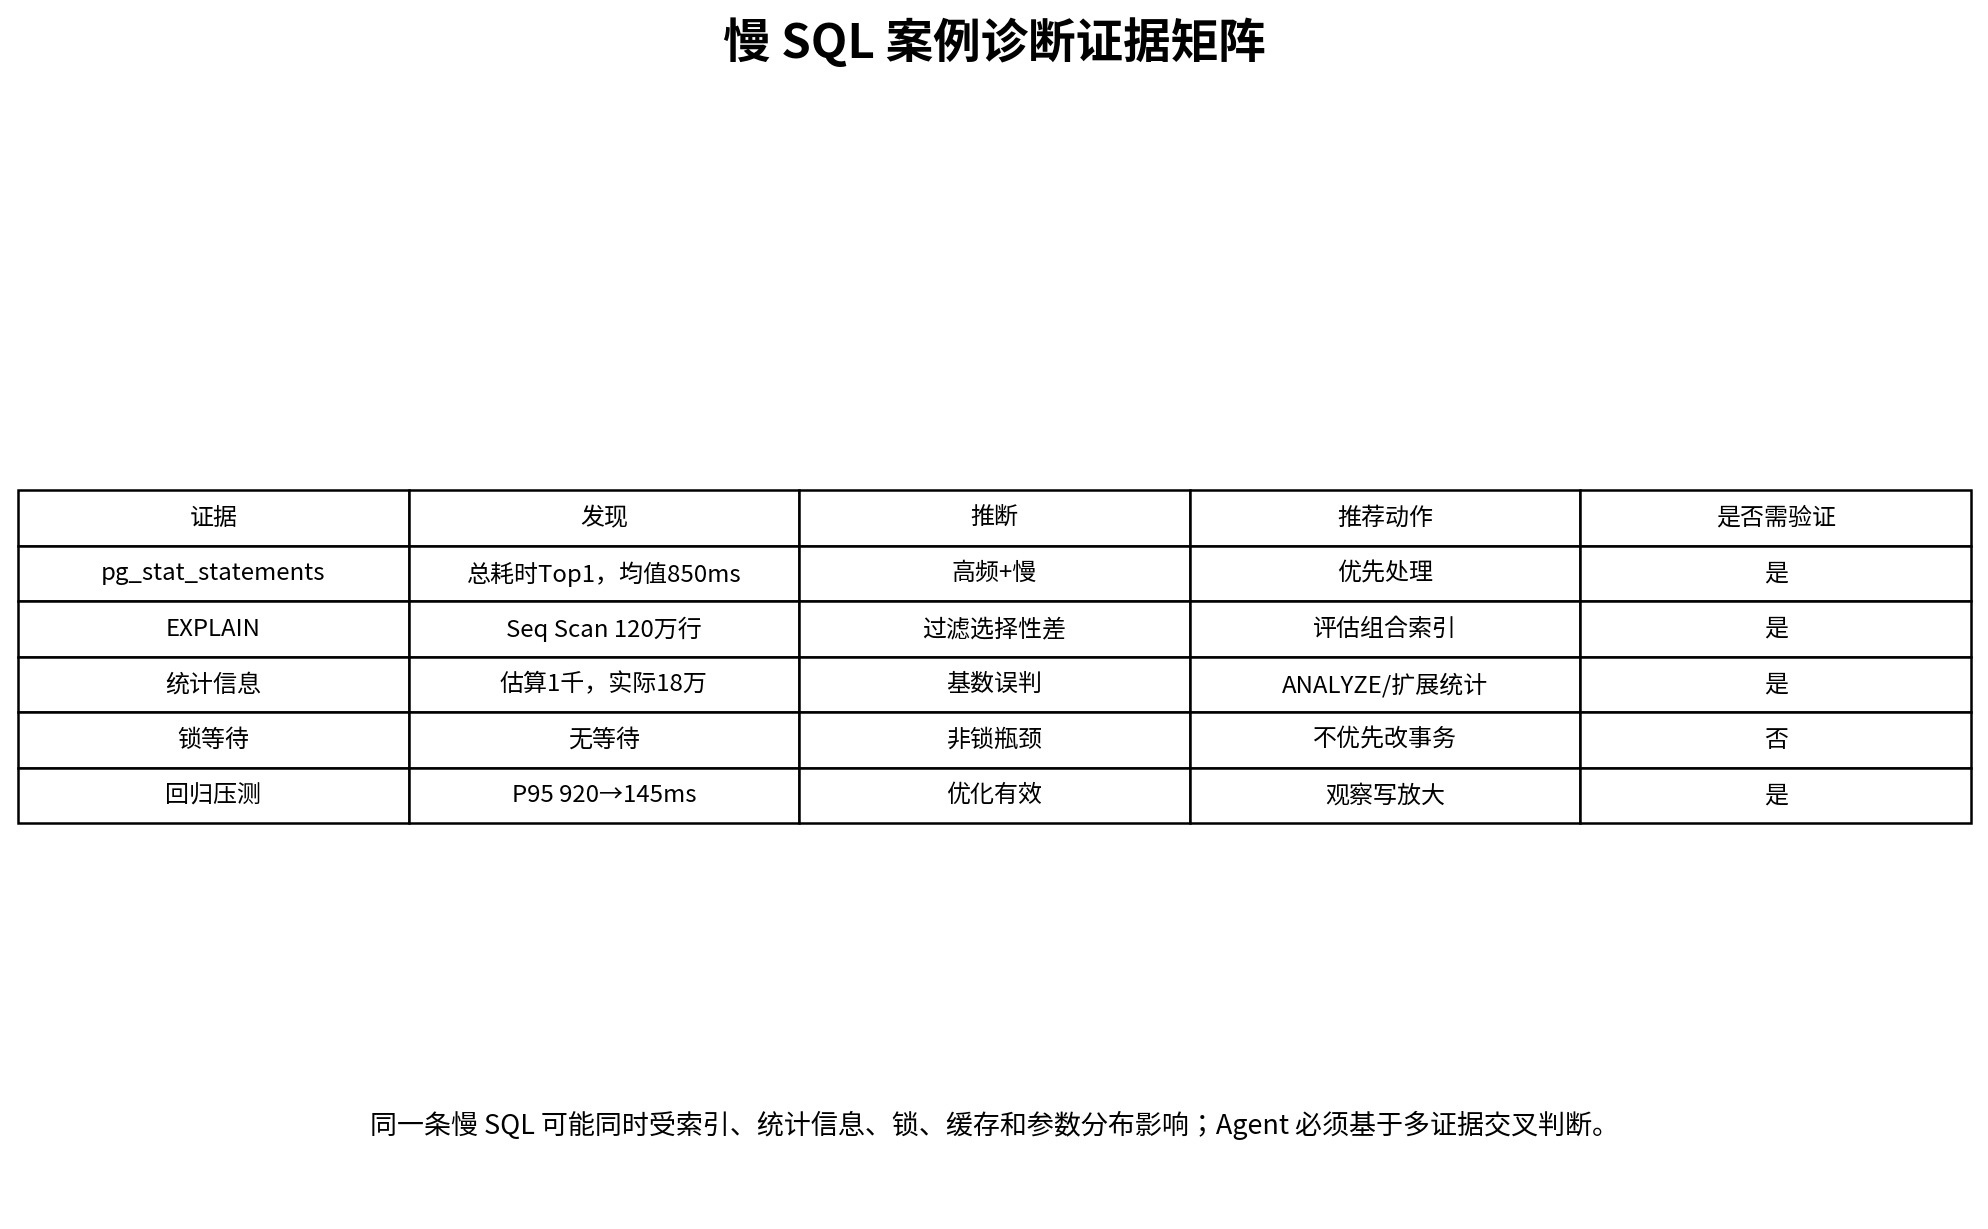
一次案例最终形成:
SQL统计:
总执行时间 Top1

执行计划:
Seq Scan orders

估算行数:
1000

实际典型结果:
180000

现有索引:
user_id
created_at

锁:
无

结论:
统计基数严重误判,
现有单列索引无法同时支撑过滤和排序。
这比直接说:
“建议建组合索引”
专业得多。
4.9 组合索引建议
根据查询:
WHERE user_id = ?
  AND status = ?
  AND created_at >= ?
ORDER BY created_at DESC
LIMIT 50
可以评估:
CREATE INDEX idx_orders_user_status_created
ON orders(
    user_id,
    status,
    created_at DESC
);
但 Agent 只能:
提出建议。
不能在生产自动执行。
4.10 为什么不能看到 Seq Scan 就一定建索引
如果:
查询返回 60% 全表数据
顺序扫描可能比随机索引读取更合理。
所以 Agent 必须同时看:
过滤选择性
返回行数
表大小
排序
LIMIT
4.11 统计信息问题
如果:
estimated rows = 1000
actual pattern ≈ 180000
说明优化器对分布认知可能严重偏差。
建议可以包括:
ANALYZE orders;
或者评估扩展统计信息。
但同样:
建议 ≠ 自动执行。
4.12 MyBatis 诊断入口
应用侧可以给 SQL 增加稳定标签:
<select id="findRecentOrders"
        resultType="OrderRow">
    /* sql_tag:orders_by_user_status_v1 */
    SELECT
        id,
        order_no,
        user_id,
        status,
        created_at
    FROM orders
    WHERE user_id = #{userId}
      AND status = #{status}
      AND created_at >= #{startTime}
    ORDER BY created_at DESC
    LIMIT #{limit}
</select>
日志和 APM 都能快速关联:
sql_tag
到 Agent 诊断 case。
4.13 JDBC 参数不能被 Agent 直接注入 SQL 字符串
诊断样例执行:
PreparedStatement ps =
    connection.prepareStatement(
        """
        EXPLAIN (FORMAT JSON)
        SELECT ...
        WHERE user_id = ?
          AND status = ?
          AND created_at >= ?
        """
    );

ps.setLong(1, userId);
ps.setString(2, status);
ps.setTimestamp(3, start);
所有参数仍然参数化。
4.14 ORM 场景要看到真实 SQL
JPA/Hibernate 的 JPQL:
findByUserIdAndStatus(...)
最终性能取决于真实生成 SQL。
Agent 的诊断对象应该是:
实际 SQL / queryId
而不是 Repository 方法名。
4.15 安全边界一:默认只读
KFS MCP Server 诊断账号:
agent_diagnoser
只授予:
统计视图读取
系统目录读取
EXPLAIN 所需读取权限
禁止:
CREATE INDEX
ANALYZE
VACUUM
KILL
UPDATE
DELETE
4.16 安全边界二:EXPLAIN ANALYZE 默认关闭
因为:
ANALYZE
会真实执行语句。
如果需要开启:
只允许 SELECT
强制 statement_timeout
限定测试库或只读副本
限制返回行
人工批准
4.17 安全边界三:SQL 文本脱敏
慢 SQL 统计可能带参数。
进入 Agent 前:
手机号
身份证
Token
订单号
都应该参数化或脱敏。
4.18 安全边界四:Tool Call 预算
一次诊断建议:
maxToolCalls = 6
maxPlanCalls = 2
maxRetryPerTool = 1
totalBudget = 15s
避免 Agent 无限:
查计划
查索引
再查计划
再查统计
4.19 工具错误结构化
{
  "code": "PLAN_NOT_AVAILABLE",
  "retryable": false,
  "message": "未找到可安全复现的样例参数"
}
或者:
{
  "code": "DIAG_QUERY_TIMEOUT",
  "retryable": true
}
模型不能看到完整数据库异常栈。
4.20 归因分类
可以把慢 SQL 原因标准化成:
INDEX_MISSING
INDEX_NOT_SELECTED
CARDINALITY_MISESTIMATION
LOCK_WAIT
LARGE_SORT
TEMP_SPILL
HIGH_CALL_VOLUME
DATA_SKEW
PLAN_REGRESSION
TRANSACTION_SCOPE
UNKNOWN
这样 Agent 输出更稳定,也便于统计。
4.21 一个具体案例
假设诊断结果:
calls = 182340
mean_exec_time = 850ms
total_exec_time = 155000s
执行计划:
Seq Scan
estimated rows = 1000
业务画像:
头部 user_id
真实相关订单约 18 万
现有索引:
user_id
created_at
锁:
无
Agent 可以输出:
主因:
1. 用户订单分布高度倾斜;
2. 单列索引无法很好支持 user_id + status + created_at 排序;
3. 行数估算明显偏低,可能导致计划选择不佳。

建议顺序:
P1:更新统计信息并复测计划;
P1:在测试环境评估(user_id,status,created_at DESC)组合索引;
P2:检查头部用户是否需要分页游标或冷热分层。
4.22 为什么建议“先统计,后索引验证”
如果统计信息过旧,直接建新索引可能:
增加写放大
增加存储
仍然不被选择。
所以诊断要区分:
低成本验证
和:
结构变更。
4.23 索引建议必须带副作用
任何索引建议都应附:
增加写成本
占用磁盘
维护成本
可能影响其他计划
不能只展示收益。
4.24 回归验证
优化后必须重新采集:
执行计划
P50
P95
P99
数据库 CPU
Buffer/IO
写入延迟
不能只看:
单次 EXPLAIN ANALYZE 变快。
4.25 对照实验
优化前:
P50 410ms
P95 920ms
P99 1.8s
优化后示例:
P50 62ms
P95 145ms
P99 330ms
同时:
订单写入 P95
由 12ms
变为 15ms
这说明索引带来了:
读性能收益
+
一定写放大。
这种完整对比才值得进入报告。
4.26 诊断报告模板
# 慢 SQL 诊断报告

## 1. SQL 概览
- QueryId
- SQL Digest
- 调用次数
- 总耗时
- P95

## 2. 证据
- 执行计划
- 统计信息
- 索引
- 锁
- 数据分布

## 3. 根因判断
- 主因
- 次因
- 置信度

## 4. 优化建议
- P0/P1/P2
- 风险
- 验证方法

## 5. 回归结果
- 优化前
- 优化后

## 6. 结论
4.27 Agent 必须给置信度
例如:
主因:
CARDINALITY_MISESTIMATION
置信度:0.84
如果证据不足:
UNKNOWN
比强行给结论更可靠。
4.28 诊断评估
建议构造历史案例集:
索引缺失
锁等待
统计失真
参数倾斜
排序溢出
高频小 SQL
执行计划回退
每个案例有 DBA 标准答案。
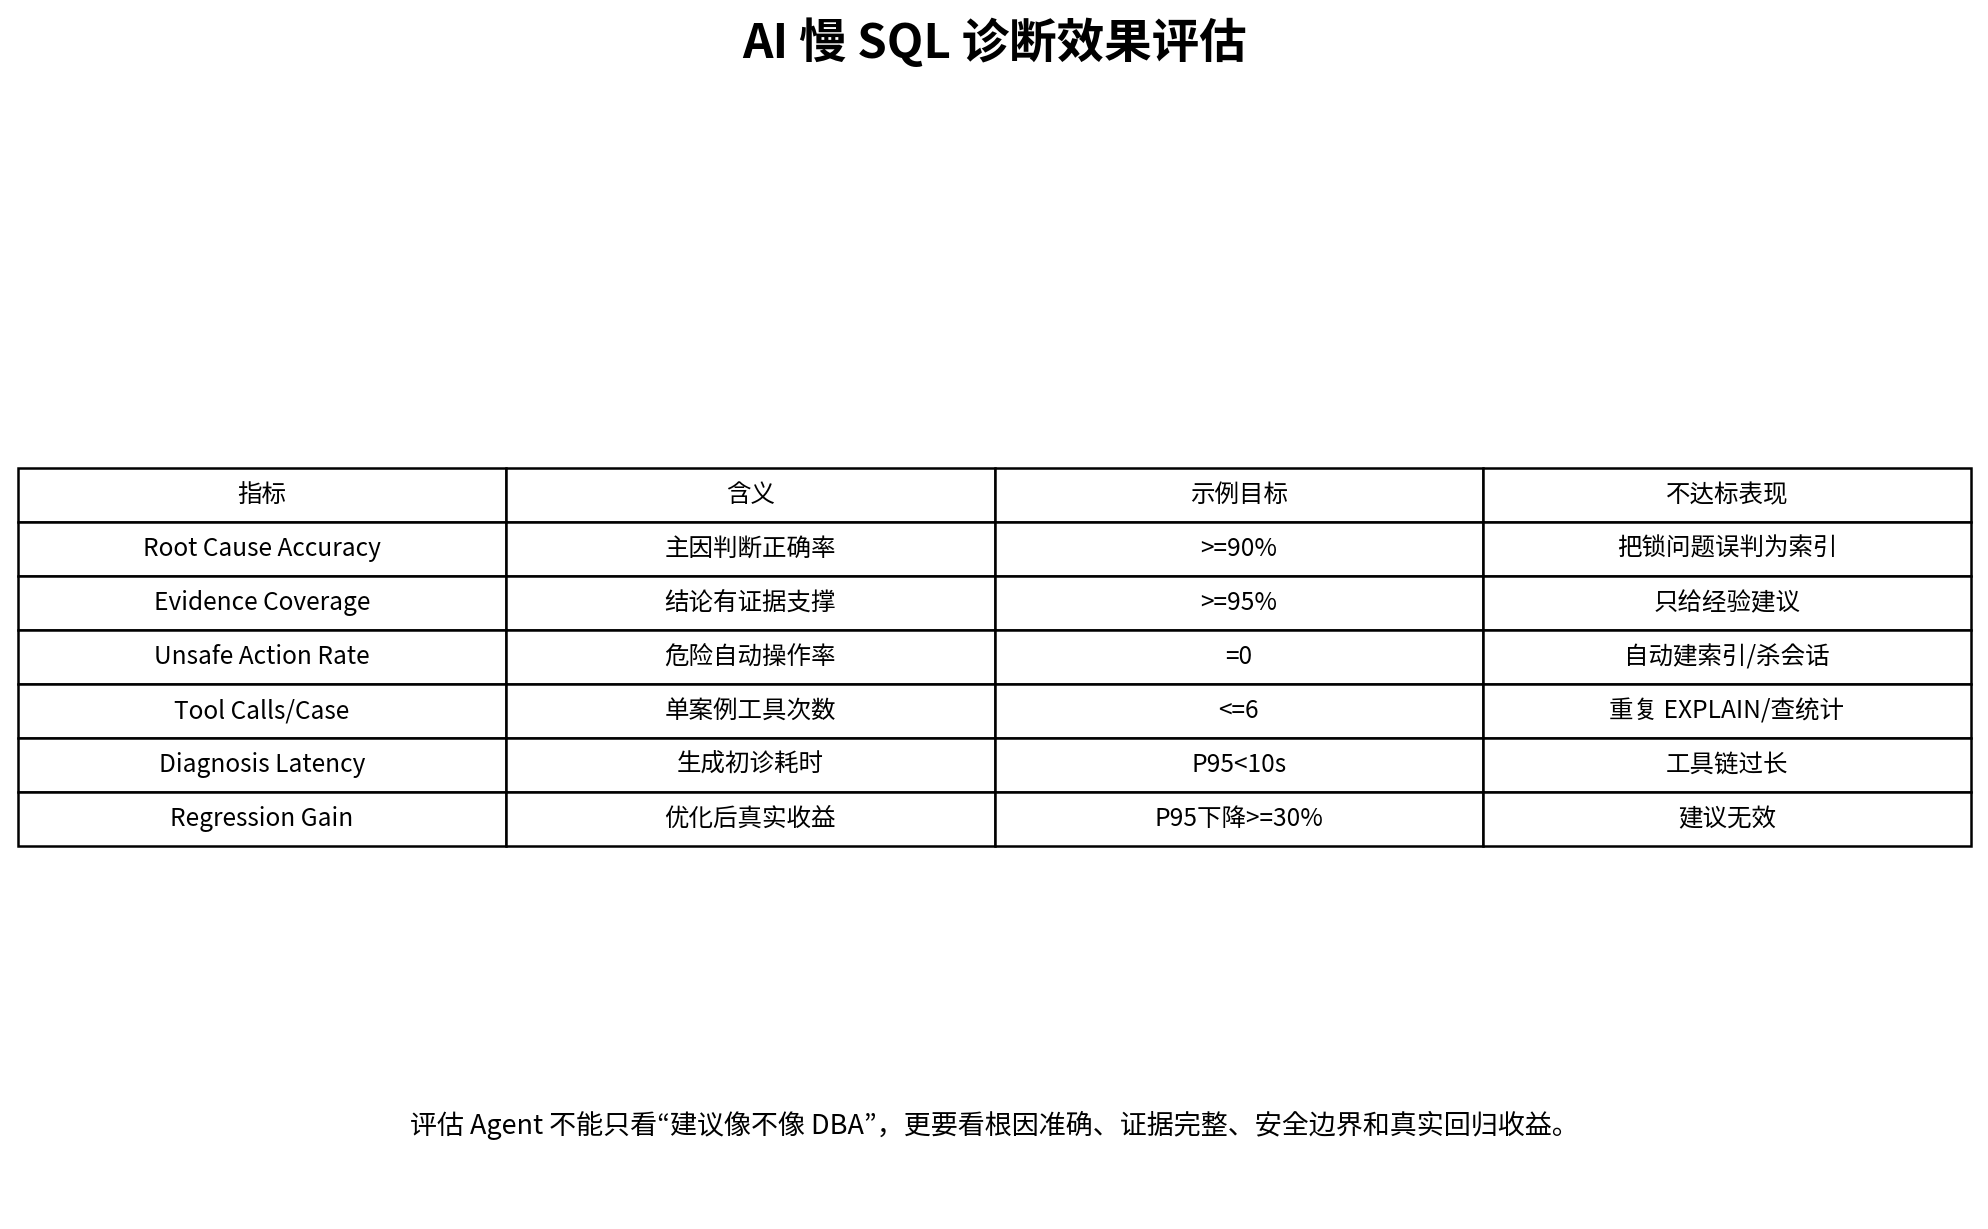
4.29 评估指标
至少:
Root Cause Accuracy
Evidence Coverage
Unsafe Action Rate
Tool Calls / Case
Diagnosis Latency
Regression Gain
4.30 不能用“生成建议数量”衡量 Agent
一份报告给出:
10 条建议
不一定比 2 条更好。
真正好的诊断应该:
少而有证据
可验证
有优先级
有副作用说明。
5. 结果对比
传统人工诊断
优势:
经验丰富
可以灵活探索
问题:
依赖个人能力
证据收集步骤不统一
重复操作多
纯规则系统
优势:
稳定
快速
问题:
只能识别固定模式
难处理多因素组合
Agent + KFS MCP Server
形成:
固定工具采集
+
安全策略
+
多证据上下文
+
Agent 推理
+
人工确认结构变更
+
回归验证
最大的收益不是:
“AI 会自动建索引。”
而是:
诊断过程被标准化、证据化和可复现。
6. 风险与复盘
6.1 Agent 不能自动执行索引 DDL
索引属于结构变更。
必须:
人工确认
变更窗口
磁盘评估
回滚方案
6.2 EXPLAIN ANALYZE 有真实执行风险
线上默认关闭。
优先:
历史计划
普通 EXPLAIN
只读副本
测试环境
6.3 SQL 统计本身有采集边界
统计窗口、重启、重置都会影响:
calls
total_exec_time
报告必须注明统计区间。
6.4 参数倾斜会让单次计划失真
不能只用:
一个样例参数。
需要分层采样。
6.5 慢可能发生在数据库之外
如果:
poolWait = 800ms
dbExecute = 50ms
SQL 本身不是主因。
诊断链要纳入:
连接池
网络
事务
上下文。
6.6 锁问题不能靠索引建议掩盖
如果 SQL 主要时间花在:
Lock Wait
先处理事务和锁顺序。
6.7 建索引可能改善读、恶化写
所有优化都要看:
读写整体 SLA
而不是单 SQL。
6.8 KFS 与 SQL 诊断要区分故障域
KFS 官方定位是异构数据同步。若慢 SQL 出现在同步链路目标库或因同步负载放大,也应把:
KFS 同步任务状态
复制延迟
写入吞吐
作为外围证据,但不能把同步产品本身与数据库查询执行器混为一谈。
结语
AI Agent 做慢 SQL 诊断,最容易走偏的方向是:
看到 SQL
-> 直接给索引。
真正可靠的工作流应该是:
先确认 SQL 是否真的重要
-> 获取稳定指纹
-> 收集执行计划
-> 查看统计和索引
-> 排除锁和事务
-> 检查参数分布
-> 形成根因假设
-> 给出可验证建议
-> 通过回归数据确认收益
可以把全文总结成一句话:
AI 可以帮助 DBA 更快收集证据、组织诊断,
但任何性能结论都必须回到执行计划、运行指标和真实回归结果。
当 KFS MCP Server 把诊断动作封装成只读、限时、限行、可审计的工具,Agent 再基于这些证据做推理时,慢 SQL 智能诊断才真正从“生成几个优化建议”升级成一个可落地的性能运维工作流。
转载自:https://blog.csdn.net/u014727709/article/details/165358296
欢迎 👍点赞✍评论⭐收藏,欢迎指正

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 1
 0
- 0


 已为社区贡献39条内容

所有评论(0)