AI Agent自动生成数据库巡检报告——KFS MCP Server、采集SQL与智能运维闭环
文章目录
- 每日一句正能量
- 前言
- 1. 背景与问题
- 2. 环境与数据
- 3. 复现过程
- 4. 方案实施
- 4.1 第一组:连接与会话巡检
- 4.2 第二组:锁等待
- 4.3 第三组:慢 SQL 与高消耗 SQL
- 4.4 第四组:数据库容量
- 4.5 第五组:复制状态
- 4.6 巡检工具不要接受任意 SQL
- 4.7 KFS MCP Server 权限控制
- 4.8 “查看阻塞”与“杀会话”必须分开
- 4.9 MyBatis 巡检 Mapper
- 4.10 JDBC 超时
- 4.11 每个工具必须限制结果量
- 4.12 证据先结构化,再交给 Agent
- 4.13 规则引擎负责“确定性判断”
- 4.14 基线比较
- 4.15 报告模板
- 4.16 Agent Prompt 要限制事实来源
- 4.17 工具错误结构化
- 4.18 工具失败时报告必须标注“不完整”
- 4.19 工具调用预算
- 4.20 并行采集
- 4.21 巡检时间窗口
- 4.22 安全审计
- 4.23 巡检证据快照
- 4.24 报告质量不能只靠主观评价
- 4.25 效果评估指标
- 4.26 一个示例实验
- 4.27 事实准确率
- 4.28 建议准确率
- 4.29 自动报告不等于自动处置
- 4.30 日常巡检与事故诊断要分开
- 5. 结果对比
- 6. 风险与复盘
- 结语
每日一句正能量
“格局之上所见皆风景,格局之下所见皆是非。”
当你的坐标尺度是日、是米,风吹草动都会成为扰动;当你的尺度是年、是公里,起伏便成了地形。格局的提升不是忽略琐碎,而是将它置于更广阔的时空背景中——你会看清它的暂时性和微小性,从而获得一种“俯瞰的能力”。
前言
数据库日常巡检看起来是一项“固定动作”,真正执行起来却很容易流于形式。
传统巡检表通常包含:
数据库是否在线
当前连接数
是否有锁等待
是否有长事务
慢 SQL 是否增加
磁盘是否接近上限
复制是否延迟
表和索引是否异常增长
问题是,人工巡检往往只停留在“把数字抄到表格里”。例如:
active connection = 186
这个数字本身并不能告诉值班人员:
186 是否异常?
和昨天相比有没有上升?
到底是哪一个服务占用?
是否已经接近连接池和数据库上限?
有没有和慢 SQL、锁等待同时出现?
AI Agent 真正适合做的,不是替 DBA 执行危险运维动作,而是把大量只读巡检证据自动采集、关联、解释,再生成一份“可行动”的巡检报告。
本文沿用前文的架构约定:KFS MCP Server 指面向 KFS/数据库能力的 MCP 工具服务层,用于向 Agent 提供受控巡检工具。公开资料中,KFS 官方产品 Kingbase FlySync 是异构数据同步软件;MCP 官方规范允许 Server 暴露带输入 Schema 的工具,适合把数据库巡检动作封装成明确、可授权、可审计的工具。MCP 工具可用于查询数据库等外部系统,工具本身具有名称和输入 Schema。 KFS 官方资料则将 Kingbase FlySync 定位为异构数据平台之间的数据同步产品。
1. 背景与问题
假设一套生产数据库每天早上 9 点需要生成巡检报告。
过去的人工流程可能是:
登录数据库
-> 查连接数
-> 查慢 SQL
-> 查锁
-> 查复制
-> 查磁盘
-> 复制截图
-> 写结论
-> 发群
整个过程最大的浪费不是 SQL 本身,而是重复搬运信息。
更麻烦的是,不同 DBA 的经验不同。
同样看到:
某 SQL mean_time = 850ms
有人会直接判为慢 SQL,有人会继续看:
调用次数
总执行时间
P95
扫描行数
是否新增执行计划
所以要把巡检自动化,不能只做:
定时执行 SQL。
必须把流程拆成:
证据采集
规则判定
趋势对比
Agent 解释
报告生成
人工复核
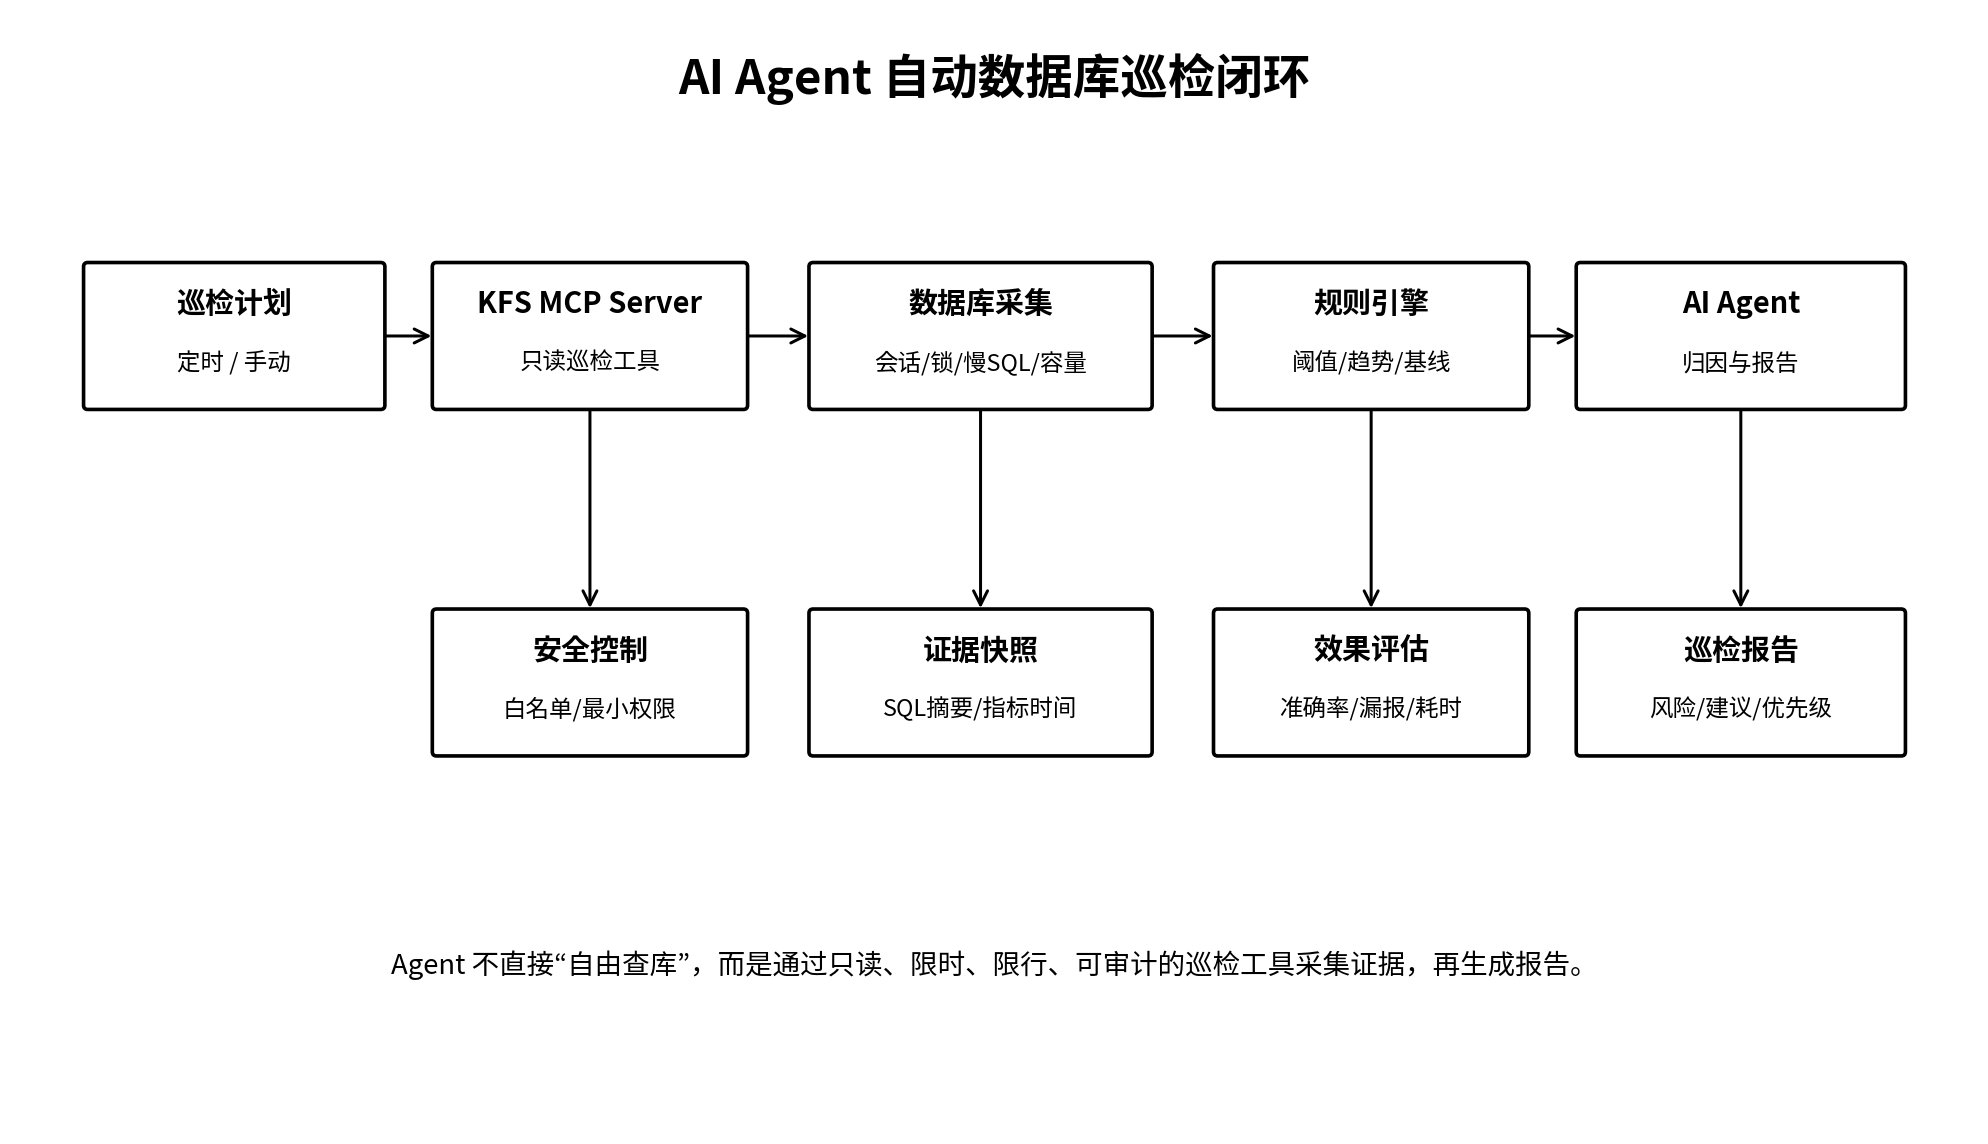
最关键的一条边界是:
Agent 不直接持有数据库自由操作权。
它只能调用经过治理的巡检工具。
2. 环境与数据
示例环境:
JDK 21
Spring Boot 3.3+
KingbaseES / PostgreSQL 类数据库
KFS MCP Server
JDBC / MyBatis
Redis
OpenTelemetry
Prometheus
巡检任务表:
CREATE TABLE inspection_job (
    id BIGINT PRIMARY KEY,
    job_no VARCHAR(64) NOT NULL UNIQUE,
    database_name VARCHAR(128) NOT NULL,
    started_at TIMESTAMP NOT NULL,
    finished_at TIMESTAMP NULL,
    status VARCHAR(16) NOT NULL,
    health_score INT NULL,
    report_uri VARCHAR(512) NULL
);
巡检结果表:
CREATE TABLE inspection_metric (
    id BIGINT PRIMARY KEY,
    job_no VARCHAR(64) NOT NULL,
    metric_code VARCHAR(64) NOT NULL,
    metric_value NUMERIC(20,4) NULL,
    metric_text TEXT NULL,
    risk_level VARCHAR(16) NOT NULL,
    collected_at TIMESTAMP NOT NULL,

    INDEX idx_job_metric(
        job_no,
        metric_code
    )
);
异常证据:
CREATE TABLE inspection_evidence (
    id BIGINT PRIMARY KEY,
    job_no VARCHAR(64) NOT NULL,
    evidence_type VARCHAR(32) NOT NULL,
    evidence_key VARCHAR(128) NOT NULL,
    evidence_json TEXT NOT NULL,
    created_at TIMESTAMP NOT NULL
);
这里把:
指标
和:
证据
分开。
这样报告里的每个风险项都可以回溯到原始采集结果。
3. 复现过程
3.1 只靠定时 SQL 的第一版
最初实现:
@Scheduled(cron = "0 0 9 * * *")
public void inspect() {

    int active =
        jdbcTemplate.queryForObject(
            "SELECT count(*) FROM pg_stat_activity",
            Integer.class
        );

    report.append(
        "当前连接数:" + active
    );
}
这当然能跑。
但它没有回答:
多少连接算异常?
active 和 idle 分别多少?
是否存在 idle in transaction?
是否比昨天增加?
所以这只是:
自动抄表。
3.2 只让大模型自己查库更危险
另一种极端做法是给 Agent 一个工具:
execute_sql(sql)
然后提示:
“请自行巡检数据库。”
这会带来两个问题:
模型可能查询超大系统视图
可能无 LIMIT
可能访问敏感表
可能反复执行相同查询
而且每次 Agent 生成的 SQL 不同,报告难以稳定对比。
所以巡检工具必须固定化。
3.3 仅看当前值会制造误报
例如:
active connections = 120
如果数据库平时:
110~130
并不异常。
但如果昨天是:
20
今天突然:
120
就值得关注。
因此巡检报告必须同时使用:
绝对阈值
趋势
历史基线
4. 方案实施
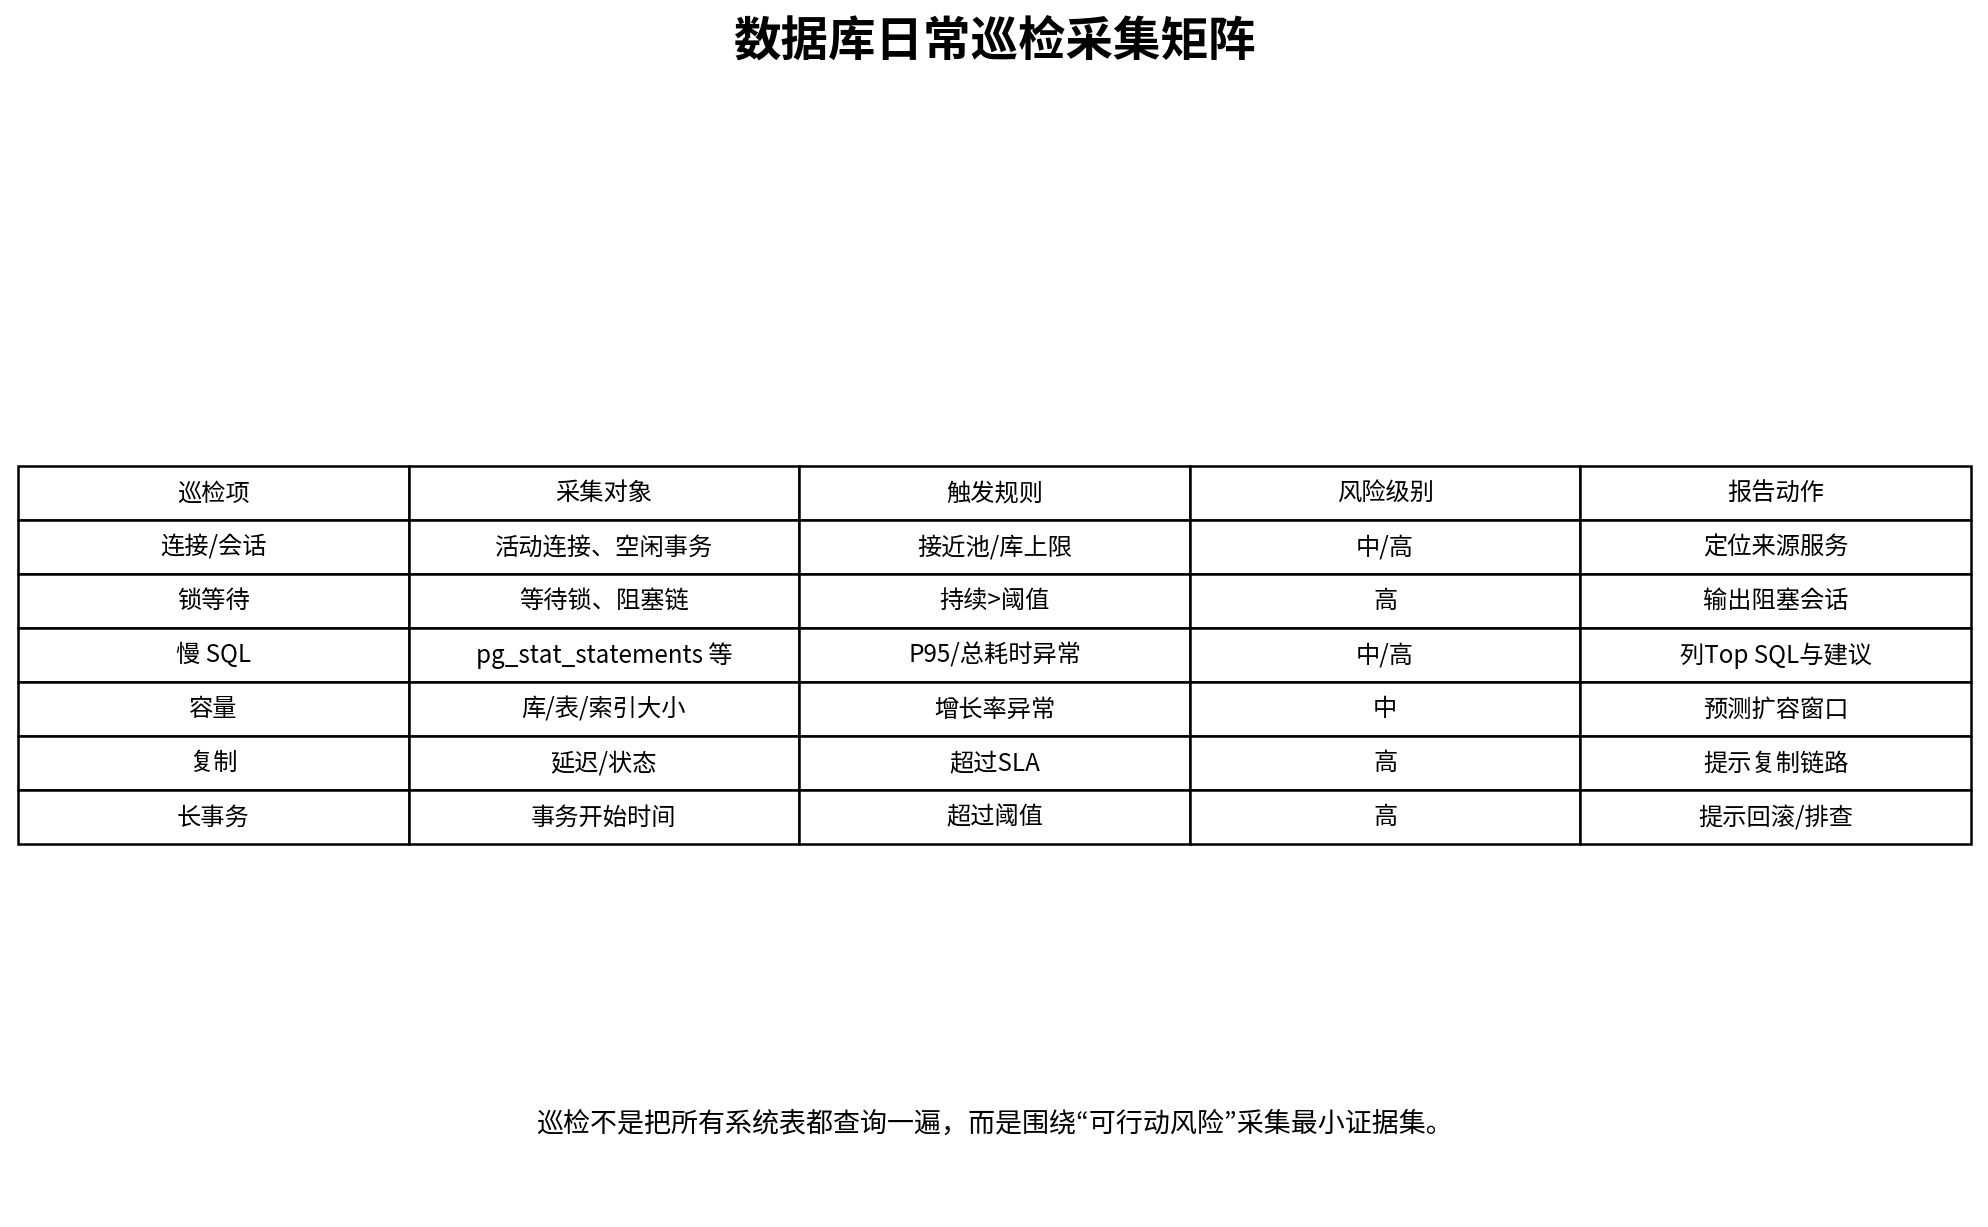
4.1 第一组:连接与会话巡检
PostgreSQL/兼容数据库常见采集思路:
SELECT
    state,
    COUNT(*) AS session_count
FROM pg_stat_activity
GROUP BY state;
长事务:
SELECT
    pid,
    usename,
    application_name,
    client_addr,
    now() - xact_start
        AS transaction_age,
    state
FROM pg_stat_activity
WHERE xact_start IS NOT NULL
  AND now() - xact_start
      > INTERVAL '5 minutes'
ORDER BY transaction_age DESC;
pg_stat_activity 是数据库会话状态的重要观测入口;巡检时应重点区分活动会话、空闲会话和长事务,而不是只看总连接数。
4.2 第二组:锁等待
pg_locks 可以查看当前活动锁对象及等待状态,官方文档明确说明它提供数据库服务器中活动锁的信息,并可结合 pg_stat_activity 补充会话信息。citeturn712981search7
示例:
SELECT
    a.pid,
    a.usename,
    a.application_name,
    a.query,
    l.locktype,
    l.mode,
    l.granted
FROM pg_locks l
JOIN pg_stat_activity a
  ON l.pid = a.pid
WHERE l.granted = false;
实际生产应进一步构建:
blocked_pid
blocking_pid
阻塞链。
报告不要只写:
发现 3 个等待锁。
而应输出:
等待最长会话
阻塞来源
事务年龄
应用名称
SQL 摘要
4.3 第三组:慢 SQL 与高消耗 SQL
PostgreSQL 的 pg_stat_statements 用于跟踪服务器上 SQL 的规划和执行统计。citeturn712981search3
示例:
SELECT
    queryid,
    calls,
    total_exec_time,
    mean_exec_time,
    rows,
    query
FROM pg_stat_statements
ORDER BY total_exec_time DESC
LIMIT 20;
巡检时不要只排:
mean_exec_time
还应至少看:
total_exec_time
calls
因为一条:
平均 20ms
每天执行 1000 万次
的 SQL,可能比一条偶发 2 秒 SQL 更消耗资源。
4.4 第四组:数据库容量
例如:
SELECT
    pg_database_size(
        current_database()
    ) AS database_bytes;
表大小:
SELECT
    relname,
    pg_total_relation_size(
        relid
    ) AS total_bytes
FROM pg_catalog.pg_statio_user_tables
ORDER BY total_bytes DESC
LIMIT 20;
真正巡检时要保存每日快照。
否则你只能知道:
现在 2TB。
却不知道:
每天增长 10GB
还是每天增长 100GB。
4.5 第五组:复制状态
如果使用主从/流复制,需要采集:
复制连接状态
LSN 差距
时间延迟
接收/回放状态
如果 KFS 被用于异构同步,也可以把:
同步任务状态
同步延迟
失败任务
作为额外巡检输入。KFS 官方产品面向异构数据同步、迁移、灾备等场景,并强调增量同步和事务级完整性,因此同步链路本身也是数据平台巡检的一部分。citeturn712981search1
4.6 巡检工具不要接受任意 SQL
MCP Server 建议提供:
inspect_sessions
inspect_long_transactions
inspect_locks
inspect_top_sql
inspect_capacity
inspect_replication
而不是:
execute_sql
工具输入:
{
  "name": "inspect_top_sql",
  "inputSchema": {
    "type": "object",
    "properties": {
      "limit": {
        "type": "integer",
        "minimum": 1,
        "maximum": 50
      },
      "orderBy": {
        "type": "string",
        "enum": [
          "total_exec_time",
          "mean_exec_time",
          "calls"
        ]
      }
    }
  }
}
这符合 MCP Tool 的设计方式:由 Server 暴露清晰的工具定义和输入 Schema,而不是让模型获得无限制的底层接口。citeturn712981search0
4.7 KFS MCP Server 权限控制
巡检账号:
agent_inspector
只允许:
读取系统统计视图
读取必要运维视图
读取同步状态
禁止:
INSERT
UPDATE
DELETE
DDL
终止会话
修改参数
巡检 Agent 和处置 Agent 必须是两个安全级别。
4.8 “查看阻塞”与“杀会话”必须分开
只读工具:
inspect_blocking_chain
可以自动调用。
危险工具:
terminate_session
如果未来开放,必须要求:
人工二次确认
更高角色
变更单号
审计
日常巡检报告不应该自动执行终止操作。
4.9 MyBatis 巡检 Mapper
<select id="findLongTransactions"
        resultType="LongTxRow">
    SELECT
        pid,
        usename,
        application_name,
        EXTRACT(
            EPOCH
            FROM (
                now() - xact_start
            )
        ) AS age_seconds,
        state
    FROM pg_stat_activity
    WHERE xact_start IS NOT NULL
      AND now() - xact_start
          > make_interval(
              secs => #{thresholdSeconds}
          )
    ORDER BY age_seconds DESC
    LIMIT #{limit}
</select>
所有阈值:
参数化。
不要让 Agent 动态拼系统 SQL。
4.10 JDBC 超时
巡检也必须限制数据库时间。
try (PreparedStatement ps =
         connection.prepareStatement(sql)) {

    ps.setQueryTimeout(3);

    ...
}
巡检不能因为查询系统视图本身太慢,反过来给生产数据库制造压力。
4.11 每个工具必须限制结果量
例如:
Top SQL 最多 50
长事务最多 50
锁等待最多 100
如果超过:
返回 count
+
TopN
不要把 5 万行系统会话信息喂给模型。
4.12 证据先结构化,再交给 Agent
例如:
{
  "metric": "long_transaction",
  "count": 3,
  "thresholdSeconds": 300,
  "top": [
    {
      "pid": 3012,
      "application": "order-service",
      "ageSeconds": 841
    }
  ]
}
Agent 根据这个数据写:
发现 3 个超过 5 分钟的长事务,
最长 841 秒,来自 order-service。
而不是自己去解析几十行数据库输出。
4.13 规则引擎负责“确定性判断”
不要把所有阈值都交给大模型。
例如:
if (longTxSeconds > 600) {
    risk = HIGH;
} else if (longTxSeconds > 300) {
    risk = MEDIUM;
}
Agent 更适合:
解释原因
组织上下文
生成建议
规则更适合:
是否越线。
4.14 基线比较
例如连接数:
当前 = 180
昨日同期 = 95
7 日中位数 = 102
数据库警戒值 = 220
Agent 可以写:
当前连接数尚未突破警戒线,
但较 7 日中位数上升约 76%,
建议优先检查近期实例扩容、
连接泄漏或慢 SQL 导致的连接占用。
这种答案比:
连接数 180,正常。
有用得多。
4.15 报告模板
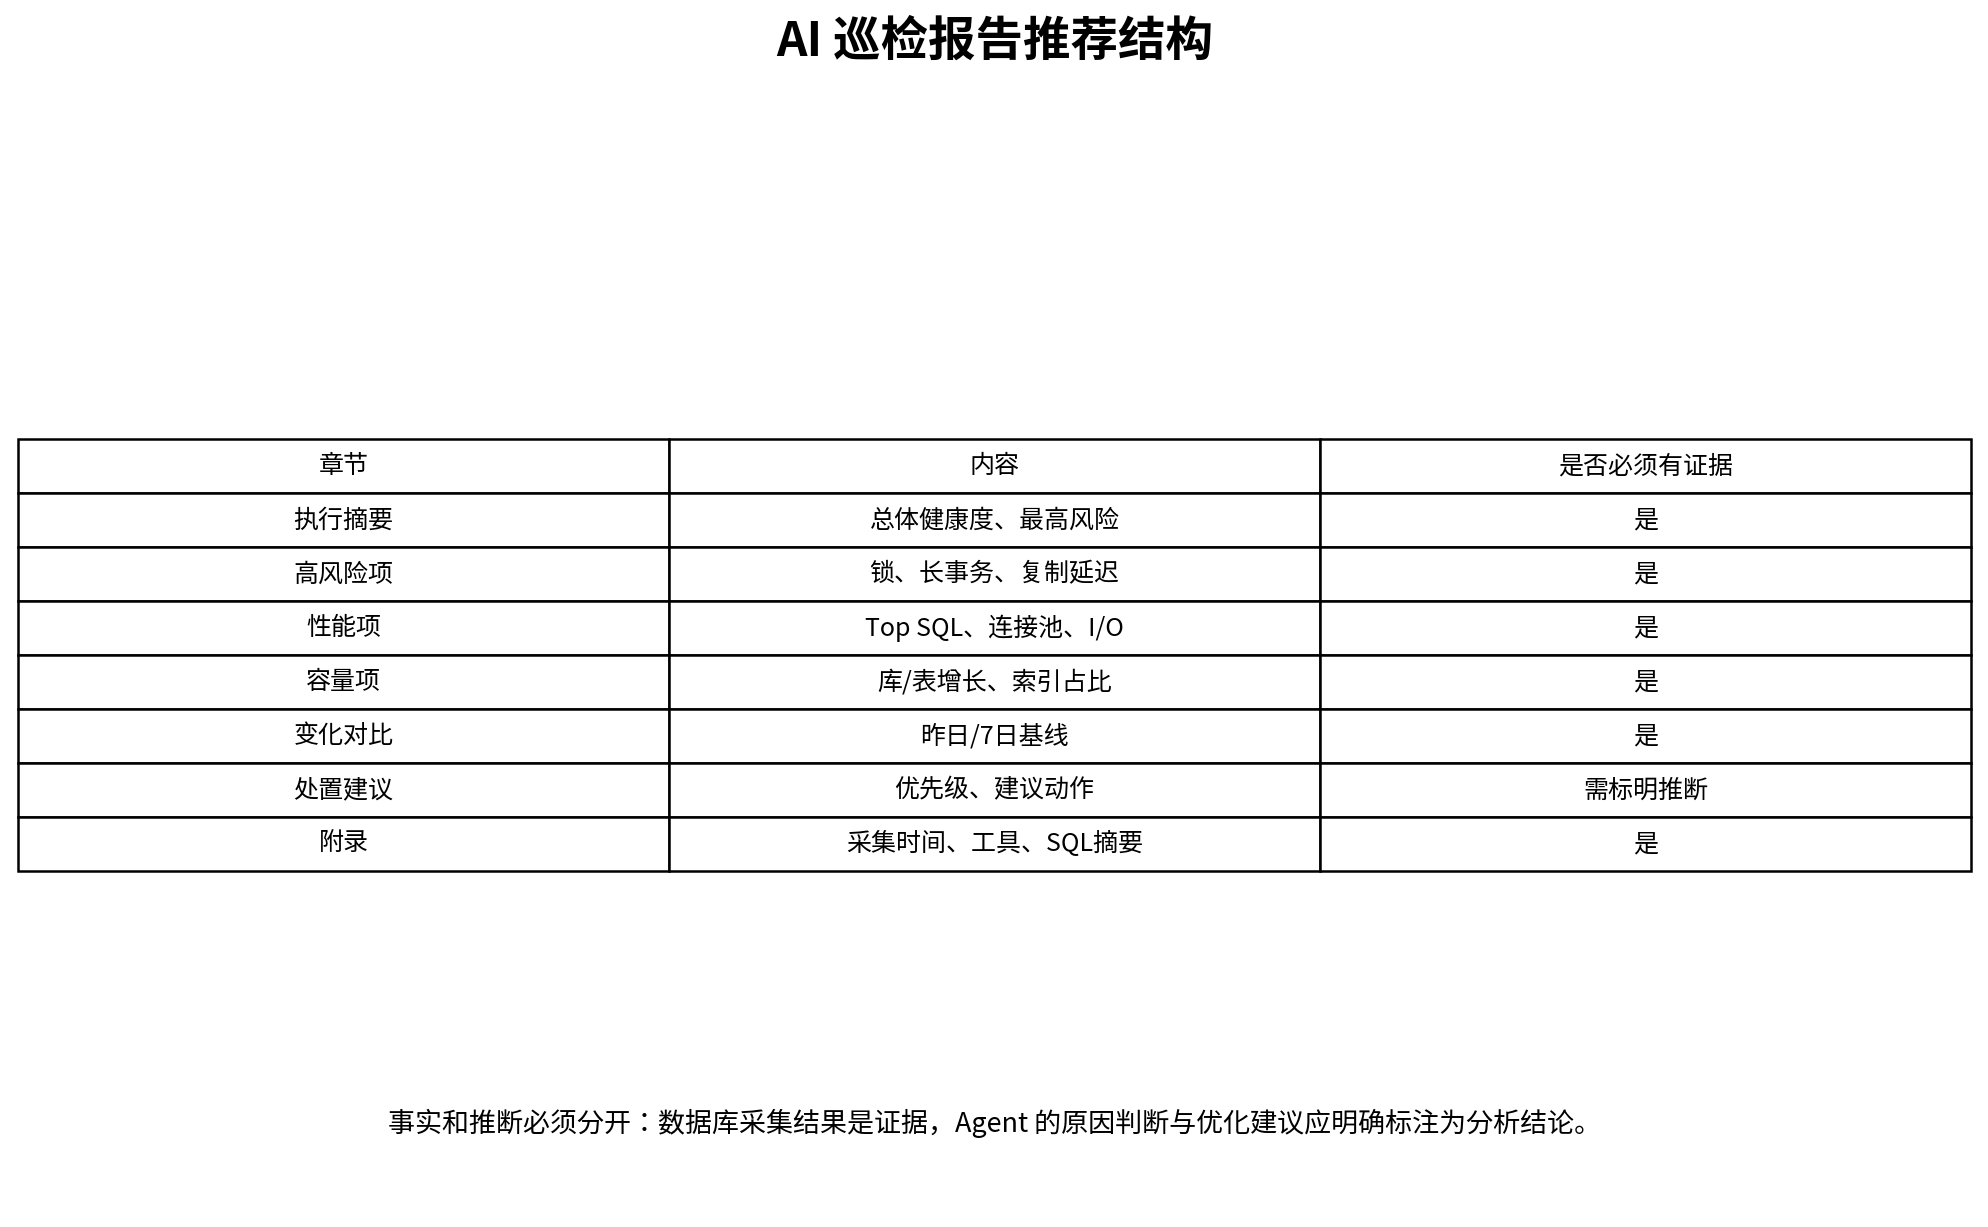
Markdown 模板:
# 数据库日常巡检报告

## 1. 执行摘要
- 健康评分:
- 高风险项:
- 中风险项:

## 2. 高风险问题
### 2.1 长事务
- 证据:
- 影响:
- 建议:

## 3. SQL 性能
- Top SQL
- 与昨日对比

## 4. 容量
- 数据库大小
- 日增长
- 预计空间窗口

## 5. 复制与同步
- 状态
- 延迟

## 6. 建议动作
- P0
- P1
- P2

## 7. 附录
- 采集时间
- 工具版本
- 指标快照
4.16 Agent Prompt 要限制事实来源
系统提示可以要求:
只能依据巡检工具返回的证据生成事实判断;
不得编造未采集的数据库指标;
推断必须使用“可能”“建议进一步确认”等表述;
不得生成高风险执行命令。
这样减少“看起来很专业但没有证据”的报告。
4.17 工具错误结构化
{
  "code": "INSPECTION_QUERY_TIMEOUT",
  "tool": "inspect_top_sql",
  "retryable": true,
  "traceId": "inspect-184-001"
}
权限不足:
{
  "code": "INSPECTION_FORBIDDEN",
  "retryable": false
}
Agent 不应该看到完整 JDBC 堆栈。
4.18 工具失败时报告必须标注“不完整”
例如:
复制状态采集失败。
报告应明确:
本次巡检“复制与同步”项未完成,
总体健康结论不包含该维度。
不能把缺失数据当成:
没有问题。
4.19 工具调用预算
一次日常巡检可以限制:
maxTools = 10
maxRetriesPerTool = 1
totalBudget = 30s
防止 Agent 因为一项失败不断重复调用。
4.20 并行采集
这些通常互相独立:
连接
容量
复制
Top SQL
可以并行。
但:
连接池
数据库并发容量
必须设上限。
例如:
maxConcurrentInspectionTools = 3
4.21 巡检时间窗口
不要在业务峰值执行重查询。
日常轻量统计可以:
随时采集。
复杂容量扫描、索引分析则应:
低峰执行
或读取监控快照。
4.22 安全审计
每次工具调用记录:
jobNo
traceId
toolName
database
operator/agent
argsDigest
durationMs
rows
riskLevel
errorCode
不要记录:
数据库密码
完整敏感 SQL
完整业务明细
4.23 巡检证据快照
报告生成时应保存:
采集时间
数据库版本
每个指标原始值
SQL Digest
这样第二天可以对比,也能在事故复盘时还原当时状态。
4.24 报告质量不能只靠主观评价
建议准备历史巡检样本:
正常日
连接泄漏
死锁
长事务
慢 SQL 激增
复制延迟
磁盘快速增长
让 Agent 对这些场景生成报告,再和 DBA 标准答案比对。
4.25 效果评估指标
至少包括:
Risk Detection Recall
False Positive Rate
Severity Accuracy
Evidence Coverage
Tool Success Rate
Tool Calls / Report
Report Generation Time
Unsafe Recommendation Rate
4.26 一个示例实验
人工巡检:
平均耗时:22 分钟
漏项率:8%
报告格式一致率:65%
自动巡检示例:
采集+生成:45 秒
漏项率:2%
报告格式一致率:100%
但还要关注:
误报率
错误归因
危险建议
所以不能只用“节省多少时间”评价 Agent。
4.27 事实准确率
每个报告结论必须能对应:
evidence_id
例如:
“发现 3 个长事务”
必须有长事务工具结果支撑。
4.28 建议准确率
例如 Agent 建议:
“立即增加 max_connections”
可能是危险建议。
真正问题也许是:
连接泄漏。
所以建议评估应单独做,不应和事实准确率混成一个指标。
4.29 自动报告不等于自动处置
推荐成熟度路径:
阶段 1:
自动采集

阶段 2:
自动报告,人工审核

阶段 3:
自动建议

阶段 4:
低风险动作自动执行

阶段 5:
高风险动作仍人工确认
不要从第一天就让 Agent 自动:
杀连接
建索引
修改参数
4.30 日常巡检与事故诊断要分开
日常巡检:
固定工具
固定阈值
固定报告
事故诊断:
更深层工具
更灵活查询
人工参与更多
不要为了事故场景能力,把日常 Agent 的权限无限放大。
5. 结果对比
传统人工巡检
优势:
经验判断灵活
异常场景处理丰富
问题:
耗时
格式不统一
容易漏项
缺少持续趋势
纯脚本巡检
优势:
稳定采集
速度快
问题:
只有数字
缺少上下文
无法解释优先级
Agent + KFS MCP Server
组合:
固定采集工具
+
确定性规则
+
历史基线
+
Agent 解释
+
统一报告模板
得到的是:
有证据
有趋势
有风险级别
有建议
的巡检结果。
最重要的变化不是:
“报告自动写出来了。”
而是:
每个结论都能回溯到一次受控工具调用。
6. 风险与复盘
6.1 巡检 Agent 不应该有写权限
这是最重要的安全原则。
日常巡检只需要:
SELECT
就不要给:
UPDATE
DELETE
DDL
终止会话
6.2 系统视图也可能泄露敏感 SQL
pg_stat_activity、SQL 统计视图可能包含:
业务参数
用户信息
所以返回给 Agent 前应:
SQL 模板化
参数脱敏
结果裁剪
6.3 巡检 SQL 本身也会产生负载
尤其:
大表容量统计
复杂索引分析
不能无限频繁执行。
6.4 阈值不能“一套走天下”
不同数据库:
连接上限
业务峰值
SLA
数据量
不同。
阈值应:
按实例配置
+
历史基线。
6.5 Agent 归因必须标注不确定性
数据库证据能证明:
连接变多
慢 SQL 增多
但未必能直接证明:
“因为某次发布导致。”
如果没有发布数据,就只能说:
“可能相关,建议结合发布记录确认。”
6.6 缺失采集项不能默认为正常
工具失败:
UNKNOWN
而不是:
HEALTHY
6.7 自动建议要设安全等级
例如:
建议检查索引
低风险。
建议终止 PID 3012
高风险。
报告可以提出后者,但自动执行必须另设审批边界。
6.8 KFS/同步链路也应纳入证据,而不是混同数据库本体
KFS 官方定位是异构数据同步产品。citeturn712981search5 因此同步延迟、任务失败属于“数据同步链路健康”,与数据库锁、SQL 性能属于不同故障域。报告里应分章节呈现,避免把同步问题错误归因成数据库本身问题。
结语
AI Agent 自动数据库巡检最值得做的,不是让模型拥有 DBA 权限,而是让:
数据库证据采集
风险规则
历史趋势
报告解释
形成自动闭环。
真正可靠的设计应该是:
固定只读工具
-> KFS MCP Server 安全控制
-> 数据库最小权限采集
-> 规则判定
-> Agent 解释
-> 证据化报告
-> 人工复核高风险建议
可以把全文总结成一句话:
自动巡检的目标不是“让 AI 替 DBA 操作数据库”,
而是“让 DBA 每天先拿到一份有证据、有优先级、可追溯的数据库健康报告”。
当每一条风险结论都有工具调用和数据库证据支撑、每一条建议都明确安全等级和不确定性之后,AI Agent 才真正从“会写运维日报”升级成可治理的智能运维助手。
转载自:https://blog.csdn.net/u014727709/article/details/165357961
欢迎 👍点赞✍评论⭐收藏,欢迎指正

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 2
 0
- 0


 已为社区贡献39条内容

所有评论(0)