AI Agent结合向量检索增强Schema理解——RAG+SQL、KFS MCP Server与对比实验
文章目录
- 每日一句正能量
- 前言
- 1. 背景与问题
- 2. 环境与数据
- 3. 复现过程
- 4. 方案实施
- 4.1 第一步:建立 Schema 文档
- 4.2 元数据采集
- 4.3 Embedding 建库流程
- 4.4 向量索引
- 4.5 查询向量
- 4.6 权限过滤必须在向量检索阶段做
- 4.7 租户必须进入检索条件
- 4.8 TopK 不要过大
- 4.9 Hybrid 检索
- 4.10 主外键关系加权
- 4.11 用 KFS 同步 Schema 变更事件
- 4.12 每个文档带 version
- 4.13 RAG 输出不是 SQL
- 4.14 KFS MCP Server 工具设计
- 4.15 MCP Tool 内部固定 SQL
- 4.16 如果确实要支持动态 SQL
- 4.17 RAG 不能绕过 MCP 权限
- 4.18 数据库账号最小权限
- 4.19 敏感字段不进入 Embedding
- 4.20 Embedding 文档中的样例要有限
- 4.21 缓存检索结果
- 4.22 检索缓存失效
- 4.23 Agent 工具调用预算
- 4.24 异常结构化
- 4.25 事务边界
- 4.26 写工具必须与 Schema RAG 分离
- 4.27 对比实验设计
- 4.28 Schema Recall@K
- 4.29 SQL Execution Success
- 4.30 Tool Calls / Request
- 4.31 Correct Answer Rate
- 4.32 一个示例结果
- 5. 结果对比
- 6. 风险与复盘
- 结语
每日一句正能量
专注自己的赛道,提升自己,远比仰望别人更有意义。
比较是偷走幸福的贼,专注是创造价值的锤。别人的成就、速度、赛道是他的故事;你的成长、进步、突破是你的史诗。你唯一能切实改变和拥有的,只有你自己。投资自己,是回报率最高且永不贬值的投资。
这些文案既是盾牌,也是利剑;既是地图,也是燃料。
前言
在简单数据库里,让 AI Agent 写 SQL 并不难。
如果数据库只有:
users
orders
products
三个表,把 DDL 全部塞给模型,模型通常就能判断该查哪张表。
但企业数据库很少这么简单。真实复杂库经常出现:
数百张业务表
历史表与归档表并存
字段名大量使用缩写
同一个“客户”概念存在多个表
表注释不完整
跨系统同步产生镜像表
同名字段语义完全不同
权限只能访问其中一部分 Schema
这时最直接的做法——“把全部 Schema 都塞进 Prompt”——会迅速遇到三个问题:
上下文越来越长;
模型注意力被大量无关表稀释;
工具调用次数和 SQL 试错次数增加。
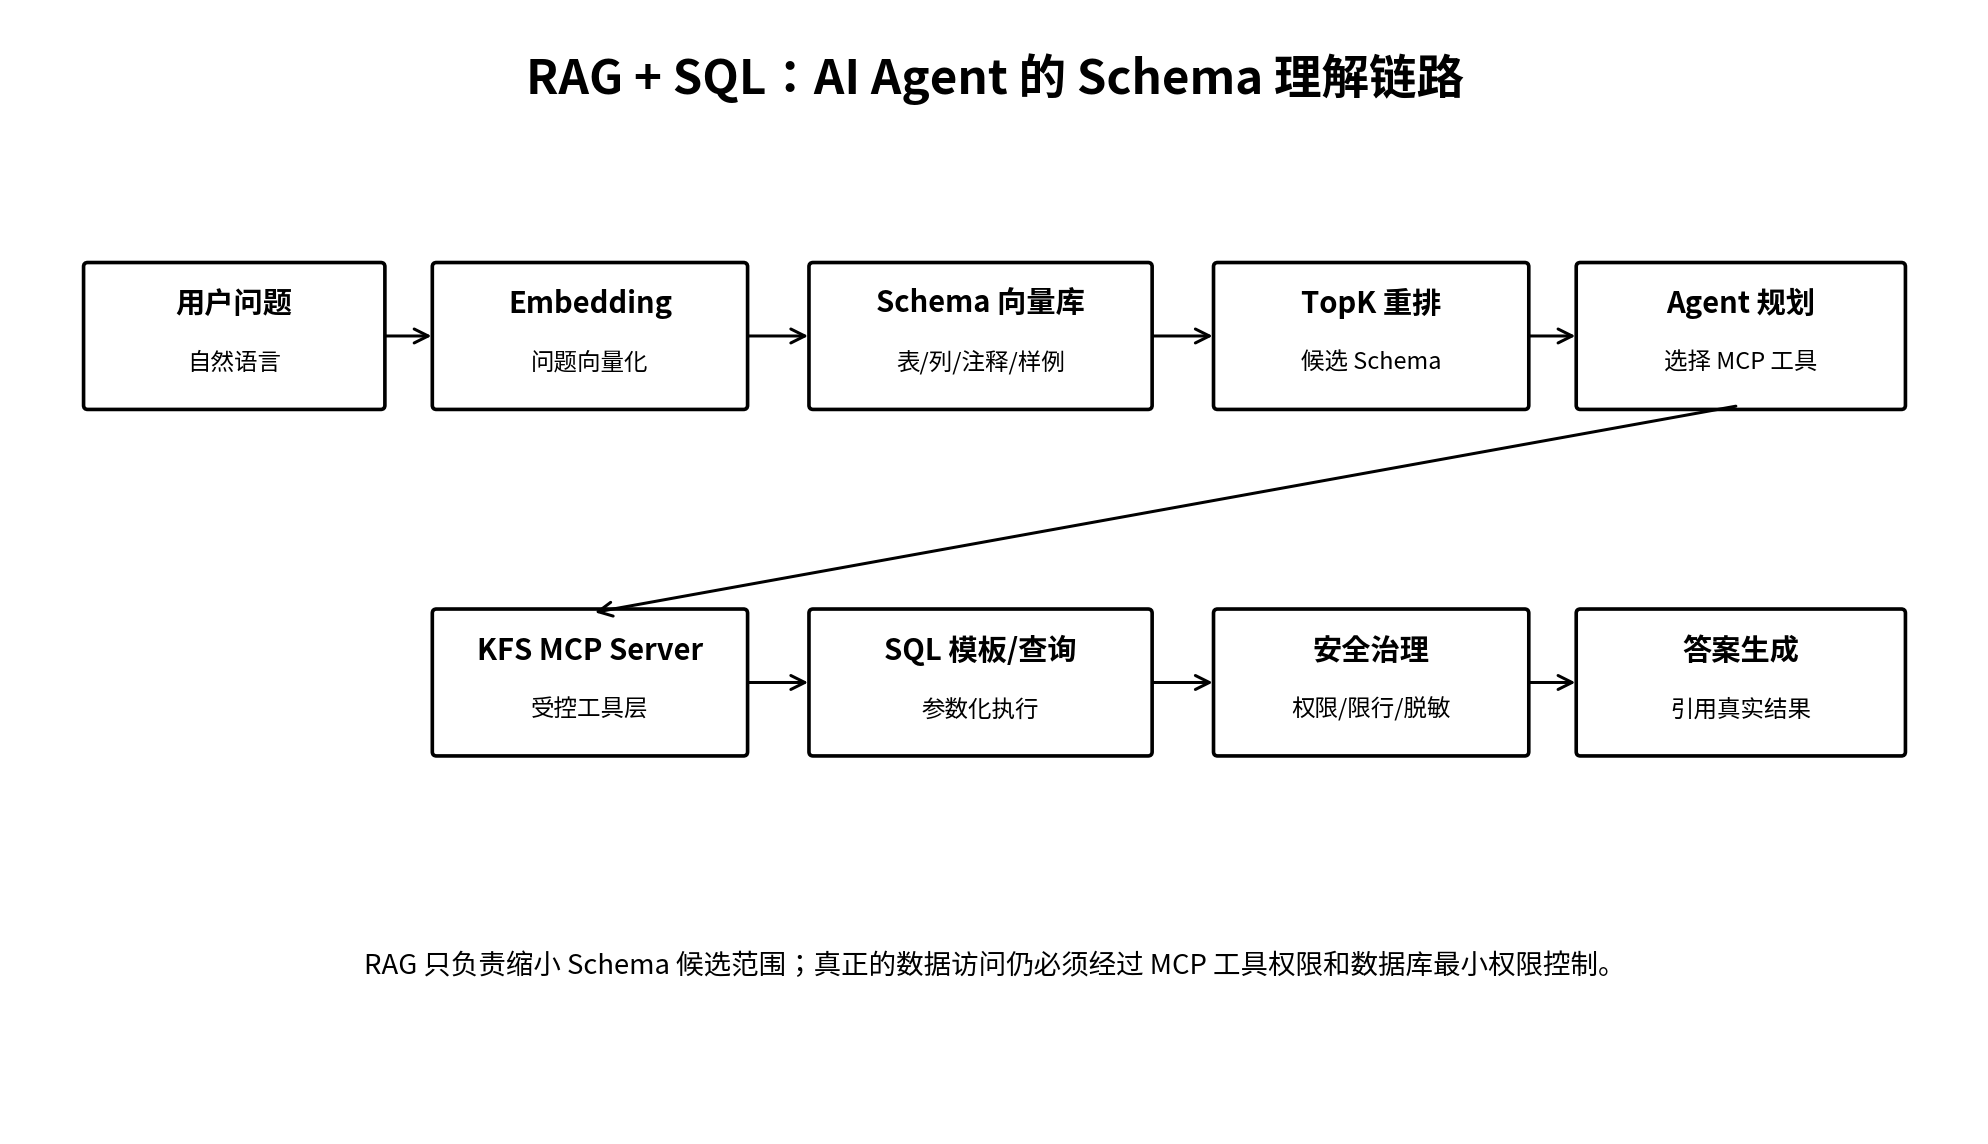
因此,一个更适合复杂数据库的方案是:
RAG 先找 Schema,
Agent 再规划 SQL,
KFS MCP Server 最后执行受控工具。
这里需要把两层职责说清楚。
本文所说的 KFS MCP Server,指“面向 KFS/数据库能力的 MCP 工具服务层”。公开资料中,KFS 官方产品指 Kingbase FlySync;本文不把“KFS MCP Server”表述为未经确认的官方固定产品,而是把它作为 AI Agent 架构里的数据库工具服务角色。
RAG 与 MCP 的边界则是:
RAG:
回答“可能需要哪些表和字段”。

MCP:
回答“模型实际允许调用哪些工具、访问哪些数据”。

数据库:
回答“最终真实数据是什么”。
1. 背景与问题
假设一个支付平台有 430 张表。
其中和“渠道失败率”有关的表包括:
payment_order
payment_order_history
channel_config
channel_daily_stat
pay_error_detail
gateway_route
用户问:
“昨天华东区域支付失败率最高的渠道是什么?
顺便告诉我失败原因主要集中在哪一类。”
如果 Agent 只看到表名,很容易做出错误判断。
例如:
channel_daily_stat
名字看起来最像统计结果,但这张表可能是 T+1 报表,只用于离线结算。
真正实时分析应该查询:
payment_order
pay_error_detail
channel_config
并通过:
channel_code
error_code
region_code
关联。
这类“哪个表才代表真正业务事实”的知识,本质上不是 SQL 语法问题,而是:
Schema 语义理解问题。
2. 环境与数据
示例环境:
JDK 21
Spring Boot 3.3+
KingbaseES / PostgreSQL 类数据库
pgvector 或独立向量数据库
Embedding Model
KFS MCP Server
MyBatis / JDBC
Redis
OpenTelemetry
业务表:
CREATE TABLE payment_order (
    id BIGINT PRIMARY KEY,
    order_no VARCHAR(64) NOT NULL,
    channel_code VARCHAR(32) NOT NULL,
    region_code VARCHAR(16) NOT NULL,
    amount NUMERIC(18,2) NOT NULL,
    pay_status VARCHAR(16) NOT NULL,
    error_code VARCHAR(32),
    created_at TIMESTAMP NOT NULL
);
错误字典:
CREATE TABLE pay_error_dict (
    error_code VARCHAR(32) PRIMARY KEY,
    error_category VARCHAR(32) NOT NULL,
    error_name VARCHAR(128) NOT NULL
);
渠道:
CREATE TABLE channel_config (
    channel_code VARCHAR(32) PRIMARY KEY,
    channel_name VARCHAR(128) NOT NULL,
    region_code VARCHAR(16) NOT NULL,
    enabled BOOLEAN NOT NULL
);
如果直接把这三张表的 DDL 给模型,问题不大。
真正的挑战是:
同一个数据库还有几百张表。
所以我们需要建立一个 Schema RAG 索引。
3. 复现过程
3.1 基线方案:全量 DDL 塞给模型
最简单的实现:
String schema =
    metadataRepository.loadAllDDL();

String prompt =
    """
    根据以下 Schema 回答问题:

    %s

    用户问题:
    %s
    """.formatted(schema, question);
当表数量增加以后会出现:
Prompt 长度快速膨胀
模型输入成本增加
无关 Schema 干扰
重要字段被淹没
更糟糕的是,大模型可能抓住名字最相似的表,而不是真正的事实表。
3.2 第二种方案:关键词搜索
例如把问题:
“支付失败率最高的渠道”
分词成:
支付
失败
渠道
然后从元数据表中搜索。
SELECT *
FROM schema_document
WHERE content LIKE '%支付%'
   OR content LIKE '%失败%'
   OR content LIKE '%渠道%';
它比全量 DDL 好,但遇到同义表达就很脆弱。
例如用户问:
“拒付率”
Schema 注释写的是:
支付失败
纯关键词未必能召回。
3.3 向量检索解决的是“语义召回”
Embedding 的价值不是直接写 SQL,而是把:
用户问题
和:
Schema 文档
映射到同一个向量空间。
问题:
“最近哪个支付通道拒付最严重?”
即使 Schema 文档使用:
渠道支付失败率
也有机会在向量空间里靠近。
3.4 但是只做向量检索仍然不够
假设检索 Top5:
channel_daily_stat
payment_order
payment_order_history
channel_config
pay_error_detail
如果直接全部交给模型,仍然可能选错历史表。
所以最终要加入:
关键词
主外键
表类型
数据时效
权限
做重排。
这就是本文推荐的:
Hybrid Schema RAG
4. 方案实施
4.1 第一步:建立 Schema 文档
不要只把 DDL 当文档。
一个更好的 Schema Document:
{
  "object": "payment_order",
  "type": "table",
  "businessName": "支付订单事实表",
  "description": "保存实时支付订单,一笔支付一行",
  "freshness": "realtime",
  "columns": [
    {
      "name": "channel_code",
      "description": "支付渠道编码"
    },
    {
      "name": "pay_status",
      "description": "支付结果,SUCCESS/FAILED"
    },
    {
      "name": "error_code",
      "description": "失败错误码"
    }
  ],
  "relations": [
    "payment_order.channel_code -> channel_config.channel_code",
    "payment_order.error_code -> pay_error_dict.error_code"
  ],
  "securityLevel": "INTERNAL"
}
Embedding 输入可以拼成:
表:payment_order
中文名:支付订单事实表
用途:实时支付订单,一笔支付一行
字段:channel_code 支付渠道编码;
pay_status 支付结果;
error_code 支付失败错误码;
关系:channel_code 关联 channel_config;
error_code 关联 pay_error_dict;
时效:实时。
这比只 Embedding:
CREATE TABLE payment_order ...
语义密度高很多。
4.2 元数据采集
JDBC:
DatabaseMetaData meta =
    connection.getMetaData();

try (ResultSet tables =
         meta.getTables(
             null,
             schema,
             "%",
             new String[]{"TABLE", "VIEW"}
         )) {

    while (tables.next()) {
        String tableName =
            tables.getString(
                "TABLE_NAME"
            );

        // 继续读取 columns / comments
    }
}
还可以从系统目录补:
表注释
列注释
主键
外键
索引
视图定义
4.3 Embedding 建库流程
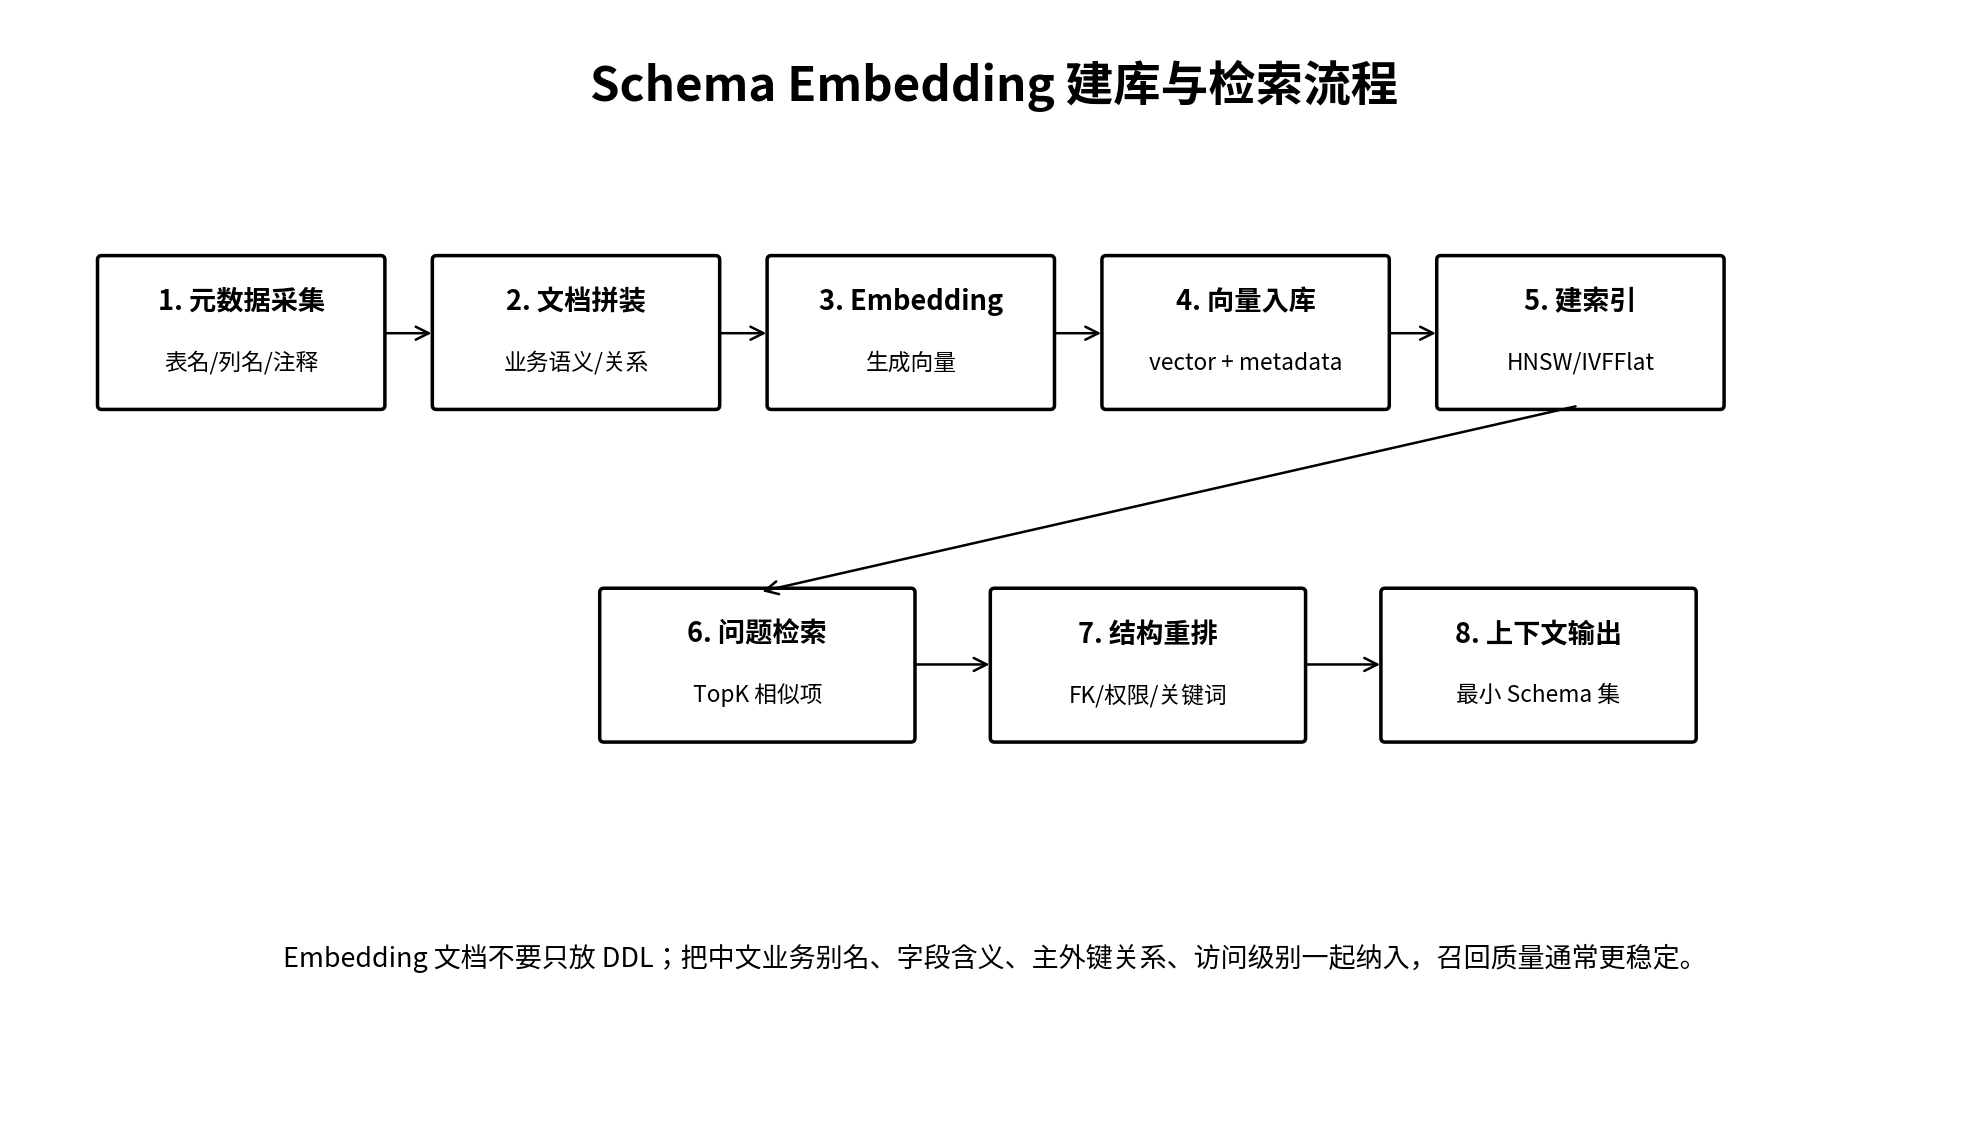
流程:
数据库元数据
-> 文档规范化
-> Embedding
-> 向量入库
-> 建向量索引
如果使用 PostgreSQL + pgvector 类方案:
CREATE TABLE schema_embedding (
    id BIGSERIAL PRIMARY KEY,
    object_name VARCHAR(128) NOT NULL,
    object_type VARCHAR(32) NOT NULL,
    schema_name VARCHAR(64) NOT NULL,
    content TEXT NOT NULL,
    metadata JSONB NOT NULL,
    embedding VECTOR(1536) NOT NULL,
    version BIGINT NOT NULL
);
维度应与实际 Embedding 模型一致。
4.4 向量索引
可使用:
HNSW
IVFFlat
具体选择应压测。
例如 HNSW:
CREATE INDEX idx_schema_embedding_hnsw
ON schema_embedding
USING hnsw (embedding vector_cosine_ops);
4.5 查询向量
伪代码:
float[] vector =
    embeddingClient.embed(
        question
    );
然后检索:
SELECT
    object_name,
    object_type,
    content,
    metadata,
    1 - (embedding <=> ?)
        AS similarity
FROM schema_embedding
WHERE schema_name = ?
ORDER BY embedding <=> ?
LIMIT 10;
4.6 权限过滤必须在向量检索阶段做
这是最重要的安全边界之一。
不能:
先检索所有 Schema
再让模型自己忽略无权对象。
应该:
WHERE schema_name = ?
  AND security_level <= ?
或者用 ACL 表:
schema_acl
过滤。
否则即使最后 SQL 没执行,模型已经知道了:
敏感表名
字段名
业务含义
这本身也是信息泄露。
4.7 租户必须进入检索条件
多租户:
WHERE tenant_id = ?
不能只进入 Prompt。
安全控制应该尽量:
在检索层和工具层执行。
4.8 TopK 不要过大
如果:
TopK = 50
最后仍然等于给模型塞大量 Schema。
实际可以从:
5~12
开始测试。
然后做重排。
4.9 Hybrid 检索
推荐得分:
finalScore
=
0.55 × vectorScore
+ 0.20 × keywordScore
+ 0.15 × relationScore
+ 0.10 × freshnessScore
例如:
payment_order
向量分高、又包含“支付”“失败”,而且是实时事实表,就应该排在:
channel_daily_stat
前面。
4.10 主外键关系加权
如果 TopK 命中:
payment_order
它的外键直接连接:
channel_config
pay_error_dict
即使后两张表向量相似度略低,也可以被关系图补召回。
算法示意:
Set<String> expanded =
    new LinkedHashSet<>(
        vectorTopK
    );

for (String table : vectorTopK) {
    expanded.addAll(
        relationGraph
            .neighbors(table)
    );
}
4.11 用 KFS 同步 Schema 变更事件
如果已有 KFS 等同步能力,可以把:
DDL/元数据变更事件
作为刷新 Schema Embedding 的触发来源之一。
架构思想:
源库 Schema 变化
-> 变更事件
-> Schema Indexer
-> 更新向量文档
-> 新 version 生效
这样不必每天全量重建。
这里的关键不是强依赖某一个同步产品,而是:
Embedding 索引必须和 Schema 版本同步。
4.12 每个文档带 version
{
  "object": "payment_order",
  "version": 18204
}
Agent 查询时:
RAG version
和:
MCP Server schema version
最好一致。
如果发现版本漂移:
停止生成 SQL
重新拉取元数据
4.13 RAG 输出不是 SQL
Schema Retriever 返回:
{
  "tables": [
    "payment_order",
    "channel_config",
    "pay_error_dict"
  ],
  "columns": {
    "payment_order": [
      "channel_code",
      "pay_status",
      "error_code",
      "created_at"
    ]
  },
  "relations": [
    "payment_order.channel_code = channel_config.channel_code",
    "payment_order.error_code = pay_error_dict.error_code"
  ]
}
然后 Agent 才进行:
工具规划。
不要让向量检索层直接拥有生产查询权限。
4.14 KFS MCP Server 工具设计
不建议暴露:
execute_sql(sql)
更推荐:
query_payment_failure_summary
query_error_category_distribution
describe_allowed_schema
例如:
{
  "name": "query_payment_failure_summary",
  "inputSchema": {
    "type": "object",
    "properties": {
      "regionCode": {
        "type": "string"
      },
      "startTime": {
        "type": "string"
      },
      "endTime": {
        "type": "string"
      },
      "topN": {
        "type": "integer",
        "minimum": 1,
        "maximum": 20
      }
    },
    "required": [
      "regionCode",
      "startTime",
      "endTime"
    ]
  }
}
4.15 MCP Tool 内部固定 SQL
MyBatis:
<select id="queryFailureSummary"
        resultType="ChannelFailureRow">
    SELECT
        o.channel_code,
        c.channel_name,
        COUNT(*) AS total_count,
        SUM(
            CASE
                WHEN o.pay_status = 'FAILED'
                THEN 1 ELSE 0
            END
        ) AS failed_count
    FROM payment_order o
    JOIN channel_config c
      ON o.channel_code =
         c.channel_code
    WHERE o.region_code =
          #{regionCode}
      AND o.created_at >=
          #{startTime}
      AND o.created_at <
          #{endTime}
    GROUP BY
        o.channel_code,
        c.channel_name
    ORDER BY failed_count DESC
    LIMIT #{topN}
</select>
这样 Agent 只控制:
参数
不控制:
SQL 结构。
4.16 如果确实要支持动态 SQL
复杂分析助手可能需要动态生成 SQL。
这时至少增加:
AST 解析
只允许 SELECT
禁止多语句
表白名单
列白名单
自动 LIMIT
查询超时
成本估计
伪代码:
SqlAst ast =
    parser.parse(sql);

if (!ast.isSelect()) {
    throw new ToolDeniedException();
}

securityPolicy.validateTables(
    ast.tables(),
    userContext
);

ast.forceLimit(200);
4.17 RAG 不能绕过 MCP 权限
即使向量检索召回:
customer_sensitive_info
MCP Tool 仍然要拒绝:
当前用户没有权限。
完整安全链是:
Schema RAG 权限过滤
+
Tool 权限
+
数据库账号权限
+
结果脱敏
不是其中任意一层。
4.18 数据库账号最小权限
Agent 读账号:
agent_reader
只授权安全视图:
GRANT SELECT
ON v_agent_payment_summary
TO agent_reader;
而不是:
GRANT SELECT ON ALL TABLES
4.19 敏感字段不进入 Embedding
特别注意:
Embedding 本身也是数据副本。
不要把:
真实身份证
手机号
账户余额样本
密钥
作为 Schema 文档样例。
示例值应使用:
脱敏
合成
类型描述
4.20 Embedding 文档中的样例要有限
有些团队为了增强语义,会放:
100 条真实样本
风险很高。
更推荐:
字段含义
枚举值
脱敏样例
统计特征
4.21 缓存检索结果
同一个会话反复问:
支付渠道
支付失败
支付错误
Schema TopK 很接近。
可以缓存:
normalizedQuestionIntent
-> schemaCandidates
但 Key 必须包含:
tenant
role
schemaVersion
4.22 检索缓存失效
当:
Schema version
变化时,缓存失效。
不要只依赖固定 TTL。
4.23 Agent 工具调用预算
Schema RAG 已经减少候选范围后,Agent 理论上应该减少:
describe_table
list_columns
trial_query
所以可设:
maxToolCalls = 4
如果超过:
认为规划失败
进入降级或要求用户收窄问题。
4.24 异常结构化
MCP Server:
{
  "code": "SCHEMA_NOT_ALLOWED",
  "retryable": false,
  "message": "当前角色无权访问该数据域",
  "traceId": "rag-182-001"
}
或者:
{
  "code": "QUERY_TIMEOUT",
  "retryable": true,
  "message": "查询超过在线分析时限"
}
不要把底层:
SQLException
完整暴露给模型和用户。
4.25 事务边界
Schema 检索是:
只读
真正执行分析 SQL 也应:
@Transactional(readOnly = true)
public List<ChannelFailureRow>
queryFailureSummary(...) {
    return mapper.queryFailureSummary(...);
}
不要让 Agent 调:
BEGIN
COMMIT
ROLLBACK
事务必须封装在 MCP Server 工具内部。
4.26 写工具必须与 Schema RAG 分离
Schema RAG 找到了:
orders.status
不代表 Agent 可以:
UPDATE orders
如果未来开放写操作,应使用独立 Tool:
update_order_status
并加入:
二次确认
幂等键
状态机校验
审计
短事务
4.27 对比实验设计
建议准备:
100~500 条真实问题
覆盖:
单表
多表 JOIN
同义词
缩写
历史表干扰
权限限制
跨域问题
不存在字段
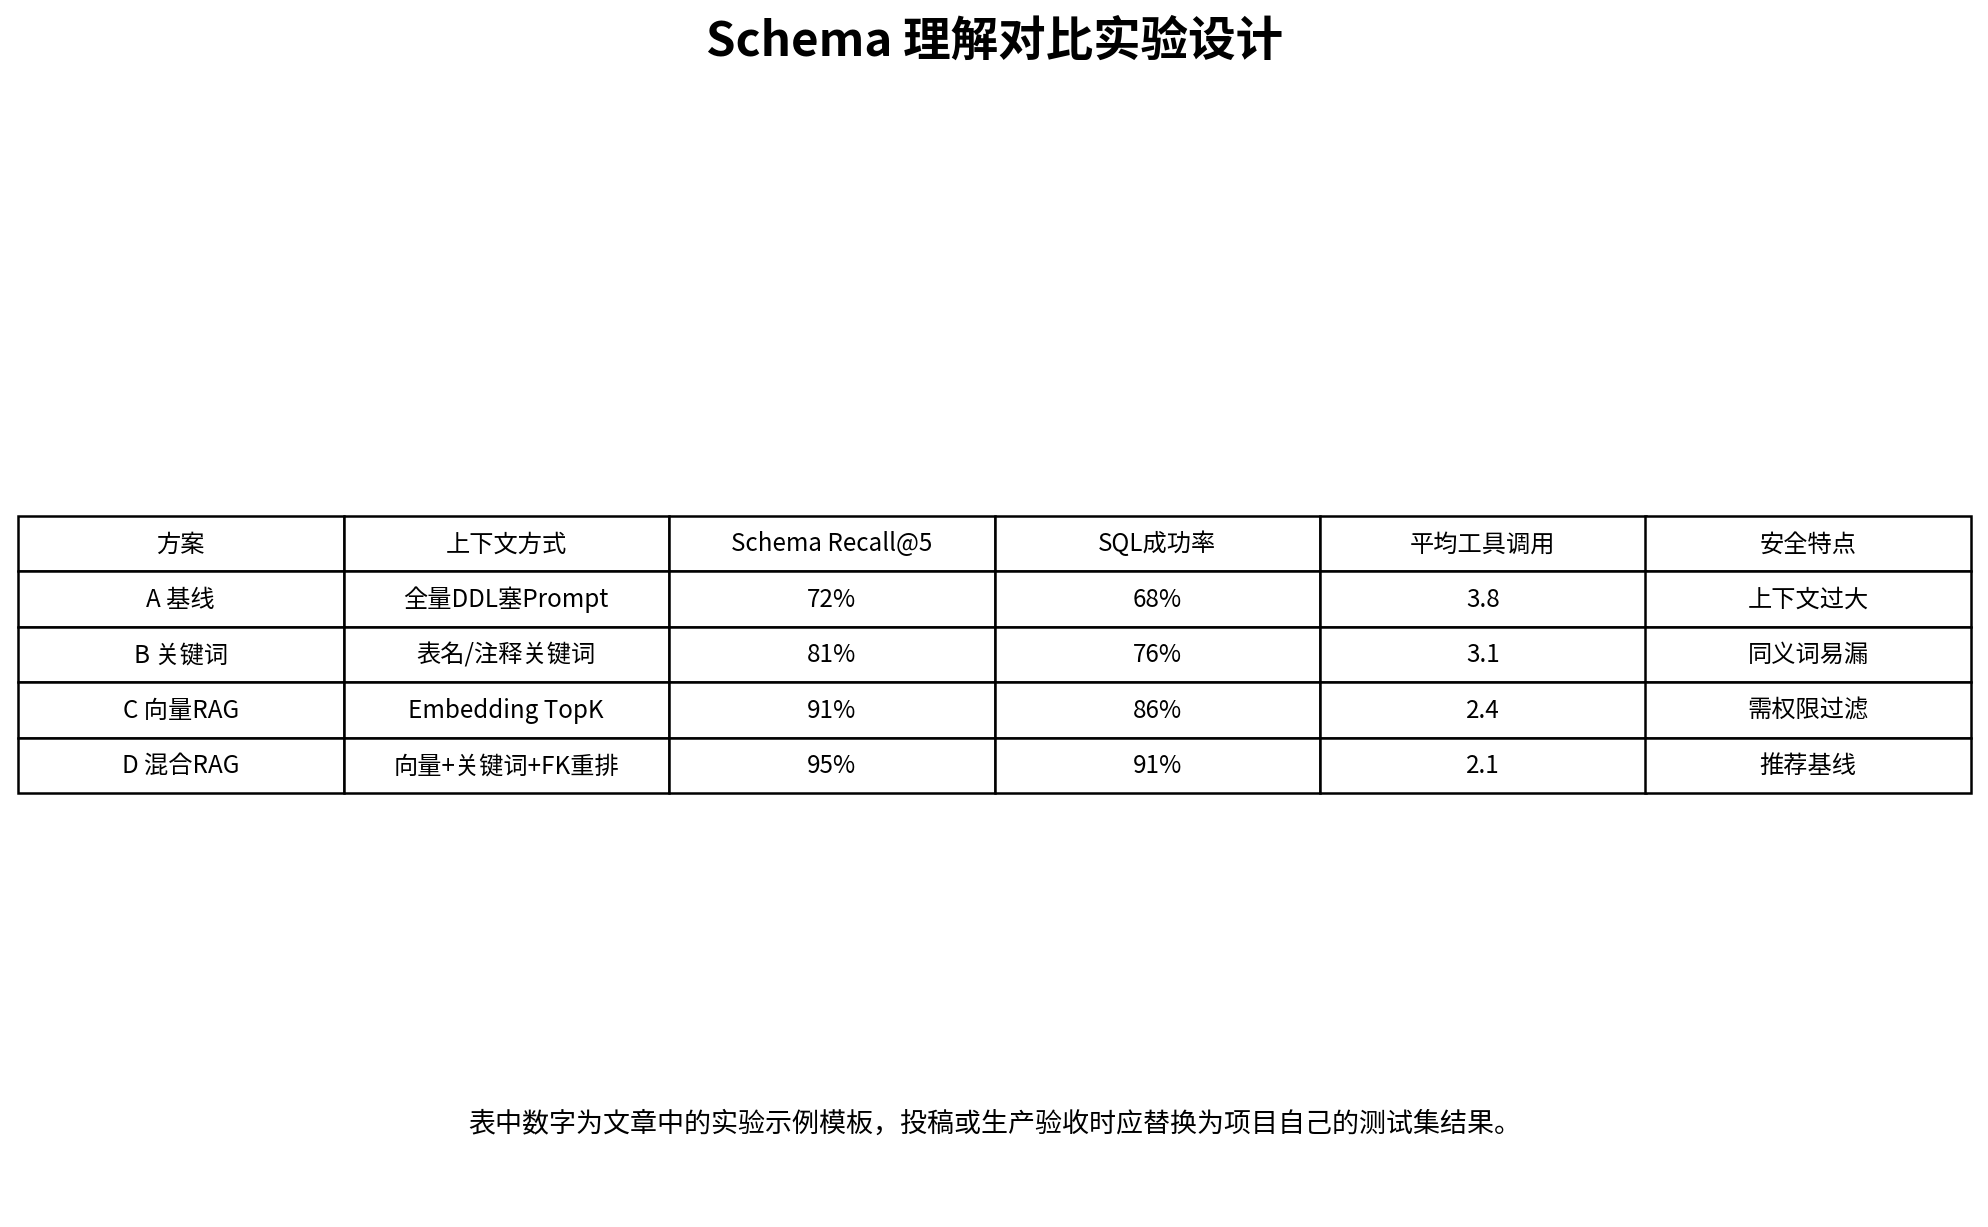
对比四组:
A:全量 DDL
B:关键词搜索
C:纯向量 RAG
D:向量 + 关键词 + 关系重排
4.28 Schema Recall@K
指标:
Schema Recall@5
定义:
正确答案真正需要的表
是否出现在 Top5 候选中。
例如标准答案需要:
payment_order
channel_config
Top5 都包含,则:
召回成功。
4.29 SQL Execution Success
生成 SQL 后真正执行。
统计:
语法成功
权限成功
运行成功
结果非空
不要只让模型自己评价 SQL。
4.30 Tool Calls / Request
这是非常关键的 Agent 指标。
RAG 的价值之一就是把:
先 describe 10 张表
减少为:
直接命中 3 张核心表。
4.31 Correct Answer Rate
最终还要人工或自动评估:
答案是否正确
因为:
SQL 能跑
不等于:
业务语义正确。
4.32 一个示例结果
示例实验:
| 方案 | Recall@5 | SQL 成功率 | 平均 Tool Call |
|---|---|---|---|
| 全量 DDL | 72% | 68% | 3.8 |
| 关键词 | 81% | 76% | 3.1 |
| 向量 RAG | 91% | 86% | 2.4 |
| Hybrid RAG | 95% | 91% | 2.1 |
这些数字用于说明实验方法,不代表任何产品官方成绩。
真正投稿时,建议替换成自己的实际测试结果。
5. 结果对比
不使用 RAG
流程:
用户问题
-> Agent 查看大量 Schema
-> 多次 describe_table
-> 尝试 SQL
-> 失败后重新找表
典型问题:
上下文大
工具调用多
容易选历史表
容易选同名字段
延迟高
使用 Schema RAG
流程:
用户问题
-> Embedding
-> TopK Schema
-> Hybrid 重排
-> 权限过滤
-> Agent 规划
-> MCP Tool
-> 数据库
得到的是一个:
最小必要 Schema 上下文。
这会同时改善:
模型输入长度
工具选择
SQL 成功率
平均工具调用次数
查询延迟
最重要的变化
RAG 并不是让模型“记住数据库”。
而是:
让模型在每个问题里只看到最相关、最允许访问的一小部分数据库结构。
这对复杂 Schema 比单纯扩大上下文更有效。
6. 风险与复盘
6.1 向量相似不等于业务正确
名字相似的两个表:
payment_order
payment_order_history
都可能得高分。
所以必须加入:
时效
表类型
关系
关键词
重排。
6.2 Schema Embedding 会过期
表结构变化后,如果索引没更新:
Agent 会依据旧 Schema 规划。
必须建立:
Schema Version
DDL 事件
索引刷新
机制。
6.3 Embedding 索引本身也有权限问题
不能因为:
只是元数据
就认为无敏感信息。
表名和字段名本身可能暴露:
风控策略
客户等级
内部审批
安全域
所以检索前就要做 ACL。
6.4 不要把真实业务数据大量写进向量库
Schema RAG 主要需要:
结构
语义
关系
少量脱敏样例
不是数据湖复制。
6.5 TopK 越大不一定越好
TopK 过大:
召回提高
但噪声也提高
最终要通过测试集找平衡。
6.6 pgvector/向量库不是性能万能药
向量检索本身也有:
索引构建
内存
召回率
过滤
更新成本
需要压测。
6.7 SQL 成功率不能作为唯一指标
一个 SQL 可以:
执行成功
但查错表。
最终仍要评估业务答案正确率。
6.8 RAG 不应拥有数据库写权限
RAG 的职责是:
检索上下文。
写操作必须经过明确工具和事务边界。
6.9 MCP Server 才是执行安全边界
模型和 RAG 都可能犯错。
最终必须由:
Tool Schema
授权
SQL 验证
数据库账号
结果治理
阻止危险访问。
结语
复杂数据库里,AI Agent 写 SQL 的最大难点往往不是 SQL 语法,而是:
先理解应该查哪里。
把所有 DDL 一次性塞给模型,只能在 Schema 较小时工作。
当数据库变成:
几百张表
多个业务域
多个历史版本
复杂权限
更可靠的路径是:
Schema 元数据
-> Embedding
-> 向量召回
-> 关键词/关系重排
-> 权限过滤
-> Agent 规划
-> KFS MCP Server 受控工具
-> 数据库真实执行
可以把本文的核心原则总结成一句话:
RAG 负责帮 Agent 找对 Schema,
MCP 负责限制 Agent 能做什么,
数据库负责给出最终真实答案。
只有把“理解、执行、安全”三个层次拆开,RAG+SQL 才不会变成一个拥有无限数据库权限的黑盒 Agent,而能真正成为复杂数据库上的可治理在线助手。
转载自:https://blog.csdn.net/u014727709/article/details/165357062
欢迎 👍点赞✍评论⭐收藏,欢迎指正

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 1
 0
- 0


 已为社区贡献39条内容

所有评论(0)