AI Agent 查询延迟如何拆分与优化——KFS MCP Server、链路耗时与缓存方案
文章目录
- 每日一句正能量
- 前言
- 1. 背景与问题
- 2. 环境与数据
- 3. 复现过程
- 4. 方案实施
- 4.1 第一层:建立统一 LatencyTracker
- 4.2 MCP 工具调用也要分内部阶段
- 4.3 不要暴露“任意 SQL”工具
- 4.4 MCP Tool Schema 应限制参数
- 4.5 工具白名单
- 4.6 数据库账号最小权限
- 4.7 第一级缓存:会话缓存
- 4.8 第二级缓存:工具结果缓存
- 4.9 权限必须进入缓存 Key
- 4.10 第三级缓存:元数据缓存
- 4.11 什么绝对不要长期缓存
- 4.12 结果集裁剪
- 4.13 JDBC 查询超时
- 4.14 连接池等待必须单独统计
- 4.15 MyBatis 适配
- 4.16 JPA/Hibernate 适配
- 4.17 Agent 不应该拥有数据库事务控制权
- 4.18 写工具的事务边界
- 4.19 工具错误要结构化
- 4.20 防止 Agent 重试风暴
- 4.21 总延迟预算
- 4.22 并行工具调用
- 4.23 一个用户请求不能占满连接池
- 4.24 KFS MCP Server 安全控制链
- 4.25 敏感字段脱敏
- 4.26 工具调用审计
- 4.27 效果评估不能只看平均延迟
- 4.28 一组示例对比
- 4.29 效果评估还要看答案质量
- 4.30 推荐评估公式
- 5. 结果对比
- 6. 风险与复盘
- 结语
每日一句正能量
当你真正快起来的时候,整个世界都会为你让路。
当你足够专注、行动足够坚定时,会自然产生一种聚焦的“势能”,许多障碍会因其微不足道而自动退却,资源也会向清晰的目标汇聚。
前言
AI Agent 接入数据库后,用户最直观的感受不是“模型多聪明”,而是“为什么问一句数据问题要等这么久”。
传统接口慢,通常还能从网关、应用、SQL 三层排查;Agent 慢则不一样。一条看似简单的请求,背后可能经历:
用户输入
-> 模型理解问题
-> 规划是否调用工具
-> MCP 工具发现
-> 选择 KFS MCP Server 工具
-> 工具参数生成
-> 权限校验
-> 数据库连接
-> SQL 执行
-> 结果序列化
-> 结果裁剪与脱敏
-> 模型二次生成
-> 返回用户
任何一段慢 300ms,总耗时就可能多出一秒以上。
更麻烦的是,团队常常把所有延迟都归因于数据库:“是不是 SQL 慢?”实际线上排查后,经常会发现数据库只占总耗时的 20%~30%,真正拖慢体验的是模型规划、重复工具调用、元数据查询、结果过大以及缓存没有分层。
本文以一个在线数据助手为例,把题目中的 KFS MCP Server 定义为“面向 KFS/数据库能力的 MCP 工具服务层”:它负责向 AI Agent 暴露受控的数据查询、元数据读取和诊断工具。这个定义强调架构角色,不把社区中的命名误写成未经确认的官方产品事实。
本文重点回答四个问题:
1. Agent 延迟究竟该怎么拆?
2. KFS MCP Server 哪一段最值得优化?
3. 缓存应该缓存什么,什么绝对不能缓存?
4. 如何在性能优化时不牺牲数据库安全?
1. 背景与问题
假设在线助手支持自然语言查询:
“帮我看一下今天支付失败率最高的 5 个渠道,并和昨天对比。”
一个普通 BI 接口可能只需要执行两条聚合 SQL。
Agent 却可能产生下面的链路:
第 1 次模型调用:
理解“今天”“昨天”“失败率”“渠道”

第 1 次 MCP 调用:
读取表结构和字段含义

第 2 次模型调用:
根据 Schema 生成查询参数

第 2 次 MCP 调用:
执行今天统计

第 3 次 MCP 调用:
执行昨天统计

第 3 次模型调用:
比较、排序、总结
如果每一步平均 300ms,总耗时很容易超过 2 秒;如果模型或数据库其中一段出现长尾,P99 可能突破 5 秒。
因此第一原则是:
优化之前先拆链路。
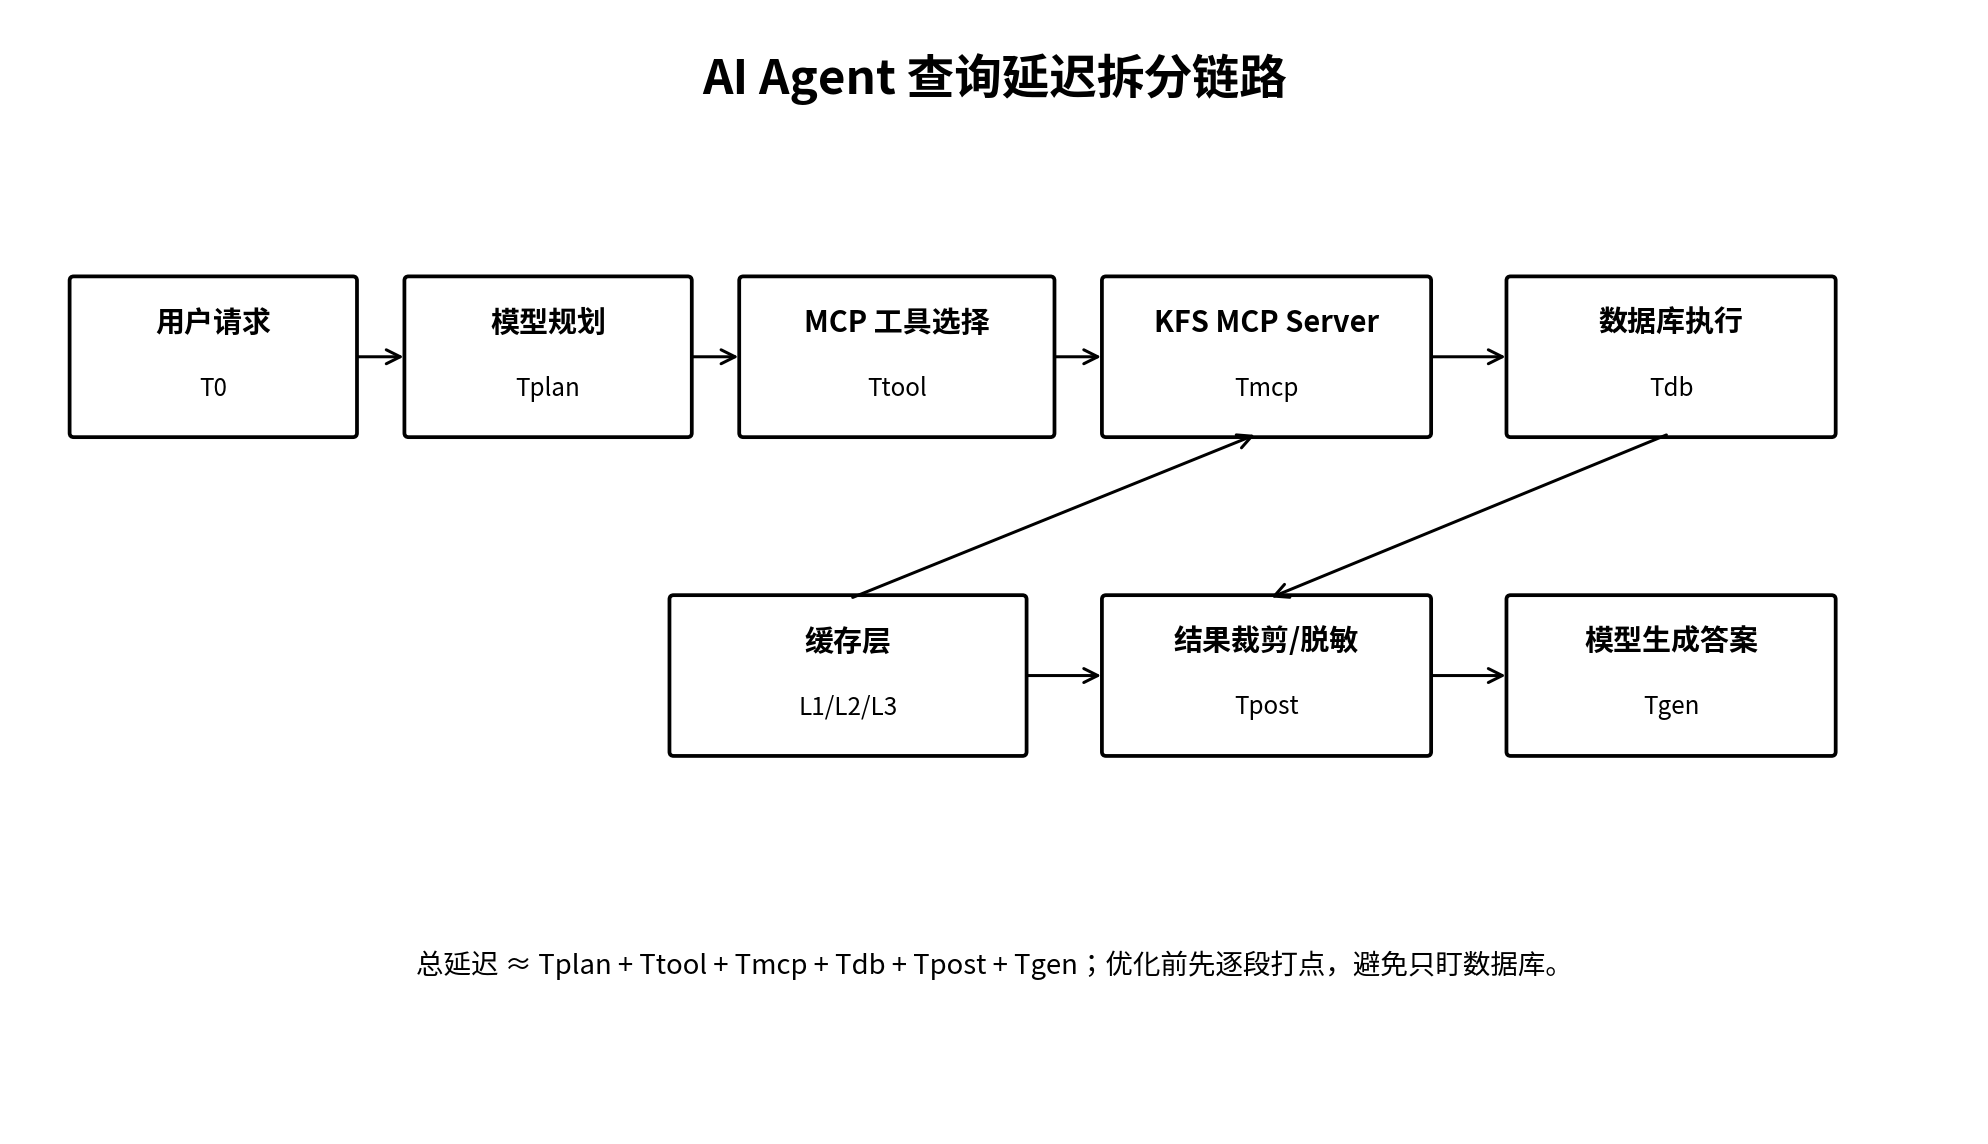
建议把总耗时定义成:
Ttotal
=
Tplan
+ Ttool
+ Tmcp
+ Tdb
+ Tpost
+ Tgen
其中:
Tplan:模型首次理解与规划
Ttool:工具发现、工具选择和参数构造
Tmcp:MCP 协议、鉴权、网络和服务编排
Tdb:数据库连接等待 + SQL 执行
Tpost:结果裁剪、脱敏、序列化
Tgen:模型基于工具结果生成答案
只有把每段量出来,才知道优化应该落在哪里。
2. 环境与数据
示例环境:
JDK 21
Spring Boot 3.3+
KingbaseES / PostgreSQL 类数据库
KFS MCP Server(本文架构中的 MCP 工具层)
HikariCP
MyBatis / JDBC
Redis
OpenTelemetry
Prometheus
业务表:
CREATE TABLE payment_order (
    id BIGINT PRIMARY KEY,
    order_no VARCHAR(64) NOT NULL,
    channel_code VARCHAR(32) NOT NULL,
    amount NUMERIC(18,2) NOT NULL,
    pay_status VARCHAR(16) NOT NULL,
    created_at TIMESTAMP NOT NULL
);
索引:
CREATE INDEX idx_payment_channel_time
ON payment_order(
    channel_code,
    created_at
);
查询失败率:
SELECT
    channel_code,
    COUNT(*) AS total_count,
    SUM(
        CASE
            WHEN pay_status = 'FAILED'
            THEN 1
            ELSE 0
        END
    ) AS failed_count
FROM payment_order
WHERE created_at >= ?
  AND created_at < ?
GROUP BY channel_code;
这个 SQL 本身并不复杂。
真正要测试的是:
Agent 从收到问题到得到这份结果,
中间到底发生了多少次工具调用。
3. 复现过程
下面是 Agent 请求从用户输入到返回结果的完整链路,以及各耗时阶段:
说明:
Tdb只是整条链路中的一小段,数据库通常只占总耗时的 20%~30%,真正拖慢体验的是模型规划、重复工具调用、元数据查询与结果过大。
3.1 先记录整条链路,而不是只记录 SQL
建议给每次 Agent 请求生成:
traceId
例如:
agt-20260809-7f91
一次调用日志:
{
  "traceId": "agt-20260809-7f91",
  "stage": "agent_plan",
  "durationMs": 420
}
MCP:
{
  "traceId": "agt-20260809-7f91",
  "stage": "mcp_call",
  "tool": "query_payment_failure_rate",
  "durationMs": 185
}
数据库:
{
  "traceId": "agt-20260809-7f91",
  "stage": "db_query",
  "sqlDigest": "pay_failure_rate_v2",
  "poolWaitMs": 8,
  "executeMs": 72,
  "rows": 12
}
最终:
{
  "traceId": "agt-20260809-7f91",
  "stage": "llm_generate",
  "durationMs": 690
}
这样才能得到真正的瀑布图。
3.2 复现重复 Tool Call
常见现象:
Agent 第一次查表结构
Agent 第二次又查表结构
Agent 第三次再次确认枚举含义
同一个会话里可能连续调用:
describe_table
describe_column
get_enum_values
这些元数据实际上几分钟内都不会变化。
如果完全不缓存:
工具调用次数越多,
延迟线性增加。
3.3 复现“数据库很快,但 Agent 很慢”
示例:
Tplan = 580ms
Ttool = 160ms
Tmcp = 120ms
Tdb = 68ms
Tpost = 95ms
Tgen = 760ms
总计:
1783ms
数据库只占:
68ms
如果团队只去调索引,哪怕把 SQL 从 68ms 优化到 30ms,用户也几乎感受不到。
3.4 复现结果过大
错误工具:
query_sql(sql)
允许模型直接查询:
SELECT *
FROM payment_order
WHERE created_at >= ...
一次返回几万行。
后果:
数据库读取慢
网络传输慢
JSON 序列化慢
Token 数增加
模型生成更慢
所以性能问题会被结果集放大。
4. 方案实施
4.1 第一层:建立统一 LatencyTracker
Java:
public final class LatencyTracker
        implements AutoCloseable {

    private final String traceId;
    private final String stage;
    private final long start;

    public LatencyTracker(
            String traceId,
            String stage) {

        this.traceId = traceId;
        this.stage = stage;
        this.start = System.nanoTime();
    }

    @Override
    public void close() {

        long durationMs =
            TimeUnit.NANOSECONDS
                .toMillis(
                    System.nanoTime()
                    - start
                );

        log.info(
            "traceId={}, stage={}, durationMs={}",
            traceId,
            stage,
            durationMs
        );
    }
}
使用:
try (var ignored =
         new LatencyTracker(
             traceId,
             "mcp_query"
         )) {

    return mcpClient.call(toolRequest);
}
不要只记录:
总耗时。
总耗时无法直接指导优化。
4.2 MCP 工具调用也要分内部阶段
KFS MCP Server 内部建议继续拆:
auth
validate
cache_lookup
pool_wait
db_execute
serialize
mask
例如:
public ToolResult execute(
        QueryToolRequest request) {

    validate(request);

    CacheKey key =
        cacheKeyBuilder.build(request);

    Optional<ToolResult> cached =
        cache.get(key);

    if (cached.isPresent()) {
        return cached.get();
    }

    ToolResult result =
        repository.query(request);

    ToolResult safe =
        masker.mask(result);

    cache.put(
        key,
        safe,
        Duration.ofSeconds(30)
    );

    return safe;
}
4.3 不要暴露“任意 SQL”工具
最危险的 MCP 设计之一:
execute_sql(sqlText)
它既是安全问题,也是性能问题。
模型可能生成:
无 LIMIT
无时间范围
低选择性条件
复杂 JOIN
更推荐把工具设计成业务化参数接口:
{
  "tool": "query_payment_failure_rate",
  "arguments": {
    "startTime": "...",
    "endTime": "...",
    "topN": 5
  }
}
服务器内部使用固定 SQL 模板:
SELECT ...
WHERE created_at >= ?
  AND created_at < ?
GROUP BY ...
LIMIT ?;
这样同时获得:
参数化
可控执行计划
可缓存
可限流
可审计
4.4 MCP Tool Schema 应限制参数
例如:
{
  "name": "query_payment_failure_rate",
  "inputSchema": {
    "type": "object",
    "properties": {
      "startTime": {
        "type": "string"
      },
      "endTime": {
        "type": "string"
      },
      "topN": {
        "type": "integer",
        "minimum": 1,
        "maximum": 20
      }
    },
    "required": [
      "startTime",
      "endTime"
    ]
  }
}
topN 最大:
20
不是为了限制模型能力,而是为了保护在线数据库。
4.5 工具白名单
建议区分:
READ_ONLY
DIAGNOSE
WRITE
ADMIN
在线助手默认只开放:
READ_ONLY
DIAGNOSE
写工具默认:
deny
如果未来开放写操作,至少需要:
用户二次确认
幂等键
权限校验
事务
审计
4.6 数据库账号最小权限
KFS MCP Server 不应该使用:
DBA
root
superuser
建议单独账号:
agent_reader
只授予:
SELECT
必要的视图
必要函数 EXECUTE
甚至不直接给基础表权限,而只开放安全视图:
CREATE VIEW v_agent_payment_summary
AS
SELECT
    channel_code,
    pay_status,
    amount,
    created_at
FROM payment_order;
敏感字段根本不出现在视图中。
4.7 第一级缓存:会话缓存
同一个 Agent 会话里经常重复查询:
表结构
字段说明
刚刚查询过的统计结果
可以在会话级缓存:
Map<String, ToolResult> sessionCache;
TTL:
10~60 秒
优点:
最快
不经过 Redis
不经过数据库
4.8 第二级缓存:工具结果缓存
适合:
最近 5 分钟统计
渠道列表
只读聚合
Redis Key 不能只写:
query_payment_failure_rate:today
应该包含:
tenant
role
tool
normalized args
data version
例如:
agent:t01:analyst:
payment_failure_rate:
2026-08-09T00:
2026-08-10T00:
top5
4.9 权限必须进入缓存 Key
这是 Agent 缓存最危险的坑。
用户 A:
有全部渠道权限
用户 B:
只能看渠道 01
如果缓存 Key 不含权限上下文:
B 可能命中 A 的结果。
因此要加入:
permissionFingerprint
例如:
String fingerprint =
    sha256(
        tenantId
        + role
        + allowedChannels
    );
4.10 第三级缓存:元数据缓存
Schema、工具描述、字段说明通常变化低频。
可以缓存:
table schema
column comments
enum mappings
tool metadata
TTL:
5~30 分钟
如果发布 DDL,则主动失效。
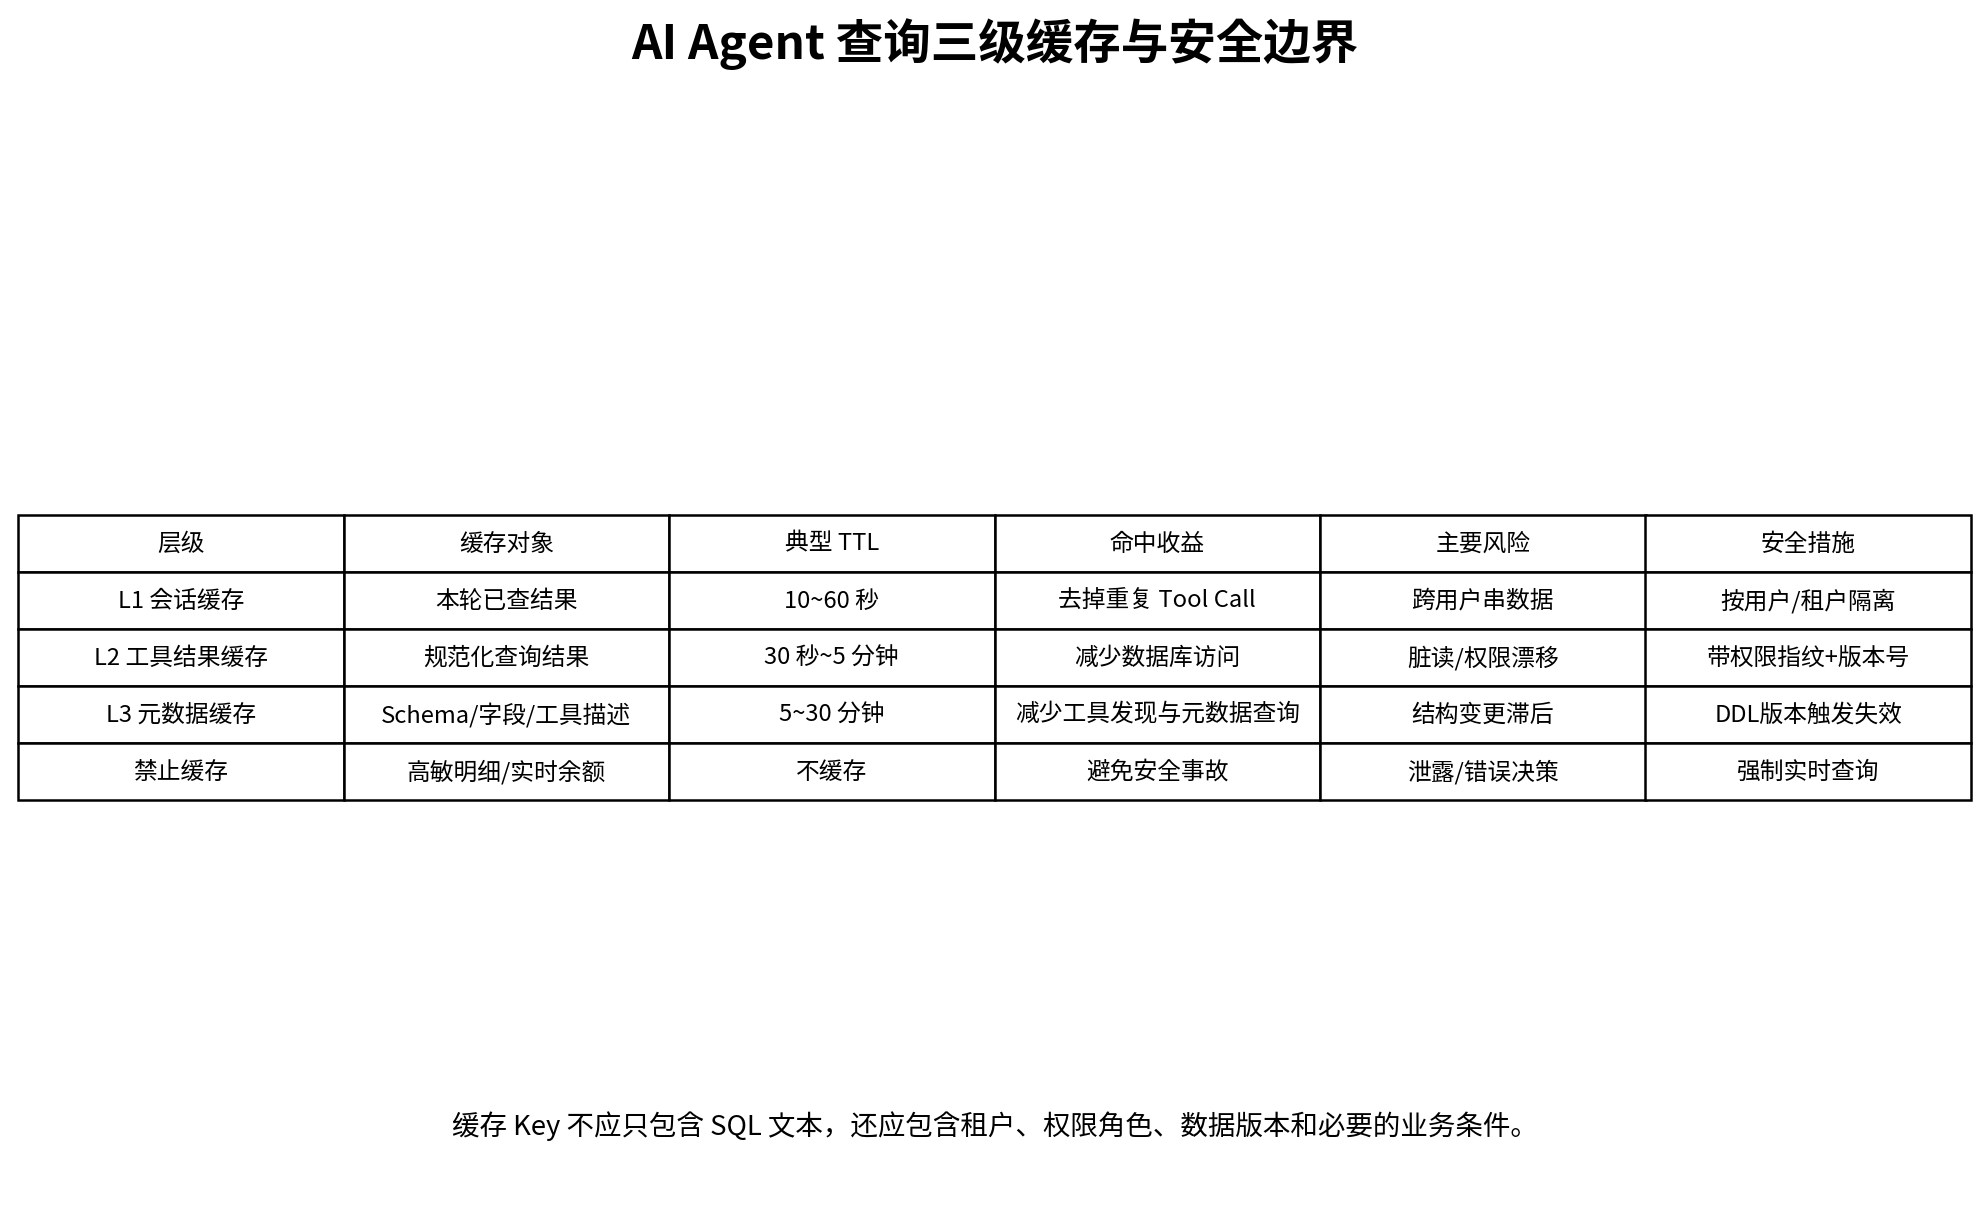
4.11 什么绝对不要长期缓存
例如:
账户实时余额
库存剩余量
审批状态
安全权限判断结果
高敏明细
这些要么实时性要求高,要么缓存错误会导致安全问题。
所以缓存优化必须先做:
数据分级。
4.12 结果集裁剪
数据库查询结果不要原样喂给模型。
例如:
10000 行
先在 MCP Server 做:
聚合
TopN
字段裁剪
最大行数
代码:
if (rows.size() > 200) {
    throw new ToolResultTooLargeException();
}
更进一步:
数据库只返回聚合后的 20 行。
这比查 1 万行后再让模型总结更快、更安全。
4.13 JDBC 查询超时
try (PreparedStatement ps =
         connection.prepareStatement(sql)) {

    ps.setQueryTimeout(2);

    ...
}
在线 Agent 工具不能允许数据库无限执行。
Spring JdbcTemplate:
jdbcTemplate.setQueryTimeout(2);
也可针对特定查询设置。
4.14 连接池等待必须单独统计
很多所谓:
SQL 800ms
实际可能是:
pool wait = 650ms
execute = 150ms
如果不拆:
连接池等待
会错误优化 SQL。
建议:
poolWaitMs
executeMs
分开记录。
4.15 MyBatis 适配
Mapper:
<select id="queryFailureRate"
        resultType="ChannelFailureRow">
    SELECT
        channel_code,
        COUNT(*) AS total_count,
        SUM(
            CASE
                WHEN pay_status = 'FAILED'
                THEN 1
                ELSE 0
            END
        ) AS failed_count
    FROM payment_order
    WHERE created_at >= #{start}
      AND created_at < #{end}
    GROUP BY channel_code
    ORDER BY failed_count DESC
    LIMIT #{topN}
</select>
所有 Agent 参数都走:
#{}
不要让模型输入进入:
${}
4.16 JPA/Hibernate 适配
Native Query:
List<Object[]> rows =
    entityManager
        .createNativeQuery("""
            SELECT
                channel_code,
                COUNT(*),
                SUM(
                    CASE
                        WHEN pay_status='FAILED'
                        THEN 1 ELSE 0
                    END
                )
            FROM payment_order
            WHERE created_at >= :start
              AND created_at < :end
            GROUP BY channel_code
        """)
        .setParameter("start", start)
        .setParameter("end", end)
        .setMaxResults(20)
        .getResultList();
复杂统计类工具建议明确 SQL,不要为了“全部 ORM 化”牺牲执行计划可控性。
4.17 Agent 不应该拥有数据库事务控制权
不要设计工具:
begin_transaction
commit
rollback
让模型自己决定事务生命周期。
在线助手的事务应该由服务端工具实现封装。
例如:
@Transactional(readOnly = true)
public QueryResult queryFailureRate(...) {
    return repository.query(...);
}
模型只看:
工具输入
工具输出
看不到事务控制细节。
4.18 写工具的事务边界
如果确实需要:
创建工单
写备注
更新状态
MCP Server 暴露的是:
create_ticket
而不是三条任意 SQL。
内部:
@Transactional
public TicketResult createTicket(
        CreateTicketCommand cmd) {

    ticketRepository.insert(cmd);

    auditRepository.insert(...);

    return ...;
}
任何一步失败:
整体回滚。
4.19 工具错误要结构化
不要返回:
java.sql.SQLException: ...
推荐:
{
  "code": "DB_QUERY_TIMEOUT",
  "retryable": true,
  "message": "查询超过在线工具时限",
  "traceId": "agt-20260809-7f91"
}
模型可以根据:
retryable
决定是否换查询范围,而不是盲目再次调用完全相同工具。
4.20 防止 Agent 重试风暴
一个常见危险链路:
DB timeout
-> Agent 认为工具失败
-> 再调一次
-> 再 timeout
-> 再调一次
一次用户请求可能放大成 3~5 次数据库查询。
服务端必须设置:
maxToolCalls
maxSameToolRetries
budgetMs
例如:
if (context.sameToolAttempts(toolName) >= 2) {
    throw new AgentBudgetExceededException();
}
4.21 总延迟预算
可以给每个请求一个:
3000ms
预算。
分配:
规划:600ms
MCP + 鉴权:200ms
数据库:800ms
结果处理:200ms
最终生成:1000ms
预留:200ms
如果数据库已经耗时:
1500ms
后续 Agent 就应该:
停止继续深挖
返回部分结果
而不是继续调三个工具直到用户超时。
4.22 并行工具调用
今天和昨天两个统计:
互不依赖
可以并行:
CompletableFuture<Result> today =
    supplyAsync(() ->
        query(todayRange)
    );

CompletableFuture<Result> yesterday =
    supplyAsync(() ->
        query(yesterdayRange)
    );
但并行不是越多越好。
要结合:
连接池大小
数据库并发容量
Agent 单请求 fan-out
设上限。
4.23 一个用户请求不能占满连接池
假设:
连接池 30
单个 Agent 请求同时发 20 个 Tool Call:
一个用户就能吃掉大半连接。
建议每请求:
maxConcurrentTools = 3
4.24 KFS MCP Server 安全控制链
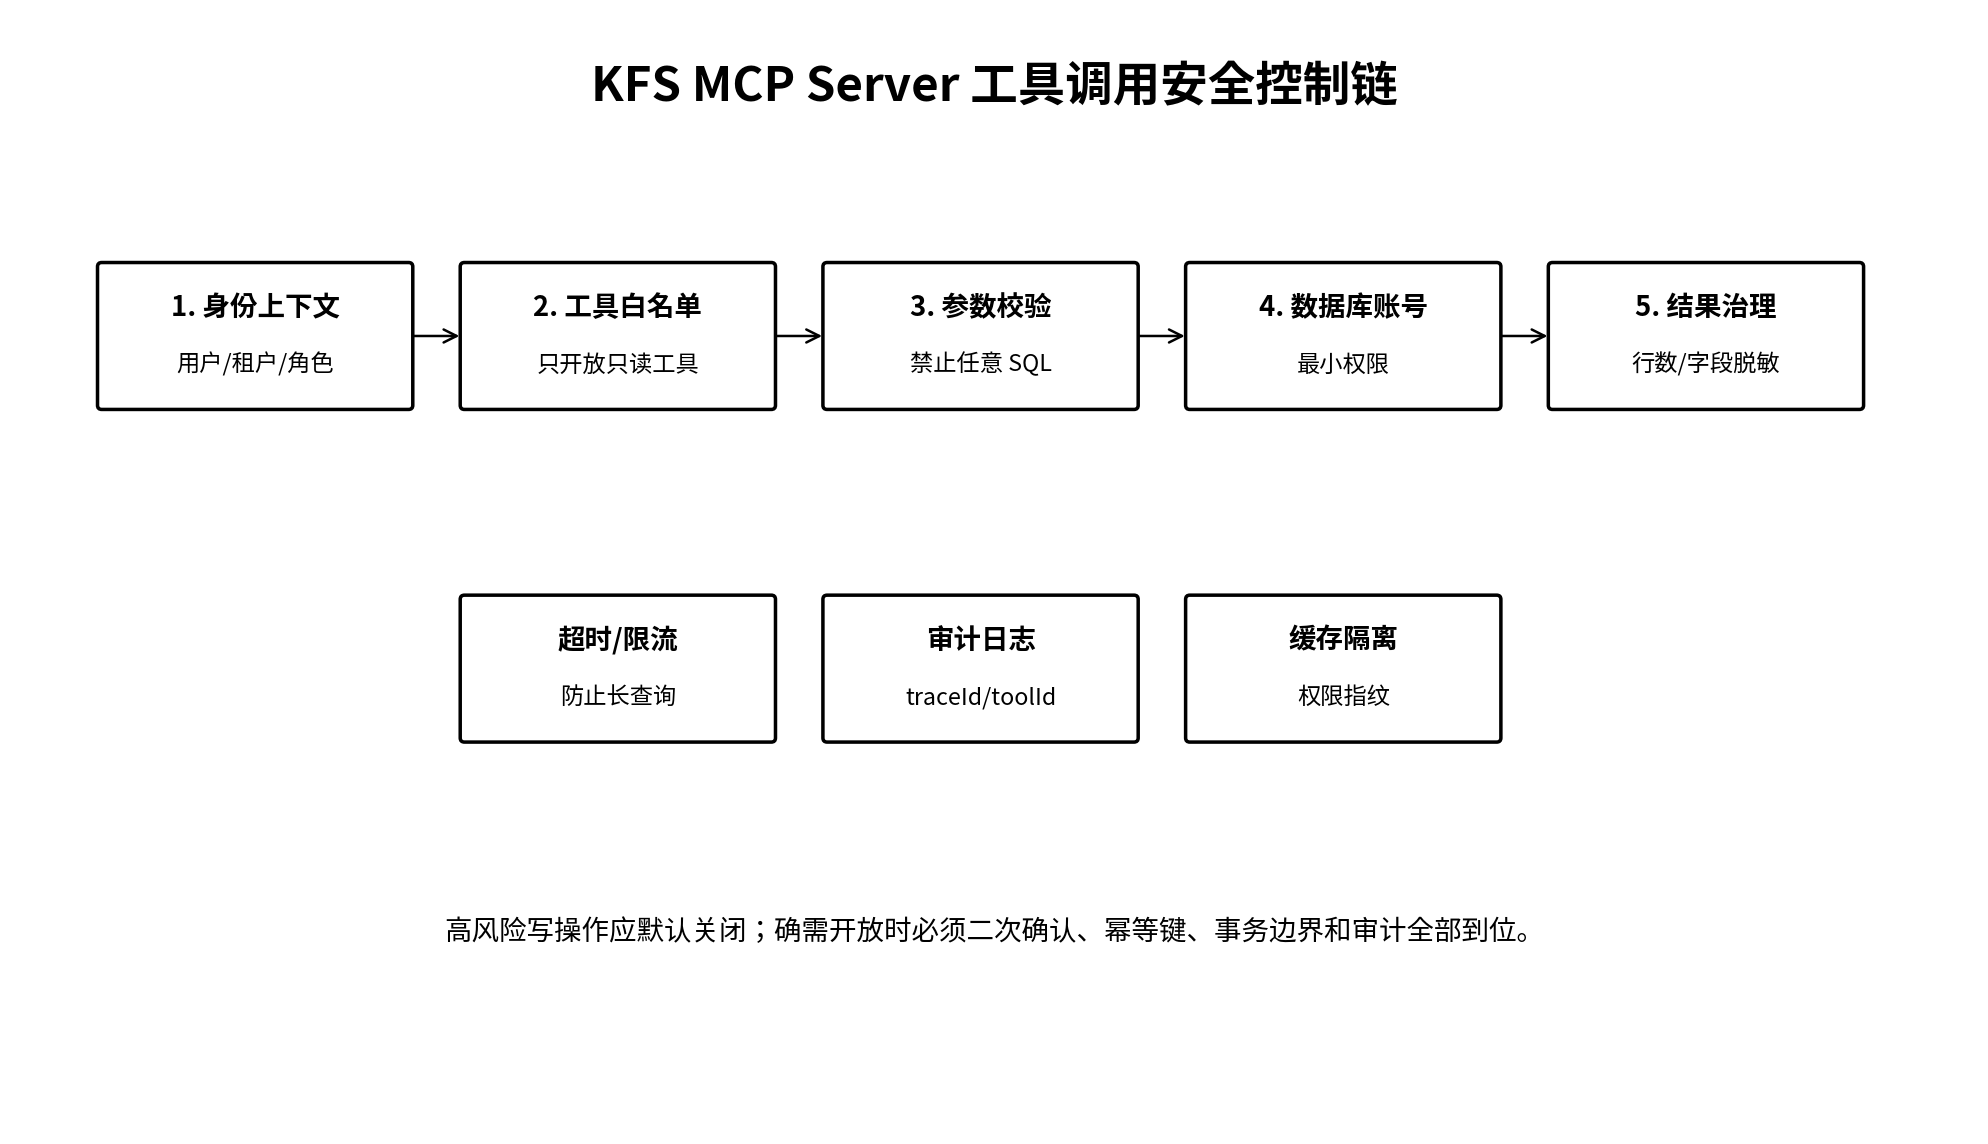
建议顺序:
身份
-> 工具授权
-> 参数校验
-> 查询限额
-> 数据库最小权限
-> 结果脱敏
-> 审计
任何一层都不能因为“模型已经判断过”就省略。
模型不是安全边界。
4.25 敏感字段脱敏
例如:
手机号
身份证
银行卡
地址
在 MCP Server 输出前处理:
row.setMobile(
    maskMobile(row.getMobile())
);
不要把完整数据先发给模型,再要求模型“不要显示”。
4.26 工具调用审计
至少记录:
traceId
userId
tenantId
model
toolName
normalizedArgs
cacheHit
rows
durationMs
sqlDigest
resultClass
errorCode
但不要记录:
密码
Token
完整身份证
敏感 SQL 参数
4.27 效果评估不能只看平均延迟
至少:
P50
P95
P99
Tool Calls / Request
DB Queries / Request
Cache Hit Rate
Result Rows
Token Usage
Timeout Rate
Retry Amplification
4.28 一组示例对比
优化前:
P50:2.1s
P95:4.8s
P99:7.2s
平均 Tool Call:4.3
平均 DB Query:3.1
缓存命中率:0%
优化后示例:
P50:1.2s
P95:2.6s
P99:4.1s
平均 Tool Call:2.7
平均 DB Query:1.8
缓存命中率:42%
这些数字只是示例,真正文章或项目验收应使用自己的压测结果。
4.29 效果评估还要看答案质量
性能优化不能让 Agent:
为了快而少查关键数据。
所以要同时评估:
答案正确率
工具选择正确率
字段引用准确率
数据时效性
权限违规率
一个 P95 下降 50%,但答案准确率从 95% 降到 80% 的方案不能上线。
4.30 推荐评估公式
可以建立综合分:
Score
=
0.35 × Correctness
+ 0.25 × Latency
+ 0.15 × ToolEfficiency
+ 0.15 × Safety
+ 0.10 × Cost
这样避免性能指标绑架整体效果。
5. 结果对比
优化前
链路:
每次都查 Schema
每次都重新调用同一工具
工具支持任意 SQL
结果集过大
无缓存
数据库异常直接重试
表现:
工具调用多
P99 长
数据库 QPS 被 Agent 放大
安全边界模糊
优化后
链路:
会话缓存
+
工具结果缓存
+
元数据缓存
+
业务化 Tool Schema
+
查询行数限制
+
数据库查询超时
+
权限指纹
+
工具调用预算
这时真正被优化的不是某一条 SQL,而是:
一次 Agent 请求产生的“总数据库工作量”。
这是 AI 数据助手和普通 API 最大的性能差异之一。
6. 风险与复盘
6.1 缓存可能把性能问题变成数据问题
错误缓存的危害比慢查询更大。
特别是:
租户
角色
权限范围
实时数据
必须进入缓存设计。
6.2 不要为了减少 Tool Call 把所有信息塞进一个超级工具
超级工具:
query_everything
虽然减少 MCP 往返,却会导致:
参数复杂
权限复杂
结果不可控
无法缓存
难以观测
更好的工具应该:
边界清晰
结果稳定
可单独计时
6.3 并行调用会放大数据库压力
模型层看起来:
从 2 秒降到 1 秒
但如果靠 5 个 SQL 同时跑,数据库压力可能变成原来的几倍。
所以并行优化必须看:
DB CPU
active sessions
connection pool
lock wait
6.4 Tool Call 次数本身就是容量指标
传统 API:
1 请求 ≈ 1 次后端调用
Agent:
1 请求 ≈ N 次工具调用
容量规划必须使用:
User QPS × Avg Tool Calls
而不是只看用户请求数。
6.5 读工具也需要权限
“只读”不等于“安全”。
只读查询仍然可能:
泄露隐私
跨租户读取
全表扫描
拖垮数据库
所以安全控制不能只针对写操作。
6.6 MCP 日志可能成为敏感数据副本
如果日志记录:
完整工具输入
完整数据库输出
等于又复制了一份数据。
应只记录:
摘要
指纹
行数
脱敏字段
6.7 效果评估要长期看 P99
缓存刚上线时平均值通常很好看。
真正要观察的是:
缓存失效瞬间
数据库抖动
并发升高
热点 Key
时 P99 是否仍然稳定。
结语
AI Agent 查询性能优化最大的误区,是继续沿用普通接口的思路:
慢了就看 SQL。
更完整的方法应该是:
先拆 Agent 链路,
再减少无效 Tool Call,
再做缓存,
最后优化真正慢的数据库查询。
对于 KFS MCP Server 这一工具层,最值得投入的不是“让模型拥有更多数据库能力”,而是让每个工具做到:
边界清晰
参数受控
结果有限
权限可审计
延迟可观测
失败可解释
可以把整套方案总结成一句话:
Agent 性能优化,不是让一次 SQL 更快,
而是让一次用户问题产生更少、更安全、更有效的数据库工作。
当链路耗时、工具调用、缓存命中、数据库执行和答案质量都进入同一套评估体系后,AI 数据助手才真正具备在线服务所需要的性能与安全工程能力。
转载自:https://blog.csdn.net/u014727709/article/details/165356679
欢迎 👍点赞✍评论⭐收藏,欢迎指正

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 3
 0
- 0


 已为社区贡献39条内容

所有评论(0)