为什么用n8n构建AI Agent反而增加人工干预?三步调试流程揭示设计缺陷
本文摘要:一个常见的场景:团队期望用n8n快速搭建一个“智能文档问答Agent”,实现自动化检索与生成。但在实际开发中,当工作流复杂后,开发者在可视化界面和日志间切换的时间,可能超过直接编写Python代码。本文的结论是:对于逻辑复杂、状态多变的AI Agent,使用通用工作流平台(如n8n)构建,其调试成本可能高于代码实现,根本原因在于其核心设计围绕确定性任务编排,而非智能体的探索性推理。
一、问题与结论
问题:在n8n中构建需要记忆、工具调用和复杂决策的AI Agent时,开发者常常陷入“配置-运行-查日志”的低效循环,人工干预不减反增。
结论:这种困境源于n8n的三个设计本质:
1. 定位差异:n8n是“工作流自动化平台”,核心是连接确定性任务,而非管理AI的不确定性。
2. 调试抽象:混合了可视化配置与内嵌代码,错误可能发生在任一层或层间数据传递,定位成本高。
3. 状态管理缺失:工作流执行默认无状态,持久化记忆等高级功能需手动构建,引入额外复杂性。
二、排查与选择依据
当AI Agent出现行为异常时,建议按以下流程排查,这能清晰揭示平台的设计边界。
第一步:检查单一节点的输出
在n8n中运行工作流,查看出错节点的“输出”面板。若输入和配置表面无误,但输出错误,问题很可能在节点内部逻辑或外部服务调用。对于AI节点,其内部推理过程如同黑盒。
第二步:检查节点间的数据传递
n8n节点间通过JSON数据传递。错误可能源于上游节点输出的结构与下游节点期望的输入不匹配。你需要在多个节点的输出面板间跳转比对,这比在代码中检查变量状态更繁琐。
第三步:引入外部调试手段
当内部日志不足时(尤其是云服务版),你可能需要:
- 在“Code”节点中插入console.log,将关键信息打印到日志。
- 将AI节点的调用抽离为自定义的API服务,用专业工具调试。
- 直接查看n8n容器日志(仅自托管版可深度操作)。
这个过程已从“低代码配置”退化为“代码级调试”。
替代方案与取舍
以下对比旨在明确不同方案的适用场景,而非评判优劣。
| 方案 | 选择条件 | 主要代价 | 不适用边界 |
|---|---|---|---|
| n8n工作流 | Agent逻辑简单,以API串联为主;需要快速连接大量第三方服务。 | 复杂逻辑调试困难;状态管理需自建;版本控制和自动化测试支持弱。 | 需要精细的错误处理、复杂状态管理、与后端服务深度集成的生产级Agent。 |
| 编程框架(如LangChain/Python) | Agent需要自定义工具、精细控制推理过程、长期维护和迭代。 | 开发门槛高,需要投入编码和基础设施搭建时间。 | 需求极简、仅为原型验证,或团队无软件工程能力。 |
| 专用AI开发平台 | 核心需求是构建和调试对话式AI或知识库应用。 | 平台功能聚焦,可能无法满足复杂的、非对话型的自动化编排需求。 | 需求是通用的、包含大量非AI步骤的业务流程自动化。 |
关键取舍:当你的Agent需要逐步增加“记忆”、“自我纠错”、“动态选择工具”等能力时,n8n的工作流模型会让你不断“打补丁”以实现本该在代码中自然表达的逻辑。此时,切换到代码方案能降低长期维护成本。
三、关键原理
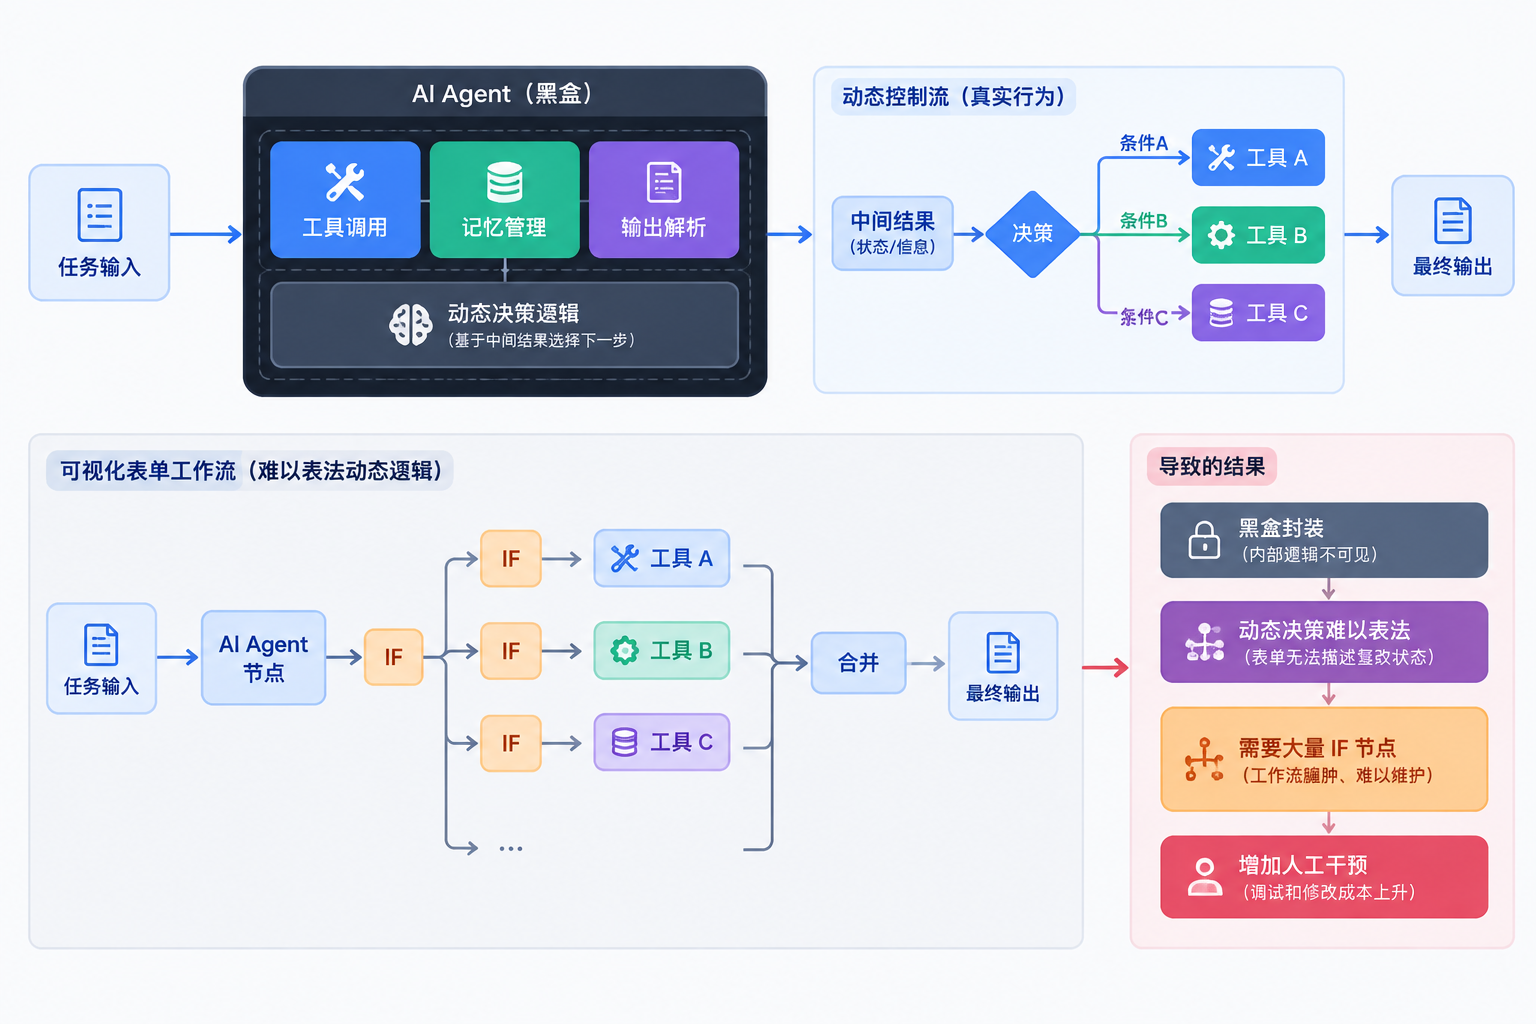
n8n的AI节点(如AI Agent节点)是一个封装好的黑盒。它内部可能集成了工具调用、记忆管理和输出解析。其根本限制在于,一个可视化的、基于表单的配置界面,无法有效表达和调试智能体所需的动态控制流和复杂状态。例如,Agent根据中间结果决定下一步该调用哪个工具,这个决策逻辑在n8n中要么无法表达,要么需要通过大量“IF”节点硬编码,使工作流变得臃肿且难以修改。
四、可运行示例
场景:复现一个简单的AI Agent调试困境。假设我们让n8n中的Agent回答“今天的日期是多少?”,并期望它知道当前日期。
环境:
- n8n v1.38.0+ (自托管,Docker部署)
- 已配置OpenAI API密钥
输入:一个包含问题的JSON,例如 {"question": "今天的日期是多少?"}
操作步骤:
1. 在n8n中创建新工作流。
2. 添加一个 Webhook 触发节点,接收上述JSON。
3. 添加一个 AI Agent 节点。
- 连接Webhook节点。
- 在“Prompt”中填写:“根据问题回答。问题:{{ $json.question }}”。
- 在“System Message”中填写:“你是一个助手,请回答问题。”
- 选择一个模型,如gpt-3.5-turbo。
4. 添加一个 Respond to Webhook 节点,输出AI节点的响应。
5. 激活工作流,通过工具向Webhook发送请求。
预期输出:AI节点可能回答“我是AI,无法获取实时日期”或一个错误的、过去训练数据中的日期。因为AI模型本身没有实时信息。
实际输出:为了获得正确日期,你必须手动增加人工干预:在Webhook和AI Agent节点之间,插入一个 Code 节点,在其中用JavaScript获取当前日期并附加到输入JSON中。例如:
// Code 节点内容 (v1.38.0+ 写法)
export default async function main() {
  const today = new Date().toISOString().split('T')[0];
  const items = this.getInputData();
  items[0].json.today = today;
  return items;
}
然后,在AI节点的Prompt中改为:“今天是{{ $json.today }}。根据问题回答。问题:{{ $json.question }}”。这个为解决一个简单问题而引入的额外节点和数据预处理逻辑,正是“人工干预增加”的微观体现。
一个常见失败及修复:如果Code节点运行后报错“this.getInputData is not a function”,原因可能是代码未正确包裹在导出的主函数中。修复方法是确保在Code节点的“JavaScript Code”编辑框中,代码位于导出的main函数体内,如上所示。
五、验证结果与边界
通过上述示例可以验证,即使解决一个简单问题,也需要手动构建数据预处理逻辑。当问题规模增长,工作流中的Code节点和条件分支会指数级增加,调试和维护成本将远超用Python编写一个等价脚本。
方案边界:
1. 适用:n8n非常适合编排那些输入输出明确、步骤固定的AI任务,例如“定时抓取新闻 -> 用AI摘要 -> 发送邮件”。
2. 不适用:构建需要复杂推理、动态决策、状态持续的AI Agent。此时,通用工作流平台的抽象层反而成为障碍。
思考
- 当项目从POC转向需要持续迭代和状态管理的生产环境时,如何在早期评估并决定是否从n8n切换到编码方案?
- 对于已选择n8n的团队,应设立哪些技术指标(如调试时间占比、工作流节点数)作为“迁移临界点”的预警?
参考资料
- n8n-io/n8n:Fair-code workflow automation platform with native AI capabilities. Combine visual building with custom code, self-host or cloud, 400+ integrations.;https://github.com/n8n-io/n8n

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 5
 0
- 0


 已为社区贡献3条内容

所有评论(0)