CL-07_智能体的跨会话记忆:2026 年方案总结
智能体的跨会话记忆:2026 年方案总结
让 Agent 记住你——跨会话持久记忆的技术方案、实现路径与选型指南。
前言
人类的记忆是连续的。你昨天和朋友聊了什么,上周做了什么决定,去年学到了什么教训——这些记忆构成了你理解世界、做出决策的基础。
但 AI Agent 天生是"失忆"的。每次会话开始,它们都从零开始。这在简单的问答场景中或许可以接受,但当 Agent 承担越来越复杂的角色——个人助理、项目协作者、长期研究伙伴——跨会话记忆就成为不可或缺的能力。
2026 年,跨会话记忆已经从"研究课题"变为"工程实践"。本文将系统梳理当前主流的记忆方案,深入分析每种方案的技术原理、适用场景和实现细节。
跨会话记忆的挑战
在讨论方案之前,我们需要理解跨会话记忆面临的根本性挑战:
1. 记忆的粒度与结构
人类记忆不是扁平的文本列表。它有层次:工作记忆(当前对话上下文)、短期记忆(最近几天的经历)、长期记忆(核心知识和经验)。Agent 的记忆系统也需要类似的层次结构。
2. 记忆的检索与相关性
当 Agent 拥有大量历史记忆时,如何在给定当前上下文的情况下,快速、准确地找到相关记忆?这不仅仅是"搜索"问题,还涉及语义理解、时间衰减和重要性评估。
3. 记忆的一致性与冲突
不同时间记录的记忆可能相互矛盾。用户偏好可能随时间变化。记忆系统需要处理更新、覆盖和版本管理。
4. 记忆的容量与成本
无限存储所有内容既不经济也不高效。记忆系统需要遗忘机制——决定什么值得保留,什么可以丢弃。
5. 隐私与安全
记忆中可能包含敏感的个人信息。跨会话记忆系统必须提供完善的访问控制和数据管理能力。
主流方案分类
2026 年的跨会话记忆方案可以归纳为四大类:
向量数据库方案
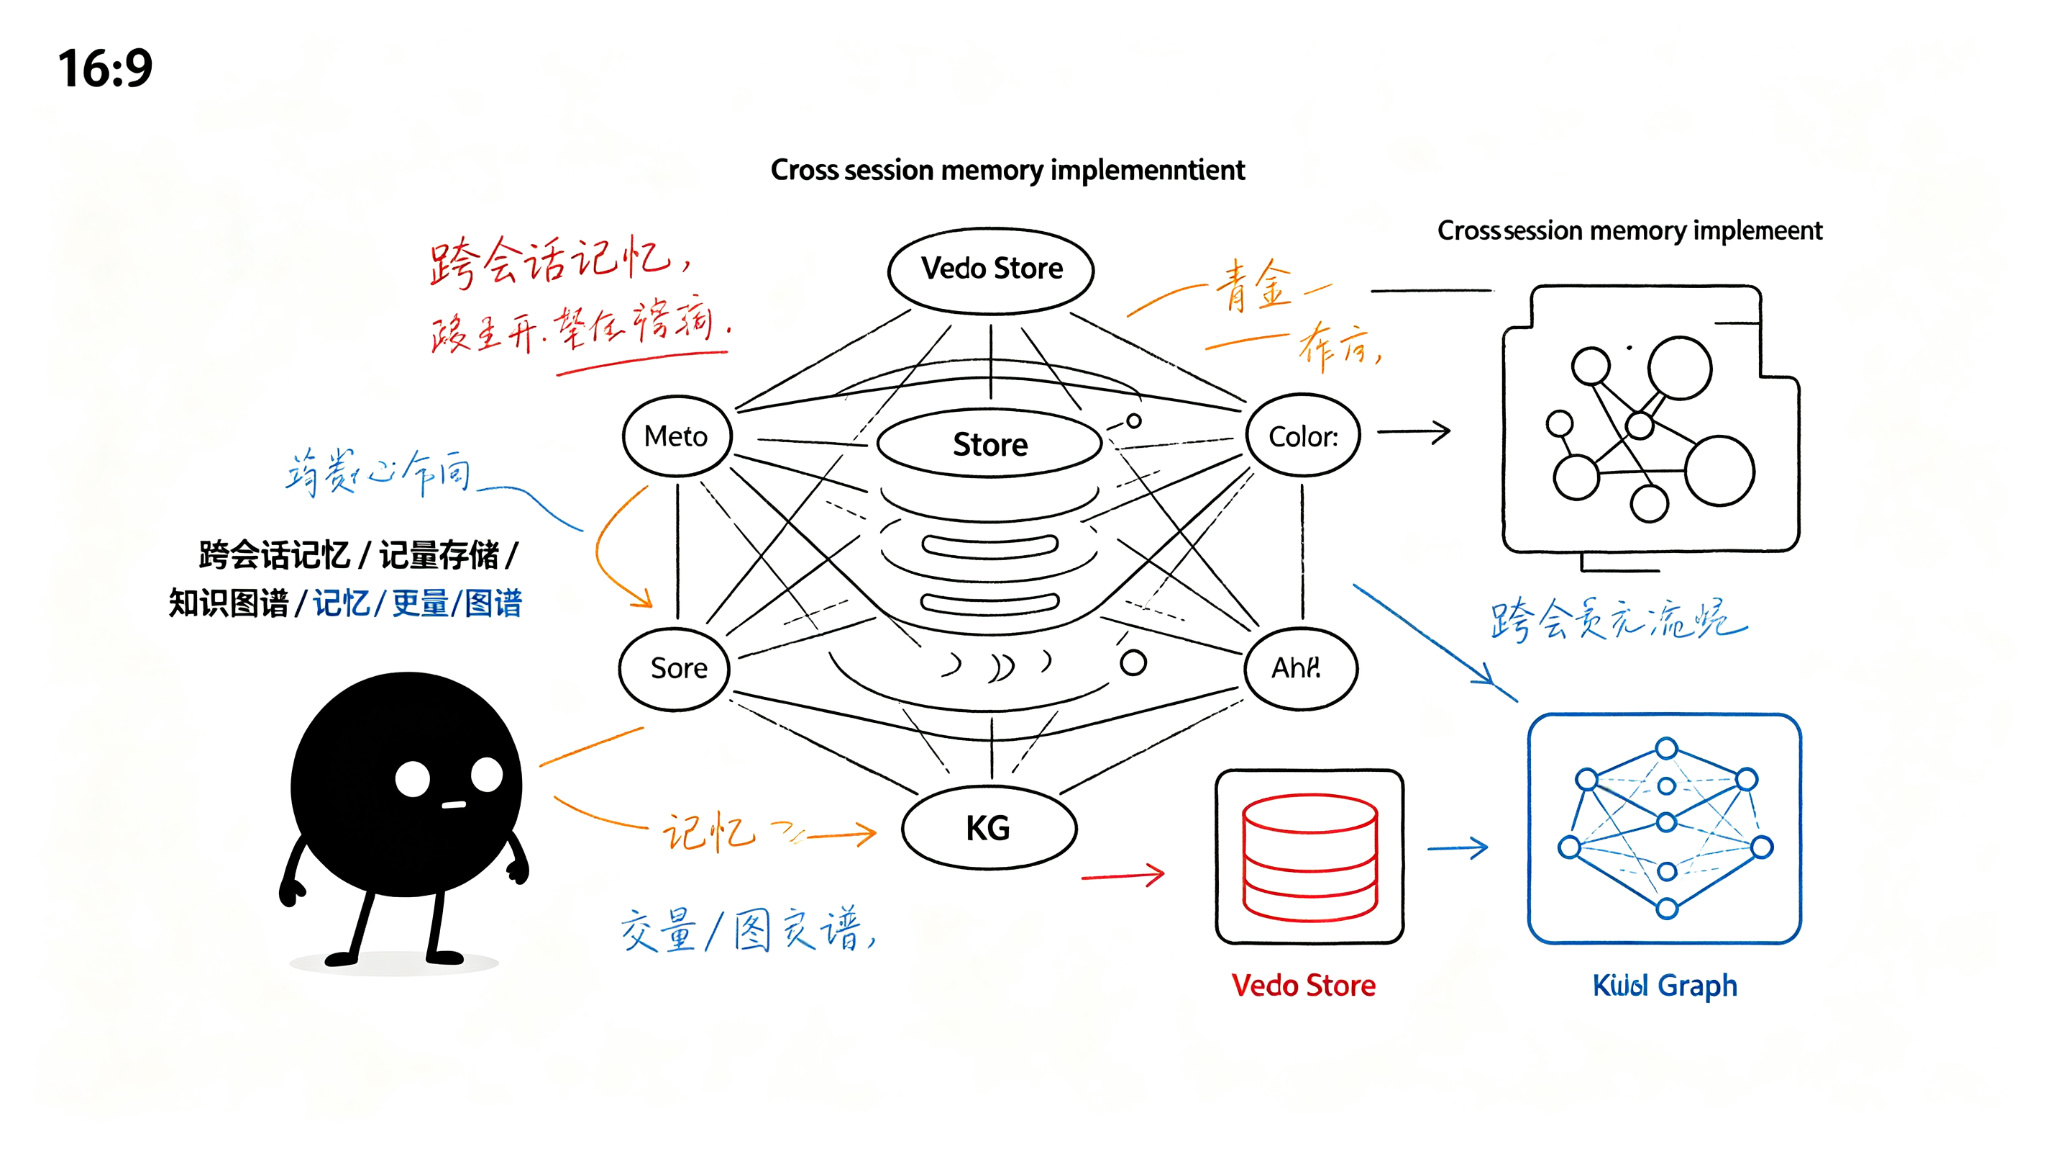
向量数据库方案是目前最广泛采用的跨会话记忆实现方式。其核心思想是:将记忆片段(文本)通过 Embedding 模型转换为向量,存储在向量数据库中;检索时将查询也转换为向量,通过相似度匹配找到最相关的记忆。
技术原理
记忆写入流程:
  原始文本 → 分块 (Chunking) → Embedding → 向量数据库存储

记忆检索流程:
  查询文本 → Embedding → 向量相似度搜索 → Top-K 结果 → 重排序 → 返回
代码示例:基于向量数据库的记忆系统
import uuid
from datetime import datetime
from dataclasses import dataclass, field
from typing import Optional
from openai import OpenAI
import chromadb

@dataclass
class Memory:
    """记忆条目"""
    id: str = field(default_factory=lambda: str(uuid.uuid4()))
    content: str = ""
    memory_type: str = "fact"  # fact / preference / event / instruction
    timestamp: str = field(default_factory=lambda: datetime.now().isoformat())
    importance: float = 0.5  # 0-1, 重要性评分
    access_count: int = 0  # 访问次数,用于衰减计算
    metadata: dict = field(default_factory=dict)

class VectorMemoryStore:
    """基于向量数据库的跨会话记忆存储"""

    def __init__(self, collection_name: str = "agent_memory"):
        self.client = chromadb.PersistentClient(path="./memory_db")
        self.collection = self.client.get_or_create_collection(
            name=collection_name,
            metadata={"hnsw:space": "cosine"}
        )
        self.openai = OpenAI()
        self.memories: dict[str, Memory] = {}

    def _get_embedding(self, text: str) -> list[float]:
        """获取文本的向量表示"""
        response = self.openai.embeddings.create(
            model="text-embedding-3-small",
            input=text
        )
        return response.data[0].embedding

    def add_memory(self, content: str, memory_type: str = "fact",
                   importance: float = 0.5, metadata: dict = None) -> Memory:
        """添加新记忆"""
        memory = Memory(
            content=content,
            memory_type=memory_type,
            importance=importance,
            metadata=metadata or {}
        )

        embedding = self._get_embedding(content)

        self.collection.upsert(
            ids=[memory.id],
            embeddings=[embedding],
            documents=[content],
            metadatas=[{
                "type": memory_type,
                "importance": importance,
                "timestamp": memory.timestamp,
                "access_count": 0
            }]
        )

        self.memories[memory.id] = memory
        return memory

    def search(self, query: str, top_k: int = 5,
               memory_type: Optional[str] = None,
               min_importance: float = 0.0) -> list[Memory]:
        """语义搜索记忆"""
        query_embedding = self._get_embedding(query)

        where_filter = {}
        if memory_type:
            where_filter["type"] = memory_type
        if min_importance > 0:
            where_filter["importance"] = {"$gte": min_importance}

        results = self.collection.query(
            query_embeddings=[query_embedding],
            n_results=top_k,
            where=where_filter if where_filter else None
        )

        memories = []
        for i, doc_id in enumerate(results["ids"][0]):
            if doc_id in self.memories:
                memory = self.memories[doc_id]
                memory.access_count += 1
                memories.append(memory)

        return memories

    def consolidate(self, max_memories: int = 1000):
        """记忆整合:合并相似记忆,删除低重要性记忆"""
        all_memories = sorted(
            self.memories.values(),
            key=lambda m: m.importance * (1 + m.access_count * 0.1)
        )

        if len(all_memories) > max_memories:
            # 删除低分记忆
            to_remove = all_memories[:len(all_memories) - max_memories]
            for memory in to_remove:
                self.collection.delete(ids=[memory.id])
                del self.memories[memory.id]


# 使用示例
store = VectorMemoryStore()

# 添加记忆
store.add_memory(
    "用户喜欢用 Python 编写 Agent,偏好使用 LangGraph 框架",
    memory_type="preference",
    importance=0.8
)

store.add_memory(
    "用户的项目使用 PostgreSQL 作为主数据库,Redis 做缓存",
    memory_type="fact",
    importance=0.7
)

# 检索相关记忆
relevant = store.search("用户的开发偏好是什么?", top_k=3)
for mem in relevant:
    print(f"[{mem.memory_type}] {mem.content}")
代表产品
- Pinecone:全托管向量数据库,适合不想运维基础设施的团队
- Weaviate:开源,支持多模态向量,内置混合搜索
- Qdrant:开源,Rust 实现,性能优异
- ChromaDB:轻量级,适合本地开发和原型验证
结构化存储方案
向量数据库擅长语义检索,但在处理结构化关系(如"用户 A 的偏好是什么"、“项目 B 使用了哪些技术栈”)时效率不如结构化存储。
Knowledge Graph 方案
知识图谱将记忆组织为实体-关系-实体的三元组结构,天然适合表示复杂的关系网络。
from neo4j import GraphDatabase
from datetime import datetime

class GraphMemoryStore:
    """基于知识图谱的跨会话记忆存储"""

    def __init__(self, uri: str, user: str, password: str):
        self.driver = GraphDatabase.driver(uri, auth=(user, password))

    def close(self):
        self.driver.close()

    def add_entity(self, name: str, entity_type: str, properties: dict = None):
        """添加实体节点"""
        props = properties or {}
        props["name"] = name
        props["created_at"] = datetime.now().isoformat()

        with self.driver.session() as session:
            session.run(
                f"MERGE (e:{entity_type} {{name: $name}}) "
                f"SET e += $props",
                name=name, props=props
            )

    def add_relation(self, source: str, target: str,
                     relation: str, properties: dict = None):
        """添加实体间关系"""
        props = properties or {}
        props["created_at"] = datetime.now().isoformat()

        with self.driver.session() as session:
            session.run(
                f"MATCH (a {{name: $source}}), (b {{name: $target}}) "
                f"MERGE (a)-[r:{relation}]->(b) "
                f"SET r += $props",
                source=source, target=target, props=props
            )

    def query_related(self, entity: str, depth: int = 2) -> list[dict]:
        """查询实体的关联记忆"""
        with self.driver.session() as session:
            result = session.run(
                "MATCH path = (e {name: $entity})-[*1..$depth]-(related) "
                "RETURN path LIMIT 50",
                entity=entity, depth=depth
            )
            paths = []
            for record in result:
                path = record["path"]
                paths.append({
                    "nodes": [{"name": n["name"], "labels": list(n.labels)}
                              for n in path.nodes],
                    "relationships": [r.type for r in path.relationships]
                })
            return paths

    def add_memory(self, subject: str, predicate: str, obj: str,
                   context: str = ""):
        """将自然语言记忆转为知识图谱三元组"""
        self.add_entity(subject, "Entity")
        self.add_entity(obj, "Entity")
        self.add_relation(subject, obj, predicate.upper().replace(" ", "_"), {
            "context": context
        })


# 使用示例
store = GraphMemoryStore("bolt://localhost:7687", "neo4j", "password")

# 添加记忆三元组
store.add_memory("用户", "偏好", "Python", "编程语言偏好")
store.add_memory("用户", "使用", "LangGraph", "Agent 框架选择")
store.add_memory("项目A", "依赖", "PostgreSQL", "数据库选型")
store.add_memory("项目A", "部署在", "AWS", "云平台选择")

# 查询关联记忆
related = store.query_related("用户", depth=2)
for path in related:
    print(f"节点: {[n['name'] for n in path['nodes']]}")
    print(f"关系: {path['relationships']}")
代表产品
- Neo4j:最成熟的图数据库,丰富的查询语言(Cypher)
- Mem0:专门为 AI Agent 设计的记忆层,支持图结构和向量检索
- Zep:Agent 记忆平台,提供时间感知的记忆检索
文件系统方案
文件系统方案是最直观、最透明的记忆方式——将记忆存储为人类可读的文件(Markdown、JSON 等),通过目录结构组织层次关系。
这种方案的代表是 OpenClaw 和 MemGPT(现称 Letta)。
设计理念
workspace/
├── MEMORY.md          # 长期记忆(核心知识、偏好、经验)
├── memory/
│   ├── 2026-08-17.md  # 每日记忆日志
│   ├── 2026-08-18.md
│   └── ...
├── USER.md            # 用户画像
└── TOOLS.md           # 工具配置记忆
这种方案的优势在于:
- 完全透明:用户可以直接查看、编辑 Agent 的记忆
- 版本控制友好:可以使用 Git 追踪记忆的演变
- 低基础设施依赖:不需要额外的数据库服务
- 人类可读:记忆以自然语言存储,便于审计和调试
OpenClaw 的记忆架构
OpenClaw 的记忆系统分为三层:
- 会话记忆:当前对话的上下文窗口(模型原生支持)
- 日志记忆:
memory/YYYY-MM-DD.md,每日事件的原始记录 - 长期记忆:
MEMORY.md,从日志记忆中提炼的核心信息
Agent 通过定期的"记忆整合"流程,将日志记忆中的重要内容提炼到长期记忆中,类似人类的"睡眠记忆巩固"。
混合方案
2026 年的最佳实践趋向于混合方案——结合向量检索的语义能力和结构化存储的关系能力。
LangMem 框架
LangMem 是 LangChain 团队推出的记忆管理框架,其核心设计是三种记忆类型的分离:
from langmem import MemoryManager, MemoryType

manager = MemoryManager(
    vector_store="chroma",     # 向量存储
    structured_store="sqlite", # 结构化存储
    embedding_model="text-embedding-3-small"
)

# 语义记忆:关于世界的事实
manager.add(
    content="Paris is the capital of France",
    memory_type=MemoryType.SEMANTIC,
    namespace="knowledge"
)

# 情景记忆:具体的事件和经历
manager.add(
    content="2026-08-18: 用户要求撰写 5 篇 Agent 技术博客",
    memory_type=MemoryType.EPISODIC,
    namespace="interactions/user_123"
)

# 程序记忆:如何执行任务的知识
manager.add(
    content="用户偏好中文写作,每篇博客 3000-5000 字",
    memory_type=MemoryType.PROCEDURAL,
    namespace="preferences/user_123"
)

# 混合检索:同时使用语义和结构化过滤
results = manager.search(
    query="用户的写作偏好",
    memory_types=[MemoryType.SEMANTIC, MemoryType.PROCEDURAL],
    namespace="preferences/user_123",
    top_k=5
)
Mem0 v2
Mem0 在 2026 年推出了 v2 版本,核心升级是图增强记忆——在向量检索的基础上,自动构建记忆之间的关系图谱,实现更智能的记忆检索和关联推理。
方案对比与选型
| 维度 | 向量数据库方案 | 知识图谱方案 | 文件系统方案 | 混合方案 |
|---|---|---|---|---|
| 检索方式 | 语义相似度 | 图遍历/查询 | 全文搜索 + LLM | 语义 + 结构化 |
| 关系建模 | ❌ 弱 | ✅ 强 | ⚠️ 手动 | ✅ 强 |
| 时间感知 | ⚠️ 需额外实现 | ✅ 关系属性 | ✅ 文件日期 | ✅ 内置 |
| 可扩展性 | ✅ 百万级 | ✅ 百万级节点 | ⚠️ 千级文件 | ✅ 百万级 |
| 基础设施 | 需要向量数据库 | 需要图数据库 | 仅文件系统 | 需要多种存储 |
| 透明度 | ❌ 黑盒 | ⚠️ 需工具查看 | ✅ 人类可读 | ⚠️ 中等 |
| 开发复杂度 | 低 | 高 | 极低 | 高 |
| 成本 | 中 | 高 | 极低 | 高 |
| 适用场景 | 通用语义检索 | 复杂关系推理 | 个人助理/小型 Agent | 生产级 Agent 系统 |
选型建议
快速起步 → 文件系统方案
适合个人 Agent、小型项目。零基础设施依赖,完全透明,易于调试。OpenClaw 的 MEMORY.md 方案就是典型代表。
语义检索为主 → 向量数据库方案
适合需要处理大量非结构化文本记忆的场景。ChromaDB 用于开发,Pinecone/Qdrant 用于生产。
关系推理为主 → 知识图谱方案
适合需要理解实体间复杂关系的场景,如企业知识管理、多 Agent 协作。Neo4j 是首选。
生产级系统 → 混合方案
LangMem 或 Mem0 v2 提供了开箱即用的混合记忆能力,适合对记忆质量有高要求的生产环境。
总结
跨会话记忆是 Agent 从"工具"进化为"伙伴"的关键能力。2026 年的技术生态已经提供了多种成熟的方案,从轻量级的文件系统到强大的混合记忆框架,开发者可以根据需求灵活选择。
几个核心观点:
- 没有银弹:每种方案都有其擅长的场景,混合方案是生产环境的最佳选择
- 记忆 ≠ 存储:好的记忆系统需要遗忘机制、重要性评估和时间感知
- 透明度很重要:用户应该能够查看、理解和修改 Agent 的记忆
- 隐私是底线:记忆系统必须提供完善的访问控制和数据管理能力
随着 Agent 承担越来越多的长期任务,跨会话记忆将成为 Agent 基础设施的核心组件。今天的选型决策,将深刻影响明天 Agent 系统的能力上限。
参考文献
- Packer, C. et al. “MemGPT: Towards LLMs as Operating Systems.” arXiv:2310.08560, 2023. https://arxiv.org/abs/2310.08560
- Mem0. “Mem0: The Memory Layer for AI Agents.” GitHub, 2024-2026. https://github.com/mem0ai/mem0
- LangChain. “LangMem: Long-term Memory for AI Agents.” LangChain Blog, 2025. https://blog.langchain.dev/langmem/
- Xu, W. et al. “Chatbot to Counselor: A Survey on Long-term Memory in Conversational AI Agents.” arXiv:2405.12151, 2024. https://arxiv.org/abs/2405.12151
- Neo4j. “Building Knowledge Graphs for AI Agent Memory.” Neo4j Developer Blog, 2025. https://neo4j.com/developer-blog/
本系列覆盖 AI 大模型基础、Agent 开发、MCP 协议、Skill 开发、RAG、模型微调、部署推理 七大方向,从入门到实战的全栈内容持续更新中。
所有文章的 Markdown 源文件、可运行代码、高清配图已整理成完整资料包。
👍 点赞 + ⭐ 关注,评论区扣「1」,挨个发你领取方式 👇

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 2
 0
- 0


 已为社区贡献19条内容

所有评论(0)