AI Agent 终于开始进入“工程化”时代:从会调用工具到可靠完成任务,一文讲透
这几天刷 CSDN,会发现一个非常明显的变化。
大家讨论 AI Agent,已经不只是“怎么调用大模型 API”了。
Multi-Agent、状态管理、Checkpoint、长任务恢复、模型路由、可观测性、成本控制这些词开始频繁出现。
这说明 AI Agent 正在发生一个非常重要的变化:
它正在从“能跑起来”,走向“真正可靠地运行起来”。
一、为什么最近大家都在讨论 Agent 工程化?
前段时间,很多人学习 AI Agent,思路通常是:
调用大模型
   ↓
让模型决定调用工具
   ↓
执行工具
   ↓
返回结果
做到这里,已经可以说:
“我会做 Agent 了。”
但是一旦真正把 Agent 放到项目里,就会马上遇到新的问题:
任务执行到一半崩了怎么办?
模型调用超时怎么办?
工具执行成功,但 Agent 没收到结果怎么办?
一个任务跑了半个小时,服务器重启了怎么办?
多个 Agent 到底怎么通信?
Agent 调用了太多次模型,成本失控怎么办?
最近 CSDN 上出现的“Agent 长周期控制平面”“Checkpoint 设计”“Agent 宕机恢复”“Multi-Agent 协作通信”等文章,本质上讨论的其实都是这些问题。
所以我觉得:
2026 年学习 Agent,已经不能只学 Prompt 和 Tool Calling 了。
真正重要的是:
怎么把 Agent 做成一个可靠的软件系统。
二、AI Agent 真正的难点,已经不是“会不会调用工具”
我们先看一个最简单的 Agent。
例如用户说:
“帮我分析一下这个 Python 项目,并修复测试失败的问题。”
Agent 可能这么工作:
用户提出任务
      ↓
Agent理解需求
      ↓
读取项目
      ↓
分析代码
      ↓
执行测试
      ↓
发现报错
      ↓
修改代码
      ↓
再次测试
      ↓
完成任务
看起来非常完美。
但是,如果:
Agent 执行到第 6 步的时候,服务器突然重启了。
怎么办?
如果系统什么都没记录,那么只能:
重新开始
于是前面的工作全部白做。
这就是为什么 Agent 开始需要:
状态管理 + Checkpoint + 恢复机制。
三、AI Agent 正在从“脚本”变成“系统”
这是我认为这几天 CSDN 热门 Agent 文章背后最值得注意的变化。
以前的 Agent 很像一个脚本:
请求
 ↓
模型
 ↓
工具
 ↓
结果
 ↓
结束
现在成熟一点的 Agent,更像一个完整系统: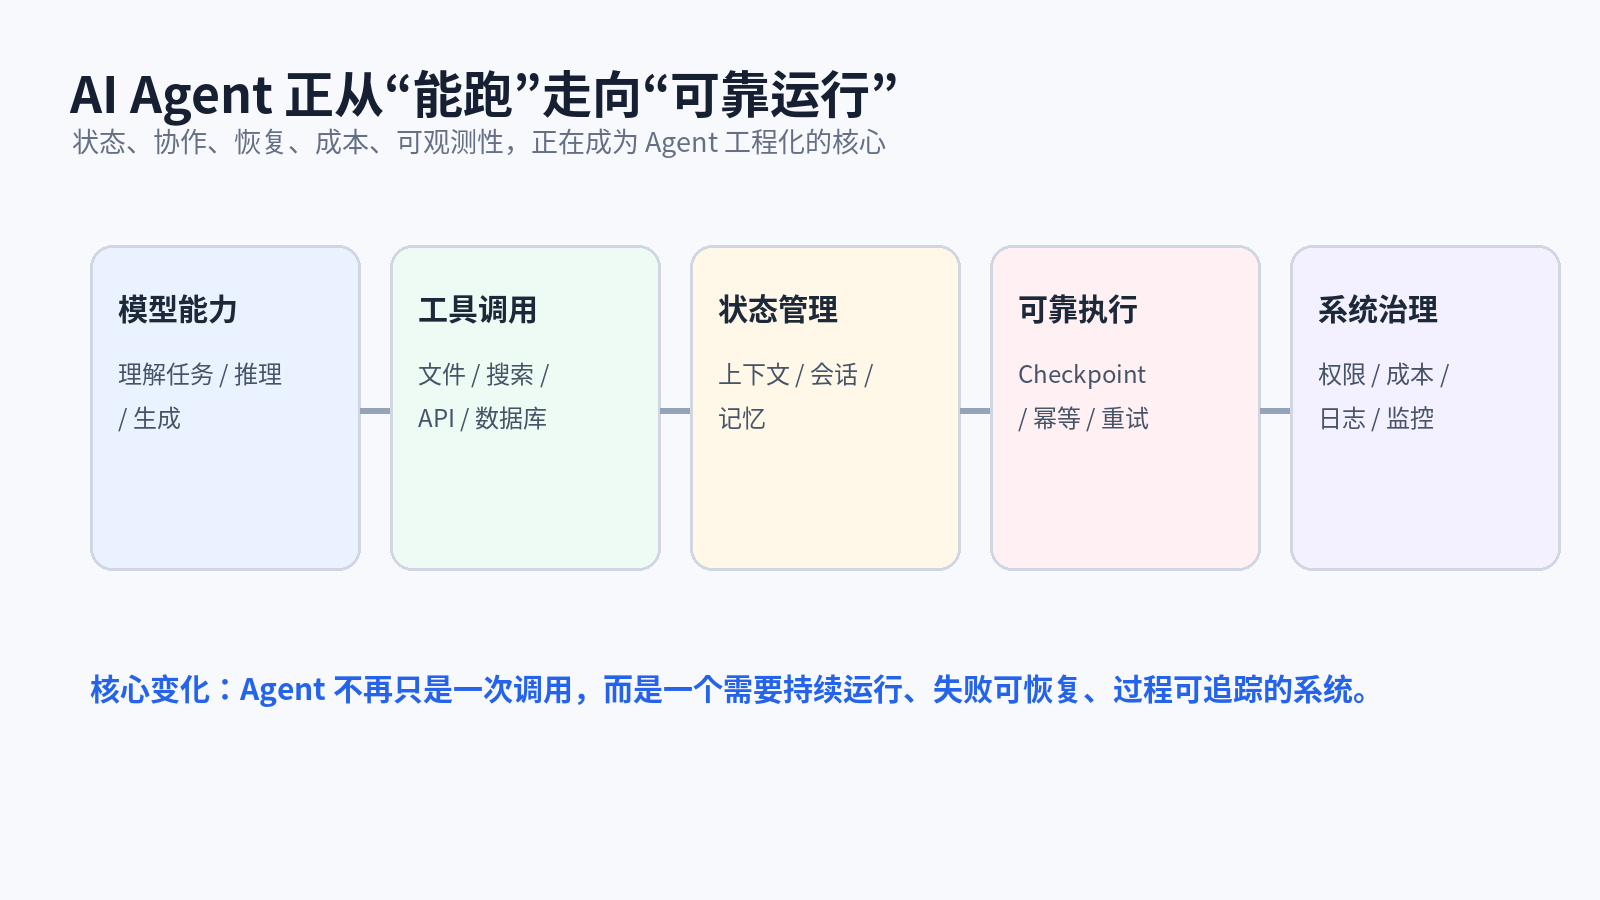
它需要同时解决:
模型能力
+
工具调用
+
状态管理
+
任务恢复
+
权限控制
+
成本管理
+
日志监控
所以现在做 Agent,已经越来越像做后端系统了。
四、第一个关键问题:Agent 的“状态”到底放在哪里?
这个问题看似简单,其实特别重要。
比如:
用户:
帮我生成一份销售分析报告
Agent 可能执行:
第1步:读取数据库
第2步:统计数据
第3步:生成图表
第4步:生成报告
第5步:发送报告
那么系统必须知道:
当前执行到哪一步了?
否则一旦发生异常,Agent 根本不知道:
“我已经做过哪些事情?”
所以一个完整的 Agent 至少需要保存:
任务ID
当前步骤
执行状态
中间结果
工具调用记录
错误信息
上下文
这就是状态。
近期 CSDN 上关于 OpenAI Agents SDK 多轮对话状态管理的文章,也专门讨论了手动维护历史、Session、服务端 continuation 等不同方案。
五、第二个关键问题:Agent 跑到一半挂了怎么办?
这就是 Checkpoint。
假设任务是:
读取文件
 ↓
分析文件
 ↓
生成报告
 ↓
上传报告
执行到:
生成报告
突然服务器挂了。
如果没有 Checkpoint:
任务重新开始
如果有 Checkpoint:
读取文件 ✅
分析文件 ✅
生成报告 ✅
上传报告 ❌

        ↓

恢复

        ↓

直接继续上传
这就非常像游戏存档。
你可以简单把 Checkpoint 理解为:
给 Agent 定期存档。
近期 CSDN 上关于“Agent 跑了 30 分钟宕机,如何从断点继续?”以及“Checkpoint 设计的三大生死关”的内容,讨论的正是这种恢复机制。
六、但是 Checkpoint 不是“每一步都保存”
这里又有一个很容易踩的坑。
很多人第一反应是:
每执行一步就保存。
这样当然安全。
但问题是:
成本太高。
比如 Agent 一次任务执行 500 步。
你每一步都保存状态:
Step 1 保存
Step 2 保存
Step 3 保存
……
Step 500 保存
数据库压力、存储成本和系统复杂度都会上去。
所以更合理的设计通常是:
只在关键节点保存。
例如:
普通推理
  ↓
普通工具调用
  ↓
关键数据变更
  ↓
Checkpoint
  ↓
高风险操作
  ↓
Checkpoint
特别是:
会产生外部影响的操作。
例如:
-
发消息
-
发邮件
-
写数据库
-
创建订单
-
删除数据
-
提交代码
这些操作一定要特别谨慎。
七、第三个关键问题:Agent 失败以后,为什么不能直接重试?
因为:
有些操作不能重复执行。
比如:
给用户转账 100 元
第一次执行成功。
但是 Agent 没收到返回结果。
于是系统认为:
“失败了,再试一次。”
结果:
第一次成功
第二次又成功
用户就损失了 200 元。
所以 Agent 工程里有一个特别重要的概念:
幂等。
简单理解:
同一件事情执行一次和执行很多次,最终结果应该保持一致,或者至少能识别“已经执行过”。
例如:
operation_id = 123456
第一次:
pending → executing → succeeded
第二次再收到:
operation_id = 123456
系统就知道:
这个任务已经执行过。
而不是再执行一次。
八、真正可靠的 Agent,其实是一个“闭环系统”
我们把前面的内容全部组合起来: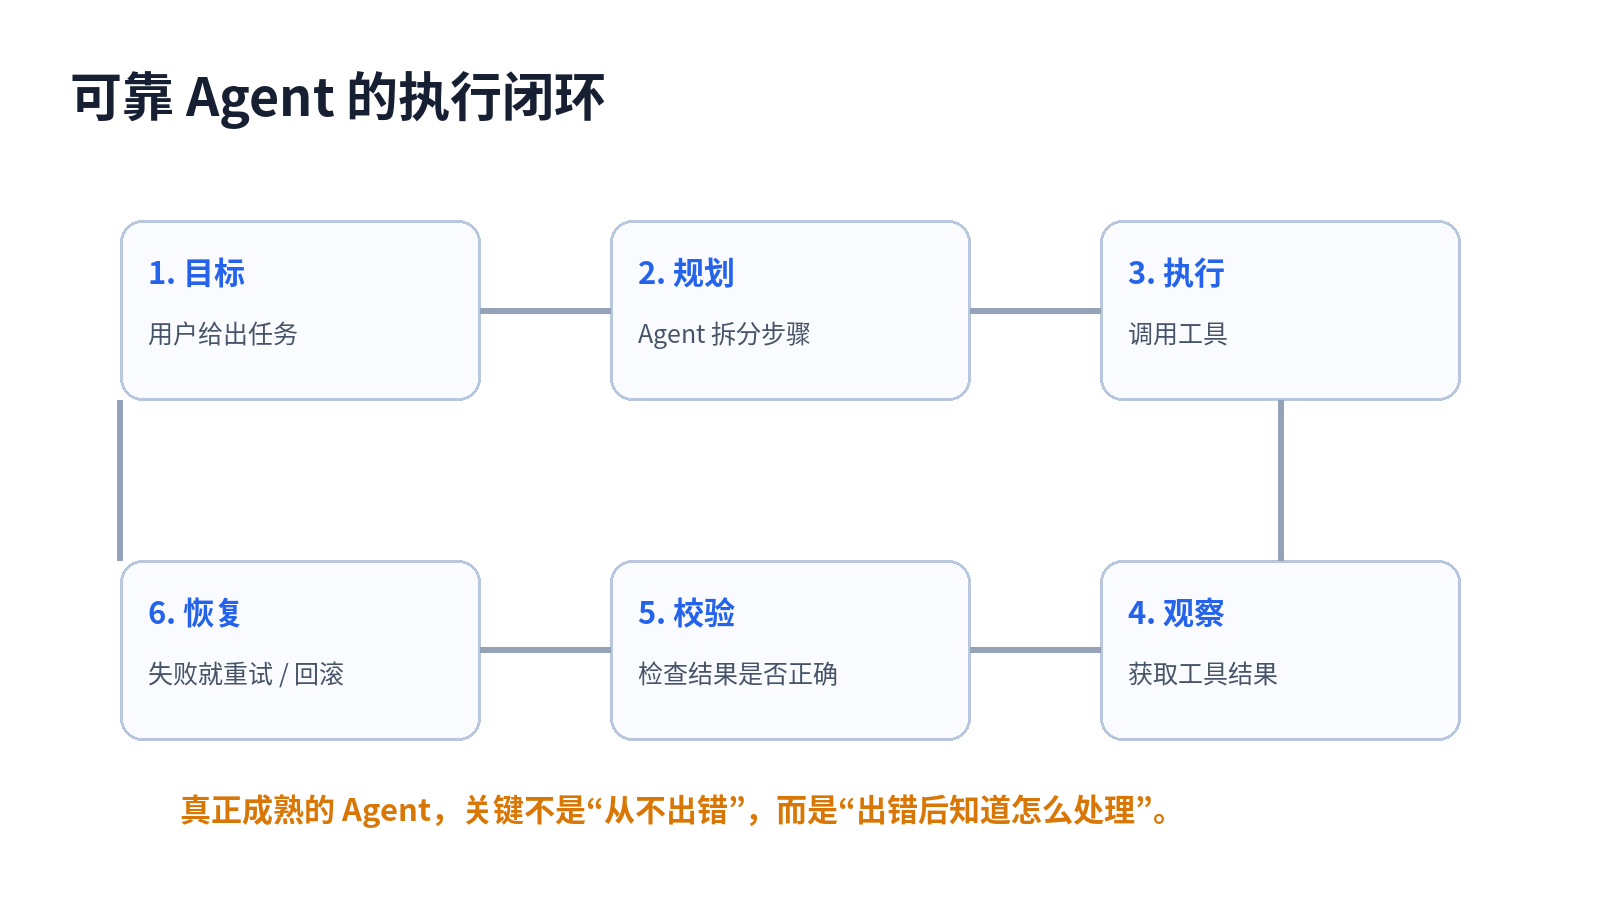
真正可靠的 Agent,不应该只是:
调用工具
 ↓
得到结果
而应该是:
目标
 ↓
规划
 ↓
执行
 ↓
观察
 ↓
校验
 ↓
失败恢复
 ↓
继续执行
这里最重要的一步其实是:
校验。
为什么?
因为 Agent 可能会犯错。
例如:
Agent:
我已经把代码修好了。
不能直接相信。
应该:
Agent 修改代码
      ↓
执行测试
      ↓
检查测试结果
      ↓
通过?
 ↙        ↘
否         是
↓           ↓
继续修改    任务完成
这就是所谓的:
验证闭环。
九、第四个热门方向:Multi-Agent
最近 CSDN 上关于 Multi-Agent 的讨论也非常多。
很多人看到 Multi-Agent,第一反应是:
Agent 越多是不是越厉害?
其实完全不是。
十、Multi-Agent 不是“人越多越好”
举个例子。
如果只是:
“帮我总结一下今天的新闻。”
一个 Agent 完全够了。
没必要:
Agent 1
Agent 2
Agent 3
Agent 4
Agent 5
Agent 6
全部上阵。
因为这时候:
通信成本
+
模型调用成本
+
调试成本
+
协调成本
可能比单个 Agent 更高。
所以:
Multi-Agent 的核心从来不是“多”,而是“分工”。
十一、什么情况下适合 Multi-Agent?
假设我们要做一个:
“自动完成市场调研报告”的系统。
可以这样设计: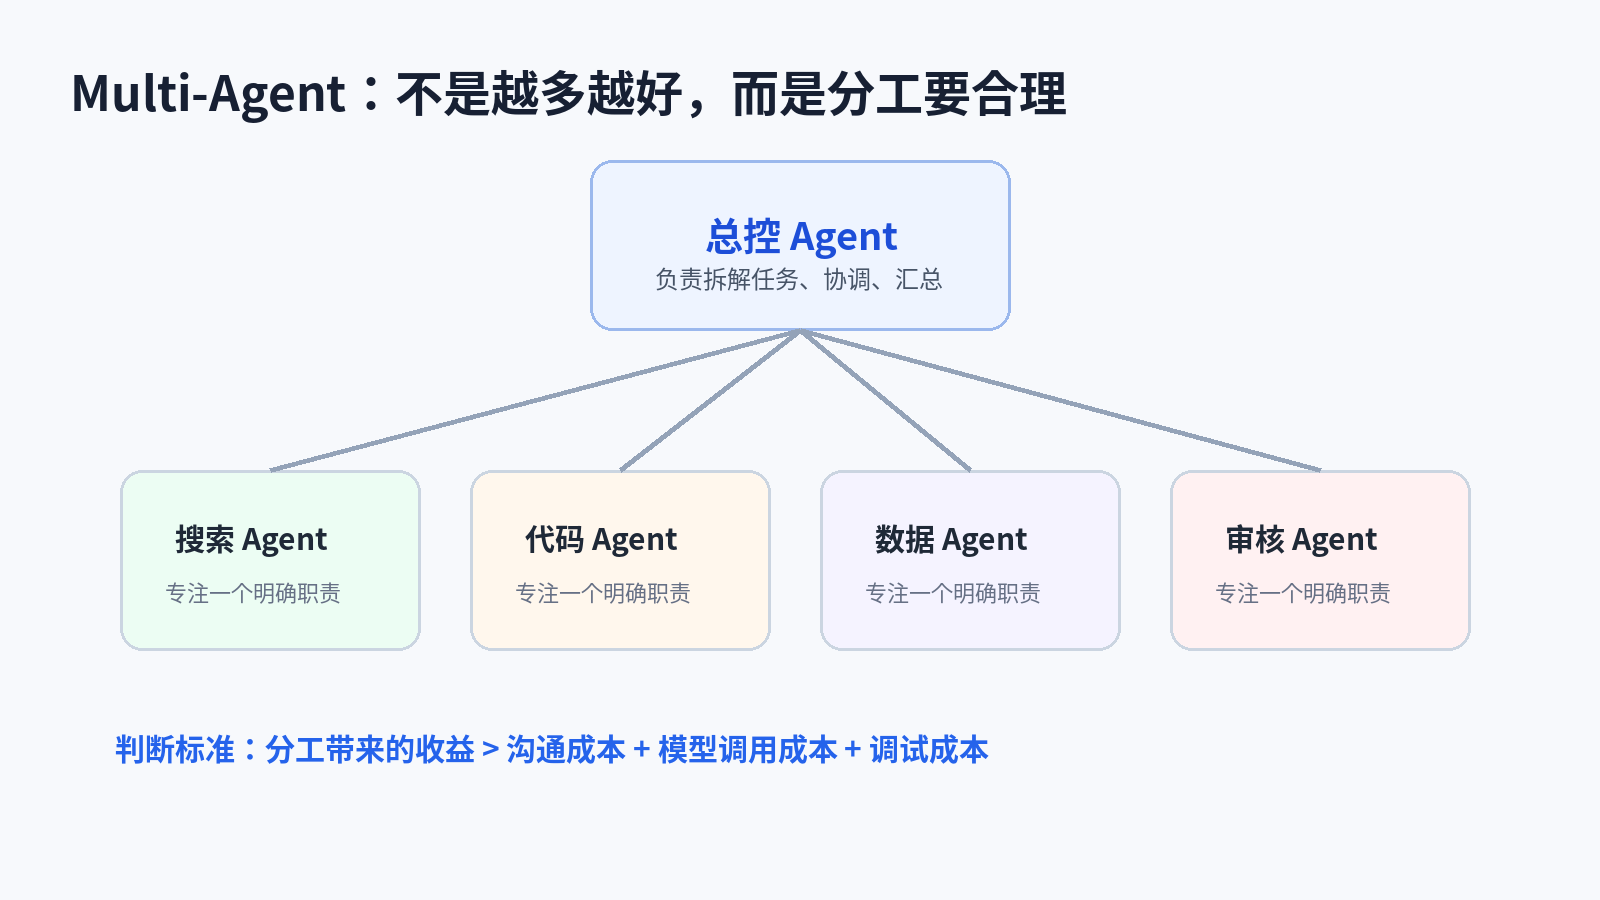
                    总控 Agent
                        ↓
       ┌────────────────┼────────────────┐
       ↓                ↓                ↓
   搜索 Agent         数据 Agent       代码 Agent
       ↓                ↓                ↓
    搜资料             分析数据          跑程序
       ↓                ↓                ↓
       └────────────────┼────────────────┘
                        ↓
                    审核 Agent
                        ↓
                    最终报告
这时候 Multi-Agent 就比较有价值。
因为每个 Agent 都有明确职责。
十二、Multi-Agent 最难的其实不是创建 Agent
而是:
Agent 之间怎么通信。
例如:
搜索 Agent:
我找到 30 条资料。

↓

总控 Agent:
把哪些资料给数据 Agent?

↓

数据 Agent:
分析完了。

↓

总控 Agent:
把结果传给审核 Agent。

↓

审核 Agent:
发现数据有问题。

↓

返回总控 Agent。

↓

重新处理。
这就是一个真正的协作系统。
最近 CSDN 上已经开始出现专门讨论 Multi-Agent 通信协议、状态管理、故障处理、消息结构、幂等重试和全链路可观测性的文章。
这也说明:
Multi-Agent 正在从“概念演示”进入“系统设计”。
十三、第五个热门方向:LLM 路由
最近还有一个很值得关注的方向:
不要所有任务都调用同一个模型。
例如:
简单任务
↓
便宜小模型

复杂任务
↓
强模型

代码任务
↓
代码模型

总结任务
↓
快速模型
这就是:
模型路由。
近期 CSDN 上已经有文章专门讨论“从关键词匹配到可靠路由:用 LLM 做意图识别”,核心也是根据业务目标让不同请求进入不同处理路径。
真正成熟的 Agent 系统,未来很可能不是:
所有请求
 ↓
一个模型
而是:
                      用户请求
                          ↓
                    意图判断 / 路由
                 ↙        ↓        ↘
              简单任务   普通任务   复杂任务
                 ↓        ↓        ↓
              小模型    标准模型   强模型
这样可以同时优化:
效果 + 速度 + 成本。
十四、第六个热门方向:大模型推理优化
Agent 一旦开始真正工作,还有一个现实问题:
太贵了。
为什么?
因为 Agent 往往不是调用一次模型。
可能是:
第1次:理解任务
第2次:分析项目
第3次:选择工具
第4次:读取文件
第5次:分析结果
第6次:修改代码
第7次:运行测试
第8次:再次修改
……
一次任务可能调用十几次甚至几十次模型。
因此:
Agent 的成本优化非常重要。
最近 CSDN 上大模型推理优化类文章也开始密集讨论 TTFT、Prefix Caching、镜像优化等问题。
这代表 AI 应用正在进入一个非常现实的阶段:
不只是“能不能做”,还要考虑“花多少钱做”。
十五、Agent 为什么需要可观测性?
这个问题很多初学者容易忽略。
假设用户告诉你:
“这个 Agent 怎么这么慢?”
你怎么查?
如果没有日志:
不知道
如果有完整 Trace:
任务开始
↓
模型调用 1:1.2 秒
↓
搜索工具:3.4 秒
↓
模型调用 2:2.8 秒
↓
数据库:0.3 秒
↓
模型调用 3:6.2 秒
↓
最终完成
马上就知道:
原来第三次模型调用最慢。
所以生产环境里的 Agent 必须能够记录:
请求ID
任务ID
Agent
模型
工具
耗时
Token
错误
重试
最终结果
这样出了问题才知道:
到底哪里出问题了。
十六、Agent 最后会不会变成一个“软件操作系统”?
这是我觉得特别值得思考的一个方向。
现在的软件:
用户
 ↓
页面
 ↓
按钮
 ↓
接口
 ↓
数据库
未来一些 AI 软件可能变成:
用户
 ↓
目标
 ↓
AI Agent
 ↓
规划
 ↓
工具
 ↓
外部系统
 ↓
完成任务
用户甚至不需要知道:
-
哪个页面
-
哪个接口
-
哪个按钮
-
哪个流程
只需要说:
“帮我把本月销售数据整理成报告。”
然后系统自动:
查数据库
↓
分析数据
↓
生成图表
↓
写报告
↓
检查结果
↓
发送给我
这也是为什么 Agent 最近越来越受关注。
它改变的不只是 AI。
它可能会改变:
软件本身的交互方式。
十七、所以 2026 年学习 AI Agent,到底该学什么?
如果你现在刚开始学习,我不建议一上来就学十几个框架。
可以按照下面这条路线走:
Python
 ↓
大模型 API
 ↓
Prompt
 ↓
结构化输出
 ↓
Tool Calling
 ↓
RAG
 ↓
Agent
 ↓
Memory
 ↓
MCP
 ↓
Skills
 ↓
Multi-Agent
 ↓
Checkpoint
 ↓
Agent 工程化
其中最应该真正搞懂的是:
第一阶段
模型怎么调用?
第二阶段
模型怎么使用工具?
第三阶段
Agent 怎么记住上下文?
第四阶段
Agent 怎么自己循环执行?
第五阶段
Agent 挂了以后怎么恢复?
第六阶段
多个 Agent 怎么协作?
第七阶段
怎么控制成本、权限和风险?
做到这里,你才算真正开始进入:
AI Agent 工程开发。
十八、我觉得 Agent 最终拼的不是“模型有多聪明”
这个观点我非常认同。
模型当然重要。
但如果一个系统:
模型很强
+
没有状态
+
没有恢复
+
没有权限控制
+
没有监控
+
没有成本控制
那么它依然很难成为一个真正可靠的产品。
相反:
不错的模型
+
优秀的工具
+
合理的工作流
+
可靠的状态管理
+
完善的恢复机制
+
可观测性
+
成本控制
它反而可能做出一个真正能落地的 Agent。
所以:
Agent 的竞争,正在从“谁的模型更强”,慢慢进入“谁的系统更可靠”。
十九、最后总结
最近 CSDN 上这些看起来很分散的文章:
Multi-Agent 协作
Agent 状态管理
Checkpoint
长周期 Agent
模型路由
推理优化
可观测性
其实都在讲同一个问题:
AI Agent 如何从 Demo 走向真正可用的生产系统?
过去,我们关心:
模型会不会回答?
现在,我们开始关心:
任务能不能完成?
再往后,我们真正关心的会变成:
任务失败能不能恢复?

执行过程能不能追踪?

成本能不能控制?

权限能不能管理?

多个 Agent 能不能协作?

长任务能不能稳定运行?
这才是 AI Agent 真正进入工程化之后的核心问题。
所以我认为:
2026 年学 Agent,最值得掌握的不是某一个框架,而是一套完整的 Agent 系统思维。
从:
模型 → 工具 → 状态 → 工作流 → 恢复 → 协作 → 监控 → 治理
一步一步学下去。
到那个时候,你再回头看 OpenClaw、LangGraph、MCP、Multi-Agent、AI 编程 Agent,就会发现:
它们其实都在解决同一个问题——怎么让 AI 不只是“会回答”,而是真正“把事情做完”。
推荐 CSDN 标题
结合最近 CSDN 上高频出现的“从……到……”“一文讲透”“为什么”“不是越多越好”“实战”等标题结构,我比较推荐这个:
《AI Agent 终于开始进入“工程化”时代:从会调用工具到可靠完成任务,一文讲透》
另外几个可以做标题测试:
《别再只会调用大模型了:2026 年 AI Agent 真正难的到底是什么?》
《从“能跑”到“可靠”:AI Agent 工程化到底要解决哪些问题?》
《Multi-Agent 不是越多越好:一文讲透 AI Agent 的状态、恢复与协作》
《AI Agent 为什么越来越像后端系统?从 Tool Calling 到 Checkpoint 一次讲明白》
这些标题借鉴了近期 CSDN 热门内容常见的选题和标题结构,但正文、结构和观点均重新组织,并没有直接复制原文章。
推荐标签:
人工智能 AI Agent 大模型 智能体 Python Agent开发 Multi-Agent MCP Agent工程化 大模型应用 AI编程 Checkpoint RAG LLM 人工智能技术
配图

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 2
 0
- 0


 已为社区贡献8条内容

所有评论(0)