大模型解码:平衡“理性与创意”的采样算法
大模型解码
当一个大语言模型(LLM)根据你的提示词预测下一个词时,它实际上并没有“思考”,而是计算出一个庞大的概率分布——词典里每一个词都可能出现,只是概率高低不同。接下来该怎么选?是永远选概率最高的那个(原理参考前面的文章大模型解码:大模型解码:从“只顾眼前”的贪心算法,到“高瞻远瞩”的集束搜索),还是偶尔“冒险”选一个冷门词?这个选择过程,就是大模型解码的采样算法(Sampling)。
采样算法的本质是在理性(确定性) 与创意(多样性) 之间寻找平衡。太理性,模型会变得重复、呆板;太追求创意,输出又可能毫无逻辑。本文将系统介绍大模型解码采样算法,并解释它们如何在不同任务中达成确定性和多样性平衡的。
本文内容参考 大模型解码:平衡“理性与创意”的采样算法
温度采样
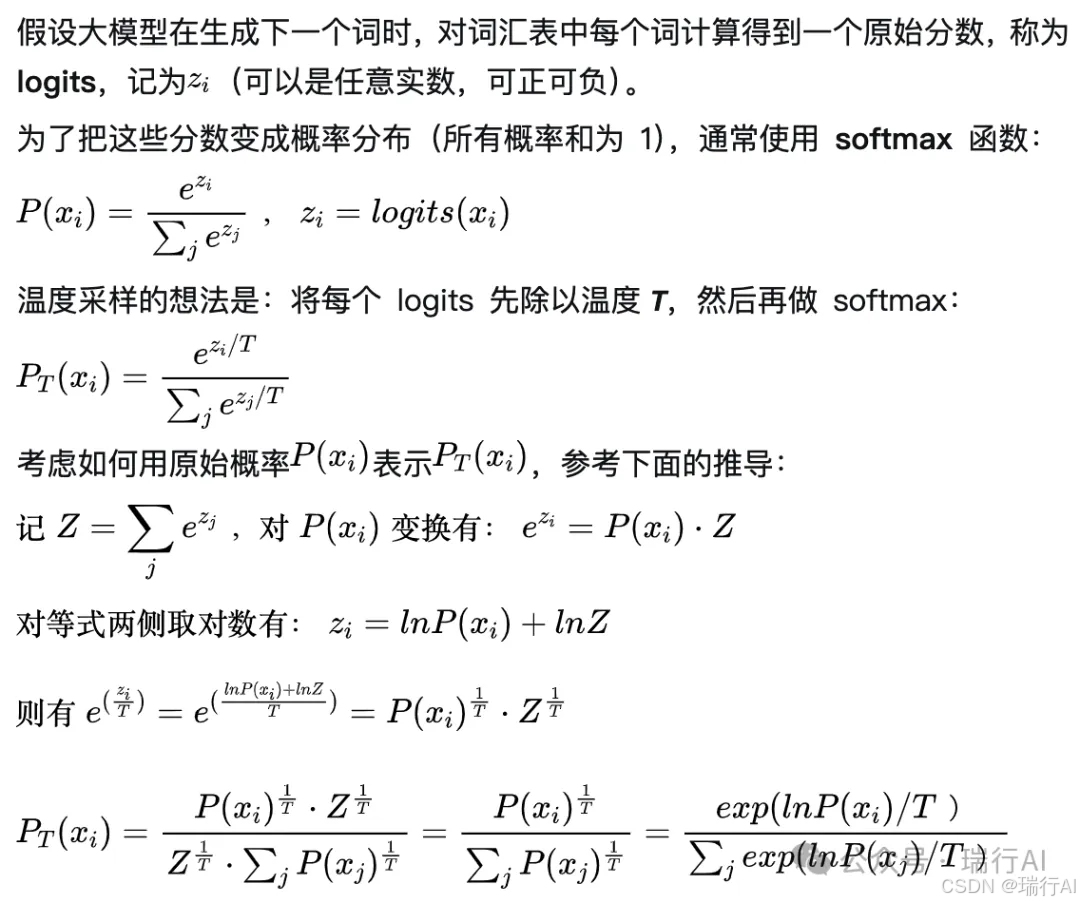
解码过程中,模型通过softmax将logits转化为概率分布以指导token生成。温度采样通过引入温度系数T,灵活调节该分布的尖锐或平坦程度。当T=1:保持原始分布。当T<1(如 0.5):分布变得更陡峭,高概率词更高,低概率词更低,模型趋于保守。当T>1(如 1.5):分布趋于平坦,原本可能性相近的词变得几乎等概率,低概率词被大大抬高,输出随机性激增。
温度小于1时,分布变得尖锐,模型几乎总选最高概率的词,这会导致生成内容极度重复(因为每一步最可能的词往往是刚用过的词)。温度调高,大于1时,如果没有截断机制,理论上每个词(包括概率极低的垃圾词)都是有可能被选中的,这些低概率词往往是拼写错误、不相关或毫无意义的 token。
温度采样的相关数学变换参考下图公式:
Top-K采样
Top-K采样是每步只从概率最高的K个词中随机采样,忽略其他所有词。K是一个固定数值,例如 20 或 30。这样做的好处是强制过滤掉长尾中的离谱候选词,同时保持一定的随机性。
Top-K 的缺点在于固定的取值K。当真实概率分布非常平坦(比如很多词的概率都差不多)时,Top-K 可能会切掉一批同样合理的词,限制了多样性;反之,当分布非常尖锐(一个词概率极高)时,Top-K 可能保留了过多低概率词,引入噪声。
Top-P采样
Top-P采样(也叫“核采样”)不再固定候选词的数量,而是动态选择一组概率总和 刚好超过阈值P的最小集合。例如,设定P=0.9,那么模型会把概率最高的词 依次加入候选集,直到累计概率超过0.9。候选集的大小随分布变化:分布集中时,候选集小(可能只有两三个词);分布平坦时,候选集大(可能有几十个词)。
Top-P 很好地平衡了质量与多样性,成为目前创意生成任务的首选方法。通常,将 Top-P 的阈值设为0.9-0.95,配合温度0.8-1.0,可以生成既流畅又有一定新颖的文本。
图解解码过程
设定输入序列x= (机、器、学、习、的、核、心、是)(输入“机器学习的核心是”共m=8个token,生成n=4个token),下面会通过树状图演示“Top-K采样”和“Top-P采样”每个token的生成过程:
详细计算拆解过程参考 大模型解码:平衡“理性与创意”的采样算法

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 4
 0
- 0


 已为社区贡献1条内容

所有评论(0)