2.2 初识网络代码——线性表示代码
前言
线性回归是机器学习中最基础且重要的模型之一,它通过寻找自变量与因变量之间的线性关系来进行预测。在深度学习时代,虽然神经网络模型日益复杂,但理解线性回归的训练原理仍然是掌握机器学习核心思想的基石。本文将从零开始,完整演示线性回归模型的训练流程,涵盖数据生成、模型构建、损失计算、参数优化到结果可视化的全过程。
本文目标:
- 掌握线性回归模型的基本原理和训练流程
- 学会使用PyTorch实现线性回归的完整训练过程
- 理解梯度下降算法的实际应用
- 掌握模型训练中的关键调试技巧和常见问题解决方法
通过本文的学习,读者将能够独立实现一个完整的线性回归模型训练,并为后续学习更复杂的神经网络模型打下坚实基础。
模型大概的训练流程:
数据处理–>构造函数–>计算loss与梯度–>更新参数–>可视化(绘图)
下面是这次训练要用到的包
import torch
import matplotlib.pyplot as plt
import random
一、数据处理
数据是机器学习的基础,良好的数据处理流程直接影响模型性能。本章节将详细介绍数据的生成与提供方法。
1.1 生成数据
在真实场景中,我们通常从数据库、文件或API获取数据。但在教学示例中,我们首先生成模拟数据来演示完整流程。
import torch
import numpy as np

def create_data(w,b,data_num):
    x=torch.normal(0,1,(data_num,len(w)))  #以0为均值,1为标准差,正态生成样本x
    y=torch.matmul(x,w)+b     #将x(500x4)与w(4x1)相乘,生成标签y(500x1),matmul表示矩阵相乘

    noise=torch.normal(0,0.01,y.shape)  #加入噪声
    y+=noise  #y=y+noise会创建一个新变量
    return x,y
注意事项:
- 噪声的添加使数据更接近真实场景,避免模型过拟合到完美线性关系
- 特征标准化(本文未展示)在实际应用中通常能加速模型收敛
- 数据分割(训练集/验证集/测试集)是避免过拟合的关键步骤
可以画图来看看数据长什么样子
num=500
true_w=torch.tensor([8.1,2,2,4])  #给出真实w
true_b=torch.tensor(1.1)  #给出真实b
X,Y=create_data(true_w,true_b,num)  #调用函数来生成数据
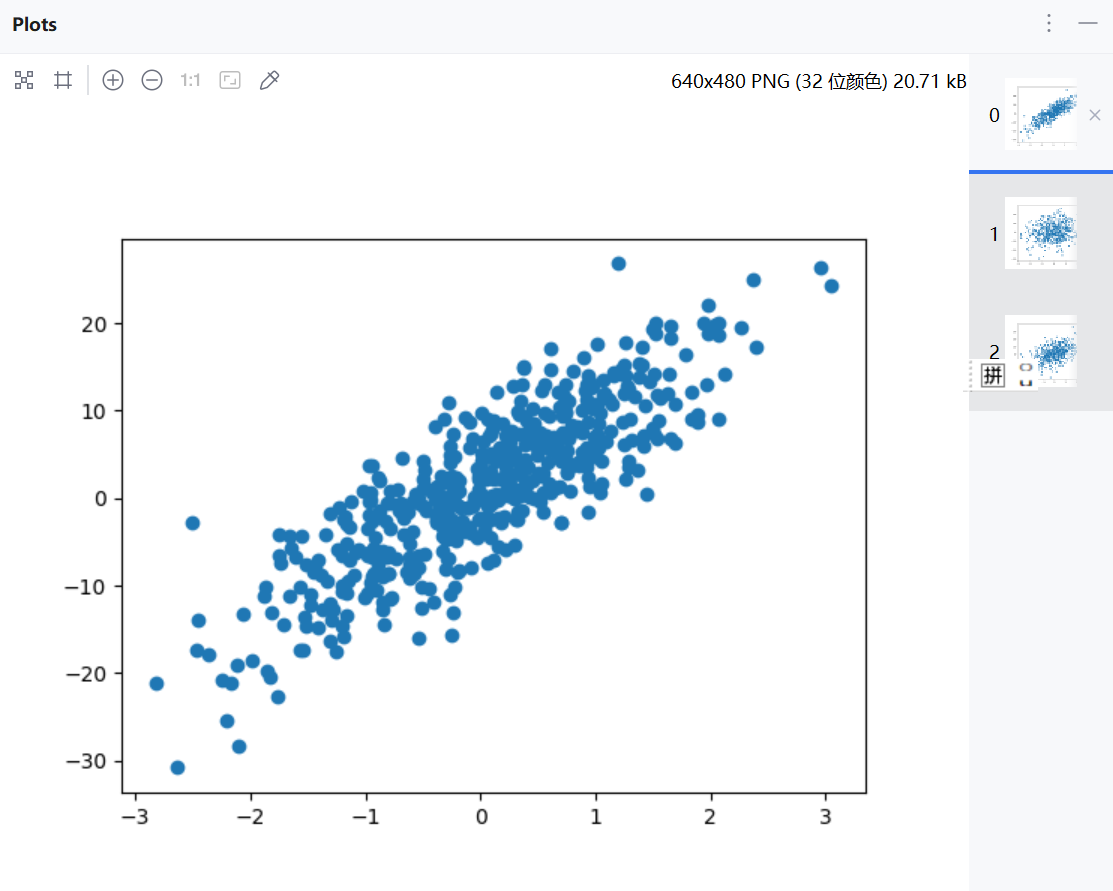
plt.scatter(X[:,3],Y)  #绘制数据,x是500x4矩阵,y是500x1矩阵,所以x要切片
plt.show()  #展示
结果如下
1.2 提供数据(数据加载器)
深度学习通常无法一次性加载所有数据到内存,特别是处理大规模数据集时。分批加载数据(mini-batch)有以下优势:
- 内存效率:减少单次内存占用
- 训练稳定性:小批量梯度下降比全批量更稳定
- 收敛速度:适当的小批量大小能加速收敛
我们做一个数据提供器,每一次调用这个函数,就提供一批数据
def data_provider(X, Y, batch_size):
    """
    def data_provider(data,label,batch_size):
    lenth=len(data[:,0])  #测量数据条数
    indices=list(range(lenth))  #生成索引,方便shuffle
    #我不能按顺序取,做不到普适性和随机性
    random.shuffle(indices)  #随机打乱,提高训练效果
    for each in range(0,lenth,batch_size):  #循环,每次取batch_size个数据
        get_indices=indices[each:min(each+batch_size,lenth)]  #取出本批次数据的索引
        get_data=data[get_indices]  #根据索引取出自变量
        get_label=label[get_indices]  #根据索引取出对应标签
        yield get_data,get_label
batch_size=16
for batch_x,batch_y in data_provider(X,Y,batch_size):  #调试的重要
    print(batch_x,batch_y)  #打印数据
    break
pycharm非常重要的功能之一就在于它的调试,在调试过程中,我们更容易了解参数的变化
批次大小选择建议:
- 小批量(32-256):大多数场景的默认选择,平衡了内存使用和梯度稳定性
- 大批量(>1024):需要更多内存,但可以利用GPU并行计算优势
- 全批量:适用于小数据集,梯度方向最准确但可能陷入局部最优
数据增强技巧(对于图像等数据):
- 随机裁剪、旋转、翻转
- 颜色抖动、亮度调整
- Mixup、Cutmix等高级增强技术
二、模型构建:线性回归实现
线性回归是机器学习中最基础的模型,其数学形式为:y=Xw+by = Xw + by=Xw+b,其中:
- XXX 是输入特征矩阵
- www 是权重向量
- bbb 是偏置项
- yyy 是预测值
前向传播函数如下
def fun(x,w,b):  #需要x,w,b来组成预测值
    pred_y=torch.matmul(x,w)+b
    return pred_y
关键理解点:
- 维度匹配:确保输入特征维度与权重维度一致
- 广播机制:PyTorch自动处理不同形状张量间的运算
- 梯度计算:
requires_grad=True的参数会自动计算梯度 - 模块化思想:将模型封装为函数或类,便于复用和调试
三、loss与梯度回传
取均绝对值误差
def maeloss(pred_y,y):  #需要预测值和真实值
    return torch.sum(abs(pred_y-y))/len(y)
随机梯度下降
def sgd(paras,lr):  #需要参数还有学习率
    with torch.no_grad():  #不开启梯度计算,因为这部分不需要
        for para in paras:  #遍历所有参数
            para-=para.grad*lr  #更新参数,不能写成para=para-para.grad*lr,会创建新变量
            para.grad.zero_()  #清空梯度,防止阻碍下一次梯度回传
梯度下降流程:
- 随机选取一个w
- 计算loss对w偏导
- 更新w的值
深度学习的基本原理也是这样
四、训练
训练准备
lr=0.01  #设置学习率
w_0=torch.normal(0,0.01,true_w.shape,requires_grad=True)  #设置w初始值
b_0=torch.tensor(0.01,requires_grad=True)  #设置b初始值
print(w_0,b_0)  #打印看看初始情况
正式训练
epochs=50  #训练轮数

for epoch in range(epochs):
    data_loss=0  #记录本轮训练的损失
    for batch_x , batch_y in data_provider(X,Y,batch_size):  #用batch_x,batch_y反复承接调用data_provider函数获得的数据进行训练
        pred_y=fun(batch_x,w_0,b_0)  #根据数据得到预测值
        loss=maeloss(pred_y,batch_y)  #计算预测值与真实值的损失
        loss.backward()  #梯度计算
        sgd([w_0,b_0],lr)  #更新参数
        data_loss+=loss  #累加损失
    print(f'epoch:{epoch:3d},loss:{data_loss:.4f}')  #输出本轮训练的损失,方便直观看清楚训练过程

print(f'真实的参数值{true_w,true_b}')  #打印真实参数
print(f'训练得到的参数值{w_0, b_0}')  #打印训练得到的参数
结果如下
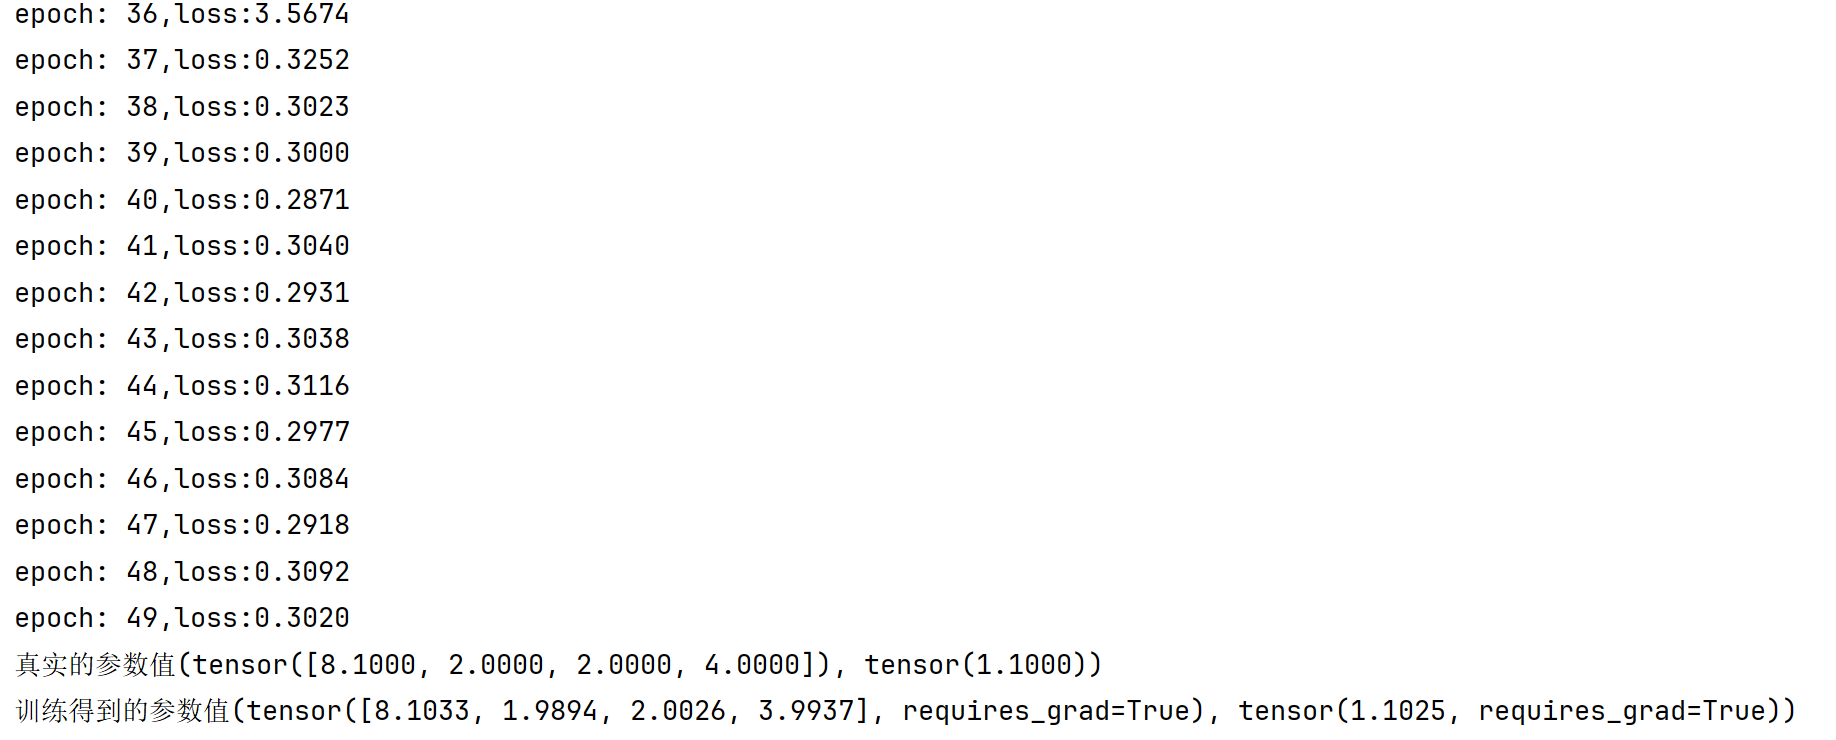
对于我们想训练的w_0和b_0来说,它们只见过batch_x和batch_y,只有这两个东西与它们产生了交互,从来没有见过true_w和true_b,而训练之后都结果相当接近,这就体现了神经网络的强大之处。
我们再来调试观察梯度出现情况
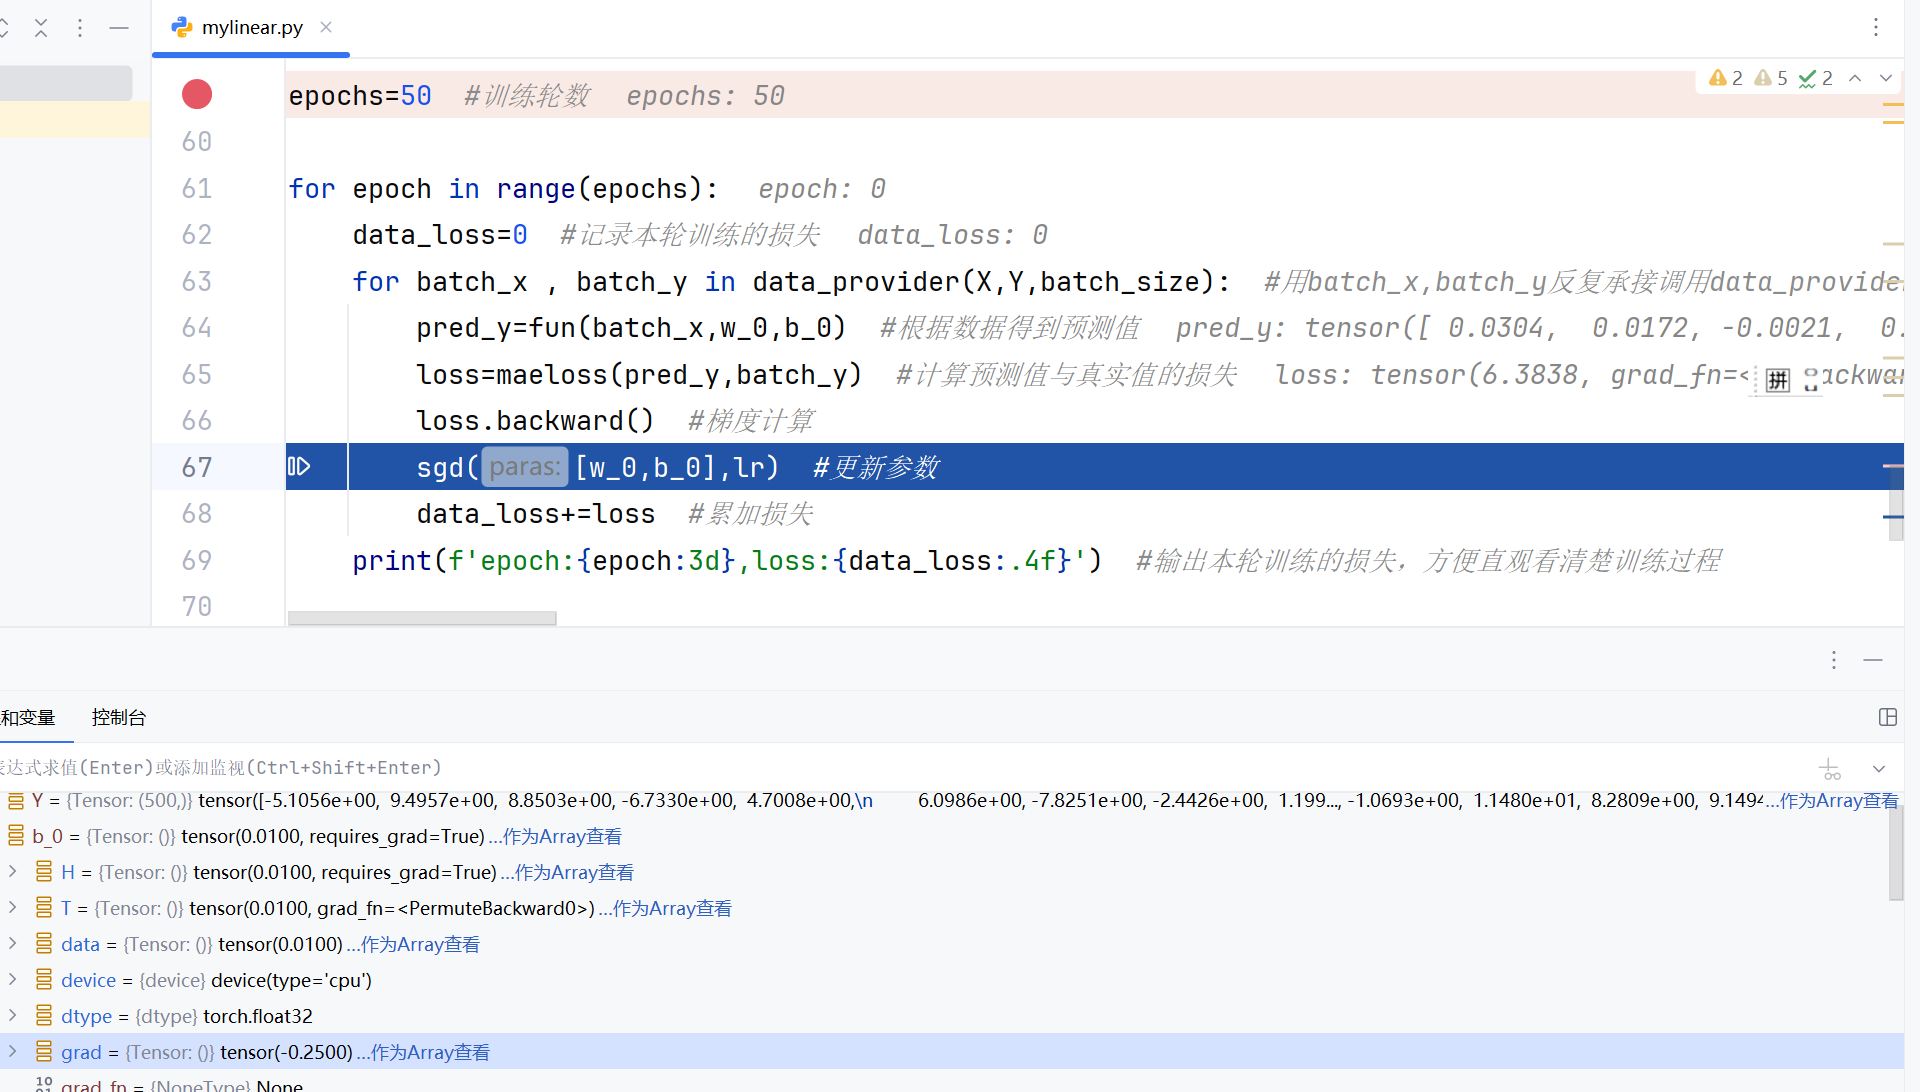
在执行梯度回传后,grad从none变为有数值
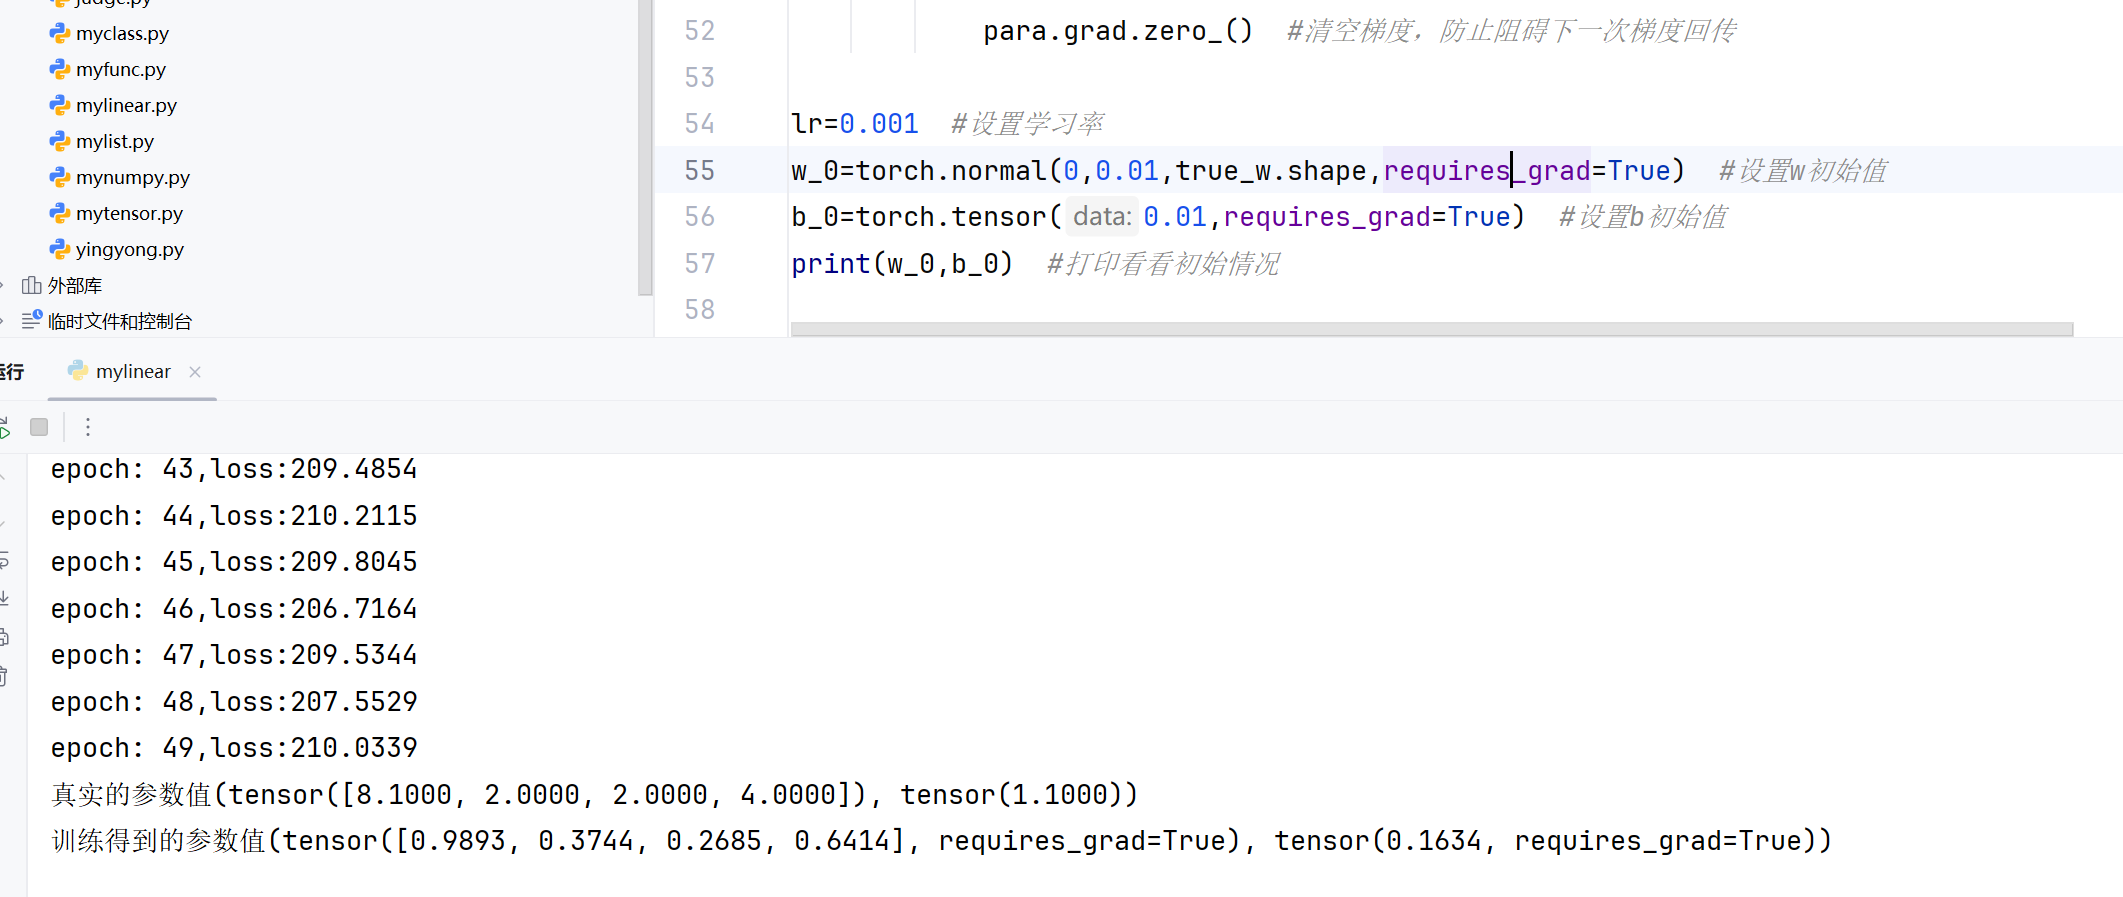
当学习率过小时
五、绘图
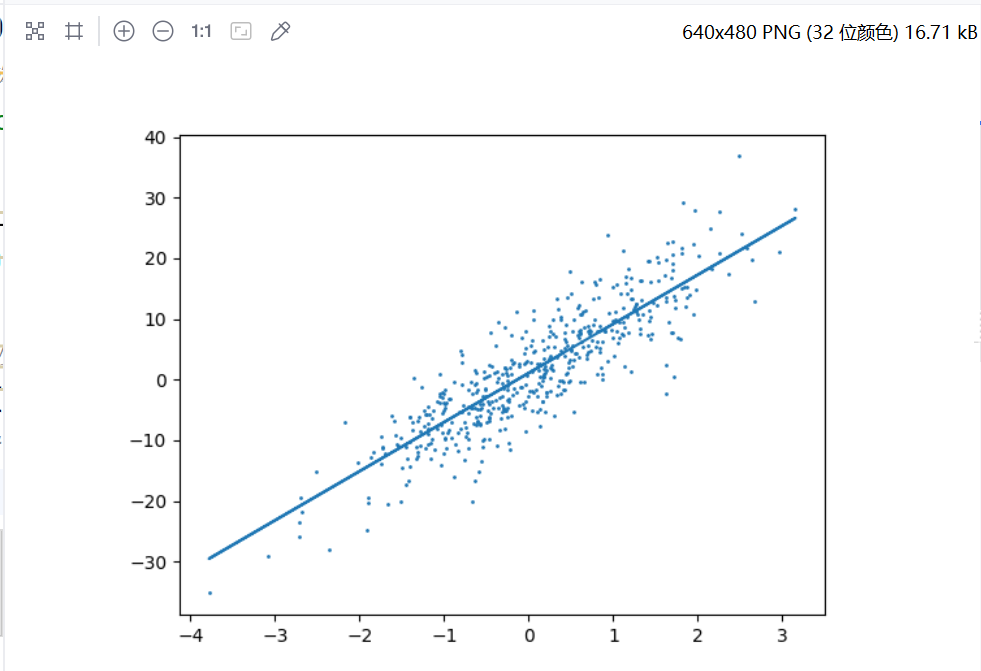
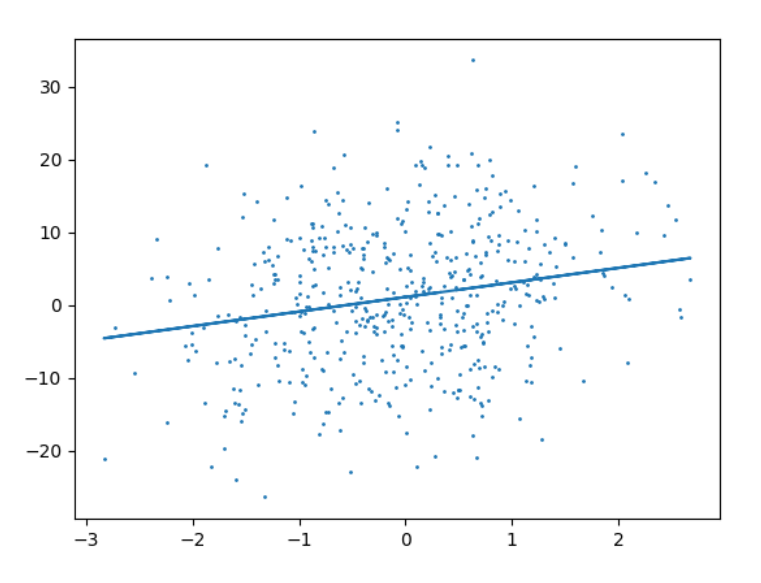
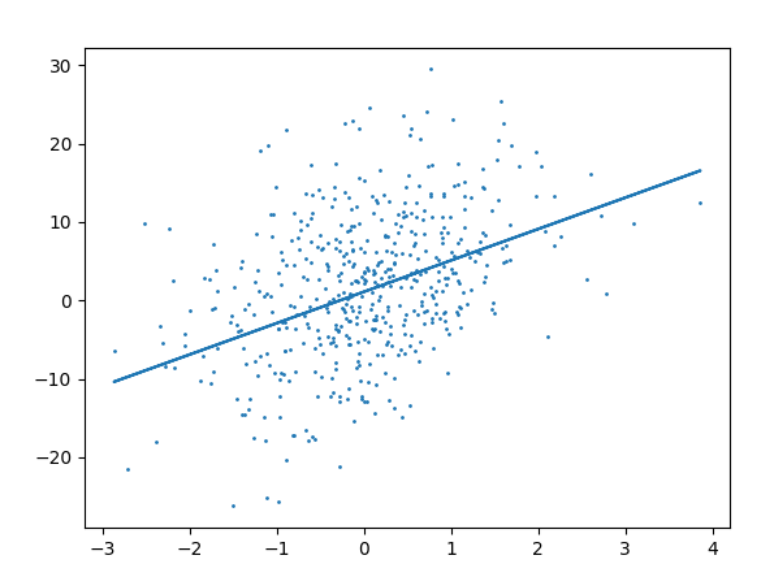
idx=0  #由于训练得到的参数是多个维度,但是画图时这里只能取一个维度
plt.plot(X[:,idx].detach().numpy(),X[:,idx].detach().numpy()*w_0[idx].detach().numpy()+b_0.detach().numpy())  #在x的这个维度上以x为横坐标,以x*w_0+b_0(预测值)为纵坐标,画一条直线
plt.scatter(X[:,idx],Y)  #在x的这个维度上绘制x与y的散点图
plt.show()  #展示
结果如下
idx=0
idx=1
idx=3
可能的报错1
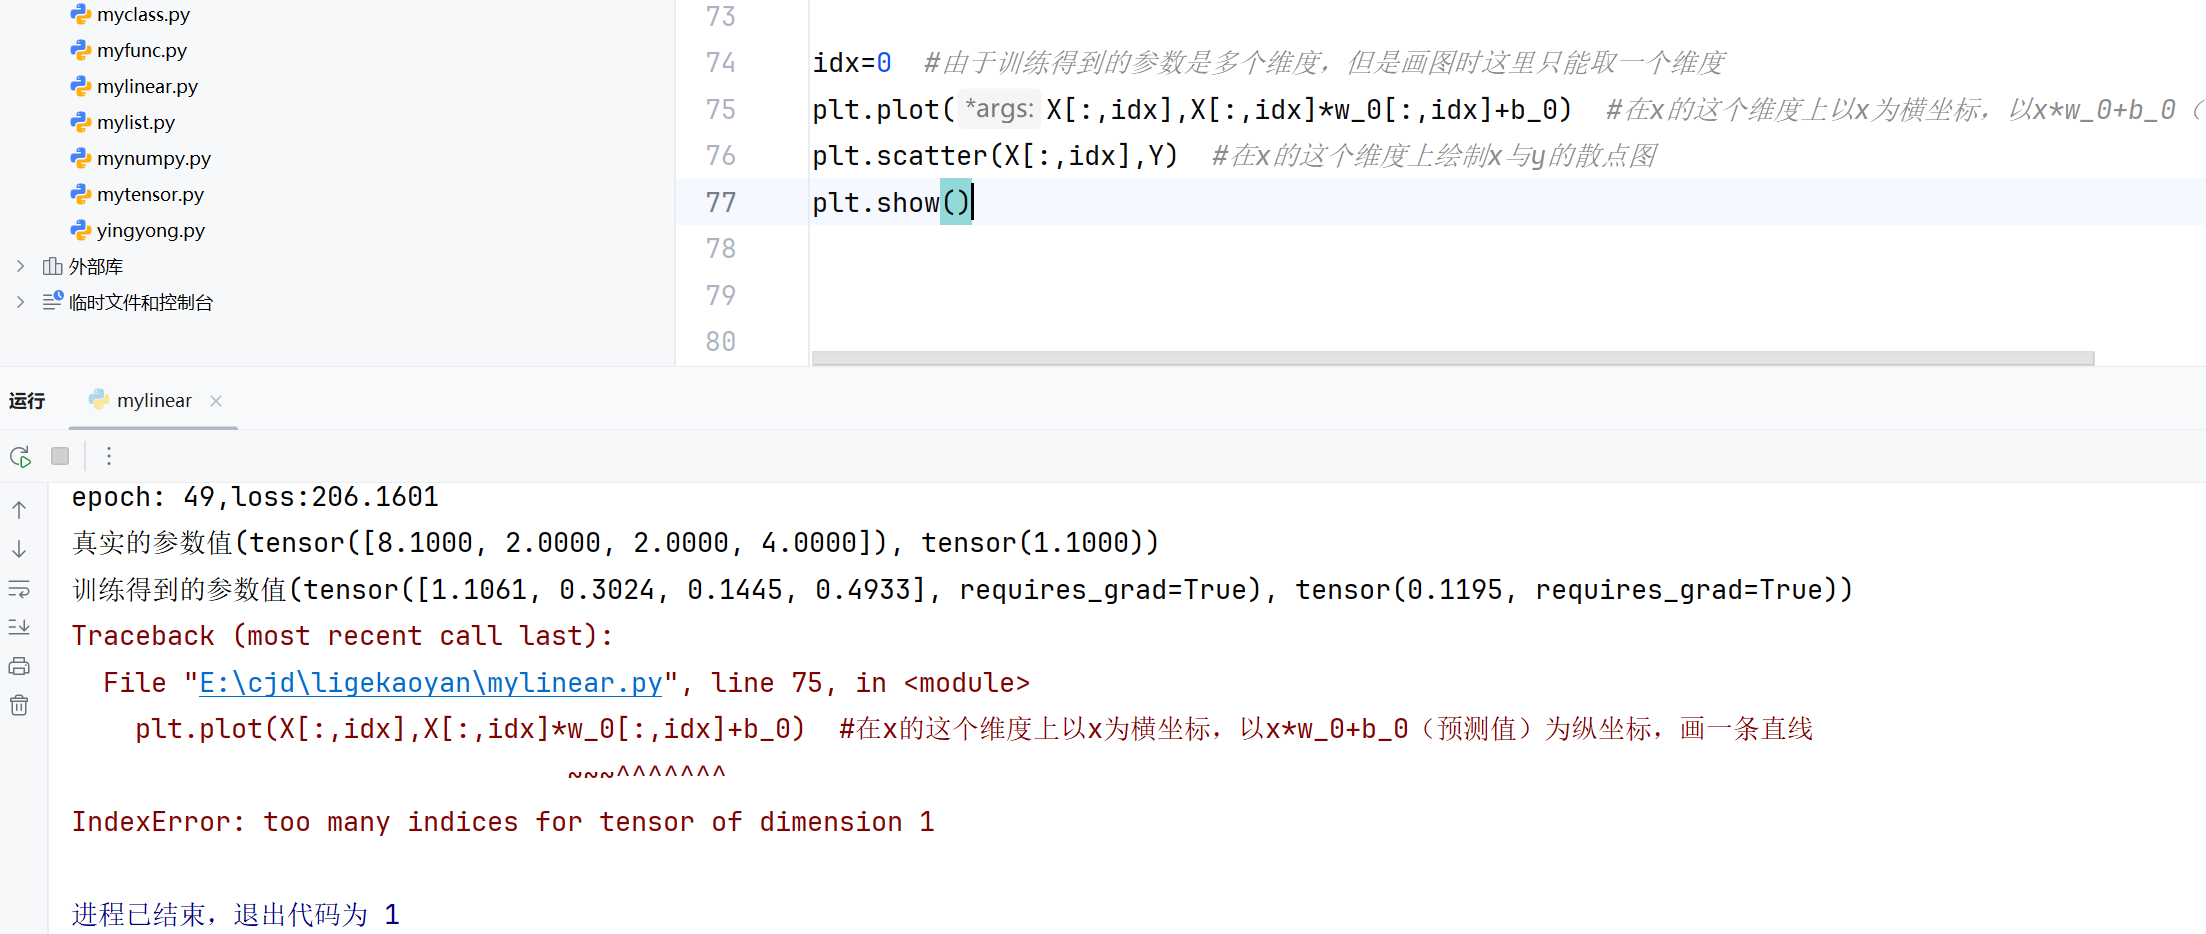
这是由于没有把参数从张量网上取下就进行画图
可能的报错2
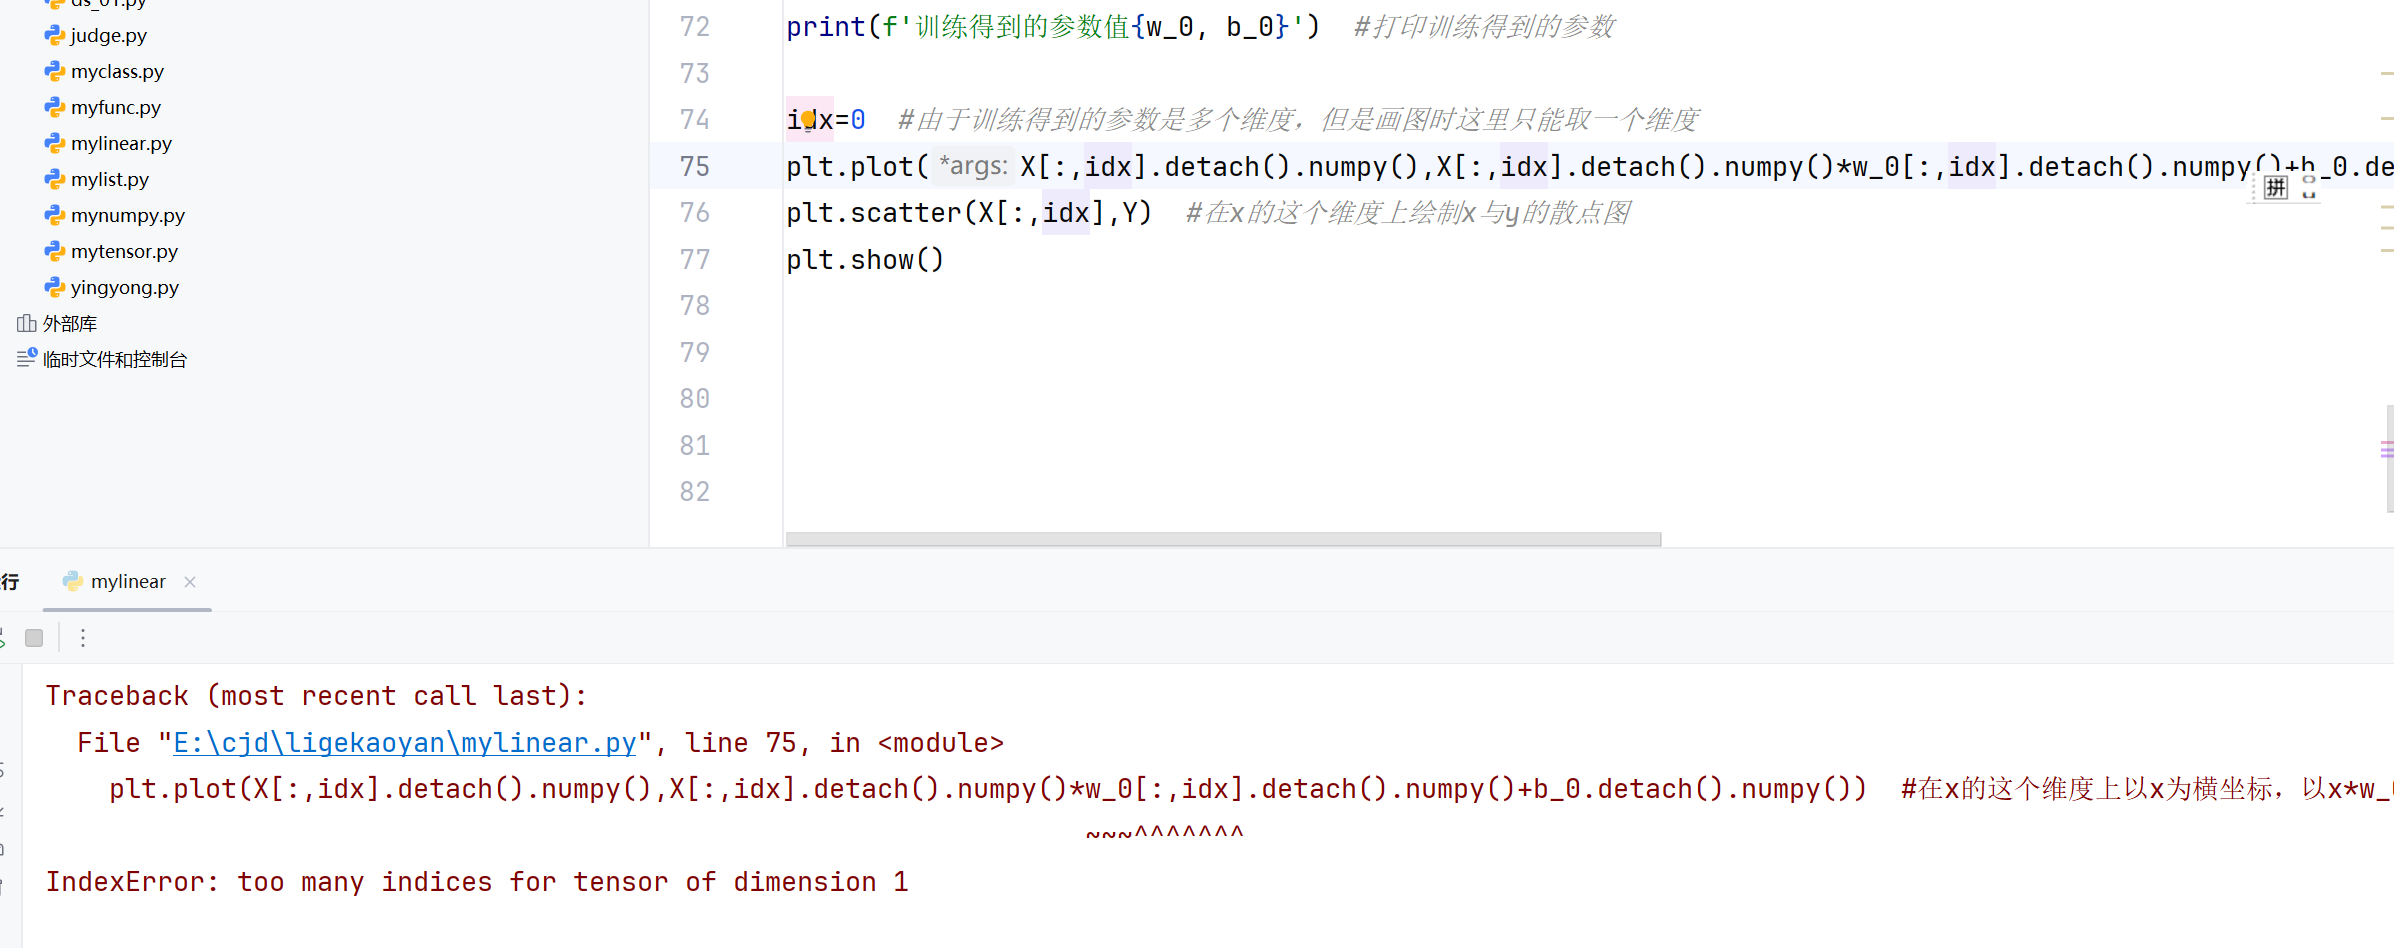
这是由于搞错了w的维度,这里x是500x4,而w是4x1,
所以相乘时应该是w_0[idx]就好
六、总结
再次回顾本次训练:
首先是数据
我们一开始没有数据,所以我们自己生成了数据,而后我们写了一个函数用于分批次地提供数据
其次是构造函数
也就是搭建神经网络,这里简单地设计了fun函数,输入x,w,b,会返回预测值
再次是构造loss与梯度回传
这里直接将预测值与真实值之间差的绝对值作为loss,然后写了sgd来根据梯度更新参数
之后是开始训练
设置好batchsize批次大小,epochs总论数,用epoch代表当前轮数
第二层for循环中反复调用data_provider()提供数据,之后调用fun(),再后调用maeloss()与sgd(),sgd前进行反向传播backward(),最后将本批次loss加到本轮次data_loss中,每一轮都将损失值打印出来
最后是打印结果
打印出真实值与训练值,使用plt进行可视化,注意x维度和w,b是否从张量网中取下
在实际情况中loss与梯度回传基本不用我们在意
神经网络训练中有一个关键点:
深度学习的神经网络训练过程最重要的地方就在于它的维度,维度是我们最值得注意的事情,如果维度变化没有出错,那么一般网络也不会出错
七、后续与思考
7.1 模型泛化能力
在实际应用中,训练好的模型需要在未见过的数据上表现良好,这就是模型的泛化能力。本文中我们使用了与训练数据同分布生成的测试数据,但在真实场景中:
- 数据分布偏移:训练数据与真实应用场景的数据可能存在分布差异
- 特征工程的重要性:选择合适的特征表示对模型性能至关重要
- 交叉验证:使用k折交叉验证可以更准确地评估模型泛化能力
7.2 过拟合风险与应对策略
线性回归虽然相对简单,但仍存在过拟合风险:
-
正则化技术:
- L1正则化(Lasso):可以产生稀疏解,实现特征选择
- L2正则化(Ridge):限制参数大小,防止过度拟合
- Elastic Net:结合L1和L2正则化的优点
-
早停法:监控验证集损失,在性能开始下降时停止训练
-
增加训练数据:更多样化的数据有助于模型学习更通用的模式
7.3 学习率调整策略
学习率是梯度下降算法中最重要的超参数之一:
-
固定学习率的局限性:
- 学习率过大:可能导致震荡甚至发散
- 学习率过小:收敛速度慢,可能陷入局部最优
-
自适应学习率算法:
- Adam:结合动量法和自适应学习率调整
- RMSprop:根据梯度平方的移动平均调整学习率
- Adagrad:为每个参数分配不同的学习率
-
学习率调度策略:
# 示例:学习率衰减
scheduler = torch.optim.lr_scheduler.StepLR(optimizer, step_size=30, gamma=0.1)
for epoch in range(epochs):
    # 训练步骤...
    scheduler.step()  # 每个epoch后更新学习率
7.4 模型评估与改进
-
评估指标:
- 均方误差(MSE):对异常值敏感
- 平均绝对误差(MAE):本文使用的方法,对异常值更鲁棒
- R²分数:衡量模型解释的方差比例
-
模型诊断:
- 残差分析:检查残差是否随机分布
- 多重共线性检测:避免特征间高度相关
- 异方差性检验:确保误差方差恒定
7.5 扩展到更复杂的场景
- 多项式回归:通过添加特征的高次项来拟合非线性关系
- 多元线性回归:处理多个自变量与因变量的关系
- 逻辑回归:将线性回归扩展到分类问题
- 神经网络中的线性层:理解全连接层与线性回归的关系
7.6 实践建议
- 数据预处理标准化:对特征进行标准化可以加速收敛
- 梯度检查:在复杂模型中验证梯度计算的正确性
- 超参数调优:使用网格搜索或随机搜索寻找最优超参数
- 模型解释性:线性回归的系数具有明确的物理意义
通过深入思考这些进阶话题,读者可以更好地将线性回归的知识应用到实际项目中,并为学习更复杂的机器学习模型奠定坚实的基础。

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐

 6
 0
- 0


 已为社区贡献2条内容

所有评论(0)