c++八股文
C++八股文
文章的主要目的是带你快速记忆C++的知识 ,是根据参考资料方便自己记忆梳理的 如有侵权请告知
持续更新中 上一次更新时间2025-10-23
参考资料
文章目录
- C++八股文
- 问题与答案
- C++ 基础
- C++ 面试
- 讲一讲封装、继承、多态是什么
- 多态分类:
- 关于虚函数的原理
- vtavle创建时机
- 一个类是否可以有多个vptr
- 什么时候将析构函数定义为虚函数
- extern的介绍
- 右值引用与std::move
- std:: forward
- 智能指针
- sharedptr底层实现原理
- enable_shared_from_this 的机制
- c++相对于c有什么特性
- c++标准库的多线程函数
- cpp类型转换
- 对new/delete malloc/free理解+(placemet new与operator new/delete)
- static
- 头文件.h和.cpp区别
- vector底层原理,怎么扩容的
- 模板
- deque(底层原理)
- list底层原理
- array/vector/list/map/deque的区别和应用场景
- struct的内部机制
- unordered map
- 栈和堆的区别。栈的静态分配和动态分配
- 内存泄漏
- 你怎么排查内存泄漏?
- 指针操作还会出现哪些问题
- 一个数组里面存了一个很大的数字,里面有很多地方都是重复的,然后让我找出重复最多的一个数,并说说时间复杂度
- python面向对象和 C++面向对象的异同
- 单例模式是否有线程安全问题
- 如何解决线程安全问题
- 介绍一下线程池
- python多态如何实现
- 讲一下如何判断两个浮点数相等
- C++ 11的了解
- C++14/17 新特性
- stl用过哪些
- 给定一个类A,有一个成员变量,完成这个类的构造函数和拷贝构造函数 ;在这个的基础上,有一个新的类B,B里面有一个A类的指针,完成B类的构造函数和拷贝构造函数
- 介绍一下自己debug的大概流程,为了提高debug的效率自己有没有好的方式方法
- 介绍一下RAII思想。他是怎么保证对象没有内存泄漏的?
- 共有继承和私有继承分别有什么区别和使用场景
- 构建项目使用的工具
- 项目中的代码管理
- .Linux下线程同步的机制有哪些?你用过哪些锁
- Linux查看当前有什么进程在运行用什么命令
- 说一下以下四行代码含义
- 继承里的override和final关键字的作用
- 文本处理,文件查找用什么命令
- function和普通函数指针的区别
- 链表可以用快排吗,链表怎么排序(冒泡?挨个交换)
- 总结
问题与答案
C++ 基础
c++ 和 c 语言
- C++有三大特性
(1)封装。(2)继承。(3)多态;- C语言和C++的区别
- C语言是C++的子集,C++可以很好兼容C语言。但是C++又有很多新特性,,如const常量、引用、cast转换、智能指针、try—catch
等等- C++可复用性高,C++引入了模板,实现了方便开发的标准模板库STL
- C++是面对对象的编程语言;C语言是面对过程的编程语言
- C++结构体和C结构体
(1)C的结构体内不允许有函数存在,C++允许有内部成员函数,且允许该函数是虚函数。
(2)C的结构体对内部成员变量的访问权限只能是public,而C++允许public,protected,private三种。
(3)C语言的结构体是不可以继承的,C++的结构体可继承。
(4)C 中使用结构体需要加上 struct 关键字,而 C++ 中可以省略 struct 关键字直接使用
- C++导入C函数的关键字以及编译区别
- 关键字:extern,表达形式为extern “C”:为了能够正确实现C++代码调用其他C语言代码。加上extern "C"后,会指示编译器这部分代
码按C语言的进行编译,而不是C++的。- 编译区别:C++支持函数重载,因此编译器编译函数的过程中会将函数的参数类型也加到编译后的代码中,而不仅仅是函数名;而C语言并不支持函数重载,因此编译C语言代码的函数时不会带上函数的参数类型,一般只包括函数名
说说 C++中 struct 和 class 的区别
- struct 一般用于描述一个数据结构集合,而 class 是对一个对象数据的封装;
- struct 中默认的访问控制权限是 public 的,而 class 中默认的访问控制权限是 private 的。
- 在继承关系中,struct 默认是公有继承,而 class 是私有继承;
- class 关键字可以用于定义模板参数,就像 typename,而 struct 不能用于定义模板参数
include头文件的顺序以及双引号""和尖括号<>的区别
尖括号<>的头文件是系统文件,双引号""的头文件是自定义文件。
编译器预处理阶段查找头文件的路径不一样。<> :头文件路径–>系统变量
" ": 当前头文件目录–>编译器设置的头文件路径–>系统变量
C++从代码到可执行二进制文件的过程
C++ 面试
讲一讲封装、继承、多态是什么
封装、继承和多态是面向对象编程的三大特性
封装:把数据和操作数据放在一个类里,只对外暴露必要的接口(public)
继承:子类复用父类的方法和属性,可以让我们不改动父类的情况下扩展功能,提高复用性和可维护性
多态:同一个接口在不同对象有不同的行为,通常通过虚函数实现(如不同子类重写父类的虚函数)
多态分类:
编译时多态【在编译阶段就确定调用哪个函数】:函数重载+运算符重载【重载是同名函数参数不同,编译器在编译时决定调用哪个函数】实现
例如void print(int x) { cout << "int" << endl; } void print(double x) {cout << "double" << endl; } int main() { print(3); // 编译器看到参数是int → 调用print(int) print(3.14); // 编译器看到参数是double → 调用print(double) }运行时多态【在程序运行时才确定】:通过虚函数表(vtable)和动态绑定实现,需要虚函数 + 基类指针或引用
Animal* a = new Dog();
a->speak();// 要运行到这里时,才会根据对象类型决定调用哪个函数
关于虚函数的原理
在基类中使用 virtual
声明的函数,在派生类中可以重写(覆盖),通过基类指针或引用调用时,会根据实际对象类型调用对应函数,而不是编译时类型。
C++ 编译器通过 虚函数表(vtable) + 指向虚函数表的指针(vptr) 实现动态绑定。
vtavle创建时机
vtable 在编译阶段生成(属于类)
vptr 在对象构造时初始化(属于对象)
vtable(虚函数表)是编译器在实现虚函数机制时自动生成的一张表,用来记录类的虚函数的地址,每个包含虚函数的类都会有一张 vtable,每个对象里都会有一个 vptr(虚表指针) 指向它所属类的 vtableclass Base { public: virtual void foo() { cout << "Base foo" << endl; } }; class Derived : public Base { public: void foo() override { cout << "Derived foo" << endl; } }; int main() { Derived d; // 对象创建 Base* b = &d; b->foo(); // 调用 Derived::foo() }调用虚函数时,通过 vptr 查 vtable 找到对应函数地址实现动态绑定
流程:
b 是一个基类指针,但它指向一个 Derived 对象;编译器看到这是一个 虚函数调用;它会去取出对象内部的 vptr;找到该 vptr 指向的虚函数表;从表中找到对应的函数地址;调用那个函数(即 Derived::foo())。vptr 在对象创建时就初始化为指向自己的 vtable,所以保证即使通过基类指针,也能找到对象真实类型的函数,不会找错
一个类是否可以有多个vptr
一般情况下,一个类只有一个 vptr。
但如果一个类多继承了多个带虚函数的基类,那它就会拥有多个 vptr:每个有虚函数的基类各对应一个独立的虚函数表(vtable)和 vptr
对象布局示意:
±-----------------+
| vptr1 ----------+ | → Derived::vtable(Base1部分)
| Base1 成员变量 |
| vptr2 ----------+ | → Derived::vtable(Base2部分)
| Base2 成员变量 |
| Derived 自己成员 |
±-----------------+
什么时候将析构函数定义为虚函数
当一个类会被继承、并且可能通过基类指针或引用来删除对象时,一定要将析构函数定义为 virtual,否则删除派生类对象时只会调用基类析构函数,造成资源泄漏。
错误例子#include <iostream> using namespace std; class Base { public: ~Base() { cout << "Base destructor" << endl; } };//virtual ~Base(){...} 这样才对 class Derived : public Base { public: ~Derived() { cout << "Derived destructor" << endl; } }; int main() { Base* b = new Derived(); delete b; // ❌ 出问题 return 0; }Derived 的析构函数没有被调用!导致 Derived 中分配的资源(内存、文件句柄等)无法释放 —— 内存泄漏!`
原因:
当析构函数不是虚函数时,delete b; 的行为是 编译时绑定(早绑定:编译阶段就决定:普通成员函数、非虚函数);
编译器只知道 b 是 Base*,所以只调用 Base::~Base();
根本不知道 b 实际上指向的是 Derived 对象;因此派生类部分资源得不到释放。
extern的介绍
extern 并不会分配内存,只是声明存在。链接器(linker)会在链接阶段把引用和定义关联起来。
// file1.cpp
 int globalVar = 100;

// file2.cpp
 extern int globalVar; // 告诉编译器,globalVar 在别处定义 void
func() {
    globalVar += 1; }
extern “C”
C++ 支持 函数重载(function overloading),所以在编译时会对函数名做“名字改编”,生成唯一的符号名。这样会造成和c语言进行链接时候对不上 extern "C"告诉编译器:这个函数按 C 的方式编译和链接,不要改名
例子
- 想在 C++ 文件中使用 C 语言的库函数
extern "C" {
    #include "my_c_library.h" }
- 在 C++ 中定义 C 接口
extern "C" void my_function(int x) {
    printf("C style linkage, x=%d\n", x); }
C 代码中只需:
void my_function(int);ps:
extern " c"实际上等价于:extern "C"
右值引用与std::move
左值:在表达式结束后依然存在的对象, 有名字,可取地址
右值:临时对象或即将消亡的值,没名字,不可取地址
右值引用的核心用途:移动语义,移动(move)则“偷”走资源,减少开销[普通拷贝(copy)会创建一份新对象;]
右值引用是 C++11 引入的语法特性,用于绑定临时对象,它的主要作用是实现移动语义和完美转发,从而减少内存拷贝,提高性能,实现移动语义时,通过移动构造函数或移动赋值函数,将资源“转移”而非“复制”。通常搭配 std::move 使用,将左值转换为右值,
std::move:它本身不会移动任何资源,它只是做了一个类型转换,移动构造函数或移动赋值运算符会利用这个右值引用,将对象内部的资源指针直接转移给新对象,同时把原对象置空,从而实现资源的所有权转移,避免深拷贝。// ✅正确写法 int&& r = 10; // 右值引用绑定到右值 10 r = 20; // 可以修改 //❌ 错误写法,不能把右值引用绑定到左值 int a = 10; int&& r2 = a; //✅ 正确写法(用std::move 转换左值为右值) int a = 10; int&& r2 = std::move(a); // a被“强制”转换成右值// 其他例子 class A { public: A(int size) { data = new int[size]; } ~A() { delete[] data; } // 拷贝构造 A(const A& other) { data = new int[10]; std::copy(other.data, other.data+10, data); std::cout << "Copy ctor\n"; } // 移动构造 A(A&& other) noexcept { data = other.data; other.data = nullptr; // 防止析构重复释放 std::cout << "Move ctor\n"; } private: int* data; }; A func() { return A(10); // 返回临时对象,这类对象是“右值”,没有名字,生命周期只在当前表达式内 } int main() { A a = func(); // ✅ } ```分析: 当函数返回一个对象时,编译器有三种选择:
- RVO(返回值优化)
C++17 起默认启用,编译器会直接在 main() 函数里构造出那个对象的内存空间。
所以连“移动”都省略- 移动构造
编译器会优先调用移动构造函数,而不是拷贝构造,因为对象是右值(即将销毁)。也就是执行A(A&& other)- 拷贝构造
如果类没有定义移动构造,就执行A(const A& other)
std:: forward
先看一个例子 👇
process(int&& x) { std::cout << "右值引用\n"; }

template <typename T>
 void relay(T arg) {        // ❶ 普通参数(按值)解决方案:void relay(T&& arg)
    process(arg); //解决方案: process(std::forward<T>(arg));
     }

int main() {
    int a = 10;
    relay(a);      // 传入左值
    relay(20);     // 传入右值 } ```
输出: 左值引用 左值引用 ❌ (预期右值引用)原因:
因为在 relay() 函数体内,参数名 arg 总是一个左值, 无论你传进来的是左值还是右值
std::forward【完美转发】 就是为了解决这个问题的。
它能让模板函数“保持实参原本的值类别(左值 / 右值)
智能指针
用于自动管理动态内存,防止内存泄漏:通过 RAII(资源获取即初始化)机制,在对象析构时自动释放资源
传统的 new/delete需要手动管理内存:A* p = new A(); // 如果这里 return 或抛异常,忘了 delete,就会内存泄漏 delete p;智能指针的三种主要类型
智能指针 头文件 主要功能 所有权特点 std::unique_ptr<memory>独占所有权 不能复制,只能转移 std::shared_ptr<memory>共享所有权 通过引用计数控制释放 std::weak_ptr<memory>弱引用 不增加引用计数,用于解决循环引用 例子:unique_ptr —— 独占所有权:
#include <memory> #include <iostream> using namespace std; struct A { A() { cout << "A()\n"; } ~A() { cout << "~A()\n"; } }; int main() { unique_ptr <A> p1 = make_unique<A>(); // 创建对象 // unique_ptr<A> p2 = p1; ❌ 不能复制 unique_ptr<A> p2 = move(p1); // ✅ 所有权转移 cout << (p1 == nullptr) << endl; // 输出 1(p1 已失效) } // p2 离开作用域,自动 delete例子:shared_ptr —— 共享所有权
#include <iostream> using namespace std; struct A { A() { cout << "A()\n"; } ~A() { cout << "~A()\n"; } }; int main() { shared_ptr<A> p1 = make_shared<A>(); // count = 1 { shared_ptr<A> p2 = p1; // count = 2 cout << p1.use_count() << endl; // 输出 2 } // p2销毁,count = 1,离开作用域,引用计数归零,自动 delete cout << p1.use_count() << endl; // 输出 1 } // 最后一个销毁,自动 delete例子:例子-weak_ptr 弱引用
#include <memory>
#include <iostream> using namespace std;

struct B;
struct A {
    shared_ptr<B> pb;
    ~A() { cout << "~A()\n"; } };
struct B {
    weak_ptr<A> pa; // ✅ 用 weak_ptr 打破循环
    ~B() { cout << "~B()\n"; } };

int main() {
    auto a = make_shared<A>();// A 的引用计数 = 1
    auto b = make_shared<B>();// B 的引用计数 = 1
    a->pb = b; // b 的引用计数 +1 => B = 2
    b->pa = a; } // a 的引用计数 +1 => A = 2,正常析构,不会内存泄漏
如果都是shared_ptr,不用weak_ptr则会,每个对象都互相“抓着”对方的 shared_ptr。两边引用计数都是 2 当 main() 结束时 a 和 b 离开作用域; A 的引用计数从 2 → 1(因为 B 还持有一个); B 的引用计数从 2 → 1(因为 A 还持有一个); a(shared_ptr) ───► [A对象] ▲ │ │ ▼ b(shared_ptr) ◄─── [B对象]所以把其中一个改成 weak_ptr:weak_ptr 是虚线箭头,不增加计数,不影响释放时机。
当 main() 结束时
A 的引用计数 1 → 0(因为没人再持有它);释放 A;
释放 A 时,内部的 pb(指向 B 的 shared_ptr)也销毁;
B 的引用计数 1 → 0;释放 B;
weak_ptr 自动失效,但不会报错。
 a(shared_ptr) ───► [A对象]
       ▲               │
       │               ▼
      b(shared_ptr) ◄───(weak_ptr)── [B对象]
sharedptr底层实现原理
shared_ptr 是通过一个控制块来管理对象生命周期的。
这个控制块里保存了对象指针、引用计数、删除器等信息。 每次拷贝一个 shared_ptr,引用计数就会加一;销毁或者 reset时计数减一。 当计数归零的时候,对象就会被自动释放。
weak_ptr 跟 shared_ptr 共用同一个控制块,但它不增加引用计数,主要用来避免循环引用或者判断对象是否还存在。
线程安全性
此外,shared_ptr 的引用计数操作是原子性【指的是:一个操作不可被中断,要么全部执行完,要么完全不执行。】的, 所以在多线程环境下也能安全使用,如果多个线程访问 shared_ptr 指向的对象,需要自己保证对象访问安全(加锁或其它同步机制)
enable_shared_from_this 的机制
在类内部,有时候你想把 this 指针包装成一个 shared_ptr 返回给外部,而不是手动 new一个新的对象(那会导致资源重复释放)。
C++ 管理 this 指针通常用 std::enable_shared_from_this。
类继承它后,会在对象内部维护一个弱指针(weak_ptr)指向自己。 当外部有 shared_ptr 管理该对象时,可以通过
shared_from_this() 返回一个新的 shared_ptr,共享同一个控制块。 这样做避免了直接用 this 创建
shared_ptr 的 double delete 风险,也避免了循环引用。
c++相对于c有什么特性
特性 说明 示例 / 补充 面向对象(OOP) C++ 支持类、封装、继承、多态 class、virtual、this 函数重载 / 运算符重载 同名函数根据参数类型和个数区分 void f(int)vsvoid f(double)模板编程 支持泛型编程,类型安全 template<class T> class A{}命名空间 避免全局命名冲突 namespace ns { int x; }引用(Reference) 引用作为别名,简化参数传递 int& ref = a;异常处理 try/catch/throw try { ... } catch(std::exception& e){}STL(标准模板库) 提供容器、算法、迭代器 vector<int> v; sort(v.begin(), v.end());构造函数 / 析构函数 对象创建与销毁自动调用 A(),~A()智能指针 自动管理内存,避免泄漏 shared_ptr,unique_ptr虚函数 / 多态 运行时多态 virtual void f();RAII 资源获取即初始化 文件、锁、内存管理等
特性 说明 强类型 更严格的类型检查,比 C 更安全 内存控制 支持 new/delete,构造析构自动调用 inline 函数 函数可以内联,提高效率 模板实例化 编译期生成特定类型代码,提高效率 类型安全的枚举(enum class) 避免名字冲突和隐式转换
c++标准库的多线程函数
std::thread —— 创建线程
#include <thread>

void func(int x) {
    std::cout << "Thread: " << x << std::endl; }

int main() {
    std::thread t(func, 10); // 启动线程执行 func(10)
    t.join();                // 阻塞等待线程结束,等待线程结束 }
此外 t.detach():线程分离,后台运行
std::mutex —— 互斥锁 std::lock_guard / std::unique_lock—— RAII 风格管理锁,防止忘记unlock#include <mutex> std::mutex mtx; void critical() { std::lock_guard<std::mutex> lock(mtx); // 自动加锁/解锁, // 临界区 }std::condition_variable —— 条件变量 用于线程间通知和等待 ,条件变量是线程同步工具通常和 mutex 配合使用。线程通过 wait 阻塞等待某个条件,条件满足后用 notify_one/notify_all 唤醒。
优点:避免轮询,占用 CPU 少;实现线程间高效通信。#include <condition_variable> std::condition_variable cv; std::mutex mtx; bool ready = false; void wait_thread() { std::unique_lock<std::mutex> lock(mtx); cv.wait(lock, []{ return ready; }); // 等待 ready = true }原子操作 提供原子加减、比较交换等操作,避免锁的开销#include <atomic> std::atomic<int> counter(0); counter++; ```
功能 类 / 函数 说明 线程局部存储 thread_local每个线程独立变量 一次初始化 std::call_once/std::once_flag保证只执行一次 future / promise std::future,std::promise,std::async异步任务和结果获取 线程睡眠 std::this_thread::sleep_for,sleep_until线程暂停
cpp类型转换
- static_cast:编译时类型检查
基本类型转换(int ↔ double)
指针或引用的上行/下行转换(非多态情况下)
[上行转换是把派生类指针/引用转换为基类指针/引用,是安全的,因为派生类一定包含基类的部分。]
[下行转换是把基类指针/引用转换为派生类,需要运行时检查,否则可能出错]- dynamic_cast:运行时类型检查(需有虚函数)
用于 基类指针/引用 ↔ 派生类指针/引用
下行转换安全,如果类型不匹配返回 nullptr(指针)或抛异常(引用)- const_cast:
用于去掉或添加const/volatile
不改变实际内存,只改变编译器对类型的限制- reinterpret_cast 按位转换,
危险,用于底层操作
用于指针类型之间或整数 ↔ 指针
对new/delete malloc/free理解+(placemet new与operator new/delete)
malloc/free:只分配/释放原始内存,不调用构造/析构函数;
new/delete:分配内存 + 构造对象 / 析构对象 +释放内存
placement new:在指定内存上构造对象,不分配内存,需要手动析构
operator new/delete:C++底层分配/释放内存的函数,
new/delete 实际调用它们;可重载实现自定义内存管理
特性 malloc/free © new/delete (C++) 内存分配 分配原始内存块 分配内存 + 调用构造函数 内存释放 手动 free 调用析构函数 + 释放内存 类型安全 不是类型安全,需要强制转换 类型安全,不需要 cast 返回值 void*,需强制转换返回对象指针,类型已知 异常处理 内存分配失败返回 NULL 内存分配失败抛 std::bad_alloc(可配置nothrow)
static
- static的特性
生命周期贯穿程序始终,只初始化一次 存储在 全局/静态区(不是栈) 作用域依旧是定义它的函数内部【如果未初始化:默认零初始化(0 或
nullptr)】
- static共享内存
类静态成员在所有对象之间共享
静态成员属于类,而不是对象,所有对象共享同一个内存class A { public: static int count; }; int A::count = 0; // 类静态成员必须在类外初始化!!!
- static作用于普通函数的作用
限制函数的链接性为内部链接(internal linkage) 只在本文件可见,其他文件无法调用 生命周期同程序,存储在 文本段
static void helper() {
    // 只能在本文件使用 }
- 全局变量 + static
static int g = 100; // 只在本文件可见作用: 限制全局变量的可见范围,仅在定义文件内部可访问 避免与其他文件全局变量重名冲突
- static实现普通函数局限于本文件的底层实现原理
编译器对 static 函数做 内部链接(internal linkage) 原理:
函数名不会导出到符号表给链接器外部使用
仅在当前目标文件可见
- 类中的static函数和普通的static的区别
类型 内存位置 是否绑定对象 是否可访问 this 普通成员函数 文本段 绑定对象 可访问 this static 成员函数 文本段 不绑定对象 不能访问 this,只能访问静态成员
头文件.h和.cpp区别
- 头文件 .h 用于 声明 接口:函数、类、宏、常量、模板等;
- 源文件 .cpp 用于 实现:函数定义、类成员函数实现、静态成员初始化;
- 头文件只包含接口信息,源文件包含实现逻辑;
- 编译时 .cpp 会生成目标文件,链接器把各目标文件组合成最终可执行程序
文件类型 作用 内容 头文件 .h/.hpp声明接口 函数声明、类声明、宏、常量、模板类/函数声明、extern 变量声明 源文件 .cpp实现 函数定义、类成员函数实现、静态成员初始化、可执行逻辑 .h文件
 int add(int a, int b); // 函数声明,不分配空间
  class A  //类声明  {
  public:
    void f();
  private:
    int x; };
#define MAX 100 //宏/常量
const int SIZE = 10; extern int globalVar; //extern  声明
模板必须放在头文件,否则编译器找不到实例化代码
vector底层原理,怎么扩容的
std::vector 底层是一块连续的动态数组,内部维护三个指针:开始、已用结束、容量结束。当容量不足时,它会按 2 倍扩容,分配新内存,将旧数据移动过去,然后释放旧内存。这样可以保证插入的摊销复杂度为 O(1)。扩容会导致迭代器、指针、引用失效。
模板
模板是编译期多态 函数模板:可以自动推导类型
template <typename T> T add(T a, T b);类模板:类模板必须显式指定
template <class T> class Vector { ... };自定义模板
template<> class Vector<int> { ... };
deque(底层原理)
deque 是一种 支持随机访问,同时在两端插入和删除都高效的顺序容器,间接寻址,略慢
可以理解为vector优化了“尾部操作”;
deque 优化了“头尾两端操作”;
list 优化了“任意位置插入删除
它不像 vector那样是一整块连续内存,而是专门设计来高效支持首尾插入删除的
- 1️⃣ 解决 vector 的“扩容拷贝”问题
- 2️⃣ 支持随机访问
关键:
中控表(map)存放指向各个 buffer 的指针;map 自身也可能扩容(但频率低)。
迭代器结构
内含指向当前元素的指针;
同时保存当前 buffer 起始和结束指针;
当到达 buffer 边界时自动跳转下一个 buffer。
buffer 大小
通常每块 buffer 存放若干个元素(如 512 字节一块);
小对象装得多,大对象装得少。总结:
deque 底层由多块定长的缓冲区(buffer)组成, 这些缓冲区通过一个中控表(map)统一管理。
它的元素在逻辑上连续,但物理上分散。这样设计可以让它在首尾两端插入和删除都高效,而且仍然支持随机访问。 插入时只需分配新的 buffer,而不需要像 vector 那样整体搬家。唯一缺点是访问稍慢,cache 命中率比 vector 低。
list底层原理
list 底层是双向链表,每个节点保存前后指针和数据。
插入、删除节点只改指针,不移动数据,效率高,迭代器也不会失效。但它不支持随机访问,因为节点不连续特点:内存结构不连续性,插入删除效率高,但不支持下标访问和遍历效率低
array/vector/list/map/deque的区别和应用场景
容器 底层结构 是否连续存储 插入删除复杂度 查找复杂度 随机访问 典型应用场景 array 静态数组 ✅ 连续 ❌ 固定大小 O(1) ✅ 支持 固定大小、性能要求高的场景(如嵌入式) vector 动态数组 ✅ 连续 尾部O(1),中间O(n) O(1) ✅ 支持 需要动态增长的顺序存储,如数据缓存 deque 分段连续内存(双端队列) 部分连续 头尾O(1),中间O(n) O(1) ✅ 支持 双端插入删除频繁,如任务队列 list 双向链表 ❌ 不连续 任意位置O(1) O(n) ❌ 不支持 频繁插入删除、对顺序有要求 map 红黑树(有序) ❌ 不连续 O(log n) O(log n) ❌ 不支持 需要按键有序存储、范围查找 unordered_map 哈希表(无序) ❌ 不连续 O(1) 平均 O(1) 平均 ❌ 不支持 快速查找、键值映射(无序) 总结
array 是固定大小的静态数组,性能最好但不能扩容。 vector 是动态数组,内存连续,支持随机访问,扩容时会重新分配内存。
deque是双端队列,支持两端快速插入删除。
list 是双向链表,适合频繁插入删除但不适合随机访
map 是红黑树结构,键值有序,查找和插入都是 O(log n)。
unordered_map 是哈希表,查找插入平均 O(1),但无序。
struct的内部机制
介绍:
在 C++ 里,struct 和 class 几乎一样,只是默认访问权限不同,struct 是public 而 class 是private
所以结构体 是一个用户自定义的数据类型,可以包含: 成员变量(数据);成员函数;构造 /
析构函数;运算符重载;继承、虚函数(C++里都支持)struct 的内部机制包括内存布局、字节对齐、构造析构、拷贝语义等。
它的成员通常顺序存放,但编译器会根据成员类型进行字节对齐,以提高CPU访问效率。
如果在栈上定义对象,结构体整体分配在栈上;如果用new,则在堆上分配。
如果 struct 中有虚函数,会额外带一个 vptr 指针,支持多态。
unordered map
基本概念
unordered_map 是一种 关联式容器,底层通过 哈希表(hash table) 实现 ——它根据 key 的哈希值
来存储元素,不保证元素的顺序✅ 优点:
查找、插入效率高(平均 O(1)); 不需要排序; 可自定义哈希函数和相等比较器。
❌ 缺点:
元素 无序; 迭代遍历慢; 内存占用大(因为桶结构)。
栈和堆的区别。栈的静态分配和动态分配
栈是系统自动管理的内存空间,主要存放局部变量和函数调用信息;堆是程序员手动分配和释放的内存。
对比项 栈(Stack) 堆(Heap) 管理方式 系统自动分配和释放 程序员手动管理( new/delete)分配效率 高(连续内存,指针移动) 低(需查找合适内存块) 生命周期 随函数调用自动创建和销毁 需程序员控制 空间大小 较小(几 MB) 较大(系统总内存限制) 内存方向 向下增长(高地址 → 低地址) 向上增长(低地址 → 高地址) 典型使用 局部变量、函数参数、返回地址 动态数组、动态对象 静态分配(编译期确定大小)
int a = 10; int arr[100];动态分配(运行期确定大小)
int n; cin >> n; int* arr = new int[n];栈的静态分配指的是编译期就能确定内存大小; 若大小只有运行时才能确定,就需要动态分配到堆上
栈的溢出场景举例。嵌套调用函数会出现什么问题
无限递归:每次函数调用都会在栈上开辟一个“栈帧”(局部变量 + 返回地址)。递归太深时栈空间耗尽 → 崩溃
局部变量太大:函数一执行,直接占用几十 MB 栈空间,也会导致崩溃
函数嵌套过多会不断创建新的栈帧,最终导致栈空间耗尽。
内存泄漏
1️⃣ 定义
内存泄漏是指程序申请了堆内存但没有释放,导致这部分内存无法再被访问或重用。
推荐用 std::shared_ptr 或 std::unique_ptr这样的智能指针自动管理内存
你怎么排查内存泄漏?
发现问题
程序运行后,内存占用持续增加,且不释放。 崩溃或性能下降也可能是内存泄漏导致。
定位泄漏位置
检查堆分配的对象是否都被释放。 查找 new/malloc 是否对应 delete/free。 注意循环引用(特别是
shared_ptr)。修复
手动释放内存(RAII 或析构函数)。
用智能指针管理资源(unique_ptr、shared_ptr + weak_ptr)。
避免裸指针直接管理堆内存。借助工具
如Valgrind(Linux):valgrind --leak-check=full ./a.out,显示未释放的内存块和来源位置。
指针操作还会出现哪些问题
- 空指针访问
int* p = nullptr;
*p = 10; // ❌ 访问空指针,程序崩溃
- 野指针
*p = 10; // ❌ 野指针操作
- 悬空引用
int& func() {
    int x = 10;
    return x; // ❌ 返回局部变量的引用 }
- 重复释放
int* p = new int(10); delete p; delete p; // ❌ 重复释放,未定义行为
- 越界访问
int arr[3] = {1, 2, 3}; int* p = arr; cout << p[5]; // ❌ 越界访问
- 指针类型错误
int arr[3] = {1, 2, 3}; int* p = arr; cout << p[5]; // ❌ 越界访问
- 内存泄漏 分配未释放
一个数组里面存了一个很大的数字,里面有很多地方都是重复的,然后让我找出重复最多的一个数,并说说时间复杂度
#include <iostream>
#include <unordered_map>
#include <vector> using namespace std;

int main() {
    vector<int> nums = {1, 3, 2, 1, 3, 1};
    unordered_map<int, int> count;

    // 统计次数
    for (int num : nums) {
        count[num]++;
    }

    // 找出出现次数最多的数
    int maxNum = 0, maxCount = 0;
    for (auto& [num, cnt] : count) {
        if (cnt > maxCount) {
            maxCount = cnt;
            maxNum = num;
        }
    }

    cout << "出现次数最多的数: " << maxNum << ",次数: " << maxCount << endl;
    return 0; }
python面向对象和 C++面向对象的异同
对比点 Python C++ 语言类型 解释型、动态类型 编译型、静态类型 内存管理 自动垃圾回收(GC) 手动管理或智能指针(RAII) 类型检查 运行时检查(动态) 编译时检查(静态) 函数绑定 动态绑定(默认虚函数) 静态绑定为主,需用 virtual实现动态绑定访问控制 无强制机制(靠约定 _、__)>明确的 public/protected/private多继承冲突 通过 MRO(方法解析顺序)解决 通过虚继承(virtual base class)解决 构造与析构 __init__/__del__构造函数 / 析构函数 this / self self显式传入this隐式传入运算符重载 支持,用 __add__、__eq__等魔法方法支持,用 operator+、operator==等模板 / 泛型 动态类型,不需要模板 模板机制强大(如 template<typename T>)编译时特性 无(运行时决定类型) 模板元编程、静态多态、编译优化丰富
- 单例模式的原理,实现方法及应用场景
单例模式是否有线程安全问题
线程安全问题 懒汉式单例在多线程下可能出现 多个线程同时创建实例 → 出现多实例。
饿汉式或 C++11 局部静态变量方式天然线程安全。
如何解决线程安全问题
互斥锁(mutex):锁住实例创建过程 双重检查锁(DCLP):减少锁开销 C++11 局部静态变量 → 编译器保证线程安全
介绍一下线程池
线程池是一组提前创建好的线程,等待处理任务。通过线程复用减少频繁创建/销毁线程开销,提高系统性能。
工作机制:
线程池初始化 → 创建 N 个线程,线程挂起等待任务
任务队列(Queue) → 线程从队列中获取任务执行
线程循环 → 完成任务后继续从队列获取新任务
线程销毁 → 线程池关闭时统一退出
线程绑核
线程默认可以被操作系统调度到任意核
可通过 pthread_setaffinity_np(Linux) 或 Windows API 绑定到指定 CPU 核
用于提高缓存命中率、减少上下文切换
队列上的线程是如何工作的?
任务生产者 → 放入任务队列 → 空闲线程取出任务 → 执行任务 → 循环
python多态如何实现
Python 多态通过 动态绑定和鸭子类型实现,不需要显式声明 virtual。
当调用对象方法时,Python在运行时根据对象的实际类型选择方法实现。
可以通过继承重写方法,也可以通过鸭子类型实现“行为一致而类型不同”的多态。 相比C++,Python 多态更灵活,但没有编译时类型检查
- 继承重写:
class Animal:
    def speak(self):
        print("Animal sound")

class Dog(Animal):
    def speak(self):
        print("Woof!")

class Cat(Animal):
    def speak(self):
        print("Meow!")

animals = [Dog(), Cat(), Animal()]

for a in animals:
    a.speak()  # 动态绑定,运行时决定调用哪个类的 speak()
鸭子类型
class Bird:
    def speak(self):
        print("Chirp!")

class Dog:
    def speak(self):
        print("Woof!")

def make_speak(obj):
    obj.speak()  # 只要 obj 有 speak 方法即可,不管类型

make_speak(Bird())  # Chirp!
make_speak(Dog())   # Woof! ```
讲一下如何判断两个浮点数相等
判断两个浮点数是否相等,应该比较它们的差值是否足够小
C++ 11的了解
C++11 是一次“大升级”,引入了很多现代编程的重要特性,比如:
自动类型推导:auto、decltype
右值引用 & 移动语义:提高性能,避免拷贝
智能指针:shared_ptr、unique_ptr、weak_ptr
lambda 表达式:函数式编程支持
多线程支持库:std::thread、mutex、future
统一初始化语法:A a{1,2,3}; range-based for 循环
constexpr 常量表达式
nullptr 替代 NULL
强类型枚举 enum class我认为 C++11 是现代C++的起点,核心在于‘类型推导、资源管理、性能提升和并发支持
C++14/17 新特性
到 C++14,我最喜欢泛型 lambda,让模板编程更轻松。 而在 C++17,我最喜欢结构化绑定和 if
constexpr,让代码更简洁、更现代。
stl用过哪些
STL主要分为六大部分:容器、算法、迭代器、仿函数、适配器、空间配置器。 STL我平时用得挺多的,像常用的容器主要有
vector、deque、list、map、unordered_map 这些。
vector底层是动态数组,支持随机访问,扩容时一般按两倍增长,插入删除比较慢; deque是分段连续空间结构,两端插入删除效率高;
list是双向链表,适合频繁插入删除; map 是红黑树实现的有序映射, unordered_map
是哈希表实现的无序映射,查找插入平均都是 O(1)。 算法部分常用 sort、find、for_each、accumulate 等,也会配合
lambda 表达式做一些自定义操作。
给定一个类A,有一个成员变量,完成这个类的构造函数和拷贝构造函数 ;在这个的基础上,有一个新的类B,B里面有一个A类的指针,完成B类的构造函数和拷贝构造函数
#include <iostream> using namespace std;

class A { private:
    int* data;  // 动态内存成员

public:
    // 普通构造函数
    A(int value) {
        data = new int(value);  // 分配堆内存
        cout << "A 构造函数: " << *data << endl;
    }

    // 拷贝构造函数(深拷贝)
    A(const A& other) {
        data = new int(*(other.data));  // 分配新内存并复制内容
        cout << "A 拷贝构造函数: " << *data << endl;
    }

    // 析构函数
    ~A() {
        cout << "A 析构函数" << endl;
        delete data;
    }

    void show() { cout << "data = " << *data << endl; } }; class B { private:
    A* a_ptr;  // 指向 A 的指针

public:
    // 构造函数
    B(int value) {
        a_ptr = new A(value);  // 创建 A 对象
        cout << "B 构造函数" << endl;
    }

    // 拷贝构造函数(深拷贝)
    B(const B& other) {
        a_ptr = new A(*(other.a_ptr));  // 调用 A 的拷贝构造
        cout << "B 拷贝构造函数" << endl;
    }

    // 析构函数
    ~B() {
        cout << "B 析构函数" << endl;
        delete a_ptr;
    }

    void show() { a_ptr->show(); } };
介绍一下自己debug的大概流程,为了提高debug的效率自己有没有好的方式方法
努力去复现场景,进行加上日志输出和录屏观测触发条件,猜测问题来源,然后进行程序的小部分修改进行检查并且多跑几次进行观测是否稳定,并且每次修改程序前我都会做好备份和记录md文件用来方便后期修改,此外我还会利用断言(assert)提前发现错误+有时候也可以设置断点来单步执行+【查看 调用栈(backtrace)、变量值、内存情况】
介绍一下RAII思想。他是怎么保证对象没有内存泄漏的?
RAII(Resource Acquisition Is Initialization)是一种 C++
编程思想,把资源的获取和释放绑定到对象的生命周期。
在构造函数中获取资源,在析构函数中释放资源。这样无论函数正常返回还是异常退出,资源都能自动释放。
典型应用包括智能指针管理堆内存、文件句柄管理等,它可以保证程序没有内存泄漏或资源泄漏,是 C++ 里安全管理资源的核心方法。
共有继承和私有继承分别有什么区别和使用场景
成员 PubD访问 PrivD访问 外部访问PubD 外部访问PrivD pub public private ✅ 可以调用 ❌ 不可以调用 pro protected private ❌ ❌ pri ❌ ❌ ❌ ❌ class Base { public: void pub() {} protected: void pro() {} private: void pri() {} }; class PubD : public Base {}; class PrivD : private Base {};
构建项目使用的工具
我对 CMake 有简单的了解,
能写基础的 CMakeLists.txt 来构建项目。
比如,我知道 add_executable用于生成可执行文件,add_library 用于生成库,target_link_libraries 可以添加依赖库。
一般的流程就是在build 目录下执行 cmake … 生成 Makefile,然后用 make 编译。 我还没有系统学习过 CMake的高级特性(如自定义模块、复杂依赖管理),但是能应付日常项目构建
项目中的代码管理
我目前的项目主要是个人本地项目,还没有用到团队协作的代码管理工具。 平时自己习惯使用 Git 进行版本管理,在本地会用一些常用命令,比如git clone、commit、push、pull、branch 等,也会在 GitHub 上托管自己的代码。
对于 IDE,我主要使用 VSCode,配置了常用的 C++ 开发环境,比如 CMake 插件、调试器(gdb/lldb)、以及 Git
插件,用起来比较轻量高效。如果将来参与团队开发,我可以很快适应 Git 分支管理流程,比如 feature 分支、merge request、以及冲突解决。
流程
我会为每个重要阶段打一个 commit,比如完成一个功能或修复一个 bug。 如果做实验性改动,会先创建分支(git checkout -btest_xx),验证后再合并回主分支,避免污染主线。
冲突
遇到过。通常是多人修改同一个文件时产生的。
我会用 git status 查看冲突文件,然后打开冲突标记手动解决,确认无误后再 git add、git commit。
我也用过 VSCode 的 Git 工具,它能可视化显示冲突部分,挺方便。
.Linux下线程同步的机制有哪些?你用过哪些锁
类型 名称 说明 🔒 互斥锁(Mutex) pthread_mutex_t/std::mutex最常用的锁,保证同一时刻只有一个线程访问共享资源。 🧩 读写锁(RWLock) pthread_rwlock_t/std::shared_mutex允许多个读者同时访问,但写操作独占。读多写少时效率高。 🚦 信号量(Semaphore) sem_t/std::counting_semaphore控制资源访问数量,常用于生产者-消费者模型。 🧵 条件变量(Condition Variable) pthread_cond_t/std::condition_variable用于线程之间的等待与通知机制(典型场景:队列等待数据)。 ⏰ 自旋锁(Spinlock) pthread_spinlock_t/ 原子自旋实现忙等待锁,不睡眠,适合临界区很短的情况。 ⚙️ 原子操作(Atomic) std::atomic不使用锁,通过硬件原子指令保证线程安全,轻量高效。
Linux查看当前有什么进程在运行用什么命令
1️⃣ ps —— Process Status 查看当前用户或系统的进程状态
若想查看系统中所有进程:ps -ef 或者ps aux
-e:显示所有进程
f:全格式显示(包含父进程 PID、启动用户等信息)
a:显示所有终端的进程
u:显示用户信息
x:显示没有控制终端的进程
2️⃣ top 实时显示系统中正在运行的进程和资源占用情况(类似任务管理器)。
3️⃣ htop(更好看更方便)
htop 是 top 的增强版(需要安装)
怎么减小性能消耗
性能消耗主要来自:
CPU计算(算法效率低、循环多、锁竞争)
内存使用(频繁申请/释放、拷贝多、缓存失效)
IO瓶颈(磁盘读写慢、网络延迟)✅ 1. 算法与数据结构优化
用更高效的数据结构(比如 unordered_map 代替 map,deque 替代 list)
降低复杂度:从 O(n²) 优化到 O(n log n)
所以优化的总体目标是: 减少重复计算、减少内存拷贝、减少阻塞等待✅ 2. 减少内存分配次数(堆操作最耗)
避免频繁 new/delete,改用对象池或复用。
在循环外创建临时对象而不是循环内。
使用 智能指针 控制生命周期,避免内存泄漏。✅ 3. 避免不必要的拷贝
传参使用 const & 或 const T*
C++11 后推荐:void func(std::string&& s); // 移动语义,避免拷贝✅ 4. 减少锁竞争(多线程场景)
尽量使用 无锁结构 或 原子操作。
减小临界区范围。
读多写少用 shared_mutex。性能优化的核心是先定位瓶颈,再针对性优化。 我一般会从算法、内存、锁竞争、I/O 和系统参数这几方面分析。 比如 CPU 占用高,我会用
perf 看热点函数; 如果是内存泄漏,就用 valgrind 分析分配路径。
说一下以下四行代码含义
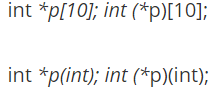
p 是一个包含 10 个元素的数组,每个元素都是 int* 类型
p 是一个指针,指向一个包含 10 个 int 元素的数组
p是一个函数声明,该函数接收一个 int 参数,返回 int*。
p 是一个指针,指向一个函数,该函数接收一个 int 参数,返回 int
声明 类型含义 解释 int *p[10];指针数组 10 个 int 指针 int (*p)[10];数组指针 指向含 10 个 int 的数组 int *p(int);函数 参数 int,返回 int* int (*p)(int);函数指针 指向返回 int、参数 int 的函数
继承里的override和final关键字的作用
让编译器强制检查:当前函数确实重写(override)了基类的虚函数。如果你写错函数名、参数、const修饰等,编译器会直接报错,防止隐藏 bug
告诉编译器“这个函数或类不允许再被重写或继承”。
文本处理,文件查找用什么命令
Linux中文本处理主要用 grep、awk、sed, 文件查找主要用 find、locate、which、grep -r。 组合使用时配合
xargs 和管道符 | 效率更高
function和普通函数指针的区别
函数指针只能指向签名完全匹配的普通函数,功能单一; 而 std::function
是一个泛型函数包装器,可以保存任意可调用对象(函数、lambda、仿函数等),内部通过类型擦除实现,使用更灵活、更安全,是现代C++推荐的回调方式。
对比点 函数指针 std::function定义方式 void (*p)(int)std::function<void(int)>可存储类型 仅普通函数或静态函数 几乎所有可调用对象(函数、lambda、仿函数、bind) 类型检查 严格(参数签名必须匹配) 自动推断,可包装任意可调用对象 安全性 无空检查,容易出错 内部有安全检查 可读性 语法复杂 简洁直观 性能 稍快(直接指针) 稍慢(内部封装类型擦除) 典型用途 C风格回调 现代C++回调、异步、事件机制
链表可以用快排吗,链表怎么排序(冒泡?挨个交换)
链表不能高效地用快排,因为快排需要随机访问; 链表排序推荐使用 归并排序,时间复杂度 O(n log n),实现简洁且性能好。
❗链表不适合快排,虽然能实现,但性能一般。 因为: 快排依赖随机访问(数组下标访问效率高); 而链表只能从头遍历到尾,无法快速定位中间元素;
所以对链表用快排,分区操作(partition)会非常慢。
18、代码实现的get和put函数时间复杂度?
2.tcp粘包怎么处理(我回答加请求头放数据长度)
7.设计一个支持海量连接的TCP服务器
3.如果有人故意把请求头写错怎么处理(有点懵,说了个可以稍作检查,如果长度太离谱就丢掉)
6.半同步半反应堆讲一下?
7.比较一下Reactor和Proactor的区别。
8.epoll和select、poll之间的区别讲一下?
10.共享内存实现原理?解决共享内存弊端,我们一般给内存加锁还是进程?
11.临界区呀,临界区和锁相比优势在哪儿?
13.介绍一下NAT的种类(答成了NAT的类型)
14.讲一下VLAN作用吧。
15.VLAN 0 用来干什么?
16.刚刚听你说交换机通过广播转发MAC,那你的MAC有做绑定吗?
5.强制类型转换?(知道吗?你用过的是怎样的转换)
8.对rust的了解(简历里提到一嘴)
4.使用过constexpr吗?举例说明其应用场景
5.如何调试正在运行的服务而不中断业务?
6.如何在生产环境中检测内存越界问题?
总结
提示:这里对文章进行总结:
例如:以上就是今天要讲的内容,本文仅仅简单介绍了pandas的使用,而pandas提供了大量能使我们快速便捷地处理数据的函数和方法。

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 7
 0
- 0


 已为社区贡献2条内容

所有评论(0)