【收藏级干货】构建生产级RAG系统:大模型应用开发者的完整技术栈
引言
在人工智能技术快速工程化的今天,检索增强生成(RAG)已成为连接大语言模型与私有知识、实现智能应用的主流范式。然而,构建一个“Hello World”级别的演示与部署一个高可用、高性能、可观测的生产级RAG系统之间存在巨大鸿沟。本文旨在梳理与归纳经过实战检验的核心技术生态,提供一份聚焦工程落地的工具清单与架构指南,以跨越这一鸿沟。
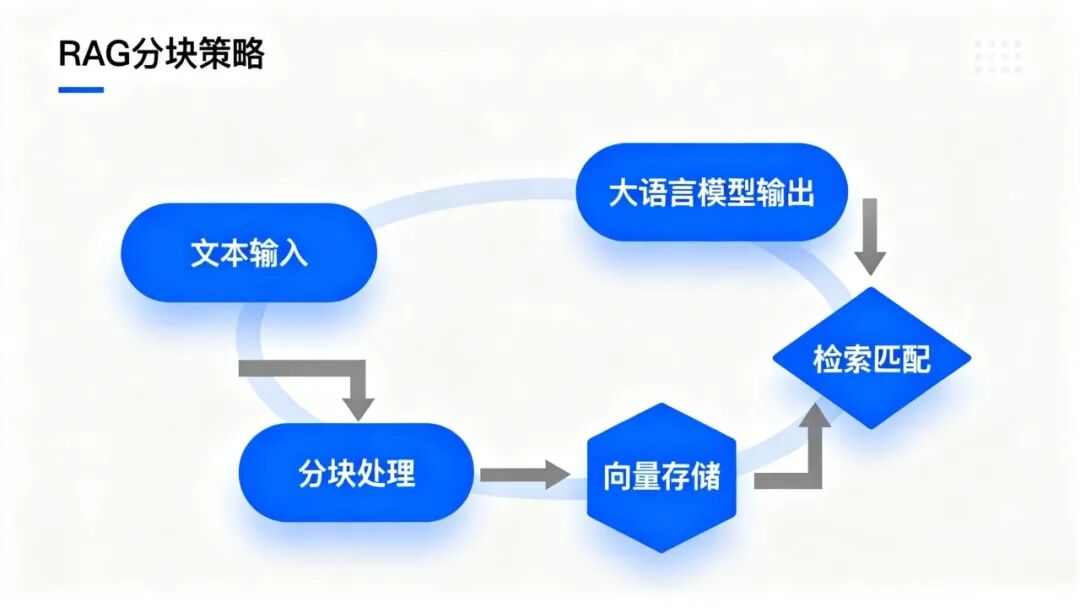
一、核心理念:生产级RAG的技术栈分层模型
一个健壮的生产级RAG系统远非一个嵌入模型加一个向量数据库那么简单。它需要一个层次化、可观测、可迭代的完整技术栈支撑。我们可以将其抽象为以下模型:
- 数据与索引层:负责数据的处理、嵌入与存储,是系统的基石。
- 检索与理解层:在索引之上执行高效、精准的搜索与语义理解,决定召回质量。
- 编排与推理层:协调检索、重排序、提示工程与大模型调用,构成核心工作流。
- 评估与优化层:持续监控系统表现,通过量化指标驱动迭代优化。
- 运维与安全层:保障系统的稳定性、可观测性及数据安全性。
下文将依此模型,梳理各层级的核心工具与最佳实践。
二、数据与索引层:向量数据库选型指南
向量数据库是RAG系统的记忆体,其选型直接决定了系统的规模、性能与成本。
| 工具 | 核心定位与优势 | 典型生产场景 |
|---|---|---|
| Chroma | 开发友好,嵌入式运行,零配置 | 本地原型验证、中小规模PoC |
| Qdrant | 性能与功能平衡,过滤能力强,云服务友好 | 千万级向量以下的主流生产选择 |
| Pinecone | 全托管、无服务器架构,极致简化运维 | 追求快速上线、不愿管理数据库集群的团队 |
| Weaviate | 原生支持混合检索(向量+关键词),具备类图数据库能力 | 需要结合精确关键字匹配与语义搜索的场景 |
| Milvus | 开源标杆,为超大规模向量搜索设计,分布式能力强 | 十亿级向量规模、对数据主权和定制化有极高要求 |
| pgvector | PostgreSQL扩展,技术栈统一 | 已深度使用PostgreSQL,希望复用现有基础设施与知识 |
选型建议:从Chroma开始原型设计,生产环境优先考虑Qdrant Cloud或Pinecone以降低运维负担。仅当数据量确达亿级且团队具备相应运维能力时,再评估自托管Milvus。
三、检索与理解层:超越基础向量搜索
单纯依赖稠密向量检索(Embedding Search)易遗漏关键词精确匹配的结果,而仅用稀疏检索(如BM25)则无法捕捉深层语义关联。因此,“混合搜索 + 重排序” 已成为生产系统的黄金标准。
1)混合检索(Hybrid Search):
- 价值:同时执行向量检索与关键词检索,综合两者得分,兼顾语义相关性与术语精确性,可将召回率提升20%以上。
- 工具:Weaviate、Elasticsearch(与ML插件结合)、Vespa等均原生支持。也可在应用层组合不同检索器的结果。
2)重排序(Reranking):
- 价值:使用计算代价更高、更精细的模型(如交叉编码器)对混合检索返回的Top K(如100条)结果进行精排,筛选出最相关的Top N(如5条)送入大模型。这是提升答案质量性价比最高的环节之一。
- 核心工具:
- Cohere Rerank API:效果稳定、易用性高的托管服务。
- BGE-Reranker / bge-reranker-v2-m3:开源领域当前效果领先的交叉编码器模型。
- FlashRank:基于Rust的极速轻量级重排序库,支持CPU运行,适合对延迟敏感的场景。
标准工作流:混合检索召回 Top 100 → 重排序模型精筛至 Top 5 → 将精筛后的上下文注入LLM生成最终答案。此模式已被Notion、Discord等公司的生产系统验证。
四、编排与推理层:框架的选择哲学
框架负责串联起检索、重排序、提示工程和LLM调用等环节,是系统的“大脑”。
- LangChain:生态之王,适合快速原型验证。拥有最庞大的集成生态和社区支持,能快速连接各种工具。但其高度抽象有时会在生产部署时带来冗余和调试复杂度。
- LlamaIndex:“数据感知”的RAG专家框架。专为RAG设计,在数据连接、索引结构(如知识图谱、分层索引)、高级检索策略(如子查询、递归检索)上具有天然优势,适合构建复杂查询系统。
- Haystack:类型安全的企业级流水线。采用明确的、类型安全的DAG(有向无环图)定义工作流,强调可复现性、可测试性和可审计性,非常适合对流程合规有严格要求的金融、医疗等领域。
- LangGraph:构建有状态、多智能体工作流。基于图的编程模型,原生支持循环、分支和状态持久化,是开发复杂Agent(如模拟对话、多步骤规划)的理想选择。
选型建议:追求开发速度和新功能探索选LangChain;构建复杂、数据驱动的RAG系统选LlamaIndex;企业级合规应用选Haystack;开发高级智能体应用选LangGraph。
五、评估与优化层:数据驱动的迭代闭环
“没有度量,就无法优化”。生产级RAG必须建立科学的评估体系。
1)核心评估维度:
- 上下文相关性:检索到的文档是否与问题真正相关?
- 答案忠实度:生成的答案是否严格基于给定上下文,未产生幻觉?
- 答案相关性:答案是否全面、准确地回答了问题?
2)核心评估工具:
- RAGAs / ARES:采用LLM-as-a-Judge(大模型即评判员)的自动化评估框架,无需人工标注即可对上述维度进行评分,快速进行批量实验对比。
- DeepEval:专为CI/CD设计的评估框架,像写单元测试一样定义评估用例,可无缝集成到开发流水线中。
- TruLens / LangSmith:提供 tracing 和评估一体化解决方案,能记录每次调用的链式步骤并自动计算相关指标。
- 关键提示:自动化评估结果(尤其是使用GPT-4等作为评判员时)需与约100-200条人工标注样本进行校准,其与人类判断的一致性通常约为85%,不可完全依赖。
六、运维与安全层:生产的守护者
1)可观测性(Observability):
- 核心指标:延迟(P50/P95/P99)、令牌消耗与成本、检索相关度分数、嵌入漂移(监控数据分布变化)。
- 关键工具:
- LangSmith / Langfuse:RAG与LLM应用可观测性的标杆。提供完整的追踪链、提示词版本管理、会话回放、成本分析等功能。Langfuse开源,更适合自定义部署。
- Arize Phoenix:专注于嵌入可视化与检索调试,可直观展示查询与文档的嵌入聚类,快速定位检索失败原因。
- OpenLIT:基于OpenTelemetry标准,可无侵入式地集成到现有应用中,并将数据对接至Prometheus/Grafana等成熟监控栈。
2)部署与服务化:
- 原型架构:Ollama (本地LLM) + Chroma + Streamlit。适合完全离线的概念验证。
- 标准生产架构:Qdrant Cloud / Pinecone (向量库) + Cohere Rerank (重排序) + 主流LLM API (如GPT-4) + Langfuse (观测)。覆盖90%的云上应用场景。
- 大规模定制架构:自托管vLLM / TGI (LLM服务) + 分布式Milvus (向量库) + 自定义微服务 + OpenLIT (监控)。适用于对数据主权、成本、规模有极端要求的场景。
3)安全防护:
- 风险:提示词注入、敏感信息(PII)泄露、越狱攻击。
- 核心工具:
- Presidio:在数据嵌入前进行PII实体识别与脱敏。
- NeMo Guardrails / LLM Guard:为LLM对话设置可编程的内容安全护栏,过滤不当输入与输出。
- PrivateGPT:提供完全离线的RAG解决方案,满足最高级别的数据隐私要求。
七、业界实践启示
- Notion AI:采用 Pinecone + GPT-4 + 自定义嵌入模型,并通过实现混合搜索显著提升了检索召回率。
- Shopify:通过领域知识微调嵌入模型和重排序器,将特定场景下的幻觉率从18%大幅降低至4%。
- 共性洞察:领先的生产系统无一例外地采用了混合检索、多阶段重排序、持续的自动化评估以及全面的可观测性这套组合拳。这表明,构建卓越的RAG系统,工程实践的成熟度与算法模型的选择同等重要。
普通人如何抓住AI大模型的风口?
领取方式在文末
为什么要学习大模型?
目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
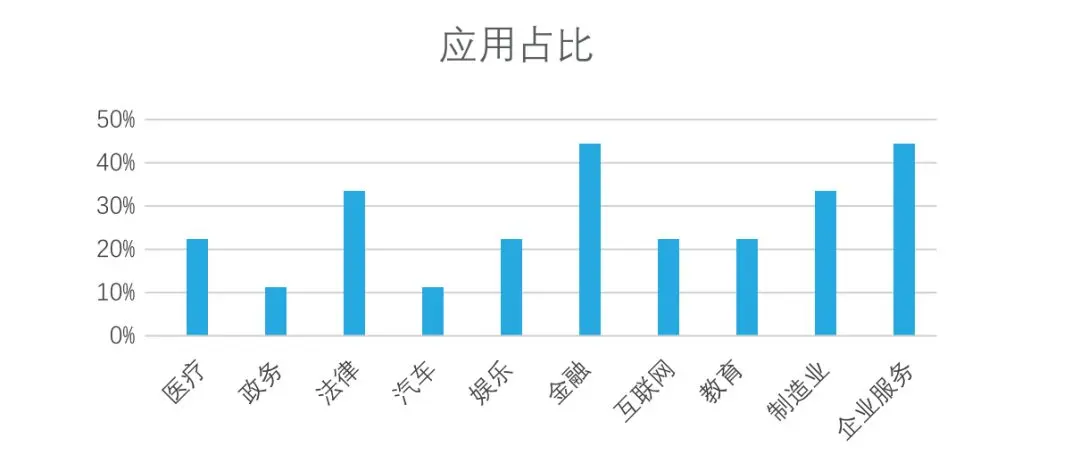
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。
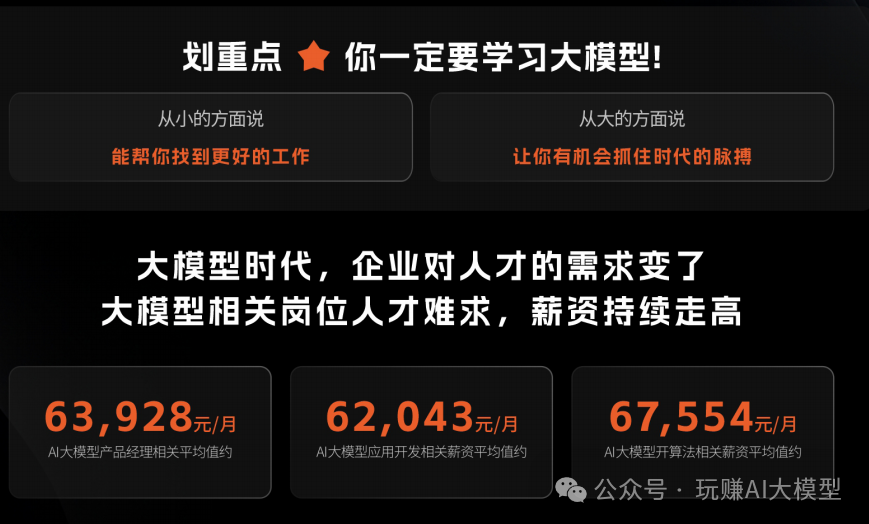
随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:
人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!
最后
只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!
在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
大模型全套学习资料展示
自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。
希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!
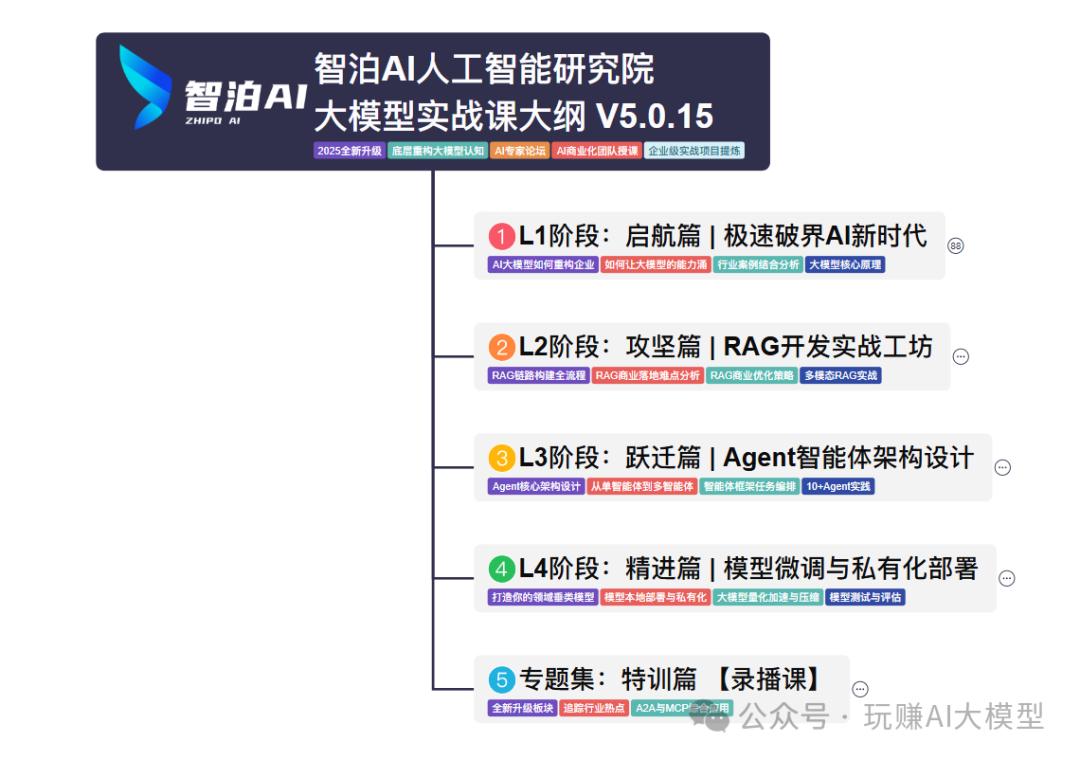
01 教学内容
-
从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!
-
大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
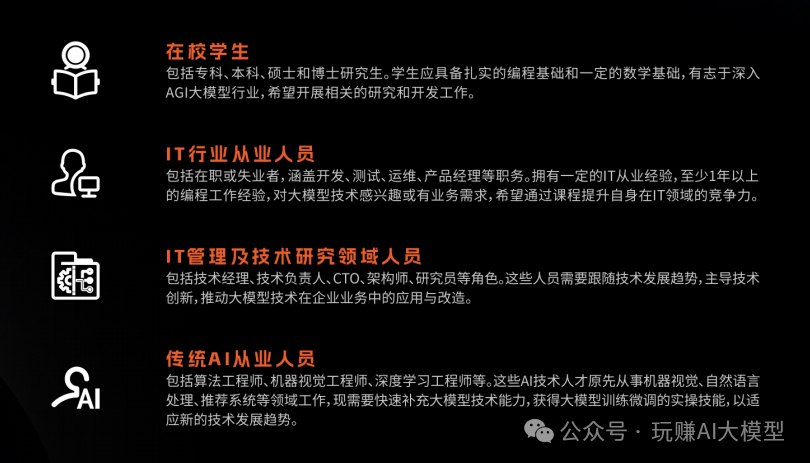
02适学人群
应届毕业生: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。
vx扫描下方二维码即可
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!
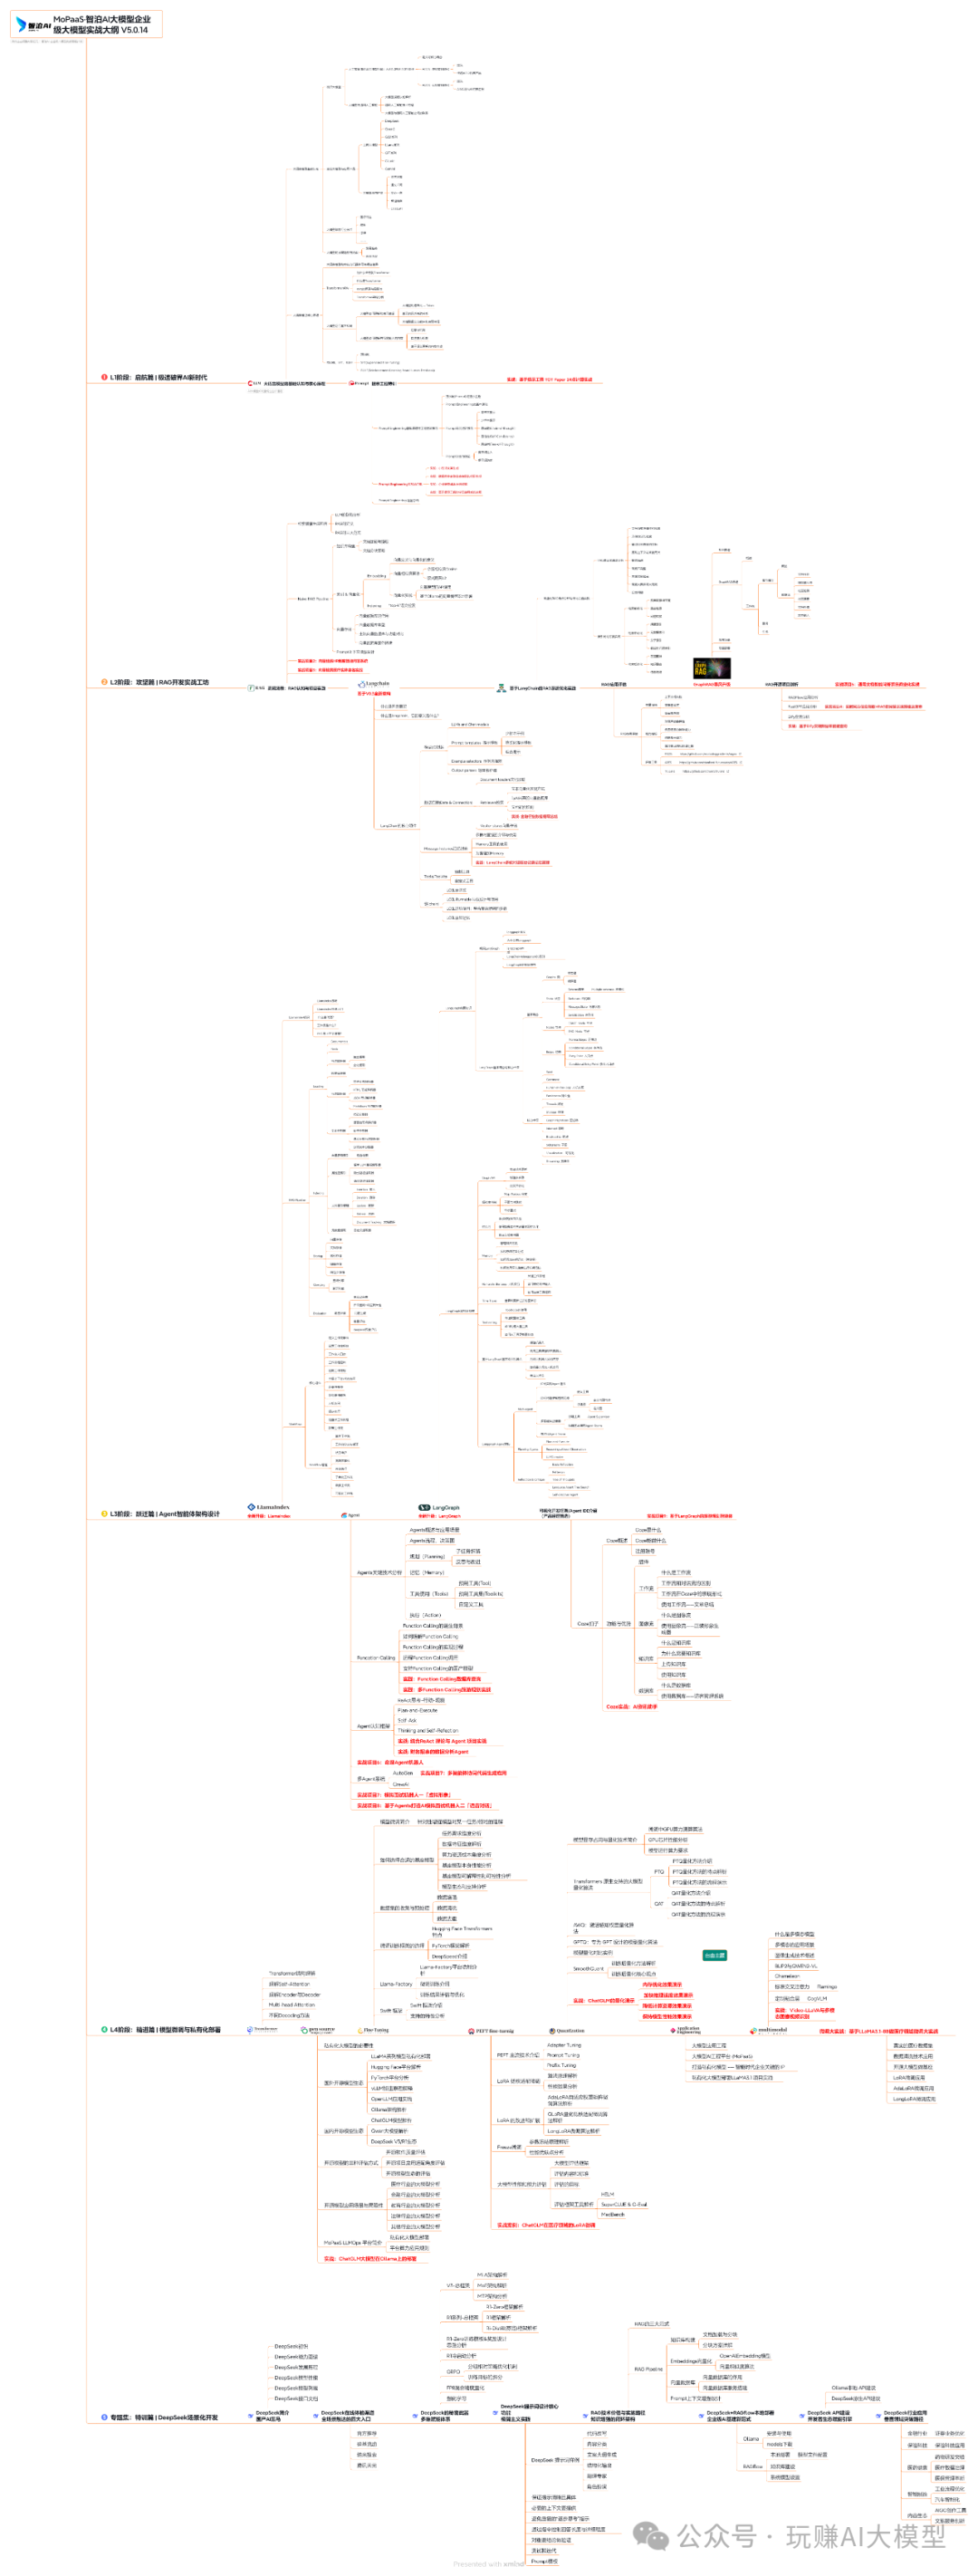
03 入门到进阶学习路线图
大模型学习路线图,整体分为5个大的阶段:
04 视频和书籍PDF合集
从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)
新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)
05 行业报告+白皮书合集
收集70+报告与白皮书,了解行业最新动态!
06 90+份面试题/经验
AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)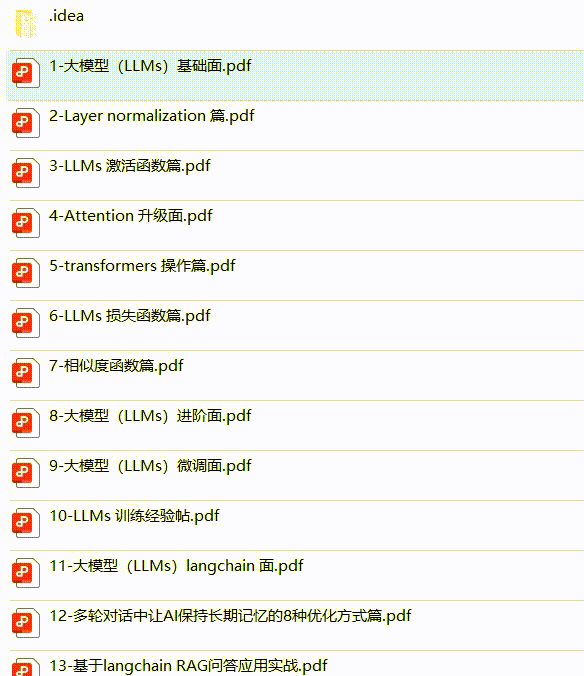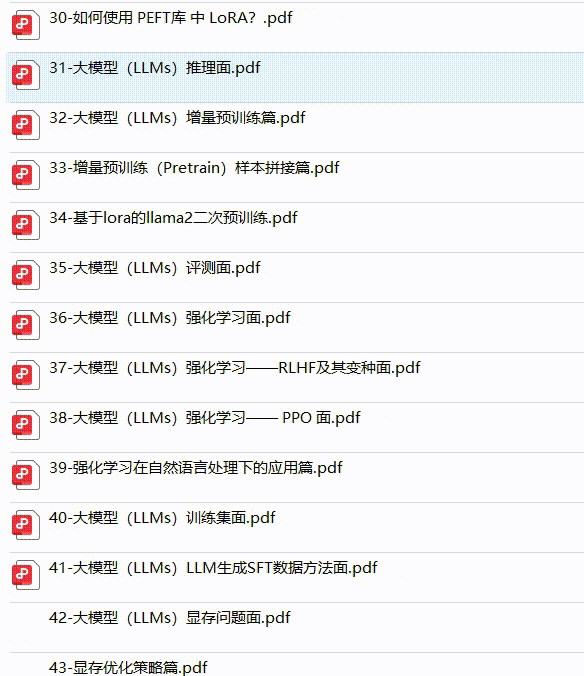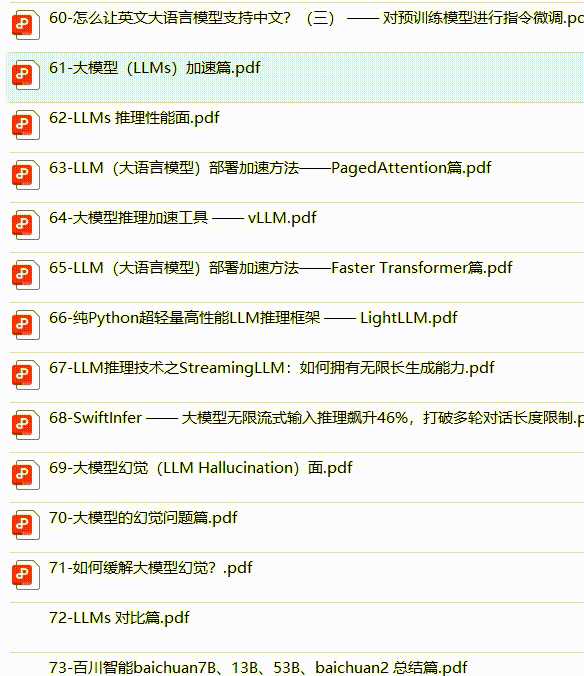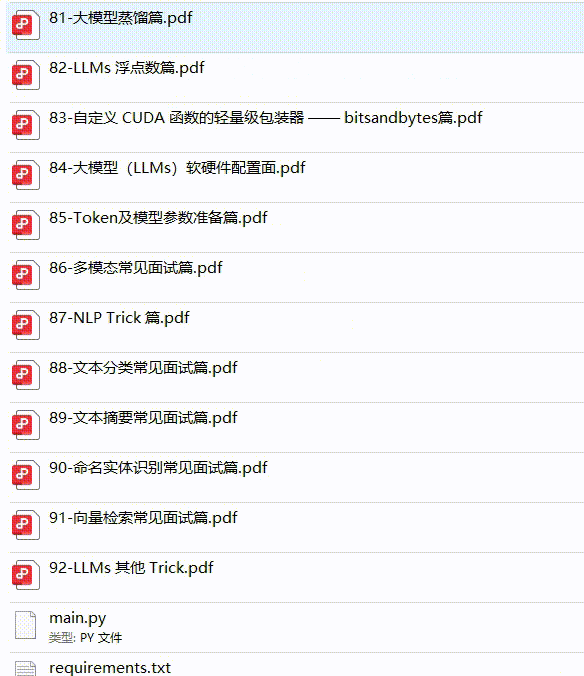
07 deepseek部署包+技巧大全
由于篇幅有限
只展示部分资料
并且还在持续更新中…
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 29
 0
- 0


 已为社区贡献161条内容

所有评论(0)