AI Agent时代来了!8大前沿开源项目总览
传统药物研发困于"不可能三角",AI从工具进化为Agent打破困局。本文盘点8大前沿开源Agent项目,涵盖结构预测、分子对接、性质预测等核心能力,深度解析其架构、优势与挑战,并提供场景化选型建议。从MolAgent的框架到DiffDock的扩散模型,从Chai-1的抗体预测到OpenFold的结构复刻,AI Agent正加速药物研发范式跃迁,推动多Agent协同、生成式AI+实验验证闭环等五大趋势演进。🚀
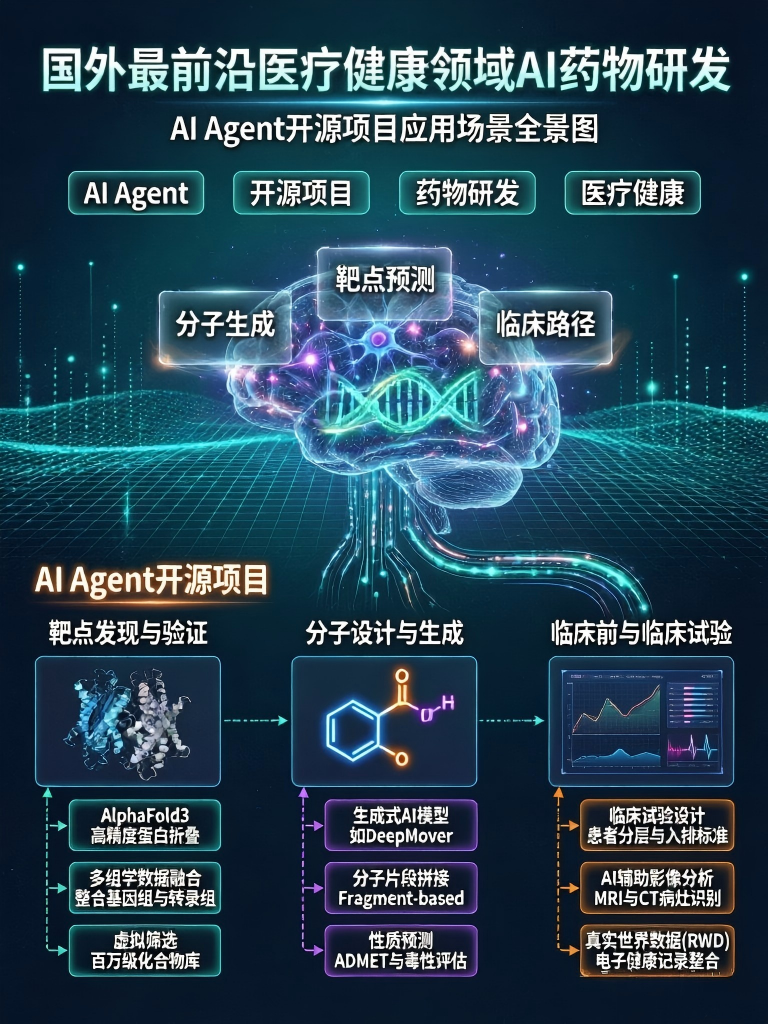
一、行业背景:从"工具时代"到"Agent时代"的范式跃迁
1.1 药物研发的"不可能三角"
传统药物研发长期被困在一个"不可能三角"中:高成功率 × 低成本 × 短时间,三者不可兼得。据统计,一款新药从发现到上市平均耗时10-15年、耗资26亿美元,且临床失败率高达90%以上。
高成功率 /\ / \ / \ 低成本/______\短时间
1.2 AI Agent:打破三角的"第三极"
过去十年,AI在药物研发中扮演的是被动工具角色——你喂数据、它出结果。但2024-2026年,随着大语言模型(LLM)和Agent架构的成熟,AI正在从"工具"进化为"智能体":
| 维度 | AI工具时代(2018-2023) | AI Agent时代(2024-2026+) |
|---|---|---|
| 交互方式 | 手动配置参数、编写脚本 | 自然语言描述意图 |
| 任务执行 | 单点任务(如对接/预测) | 多步规划+自主执行+反馈迭代 |
| 工具调用 | 用户手动串联工具 | Agent自动调度工具链 |
| 知识积累 | 每次独立运行 | 记忆+经验沉淀+持续进化 |
| 门槛 | 需要计算化学/编程背景 | 生物学家零代码可用 |
1.3 为什么是现在?
三大技术汇流催生了AI药物研发Agent的黄金时刻:
-
- 基础模型成熟:AlphaFold系列、ESM系列、DiffDock等奠定了结构预测的底层能力
-
- Agent框架标准化:ReAct、MCP(Model Context Protocol)、A2A等协议让异构Agent可互操作
-
- 算力普惠化:云端GPU集群+开源模型 democratize 了药物研发的算力门槛
二、全景扫描:8大前沿开源Agent项目总览
2.1 项目矩阵速览
| 序号 | 项目名称 | 机构/团队 | 核心定位 | 开源协议 | GitHub地址 |
|---|---|---|---|---|---|
| 1 | MolAgent | Open Analytics / 安特卫普大学 | 智能体时代的生物分子性质预测框架 | MIT | github.com/openanalytics/MolAgent |
| 2 | DiffDock | MIT CSAIL实验室 | 扩散模型驱动的分子对接Agent | MIT | github.com/gcorso/DiffDock |
| 3 | Chai-1 | Chai Discovery | 多模态生物大分子复合物预测Agent | Apache 2.0 | github.com/chaidiscovery/chai-lab |
| 4 | OpenFold | Columbia University / AQ Laboratory | AlphaFold的100%开源复刻版 | Apache 2.0 | github.com/aqlaboratory/openfold |
| 5 | RoseTTAFold | 华盛顿大学 David Baker实验室 | 蛋白结构预测与设计的开源标杆 | MIT | github.com/rosettacommons/roseTTAFold |
| 6 | ESMFold | Meta AI | 蛋白大语言模型驱动的超快速结构预测 | MIT | github.com/facebookresearch/esm |
| 7 | BoltzGen | MIT + Boltz团队 | 全原子生成式结合剂设计Agent | MIT | github.com/HannesStark/boltzgen |
| 8 | DeepChem | DeepChem社区 | 深度学习药物发现全栈框架 | Apache 2.0 | github.com/deepchem/deepchem |
2.2 能力维度雷达图(文字版)
分子生成能力 /\ / \ / \ 结构预测 ----/------\---- 虚拟筛选 | | | | | | 性质预测 ----\------/---- 工作流自动化 \ / \ / \/ 工具生态成熟度
各项目能力侧重:
- • 结构预测之王:Chai-1 ≈ OpenFold ≈ RoseTTAFold
- • 对接模拟之王:DiffDock
- • 分子设计之王:BoltzGen
- • 全栈框架之王:DeepChem / MolAgent
三、深度解读:每个项目的架构、产品优势与挑战
3.1 MolAgent —— “智能体时代的分子性质预测基础设施”
📍 开源地址:https://github.com/openanalytics/MolAgent
🏛 架构解析:
┌─────────────────────────────────────────────┐│ 用户自然语言指令 │└──────────────────┬──────────────────────────┘ │ ▼┌─────────────────────────────────────────────┐│ Agent Orchestrator (调度器) ││ • 任务理解与拆解 ││ • 工具链自动编排 ││ • 反馈闭环优化 │└──────┬──────────┬──────────┬────────────────┘ │ │ │ ▼ ▼ ▼┌─────────┐┌─────────┐┌─────────┐│特征工程 ││模型选择 ││集成预测 ││自动化 ││自动优化 ││自动验证 │└─────────┘└─────────┘└─────────┘ │ ▼┌─────────────────────────────────────────────┐│ MCP协议输出 → 兼容任意Agent基础设施 │└─────────────────────────────────────────────┘
🎯 产品优势:
- • 与系统无关的Agent框架:不绑定特定LLM或Agent平台,可即插即用
- • MCP协议原生支持:天然兼容Google的MCP和A2A协议,未来可无缝接入更广阔的Agent生态
- • 端到端自动化:从特征工程到模型选择到集成验证,全流程无人化
- • 学术背书:发表于J. Chem. Inf. Model.(ACS旗下权威期刊)
⚠️ 挑战与局限:
- • 聚焦"性质预测"单点能力,尚未覆盖分子生成和对接全流程
- • 社区生态尚在早期,工具链丰富度不如DeepChem
- • 工业级验证案例较少,主要停留在学术 benchmark
🎬 适用场景:药物发现早期阶段的ADMET预测、毒性评估、成药性筛选
3.2 DiffDock —— “用扩散模型重写分子对接规则”
📍 开源地址:https://github.com/gcorso/DiffDock
🏛 架构解析:
┌──────────────────────────────────────────────┐│ 输入:蛋白质PDB + 配体SMILES │└──────────────────┬───────────────────────────┘ │ ▼┌──────────────────────────────────────────────┐│ Diffusion Process (扩散过程) ││ ││ 正向:给配体位置加噪声 → 随机散布 ││ 反向:学习"去噪" → 精准"拉"入活性口袋 ││ ││ 三个自由度:平移 + 旋转 + 扭转 │└──────┬───────────────────┬───────────────────┘ │ │ ▼ ▼┌─────────────┐ ┌─────────────┐│ Score Model │ │Confidence ││ (评分模型) │ │Model(置信度) ││ 引导分子移动 │ │筛选最优姿态 │└─────────────┘ └─────────────┘ │ ▼┌──────────────────────────────────────────────┐│ 输出:最优结合构象 + RMSD预测 │└──────────────────────────────────────────────┘
🎯 产品优势:
- • 盲对接之王:无需预先指定结合口袋,自动在整个蛋白表面搜索结合位点,准确率远超传统方法
- • 生成式范式革命:摒弃传统"采样-打分"范式,用扩散模型直接生成稳定结合构象
- • 速度优势:GPU上推理速度比传统对接工具快3-12倍
- • 社区事实标准:全球超80%开源AI对接项目以其为基础框架
⚠️ 挑战与局限:
- • 蛋白柔性处理不足(主要假设蛋白为刚性)
- • 亲和力预测能力有限(需结合GNINA/MM-GBSA二次评分)
- • 对大分子/多肽/核酸的适配性有限
🎬 适用场景:小分子药物虚拟筛选、老药新用、未知靶点结合位点发现
3.3 Chai-1 —— “药物发现的ChatGPT时刻”
📍 开源地址:https://github.com/chaidiscovery/chai-lab
🏛 架构解析:
┌─────────────────────────────────────────────────┐│ Chai-1 单模型架构 ││ ││ 输入:蛋白质序列 + 小分子SMILES + 核酸序列 ││ + 抗体序列 + 共价修饰信息 ││ ││ ┌─────────────────────────────────────────┐ ││ │ Transformer + ESM语言模型底座 │ ││ └─────────────────────────────────────────┘ ││ │ ││ ▼ ▼ ▼ ││ 蛋白单体 蛋白复合物 蛋白-配体 ││ 结构预测 预测 对接预测 │└─────────────────────────────────────────────────┘ │ ▼┌─────────────────────────────────────────────────┐│ 输出:高精度3D结构 + 置信度评分 ││ PoseBusters蛋白-配体Top-1成功率: 82% ││ (超过AlphaFold3) │└─────────────────────────────────────────────────┘
🎯 产品优势:
- • 单模型覆盖全场景:蛋白、小分子、核酸、抗体、共价抑制剂,一个模型全部搞定
- • 抗体预测反超AF3:抗体-抗原界面预测精度是AlphaFold3的1.8倍
- • 无需MSA也能跑:单序列模式即可工作,大幅降低计算成本
- • 团队基因强大:创始团队来自OpenAI、Google FAIR、Absci,CEO曾参与GPT-1/2开发
⚠️ 挑战与局限:
- • 开源仅限非商业用途(商业需许可)
- • Chai-2/Chai-3已转向闭源,开源版本可能落后
- • 复合物预测中相对定位偶有偏差
🎬 适用场景:抗体-抗原设计、蛋白-小分子对接、多聚体结构预测、全新靶点结构注释
3.4 OpenFold —— “AlphaFold2的完全开源复刻”
📍 开源地址:https://github.com/aqlaboratory/openfold-3 (OpenFold3预览版)
🏛 架构解析:
┌─────────────────────────────────────────────────┐│ OpenFold 架构 (AF2复刻) ││ ││ 输入:氨基酸序列 ││ │ ││ ▼ ┌──────┴─────┐│ MSA生成 │ 模板检索 ││ (HHblits/MMseqs2) │ (PDB) ││ │ └──────┬─────┘│ └──────────┬─────────────────────────────┘│ ▼│ ┌─────────────────────────────────────────┐│ │ Backbone Generation (骨架生成) ││ │ + Pair Representation (残基对表征) ││ │ + Structure Module (结构模块) ││ └─────────────────────────────────────────┘│ ││ ▼│ 输出:原子级精度3D蛋白质结构 (pLDDT ≥ 90)└─────────────────────────────────────────────────┘
🎯 产品优势:
- • 100%精度复刻AF2:预测精度与AlphaFold2完全一致
- • 推理速度提升2-3倍:优化后的训练与推理效率
- • Apache 2.0完全商用自由:无商业使用限制,企业可自由部署
- • 全球60%药企在用:工业界替代AlphaFold2的绝对首选
⚠️ 挑战与局限:
- • 原生版本不支持蛋白-配体复合物预测(需配合其他工具)
- • OpenFold3预览版尚在早期,稳定性待验证
- • 需要大规模数据库支持(MSA生成是算力瓶颈)
🎬 适用场景:大规模蛋白结构预测、靶点结构注释、企业级私有化部署
3.5 RoseTTAFold —— “蛋白结构预测的开源双子星”
📍 开源地址:https://github.com/rosettacommons/roseTTAFold
🏛 架构解析:
┌─────────────────────────────────────────────────┐│ RoseTTAFold 三轨网络架构 ││ ││ Track 1: 序列轨道 ──────────┐ ││ Track 2: 距离轨道 ──────────┼── 交互注意力 ──► 融合 ││ Track 3: 坐标轨道 ──────────┘ ││ ││ ▼ ▼│ 进化信息(MSA) 拓扑约束 3D坐标迭代优化 │└─────────────────────────────────────────────────┘ │ ▼┌─────────────────────────────────────────────────┐│ 输出:高精度3D结构 + 蛋白-蛋白相互作用 ││ RFAA版本:覆盖AlphaFold3全部能力 ││ RoseTTAFold Diffusion:蛋白构象动态变化预测 │└─────────────────────────────────────────────────┘
🎯 产品优势:
- • 三轨注意力创新:序列+距离+坐标三轨并行交互,捕捉折叠的物理化学特性
- • RFAA全原子版本:支持蛋白、小分子、核酸、金属离子、辅因子的全原子复合物预测
- • MIT协议完全免费商用:代码、权重、训练数据全公开
- • 合成生物学行业标准:在蛋白设计、蛋白-核酸复合物上性能显著优于AF3
⚠️ 挑战与局限:
- • 环境配置复杂(依赖多个外部工具和数据库)
- • 推理速度较慢(相比ESMFold)
- • PyRosetta优化版需要额外许可证
🎬 适用场景:蛋白-核酸复合物预测、蛋白设计、多链蛋白组装、合成生物学
3.6 ESMFold —— “用大语言模型读蛋白质’天书’”
📍 开源地址:https://github.com/facebookresearch/esm
🏛 架构解析:
┌─────────────────────────────────────────────────┐│ ESMFold 架构 (基于ESM-2) ││ ││ 输入:氨基酸序列 (无需MSA!) ││ │ ││ ▼ ┌──────┴─────┐│ ESM-2 蛋白大语言模型 │ 模板检索 ││ (15亿参数/30亿参数/150亿参数) │ (可选) ││ │ └──────┬─────┘│ └──────────┬─────────────────────────────┘│ ▼│ ┌─────────────────────────────────────────┐│ │ Structure Module (结构模块) ││ │ (轻量级Trunk + 坐标预测头) ││ └─────────────────────────────────────────┘│ ││ ▼│ 输出:原子级精度3D结构 (速度极快!)└─────────────────────────────────────────────────┘
🎯 产品优势:
- • 极速推理:无需MSA计算,单序列直接预测,速度比AF2快100倍以上
- • 基因组级规模:可批量处理百万级蛋白的结构注释
- • MIT协议完全免费商用:支持本地部署
- • Meta背书:基于ESM系列大语言模型,持续迭代
⚠️ 挑战与局限:
- • 精度略低于AF2/Chai-1(尤其在复杂复合物场景)
- • 对长序列(>2000残基)的预测质量下降
- • 不支持蛋白-配体对接
🎬 适用场景:宏基因组蛋白注释、病原微生物蛋白快速预测、孤儿受体靶点发现、大规模虚拟筛选前置步骤
3.7 BoltzGen —— “全原子生成式蛋白结合剂设计”
📍 开源地址:https://github.com/HannesStark/boltzgen
🏛 架构解析:
┌─────────────────────────────────────────────────┐│ BoltzGen 全原子生成架构 ││ ││ 输入:靶蛋白结构 + 结合位点约束 ││ │ ││ ▼ ┌──────┴─────┐│ Boltz-1 基础模型 │ 设计规范 ││ (扩散模型+Transformer) │ 语言接口 ││ │ └──────┬─────┘│ └──────────┬─────────────────────────────┘│ ▼│ ┌─────────────────────────────────────────┐│ │ 几何连续表示 (替代离散残基标签) ││ │ + 联合训练: 蛋白折叠 + 结合剂设计 ││ └─────────────────────────────────────────┘│ ││ ▼ ▼ ▼│ 蛋白质 纳米抗体 环肽/小分子│ 设计 设计 设计└─────────────────────────────────────────────────┘ │ ▼┌─────────────────────────────────────────────────┐│ 输出:具有纳摩尔级亲和力的结合剂序列+结构 ││ 66%靶标获得纳摩尔级亲和力 │└─────────────────────────────────────────────────┘
🎯 产品优势:
- • 单一模型统一多模态:首次在单一全原子生成模型中统一蛋白折叠与结合剂设计
- • 跨分子类型可控生成:通过"设计规范语言"灵活切换蛋白质/纳米抗体/环肽/小分子
- • 实验验证出色:66%靶标获得纳摩尔级亲和力,超越传统方法数个数量级
- • MIT开源:完全自由使用
⚠️ 挑战与局限:
- • 相对较新(2025年10月发布),社区生态尚不成熟
- • 对靶蛋白质量要求高(需要高质量晶体结构)
- • 大规模虚拟筛选的吞吐量有待验证
🎬 适用场景:新型抗体设计、酶工程优化、小分子配体筛选、纳米抗体从头设计
3.8 DeepChem —— “AI药物发现的底层操作系统”
📍 开源地址:https://github.com/deepchem/deepchem
🏛 架构解析:
┌─────────────────────────────────────────────────┐│ DeepChem 全栈架构 ││ ││ ┌───────────────────────────────────────────┐ ││ │ Application Layer (应用层) │ ││ │ • 分子性质预测 • 毒性评估 • ADMET │ ││ │ • 虚拟筛选 • 分子生成 • 反应预测 │ ││ └─────────────────┬─────────────────────────┘ ││ │ ││ ┌─────────────────┴─────────────────────────┐ ││ │ Model Layer (模型层) │ ││ │ • GNN/Graph Convolution │ ││ │ • Transformer/BERT家族 │ ││ │ • 扩散模型 • 强化学习 │ ││ │ • DFT加速 • 分子动力学 │ ││ └─────────────────┬─────────────────────────┘ ││ │ ││ ┌─────────────────┴─────────────────────────┐ ││ │ Data Layer (数据层) │ ││ │ • ChEMBL/PubChem/ZINC │ ││ │ • 分子图表示 • SMILES/InChI │ ││ │ • 量子化学计算接口 │ ││ └───────────────────────────────────────────┘ │└─────────────────────────────────────────────────┘
🎯 产品优势:
- • 最全面的工具链:覆盖分子表征、模型训练、性质预测、虚拟筛选全流程
- • 图神经网络先驱:将分子视为图结构,完美保留拓扑信息
- • DFT加速突破:神经网络近似交换关联泛函,量子化学计算加速数百倍
- • 社区最活跃:GitHub Star数最高,社区贡献最活跃
⚠️ 挑战与局限:
- • 学习曲线陡峭(需要较强的编程和深度学习基础)
- • 缺乏高层Agent封装(需要自行搭建Agent逻辑)
- • 文档和示例质量参差不齐
🎬 适用场景:AI药物研发算法研究、自定义Agent框架搭建、大规模虚拟筛选管道、量子化学加速计算
四、选型建议:场景化选型矩阵
4.1 按研发阶段选型
| 药物研发阶段 | 推荐Agent项目 | 理由 |
|---|---|---|
| 靶点发现与验证 | ESMFold + OpenFold | 大规模蛋白结构快速注释 |
| 先导化合物发现 | DiffDock + MolAgent | 虚拟对接+性质预测双轮驱动 |
| 分子优化 | BoltzGen + Chai-1 | 生成式设计+亲和力优化 |
| ADMET评估 | MolAgent + DeepChem | 自动化性质预测+毒性评估 |
| 抗体设计 | Chai-1 + BoltzGen | 抗体-抗原预测+纳米抗体设计 |
| 全流程自动化 | DeepChem (自建Agent) | 最全面的底层工具链 |
4.2 产品化成熟度评估
| 项目 | 技术成熟度 | 社区活跃度 | 商用友好度 | 易用性 | 综合评分 |
|---|---|---|---|---|---|
| MolAgent | ★★★★☆ | ★★★☆☆ | ★★★★★ | ★★★★☆ | 4.1/5 |
| DiffDock | ★★★★★ | ★★★★★ | ★★★★☆ | ★★★☆☆ | 4.4/5 |
| Chai-1 | ★★★★★ | ★★★★★ | ★★★☆☆ | ★★★★☆ | 4.2/5 |
| OpenFold | ★★★★★ | ★★★★☆ | ★★★★★ | ★★★☆☆ | 4.2/5 |
| RoseTTAFold | ★★★★★ | ★★★★☆ | ★★★★★ | ★★☆☆☆ | 4.0/5 |
| ESMFold | ★★★★☆ | ★★★★★ | ★★★★★ | ★★★★★ | 4.4/5 |
| BoltzGen | ★★★★☆ | ★★★☆☆ | ★★★★★ | ★★★☆☆ | 3.8/5 |
| DeepChem | ★★★★★ | ★★★★★ | ★★★★★ | ★★☆☆☆ | 4.1/5 |
五、落地考量
5.1 合规与安全
| 考量维度 | 关键问题 | 建议措施 |
|---|---|---|
| 数据隐私 | 药物分子数据是否涉及商业机密? | 选择支持本地部署的开源方案(OpenFold/ESMFold) |
| 模型可解释性 | Agent决策是否可追溯? | 优先选择提供置信度评分和解释输出的项目 |
| 监管合规 | FDA/EMA对AI辅助药物审批的要求 | 保留完整实验验证链路,AI输出作为假设生成工具 |
| 开源协议 | 商用是否受限? | 注意Chai-1非商业限制,商用优先选MIT/Apache 2.0项目 |
5.2 技术集成路径
阶段1 (1-3月):基础能力验证 → 部署ESMFold/OpenFold做结构预测基线 → 部署DiffDock做对接验证阶段2 (3-6月):Agent框架搭建 → 基于MolAgent框架构建性质预测Agent → 集成MCP协议实现工具互操作阶段3 (6-12月):全流程自动化 → 串联"靶点结构→虚拟筛选→性质优化"工作流 → 引入强化学习闭环优化阶段4 (12月+):生产化部署 → 容器化+GPU集群部署 → 建立干湿实验闭环反馈机制
5.3 商业模式思考
| 模式 | 代表项目 | 核心逻辑 |
|---|---|---|
| 开源基座+商业许可 | Chai Discovery | 开源建立生态→闭源核心能力收费 |
| 工具免费+服务收费 | DeepChem社区 | 基础工具免费→企业级支持收费 |
| 平台即服务 | MolAgent | 开源框架→云端部署+定制开发 |
| 研究免费+工业授权 | OpenFold | 学术自由使用→工业场景授权 |
六、趋势展望:2025→2028技术演进路线
6.1 技术演进三阶段
2025 2026-2027 2028+ │ │ │ ▼ ▼ ▼┌─────────┐ ┌─────────┐ ┌─────────┐│ Agent │ │ Autonomous│ │ Frontier││ 工具链 │ ──────────────► │ 研发 │ ─────────────► │ 智能体 ││ 集成化 │ │ 操作系统 │ │ 自主进化 │└─────────┘ └─────────┘ └─────────┘ │ │ │ • 单点Agent • 多Agent协同 • 自主假设生成 • 工具串联 • 干湿闭环 • 自监督持续学习 • 人工监督 • 全链条自动化 • 跨物种泛化设计
6.2 值得关注的五大趋势
-
- 多Agent协同药物发现:单一Agent难以覆盖全流程,多Agent协作(一个负责对接、一个负责性质优化、一个负责合成路线规划)将成为主流
-
- MCP/A2A协议标准化:不同Agent间的通信协议将标准化,形成"药物研发Agent生态市场"
-
- 生成式AI+实验验证闭环:AI生成假设→湿实验验证→数据回流训练→迭代优化,形成真正的自主研发循环
-
- 小样本/零样本药物设计:针对罕见病靶点等数据稀缺场景,少样本学习能力成为核心竞争力
-
- AI原生药物发现公司崛起:类似Chai Discovery"只做软件不建管线"的新模式将挑战传统药企研发范式
最后
对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?
答案只有一个:人工智能(尤其是大模型方向)
当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应聘者,月基础工资也能稳定在4万元左右。
再看阿里、腾讯两大互联网大厂,非“人才计划”的AI相关岗位应聘者,月基础工资也约有3万元,远超其他行业同资历岗位的薪资水平,对于程序员、小白来说,无疑是绝佳的转型和提升赛道。
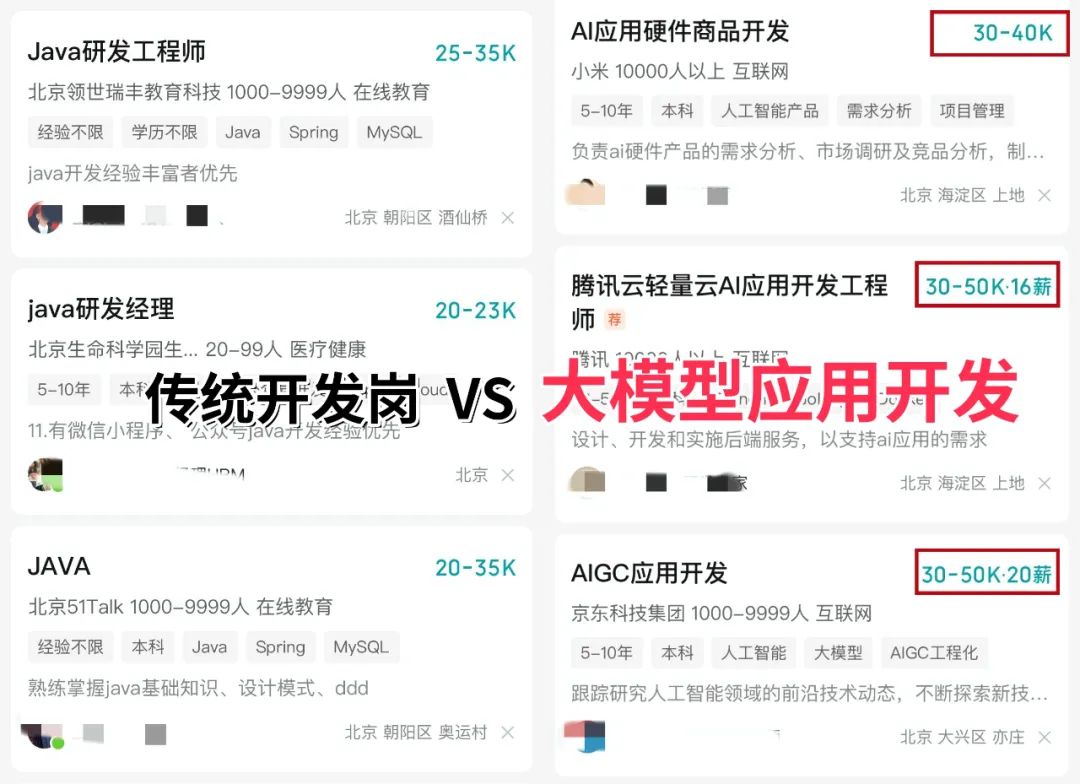
如果你还不知道从何开始,我自己整理一套全网最全最细的大模型零基础教程,我也是一路自学走过来的,很清楚小白前期学习的痛楚,你要是没有方向还没有好的资源,根本学不到东西!
下面是我整理的大模型学习资源,希望能帮到你。
👇👇扫码免费领取全部内容👇👇

最后
1、大模型学习路线
2、从0到进阶大模型学习视频教程
从入门到进阶这里都有,跟着老师学习事半功倍。
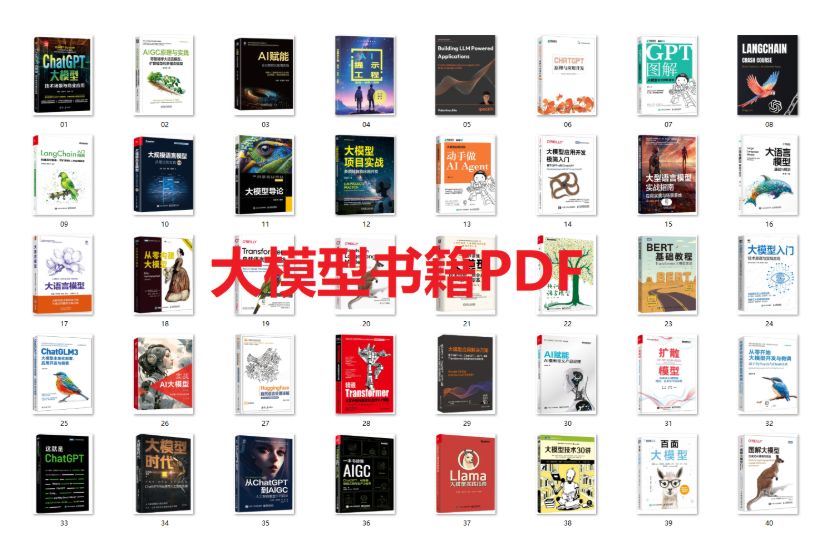
3、 入门必看大模型学习书籍&文档.pdf(书面上的技术书籍确实太多了,这些是我精选出来的,还有很多不在图里)
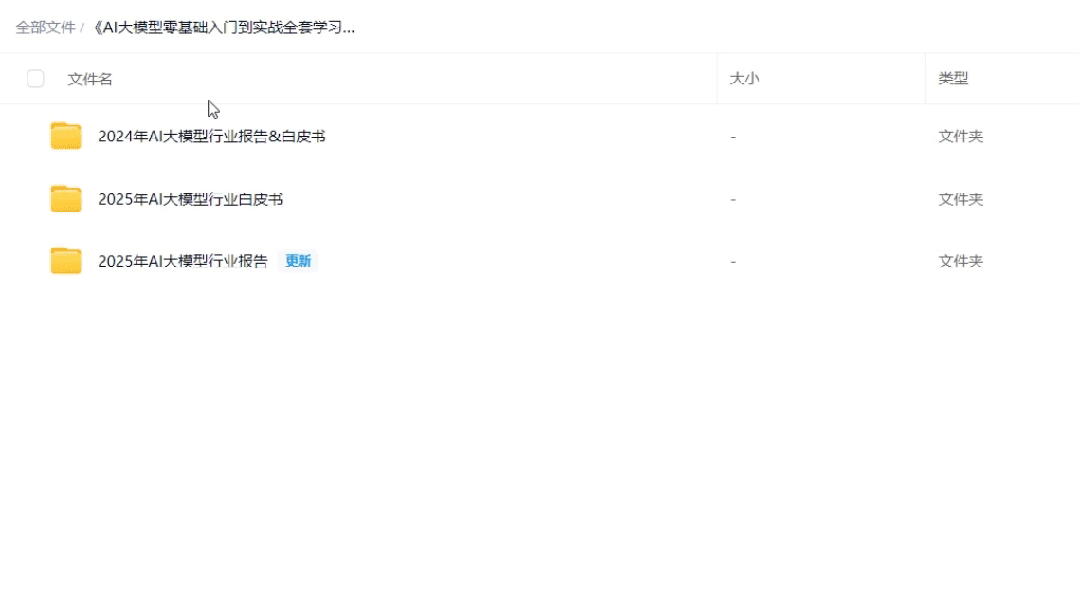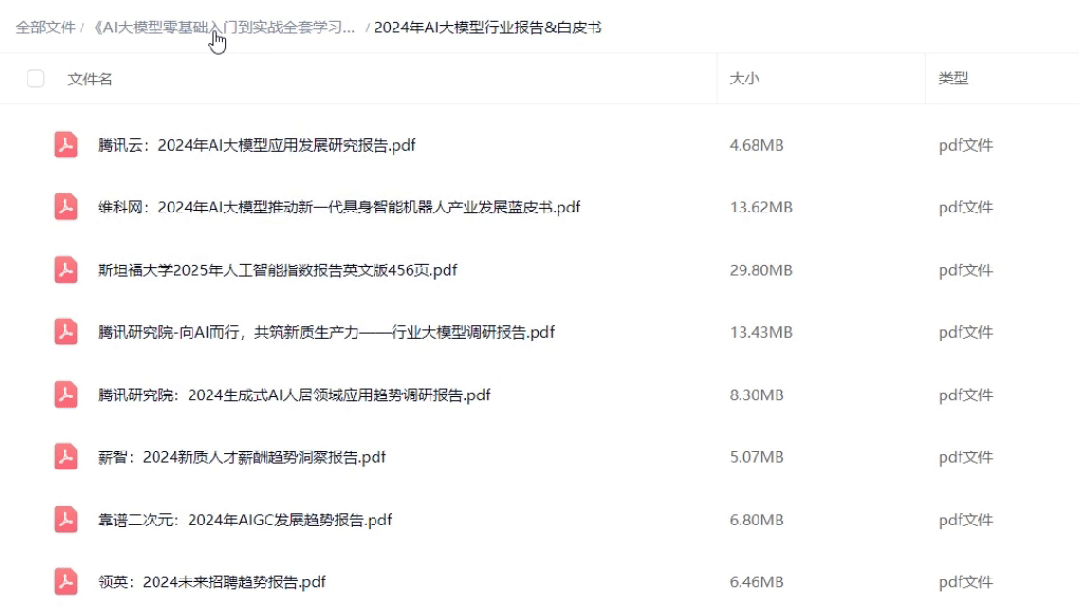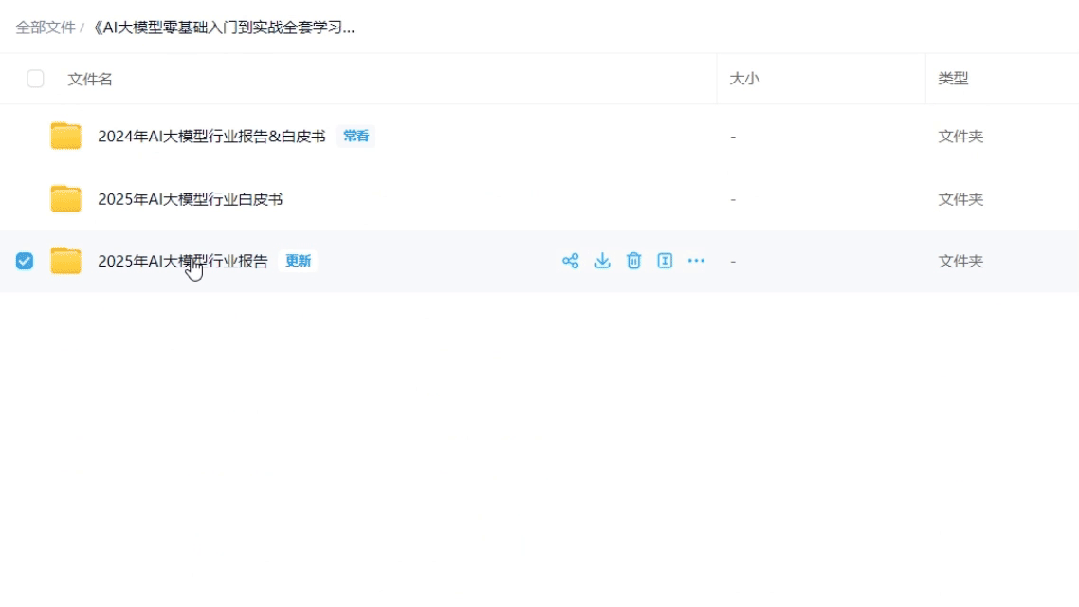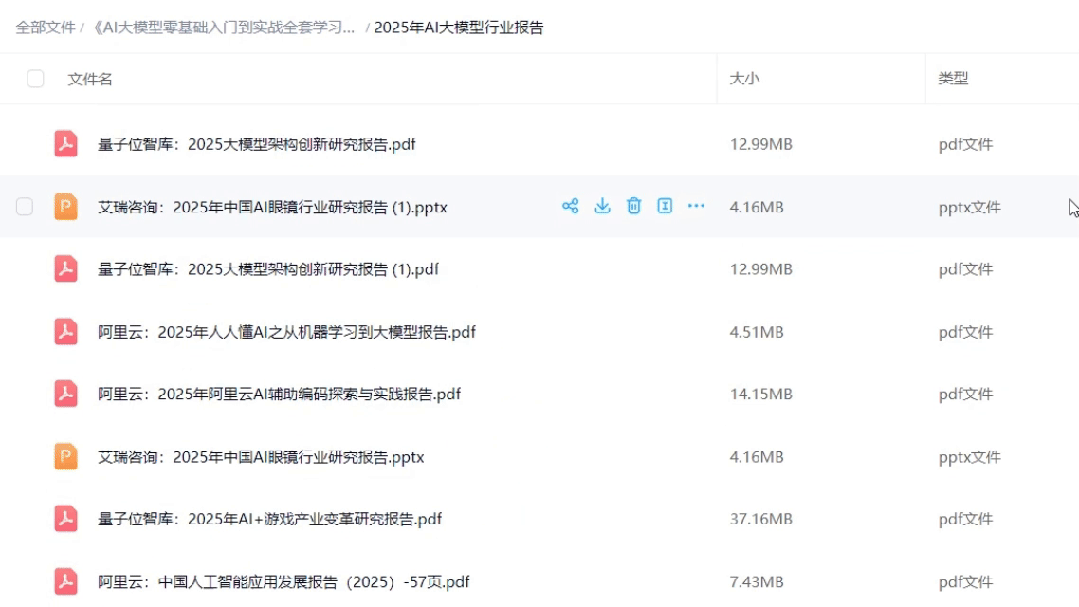
4、 AI大模型最新行业报告
2026最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。
5、面试试题/经验
【大厂 AI 岗位面经分享(107 道)】
【AI 大模型面试真题(102 道)】
【LLMs 面试真题(97 道)】
6、大模型项目实战&配套源码
适用人群
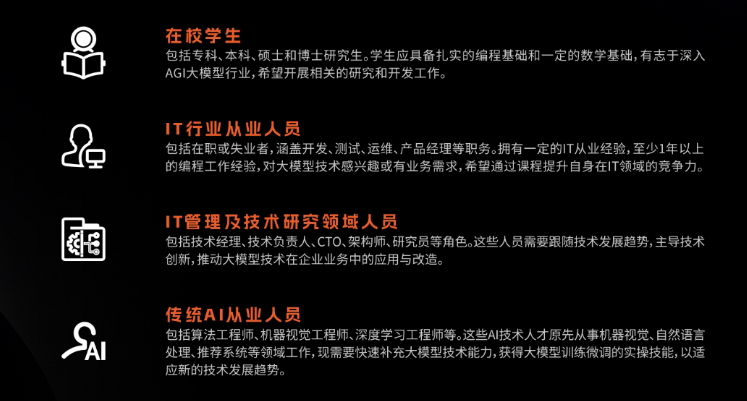
四阶段学习规划(共90天,可落地执行)
第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
-
硬件选型
-
带你了解全球大模型
-
使用国产大模型服务
-
搭建 OpenAI 代理
-
热身:基于阿里云 PAI 部署 Stable Diffusion
-
在本地计算机运行大模型
-
大模型的私有化部署
-
基于 vLLM 部署大模型
-
案例:如何优雅地在阿里云私有部署开源大模型
-
部署一套开源 LLM 项目
-
内容安全
-
互联网信息服务算法备案
-
…
👇👇扫码免费领取全部内容👇👇

3、这些资料真的有用吗?
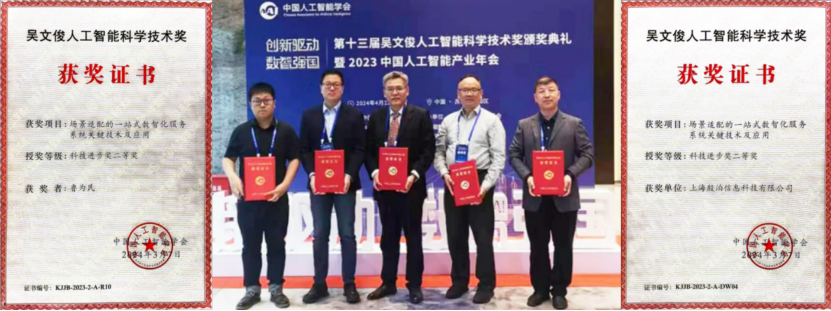
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】


Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐

 1
 0
- 0


 已为社区贡献184条内容

所有评论(0)