基于FastAPI+LangChain,我造了一个能“思考”的企业知识库平台
AI Agentic RAG 高级企业知识库平台
基于 FastAPI + LangChain + LangGraph + RAG + PGVector 的企业级知识库平台,前后端分离。
一、技术栈
后端:FastAPI + Uvicorn + Tortoise ORM(异步)+ LangChain + LangGraph + PyJWT + sse-starlette(Python 3.11)前端:Vue3 + Vite + Element-Plus + Vue-Router + Axios + ECharts数据库:MySQL 8(业务库 25 张表)+ PostgreSQL 16+ / PGVector(向量库 1 张表)模型:全部使用阿里云百炼,在管理端配置,改配置立刻生效不用重启
| 用途 | 模型 | 接口 |
|---|---|---|
| 对话 | qwen-plus | OpenAI 兼容 |
| 向量 | text-embedding-v4 | OpenAI 兼容,1024 维 |
| 重排 | gte-rerank-v2 | DashScope 原生(自写 LangChain 重排组件) |
二、目录结构
ai_system/
├─ fastapi-app/
│  ├─ main.py
# 入口,启动时初始化 PGVector
│  ├─ settings.py
# MySQL / PGVector / JWT 配置
│  ├─ models.py
# 25 张业务表的 Tortoise ORM 模型
│  ├─ api/
# 路由(自动扫描注册)
│  ├─ common/
# 统一返回、异常处理、JWT、依赖
│  ├─ rag/
│  │  ├─ llm.py
# 模型工厂(配置热生效)+ Prompt 渲染
│  │  ├─ rerank.py
# 自写 BaseDocumentCompressor(gte-rerank-v2)
│  │  ├─ bm25.py
# jieba 中文分词 BM25
│  │  ├─ fusion.py
# RRF 倒数排名融合
│  │  ├─ vectorstore.py
# PGVector 异步访问
│  │  ├─ splitter.py
# 递归分块 / 父子分块
│  │  ├─ parser.py
# PDF/Word/Excel/MD/TXT + OCR
│  │  ├─ rewrite.py
# 多查询扩展 / 指代消解 / HyDE
│  │  ├─ retriever.py
# 混合检索主管道(分阶段追踪 + 量纲显式化)
│  │  ├─ graph.py
# LangGraph Agentic RAG 状态图
│  │  ├─ tools.py
# Function Calling 工具中心
│  │  ├─ judge.py
# LLM-as-judge 四指标评测
│  │  ├─ ingest.py
# 文档入库管道
│  │  └─ qa.py
# 问答生成(含流式)
│  └─ requirements.txt
└─ vue/
├─ src/views/manager/
# 管理端页面
├─ src/views/portal/
# 用户端问答
└─ .env.development
# VITE_BASE_URL
三、启动步骤
1. 数据库
-- MySQL:导入业务库
SOURCE ai_system.sql;
-- PostgreSQL:创建向量库并初始化
CREATE DATABASE vector_store;
\c vector_store
SOURCE pgvector_init.sql;
2. 后端
cd ai_system/fastapi-app
pip install -r requirements.txt
# 按实际环境修改 settings.py 或设置环境变量(MYSQL_* / PG_*)
python main.py
# 默认 9090 端口
3. 前端
cd ai_system/vue
npm install
npm run dev
4. 初始化配置
- 用
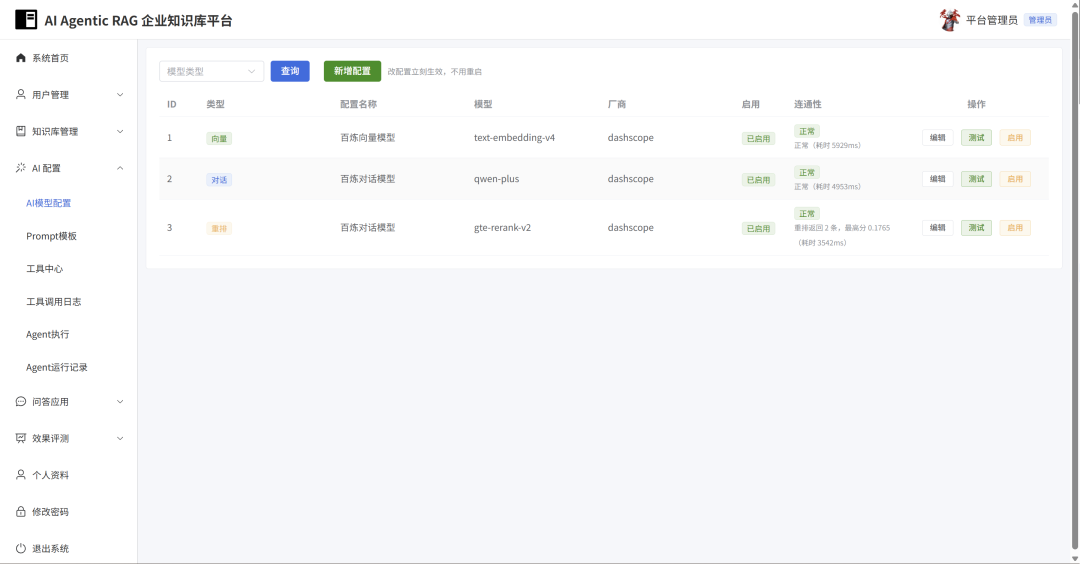
admin / admin登录管理端 - AI 配置 → AI模型配置:新增并启用三类模型(对话 / 向量 / 重排),点「测试」验证连通性
- 对话:
qwen-plus,API Base 留空(自动用百炼 OpenAI 兼容地址) - 向量:
text-embedding-v4,维度 1024 - 重排:
gte-rerank-v2
- 对话:
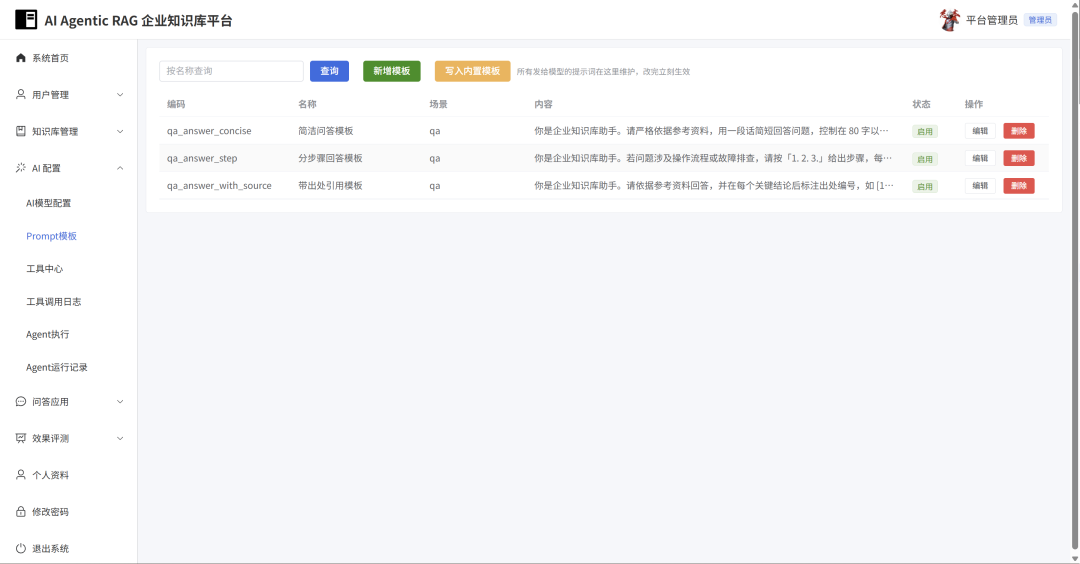
- AI 配置 → Prompt模板:点「写入内置模板」
- AI 配置 → 工具中心:点「写入内置工具」
- 知识库管理 → 知识库管理:新建知识库,绑定向量模型与切分策略
- 知识库管理 → 文档管理:上传文档,自动解析切分向量化
- 问答应用 → 应用管理:新建应用,绑定知识库与检索策略
四、核心设计说明
1. 混合检索 + RRF 融合
向量检索认识同义词但认不出 GTE-3000 这类精确型号,BM25 认得型号却听不懂同义表达,两路一起跑再用 RRF 按名次融合。融合不能直接加分数——向量是 0~1 余弦相似度,BM25 没有上界,量纲不同,RRF 只看名次不看分数正是为此设计。
中文分词额外把 GTE3000 拆出 gte 和 3000(见 rag/bm25.py 的 smart_tokenize)。
2. 分数量纲显式化,阈值按量纲分开配
score 在管线里被反复覆盖,每覆盖一次量纲就换一次:
| 量纲 | 取值范围 | 是否阈值过滤 |
|---|---|---|
| 余弦相似度 | 0 ~ 1(相关片段实测 0.46~0.77) | 是 |
| BM25 分数 | 无上界 | 否 |
| RRF 名次分 | 约 0.016 ~ 0.033 | 否(只表示名次先后) |
| 重排相关分 | 0 ~ 1(相关片段实测 0.14~0.20) | 是 |
策略表里余弦相似度和重排相关分各配一个阈值;RRF 名次分与 BM25 在页面上标注「本次不适用」。实现见 rag/schemas.py 与 rag/retriever.py 的 StageTrace。
3. 父子分块
片段小则命中准但上下文不全,片段大则上下文完整但难命中。切两遍:只把子块向量化参与检索(小块用来找),命中后回填整个父块给模型生成(大块用来答)。见 rag/splitter.py。
4. 自写 LangChain 重排组件
百炼重排接口不在 OpenAI 兼容模式下,包装成 BaseDocumentCompressor(rag/rerank.py),作为标准组件接入检索链路。重排在粗筛之后执行,候选上限 20 条。
5. Agentic RAG
rag/graph.py 用 LangGraph 把「检索 → 评估 → 改写 → 再检索 → 生成 → 自查」编成状态图。检索几轮、改写几次、答案不合格要不要重来,全由模型每一轮判断决定,代码只设循环上限(max_retrieval)。每一步落成 agent_step,配合 agent_run 与前端时间线完整回放。
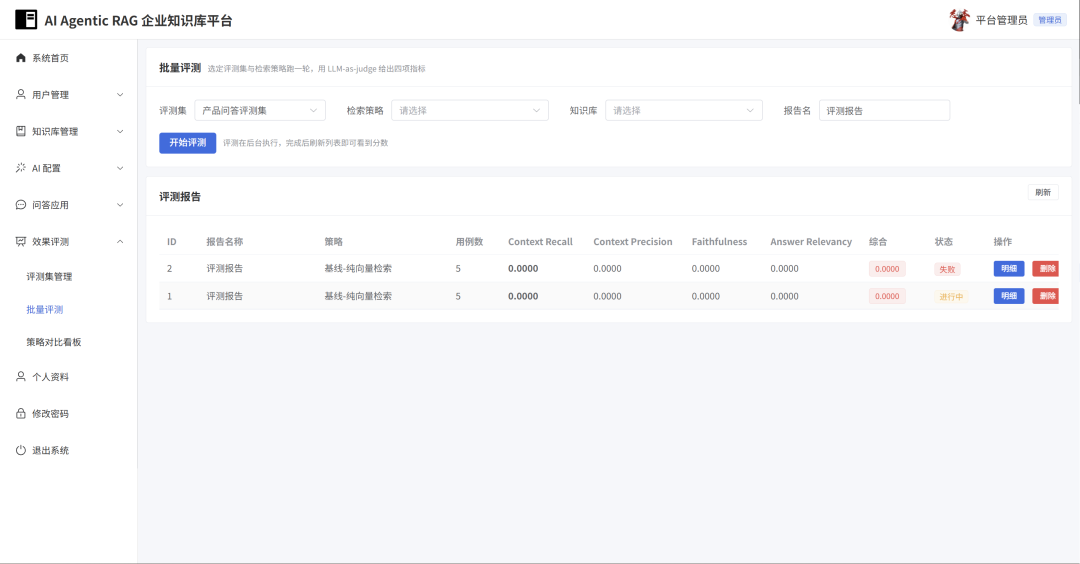
6. LLM-as-judge 四指标
| 指标 | 含义 | 归属 | 计算方式 |
|---|---|---|---|
| Context Recall | 该找的资料找回来没有 | 找资料 | 集合运算(用例带来源片段 ID) |
| Context Precision | 有用的资料排在前面没有 | 找资料 | 裁判模型 |
| Faithfulness | 答案有没有编 | 写答案 | 裁判模型 |
| Answer Relevancy | 有没有跑题 | 写答案 | 裁判模型 |
裁判模型 temperature 固定为 0。Context Recall 不靠模型判断——用例记录来源片段 ID,直接做集合运算;参照精确到单条,避免分母被撑大。
五、主要接口
| 前缀 | 说明 |
|---|---|
/login``/register``/auth/* | 登录注册、个人资料、修改密码 |
/admin/*``/user/* | 管理员与用户管理 |
/knowledgeBase/* | 知识库 |
/splitStrategy/*``/retrievalStrategy/* | 切分策略 / 检索策略 |
/document/*``/chunk/* | 文档上传解析 / 片段人工修正 |
/retrieval/test``/retrieval/compare | 检索测试 / 召回调试台(最多 4 套并排) |
/aiModel/*``/prompt/*``/tool/* | 模型配置 / Prompt / 工具中心与日志 |
/agent/run``/agent/runPage``/agent/steps/{id} | Agent 执行与运行记录 |
/chatApp/*``/chat/* | 应用管理 / SSE 流式问答与会话 |
/eval/* | 评测集、批量评测、策略对比 |
/dashboard/summary | 首页统计 |
六、主要功能
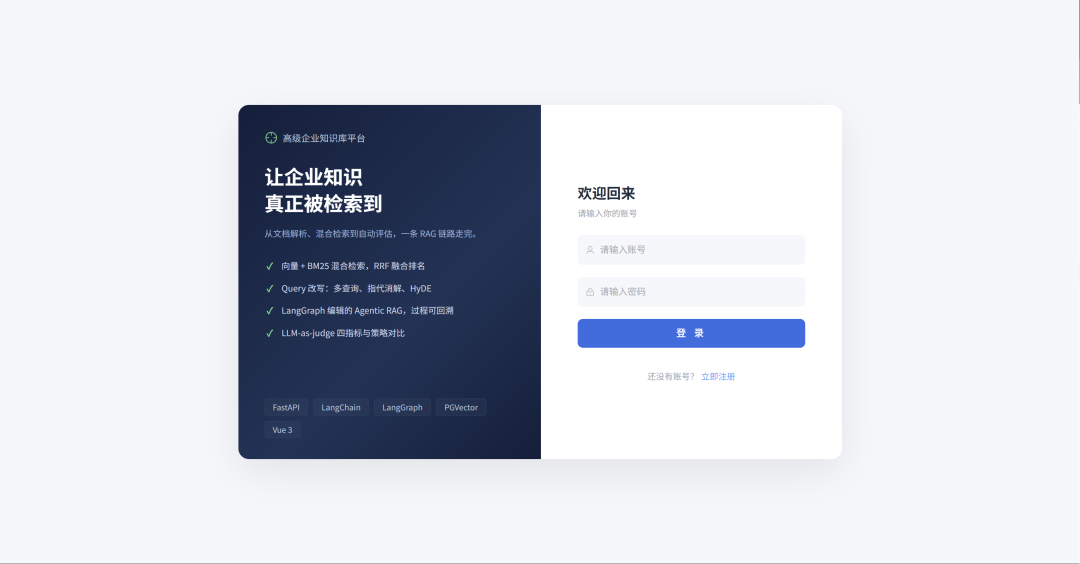
1、登录
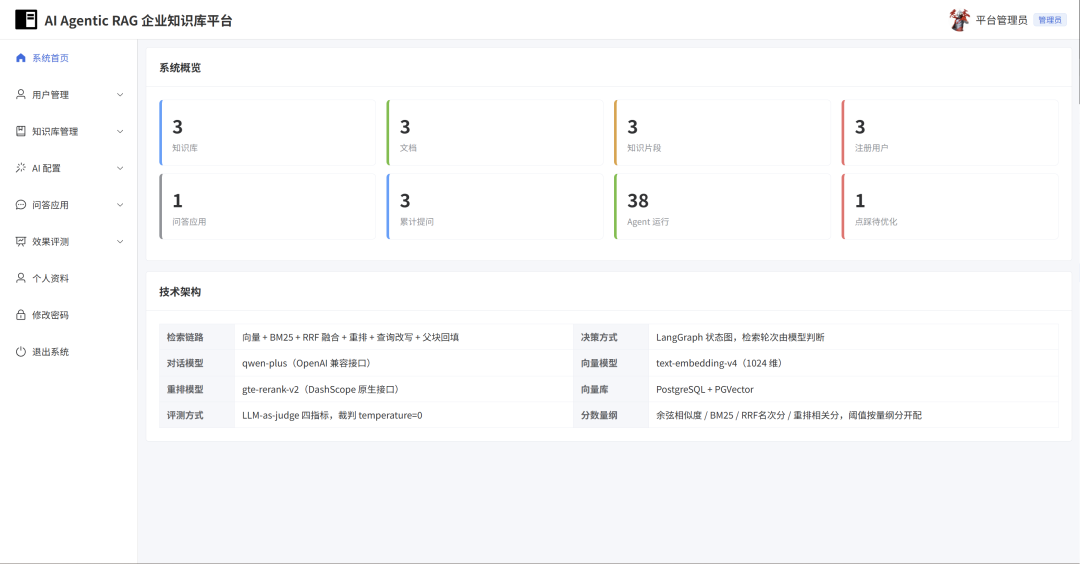
2、管理员首页
3、AI模型配置
4、Prompt模版
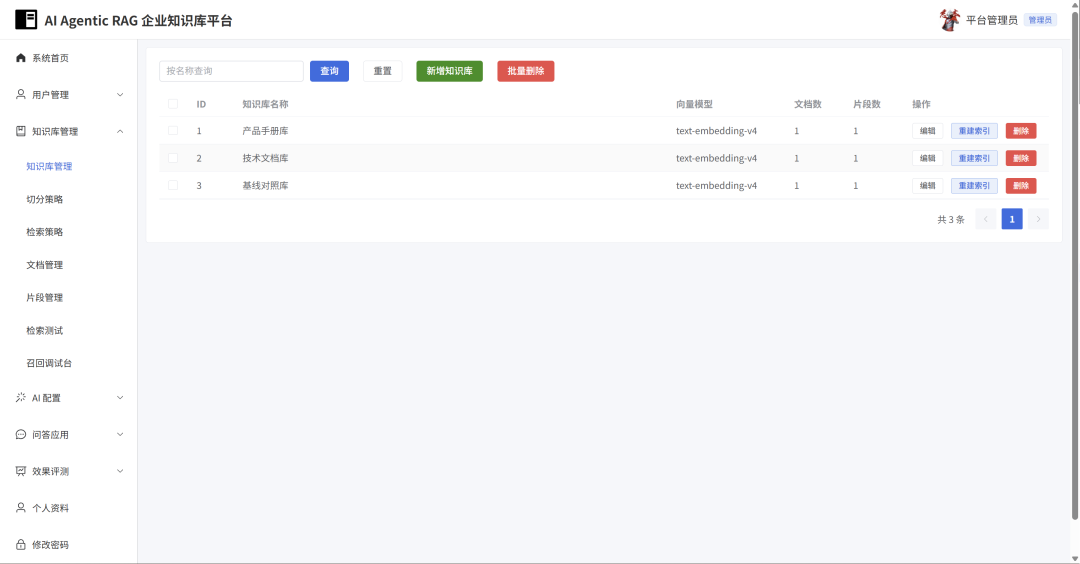
5、知识库管理
6、批量测评
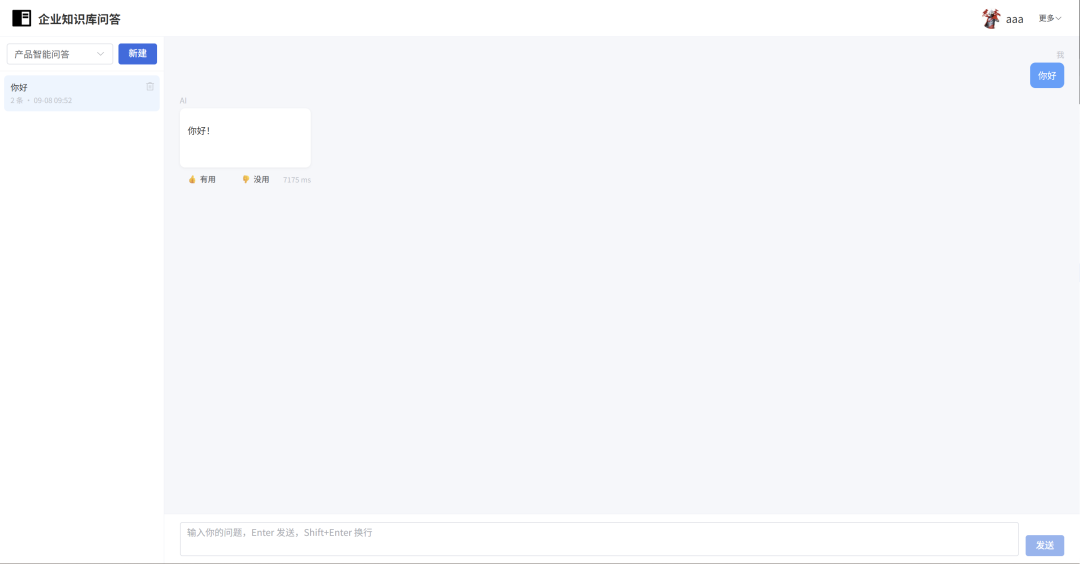
7、用户问答页面
最后
对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?
答案只有一个:人工智能(尤其是大模型方向)
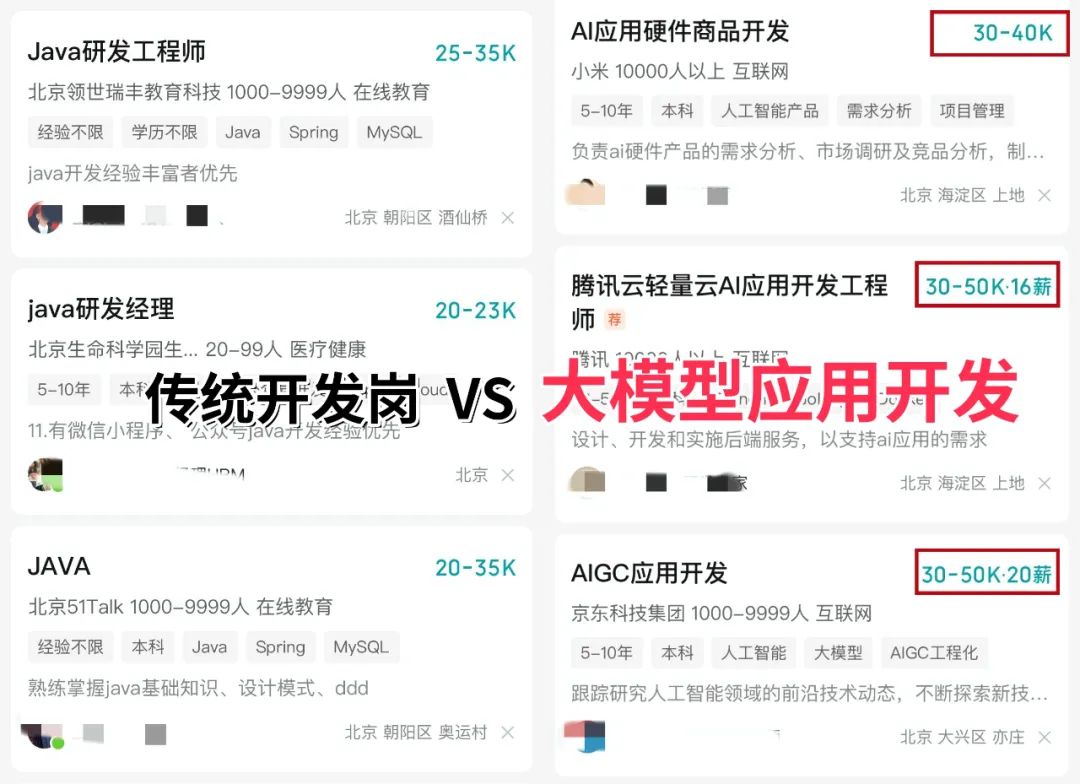
当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应聘者,月基础工资也能稳定在4万元左右。
再看阿里、腾讯两大互联网大厂,非“人才计划”的AI相关岗位应聘者,月基础工资也约有3万元,远超其他行业同资历岗位的薪资水平,对于程序员、小白来说,无疑是绝佳的转型和提升赛道。
如果你还不知道从何开始,我自己整理一套全网最全最细的大模型零基础教程,我也是一路自学走过来的,很清楚小白前期学习的痛楚,你要是没有方向还没有好的资源,根本学不到东西!
下面是我整理的大模型学习资源,希望能帮到你。
👇👇扫码免费领取全部内容👇👇

最后
1、大模型学习路线
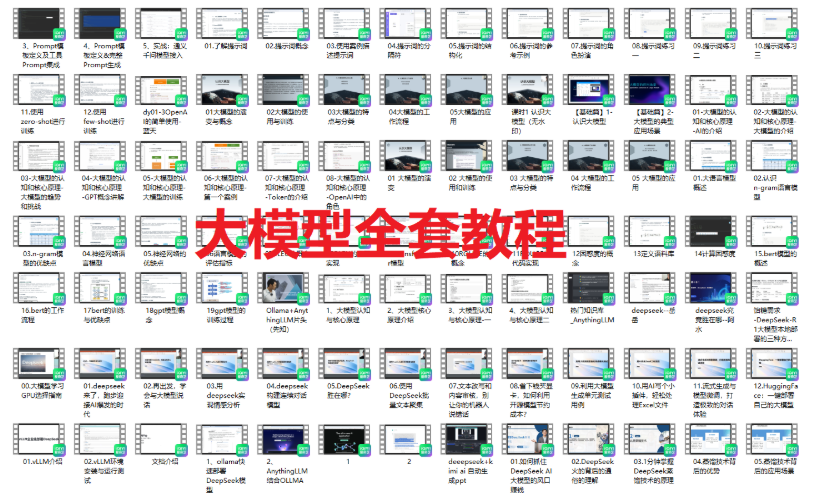
2、从0到进阶大模型学习视频教程
从入门到进阶这里都有,跟着老师学习事半功倍。
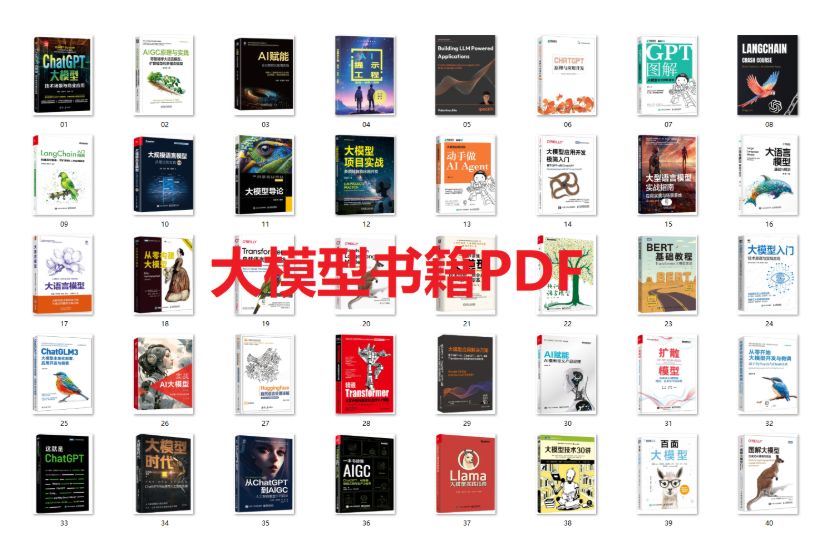
3、 入门必看大模型学习书籍&文档.pdf(书面上的技术书籍确实太多了,这些是我精选出来的,还有很多不在图里)
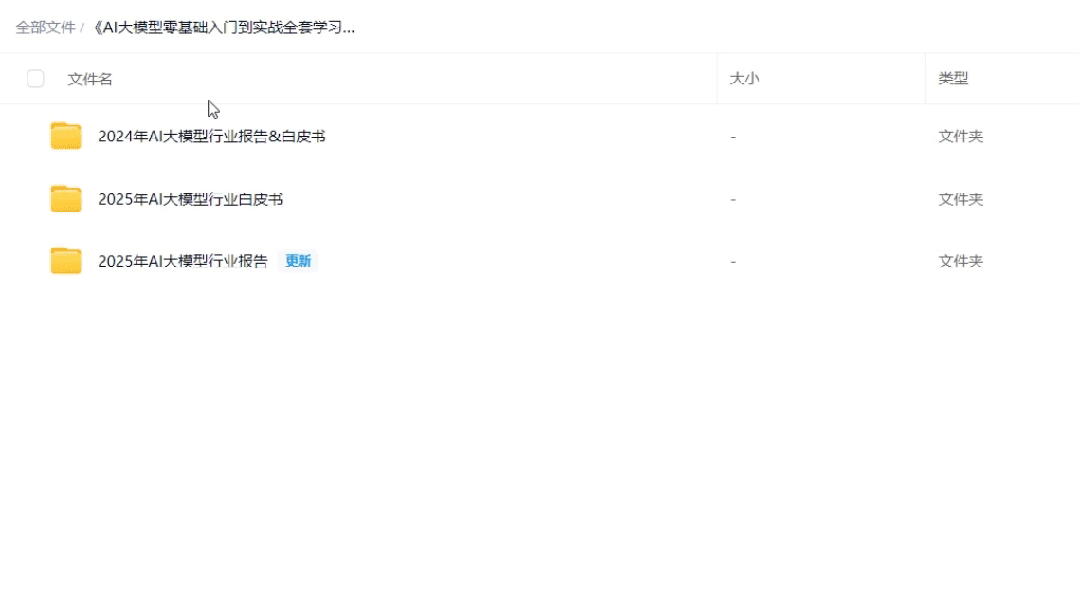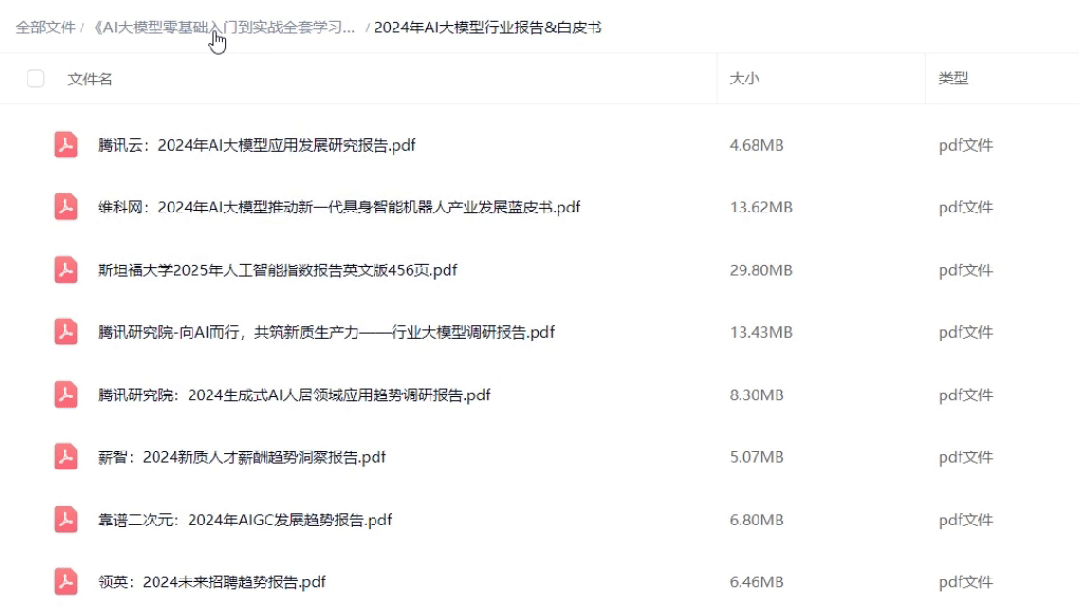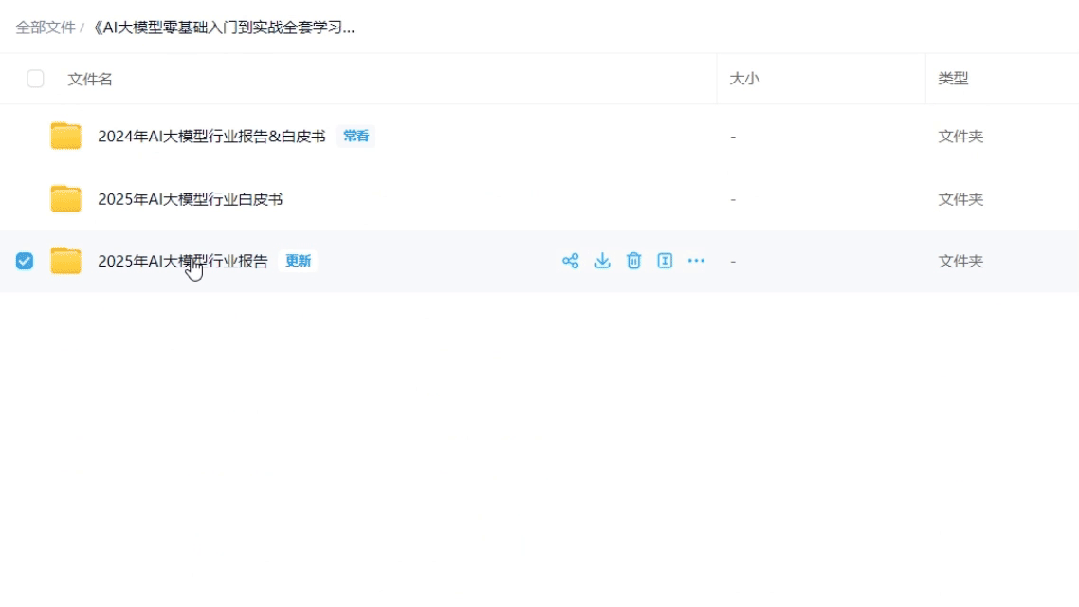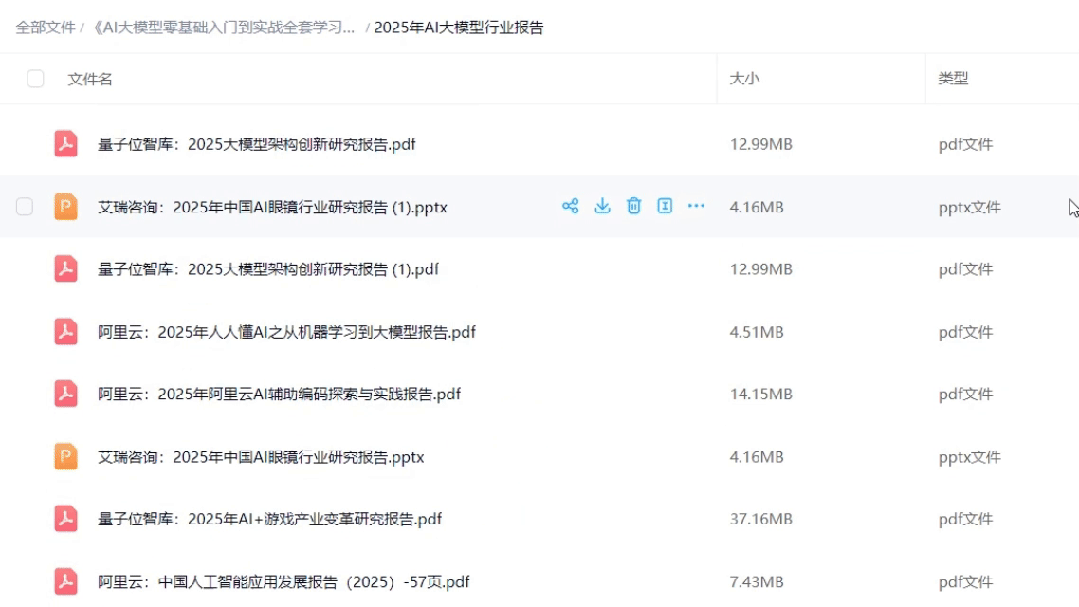
4、 AI大模型最新行业报告
2026最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。
5、面试试题/经验
【大厂 AI 岗位面经分享(107 道)】
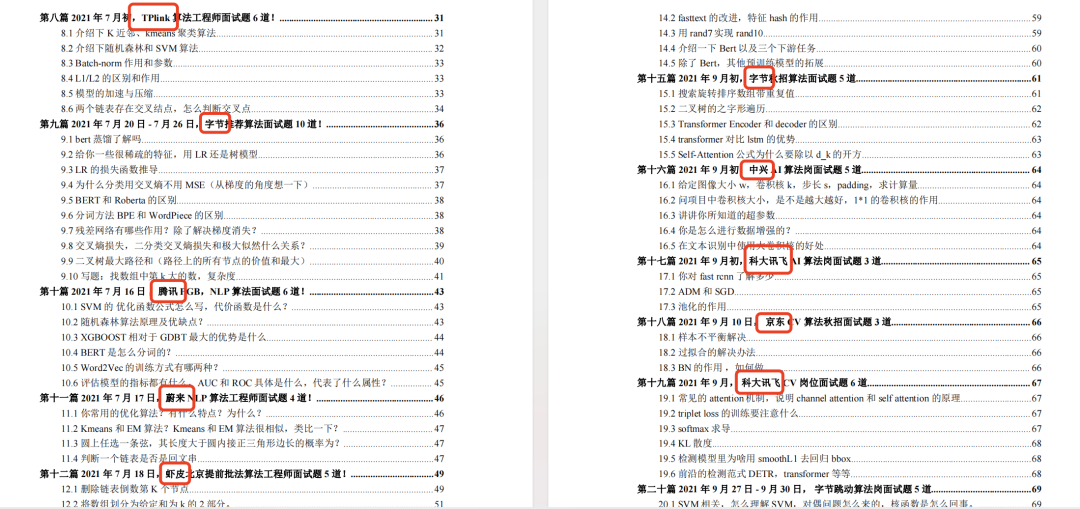
【AI 大模型面试真题(102 道)】
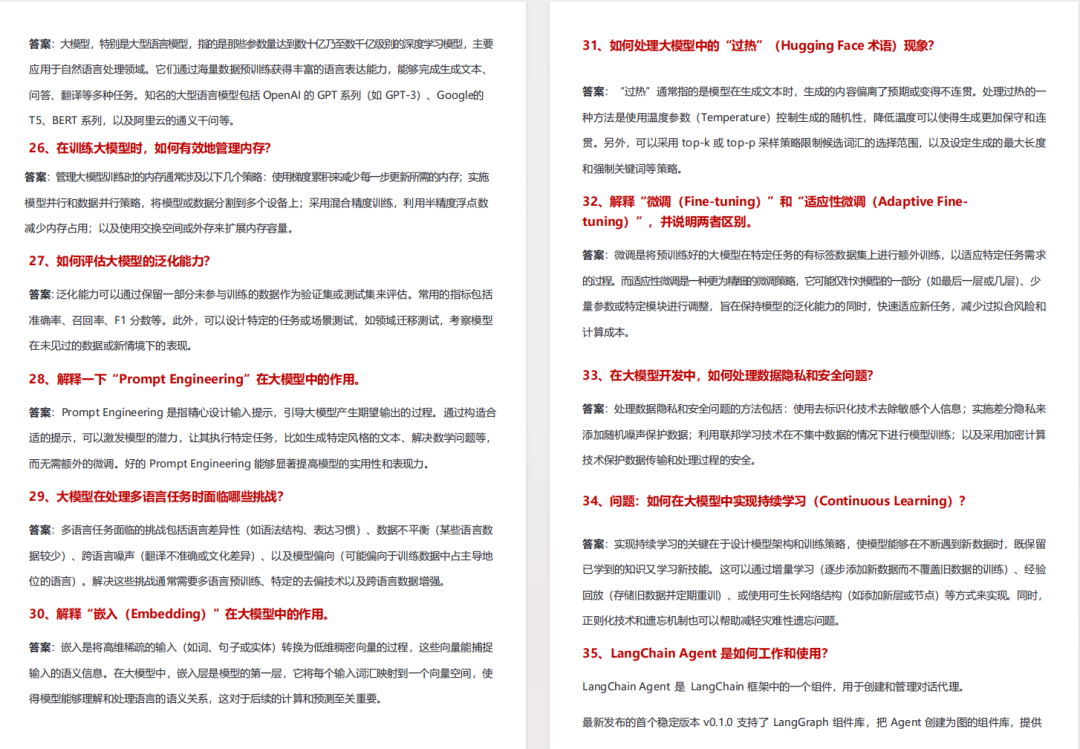
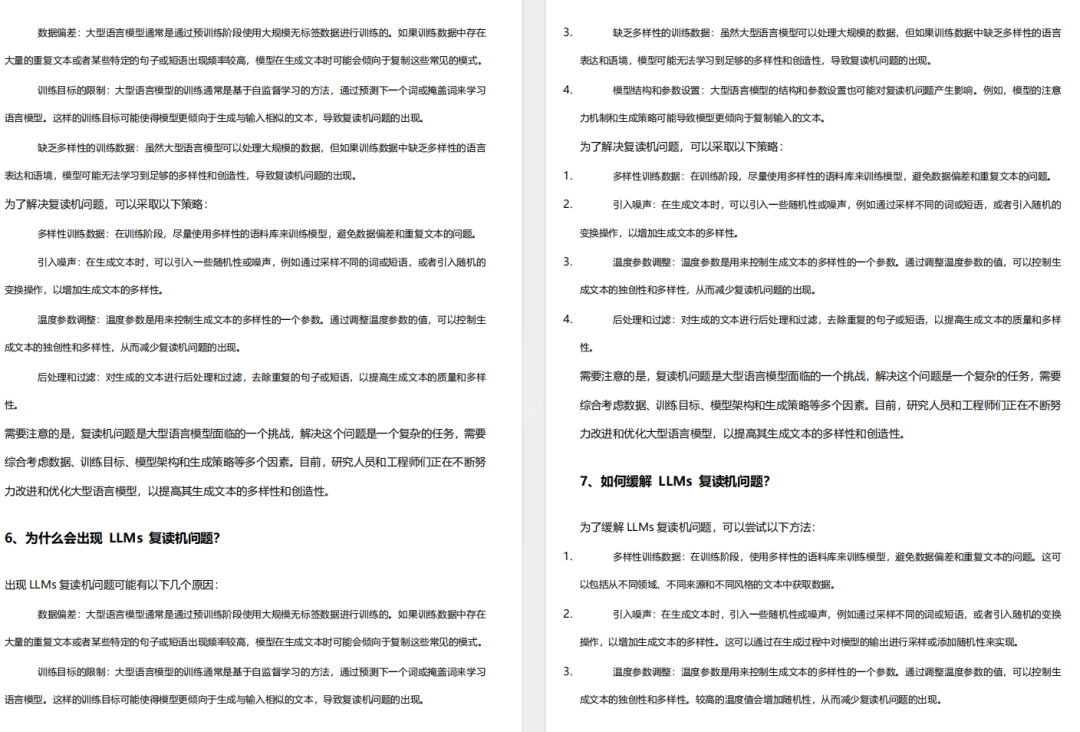
【LLMs 面试真题(97 道)】
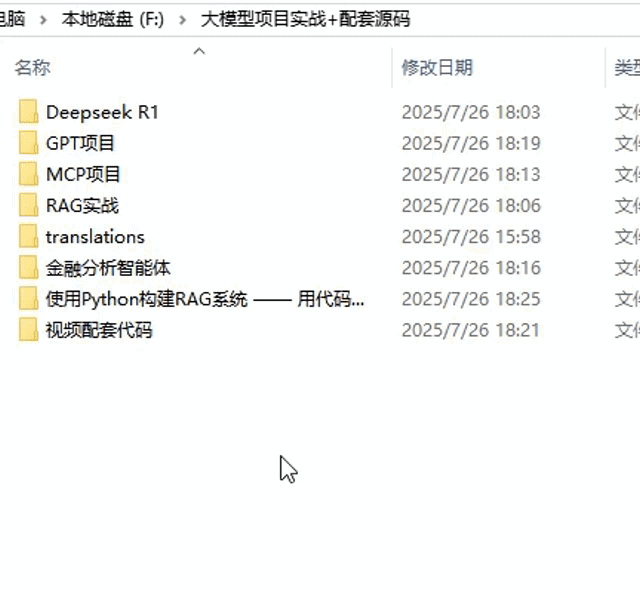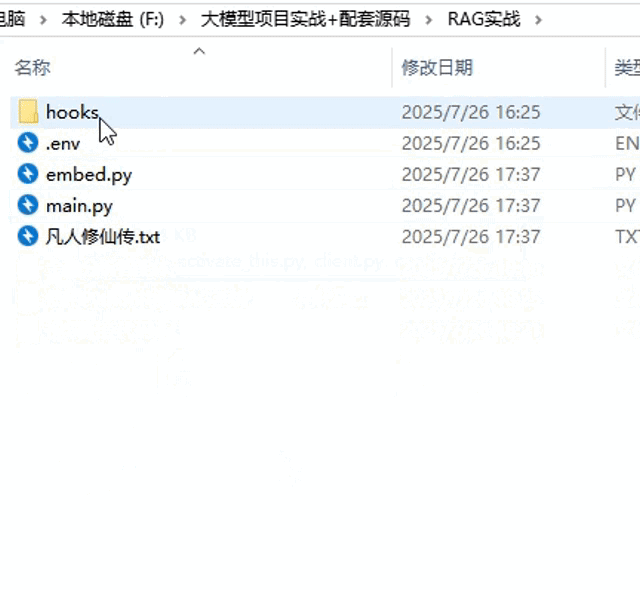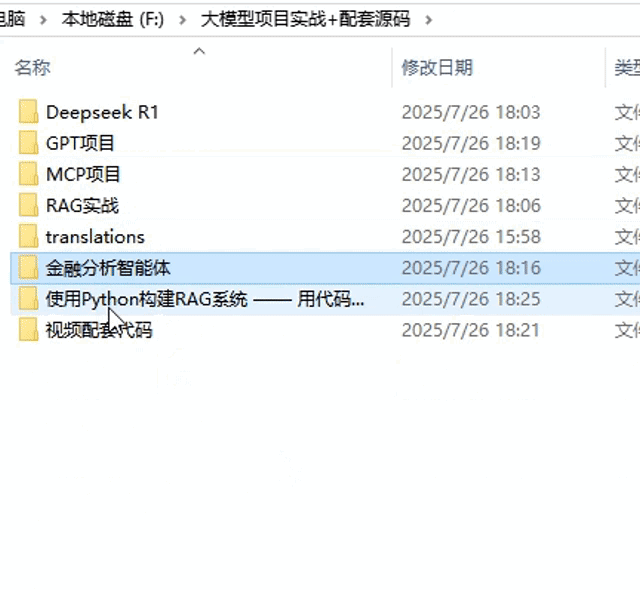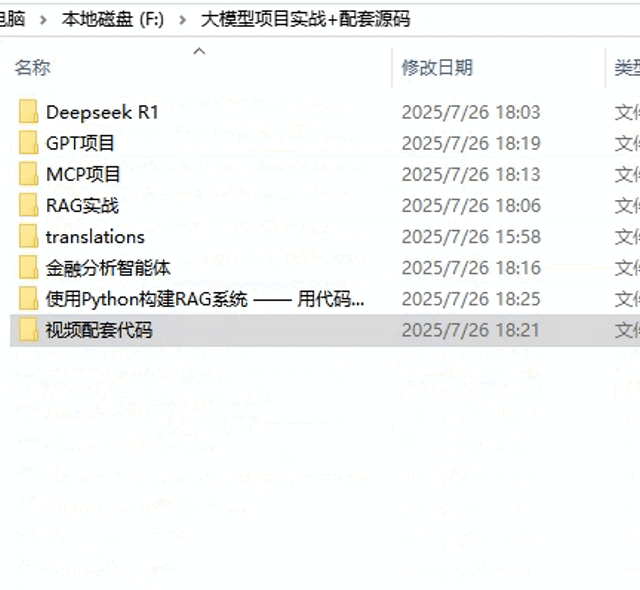
6、大模型项目实战&配套源码
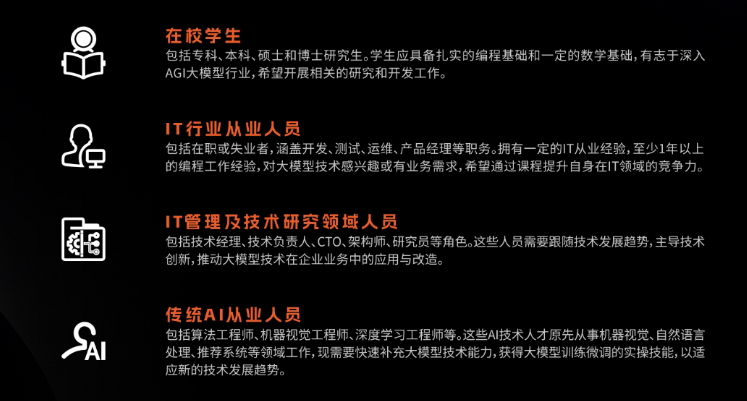
适用人群
四阶段学习规划(共90天,可落地执行)
第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
-
硬件选型
-
带你了解全球大模型
-
使用国产大模型服务
-
搭建 OpenAI 代理
-
热身:基于阿里云 PAI 部署 Stable Diffusion
-
在本地计算机运行大模型
-
大模型的私有化部署
-
基于 vLLM 部署大模型
-
案例:如何优雅地在阿里云私有部署开源大模型
-
部署一套开源 LLM 项目
-
内容安全
-
互联网信息服务算法备案
-
…
👇👇扫码免费领取全部内容👇👇

3、这些资料真的有用吗?
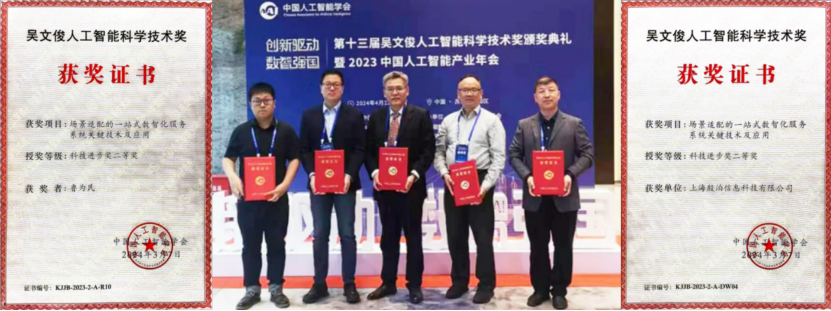
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】


Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐

 1
 0
- 0


 已为社区贡献168条内容

所有评论(0)