电商小白必看:AI Agent Memory系统实战指南,收藏学习助你提升开发技能!
本文深入解析了电商场景下AI Agent Memory系统的设计与应用,涵盖四类信息源整合、四层记忆架构设计、事实提取与显式记忆管理、记忆召回机制等关键内容。通过分层沉淀用户信息,有效解决用户数据分散问题,最终赋能推荐、客服与营销,实现从记忆到用户智能的转化。对于想要提升AI开发技能的小白和程序员来说,本文提供了实用的实战指导和收藏价值。
一、记住什么:四类信息源
电商平台天然有大量用户数据,但消费意愿与水平因人而异,因此需要对 Memory 系统的信息源进行整合分类:
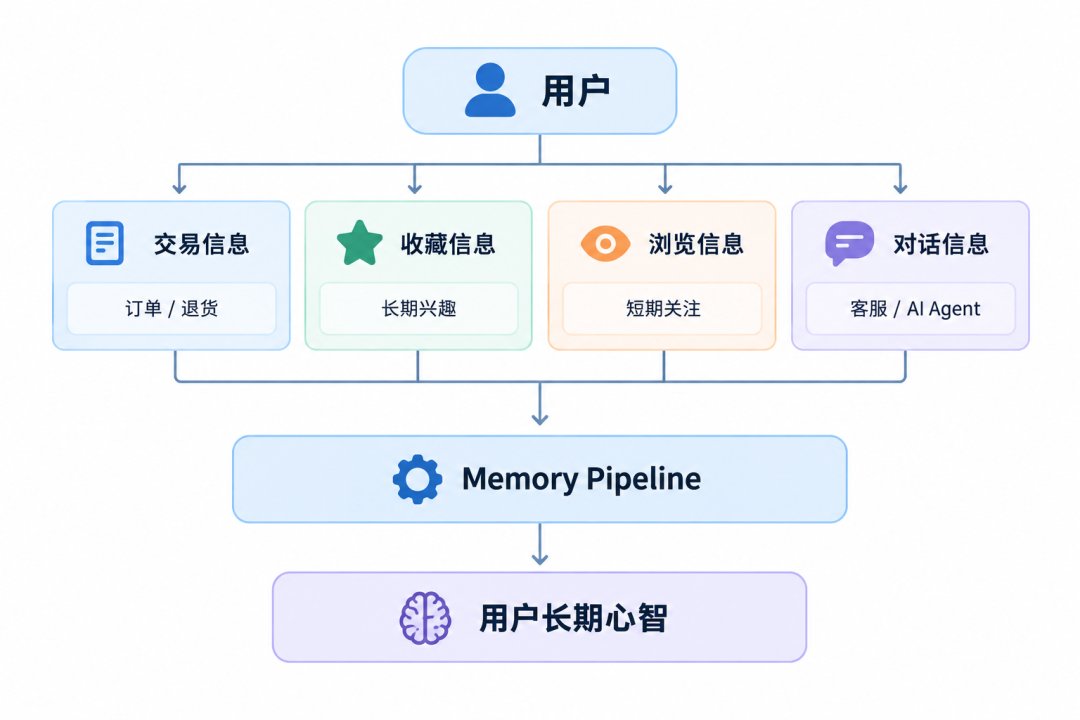
- 订单信息
订单是最强的长期行为信号,包含完整的交易生命周期:下单、支付、购买频次、客单价、退货、退款、投诉、售后、评价。
过去一年: 咖啡豆 × 12咖啡机 × 1磨豆机 × 1滤纸 × 20清洁用品 × 8
如果系统只看到“用户买过咖啡机”,就丢失了大量信息。更好的做法是逐步形成:
用户长期购买咖啡相关商品。
再结合购买频率和商品金额,形成更精确的判断:
用户是高频咖啡消费用户,对相关产品具有持续消费能力。
- 收藏信息
收藏不等于要买,但它说明“持续感兴趣”。用户可能收藏了很多商品,最终没有购买:
收藏:

高端磨豆机 × 2
精品咖啡器具 × 3
高端咖啡机另一型号 × 1
这不能证明用户一定会购买,但至少说明他对高端咖啡设备存在持续兴趣。如果收藏行为持续数月,Memory 就可以把它从单次行为提升为长期兴趣。
- 浏览与搜索
浏览、搜索、点击描述的是短期兴趣:
最近 7 天:

搜索:跑鞋

浏览:Nike × 8、ASICS × 6、New Balance × 4

收藏:2 款
可以形成“用户近期对跑鞋类商品关注较高”,但不能直接把短期行为等同于长期兴趣。行为信息需要结合频次、时间、持续性以及后续行为来判断,长期兴趣和短期兴趣分开处理。
- 对话信息
相比订单和行为,对话多了一层价值:它能解释用户为什么这么选择。
“贵一点没关系,但是我比较在意品牌和售后。”
可以提取:
消费水平:中高价格敏感度:较低决策因素:品牌、售后
“最好送货上门,我不喜欢去驿站取。”
配送偏好:送货上门负向偏好:不喜欢驿站取件
这些偏好不在订单和行为数据里,而在IM工作台对话框,这些信息对 AI 理解用户很关键。
二、四层记忆架构
最直观的方案是把用户所有历史信息丢进一个 Memory Pool,Embedding 后向量召回,喂给 LLM。
用户所有历史信息 → 一个 Memory Pool → Embedding → 向量召回 → LLM
很快会撞上问题:“搜索过 iPhone”和“购买过 iPhone”不是同一个强度的信号;“浏览过一次跑鞋”和“半年持续买跑鞋”也不是一回事。一个池子装不下不同强度的信号,所以记忆需要分层:不同来源的信息先分别理解,不同时间尺度的信息分别沉淀,最终形成统一的用户心智。
- 架构设计
整个系统分成四层:
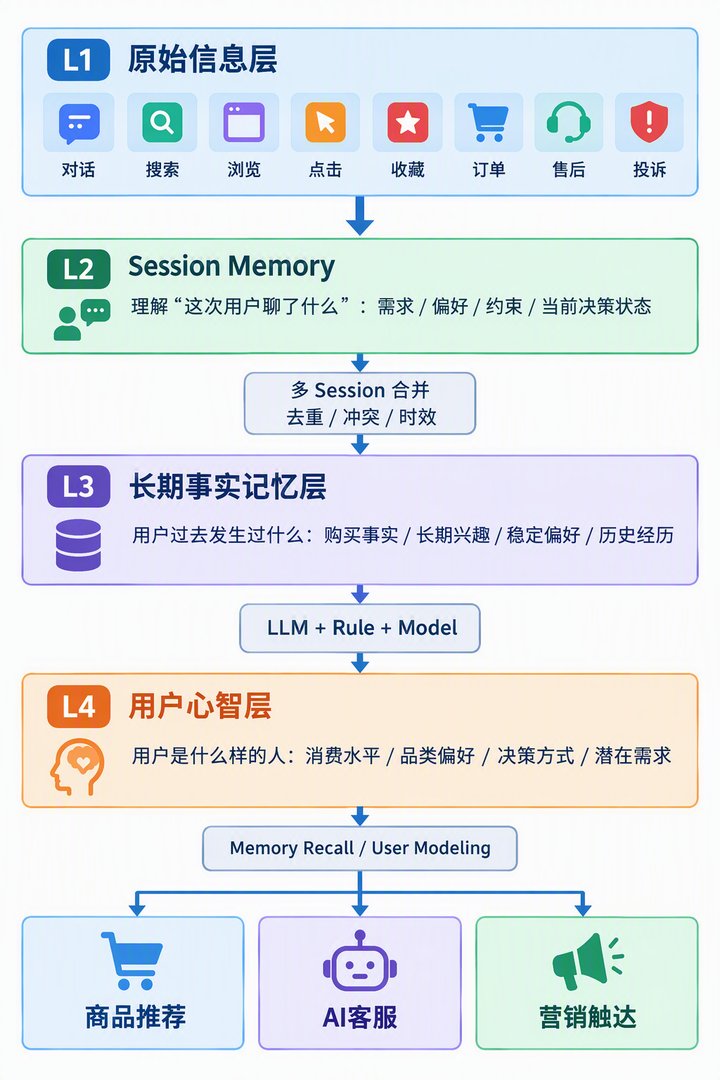
四层架构里,越上层来源越全、噪音越大、越不稳定——浏览、搜索、收藏、对话、订单全都混在一起;越往下越稳定,因为每一层都在做抽象、过滤、总结,也越来越理解用户。
L1 记录用户做了什么:一次搜索、一次点击都会进来,信息最全,也最不稳定。

L2 理解这次发生了什么:把一次交互提炼成事实,过滤掉一次性噪音。

L3 沉淀用户过去发生了什么:跨 Session 合并、去重、处理冲突,只留经多次验证的长期事实。

L4 理解用户是什么样的人:在事实之上建模,得到最稳定的用户判断。
从 L1 到 L4,是信息逐层被抽象、过滤、总结的过程;落到每一条用户身上,就是一步步从噪音走向对用户的稳定理解。
- 记录原始信息,提炼 Session 事实
L1 只做统一入口,不负责推断。文本、语音(ASR)、图片(OCR/VLM)、搜索、浏览/点击、订单/售后都先进来标准化,再原样保存:
用户原话:我想买一台3000元左右的咖啡机,最好自动清洗。
Source:Conversation
Timestamp:2026-09-13
Session:S10001
L1 的原则是:记录原始信息,不做任何总结抽象。
有了原始信息,L2 理解一次完整 Session。用户连续聊了十几轮:
“想买咖啡机。”“预算 3000 左右。”“家里两个人。”“每天早上喝。”“不想每天清洗。”“自动清洗的有哪些?”
这十几轮对话不需要全部塞给下一次 Agent,而是提炼成一条 Session Memory:
用户本次计划购买家用咖啡机,预算约3000元,2人使用,主要用于日常饮用,希望操作简单、维护方便,重点关注自动清洗功能,当前处于商品比较阶段。
- 沉淀长期事实,建模用户心智
L3 在多个 Session 之上形成长期事实:跨 Session 合并后,得到的是“这个用户过去发生过什么”的事实列表。
“用户购买过 3 台高端耳机”是事实;“用户是高端数码发烧友”是推断,推断进入 L4。
L4 在事实之上建模用户心智。还是咖啡用户,L3 里已总结了这些事实:
购买:咖啡豆 × 12、咖啡机 × 1、磨豆机 × 1、滤纸 × 20、清洁用品 × 8
收藏:多款高端咖啡设备
对话:“贵一点没关系,但我比较在意品牌和售后。”
行为:近期持续浏览磨豆机相关商品
L4 进一步形成:
兴趣领域:咖啡
消费水平:中高
价格敏感度:较低
决策因素:品牌 / 售后 / 品质
长期特征:咖啡高频消费者
近期兴趣:磨豆机 / 器具升级
潜在需求:可能关注高端磨豆机
这一步,从 Memory 到了 User Profile / User Mental Model。
三、事实提取、显式记忆与生命周期
- 事实提取
借鉴 Mem0 的核心思路:不是保存完整对话,而是从新信息中提取值得长期保留的事实。写入前先和已有 Memory 比对,判断是新增、更新、删除还是无需变化:
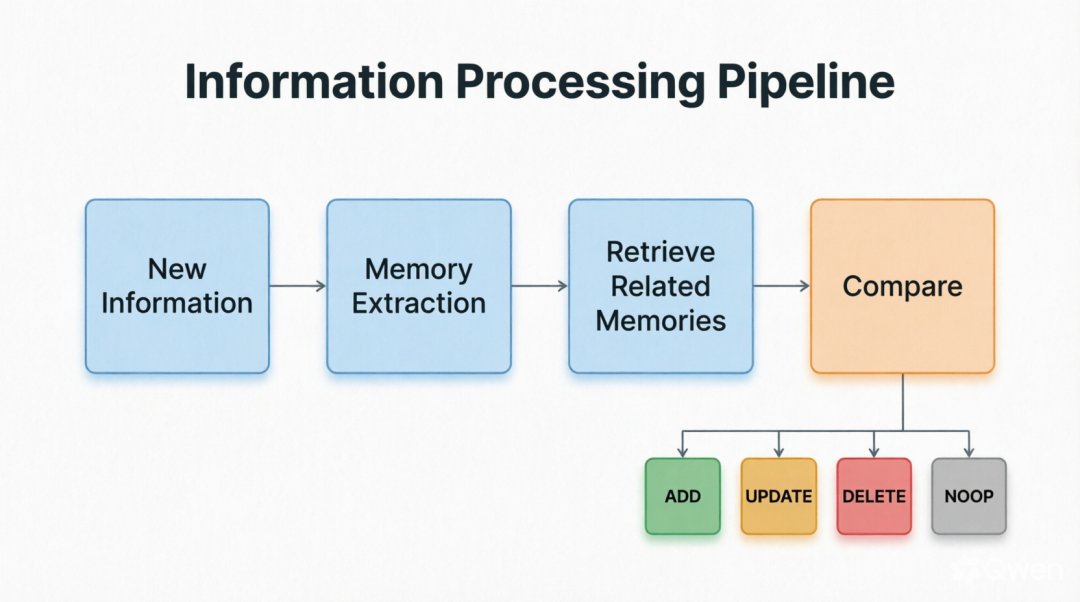
不会把每个消息都存下来,而是用模型判断标准是“是否值得长期记忆”:点击一次袜子通常不值得记,连续半年购买跑步装备就值得形成长期兴趣。
- 跨 Session 合并
每个 Session 独立存在时,Agent 看到的还是一个一个孤立事件。譬如,用户过去半年有 5 次不同的会话记录:
S1 “想买咖啡机,3000 以内”
S2 “有没有自动清洗的?”
S3 “咖啡豆有没有推荐?”
S4 购买了一台 2799 元的咖啡机
S5 又购买了咖啡豆、滤纸
尽管各 Session 产生于不同的时间与场景,但会话之间仍存在语义关联;通过跨 Session 的合并与去重,可从中提炼出稳定的长期事实:
1. **长期关注咖啡相关产品**

2. **曾购买 2799 元家用咖啡机**

3. **持续购买咖啡豆及相关耗材**

4. **多次关注自动清洗功能**

5. **具有持续咖啡消费行为**
L3 就是靠这种合并,把散落的事件连成用户的历史。
- 显式记忆
用户主动在对话框中主要要求的,这一类记忆优先级最高:
“以后买东西都优先给我推荐包邮的。”“记住,我不喜欢驿站取货,最好送货上门。”
这类指令走独立的显式记忆通道,不需要记忆系统总结猜测,可以直接写入长期偏好:
用户主动表达:“我不喜欢驿站取货。”
行为推断:    用户有几次选择了送货上门。
最终:        配送偏好 = 送货上门
当显式表达和行为推断冲突时,以显式表达为准。mem9 把“记住这件事”“保存这个”这类指令视为显式 durable write,而不是普通聊天内容。
- 生命周期管理
用户的偏好会变:
2025:“我买东西比较看价格。”
 2026:“贵一点没关系,我现在更在意品质。”
如果只增不改,记忆里会堆满互相矛盾的信息。所以记忆需要完整的生命周期:
ADD → UPDATE → STRENGTH → DECAY → CONFLICT → DELETE
每条记忆还要带上 confidence / importance / source / created_at / updated_at / last_used_at 之类的元数据,用来区分长期稳定偏好和临时行为。
四、记忆召回
- 召回方式
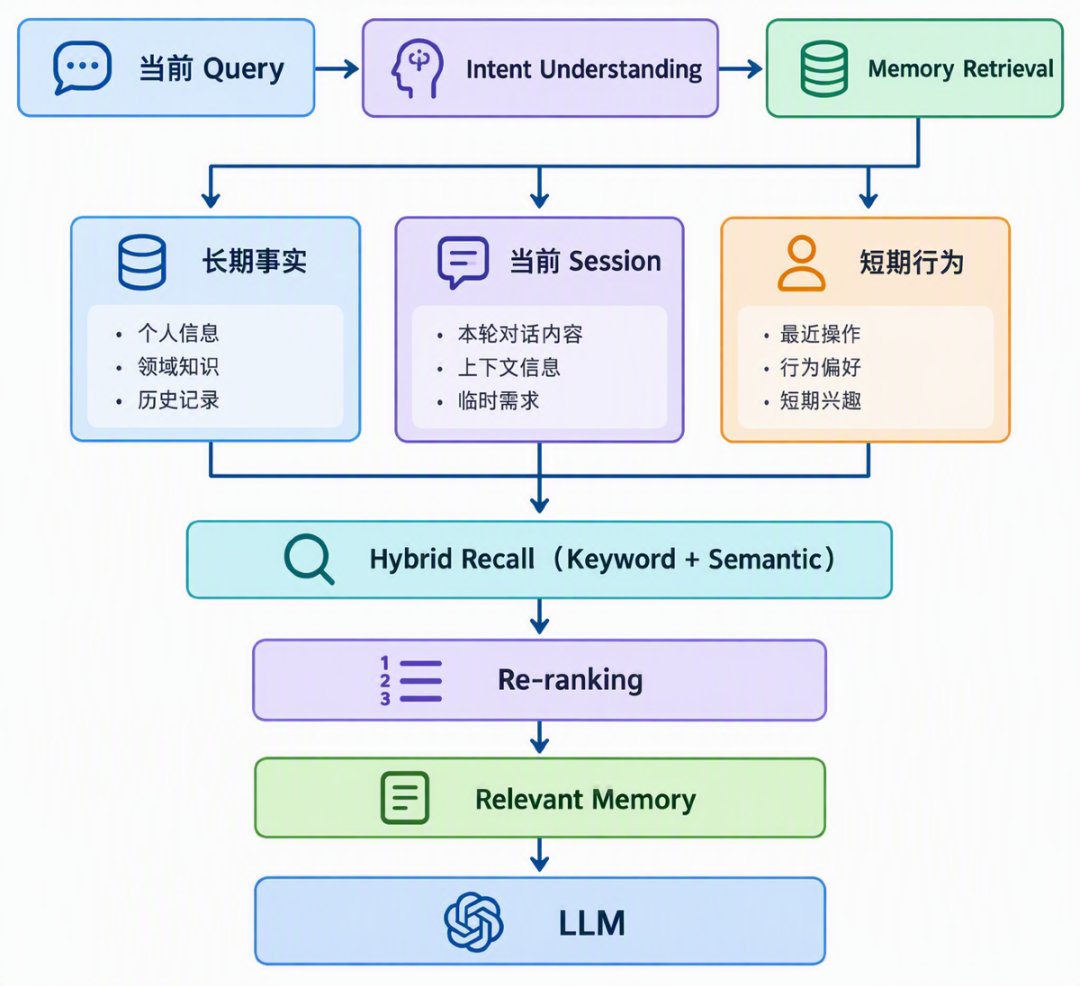
用户再次进来问“最近有什么推荐”,系统不会把所有历史 Memory 都取出来。mem9 的核心观点是:不要“把历史聊天全部塞回 LLM”,而是提炼成 facts / insights 层,根据当前任务召回最相关的信息。
召回可以同时结合关键词匹配和语义检索,即 Hybrid Recall:
- 记忆使用
最终喂给线上 Agent 的系统可能只有这几行:
长期:
咖啡高频用户
偏好知名品牌
价格敏感度低

近期:
近7天持续浏览磨豆机
收藏2款高端磨豆机

当前:
用户询问“有没有适合我的”
而不是过去几个月的几百条聊天记录。
五、赋能:推荐、客服与预测
- 共享用户认知层
记忆建起来后,成为多个业务 Agent 共用的用户认知层:
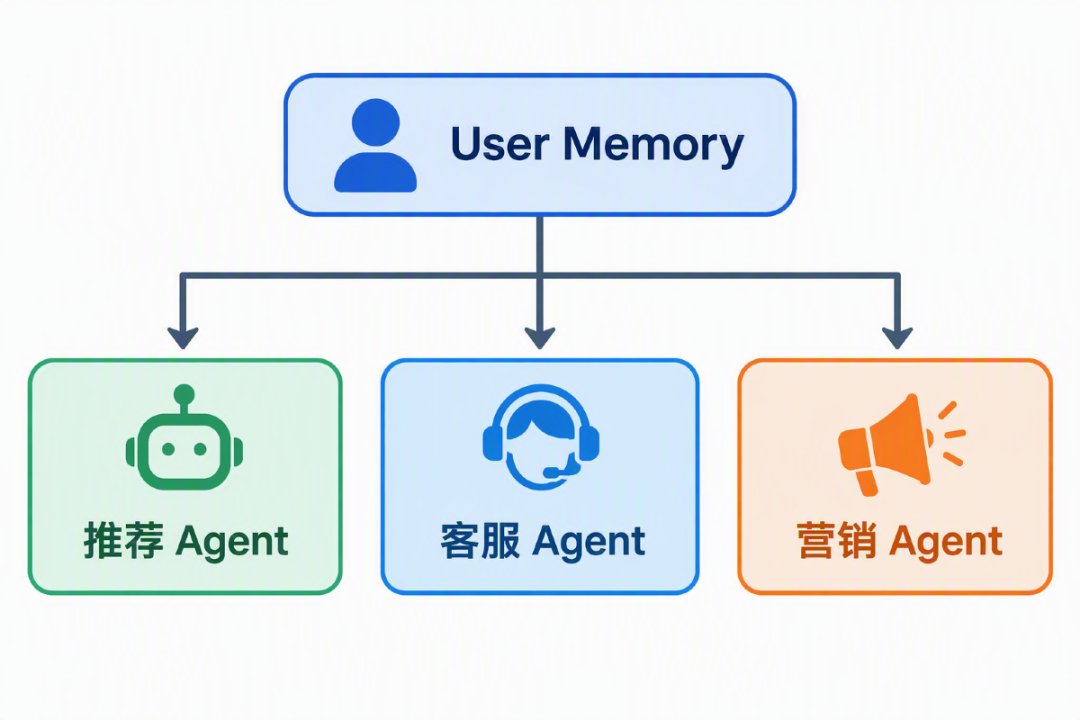
推荐 Agent 决定给用户推荐什么,输入包括长期偏好、短期兴趣、消费能力、实时热点、商品特征。
- 客服 Agent:不用再从零问起
用户问“有没有适合我的咖啡机?”,客服 Agent 不用从“预算多少”问起,可以直接结合 Memory:
“你之前比较看重品牌和售后,也一直在用自动清洗机型,我可以优先帮你筛几款中高端的。”
还能由“当前意图 + 用户 Memory”动态生成后续问题:
[哪款自动清洗效果最好?]
[适合两人家庭的是哪款?]
[这几款有什么区别?]
[现在买有没有优惠?]
- 预测下一步:从推荐商品到推荐行动
记忆和 Agent 结合后,能力范围从推荐商品扩展到预测用户下一步需求:
长期购买咖啡豆 → 购买咖啡机 → 购买滤纸 → 近期浏览磨豆机 → 预测:下一阶段可能要升级器具
此时 Memory 从“记录历史”演化为“理解趋势”,再进一步到“预测未来需求”。
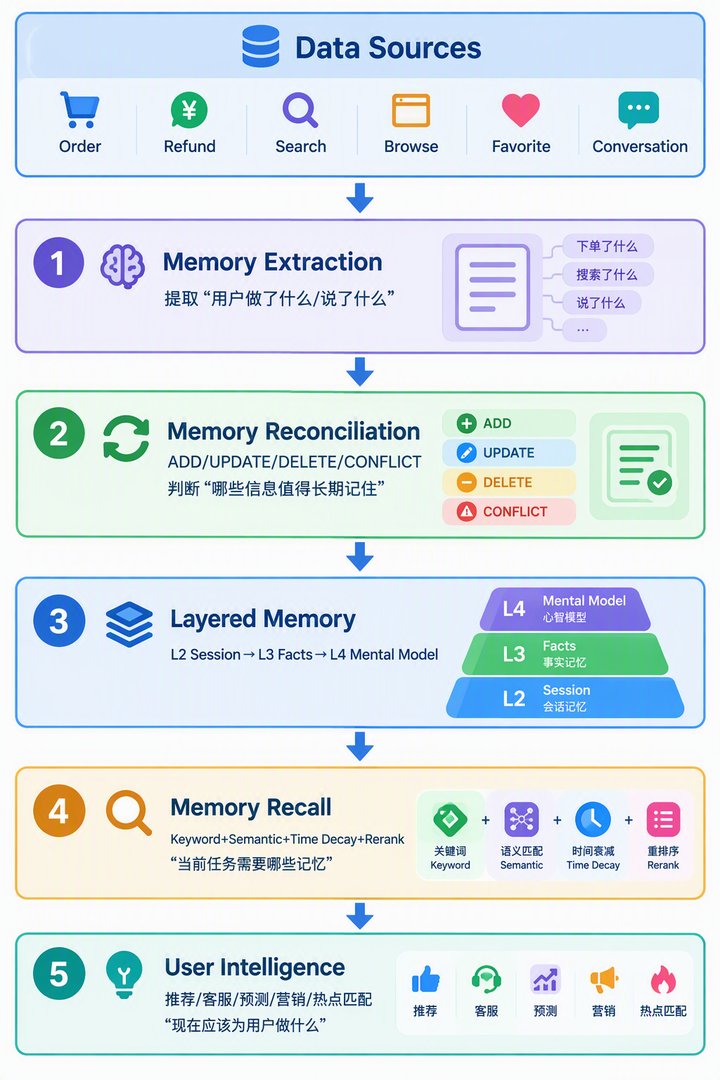
- 整体系统:从 Memory 到 User Intelligence
把记忆、Agent 和业务结合起来,整个系统可以抽象成五个部分:
六、小结
电商数据天然分成四类信号:订单反映用户买过什么,收藏反映长期兴趣,浏览搜索反映近期关注,对话解释用户为什么这么选;用户主动说“记住这个”则是最明确的长期偏好。
记忆系统把这四类信息分层沉淀下来:
原始信息 → Session Memory → 长期事实 → 用户心智 → 用户预测
设计上,Mem0 的思路是把记忆变成事实提取、去重、更新、冲突处理和生命周期管理;mem9 则强调分层记忆、跨 Session 持久化、显式 durable write 和面向任务的混合召回。
最终,记忆服务于整个业务:让推荐知道用户现在想买什么,让客服知道用户为什么这么选,让系统理解何时该把合适的内容推给用户,甚至预测用户的下一步需求。核心目标是让 AI 不只是记住用户,而是越来越理解这个用户。
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线科技企业深耕十二载,见证过太多因技术卡位而跃迁的案例。那些率先拥抱 AI 的同事,早已在效率与薪资上形成代际优势,我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在大模型的学习中的很多困惑。我们整理出这套 AI 大模型突围资料包:
- ✅ 从零到一的 AI 学习路径图
- ✅ 大模型调优实战手册(附医疗/金融等大厂真实案例)
- ✅ 百度/阿里专家闭门录播课
- ✅ 大模型当下最新行业报告
- ✅ 真实大厂面试真题
- ✅ 2026 最新岗位需求图谱
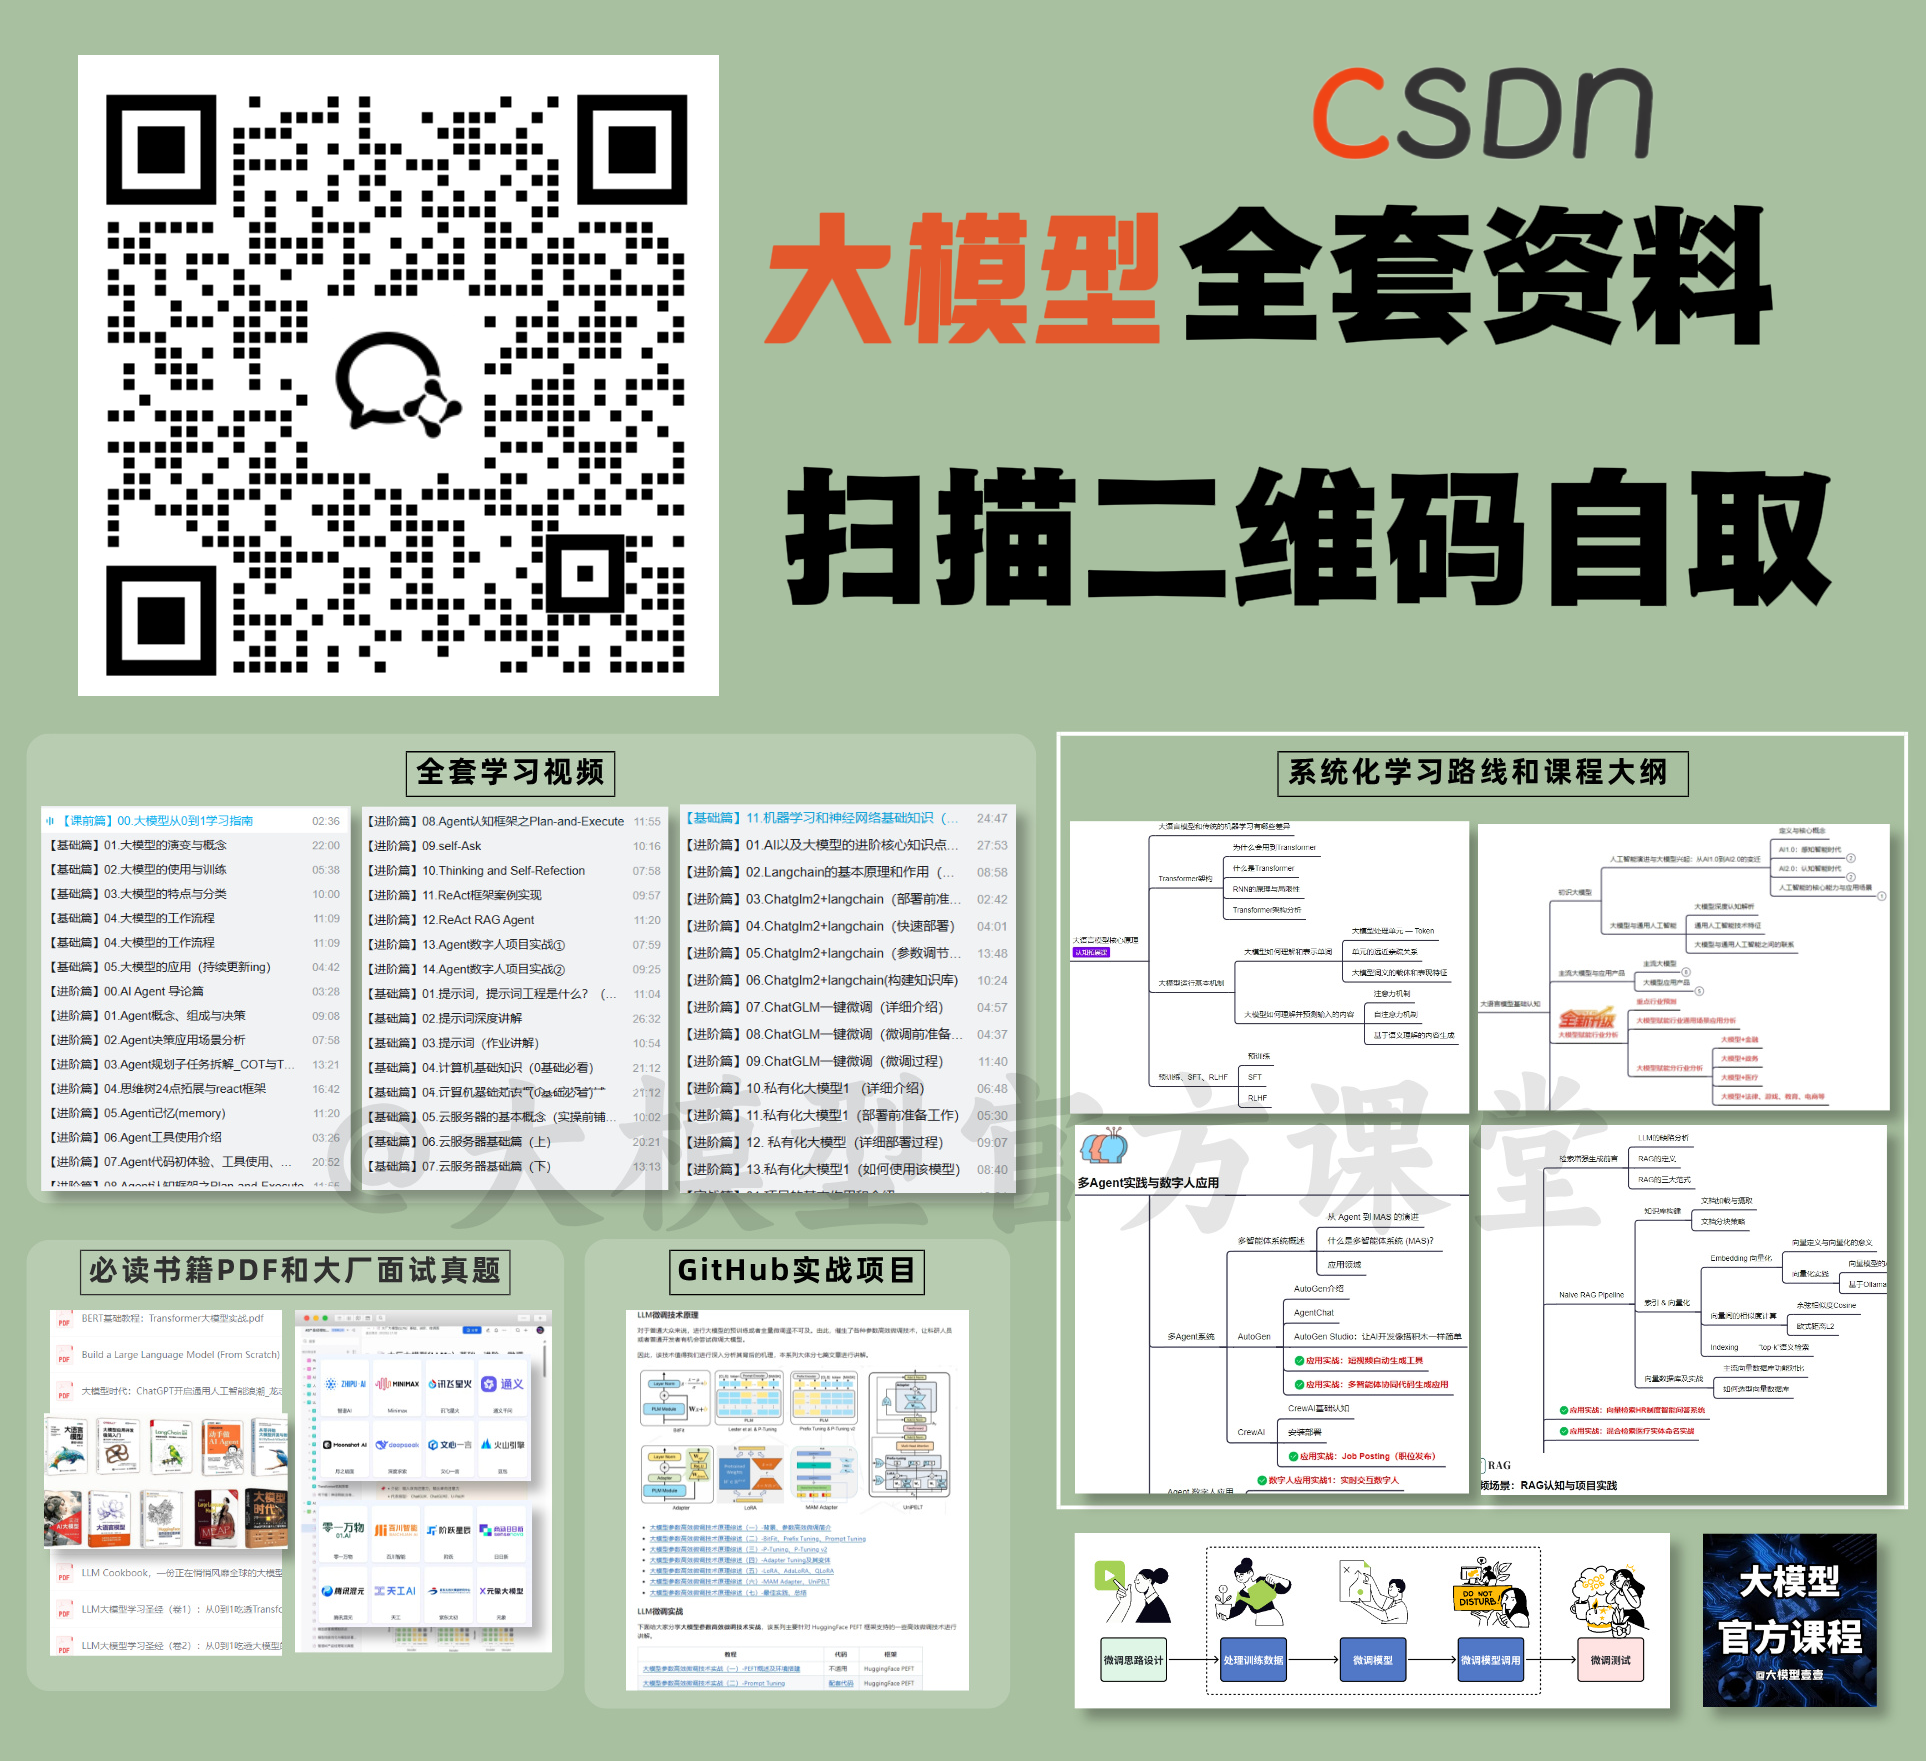
所有资料 ⚡️ ,朋友们如果有需要 《AI大模型入门+进阶学习资源包》,下方扫码获取~
① 全套AI大模型应用开发视频教程
(包含提示工程、RAG、LangChain、Agent、模型微调与部署、DeepSeek等技术点)
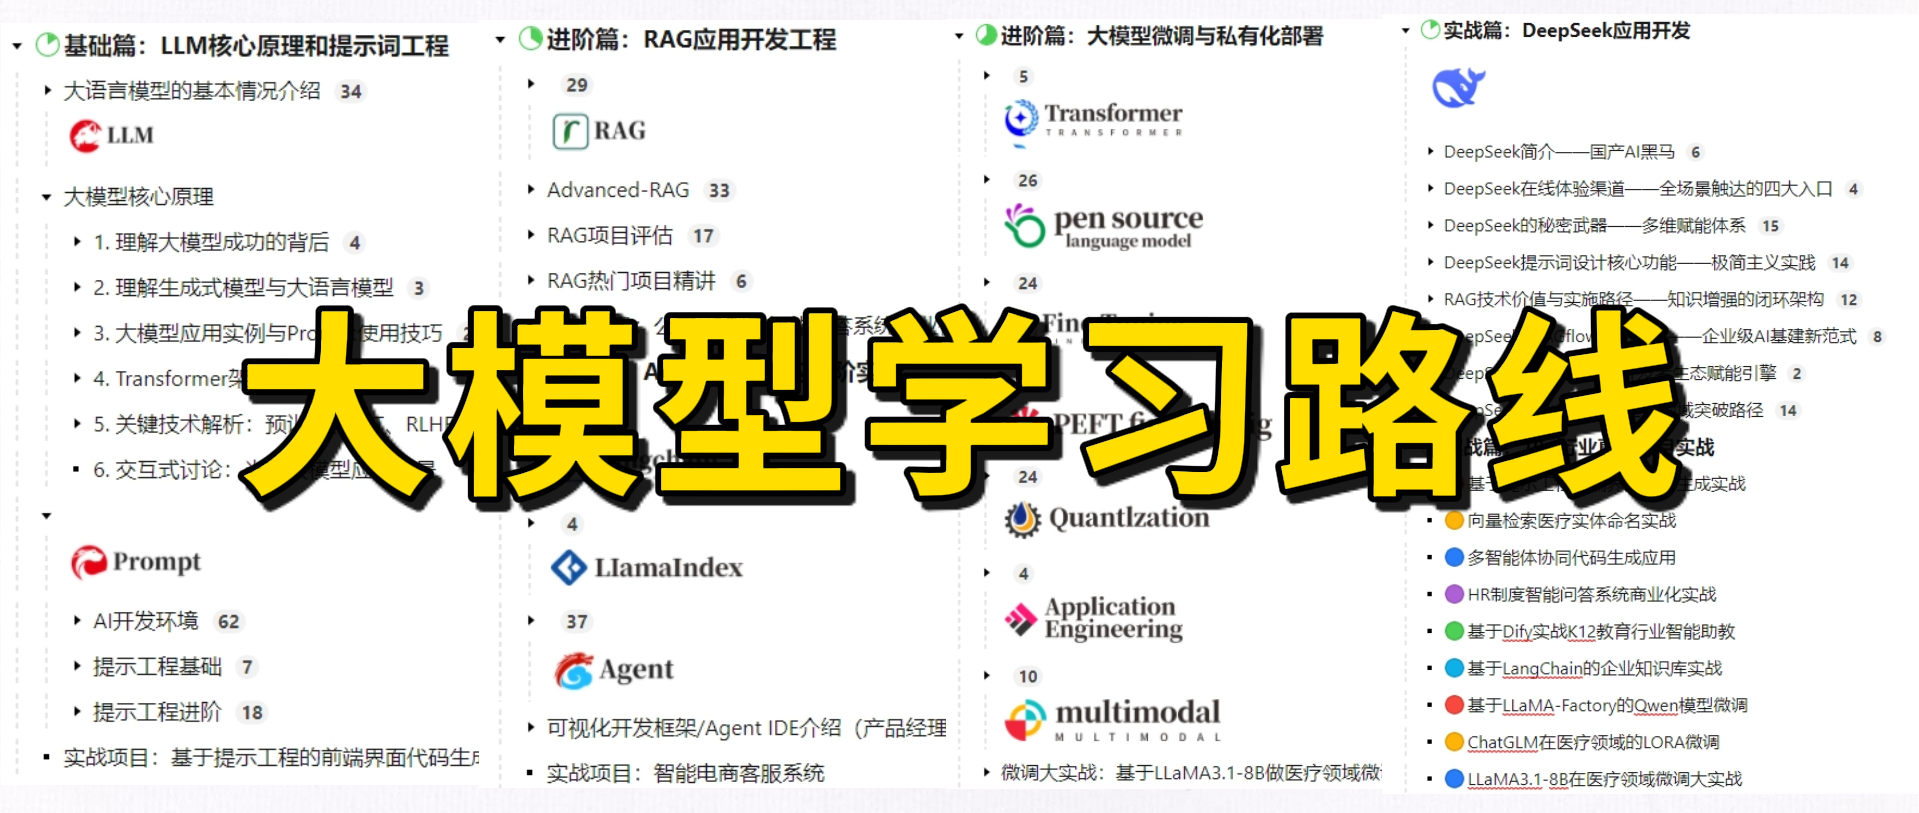
② 大模型系统化学习路线
作为学习AI大模型技术的新手,方向至关重要。 正确的学习路线可以为你节省时间,少走弯路;方向不对,努力白费。这里我给大家准备了一份最科学最系统的学习成长路线图和学习规划,带你从零基础入门到精通!
③ 大模型学习书籍&文档
学习AI大模型离不开书籍文档,我精选了一系列大模型技术的书籍和学习文档(电子版),它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。
④ AI大模型最新行业报告
2025最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。
⑤ 大模型项目实战&配套源码
学以致用,在项目实战中检验和巩固你所学到的知识,同时为你找工作就业和职业发展打下坚实的基础。
⑥ 大模型大厂面试真题
面试不仅是技术的较量,更需要充分的准备。在你已经掌握了大模型技术之后,就需要开始准备面试,我精心整理了一份大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。
以上资料如何领取?
为什么大家都在学大模型?
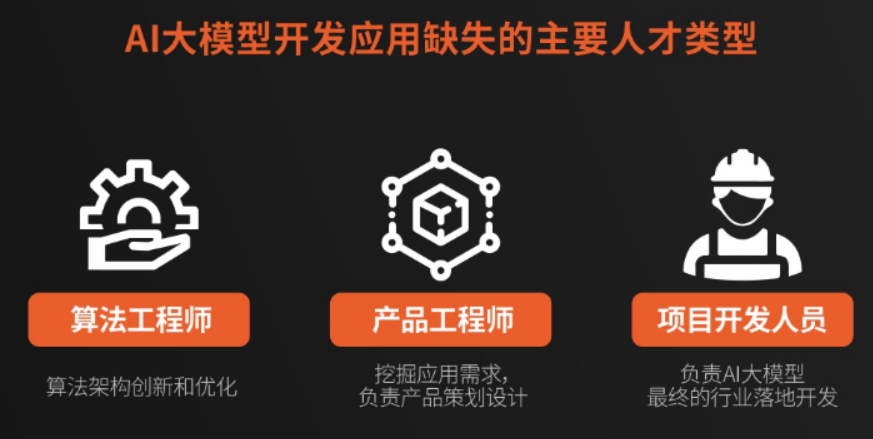
最近科技巨头英特尔宣布裁员2万人,传统岗位不断缩减,但AI相关技术岗疯狂扩招,有3-5年经验,大厂薪资就能给到50K*20薪!
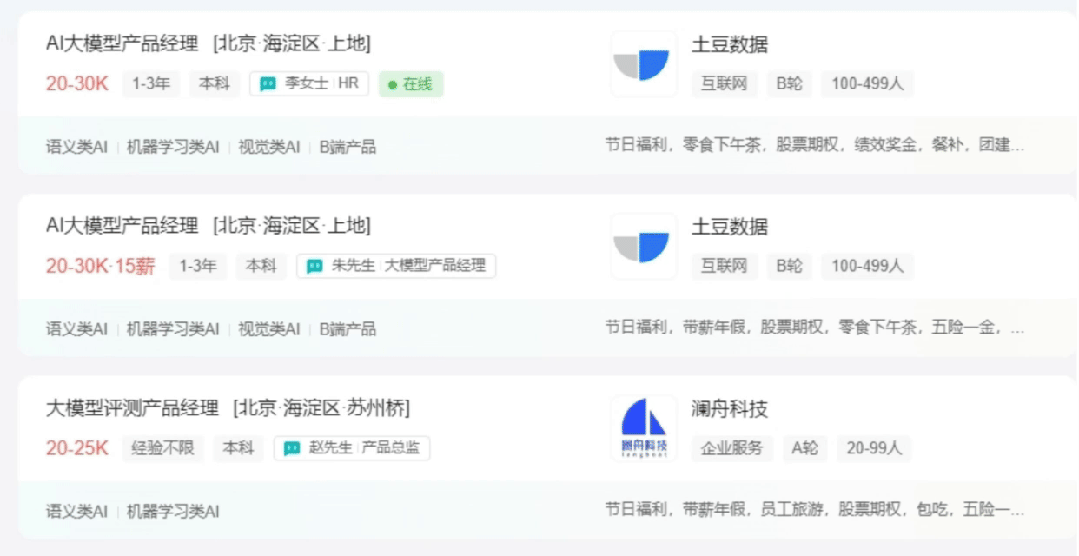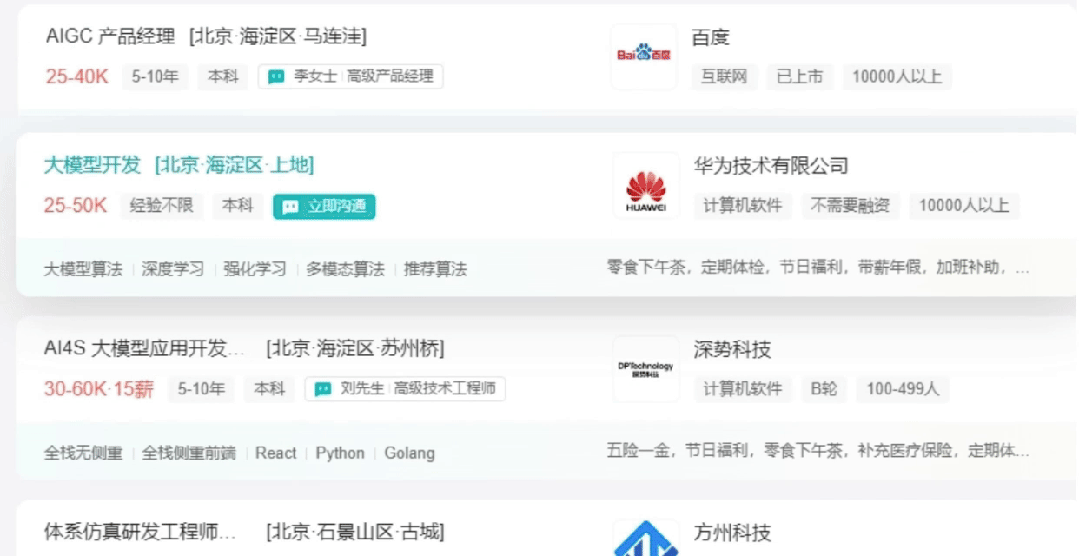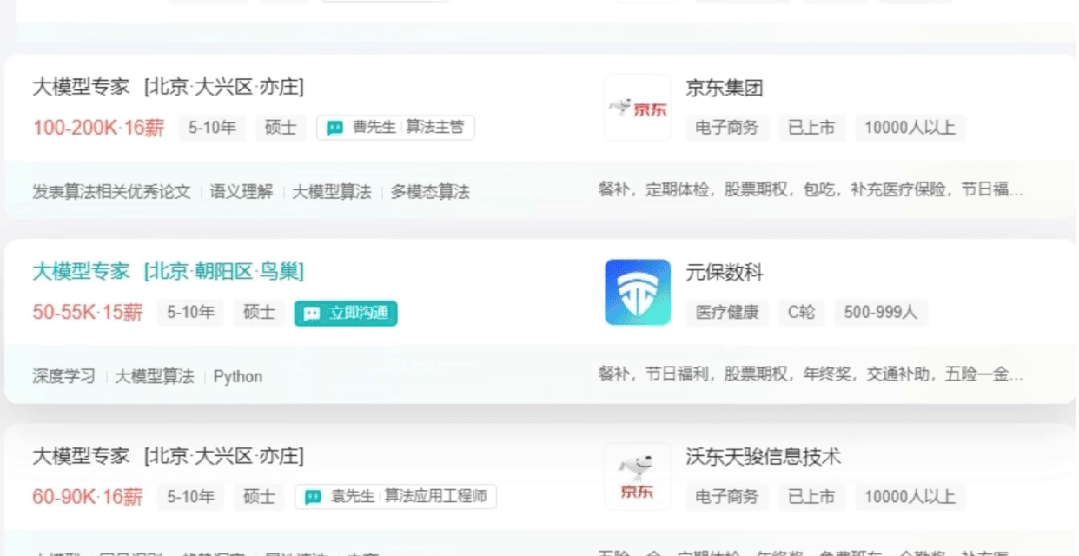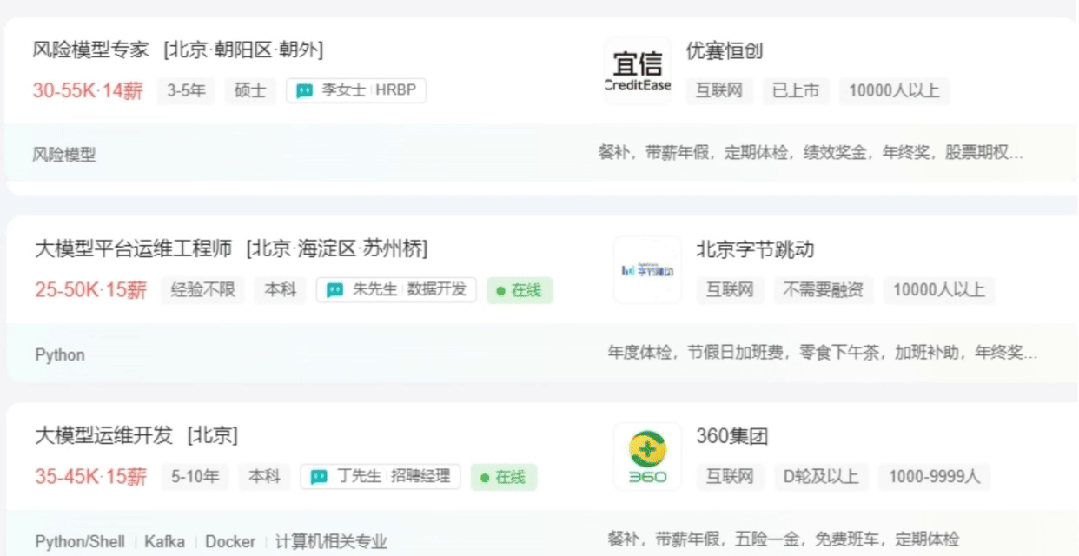
不出1年,“有AI项目经验”将成为投递简历的门槛。
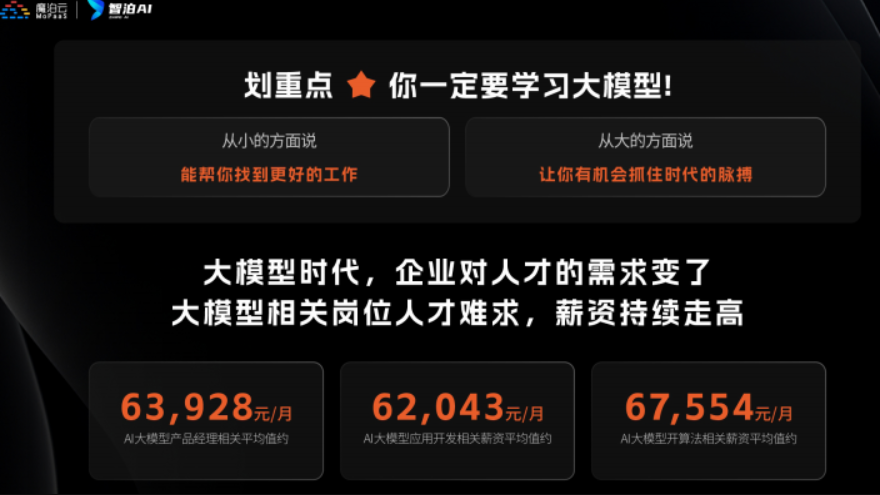
风口之下,与其像“温水煮青蛙”一样坐等被行业淘汰,不如先人一步,掌握AI大模型原理+应用技术+项目实操经验,“顺风”翻盘!
这些资料真的有用吗?
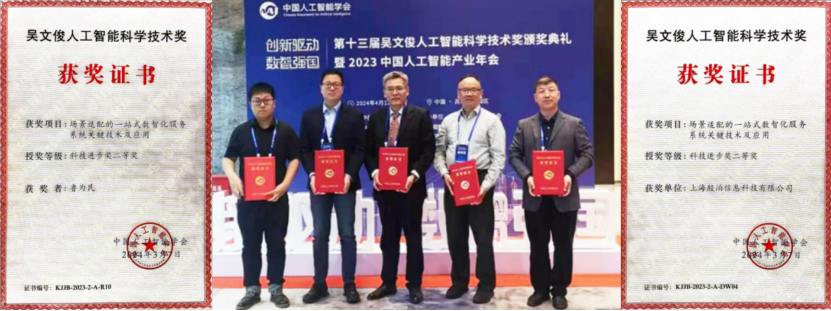
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
以上全套大模型资料如何领取?

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐
 1
 0
- 0


 已为社区贡献199条内容

所有评论(0)