AI Agent学习 | Embedding 和 向量库 原理详解
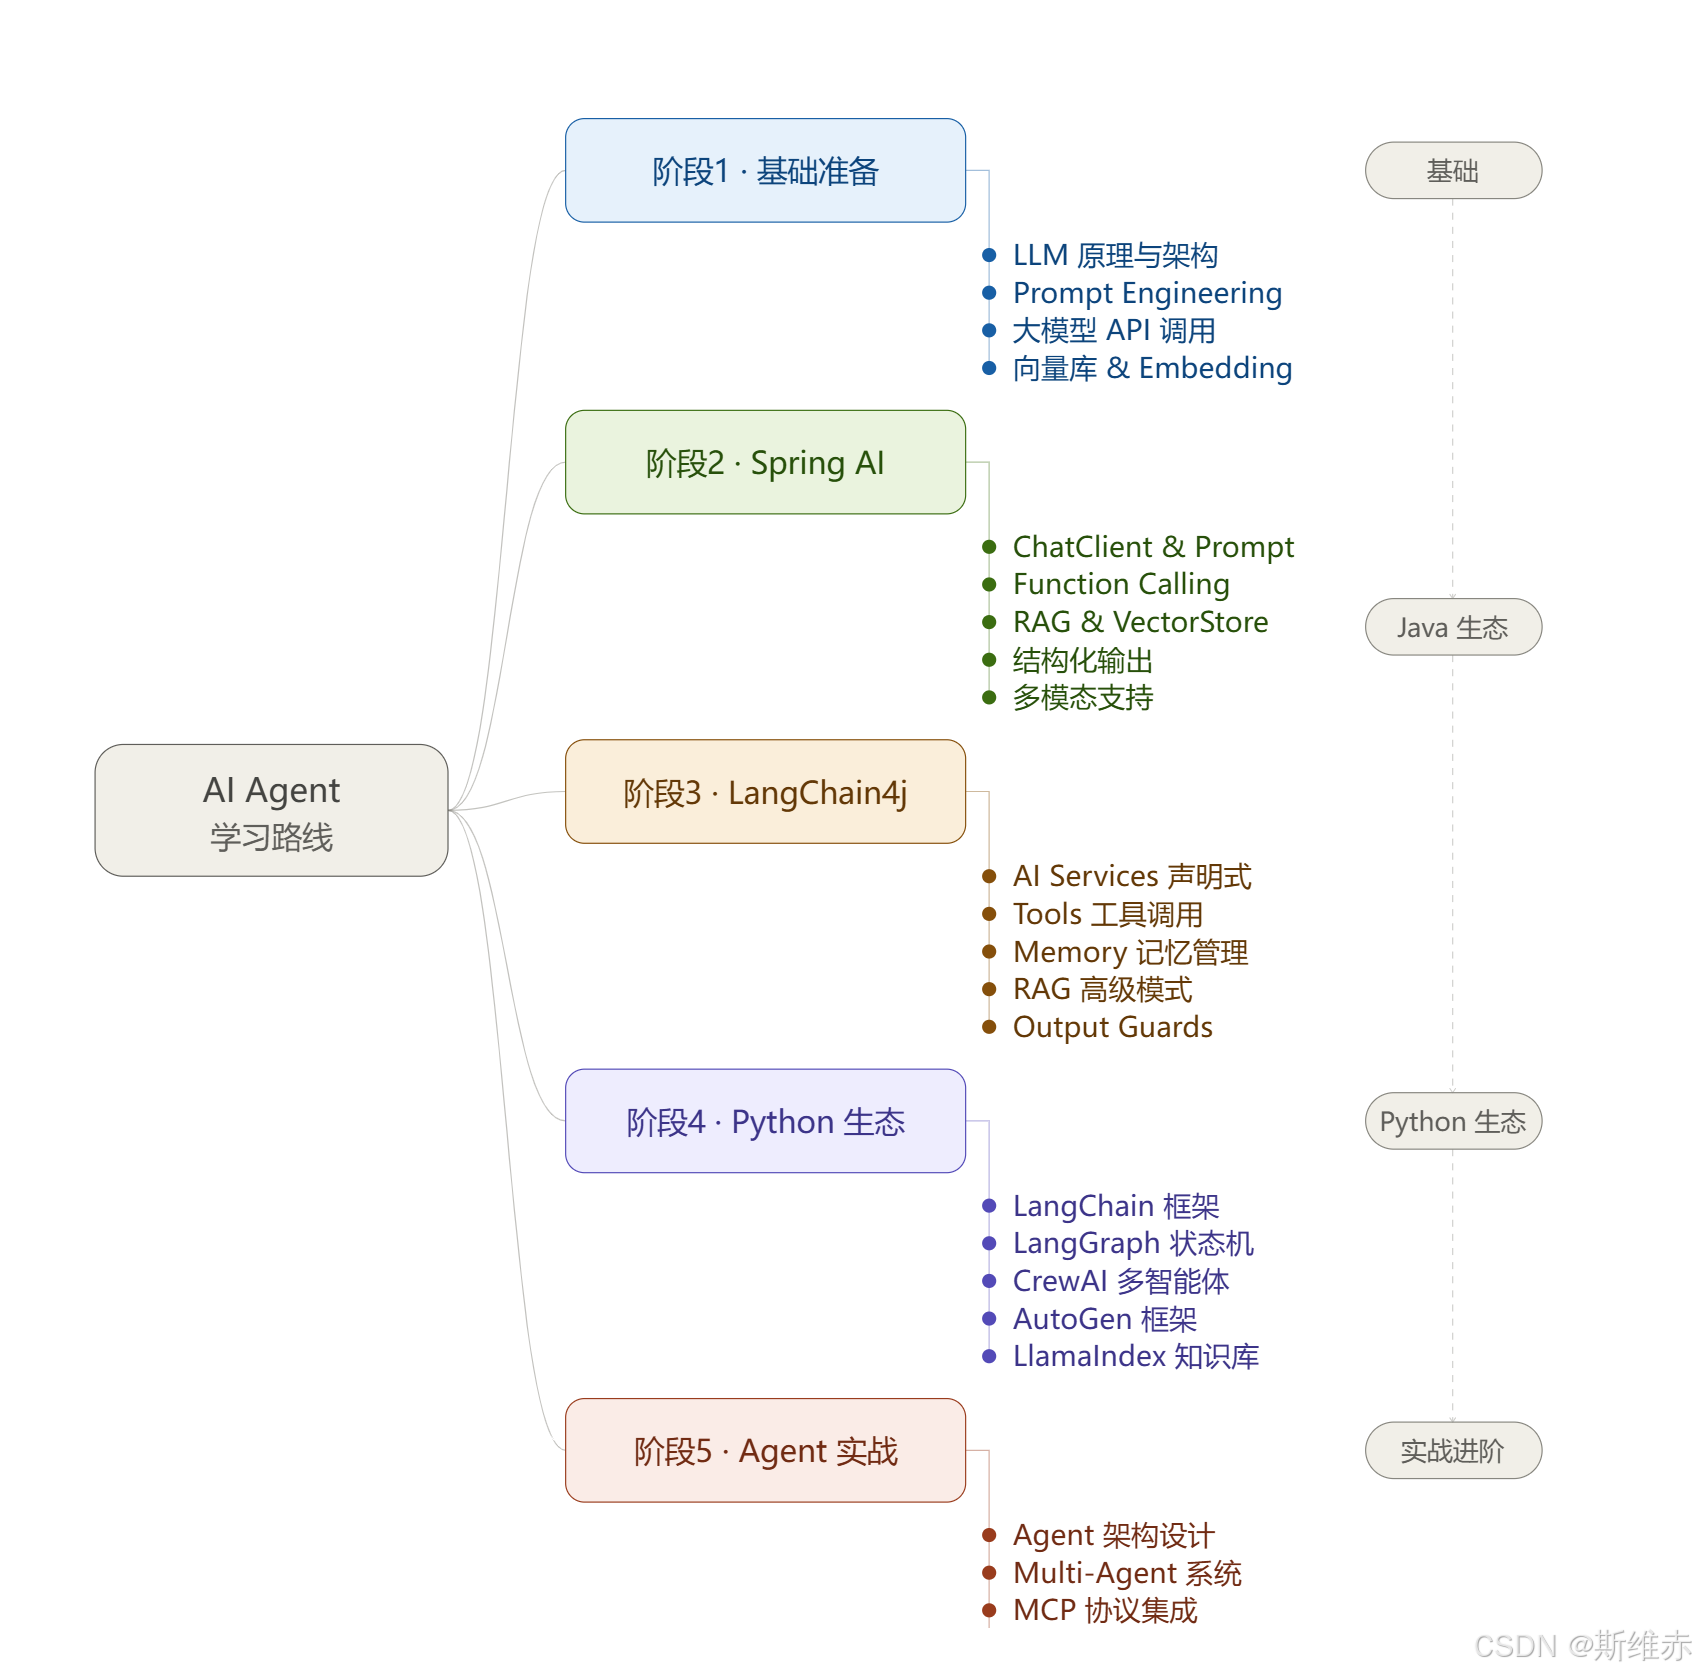
导读 :ChatGPT 认识维基百科,但不认识你公司的制度文档。怎么让 AI "记住"私有知识?答案就是今天的主角:Embedding(把语义变成坐标)和向量数据库(在海量坐标里快速找近邻)。原理用坐标和色卡讲明白,代码用 Spring AI 直接跑,看完就能搭出你自己的知识库问答。
01 · 先讲一个"搜不到"的尴尬
你负责的公司知识库里有一篇文档,标题叫《充电器故障排查指南》,里面写着:
手机无法充电时,先检查充电线接口是否有异物,再用酒精棉片清洁 USB-C 接口……
然后有员工来问:"我手机充不进电怎么办?"
如果知识库用的是普通关键词搜索,这条查询很可能搜不到那篇文档——因为"充不进电"和"故障排查""接口异物"里,一个关键词都对不上。
人一眼就能看出这两句话在说同一件事。但"字面"搜索匹配的是文字,而人想匹配的是"意思"。
怎么让计算机也懂"意思"?这就是 Embedding 要解决的问题。
02 · Embedding:把语义翻译成坐标
什么是向量
回忆一下初中数学:平面上的点可以用坐标 (x, y) 表示,比如你家在 (3, 4),朋友家在 (5, 1)。坐标之间的距离,就是两人家的远近。
向量就是"更高维的坐标"。一个 1536 维的向量,就是 1536 个数字排成一排——它表示高维空间里的一个点。
Embedding 干什么
Embedding 就是把一段文字,变成这样一个高维坐标。
关键的性质是:语义相近的文本,坐标距离也近。
-
"我爱吃苹果" 和 "水果是我的最爱" → 坐标很近
-
"我爱吃苹果" 和 "汽车保养要看机油" → 坐标很远
类比:想象一个巨大的"色卡"。红色、酒红、砖红挤在一起,因为它们"视觉上相近";红色和蓝色离得远。Embedding 就是把语言映射到一张"语义色卡"上——意思相近的词,位置就靠近。
这个映射不是人写的,是专门的 Embedding 模型在训练中自动学出来的(常见的有 BGE、OpenAI 的 text-embedding-3、通义 text-embedding-v4 等)。训练时模型见过海量"苹果和水果一起出现、苹果和汽车很少一起出现"的文本,就把这些关联"折叠"进了坐标里。
💡 Java 类比可以把它想成一个超大的
Map<String, float[]>:输入一句中文,输出一个浮点数组。模型不同,数组长度(维度)也不同——768 维、1024 维、1536 维都有。
动手验证一下这个直觉
下面这段 Java 用 Spring AI 的 EmbeddingModel 把三句话变成向量,再用手写的余弦相似度算距离:
double[] a = embeddingModel.embed("我喜欢吃苹果");
double[] b = embeddingModel.embed("水果是我的最爱");
double[] c = embeddingModel.embed("汽车保养要看机油");

System.out.println("苹果 vs 水果 : " + cosine(a, b));   // 大概率接近 0.8+
System.out.println("苹果 vs 汽车 : " + cosine(a, c));   // 大概率接近 0.2-0.4

// 余弦相似度:两向量夹角的余弦,越接近 1 表示方向越一致(语义越近)
static double cosine(double[] x, double[] y) {
    double dot = 0, nx = 0, ny = 0;
    for (int i = 0; i < x.length; i++) {
        dot += x[i] * y[i];
        nx += x[i] * x[i];
        ny += y[i] * y[i];
    }
    return dot / (Math.sqrt(nx) * Math.sqrt(ny) + 1e-9);
}
"苹果"和"水果"的距离,会明显比"苹果"和"汽车"近。这就是语义匹配的底层直觉。
03 · 相似度:三把尺子怎么选
向量有了,怎么判断"近不近"?有三种常用度量:
| 度量 | 直觉 | 特点 | 文本场景 |
|---|---|---|---|
| 余弦相似度 | 看"方向"是否一致,不看长短 | 对文本长度不敏感,最常用 | ✅ 首选 |
| 点积 | 方向 + 长度的综合 | 向量需先归一化,否则长文本占便宜 | 部分库默认 |
| 欧氏距离 | 看绝对距离,越小越近 | 对长度敏感,通常要归一化后用 | 少用 |
文本场景基本无脑选余弦相似度:两个句子长度差很多("好吃" vs "这个苹果真的非常好吃而且很甜"),语义可能一样,余弦只看方向,不受长度干扰。
顺带一提:全程只用同一个 Embedding 模型。不同模型产出的向量"坐标系"不一样,混着用等于拿两把不同刻度的尺子量长度,结果没意义。
04 · 向量数据库:海量坐标怎么快速找
为什么不能暴力搜
Embedding 之后的检索叫"最近邻搜索"。几万条文档时,暴力把每条向量和问题向量算一遍余弦,还行;几百万条时,每次都全量算,性能就崩了。
所以向量数据库用 ANN(近似最近邻)算法——不追求 100% 精确,用索引结构(如 HNSW、IVF)把"挨个比"变成"先粗筛再精排",速度提升几个数量级,精度损失很小。
类比:找一本书,暴力方式是抱着书从书架头走到尾;有索引的方式是看分类标签直奔那一格。ANN 就是那个"分类标签"。
为什么不用 MySQL
| 检索方式 | 匹配原理 | 典型短板 |
|---|---|---|
LIKE '%退款%' | 字面包含 | 换个说法"把钱退给我"就搜不到 |
| Elasticsearch 全文检索 | 分词 + 词频 | 不懂语义,"苹果"在水果文档和手机文档里权重一样 |
| 向量检索 | 语义距离 | 需要 Embedding 成本,但"怎么退钱"能命中"退款流程" |
一句话:关键词匹配的是"字面",向量检索匹配的是"意图"。
选型参考
| 方案 | 定位 | 适合 |
|---|---|---|
| SimpleVectorStore | 内存实现(Spring AI 内置) | 开发调试、小规模验证 |
| PGVector | PostgreSQL 插件 | 想和现有数据库同栈,省运维 |
| FAISS | Meta 开源库 | 离线/单机大规模检索 |
| Milvus / Qdrant | 专用向量数据库 | 生产级、大规模、高并发 |
| Redis 向量模块 | 缓存 + 检索一体 | 已有 Redis、场景较轻 |
Spring AI 用 VectorStore 接口把这些实现统一了:今天用 SimpleVectorStore 开发,明天换 PGVector 上生产,业务代码一行不用改,只换 Bean 实现和配置。
05 · 它在 RAG 里的位置
如果你看过之前那篇 RAG 文章,会发现 Embedding 和向量库正是 RAG 的地基。整个链路长这样:
【离线:建索引】
知识库文档 → 文本切分(Chunk) → Embedding 向量化 → 存入向量数据库

【在线:答问题】
用户提问 → 问题向量化 → 向量库相似度检索 Top-K → 相关片段注入 Prompt → 大模型生成回答
Embedding 负责"把文字变成坐标",向量库负责"存坐标、按距离找近邻",RAG 负责"把找回来的片段喂给大模型"。三层各司其职。
06 · Spring AI 实战:一个能跑的知识库问答
下面这套代码完整可跑,实现了"公司知识库 → 语义问答"。
第一步:加依赖、配 Embedding 模型
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-starter-model-openai</artifactId>
</dependency>
spring:
  ai:
    openai:
      api-key: ${OPENAI_API_KEY}
      embedding:
        model: text-embedding-3-small   # Embedding 模型
注意:Embedding 模型和对话模型是两回事。DeepSeek 这类只提供对话模型的厂商没有 embedding 接口,可以接 OpenAI、通义,或本地 Ollama 跑 BGE。反正代码里都叫
EmbeddingModel
,换供应商只改配置。
第二步:配置内存向量库 + RAG Advisor
@Configuration
public class RagConfig {

    // 内存向量库:add() 时自动调用 EmbeddingModel 计算向量
    @Bean
    public VectorStore vectorStore(EmbeddingModel embeddingModel) {
        return SimpleVectorStore.builder(embeddingModel).build();
    }

    // 检索增强 Advisor:每次提问前自动"检索 → 拼接上下文"
    @Bean
    public QuestionAnswerAdvisor questionAnswerAdvisor(VectorStore vectorStore) {
        return QuestionAnswerAdvisor.builder(vectorStore)
            .searchRequest(SearchRequest.builder()
                .similarityThreshold(0.4)  // 相似度低于 0.4 的片段直接丢弃
                .topK(4)                   // 取最相关的 4 段
                .build())
            .build();
    }
}
第三步:把知识库灌进去
@Component
public class KnowledgeInitializer {

    private final VectorStore vectorStore;

    public KnowledgeInitializer(VectorStore vectorStore) {
        this.vectorStore = vectorStore;
    }

    @PostConstruct
    void init() {
        vectorStore.add(List.of(
            new Document("公司年假制度:员工入职满一年后,每年享有 15 天带薪年假,"
                       + "需提前 3 个工作日申请。",
                Map.of("type", "HR")),                      // 元数据,可用来过滤
            new Document("办公用品申请:通过 OA 系统提交申请,1 个工作日内审批完成。",
                Map.of("type", "行政"))
        ));
    }
}
第四步:一个问答接口
@RestController
public class FaqController {

    private final ChatClient chatClient;
    private final QuestionAnswerAdvisor ragAdvisor;

    public FaqController(ChatClient.Builder builder, QuestionAnswerAdvisor ragAdvisor) {
        this.chatClient = builder.build();
        this.ragAdvisor = ragAdvisor;
    }

    @GetMapping("/ask")
    public String ask(@RequestParam String question) {
        return chatClient.prompt()
            .user(question)
            .advisors(ragAdvisor)   // 自动完成"检索 + 注入 + 生成"
            .call()
            .content();
    }
}
效果
GET /ask?question=我入职一年了,能休几天假?
→ 根据公司制度,入职满一年后每年享有 15 天带薪年假,需提前 3 个工作日申请。
注意:问题里"入职一年"和文档里"入职满一年""15 天带薪年假"没有几个字是一样的——但语义匹配上了。这就是 Embedding + 向量检索和关键词搜索的本质区别。
如果想看检索中间结果,直接调向量库:
List<Document> hits = vectorStore.similaritySearch("能休几天年假?");
hits.forEach(d -> System.out.println("命中: " + d.getContent()));
// 输出第一条是年假制度那条,而不是办公用品那条
07 · 实战要点:五个常见坑
① 切分(Chunking)决定上限。 检索的最小单位是切出来的文本块。整篇一起向量化 → 语义混杂、命中不精准;切太碎 → 一句话被腰斩、上下文丢失。一般按 256~512 token 切,长文档按标题结构切。
② Top-K 和阈值要一起调。topK 控制返回几条,similarityThreshold 控制最低相似度。K 太大混入噪声,阈值太高可能什么都搜不到,按业务实测调。
③ 元数据过滤很实用。 给文档打标签(部门、版本、时间),检索时按 type == 'HR' 之类的表达式过滤,能大幅提升准确性——比如"只查今年的人力制度"。
④ 混合检索更稳。 向量检索擅长语义,但精确匹配(产品编号、代码符号)容易漏。生产级方案是"向量 + 关键词(BM25)"双路检索再融合,两边都照顾到。
⑤ 检索 ≠ 问答结束。 检索只是第一步,注入的 Prompt 要写明"仅依据上下文回答,没依据就说不知道",否则模型可能跳过检索结果自己编——幻觉又回来了。
08 · 写在最后
把这篇和前面几篇串起来看,你其实已经掌握了 AI 应用开发的完整拼图:
-
LLM 原理:模型怎么理解语言(Transformer、注意力)
-
API 调用:模型怎么被调用(HTTP + 消息 + 流式)
-
Prompt 工程:怎么让模型答得对(角色、示例、思维链)
-
Embedding + 向量库:怎么让模型"记住"你的私有知识(语义检索、RAG 地基)
动手建议:把代码跑起来,往知识库里加几段自己的文档,然后用各种"换着说法"的问题去问它——你会直观感受到"语义匹配"和"关键词匹配"的差距,这个体感比读十篇文章都有用。
往期文章:
AI Agent学习之路 | 第一阶段01 | LLM 工作原理详解
AI Agent学习之路 | 第一阶段02 | Prompt Engineering(提示词工程)的三板斧核心技巧
AI Agent学习之路 | 第一阶段03 | 和 AI 聊天,其实是一次 HTTP 请求(API调用实现)
下一阶段第一节【ChatClient搭配Prompt具体实现】——这也是我们 AI Agent 学习路线的下一阶段课程。想继续的学习的点个【赞】和【推荐】让主编知道!
点个【关注】,私信主编,获取一手的面试八股、编程教程、效率工具、AI Agent等学习资料。

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐

 1
 0
- 0


 已为社区贡献3条内容

所有评论(0)