transformers v5.17.0发布:1M上下文、780B MoE、语音、多模态、缓存与内核全面进化
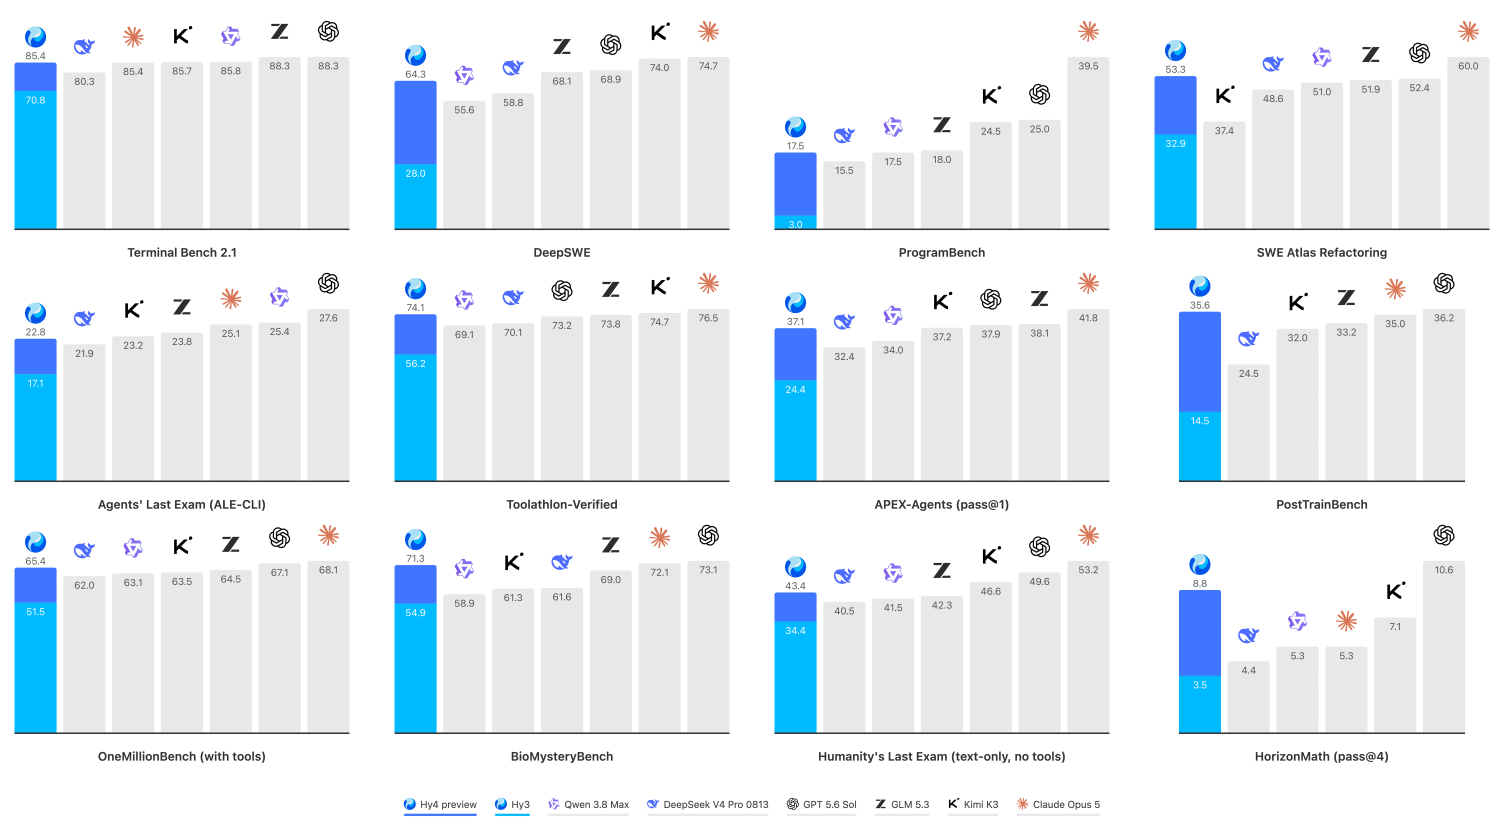
2026年9月15日,Hugging Face Transformers 发布 v5.17.0。此次版本覆盖范围很广,新增多款语言、语音、多模态与音频编解码模型,同时围绕生成性能、缓存机制、内核注册、量化、视觉 RoPE、MTP、设备适配、测试体系和文档进行了集中升级与修复。
对于开发者而言,transformers v5.17.0 的关键词可以概括为:超长上下文、稀疏注意力、线性注意力、长音频生成、多语言语音识别、多模态文档检索、低码率神经音频编码、生成链路优化,以及大量底层兼容性修复。
一、全新模型阵容:从 780B MoE 到语音、多模态与音频编解码
本次版本新增 HYV4、VibeVoice、NeoMME、NeoMME-Retriever、Fun-ASR-Nano、KimiLinear、Canary 与 NeuCodec 等模型支持,覆盖大语言模型、语音合成、自动语音识别、语音翻译、视觉文档检索、音频压缩等多个方向。
二、HYV4:780B 参数 MoE 与 1M Token 超长上下文
HYV4 的预览版本是一款拥有 780B 参数的混合专家语言模型。虽然总参数规模达到 780B,但每个 Token 实际激活的参数量为 49B,从而通过 MoE 架构在模型容量与推理计算量之间取得平衡。
其每个 MoE 层包含 256 个路由专家,以及 1 个始终激活的共享专家。每一个 Token 会被路由至 8 个专家进行处理。这样的设计既能让不同 Token 选择适合自己的专家路径,也能通过共享专家保留稳定的通用计算能力。
HYV4 最引人关注的能力之一是支持 1M Token 上下文窗口,适用于超长文档分析、长代码库理解、复杂知识库问答以及长篇多轮内容处理等任务。
其架构融合了四项关键设计。
第一项是多头潜在注意力,也就是 MLA。该机制通过低秩潜变量压缩键和值,其中 kv_lora_rank 用于定义压缩后的低秩空间,再由 kv_b_proj 将潜变量扩展回每个查询头所需的键和值。该设计能够降低长上下文推理中的 KV 存储与计算压力。
第二项是 DeepSeek 稀疏注意力,也就是 DSA。它通过轻量级索引器,为每一个 Query 选择 index_topk 个最相关的 Key,而不是让每个 Query 关注全部历史 Token,从而减少注意力计算开销。
在索引器执行方式上,HYV4 参考 IndexShare 机制。只有 indexer_types 中标记为 full 的层会真正运行索引器;标记为 shared 的层则复用前一个 full 层已经选择出的注意力位置。这种设计减少了索引选择过程的重复计算。
第三项是带门控的 MLA 与可学习注意力汇聚点。每个注意力头都拥有一个可学习的 sink logit,它会参与 Softmax 归一化过程,但不贡献具体的 Value 信息。这一机制与 GPT-OSS 中的相关设计一致。
第四项是独立超连接,也就是 iHC。它不再使用传统的单一残差路径,而是采用 hc_mult 条并行残差流。在每个子层之前,这些残差流会先进行折叠;在子层处理完成后,再被重新分配到多条残差流中。
需要注意的是,当前实现不会执行多 Token 预测层,也就是 MTP 层。发布的检查点仍然保留了这些权重,因此其他运行时仍可将其用于推测解码;但在当前加载流程中,这些权重会被忽略。
HYV4 已通过对应模型实现加入 transformers,相关文档可供查阅。
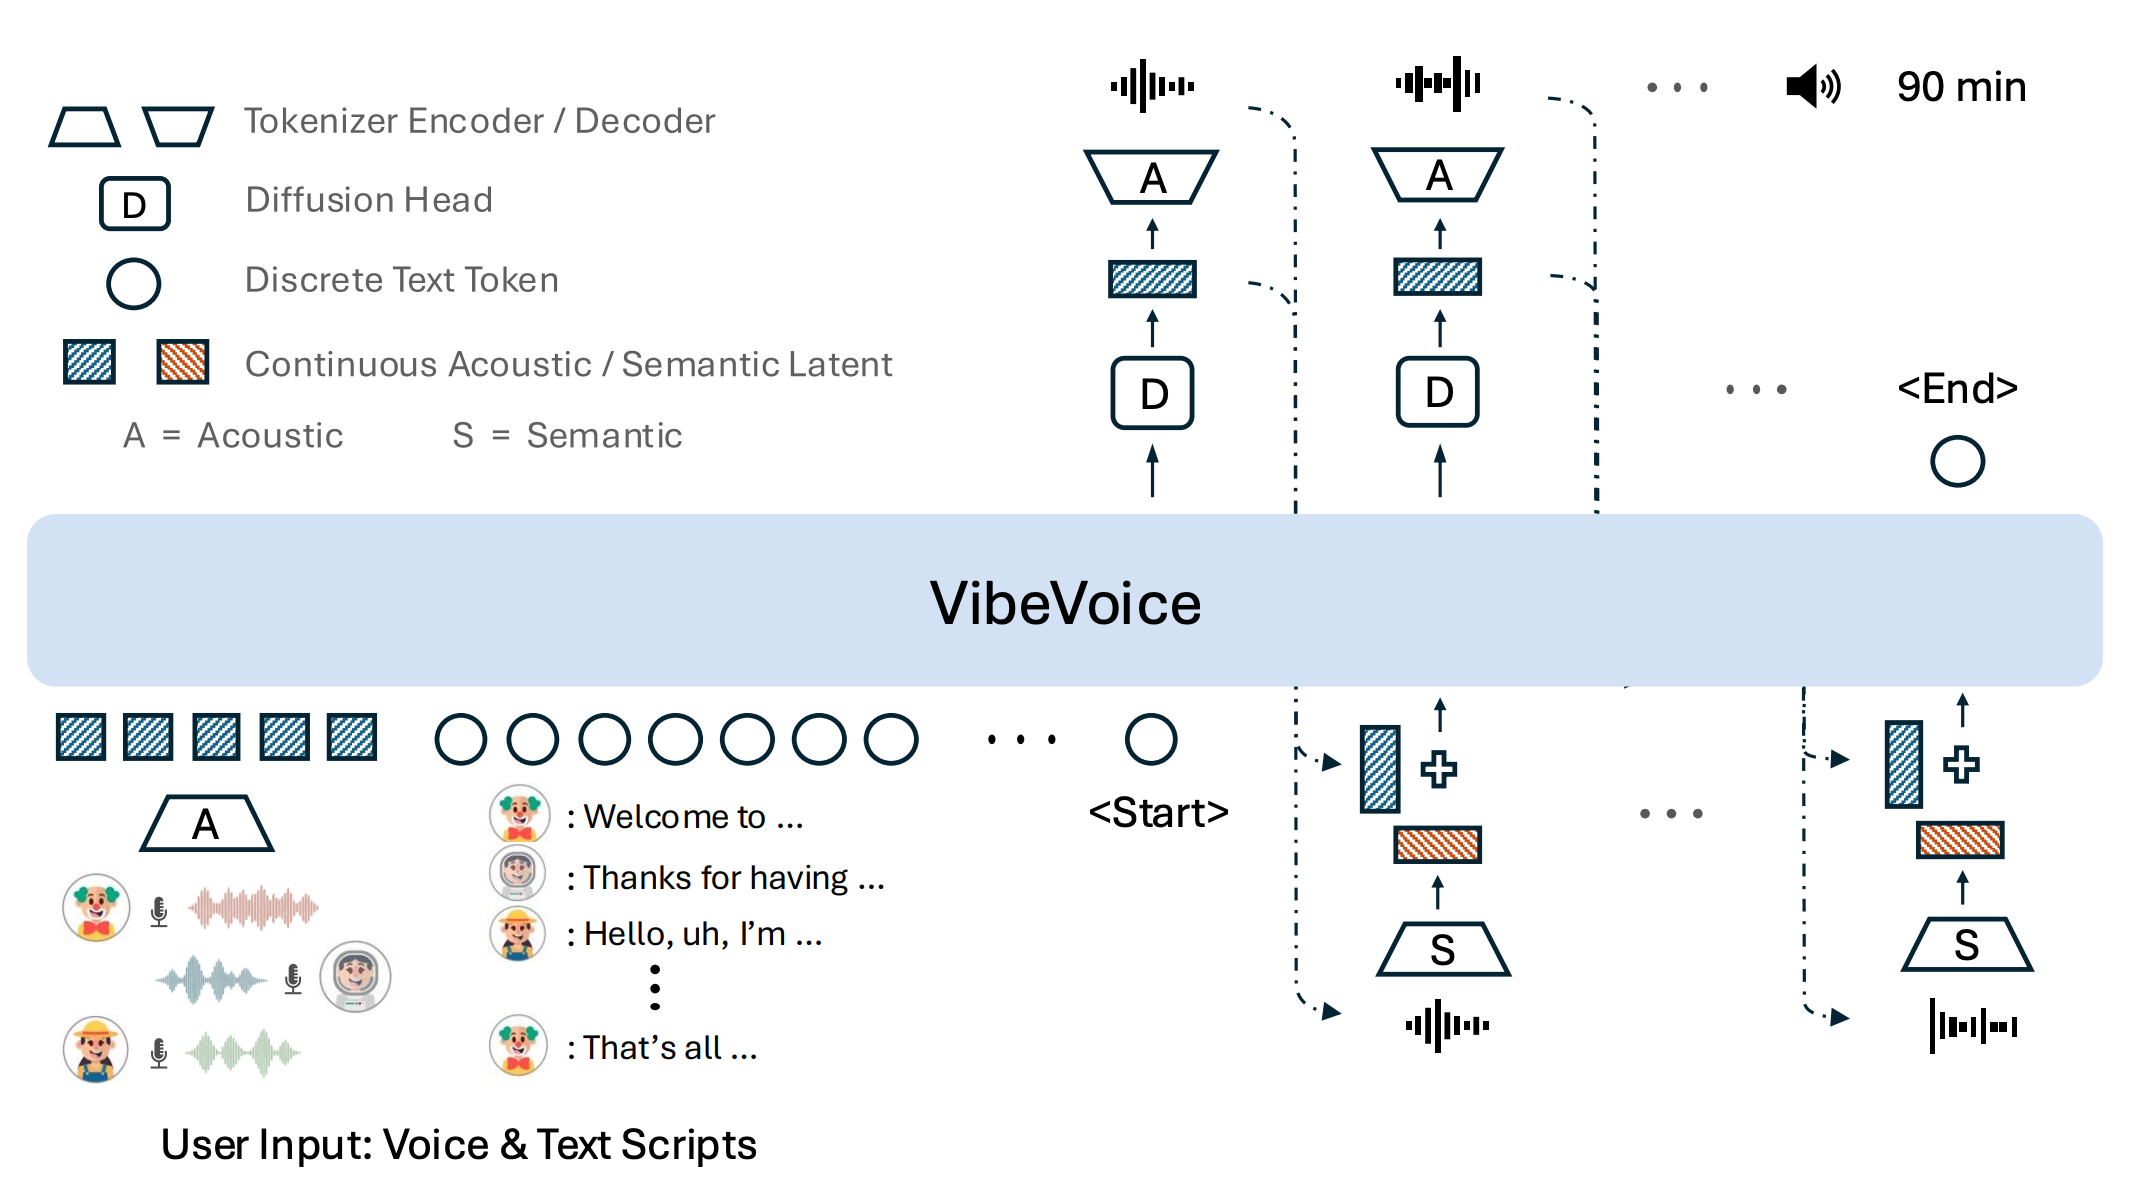
三、VibeVoice:面向多说话人长音频生成的语音合成框架
VibeVoice 是一套用于生成高保真、长形式、多说话人语音的框架。它在大语言模型结构中采用下一 Token 扩散方法,用于模拟更加自然的对话氛围与说话节奏。
与传统短句语音合成不同,VibeVoice 重点关注长时间、多角色、连续对话场景中的语音一致性与真实感。它特别适合用于生成播客内容、多参与者有声读物,以及需要模拟自然聊天氛围的长音频内容。
v5.17.0 已实现 VibeVoice 模型支持,并提供相应文档。
此外,围绕 VibeVoice,本次版本还修复了量化缓存相关问题,并跳过了不稳定的生成导出测试。文档部分也修复了 VibeVoice 文档中的代码语法错误与文字拼写问题。
四、NeoMME 与 NeoMME-Retriever:多语言、多模态原生编码器
NeoMME 是一组高效的多模态原生多语言基础编码器,包含 260M 和 800M 参数规模。
该模型将多语言文本 Token 与原始图像 Patch 直接送入同一个双向 Transformer 编码器中处理,不依赖单独预训练的视觉塔,也不需要额外的因果语言模型。这种统一的编码方式使其能够更紧密地建模文本和图像信息。
NeoMME-Retriever 则是在 NeoMME 基础模型上进一步微调得到的视觉文档检索模型,面向文本查询与文档之间的检索任务。文档既可以是纯文本,也可以是页面截图。
该模型会生成两类向量表示:
- 多向量嵌入,用于 MeanMaxSim 评分,支持后期交互式检索。
- 平均池化嵌入,用于余弦相似度计算,支持稠密检索。
通过将后期交互与稠密向量目标联合起来,NeoMME-Retriever 能够服务于视觉文档搜索、截图检索、多语言资料匹配等场景。
此次版本加入 NeoMME 与 NeoMME-Retriever 支持,并针对 NeoMME 进行了不继承装饰器相关调整。
五、Fun-ASR-Nano:800M 参数的中英日端到端语音识别模型
Fun-ASR-Nano 是一款 800M 参数端到端自动语音识别模型,面向中文、英文和日文语音识别任务。
该模型在中文、英文与日文 ASR 基准上实现了领先表现,同时相比许多同类模型具有更小的参数规模。
其主要能力包括:
- 支持中文、英文和日文。
- 支持 7 种中文方言与 26 种区域口音。
- 支持热词定制,适合添加行业术语、专有名词和特定领域词汇。
- 原生输出标点,不需要再额外接入独立的标点恢复模型。
对于客服质检、会议转写、内容字幕、方言语音交互、行业语音录入等场景,这类端到端识别能力具有较高实用价值。
六、KimiLinear:混合线性注意力架构进入 transformers
Kimi Linear 是一种混合线性注意力架构,其核心是 Kimi Delta Attention,也就是 KDA。
KDA 是对 Gated DeltaNet 的改进。传统设计中的遗忘机制通常以注意力头为单位,而 KDA 进一步让每一个 Key 通道都拥有独立的遗忘门。这样一来,循环状态可以按照通道进行衰减,而不再只能按整个注意力头统一衰减。
KimiLinear 的大多数层采用 KDA;每隔四层保留一个全注意力模块。这个全注意力模块复用 DeepSeek-V3 的多头潜在注意力 MLA。
在前馈网络方面,KimiLinear 使用 DeepSeek-V3 风格的 MoE,并包含共享专家。也就是说,该架构通过线性注意力承担大部分高效计算任务,同时周期性使用全注意力补充全局建模能力,再配合 MoE 提升模型表达容量。
本次版本加入 KimiLinear 支持,并修复了 CPU Offload 测试中本地专家数量设置的问题,测试设置调整为 num_local_experts=4。
七、Canary:ASR 与语音到文本翻译模型支持
Canary-1B-v2 是一款快速、稳健的多语言模型,支持自动语音识别和语音到文本翻译。
该模型复用了来自 Parakeet 的 Fast Conformer 编码器,并通过 ParakeetEncoder 与 ParakeetEncoderConfig 进行加载。编码器输出会交给 Transformer 解码器处理。
解码器具有以下特点:
- 使用固定正弦位置嵌入。
- 对编码器输出执行交叉注意力。
- 输入嵌入与输出嵌入权重绑定。
Canary 通过解码器提示前缀来选择具体任务。提示格式如下:
<|startofcontext|> <|startoftranscript|> <|emo:undefined|> <source_lang> <target_lang> <pnc|nopnc> <|noitn|> <|notimestamp|> <|nodiarize|>
其中,当 source_lang 与 target_lang 相同,模型执行转写任务;两者不同时,则执行翻译任务。
v5.17.0 已加入 Canary-1B-v2 支持及对应文档。
八、NeuCodec:低码率、具备传输鲁棒性的神经音频编解码器
NeuCodec 是一种神经音频编解码模型,基于有限标量量化扩展 XCodec2。
该模型采用有限标量量化,也就是 FSQ。由于 FSQ 使用单一代码本,因此特别适合作为语音语言模型等下游模型的音频 Token 表示方式。
NeuCodec 的特点包括:
- 训练数据采用 CC 数据,因此不存在非商业数据限制。
- 在每秒 50 个 Token、每个 Token 16 Bit 的条件下,总码率为 0.8kbps。
- 输入为 16kHz 音频,输出通过上采样解码器生成 24kHz 音频。
- FSQ 编码机制具备比特级错误抵抗能力,适合不稳定和噪声较大的传输通道。
本次版本正式加入 NeuCodec 支持,相关文档同步提供。
九、重要破坏性变更:视觉二维与三维 RoPE 统一
v5.17.0 对视觉旋转位置嵌入进行了标准化改造。
此前,二维和三维视觉 RoPE 可能存在注意力层级或特定模型级别的网格交错计算逻辑。现在,这些逻辑已统一为集中式 RoPE 频率计算模块。
因此,依赖注意力层级 RoPE 网格交错逻辑,或者依赖模型专属 RoPE 实现的自定义视觉模型,需要迁移到新的 modeling_rope_utils.py 实现方式。
此次变更涉及视觉二维与三维旋转位置嵌入,是升级 v5.17.0 时需要重点关注的兼容性调整。
十、生成模块优化:减少同步、避免不必要下载、补齐正确性问题
生成模块在本次版本中获得多项优化与修复。
首先,生成过程中不再在每一个解码步骤都执行不必要的加速器同步。这一优化能够降低逐步解码的额外开销,从而改善生成性能。
其次,修复了生成时无条件下载远程 Hub 文件的问题。现在生成流程不会因为不必要的逻辑而自动下载远程文件。
此外,版本还包含以下生成相关修复:
- 对编码器解码器模型强制执行自动编译缓存检查。
- 统一 AfMoE 中
past_key_values参数的命名,使 forward 与 generate 之间更加一致。 - 修复 MTP 生成测试中与转义层忽略键有关的正则门控问题。
- 修复多个生成集成测试中因输出不匹配导致的不稳定问题。
- 对 VibeVoice 跳过不稳定的 generate 导出测试。
十一、缓存系统修复:量化缓存、分页注意力与连续批处理说明完善
缓存机制也是本次更新的重要部分。
v5.17.0 修复了 VibeVoice 中的量化缓存问题,避免量化缓存逻辑出现异常。
针对 VoxtralRealtime,修复了错误拒绝非静态缓存实现的问题,使其不再将非静态缓存错误视为不支持的实现。
对于分页注意力,如果在没有缓存的情况下调用 forward,现在会明确抛出异常,而不是静默失败。这有助于开发者更快定位缓存传递错误。
文档也进一步说明了 ContinuousBatchingConfig 的使用方式,并补充了滑动窗口模型的相关限制。
此外,系统还针对过期的 GitHub API 缓存,加入了重新尝试获取每日 CI 运行信息的机制。
十二、Kernel 能力增强:导入、回退提示、注册机制全面改善
内核支持在 v5.17.0 中也得到了强化。
当仅安装 fla-core 时,嵌套 FLA Kernel 导入现在可以正常工作。
对于 Hub Kernel 函数,如果其执行时悄然回退到速度更慢的纯 PyTorch 参考实现,系统将发出一次警告。这可以帮助开发者识别性能路径是否真正启用了高性能 Kernel。
KernelConfig 现在支持注册独立函数,例如 RoPE。同时,还可以选择不继承默认映射,使 Kernel 定制方式更加灵活。
此外,本次更新修正了 ESMFold2 Kernel 的提交与仓库路径,并更新了 KernelConfig 自定义相关文档。
十三、量化修复:FP8、MXFP4 与 AutoRound 能力完善
量化模块修复了多项问题。
针对 Qwen 模型,修复了 Qwen4Exp-FP8 位置嵌入处理问题。
针对张量并行场景,补齐了缺失的 FP8 Tensor Parallel 层覆盖逻辑。
在 XPU 设备上,如果设置 use_kernels,MXFP4 权重将保持量化状态,不再进行不必要的反量化。
AutoRound 量化新增支持 5 Bit、6 Bit 与 7 Bit 配置。
十四、模型、训练、设备与接口层面的关键改进
除上述重点模块外,v5.17.0 还包含大量模型功能、接口与运行时修复。
在位置编码与注意力方面,继续完善 MRoPE;允许微型模型使用嵌套 RoPE 参数;修复旋转位置嵌入回归问题;修复 RoPE 编码器中基于位置索引的 Token Type 查找逻辑;修复 Gemma3 和 Gemma4 视觉模型创建掩码时的滑动窗口 layer_idx 问题;并移除了已弃用的掩码函数。
在损失计算方面,Decoder-only LLM 和 VLM 的损失计算现在会正确遵循 shift_labels。
在视觉模型与多模态模型方面,修复 YOLOS 在 device_map="auto" 下的设备不匹配问题;更新 HunYuanVL、Flava、MiniCPMV4_6、Qwen3VLMoe 等模型集成测试的预期输出或黄金值;修复 Pix2StructTextAttention 初始化时应使用 hidden_size 而非 d_kv 的问题;修复 Grounding DINO 的 FP16 dtype 问题;文档明确说明 SmolVLM、Idefics2、Idefics3 的 image_hidden_states 与 pixel_values 不能同时使用。
在训练与内存方面,修复 gradient_checkpointing_enable(offload=True) 中的 AttributeError,并新增梯度检查点 Offload 支持。文档中补充了部分检查点与 group_by_length 内容。
在 MTP 相关能力上,系统只捕获最后一层的 hidden_states 以节省内存;支持通过 capture_outputs 仅捕获必要的隐藏状态;支持按层配置 MTP;同时暂时跳过部分 MTP 慢速测试。
在设备兼容性方面,扩展了部分 XPU 场景支持;增加 HunYuanVL 模型测试的 XPU 预期;修复 XPU 上的部分失败;修复 Inkling 在 MPS 与 CUDA 下的 Mel 频谱提取;为 AMD MI300 增加 PR 评论 CI;为分片加载时的进程组初始化设置与加载规模相关的超时机制。
在模型接口方面,为 PreTrainedModel 增加 supports_context_parallel;让 Nemotron-H、Falcon-H1 和 Mamba2 中的 Mamba2 Mixer 接收额外参数;修复 GLM 5.3 Flash 在分块 KDA 中的 NaN 梯度问题;让 ESMFold2 的 distogram_head 保持 FP32;修复 Qwen 3.5 MoE 的装饰器问题;修复 Qwen4Exp 使用 partial 以更便于处理掩码跳过逻辑的问题。
十五、Tokenizer、Pipeline、导出与错误提示持续打磨
在 Tokenizer 与文本处理方面,修复稀疏 TikToken Tokenizer 静默失败问题;修复批量 decode() 路径未遵循 clean_up_tokenization_spaces 设置的问题;修复 transformers chat 中 generate_flags 解析问题。
在 Pipeline 与错误提示方面,文档进一步澄清 Pipeline 中的设备放置方式;当一个 Token 同时被强制生成和禁止生成时,系统会抛出明确错误。
在视频处理方面,当后端不可用且视频处理器类为 None 时,系统会进行保护,避免出现不清晰的异常。
在 ONNX 与导出方面,针对 PyTorch 2.13 中两个 Dynamo 回归问题,跳过受影响模型;并修复部分导出与集成测试不稳定问题。
十六、依赖、Docker、测试与工程体系更新
在依赖与环境适配方面,修复由 PyTorch 2.14 及更高版本触发的包版本读取问题。Docker 环境中,CPU 版 PyTorch 升级限制为不高于 2.14.0,torchcodec 限制为不高于 0.16.0。针对 PyTorch 2.13,修复 Flash Attention 回退路径失败的问题。
在测试与 CI 方面,修复多个模型的集成测试,包括 GLM4 MoE、Nemotron、Kosmos2、CWM、FSMT、Seamless M4T V2、HyperCLOVAX、Cohere Compass、GLM5 Next 等。
此外还包括:
- 修复部分 A10 测试预期。
- 使用专用辅助工具进行 DeepGEMM 与 SonicMoE 测试。
- 将测试夹具指向已托管的内部测试副本。
- 移除已退役的多 GPU 数据并行 forward 测试。
- 完善处理器测试。
- 增加噪声评论检查器。
- 避免输出到 stdout 导致测试失败检查任务异常。
- 修复依赖搜索可能出现的无限循环。
- 修复区间合并函数
_find_disjoint的不变量问题。 - 更新工作流中的 Tailscale Action 版本。
- 更新开发版本。
- 修复预发布工具。
- 压缩代理约定文件,并记录两个模块化陷阱。
- 升级 transformers-mlinter 至 0.1.5,并清理新增发现的问题。
文档方面还包括模型每层配置说明、LiteRT 社区集成页面、MLinter 参考资料、GLM 5.3 文档更新、ALBERT 自动文档指令修复、参数名与函数签名不一致的文档修复、移除文档中的虚假参数、修复代码片段等。
十七、总结:v5.17.0 是一次覆盖模型、推理与工程底座的大规模版本升级
代码地址:github.com/huggingface/transformers
transformers v5.17.0 不只是简单增加了几个新模型,而是在大模型架构、超长上下文、生成性能、缓存稳定性、Kernel 调度、量化推理、视觉位置编码、语音处理、多模态检索和工程测试等方面同步推进。
其中,HYV4 带来了 780B MoE、49B 激活参数、256 路由专家、8 专家激活与 1M Token 上下文窗口;KimiLinear 引入混合线性注意力;VibeVoice、Fun-ASR-Nano、Canary 与 NeuCodec 扩展了语音生成、识别、翻译和音频压缩能力;NeoMME 与 NeoMME-Retriever 则进一步丰富了多语言多模态编码与视觉文档检索能力。
对于正在使用自定义视觉 RoPE、缓存系统、量化模型、KernelConfig、MTP 或编码器解码器生成链路的开发者而言,升级前尤其需要关注视觉 RoPE 集中化迁移、缓存行为变化、生成流程调整及相关接口兼容性。

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐
 7
 0
- 0


 已为社区贡献44条内容

所有评论(0)