从全栈到 AI 应用开发:Workflow、Agent 与 AIGC 到底怎么区分?
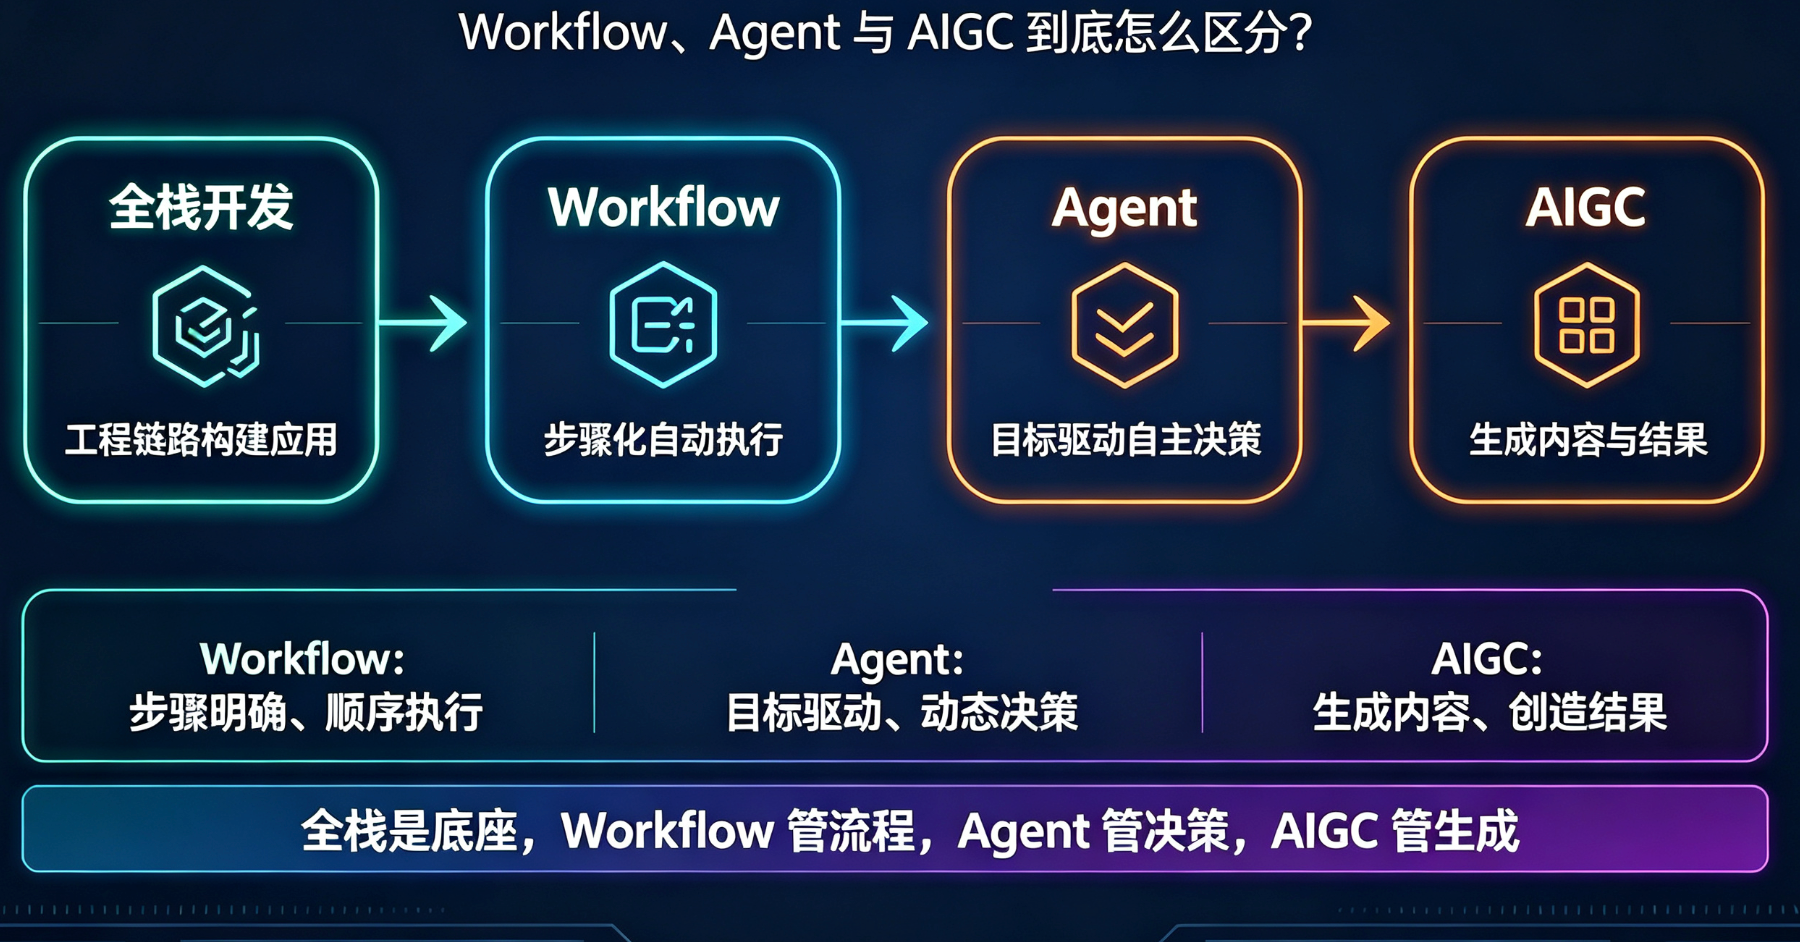
从全栈到 AI 应用开发:Workflow、Agent 与 AIGC 到底怎么区分?
引言
作为一名全栈软件开发工程师,我最近在接触 AI 相关需求时,经常被一堆概念绕晕:AI Agent 工程、AI 应用开发、AIGC、Workflow、RAG……它们之间到底是什么关系?一个业务需求,什么时候该用 Workflow,什么时候该上 Agent?
这篇文章,是我自己梳理的一份笔记,希望能帮到同样从传统开发转向 AI 领域的工程师。
一、先纠正一个常见笔误:不是 AI GC,是 AIGC
很多人会把 AIGC 写成 AI GC,其实正确写法是:
AIGC = AI Generated Content(人工智能生成内容)
它指的是用 AI 来生成内容,比如 ChatGPT 写文章、Midjourney 画图、Copilot 写代码、文生视频等。AIGC 是一种能力或应用形态,不是一个岗位。
二、概念关系:从大到小
先看一张全局图:
也就是说:AIGC 是 AI 应用的一种;Agent 也是 AI 应用的一种;AI 应用开发工程师 是负责做这些应用的岗位;AI Agent 工程师 是更聚焦做 Agent 的岗位。
三、几个岗位的区别
| 岗位 | 做什么 | 关键词 |
|---|---|---|
| AI 应用开发工程师 | 用 LLM 做产品功能 | 调 API、写 Prompt、接业务 |
| AI Agent 工程师 | 做能自主决策、调工具的智能体 | 规划、工具调用、记忆、多步执行 |
| AIGC 工程师 | 做内容生成类应用 | 文生图、文生视频、文案生成 |
| 算法工程师 | 训练/微调模型 | PyTorch、训练、数据、GPU |
从行业招聘趋势来看,AI Agent 方向的岗位需求正在快速增长。以埃森哲的 AI 全栈工程师(AI Agent 方向) 岗位为例,其职责涵盖:AI 产品从 0 到 1 全流程落地、AI Agent 架构设计与开发、RAG 系统构建、大模型工程化落地、高可用后端服务搭建,以及项目部署运维与架构优化。腾讯的 AI 应用开发工程师-Agent 方向 岗位则要求设计并实现 AI Agent 核心系统,包括任务规划、长期记忆、意图识别与多 Agent 协同、RAG 架构优化,以及 Agent 基础设施(Durable Execution、沙箱与安全执行环境)的构建。
这些岗位要求揭示了一个趋势:AI Agent 工程师需要同时具备 AI 能力理解 + 软件架构 + 数据工程 + 后端工程 + 安全 + 测试评估 + DevOps 的复合能力。
四、核心区分:Workflow vs Agent
这是最容易混淆,也最值得讲清楚的一点。
4.1 一句话区分
Workflow:下一步由代码决定。
Agent:下一步由模型决定。
4.2 Workflow 示例
用户说:“我要改地址。”系统流程是写死的:
这里 AI 只负责“识别意图”和“抽取信息”,下一步做什么是代码写死的。
4.3 Agent 示例
用户说:“我要改地址,顺便看看这周能不能提前保养。”系统没有写死流程,而是让 LLM 自己决定:
下一步做什么,是 LLM 自己决定的,不是代码写死的。这才叫 Agent。
4.4 对比表
| 类型 | 谁决定下一步 | 稳定性 | 灵活性 | 调试难度 |
|---|---|---|---|---|
| Workflow | 代码写死 | 高 | 低 | 低 |
| Agent | LLM 自己决定 | 低 | 高 | 高 |
五、Agent 的核心组件
一个生产级 Agent 系统通常包含以下核心组件:
三个最核心的能力定义了这个类别:规划(Planning)、工具使用(Tool Use)、记忆(Memory)。
- 规划:将目标分解为有序的子任务,通过显式推理步骤与动作交错,使每一步观察都能修正剩余计划。
- 工具使用:通过结构化调用格式连接模型到代码解释器、搜索索引、数据库、浏览器和 API。互操作性标准(如 MCP)正在出现,以统一描述这些连接,而非按供应商定制。
- 记忆:将当前会话的工作上下文与跨会话持久化的存储分离,通常通过嵌入相似度检索,并选择性地注入以保持在上下文限制内。
六、RAG:Agent 的“知识接口”
RAG(检索增强生成)是 AI 应用中最常见的技术模式之一。它的核心思想是:不训练模型,而是把外部数据喂给模型。
6.1 RAG 的工作原理
RAG 的基本流程包括三个步骤:
检索:使用用户请求查询外部知识库(向量存储、关键词搜索或 SQL 数据库),目标是获取支持 LLM 响应的数据。
增强:将支持数据与用户请求结合,使用模板和额外格式指令构建提示消息。
生成:将增强后的提示传递给 LLM,生成用户请求的响应。
6.2 RAG 的优势
RAG 通过以下方式增强 LLM:
- 专属知识:包含最初未用于训练 LLM 的专有信息(如备忘录、邮件、文档)来回答特定领域问题。
- 最新信息:从更新的知识库中提供信息给 LLM。
- 引用来源:让 LLM 引用特定来源,使用户可验证响应的事实正确性。
- 数据安全与访问控制:检索步骤可根据用户认证选择性检索个人或专有信息。
6.3 Agentic RAG:从静态到动态
传统的 RAG 是一次性检索,而 Agentic RAG 将检索变成了一个可控的、迭代的行为。
在 Agentic RAG 中,检索不再是静态的预处理步骤,而是嵌入推理循环中的自适应、序列化操作。Agent 在每次迭代中评估当前知识状态,决定是否:用修正后更具体的查询重新检索、调用外部工具(搜索引擎、计算器、SQL 数据库)、从工作记忆中存储/检索、生成部分或最终输出。
例如,对于“解释最近欧盟 AI 法规的影响”这样宽泛的查询,Agent 可能迭代地将其分解为更窄的子查询:2023 年 EU AI Act 的关键条款是什么?哪些部分适用于非欧盟云提供商?执法机制如何在各司法管辖区实施?
这种通过推理进行查询重构的能力,使 Agentic RAG 能够进行多跳检索,每一步都建立在前一步的输出之上。
七、框架怎么选:LangChain vs LlamaIndex
在实际开发中,选择框架是一个绕不开的问题。
7.1 核心理念差异
LlamaIndex 是 RAG-first 的框架,专注于文档解析、索引类型、查询引擎和检索优化。它的强项是:对复杂文档(PDF 表格、多列布局、扫描件)的解析、更多开箱即用的索引类型(向量、摘要、树、知识图谱)、更高级的查询模式(子问题分解、多步检索、查询路由)。
LangChain 是更广泛的 LLM 应用框架,强调编排和 Agent 能力。它的强项是:更广泛的集成生态(向量存储、LLM 客户端、工具)、更灵活的组

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐

 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)