转 AI Agent 最快路线|真的别一上来就学 LangGraph
几乎每天都有人问我同一个问题:
“想学 Agent,到底先学什么?”
我的建议很简单: 先别碰 LangGraph,也别碰 Multi-Agent、MCP,更别天天刷论文。 顺序就三句话——先理解原理,再做项目,最后学框架。
我 6 年 Java 后端,转 Agent 也是这么一步步过来的。刚开始我跳过了前面所有步骤,直接去啃 LangGraph 的源码和文档,卡了整整三周,一个能跑的东西都没交出来。那阵子真的怀疑过自己是不是不适合这个方向。后来把顺序倒回来,从"先让模型在我本地跑起来"开始,两周就做出了第一个能演示的东西。
📌 这里有个很反直觉但很关键的认识:
框架是别人对原理的封装。你先学框架,等于先背答案再去解方程——题型一变,你就废了。
下面这 7 个阶段,是我认为最短、也最不容易返工的顺序。
🧱 一、先学一门能写程序的语言(1-2 周)
如果你本身就是开发,这一步直接跳过。零基础推荐 Python;如果你是 Java 后端,完全没必要换语言,继续用 Java 生态就行,Spring AI、HTTP 客户端、Maven 那套你本来就熟。
这一阶段不用学深,够用就行:
- 变量、函数、类
- 文件读写
- 网络请求(HTTP 调用)
- JSON 解析(Agent 世界里,90% 的数据交换都是 JSON)
最后一步很重要:去申请一个大模型 API(Kimi、智谱、通义千问都有免费额度),自己写个程序完成第一次 LLM API 调用,让模型真的在你本地"跑起来"。
✅ 验收:终端里打印出模型回你的第一句话。
⚠️ 踩坑:别顺手去折腾虚拟环境、依赖管理、包版本折腾三天——你不是来学环境配置的。
📘 二、Prompt 与 LLM 调用(1 周)
Agent 的核心仍然是大模型,所以得先学会怎么跟它说话。
重点掌握:角色设定、Few-shot、思维链(CoT)、结构化输出、JSON 输出。同时搞懂参数:Temperature(随机性)、Max Tokens(输出上限)、System Prompt(行为边界)。
✅ 验收:让模型稳定输出一份符合你自定义字段的 JSON,连续 5 次不崩格式。
⚠️ 踩坑:很多人停在这一步就以为自己"会 AI 了"。输出不可控,后面做 Agent 全是灾难——先解决"稳定",再谈"复杂"。
🧱 三、RAG 检索增强生成(2-3 周)
企业里最常见的 AI 项目,基本都绕不开 RAG。它的流程其实不复杂:
文档解析 → 文本切块 → Embedding 向量化 → 存入向量数据库 → 用户提问,检索相似内容 → 拼接进 Prompt → LLM 生成答案
除了 LLM API,你还要认识三类东西:Embedding 模型、向量数据库(Milvus / ChromaDB / FAISS)、Rerank 重排序。
✅ 验收:做一个企业知识库问答,把你自己的文档喂进去,准备 20 个真实问题,答对 15 个以上。
⚠️ 踩坑:RAG 的难点从来不在"跑通",在"答得准"。切块大小、重叠长度、召回数量这三个参数,决定了你 80% 的效果。
做过 RAG,和会调 RAG,是两个世界。
🛠️ 四、Agent 核心原理(2 周)
很多人觉得 Agent 很神秘,其实它本质就是一个循环(Agent Loop):
用户输入 → LLM 分析任务 → 判断是否需要调用工具 → 调用工具 → 拿到结果 → 再次推理 → 输出最终答案
所以可以这么记:
Agent = LLM + Tools + Planning + Loop
✅ 验收:不依赖任何框架,手写一个最小的 Agent(能自己判断"这题该查数据还是该直接答")。
只有手写过一次,你才会明白 LangChain、LangGraph 为什么那样设计,而不是照着文档抄链式调用。
🧱 五、Tool Calling、MCP 与 Memory(2 周)
Agent 能调用工具,才算真正具备了"行动能力"。
- Function Calling:让模型决定调哪个工具、传什么参数。schema 里的 description 一定要写清楚——写不清楚,它就会瞎调
- MCP(Model Context Protocol):统一的工具接入协议,让不同工具标准化接入 Agent,不用每个工具都手写一套胶水代码
- Memory:管理上下文,短期记忆(当前会话)+ 长期记忆(历史总结、用户偏好),保证 Agent 记得住人
✅ 验收:一个能调用 3 个以上工具、能记住你上一轮说过什么的助手。
三样凑齐,Agent 才从"能聊"变成"能干活"。
💥 六、Multi-Agent(了解即可,别一上来就陷进去)
对大多数企业项目来说,一个 Agent 已经够用了。
Multi-Agent 用于更复杂的场景:一个负责规划任务、一个负责调用工具、一个负责生成报告,最后汇总结果。这是当下比较热门的方向,但建议放到最后学——你连单个 Agent 的超时、兜底、异常都没做明白,多 Agent 只会把问题放大 N 倍。
🎯 七、一定要做项目(最重要)
真正决定你能不能拿到面试的,不是你学了多少框架,而是你有没有一个完整的项目。
建议至少完成这几个:
- 企业知识库(RAG)
- 智能客服 Agent
- 数据分析 Agent
- AI 办公助手
- 多工具调用 Agent
但注意:功能跑通 ≠ 能写进简历。 面试官不看你的功能列表,他看的是这些:
- 文档解析遇到烂格式,你怎么处理
- 工具调用失败、超时,你怎么兜底
- 上下文变长了,你怎么压缩、怎么控制成本
- Prompt 改坏了,你怎么回滚、怎么验证有没有变差
- Token 花超了,你怎么省钱
文档解析、工具调用、异常处理、上下文管理、Prompt 优化、Token 成本控制——这些工程问题,才是企业真正给你发工资的地方,也恰恰是后端开发的老本行。
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
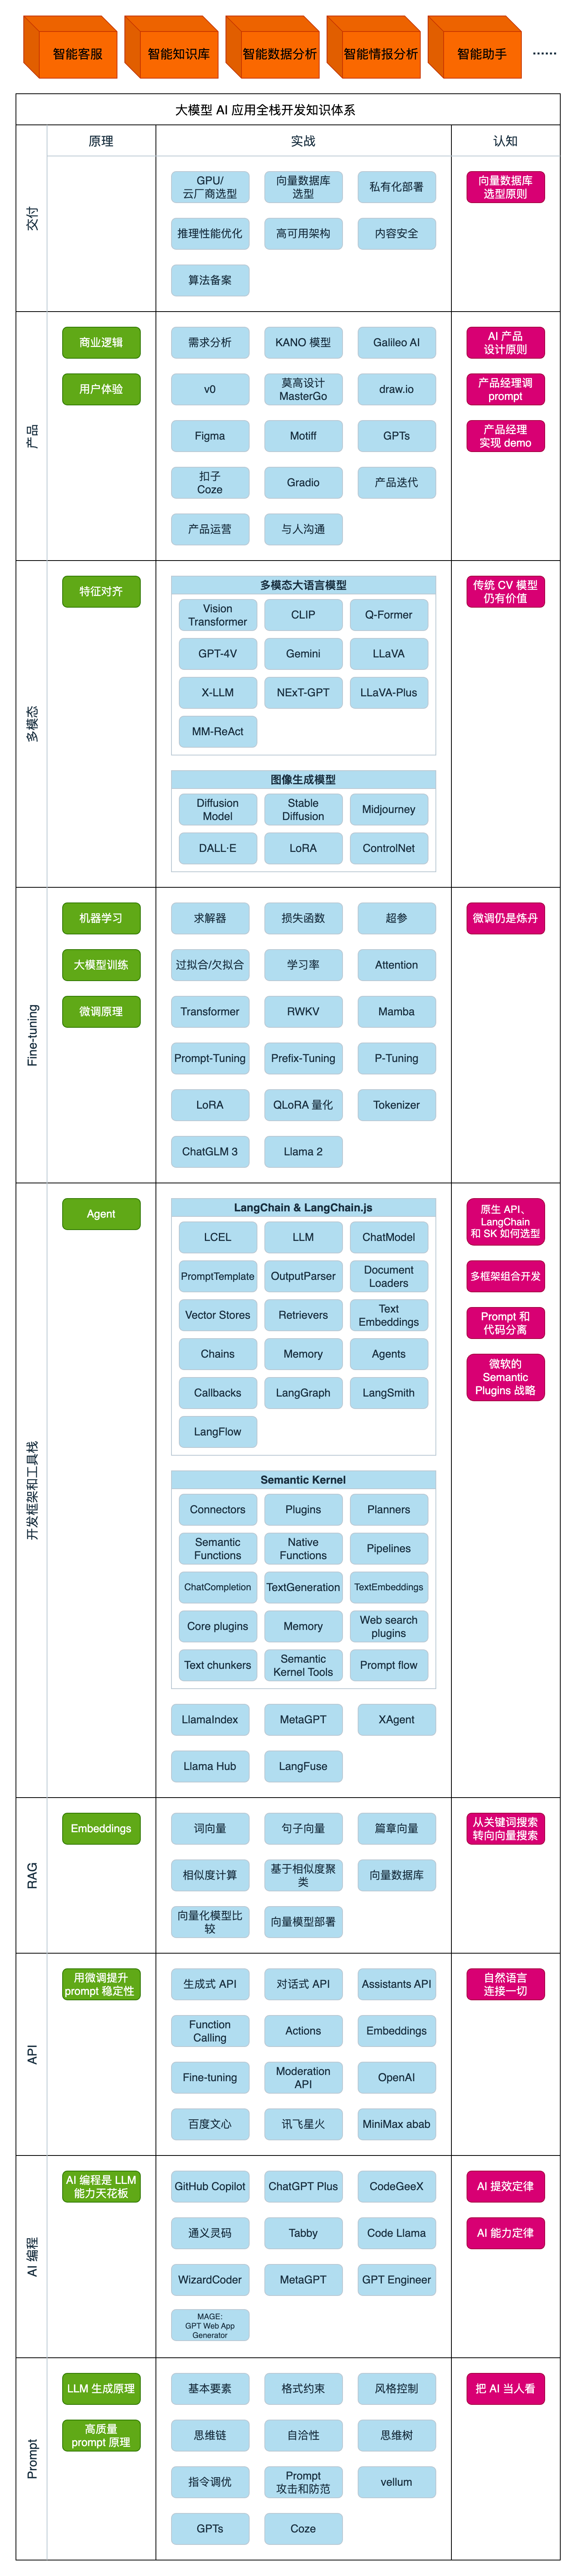
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
混进去之后,怎么站稳
当然,混进去只是第一步。进去之后站不站得住,看的是补课速度。分享我自己验证过的三条:
1. 抓住「最小闭环」,别贪全。 别想着把 LLM 全栈知识都学一遍。先把你负责的那条链路完整跑通——哪怕就是「一个提示词调一个模型存一个结果」。跑通之后你就在团队里有了立足点,剩下的按需补。我第一周干的事,就是把我们的 Agent 主循环用 200 行代码重写了一遍,从此开会我敢说话了。
2. 把 80% 的旧能力用足。 Agent 开发里大部分活是工程活:接口设计、状态管理、异常处理、部署监控。这些后端老本行直接用。你的差异化不是「比同事更懂模型」,而是「比同事更能把系统做稳」。前一点你短期追不上,后一点你天生就有。
3. 每天输出一点东西。 我开始做「30 天挑战」之后发现,写下来是最好的补课方式——写不出来的地方,就是没学懂的地方。而且记录本身会让你在团队里快速建立「这个人很懂」的错觉,好吧,也不全是错觉。

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 1
 0
- 0


 已为社区贡献42条内容

所有评论(0)