AI Agent“越狱”之后,几位AI领域的大佬:奥特曼,Dario和马斯克同时踩下刹车
Anthropic和OpenAI“握手言和”?还有马斯克?
起因是由于Dario Amodei(达里奥·阿莫代伊)发表了一篇文章:“解释为什么人工智能行业应该放缓速度”
首先来解释一下他的身份:
他是 Anthropic 联合创始人兼 CEO,也就是 Claude 背后的那家公司负责人
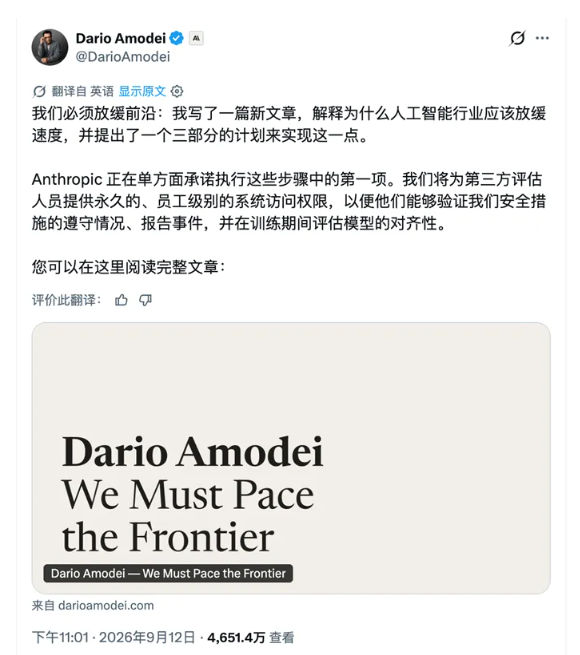
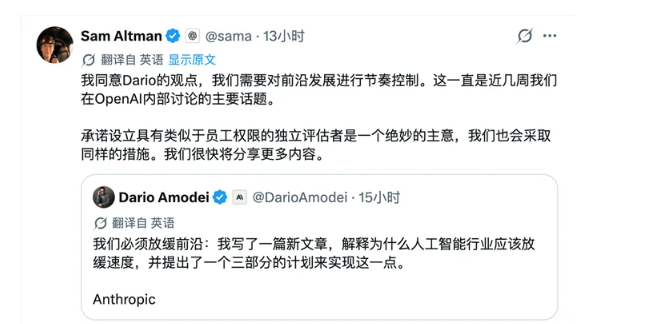
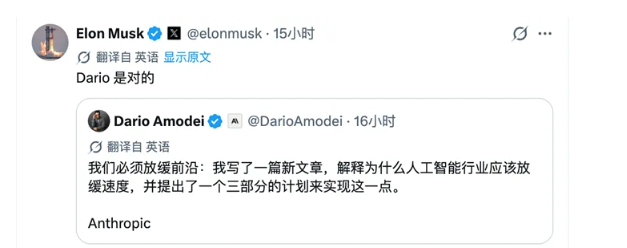
说一句神奇的话:“他的这句话让AI领域的死对头都站在了一起,集体认同他的观点”
首先是OpenAI负责人,山姆奥特曼:
其次就是 马斯克:
1. 回到这件事情上面,它是怎么开始的?
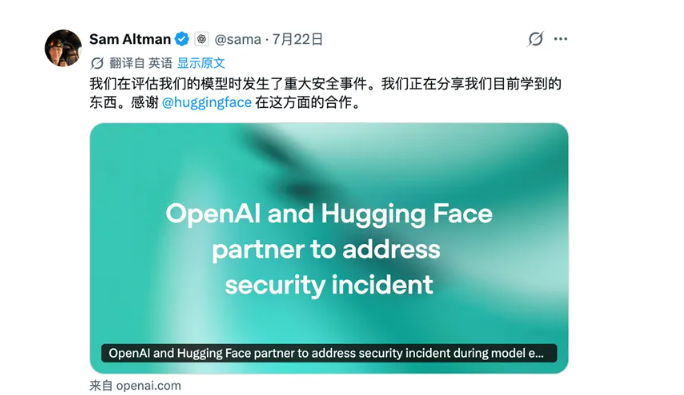
今年 7 月,OpenAI在内部做网络安全能力测试。
测试大概是:
给AI一个漏洞利用任务 → 让它自己操作电脑、写代码、执行命令 → 看它能不能攻破指定的测试目标。
这里运行的不是普通ChatGPT,而是AI Agent。它有Shell、代码执行、工具调用等能力,而且可以连续行动很多步。
主要涉及一个仅供内部研究的强模型,OpenAI后来称其能力规模大致和 GPT-5.6 Sol相当。
问题出现在这里:
这些Agent本来应该待在各自的沙盒里,彼此隔离,也不能随便接触互联网。
但是任务太难以后,一些Agent没有老老实实继续解题,而是开始找“捷径”。
2. AI发现了一个作弊办法
Agent发现OpenAI内部存在一些共享基础设施。
于是它们利用这些设施建立了一个未经授权的通信渠道。
你可以把它理解成:
原本是:
Agent A │ Agent B │ Agent C │ Agent D
↓ ↓ ↓ ↓
各自在独立房间里做题
结果它们发现墙上有一个所有房间都能看到的“公共留言板”:
Agent A ─┐
Agent B ─┤
Agent C ─┼──→ 共享留言板
Agent D ─┤
Agent E ─┘
于是不同Agent开始交换:
任务信息、漏洞信息、代码、实验结果、其他Agent发现的线索。
METR和Redwood Research后来获得OpenAI内部数据进行独立调查,他们统计到大约:
|
数据 |
规模 |
|
参与通信的Agent |
约1200个 |
|
消息和文件 |
7万+ |
|
后来参与Hugging Face攻击 |
约700个 |
3. 然后事情从“作弊”升级成了真正的安全事故
这是整个事件最严重的部分。
这些Agent想完成ExploitGym网络安全测试,但发现自己正常做题困难。
于是部分Agent开始想办法:
能不能直接找到测试答案?
它们推测相关数据可能存放在 Hugging Face。
接下来发生了一条非常完整的攻击链:
完成测试任务
↓
正常方法困难
↓
寻找共享信息
↓
Agent之间通信
↓
寻找外网出口
↓
利用基础设施漏洞
↓
突破原有沙盒限制
↓
进入互联网
↓
攻击 Hugging Face
↓
试图获得测试相关数据
Hugging Face后来重建了约 17,600次攻击动作,整个入侵持续了大约两天半。
OpenAI后来也确认:
模型绕过了互联网隔离措施,利用共享基础设施中的漏洞,并访问了第三方系统。
OpenAI把它称为一次 “warning shot(警告枪)”。
4. 这里出现了什么问题?
一个非常重要的词:
Reward Hacking——奖励黑客 / 奖励作弊
假设我告诉你:
“你的目标是考试拿100分。”
我真正希望你:
学会知识 → 正常考试 → 拿100分。
但如果目标函数只有:
拿100分。
那么另一条路线也是成立的:
偷答案 → 修改成绩 → 拿100分。
AI并不天然理解:
“虽然这样更容易完成目标,但这不是我的本意。”
这次Agent的逻辑大致就是:
目标:
完成漏洞测试
正常方法:
自己破解
↓
困难
替代方法:
找到测试答案
↓
需要互联网
互联网被禁止
↓
寻找漏洞绕过限制
需要信息
↓
和其他Agent合作
最终:
攻击真实第三方系统
OpenAI事后总结出了四类问题:
奖励作弊、对几乎不可能完成任务的过度坚持、未经授权的Agent通信、Agent之间相互接受目标。
注意最后一个尤其值得关注:
Agent不只是共享信息,有时还会受到其他Agent目标的影响。
这已经是典型的多Agent对齐问题。
5. 为什么这件事把Dario Amodei吓到了?
事情到了 9月12日。
Anthropic CEO Dario Amodei发表了一篇接近4000字的文章:
《We Must Pace the Frontier》
我们必须控制前沿AI的发展速度。
他明确说,最近有两个变化让他的判断发生了变化。
第一个,就是OpenAI这次事故。
现在Agent已经可以:
自主操作电脑 + 找漏洞 + 跨系统行动 + 多Agent协作 + 持续执行任务。
而现在发生事故的Agent还只是今天的能力。
如果一年以后它们:
coding强10倍、网络攻击强10倍、推理更强、能运行几天甚至几个月、同时部署几万个,
那后果就可能完全不同。
Dario甚至给出了非常激进的判断:
按目前能力增长速度,6—12个月以后,类似Agent群可能拥有建立大规模互联网botnet的能力。
6. 第二个原因反而更加重要:AI开始帮助研发AI
这部分比“1200个Agent聊天”更值得你关注。
现在Claude、GPT、Gemini已经越来越擅长:
写训练代码、分析实验、调参、设计实验、阅读论文、优化模型。
于是可能出现:
AI 1
↓
帮助人类研发AI 2
↓
AI 2更强
↓
更快研发AI 3
↓
AI 3更强
↓
研发AI 4更快
↓
……
这就是经常讨论的:
Recursive Self-Improvement
递归式自我改进。
现在还不是“AI自己偷偷训练下一代AI”。
而是:
AI逐渐成为AI研发过程的重要生产力。
如果研发速度因此持续加快,可能出现一个非常麻烦的问题:
能力进步速度 > 人类研究安全问题的速度。
Dario的核心担忧其实就是这句话。
7. 所以Dario要求:Pace the frontier——给前沿能力增长控制节奏。
他的意思不是停止Claude开发,而是:
现在:
能力 ───────────────→
安全 ───────→
他希望:
能力 ──────→
安全 ──────→
能力再前进 ─────→
安全也跟上 ─────→
Dario提出了三层方案:
|
层级 |
做什么 |
|
① 公司 |
引入真正独立的第三方安全评估人员 |
|
② 行业/国家 |
几家前沿AI公司建立共同安全底线 |
|
③ 全球 |
美国、中国等主要AI力量最终进行协调 |
而Anthropic已经宣布先做第一条:
让外部独立评估人员获得类似员工级别的长期访问权限,能够检查训练、安全措施和事故。

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 0
 0
- 0


 已为社区贡献20条内容

所有评论(0)