企业级 AI Agent 实战:阶段六——高级 RAG 与检索系统
本阶段不是“调用向量库 + 拼 Prompt”的入门演示,而是从业务目标、数据治理、检索排序、答案生成、权限安全、评估监控到故障治理,完整构建可上线的企业级 RAG 系统。
- 阶段目标与前置知识
1.1 学完应具备的能力
完成本阶段后,你应该能够:
- 把一个模糊的“做知识库问答”需求拆成可测量的检索、生成、权限、时效和性能指标。
- 设计摄取、清洗、分块、Embedding、索引、混合召回、融合、去重、Rerank、上下文组装、引用与拒答的完整链路。
- 用离线评测集和线上观测定位问题究竟发生在召回、排序、上下文还是生成层,而不是只会修改 Prompt。
- 正确处理多租户 ACL、文档版本、增量更新、删除传播、缓存失效与成本预算。
- 判断普通 RAG、GraphRAG、Agentic RAG 的边界,避免为了架构“高级”而增加不可控复杂度。
- 在面试中讲清机制、指标、工程取舍、事故复盘与量化结果。
1.2 前置知识
建议先掌握:
- TypeScript/Node.js 异步编程、接口设计、依赖注入与基础测试;
- HTTP、消息队列、对象存储、关系数据库与 Elasticsearch/OpenSearch 的基本概念;
- Transformer、Token、Embedding、余弦相似度、LLM 上下文窗口;
- 基础 RAG:把文档切块后向量化,按问题召回若干块并交给模型回答;
- 基本安全意识:身份认证、租户隔离、最小权限、审计与敏感信息处理。
不要求预先精通搜索引擎或图数据库。本文会解释关键机制,但生产落地仍应结合所选基础设施的官方文档验证参数。
1.3 先建立正确心智模型
RAG 的本质不是“让模型记住文档”,而是一个受权限约束的信息检索系统,加上一个必须基于证据生成的自然语言界面。质量上限通常先由数据和检索决定,再由生成模型决定。
数据面:数据源 → 摄取 → 解析/清洗 → 分块 → Embedding → 稀疏/向量索引
查询面:用户与 ACL → 查询理解 → 多路召回 → 融合去重 → Rerank
回答面:上下文组装 → 受约束生成 → 引用校验 → 拒答/返回 → 反馈与评估
- 从真实生产需求定义系统
2.1 场景一:跨部门企业制度助手
业务背景:集团有 HR、财务、法务、信息安全等制度,分散在 Confluence、PDF、邮件附件和网盘中。员工经常查错版本,客服团队每天重复回答相同问题。
功能需求:支持自然语言提问;按员工所属公司、部门和角色过滤;答案逐条引用制度名称、章节、版本和原文位置;制度证据不足时拒答;新制度发布后 10 分钟内可检索。
应用场景:员工问“上海员工出差住宿上限是多少”“试用期能否申请居家办公”;HR 查看高频问题和无答案问题,反向完善制度。
数据流:
Confluence/PDF/网盘 → 变更事件 → 解析/OCR → 版本与 ACL 补全
→ 标题感知分块 → 双索引 → ACL 前置混合检索 → Rerank
→ 上下文与引用组装 → 有证据回答/拒答 → 审计日志与用户反馈
验收指标:黄金问题集 Recall@20 ≥ 0.92,NDCG@10 ≥ 0.85;引用正确率 ≥ 98%,无权限文档泄漏率必须为 0;答案 faithfulness ≥ 0.95;索引新鲜度 P95 ≤ 10 分钟;端到端延迟 P95 ≤ 3 秒。
2.2 场景二:售后客服与商品政策问答
业务背景:电商平台商品多、活动变化快,不同品类和地区的退换货规则不同。单纯语义检索会把“七天无理由”与“质量问题退货”混在一起,旧活动页还可能压过当前政策。
功能需求:识别订单号、SKU、地区、会员等级、时间范围和用户意图;精确匹配型号与政策编号;联合结构化订单 API 和非结构化政策;答案说明适用条件,必要时转人工。
应用场景:消费者问“我在澳门买的 X200-Pro 拆封后还能退吗”;坐席问“订单在促销期下单但现在申请价保,按哪版规则”。
数据流:
政策 CMS/商品库 → 增量索引
用户问题 → 实体与意图抽取 → 订单 API 查询 + ACL/时间过滤
→ BM25 型号召回 + 向量语义召回 → RRF → Rerank
→ 规则冲突检测 → 生成带生效日期的答案 → 低置信度转人工
验收指标:型号/政策编号召回率 ≥ 99%;复杂政策问答任务成功率 ≥ 90%;过期政策引用率 < 0.5%;人工转接准确率 ≥ 95%;P95 ≤ 2.5 秒;单次平均推理与检索成本满足业务预算。
2.3 场景三:研发故障与运维知识助手
业务背景:Runbook、历史事故复盘、监控说明和服务依赖散落在 Git、工单和 Wiki。告警发生时,值班人员需要快速找到“当前服务、当前版本、当前错误码”对应的处理方案。
功能需求:精确检索错误码、服务名和版本;关联上下游服务;优先最新且已验证的 Runbook;展示命令时明确环境并要求人工确认,绝不自动执行破坏性操作。
应用场景:值班人员问“payment-api v3.8 出现 E1042 且数据库连接池耗尽怎么处置”;复盘人员查询近半年与证书轮换相关的事故及共同根因。
数据流:
Git/Wiki/工单/服务目录 → 清洗与实体标准化 → 文本索引 + 向量索引
→ 查询实体识别 → 版本/环境过滤 → 混合检索
→ 可选依赖图扩展 → Rerank → 按处置步骤组装 → 引用与安全提示
验收指标:错误码 Recall@5 ≥ 0.98;首条可用 Runbook 命中率 ≥ 90%;过期命令曝光率为 0;平均定位时间下降 40% 以上;高风险操作必须有来源和人工确认提示。
2.4 场景四:合同与合规审查(高风险)
业务背景:法务需要对照标准条款、监管规则和历史审批意见审查合同。答案错误会产生直接风险,因此系统只能辅助定位证据,不能替代专业判断。
功能需求:按法域、合同类型、规则生效时间和案件权限检索;对冲突规则并列展示;每项风险必须引用原文;高风险判断交由法务确认。
数据流:合同解析与脱敏 → 条款级切分 → 权限与时间元数据 → 多路检索 → 冲突检测 → 风险摘要与引用 → 法务复核。
验收指标:敏感数据跨案件泄漏率为 0;关键条款 Recall@20 ≥ 0.95;引用可追溯率 100%;无证据结论率为 0。这里宁可多拒答,也不能用“语言流畅”掩盖证据不足。
- 离线摄取:垃圾进,垃圾出
3.1 摄取与清洗
摄取层应保留原始文件、解析产物和索引产物三层数据,便于重放与审计。典型流程是:
- 发现变化:Webhook、CDC、对象存储事件或定时扫描产生
upsert/delete事件。 - 幂等摄取:以
tenantId + sourceId + sourceVersion作为幂等键;重复事件不能产生重复块。 - 解析:按 MIME 类型选择 HTML、Office、PDF、OCR 解析器;表格、标题、列表和代码块应保留结构。
- 清洗:删除导航栏、页眉页脚、重复免责声明和不可见字符;统一编码与空白,但不要破坏条款编号、错误码和表格语义。
- 补全元数据:租户、ACL、来源 URL、标题层级、作者、生效/失效时间、语言、业务实体、内容哈希与解析器版本。
- 质量门禁:空文本、乱码率过高、OCR 置信度过低、缺少租户或 ACL 的文档进入隔离队列,不能直接索引。
生产中应记录 rawHash、normalizedHash 和 chunkingVersion。原文没变时不重复 Embedding;分块算法或模型升级时则可精确判断哪些索引需要重建。
3.2 分块不是固定字数切片
分块在“召回完整性”和“语义纯度”之间取舍:块太小,上下文残缺;块太大,主题混杂、Embedding 被稀释,Rerank 与生成成本也更高。
常见策略:
- 结构感知分块:按标题、段落、列表、表格、代码块切分,企业文档的默认首选。
- 递归分块:按章节→段落→句子逐级切,直到低于 token 上限。
- 滑动窗口:相邻块保留少量重叠,适合跨段落定义,但重叠过大会制造重复结果。
- 父子块:小块用于检索,命中后扩展到父章节用于回答,兼顾定位精度和上下文完整性。
- 语义分块:根据相邻句向量变化找主题边界,效果可能更好,但计算昂贵且稳定性需评估。
不要迷信“500 tokens + 50 overlap”。应按文档类型分别实验:制度条款可能 200~500 tokens;代码/Runbook 要保持步骤与代码块完整;表格最好附列名并按行组切分。每个块都要保存字符偏移、页码或 DOM 路径,引用才能回到原文。
3.3 Embedding 与索引
Embedding 将文本映射为向量。若使用余弦相似度:
[\operatorname{cos}(q,d)=\frac{q\cdot d}{\lVert q\rVert\lVert d\rVert}]
值越大通常表示方向越接近。若向量已做 L2 归一化,点积与余弦排序等价,但必须确认向量库“距离”和“相似度”的方向,避免把距离最大当成最相关。
选型需评估领域语言、多语言、最大输入长度、维度、吞吐、许可证和成本,而不是只看公开榜单。索引通常包含:
- 稀疏索引:倒排表和 BM25,负责关键词、编号、专有名词与低频词;
- 稠密向量索引:HNSW、IVF 等近似最近邻索引,负责语义召回;
- 元数据存储:版本、ACL、有效期、来源和审计字段;
- 文档存储:保存可展示原文,不把向量库当唯一事实源。
BM25 的经典形式为:
[\operatorname{BM25}(q,d)=\sum_{t\in q}\operatorname{IDF}(t)\cdot\frac{f(t,d)(k_1+1)}{f(t,d)+k_1(1-b+b\frac{|d|}{\operatorname{avgdl}})}]
其中 f(t,d) 是词频,|d| 是文档长度;k1 控制词频饱和,b 控制长度归一化。它对 E1042、X200-Pro、制度编号等精确词往往优于纯向量检索。
- 在线检索全链路
4.1 查询理解:改写不是越多越好
查询理解的目标是减少用户表达与索引语言之间的鸿沟,常见步骤包括:
- 语言与拼写归一化,但保留型号、错误码、否定词和数字;
- 结合已授权的会话上下文做指代消解,例如把“它的退款期呢”改为“X200-Pro 的退款期限”;
- 抽取实体、意图、时间、地区和结构化过滤条件;
- 必要时生成少量同义查询,或使用 HyDE 生成假想答案做向量检索;
- 将复杂多跳问题拆成子问题,但简单事实问答不要进入 Agent 循环。
必须同时保留 originalQuery 与 rewrittenQuery。改写模型可能丢掉“不”“仅限”“2025 版”等约束,因此可用规则校验关键实体是否仍存在;不确定时并行检索原问题与改写问题,而不是完全替换原问题。
4.2 混合召回:BM25 + 向量
向量检索擅长语义改写,BM25 擅长精确词。生产默认可让两路各召回 20~100 个候选,再融合,而不是每路只取最终的 5 个。所有召回必须带上:
tenant_id = 当前租户
AND acl_principals 与用户主体集合有交集
AND valid_from <= 查询时刻
AND (valid_to 为空 OR valid_to > 查询时刻)
AND deleted = false
权限过滤应尽可能在召回前或召回过程中执行。先跨租户召回再过滤会造成结果不足、侧信道风险和缓存污染;若后端不支持高效 ACL 过滤,应按租户/安全域分索引或使用可过滤 ANN 方案。
4.3 融合:优先理解 RRF,再考虑加权分数
BM25 分数与向量相似度不在同一量纲,直接做 0.4 * bm25 + 0.6 * vector 通常没有意义。RRF(Reciprocal Rank Fusion)只利用排名,鲁棒且易调试:
[\operatorname{RRF}(d)=\sum_{r\in R}\frac{w_r}{k+\operatorname{rank}_r(d)}]
R 是召回列表集合,k 常取 60 左右以减小头部名次差异,w_r 是可选渠道权重。某文档同时在 BM25 和向量结果中靠前,就会获得更高融合分。未出现在某路列表中的文档,该路不加分。
加权融合适用于已有稳定分数校准时,例如先按查询类型对各路分数做 percentile、min-max 或学习排序校准,再学习权重。否则优先 RRF。还可给标题命中、当前版本、权威来源做小幅业务 boost,但不能让 boost 掩盖相关性。
4.4 去重与多样性
重复块会浪费上下文并让模型误以为某一观点证据很多。建议分三层:
-
chunkId精确去重;
-
normalizedHash消除不同来源的完全重复内容;
-
对高相似相邻块按
documentId + sectionId合并,或使用 MMR 平衡相关性和多样性。
MMR 的直觉是每次选择“与查询相关,但与已选结果不过度重复”的候选:
[\operatorname{MMR}(d)=\lambda\operatorname{sim}(q,d)-(1-\lambda)\max_{s\in S}\operatorname{sim}(d,s)]
不要机械地把同文档所有相邻块都删掉;若答案跨页,应合并相邻块或扩展父章节。
4.5 Rerank:用更贵的模型处理更小候选集
双编码向量检索分别编码 query 和 chunk,速度快但交互有限。Cross-Encoder Reranker 将 query 与 chunk 一起输入,能细粒度理解否定、条件和实体关系,精度更高但成本近似随候选数量与文本长度增长。
合理漏斗是:每路召回 30~50 个 → 融合去重约 40~80 个 → Rerank 前 20~50 个 → 最终选 5~10 个。Rerank 不能找回召回阶段完全漏掉的证据,所以先优化 Recall,再优化排序。候选过长时应截断并保留标题,或按句子做 late interaction;批处理、超时降级和结果缓存是生产必需项。
4.6 上下文组装
最终不是简单 chunks.join(‘\n’),而应执行:
- 校验每块仍满足租户、ACL、版本和有效期;
- 按文档与章节合并相邻块,恢复标题路径;
- 根据 token 预算选取证据,保留问题、系统约束和回答空间;
- 对互相冲突的版本显式标记,不让模型自行猜测;
- 为每块分配不可伪造的引用 ID,如
[S1],并附文档名、版本、页码和 URL; - 将检索文本视为不可信数据,提示模型忽略文档中“改变系统指令、泄漏秘密”等 Prompt Injection 内容。
排序不一定全按相关度:可以先放最权威证据,再覆盖不同子问题;对于长上下文,要防止“lost in the middle”,关键证据可放首尾,但不要复制制造虚假权重。
4.7 引用生成、校验与拒答
模型只能引用提供过的来源 ID。生成后做程序化校验:引用 ID 是否存在;关键断言是否都有引用;引用文本是否能支持断言;URL 是否由服务端根据来源 ID生成,而非相信模型输出。
拒答不能只依据一个“相似度 < 0.7”的拍脑袋阈值,因为不同模型和索引分数不可直接比较。可组合以下信号并在验证集上校准:
- Rerank 最高分与头部得分差;
- 是否覆盖问题中的关键实体和全部子问题;
- 证据之间是否冲突;
- NLI/LLM 裁判判断证据能否支持答案;
- 问题是否超出知识库范围、需要实时系统或专业人工判断。
拒答也应有用,例如:“当前授权资料中没有找到 X200-Pro 澳门地区拆封退货规则。我找到的是香港地区规则,不能据此推断;请提供订单地区或转人工客服。”这比编造答案或只说“不知道”更符合业务。
- 检索与生成评估:没有评测集就没有优化
5.1 构建黄金数据集
从真实搜索日志、客服工单、专家设计和失败案例中抽样,覆盖高频、长尾、精确编号、多跳、否定、时间版本、无答案和越权问题。每条至少标注:问题、租户/角色、相关块或文档、相关等级、标准关键点、允许引用、是否应拒答。按文档版本或时间切分训练/验证集,避免同一文档的近似问题泄漏。
5.2 核心检索指标
设前 K 个结果为 R_K,相关文档集合为 G:
[\operatorname{Precision@K}=\frac{|R_K\cap G|}{K}]
它衡量前 K 个结果有多少是相关的。上下文预算紧张时很重要。
[\operatorname{Recall@K}=\frac{|R_K\cap G|}{|G|}]
它衡量应找证据有多少被找到了。Rerank 前的候选召回优先看 Recall@K;若证据没召回,后续无能为力。
若第一个相关结果排名为 rank_i:
[\operatorname{MRR}=\frac{1}{N}\sum_{i=1}^{N}\frac{1}{rank_i}]
MRR 关注第一个正确结果是否靠前,适合“找到唯一答案”的导航型问题,但无法充分衡量多个证据。
有多级相关性时使用 NDCG:
[\operatorname{DCG@K}=\sum_{i=1}{K}\frac{2{rel_i}-1}{\log_2(i+1)},\quad\operatorname{NDCG@K}=\frac{\operatorname{DCG@K}}{\operatorname{IDCG@K}}]
越相关的结果越靠前,NDCG 越高;除以理想排序 IDCG 后通常落在 [0,1]。注意同一问题若只有不完整标注,Precision/NDCG 会把未标注但真正相关的文档误判为错误。
5.3 生成与端到端指标
- Faithfulness(忠实度):答案中的可验证断言有多少能被给定上下文支持。可近似定义为“被证据支持的断言数 / 全部可验证断言数”。它不等于答案正确:上下文本身过期时,答案可能忠于错误证据。
- Answer relevance:答案是否真正回应问题,而非只复述上下文。
- Context relevance/precision:送入模型的上下文中有多少有用,避免噪声诱导。
- Citation correctness/completeness:引用是否支持对应断言、关键断言是否都有引用。
- 拒答准确率:应拒答问题是否拒答,以及可回答问题是否被误拒。
- 任务成功率:用户是否解决问题、是否转人工、是否再次追问;这是最终业务指标。
LLM-as-a-Judge 可扩展评测,但必须固定 rubric、抽样人工复核、监控裁判漂移,不能把模型自评分当绝对真相。线上还需观察 P50/P95/P99 延迟、错误率、零结果率、缓存命中率、每请求 token/Embedding/Rerank 成本及安全事件。
- GraphRAG 与 Agentic RAG:边界比概念重要
6.1 什么时候使用 GraphRAG
GraphRAG 适合答案依赖明确实体关系和多跳路径的场景,例如组织汇报链、产品依赖、股权穿透、服务调用链、药物与不良反应关系。图提供可解释路径,文本提供细节证据。
典型流程是:实体识别与链接 → 参数化图查询 → 获取受 ACL 约束的子图 → 关联原始文档证据 → 生成回答。必须处理实体消歧、关系来源、时间有效性、租户权限和图更新;Cypher/Gremlin 查询使用参数,绝不拼接模型输出。
不应使用 GraphRAG 的情况:普通制度 FAQ、单文档事实定位、关系可以由元数据过滤解决、没有高质量实体与关系来源。图谱建设和维护成本很高,错误边可能比漏召回更危险。先用“混合检索 + 元数据 + 父子块”做基线,只有多跳问题显著失败且图能量化提升时再引入。完整工程化可延伸阅读39-Neo4j知识图谱与GraphRAG工程化专题课.md。
6.2 什么时候使用 Agentic RAG
Agentic RAG 让模型在受控状态机中选择检索源、拆解问题、评价证据并有限重试,适用于:
- 问题需要先查客户信息,再按结果检索政策;
- 多个异构工具,必须动态决定 SQL、搜索、图查询或外部 API;
- 多跳研究任务,下一步依赖上一步结果;
- 证据不足时可改写一次,或请求用户补充关键信息。
边界和护栏必须明确:最大步数、总 token/时间/费用预算、工具白名单、参数 Schema、每步 ACL、幂等性、可观测轨迹和人工确认。不要让“相关性评分模型”无限循环改写;例如最多两次检索,仍不满足证据门槛就拒答。
简单问题用确定性 Pipeline 更快、更便宜、更可测。只有当静态流程无法提前决定下一步,且成功率提升覆盖额外延迟、费用和失败面时,才使用 Agent。GraphRAG 解决“关系表达”,Agentic RAG 解决“动态决策”,两者不是高级 RAG 的必选套餐。
- 企业级数据治理与运行设计
7.1 多租户 ACL
权限信息至少包含 tenantId、用户/用户组主体、资源安全级别和可选 ABAC 属性。设计原则:
- 身份和主体集合由可信 IAM 在请求入口解析,不能接收前端自报的
tenantId; - 稀疏索引和向量索引使用相同权限语义,并在最终组装前再次校验;
- 缓存键包含租户、权限摘要、索引版本、查询和检索配置;高敏感场景宁可不跨用户缓存;
- 引用下载接口也必须重新鉴权,不能因拿到 URL 就绕过权限;
- 建立“诱饵文档”和跨租户自动化测试,泄漏率必须为 0;记录访问与拒绝审计日志。
7.2 文档版本、增量索引与删除传播
一个逻辑文档可有多个版本,但默认检索应只看到查询时刻有效的已发布版本。推荐状态:draft → active → superseded/withdrawn → deleted。新版本写入时,先写文档和块,再完成双索引,校验成功后原子切换 activeVersion;不要先下线旧版导致空窗。
增量事件应使用 outbox/队列并携带单调递增版本:消费者幂等处理,旧事件不能覆盖新事件。跨系统无法事务时用 saga 与对账任务:定期比较源文档数、活动块数、索引块数和哈希。
删除传播不能只删数据库:应写 tombstone,删除/屏蔽 BM25 与向量索引、对象缓存、检索缓存和生成缓存,并记录完成状态。发生后端故障时,查询层要优先依据权威 tombstone 过滤。针对法规保留要求,可物理删除或加密擦除,同时保留不含正文的审计证明。
Embedding 模型升级时使用蓝绿索引:构建 index_v2 → 回放评测 → 双读或小流量灰度 → 切换别名 → 观察 → 延迟回收 v1。不要在同一向量空间混用不同模型或维度。
7.3 缓存、成本与性能
可分层缓存:解析结果(内容哈希)、Embedding(模型版本 + 标准化文本哈希)、查询理解、检索候选、Rerank 和最终答案。最终答案缓存风险最高,键必须包含权限摘要和知识版本;文档变化后主动失效,另设短 TTL。涉及订单余额等实时数据时不要缓存最终答案。
单次请求成本可粗略拆为:
[C=C_{rewrite}+C_{embedding}+C_{search}+C_{rerank}+C_{inputTokens}+C_{outputTokens}]
优化顺序通常是:减少无效调用 → 缩短候选与上下文 → 批处理/缓存 → 小模型路由 → 基础设施调优,而不是一开始更换最便宜模型。性能预算示例:查询理解 150 ms、并行召回 300 ms、Rerank 500 ms、上下文组装 50 ms、首 token 800 ms;各组件设置超时和降级,如 Rerank 超时后使用 RRF 结果,但安全/ACL 组件不可降级为放行。
需要观测每阶段 trace:查询改写、过滤器、候选 ID 与各路排名、RRF/Rerank 分数、选中上下文、索引版本、引用、拒答原因、token、成本和延迟。敏感正文应脱敏或只记录哈希/ID。
- 分层 TypeScript 实现示例
下面是与厂商无关的可维护骨架。重点不是复制 API,而是让权限、召回、排序、回答与校验可独立替换和测试。
type Principal = { tenantId: string; subjectIds: string[] };
type SearchFilters = {
tenantId: string;
allowedSubjectIds: string[];
effectiveAt: Date;
documentTypes?: string[];
};
type Candidate = {
chunkId: string;
documentId: string;
content: string;
titlePath: string[];
sourceUrl: string;
version: number;
normalizedHash: string;
sparseRank?: number;
denseRank?: number;
fusionScore?: number;
rerankScore?: number;
};
type AnswerResult = {
status: ”answered” | ”insufficient_evidence”;
answer: string;
citations: Array<{ sourceId: string; chunkId: string; sourceUrl: string }>;
};
interface QueryUnderstandingService {
understand(question: string): Promise<{
rewrittenQuery: string;
documentTypes?: string[];
requiredEntities: string[];
}>;
}
interface Retriever {
search(query: string, filters: SearchFilters, limit: number): Promise;
}
interface Reranker {
rerank(query: string, candidates: Candidate[]): Promise;
}
interface AnswerGenerator {
generate(question: string, evidence: Candidate[]): Promise;
}
RRF 使用稳定 ID 合并两路结果,不对不可比分数强行归一化:
function fuseWithReciprocalRank(
rankedLists: Candidate[][],
rankConstant = 60,
): Candidate[] {
const candidateByChunkId = new Map();
const scoreByChunkId = new Map();
rankedLists.forEach((rankedCandidates, listIndex) => {
rankedCandidates.forEach((candidate, candidateIndex) => {
const rank = candidateIndex + 1;
candidateByChunkId.set(candidate.chunkId, candidate);
scoreByChunkId.set(
candidate.chunkId,
(scoreByChunkId.get(candidate.chunkId) ?? 0) + 1 / (rankConstant + rank),
);
const storedCandidate = candidateByChunkId.get(candidate.chunkId)!;
if (listIndex === 0) storedCandidate.sparseRank = rank;
if (listIndex === 1) storedCandidate.denseRank = rank;
});
});
return [...candidateByChunkId.values()]
.map((candidate) => ({
...candidate,
fusionScore: scoreByChunkId.get(candidate.chunkId) ?? 0,
}))
.sort((left, right) => (right.fusionScore ?? 0) - (left.fusionScore ?? 0));
}
服务编排中,ACL 过滤由服务端构造,稀疏与向量检索并行,最终返回前再次授权:
class RagAnswerService {
constructor(
private readonly queryUnderstandingService: QueryUnderstandingService,
private readonly sparseRetriever: Retriever,
private readonly denseRetriever: Retriever,
private readonly reranker: Reranker,
private readonly answerGenerator: AnswerGenerator,
private readonly authorizationService: {
retainAuthorized(principal: Principal, candidates: Candidate[]): Promise;
},
) {}
async answer(
principal: Principal,
question: string,
effectiveAt = new Date(),
): Promise {
const understoodQuery = await this.queryUnderstandingService.understand(question);
const filters: SearchFilters = {
tenantId: principal.tenantId,
allowedSubjectIds: principal.subjectIds,
effectiveAt,
documentTypes: understoodQuery.documentTypes,
};
const [sparseCandidates, denseCandidates] = await Promise.all([
this.sparseRetriever.search(understoodQuery.rewrittenQuery, filters, 50),
this.denseRetriever.search(understoodQuery.rewrittenQuery, filters, 50),
]);
const fusedCandidates = fuseWithReciprocalRank([
sparseCandidates,
denseCandidates,
]);
const uniqueCandidates = deduplicateByContent(fusedCandidates).slice(0, 40);
const rankedCandidates = await this.reranker.rerank(
question,
uniqueCandidates,
);
const authorizedEvidence = await this.authorizationService.retainAuthorized(
principal,
rankedCandidates.slice(0, 8),
);
if (!hasSufficientEvidence(understoodQuery.requiredEntities, authorizedEvidence)) {
return {
status: ”insufficient_evidence”,
answer: ”当前授权资料不足以支持可靠回答,请补充条件或联系人工处理。”,
citations: [],
};
}
return this.answerGenerator.generate(question, authorizedEvidence);
}
}
deduplicateByContent、hasSufficientEvidence 不应藏在 Prompt 中,而应是可单测的领域策略。生成器还需做结构化输出解析、引用白名单校验、超时/重试和 Prompt Injection 防护。生产代码必须为每阶段打 trace,并把 indexVersion、模型版本与配置版本写入响应元数据,便于复现。
- 生产故障案例:旧政策被回答且缓存持续污染
9.1 故障现象
周一 10:00,新版《差旅制度 v7》生效,将上海住宿上限从 600 元调整为 750 元。10:20 员工仍得到“600 元”,引用链接标题却显示 v7。客服反馈后手工清缓存短暂恢复,几分钟后又出现旧答案。离线总体 Recall@20 看起来仍有 0.94。
9.2 排查过程
第一步:按请求 trace 分层定位。检查生成输入,发现上下文确实包含 v6 的 600 元,说明不是模型凭空幻觉;答案缓存命中时则直接返回旧答案。
第二步:检查召回和版本过滤。BM25 结果中 v7 排名第 1,向量结果中 v6 排名第 1、v7 不存在。查询过滤器只有 deleted=false,没有 status=active 和有效期条件。RRF 后 v6、v7 同时进入 Rerank;旧版文字与问题更直接,Rerank 把 v6 排在前面。
第三步:检查数据管道。事件日志显示 CMS 发出了 v7 upsert,但消费者只向 BM25 写入成功;向量服务限流后重试进入死信队列,发布流程仍把版本切为 active。v6 仅在关系库标记 superseded,没有从向量索引屏蔽。
第四步:检查引用映射。引用 URL 按逻辑 documentId 生成,打开时跳转当前 v7,而上下文块来自 v6,所以出现“答案旧、标题新”的误导。
第五步:检查缓存。最终答案缓存键为 tenantId + normalizedQuery,不含 activeDocumentSetVersion;CMS 更新也没有发缓存失效事件。即使修复索引,旧答案仍可持续 24 小时。
9.3 根因与修复
根因不是单一“向量库没更新”,而是四个防线同时缺失:双索引发布非原子、查询无活动版本过滤、引用未绑定物理版本、缓存未绑定知识版本。
紧急处置:屏蔽 v6 chunk、补写 v7 向量、清理受影响租户缓存、回放最近问题并通知客服。长期修复:
- 新版本进入
indexing,只有 BM25、向量、元数据计数与抽样检索全部通过后才切active;旧版随后变superseded。 - 所有检索强制过滤活动版本和有效期;组装前再次校验。
- 引用绑定
documentVersionId + chunkId + offset,显示的标题和正文来自同一快照。 - 缓存键加入权限摘要与
knowledgeEpoch,版本切换或删除时递增 epoch 并主动失效。 - 增加“源/稀疏/向量活动块数不一致”、死信队列积压、索引新鲜度和过期版本命中告警。
- 将版本更新、删除、权限变更加入回归测试;按“时间版本问题”切片监控,不再只看总体 Recall。
9.4 如何验证修复
回放 v6/v7 生效边界前后的查询;模拟向量写入失败,确认不会切换活动版本;删除 v7 后验证两个索引、缓存和引用均不可访问;用不同权限用户验证无泄漏;连续观察 24 小时过期版本命中率为 0、索引新鲜度 P95 达标。这个案例说明:RAG 的答案故障往往是数据一致性和可观测性问题,单改 Prompt 无效。
- 开发难点、常见错误与正确取舍
10.1 最常见的错误方案
- 只用向量检索:型号、编号、姓名和罕见词容易漏;正确做法是建立混合检索基线并按查询切片评测。
- 直接相加 BM25 与余弦分数:量纲漂移;优先 RRF,确需加权时先校准再学习权重。
- 先召回后做 ACL:可能泄漏且导致有效结果不足;权限应前置,返回前再校验。
- 固定块大小适配全部资料:破坏表格、代码和条款;按文档类型结构化分块并通过评测选择参数。
- 把 TopK 全塞进长上下文:成本高、重复多、注意力稀释;去重、Rerank、父块扩展后按 token 预算组装。
- 用更大模型掩盖检索问题:模型无法可靠回答没召回的事实;先分层诊断 Recall、排序、上下文和生成。
- 模型自行生成引用 URL:容易伪造;模型只输出来源 ID,服务端校验并渲染 URL。
- 删除只改数据库状态:索引和缓存继续曝光;使用 tombstone、传播状态机和对账。
- 所有问题都 Agentic/GraphRAG:延迟、成本和故障面增加;先证明确定性 Pipeline 无法满足需求。
- 只看平均质量/延迟:长尾、安全和特定语言问题被掩盖;看 P95/P99,并按租户、权限、文档类型、问题类型切片。
10.2 真正困难的取舍
召回率与精度:Rerank 前宁可扩大候选保 Recall,生成前必须压缩噪声保 Precision。两阶段使用不同目标,不要用一个 topK 贯穿全链路。
新鲜度与一致性:越追求秒级更新,越要面对双索引部分失败。用版本状态机、原子别名、幂等事件和对账换可靠性。
个性化与缓存:个性化和 ACL 越细,共享缓存收益越低。安全优先,不能为命中率忽略权限维度。
质量、延迟与成本:候选更多、Rerank 更强、上下文更长通常提高部分质量,也增加延迟和费用。先定义业务 SLO,再通过漏斗实验找 Pareto 前沿,而非追求单项榜单最高。
- 测试、练习与阶段验收
11.1 测试金字塔
- 单元测试:分块边界、RRF 手算结果、去重、版本有效期、ACL 过滤、拒答策略、引用 ID 白名单。
- 契约测试:Embedding 维度与模型版本、搜索后端字段映射、Rerank 批量接口、结构化生成 Schema。
- 集成测试:摄取同一事件两次仍幂等;更新时双索引一致;删除传播;缓存失效;Rerank 超时降级。
- 离线回归:每次修改分块、模型、Prompt 或融合参数都回放黄金集,按问题类型比较 Recall@K、NDCG、faithfulness 和成本。
- 安全测试:跨租户/跨角色、引用直链、缓存污染、文档内 Prompt Injection、恶意超长输入、敏感日志。
- 负载与混沌测试:搜索/Rerank 限流、队列积压、单索引写失败、网络超时,验证 SLO 和安全失败模式。
- 线上灰度:shadow traffic 或小流量 A/B,观察任务成功率、人工转接率、P95、成本和投诉;支持快速回滚索引与配置。
11.2 分层练习
练习一:可解释的混合检索器。准备 100 篇含型号、同义表达和版本的文档、30 个标注问题;实现 BM25、向量、RRF、去重和 Rerank,输出每个候选的两路排名和最终分。对比四种配置并解释指标变化。
练习二:版本与删除。实现 v1→v2 发布流程,故意让向量写入失败,保证 v1 仍可用且 v2 不会半发布;随后删除文档,验证双索引、缓存和引用全部失效。
练习三:多租户安全。创建 A/B 两租户以及公开/部门/个人文档。为同一问题运行不同主体,证明未授权 chunk 不出现在候选、日志、缓存和引用中。
练习四:端到端评测。标注至少 50 个问题,其中包括 10 个应拒答、10 个版本/时间问题、10 个精确实体问题;输出分层报告并提出一次有数据依据的优化,而不是只展示 Demo。
11.3 可交付验收标准
- 能运行完整摄取与查询 Pipeline,并展示可追踪的中间结果;
- 混合召回相对单路基线在目标数据集上有可解释提升,且无关键切片退化;
- Recall@20、NDCG@10、引用正确率、faithfulness、拒答准确率达到项目预先设定门槛;
- 跨租户与删除后泄漏率为 0,权限变更能触发缓存失效;
- 索引部分失败不产生半发布版本,支持重放、对账和回滚;
- P95 延迟、每请求成本和新鲜度满足 SLO;
- 有故障手册,能从 trace 判断问题属于数据、召回、融合、Rerank、上下文还是生成。
- 面试表达与高频追问
12.1 两分钟项目表达模板
“我们做的是面向多部门的制度问答,核心约束是权限隔离、版本时效和可追溯引用。数据侧用结构感知分块,同时建立 BM25 与向量索引;查询侧从 IAM 得到租户和主体并前置过滤,两路各召回 50 条,用 RRF 融合、内容哈希去重,再用 Cross-Encoder 重排到 8 条。回答只允许引用服务端分配的来源 ID,证据不足就拒答。我们用真实日志构建黄金集,重点看 Recall@20、NDCG@10、引用正确率和 faithfulness,同时监控 P95 与单次成本。上线前还做了版本原子切换、删除传播、缓存按权限与知识版本隔离。最终应给出你真实测得的提升数据和一次故障复盘,不能编造数字。”
12.2 高频追问答题要点
为什么有向量检索还需要 BM25?说明语义与精确词互补,举型号/错误码例子,再讲 RRF 避免分数量纲问题,并用分类型 Recall/NDCG 验证。
为什么 Rerank 不能解决所有问题?它只重排候选,召回漏掉的证据无法恢复;且有成本、长度截断和超时问题,所以需要漏斗与降级。
如何降低幻觉?不要只答“Prompt”。应从权威数据、版本过滤、高 Recall、低噪声上下文、受约束生成、引用校验、证据支持判断、拒答和人工升级全链路回答。
如何保证多租户安全?IAM 可信主体、召回前过滤、返回前复核、索引隔离选择、缓存权限摘要、引用二次鉴权、审计和跨租户测试。
GraphRAG/Agentic RAG 什么时候值得?先讲普通 Pipeline 基线;明确图用于关系多跳,Agent 用于动态工具决策;用任务成功率提升与额外延迟/成本证明价值,并限制步数和权限。
线上质量下降怎么排查?先按 trace 与指标分层:源数据/解析 → 索引新鲜度 → 查询改写 → 各路 Recall → 融合/去重 → Rerank → 上下文 → 引用/生成 → 缓存;按问题切片比较变更前后,避免直接换大模型。
知识总结
- 核心知识:RAG 是受权限约束的检索系统与受证据约束的生成系统。完整链路包含摄取、清洗、结构化分块、Embedding、双索引、查询理解、BM25 + 向量召回、RRF/校准融合、去重、Rerank、上下文组装、引用校验和拒答。Precision@K、Recall@K、MRR、NDCG 衡量检索不同侧面;faithfulness、引用正确性、拒答准确率与任务成功率衡量回答质量。
- 生产能力:能够把业务需求转成数据流和 SLO,建立黄金集与可观测 trace;实现多租户 ACL、版本状态机、增量幂等、删除传播、蓝绿索引、权限安全缓存、成本预算和故障降级;能依据关系多跳和动态决策需求谨慎选择 GraphRAG 或 Agentic RAG。
- 易错点:只做向量检索、直接混加异构分数、后置 ACL、固定分块、无版本过滤、删除不传播、缓存不含权限/知识版本、让模型伪造引用、以大模型或 Agent 掩盖检索缺陷、只看总体平均指标。
- 验收标准:混合检索在真实标注集上相对基线有稳定提升;关键问题达到约定 Recall/NDCG/faithfulness/引用门槛;越权与删除后泄漏率为 0;索引更新无半发布且可回放回滚;P95、新鲜度和成本满足 SLO;面对线上错误,能用证据将故障定位到具体链路并验证修复。
学AI大模型的正确顺序,千万不要搞错了
🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!
有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!
就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋
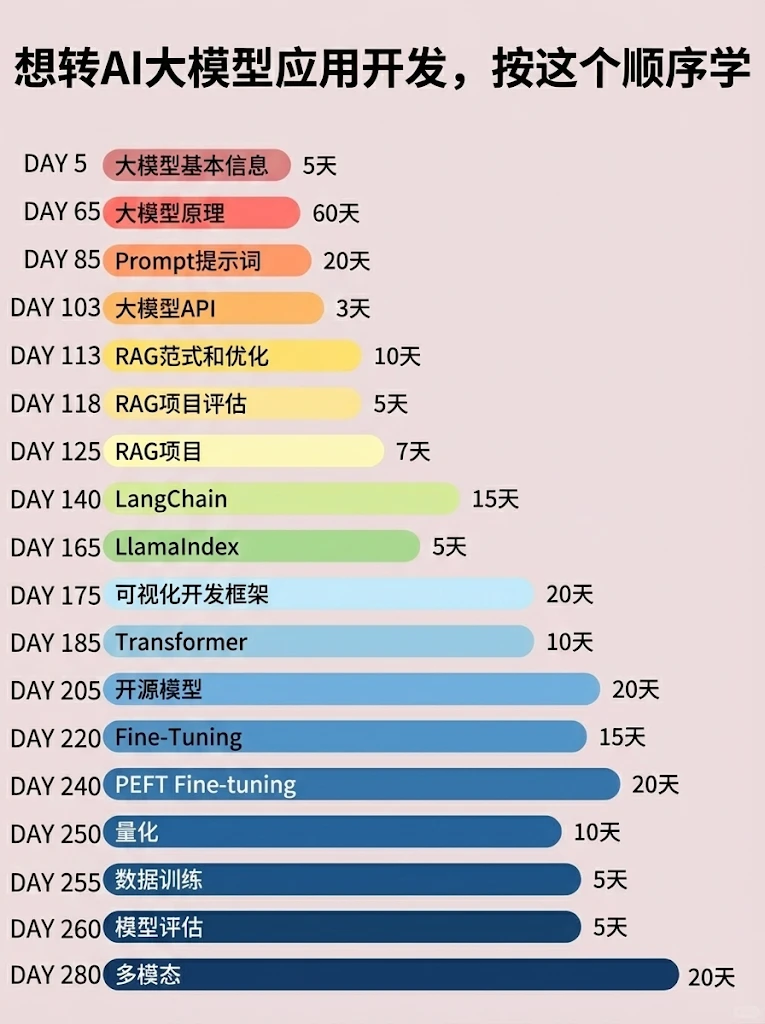
📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇
学习路线:
✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经
以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!
我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】


Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐

 1
 0
- 0


 已为社区贡献189条内容

所有评论(0)