AI Agent:循环系统+工具+记忆+框架,提升效率的秘密武器!
AI Agent是一个调用工具的循环系统,包含Loop、Tools、Memory、Harness四个核心构成。Loop通过ReAct模式实现循环执行,Tools赋予Agent行动能力,Memory作为知识库存储上下文信息,Harness则负责底层基础设施和系统运行。理解这些构成,有助于提升工作效率和开发相关产品。
Agent到底是什么?
你可能已经有个大概的了解:是会帮人们干活的大模型。
你也可能已经听到一些像(能自主规划执行的)Workflow、数字员工这样的名词概念。
以上这些说法虽然不能说错,但还不够。
我们希望知道,Agent到底是怎么工作的?有哪些构成?
如果要更好使用Agent,能帮助我们提升工作效率、开发工具产品,就需要进一步深入了解Agent底层的工作机制和核心模块。
这篇文章,尝试回答这些问题。
首先,我们给Agent下一个更为具体简练的定义。
AI Agent是一个能够调用工具的循环系统。
这个定义抓住了Agent两个更为本质的特征,反映Agent在工作时真正发生了什么:
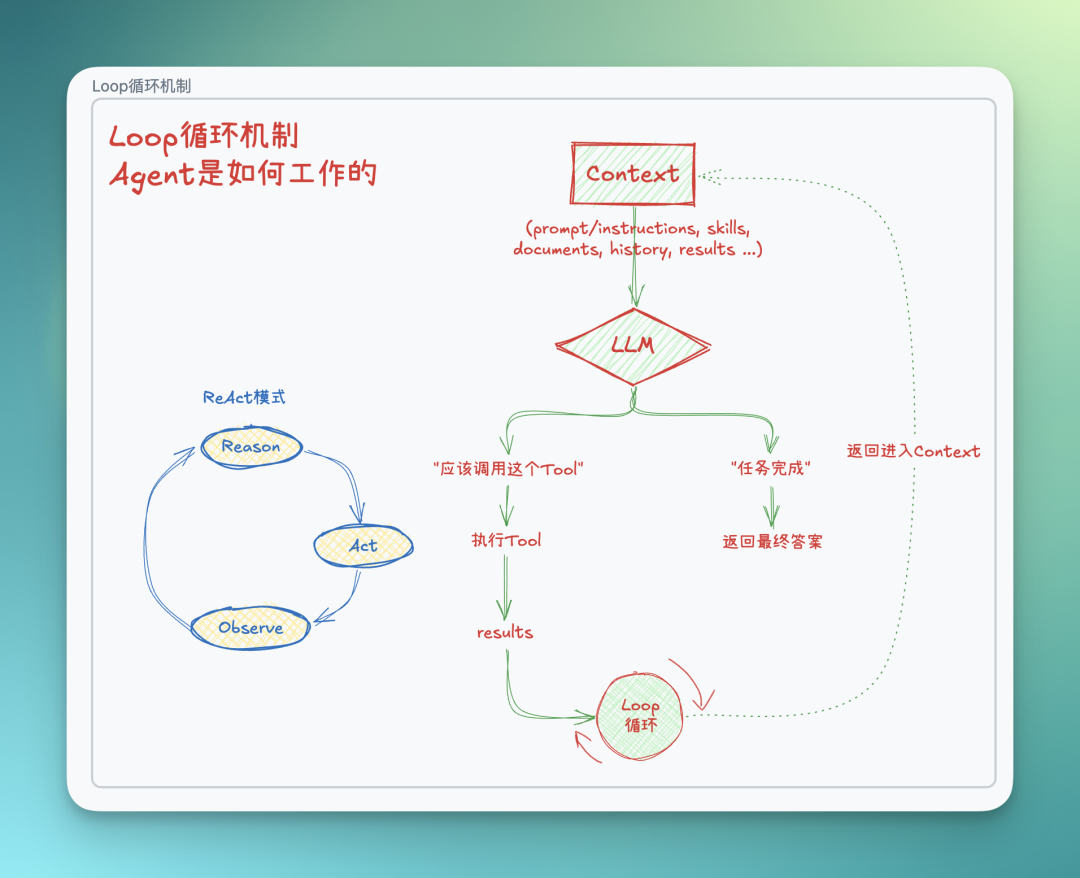
1、Agent的核心工作机制:Loop循环。(ReAct模式,下面展开)
2、Agent的行动能力:对Tools工具的调用。
同时,Agent系统在调用Tools执行Loop循环过程中,强依赖两个条件:
1、Agent将Context(需要让LLM读取的上下午信息)输入到LLM,而每次的执行结果需要被保留并作为Context输入到后续的执行中(否则每次循环执行都是全新的过程,也就谈不上智能了)。
2、整个循环过程、对工具的调用,需要有一个指挥官统一协调管理来处理各种问题情况。
因而就有了另外两个模块:Memory、Harness。
总的来说,Agent由这四个核心构成:Loop、Tools、Memory、Harness。
下面分别拆解。
1、Loop:Agent的工作机制
你输入一段文本,LLM收到后给你回答一段文本:这是LLM做的事情,具体应用形态是大家已经熟悉的Chatbot(聊天机器人)。
Agent跟LLM的主要区别在于:
你输入文本给到LLM,LLM输出的也是文本。
而同样的事情,Agent输出的是一次具体的行动(执行Tool);这次行动执行的结果要继续输入给LLM,LLM据此判断下一步要做什么(Loop循环)。
Agent在工作时,实际上底层机制就是在执行Loop循环。
这个Loop循环,遵循ReAct模式,包括以下步骤:
1.Reason(思考推理):LLM调研规划,先调研规划,明确要做什么、怎么做;2.Act(行动):模型调用Tools开始干活;3.Observe(观察/评估):观察阶段结果是否已经满足预期;4.再到下一轮的Reason…如是往复:前面的行动结果作为输入给到LLM,开始下一轮的循环,直到Agent判断认为已经得出目标答案。
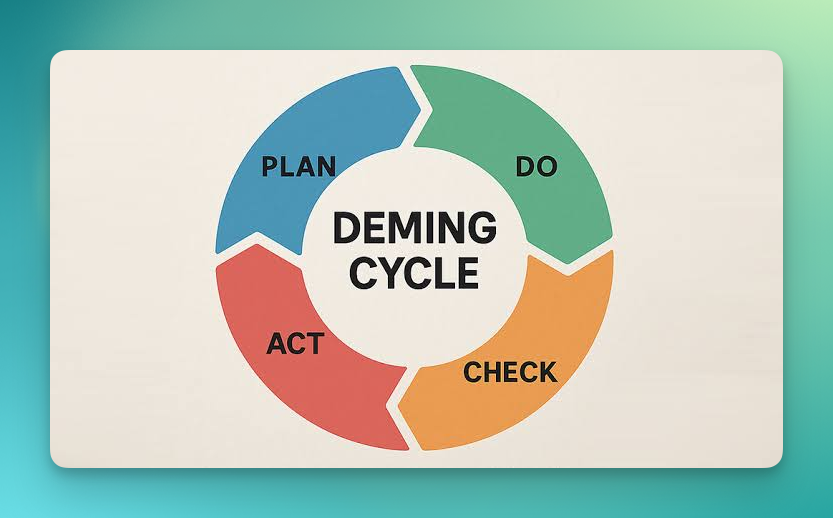
你会发现,这个基于ReAct的Loop循环,其实是对人类实际工作过程的模拟抽象,很类似于PDCA戴明环。
所有Agent(不管是coding、研究、做PPT、客服…)可能表面上看似不同(流程、工具、需要的上下文),但工作时底层机制是一样的,都是这个Loop循环。
由此也可以发现,LLM本身仍然是在思考、推理并生成文本,只是Agent里的LLM生成的文本可以是“运行某个Tool”这样的执行指令。
Agent系统有能力去调取这个Tool并按照指令执行,从而完成了一次行动并交付交付。
那么Tool在这里又是什么呢?
2、Tools:Agent的手脚(执行能力)
Tool就是可供LLM调用的一项具体能力,比如:
•打开浏览器;•搜索网页;•发送邮件;•查询数据库;•翻译一段文字;•操控电脑;•检查代码;•查询日历;•……
就像给大脑提供了手脚,有了手脚,也就有了行动能力。
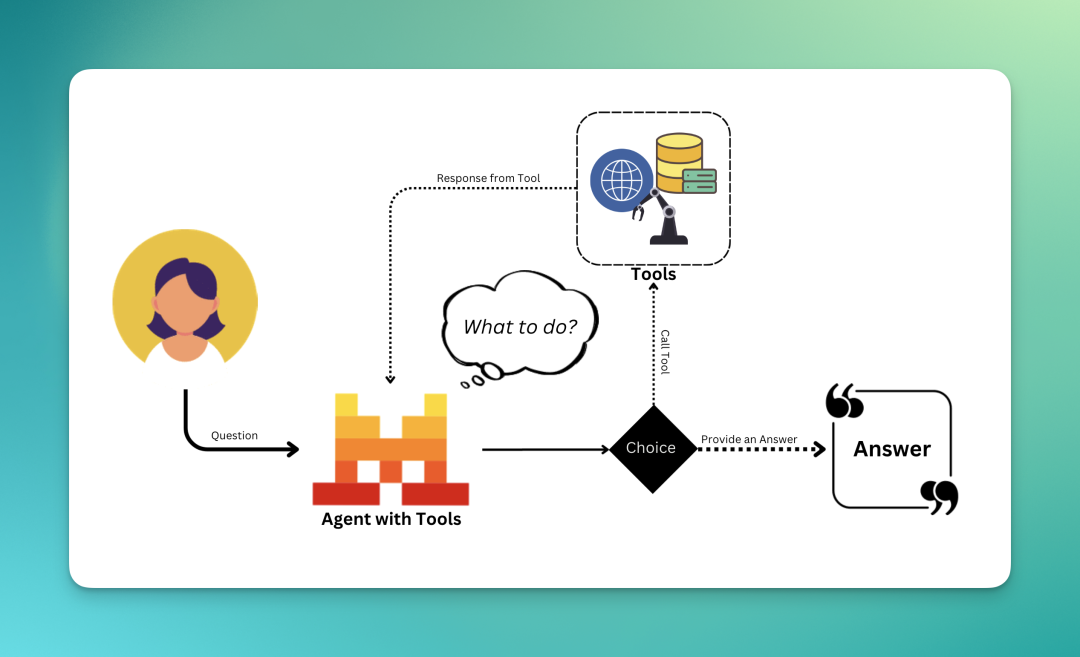
为了让LLM知道这个能力是干什么的,Tools需要有较为明确的名称和描述说明(description)。
可以想象一个操作系统界面,上面布满了按钮,每点一个按钮就会执行一个特定的动作。LLM跟你一样,需要给他输入这些按钮的名称和功能说明,才能判断什么时候该按哪个按钮(即什么时候该用哪些Tools)。
所以关于Tools使用的一个最佳实践,就是在设计时尽量明确一个tool就对应一项简单具体的任务,简单到description里一两句话就能描述清楚是做什么的。
这样LLM的判断会更准确,Agent的执行效果就会越好。
作为Agent系统的核心组成部分,一些常用的公共的Tools,很多系统已经预置了。
你也可以在需要时接入外部的Tools,从而扩展系统的能力。
此时就需要用到MCP。这是连接Agent系统和外部系统的一种开放标准协议(进一步了解可以参考之前的文章:%%补充过往文章%%),添加所需要外部工具提供方的MCP服务器即可实现调用。
除了Agent系统预置和外部服务,你也可以自己制作Tools,从而满足比较个性化的需求。
再强调一遍,Tool是能力,不是知识(来自于下面要讲的Memory)。做一件事情,离不开知识和能力,知识(knowledge)作为Context并被保存在Memory里供Agent读取参考,而能力(Tools)让Agent可以行动,对现实物理世界做出改变。
所以要分清楚:Tool负责“能做什么、做了什么”,并不承担“怎么做”。
后者属于我们下面要讲的Memory即知识库的范畴。
3、Memory:知识库
为什么需要有Memory?
Agent的核心机制Loop是在上一次循环结束后要将执行结果和历史所有资料作为Context输入给下一次循环。
要做到这一点,就必须要有一个地方把每次的Context存下来能被读取到。
这就是Memory做的事情,听上去很像计算机里的缓存(RAM)。
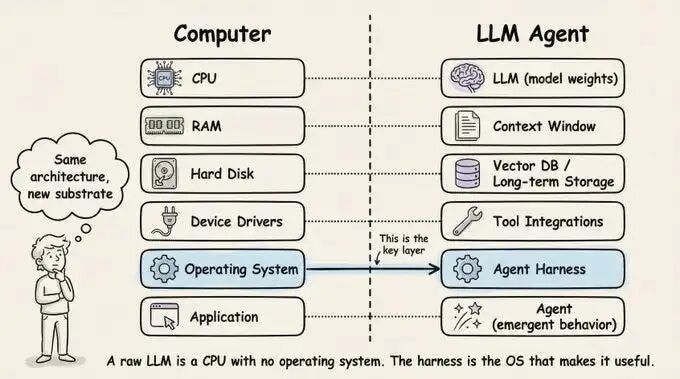
那么Memory具体是怎么实现的呢?
之前采用的技术方案主要是向量数据库(vector databases),简单来说,就是将Context的所有文件信息做embedding(转换为向量特征),每次运行时找到特征值最相似(similarity)的数据块(chunks),从而判断哪些数据更应该被读取作为输入。
如今的技术方案,更多采用的是知识库,即许多markdown文件的文件夹集合。
Agent通过搜索关键词,读取每个文件的标题、描述信息,以及文件夹的树状结构,会更加容易和准确判断出哪些内容对于下一次循环以及整个任务目标更相关。这个过程,很像是一个新员工开始工作时要读取公司或部门的Wiki文档(或者老员工留下来的交接文案文档)。
如果你有使用过Agent,可能会注意到在推理和执行过程中,会出现“搜索××关键词→找到n份文档→读取文档内容→已了解背景信息”这样的提示,就是Agent在使用Memory知识库。
这里的关键在于文件本身和文件夹的结构化,相比于原有的向量数据库的相似度更有优势。
更妙的是,知识库里的文件除了可被读取,还能改写。这意味着Context里的内容可以随时更新迭代,比如上一个任务的执行结果日志、报错记录,比如新增了一个数据资料文档等等。
所以,当前Memory的工作方式实质上就是每次执行过程中对Context里文件读取和增删改写。
这也是为什么我们会感知到Agent越来越懂自己,能单次多轮对话、读取历史对话,能根据最新情况做调整。
而作为告诉Agent怎么做的操作手册,Skill使用markdown文件夹(可随时迭代修改)的交互范式被越来越多的大模型厂商接受。
4、Harness:底层基础设施
Agent作为一个系统并不是魔法,本身需要对执行中的各种基础细节问题做处理解决,就我们前面讲到的3个核心组件来说:
•谁来发起并控制Loop循环?•谁执行Tools?•谁管理Context,尤其是Context可能过长的时候?
此外,还有:
•执行出错了如何处理?•调用工具的权限管控?(你也不希望Agent随时能控制你电脑上的任何软硬件和文件吧)•什么时候该让用户提供更多信息,确认是否往下进行?
一个稳定的优秀的Agent系统,就要对上面这些问题处理得更好,用户的使用体验也就更好。
这也就是Agent的第四个核心组件(而且当前似乎已成为最重要):Harness要做的事情。
Harness好像还没有一个共识的翻译,一般可以叫做框架、编排、运行环境… 可将其看做是Agent的底层架构、基础设施、操作系统。
像Codex、Claude Code、Workbuddy、TraeWork/TraeCode、Deepseek Harness这类Agent产品,从工程角度看,主要构成就是Harness,就像Windows、MacOS、Linux操作系统那样。
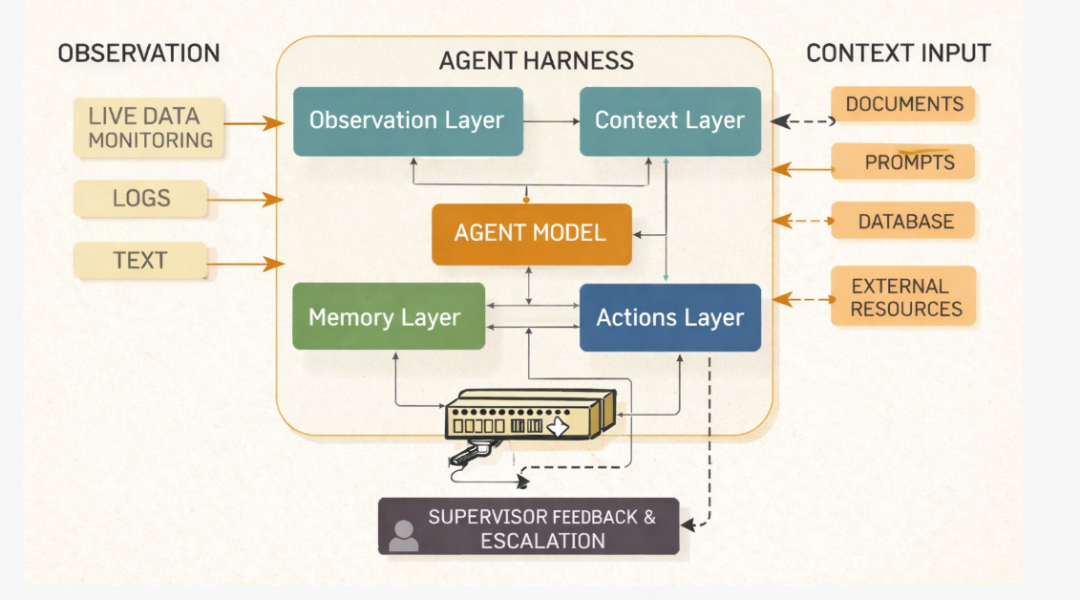
在这些有着更友好易用界面的Agent产品出现之前,要搭建一个Agent,里面的功能组件大概要靠用户自己用Python手搓出来,要写一大堆的条件循环函数来实现:Loop及其调度、任务何时应中止或重试、在Context不同文件之间注意力的跳转…
如今这些繁琐的编排调度工作,都被Harness包含并接管了。
把上面这4个组件合在一起,就能看到一个AI Agent到底是什么:
•Loop机制:调用模型、工具,执行、重复,直到任务完成;•Tools执行:让大模型具有行动能力,包括对读取文件、使用Shell程序,以及连接MCP服务器;•Memory知识库:实现循环过程中对Context上下文管理,判断并决定哪些内容应该放在context window中(尤其是对话交互越来越长的情况下)。•Harness:整个系统的基础设施,运行出问题如何解决,权限验证登(哪些操作Agent可以自行把控,而哪些需要请求人类用户允许。太过频繁你会觉得事儿多,一路干到底不问你你也会心虚。可将管理中授权是个艺术,可见老板也不好当)。
在广义的产品意义上,Harness基本等同于我们在用的Agent,因为Harness把前面说的机制和组件都纳入到架构中,并成为Agent的运行环境和基础设施。
乃至最终我们可以这样简要总结:
Agent = LLM + Harness。
最后
我在一线科技企业深耕十二载,见证过太多因技术更迭而跃迁的案例。那些率先拥抱 AI 的同事,早已在效率与薪资上形成代际优势,我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在大模型的学习中的很多困惑。
我整理出这套 AI 大模型突围资料包:
- ✅AI大模型学习路线图
- ✅Agent行业报告
- ✅100集大模型视频教程
- ✅大模型书籍PDF
- ✅DeepSeek教程
- ✅AI产品经理入门资料
完整的大模型学习和面试资料已经上传带到CSDN的官方了,有需要的朋友可以扫描下方二维码免费领取【保证100%免费】👇👇
为什么说现在普通人就业/升职加薪的首选是AI大模型?
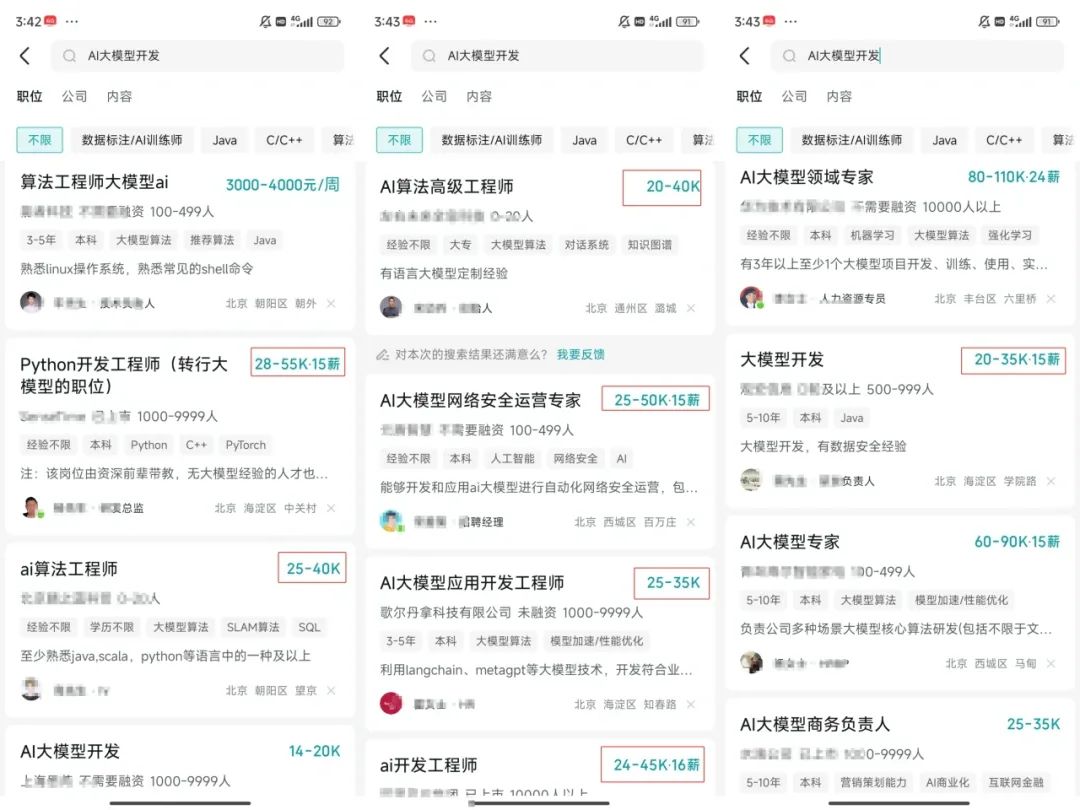
人工智能技术的爆发式增长,正以不可逆转之势重塑就业市场版图。从DeepSeek等国产大模型引发的科技圈热议,到全国两会关于AI产业发展的政策聚焦,再到招聘会上排起的长队,AI的热度已从技术领域渗透到就业市场的每一个角落。
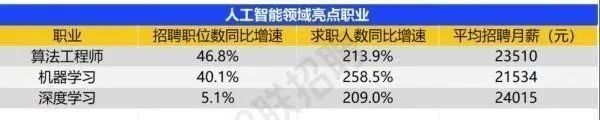
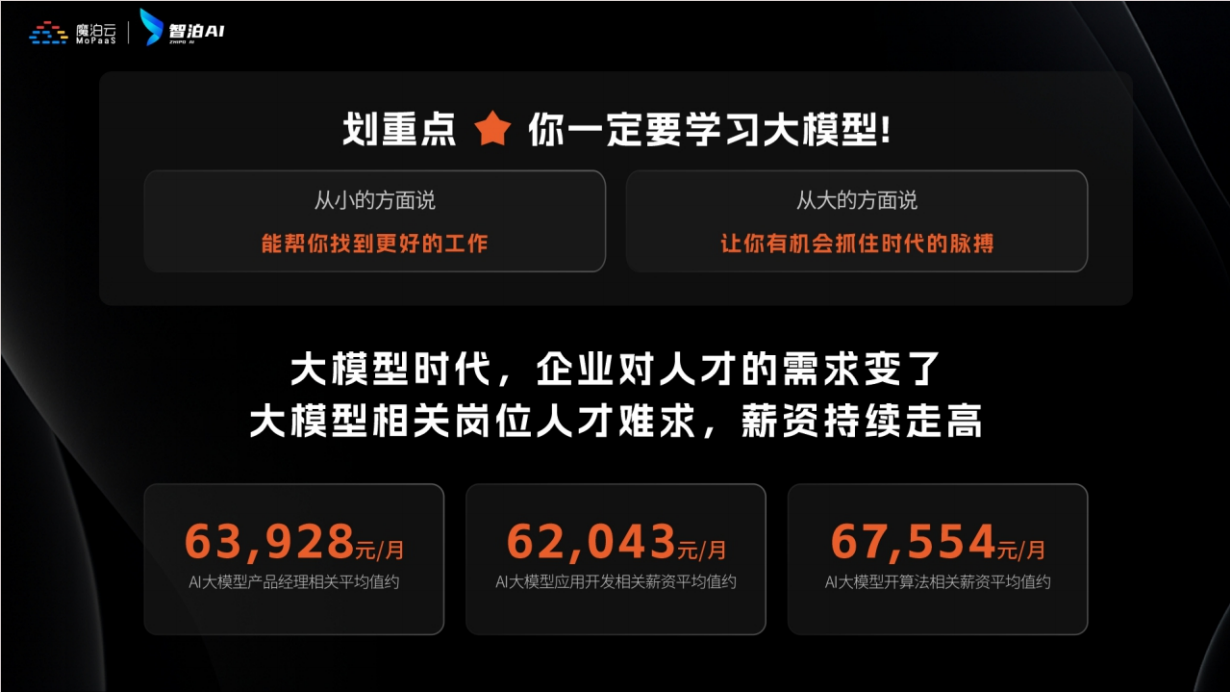
智联招聘的最新数据给出了最直观的印证:2025年2月,AI领域求职人数同比增幅突破200% ,远超其他行业平均水平;整个人工智能行业的求职增速达到33.4%,位居各行业榜首,其中人工智能工程师岗位的求职热度更是飙升69.6%。
AI产业的快速扩张,也让人才供需矛盾愈发突出。麦肯锡报告明确预测,到2030年中国AI专业人才需求将达600万人,人才缺口可能高达400万人,这一缺口不仅存在于核心技术领域,更蔓延至产业应用的各个环节。
资料包有什么?
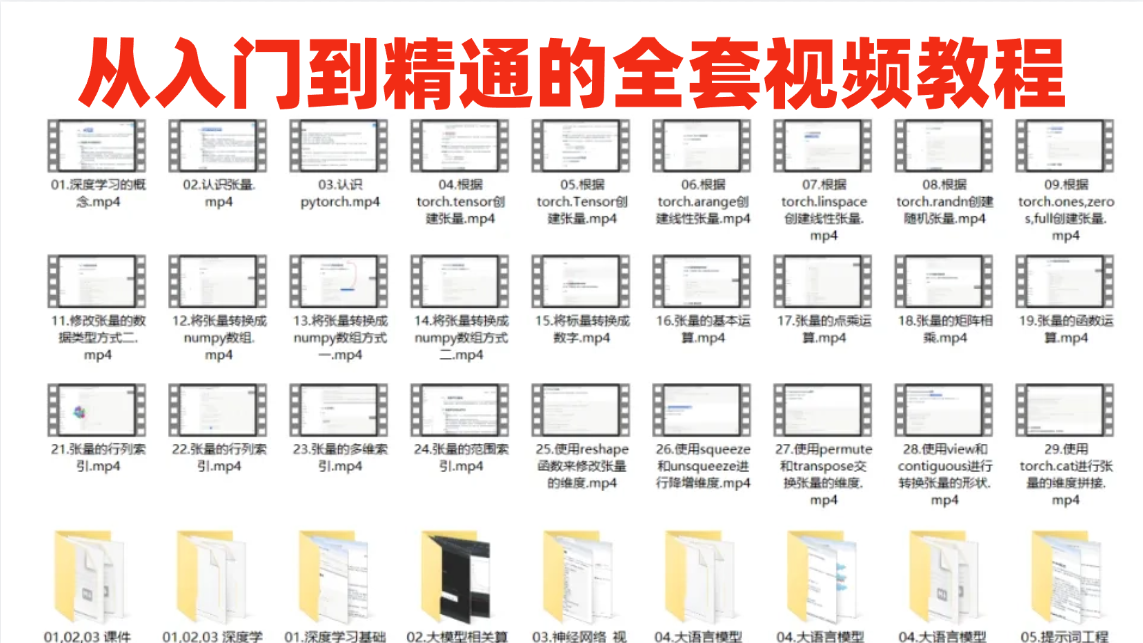
①从入门到精通的全套视频教程⑤⑥
包含提示词工程、RAG、Agent等技术点
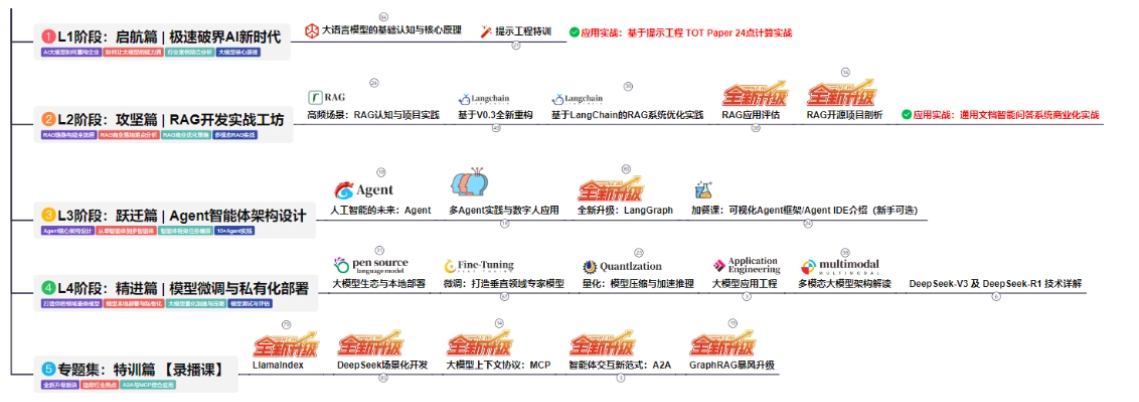
② AI大模型学习路线图(还有视频解说)
全过程AI大模型学习路线
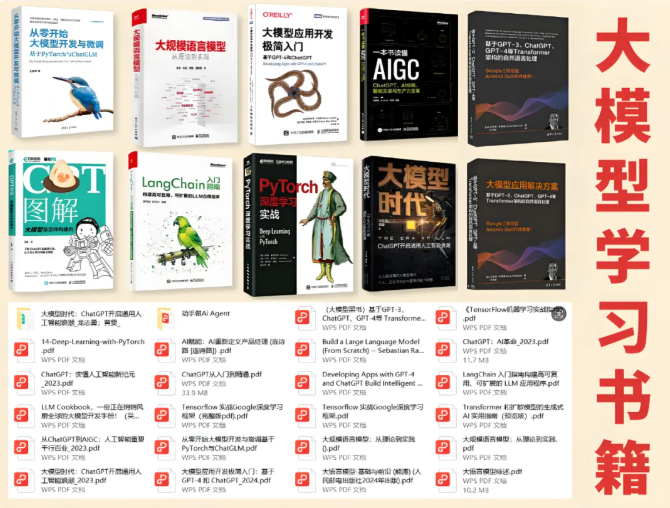
③学习电子书籍和技术文档
市面上的大模型书籍确实太多了,这些是我精选出来的
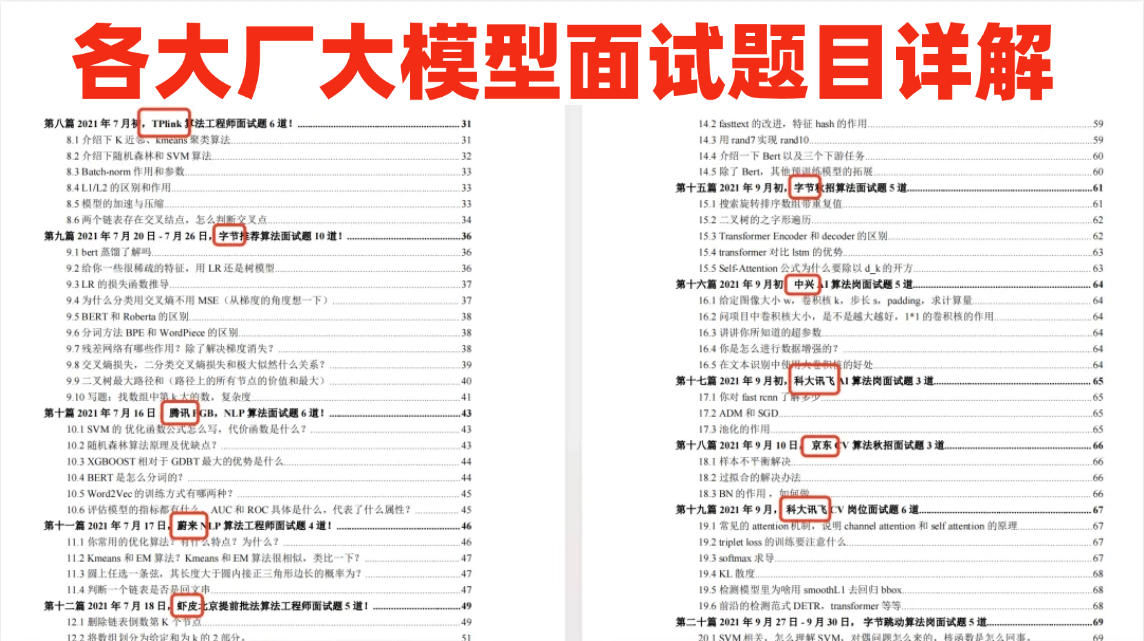
④各大厂大模型面试题目详解
⑤ 这些资料真的有用吗?
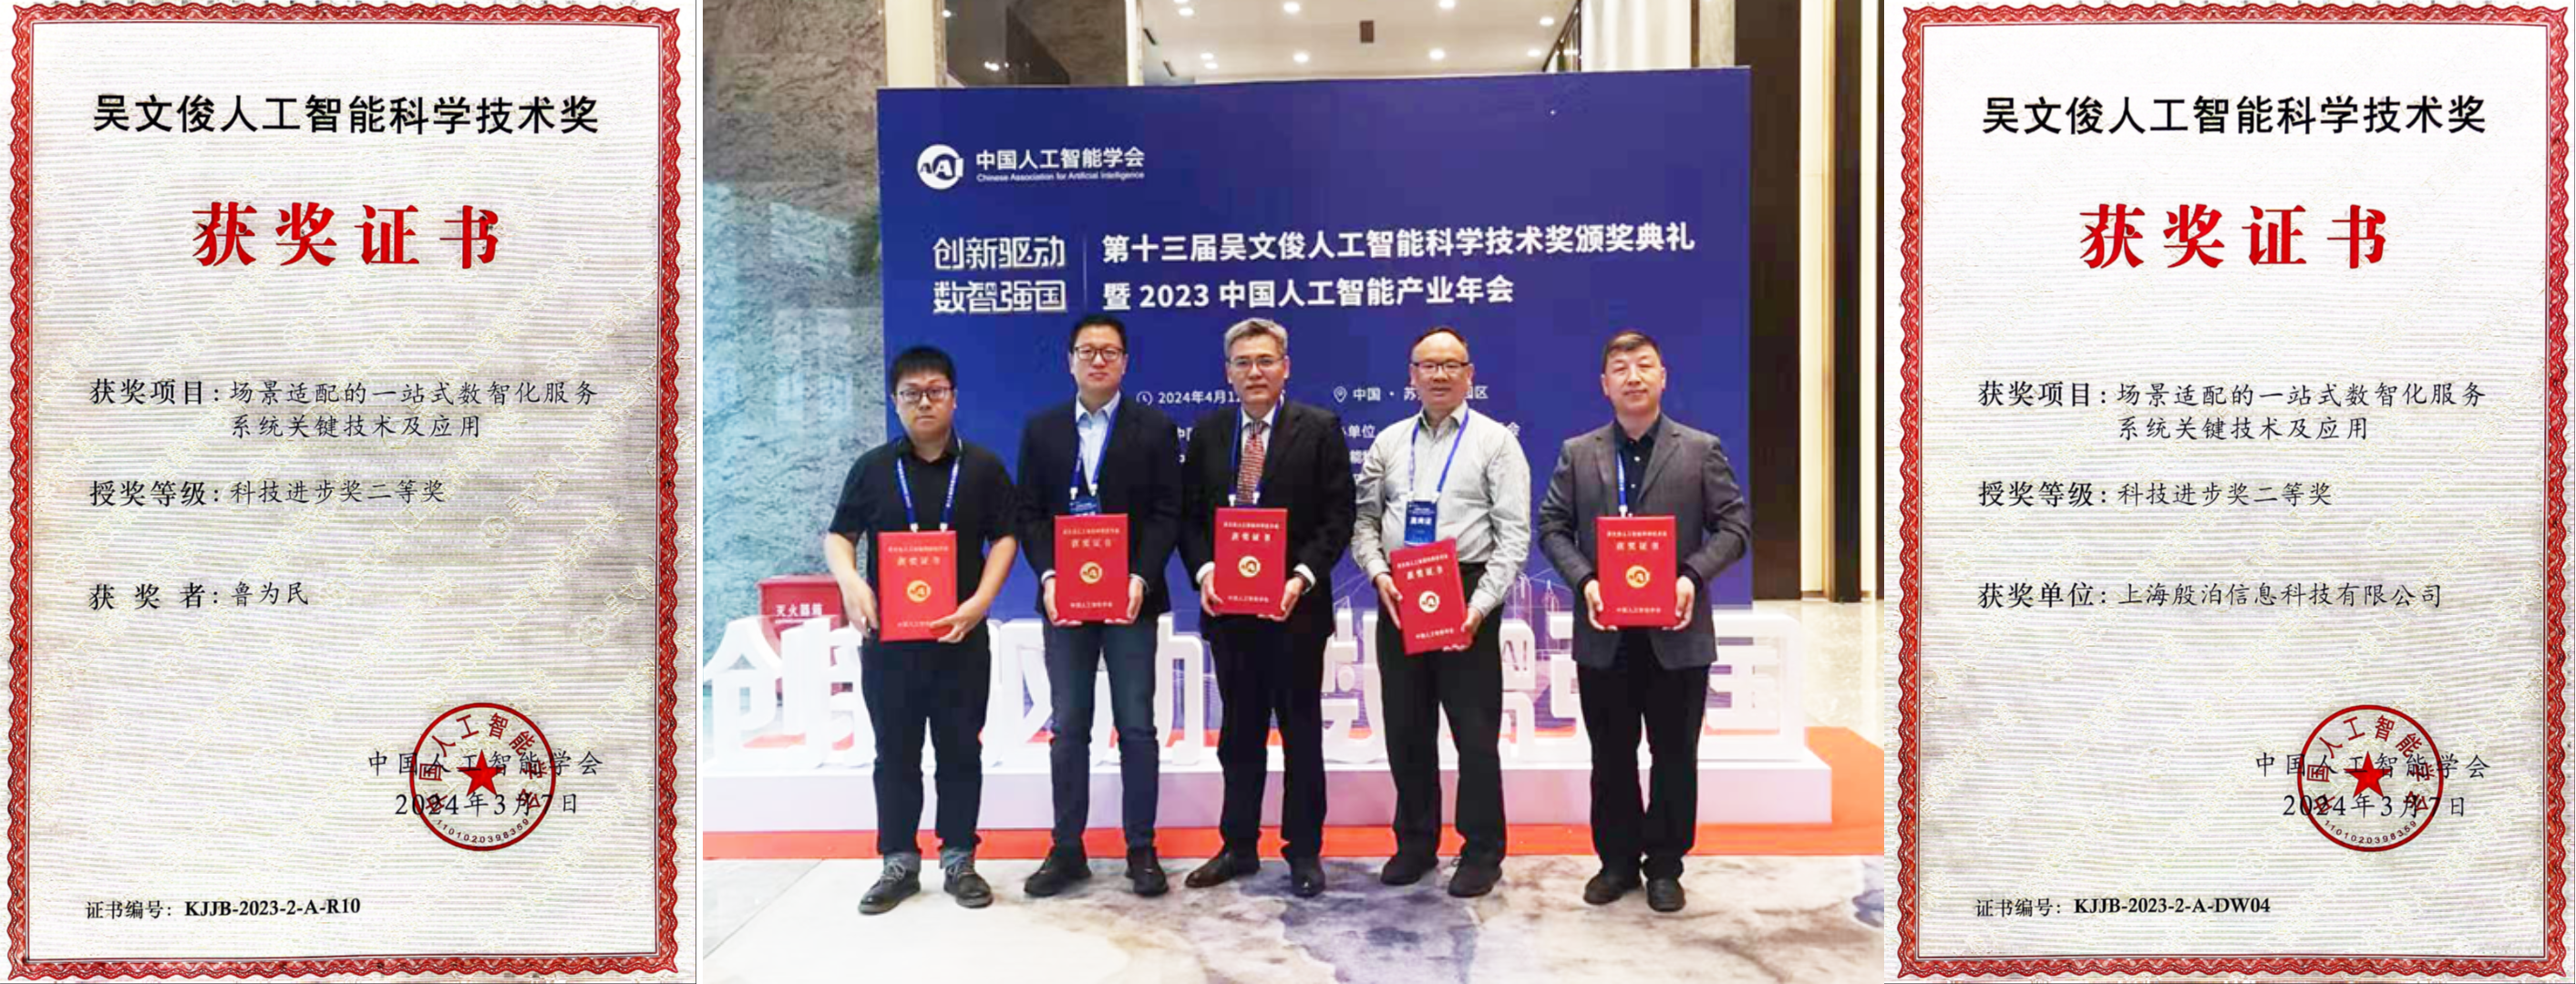
这份资料由我和鲁为民博士共同整理,鲁为民博士先后获得了北京清华大学学士和美国加州理工学院博士学位,在包括IEEE Transactions等学术期刊和诸多国际会议上发表了超过50篇学术论文、取得了多项美国和中国发明专利,同时还斩获了吴文俊人工智能科学技术奖。目前我正在和鲁博士共同进行人工智能的研究。
所有的视频教程由智泊AI老师录制,且资料与智泊AI共享,相互补充。这份学习大礼包应该算是现在最全面的大模型学习资料了。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
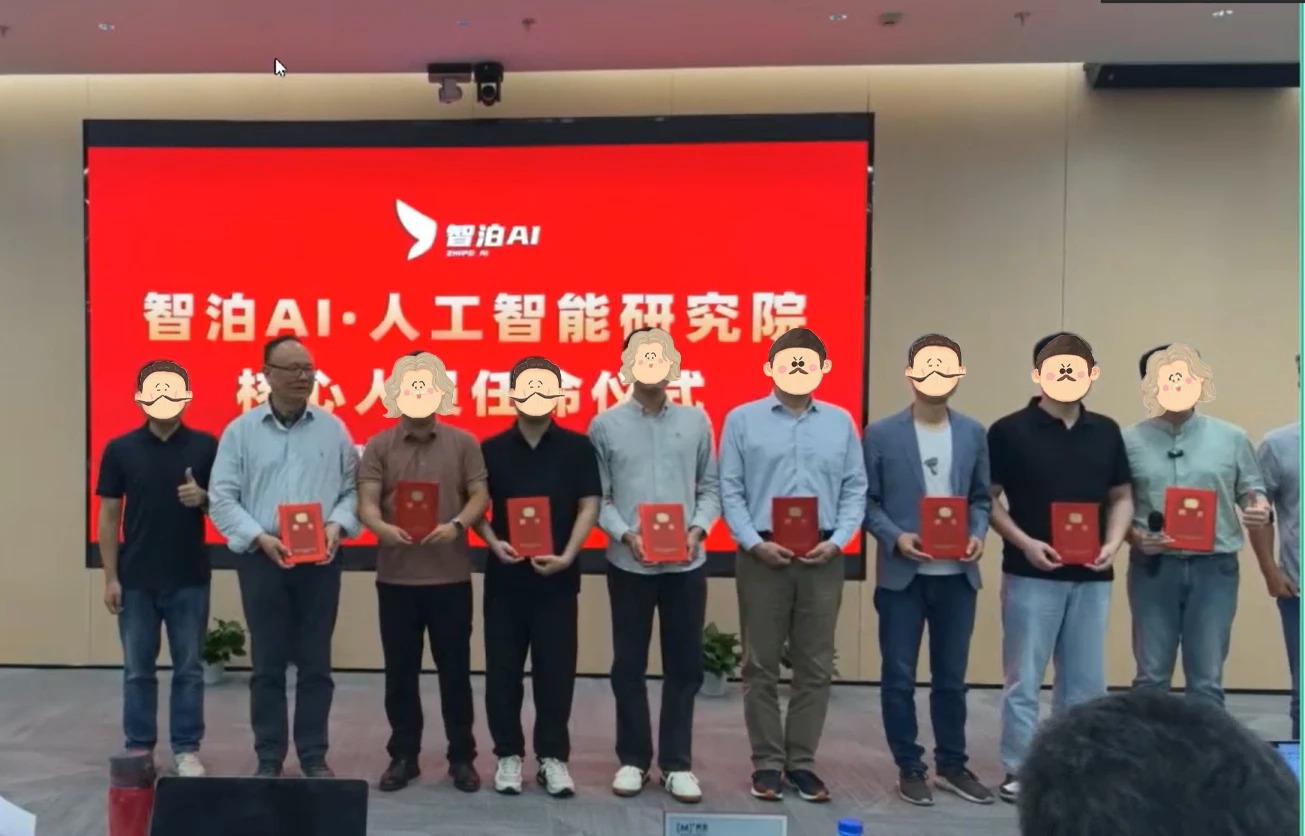
智泊AI始终秉持着“让每个人平等享受到优质教育资源”的育人理念,通过动态追踪大模型开发、数据标注伦理等前沿技术趋势,构建起"前沿课程+智能实训+精准就业"的高效培养体系。
课堂上不光教理论,还带着学员做了十多个真实项目。学员要亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
如果说你是以下人群中的其中一类,都可以来智泊AI学习人工智能,找到高薪工作,一次小小的“投资”换来的是终身受益!
应届毕业生:无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型:非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能 突破瓶颈:传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。
👉获取方式:
😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓**

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐
 1
 0
- 0


 已为社区贡献165条内容

所有评论(0)