Agent 开发一面高频题:从向量检索到容错,把“八股”答成系统设计
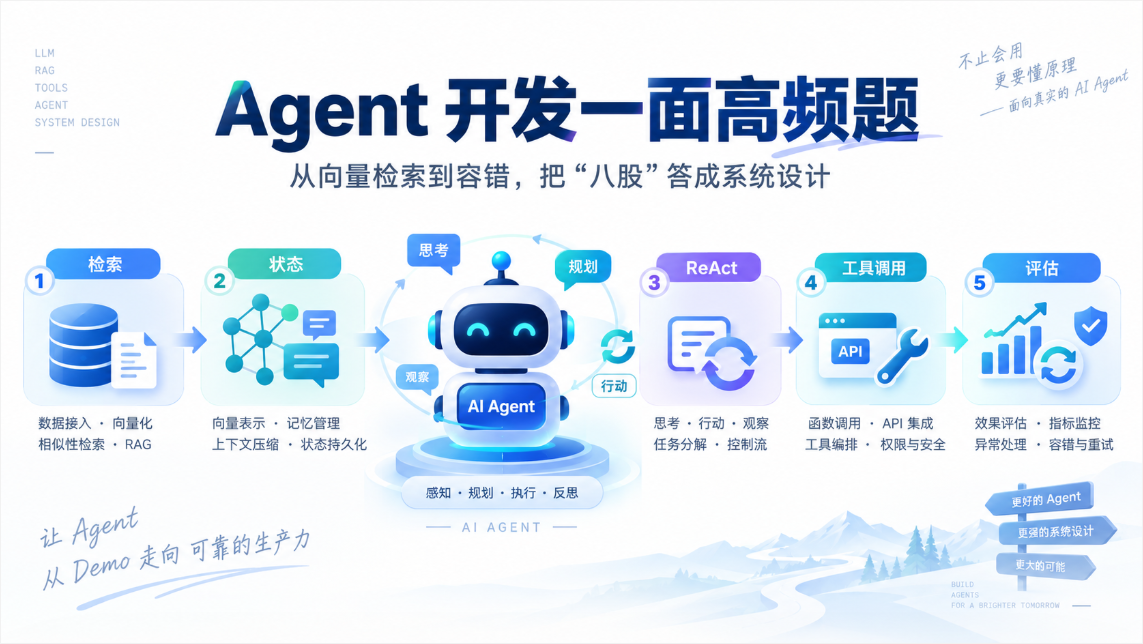
Agent 面试里的基础题,真正考的不是术语记忆,而是你能否把一个概念落到可运行、可评估、可恢复的系统里。
一场 Agent 开发一面很容易出现这样的题目:向量数据库和关系数据库有什么区别?ReAct 怎么实现?多轮对话状态如何管理?工具调用失败怎么办?
它们看起来像分散的八股题,其实可以串成一条完整链路:Agent 接收任务,在受控上下文中推理,检索信息、调用工具,并对结果、成本与失败负责。
这篇文章按这条链路整理常见问题,并给出工程化的回答方式。目标不是背出一套标准答案,而是能用自己的项目把答案讲完整。
1. 先建立答题框架:概念、机制、落地、边界
对一个技术问题,推荐按四层组织回答:
- 概念:它解决什么问题。
- 机制:运行时的数据或控制流是什么。
- 落地:在自己的项目里如何使用。
- 边界:它在哪些条件下会失效,如何补救。
例如被问“ReAct 的核心思想是什么”,只说“Reasoning + Acting”只完成了第一层;能讲出循环控制、工具结果回灌、停止条件和失败处理,才说明真正理解了它。
2. 数据层:关系数据库和向量数据库不是替代关系
2.1 两者分别擅长什么
关系数据库保存的是结构化事实:用户、订单、权限、状态。它按明确字段筛选和关联,例如“查询 ID 为 42 的订单”。常见索引包括 B+ 树和哈希索引。
向量数据库保存的是文本、图片等内容经过 Embedding 模型编码后的高维向量。查询也会被编码为向量,再通过余弦相似度、内积或欧氏距离找出最相近的 Top K 内容。为避免全量比对,系统通常采用 HNSW、IVF、PQ 一类近似近邻索引。
| 维度 | 关系数据库 | 向量数据库 |
|---|---|---|
| 数据形态 | 表、字段、确定值 | 高维向量与原始文本/元数据 |
| 主要问题 | 精确事实与事务操作 | 语义相近内容的召回 |
| 查询方式 | SQL 条件、Join、聚合 | 相似度检索、Top K |
| 典型索引 | B+ 树、哈希 | HNSW、IVF、PQ |
| 例子 | 查某用户的订单状态 | 按案情检索相近法条 |
“向量库能理解语义”是一个便于沟通的说法。严格地说,语义表示由 Embedding 模型产生,向量库负责高效地保存、过滤和近邻搜索。
2.2 一个常见的混合检索设计
真实 RAG 系统往往同时使用两者。向量检索负责从文档中召回候选片段,关系库或元数据过滤负责约束租户、权限、时间范围和文档状态;必要时再加关键词检索和重排。
用户问题
  → query embedding
  → 向量召回 Top K 片段
  → 按 tenant_id / 权限 / 时间过滤
  → rerank
  → 将少量高质量上下文交给模型
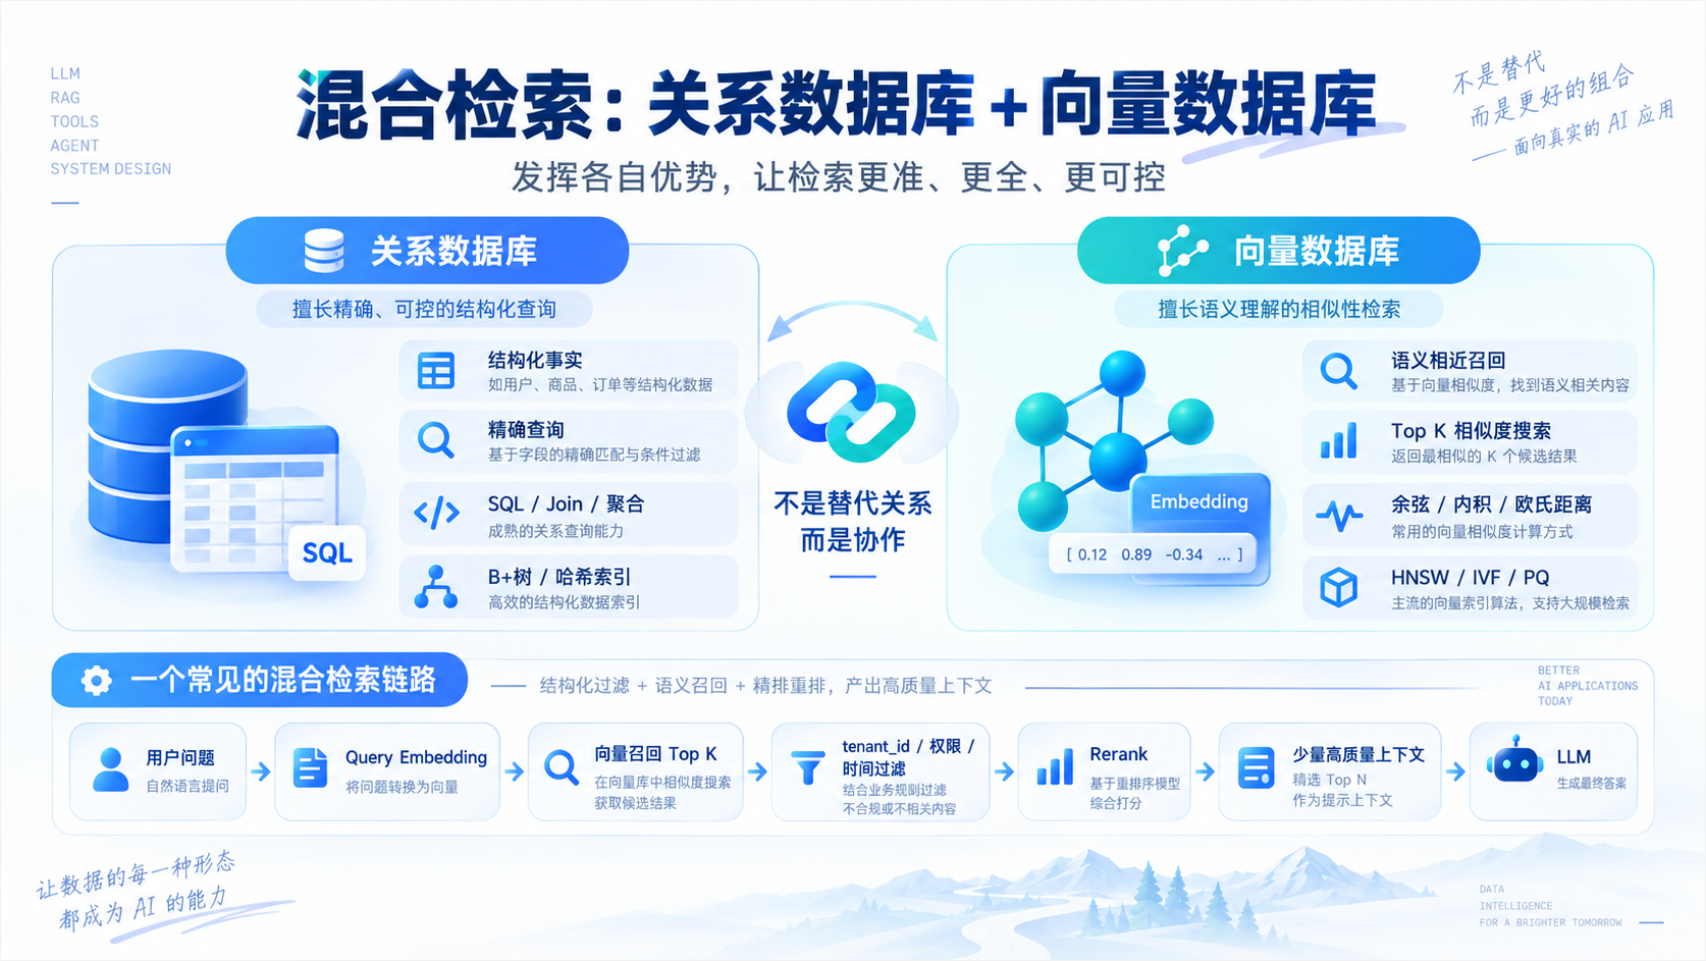
面试中可以落到一句话:关系库保证“找对那条事实”,向量库提高“找到相关语义”的概率;业务系统通常需要两者协作。
3. 控制层:ReAct 如何从概念变成 Agent Loop
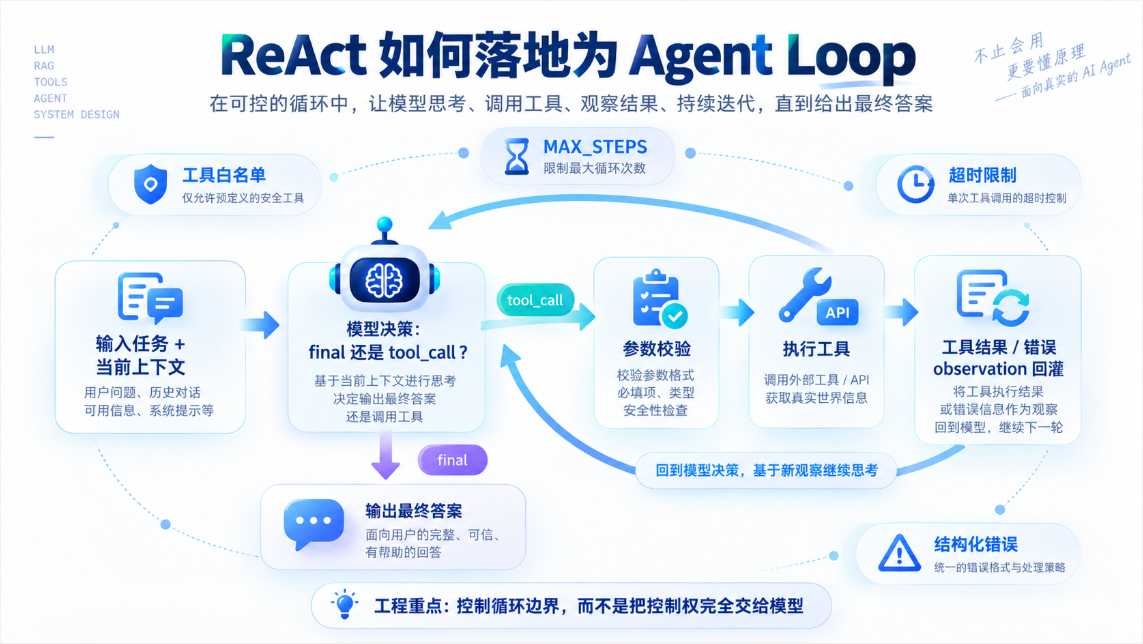
ReAct 是 Reasoning 和 Acting 的组合。模型根据当前目标和已有观察信息决定下一步:直接回答,或者发起一次工具调用。执行器运行工具,将结果作为新的 observation 写回上下文,再让模型继续决策。
输入任务 + 当前上下文
        ↓
模型决策:final 还是 tool_call?
        ↓ tool_call
执行器校验参数并调用工具
        ↓
工具结果 / 错误结果写回消息历史
        ↓
再次调用模型
        ↓
达到停止条件后输出 final
最小的伪代码如下。这里的关键不在循环本身,而在循环的边界:最大轮次、工具白名单、超时和结构化错误都由 Harness 控制,不能只交给模型“自觉”。
messages = build_context(user_input, session_state)

for _ in range(MAX_STEPS):
    response = llm.invoke(messages, tools=ALLOWED_TOOLS)

    if response.is_final:
        return response.content

    call = validate_tool_call(response.tool_call)
    result = run_tool(call, timeout_s=10)
    messages.extend([response.as_message(), tool_message(call.id, result)])

raise AgentStepLimitExceeded("agent exceeded MAX_STEPS")
3.1 ReAct 的“推理”不等于暴露思维链
工程上需要的是可执行的决策:调用哪个工具、参数是什么、何时终止、对结果是否满意。日志可以保存结构化的工具轨迹和状态摘要,用于调试和评估;不应把模型的自由文本推理当作可靠控制协议。
3.2 一个更像项目经历的回答
“我的 Agent 用一个显式状态机驱动 ReAct 循环。模型只能在回答和已注册工具之间选择;执行器会校验工具参数、限制最大步数,并把工具成功或失败结果回灌给下一轮。这样遇到异常时,Agent 看到的是可处理的 observation,而不是进程直接崩掉。”
4. 记忆和状态:不要把完整聊天记录一直塞进 Prompt
4.1 短期记忆:这次任务正在发生什么
短期记忆通常是当前会话的工作上下文,包括系统约束、用户目标、最近消息、工具定义、中间结果与当前计划。它有时放在内存里,有时存入带 TTL 的会话存储。它的生命周期与任务或会话绑定。
4.2 长期记忆:以后仍有价值的内容
长期记忆应当是经过筛选后可复用的信息,而不是聊天记录的备份。一个实用划分是:
- 语义记忆:稳定事实和用户偏好,例如用户是 Java 后端学习者。
- 情景记忆:过去一次任务做过什么、结果如何、有哪些约束。
- 程序性记忆:可复用的规则、Skill、工作流和工具使用范式。
长期记忆写入前要判断价值、来源和有效期。用户偏好变更后应可覆盖;检索结果必须带来源,不能因为“曾经被模型说过”就当作事实。
4.3 多轮状态管理的五个问题
设计对话状态时,可以依次检查:
| 问题 | 设计要点 |
|---|---|
| 保存什么 | 消息、目标、工具轨迹、任务状态、必要的用户偏好 |
| 怎样更新 | 新问题是否延续旧目标;冲突信息如何覆盖或标记 |
| 如何控长 | 滑动窗口、摘要、按需检索历史,避免上下文无限增长 |
| 如何隔离 | 用 user_id、tenant_id、session_id 隔离数据与权限 |
| 如何收尾 | 将有价值内容写入长期记忆,清理临时结果与敏感上下文 |
其中最容易被忽略的是隔离。多用户系统如果只按“最近聊天记录”取上下文,就可能把 A 的信息带给 B;这不是模型效果问题,而是数据边界错误。
5. 评估层:准确率只是开始
Agent 的输出通常经过多步决策,因此“最终答案准确率”不足以定位问题。一个可执行的评估体系至少包含以下层次:
| 层次 | 关注指标 | 用途 |
|---|---|---|
| 任务结果 | 任务成功率、答案正确性、引用正确性 | 判断用户目标是否完成 |
| 组件能力 | 检索 Recall/Precision、重排效果、工具参数正确率 | 定位 RAG、Tool、Prompt 问题 |
| 执行轨迹 | 工具选择率、无效调用率、平均步数、循环率 | 判断 Agent 是否在乱走 |
| 线上体验 | P50/P95 延迟、Token 与工具成本、错误率 | 控制可用性与预算 |
| 安全与鲁棒性 | 越权率、注入攻击通过率、恢复成功率 | 防止高风险行为 |
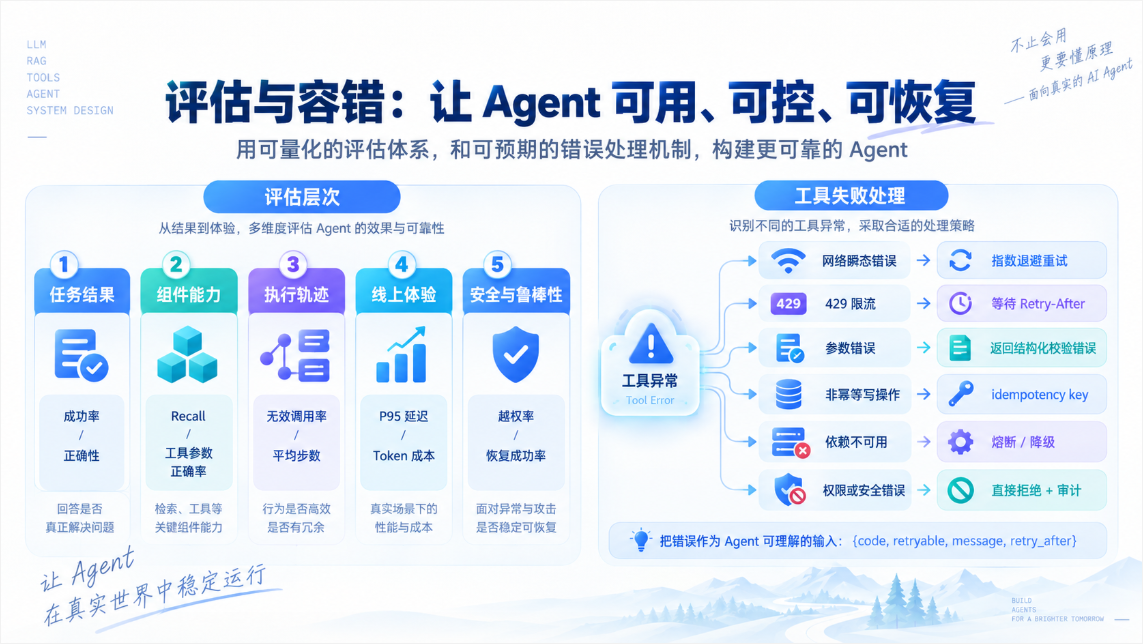
评估要分阶段。开发时先做单组件回归,例如固定测试集验证检索与工具选择;再做端到端任务集;上线后用埋点、采样回放和人工反馈持续监控。通过单元测试不代表真实用户工作流已经可靠。
6. 框架选择:LangChain 与 LlamaIndex 解决了什么,没解决什么
LangChain 提供模型、Prompt、工具、检索器和链路编排的抽象,适合快速拼装应用。LlamaIndex 更聚焦数据接入、索引和检索增强流程。两者都能降低原型阶段的重复劳动。
但框架不替你完成系统设计。它们的边界通常在于:
- 抽象层较多,排错时需要知道底层模型调用和消息格式。
- 版本演进快,示例代码和实际 API 可能不一致。
- 默认链路未必符合生产要求,例如权限过滤、观测、重试与成本控制仍需自己补齐。
因此项目中应优先讲清“我为什么选它、封装了什么、哪些关键路径没有被框架遮住”,而不是只报框架名。
7. Prompt 设计:把自然语言要求变成稳定接口
稳定性来自约束,而不是堆砌技巧名词。一个用于工具调用的 Prompt 至少应明确:角色与目标、允许的工具、何时调用、参数格式、无信息时怎样回答、最终输出格式。
实践中还要配合结构化输出校验、少量代表性样例、检索上下文边界和版本化回归集。Prompt 改一个字也可能改变工具选择,所以它应与代码一样进入版本管理和测试。
8. 工具失败:把错误作为 Agent 可理解的输入
外部 API 会超时、限流、返回脏数据,也可能发生业务错误。健壮系统不应只在 except 中打印日志,而要按错误类别给出不同处理:
网络瞬态错误 → 指数退避重试,限制次数
429 限流      → 等待 Retry-After 或切换队列
参数错误      → 返回结构化校验错误,让模型修正参数
非幂等写操作  → 使用 idempotency key,避免重试造成重复写入
依赖长期不可用 → 熔断、降级到缓存/只读能力,并告知用户
权限或安全错误 → 直接拒绝,记录审计日志
工具返回给 Agent 的错误应结构化,例如 {code, retryable, message, retry_after}。模型据此可以改参数、换工具或向用户说明限制;执行器仍要掌握最终控制权,不能允许它无限重试。
9. 面试时怎样把答案收束到项目
每道基础题讲完后,用一个自己的项目事实收尾:
在我的知识库 Agent 中,文档片段先由向量检索召回,再按用户权限做元数据过滤。Agent 以最大 6 步的工具循环运行,工具调用都经过 schema 校验。我们同时记录任务成功率、P95 延迟和无效调用率;检索服务超时时返回可重试错误,超过阈值则降级为关键词搜索。
这段话把检索、状态、执行、评估和容错连到了一起。没有做过的细节不要虚构,换成你真正实现并验证过的设计即可。
一句话总结
Agent 面试的基础题可以看作一套系统设计词汇:数据如何被找回,状态如何被控制,工具如何被执行,失败如何被恢复,结果如何被度量。
Tags: AI Agent RAG 向量数据库 ReAct LangChain 面试

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 3
 0
- 0


 已为社区贡献4条内容

所有评论(0)