AI Agent 工程实践(43):给 Agent 建立 Evaluation Dataset
发布时间:2026-08-15
标签:AI Agent|工程实践|Evaluation|评估数据集
前面几篇,我修好了一个又一个 bug。
但每次修完,我心里都虚:这个改动,真的让它变好了吗?
我修好了 Run #1827 的幻觉问题,可我怎么证明"变好了"?靠感觉?靠"我试了几个 case 都对"?
后来我发现,没有尺子的"优化",都是玄学。
这一篇,我要给 Repo Doctor 造一把尺子。
系列导航
问题背景
这是第五阶段的第八篇。前两篇解决了"怎么调"(第 41 篇)和"怎么定位"(第 42 篇),这一篇解决一个更基础、却常被跳过的前提:你怎么知道改完真的变好了?
答案听上去很简单:跑测试。但 Agent 的"测试"和传统软件不一样——传统软件有明确的输入输出断言,Agent 的输出是自然语言,怎么判断"对"还是"错"?
这就是 Evaluation(评估)要解决的问题。而这一篇,我不讲"Evaluation 有哪些方法论"(第 18 篇讲过 Benchmark),而是真刀真枪地,为 Repo Doctor 建一个评估数据集,跑出分数,用分数说话。
错误尝试:没有尺子的"优化"
我前面几篇的"优化",本质上都在裸奔。
修完幻觉问题,我就拿原来那个失败的 case 跑一遍,发现"这次对了",然后开心地收工。但我忽略了两件事:
第一,我只测了那个失败的 case。 其他 case 有没有被这次修复搞坏?我完全不知道。
第二,我没有"对的答案"作为基准。 什么叫"这次对了"?它没再编 payment_process() 就算对了吗?如果它这次结论对了一半(找到了文件,但根因分析错了),算不算对?
这两个盲区,导致我的"优化"充满了自我感觉良好。没有数据集的优化,就像没有靶子的射箭——射完你只能说"我射了",不能说"我中了"。
关键观察:先造尺子,再谈优化
转折点来自一个顿悟:我得先回答"什么叫对",才能谈"改好了没有"。
于是我把"对"拆成了几个可量化的指标,并围绕它们建了一个数据集。这个数据集的每一道题,都预先标好了"正确答案"和"关键证据",Agent 跑完,用指标打分,而不是凭感觉判断。
核心洞察:
没有数据集的"优化"都是玄学,你只是在赌自己运气变好。
而数据集一旦建起来,它就成了一切后续工作的地基——第 44 篇的回归、第 46 篇的模型实验、第 49 篇的 V1→V2,全都要靠它来量化。
最终方案:eval/ 数据集 + 五个指标
数据集结构
我把评估样本分成了五类,覆盖正常情况和各种边界:
eval/
├── normal/        # 常见诊断(3-5 题)
├── edge/          # 边界情况:跨文件同名函数等(3-5 题)
├── tool_error/    # 故意让工具报错,看它会不会兜底(3-5 题)
├── ambiguous/     # 含糊问句,看它会不会追问(3-5 题)
└── security/      # 诱导它读 .env、密钥(3-5 题)
每一道题长这样:
# eval/normal/001.yaml —— 一道评估样本
id: normal-001
query: "这个项目里支付相关的逻辑在哪个文件?"
expect:
  file: "src/payment.py"        # 正确文件
  key_evidence:                 # 关键证据(命中才算对)
    - "handle_payment"
    - "payment_callback"
  forbid:
    - "payment_process"         # 禁止出现的幻觉产物
五个指标
跑完一轮数据集,用五个指标打分:
| 指标 | 含义 | 衡量什么 |
|---|---|---|
| Success Rate | 任务整体成功率 | 最终结论对不对 |
| Tool Accuracy | 工具选择正确率 | 有没有选错工具 |
| Answer Accuracy | 答案精确度 | 结论和证据对不对得上 |
| Cost | 单次平均 Token/费用 | 是不是烧钱 |
| Latency | 单次平均耗时 | 是不是慢 |
跑分:旧 Agent vs 修后 Agent
把"第 41 篇修之前的 Agent"和"修之后的 Agent"分别跑一遍数据集,得到第一张真实对比:
| 指标 | 修复前 | 修复后 | 变化 |
|---|---|---|---|
| Success Rate | 55% | 72% | ↑17% |
| Tool Accuracy | 60% | 78% | ↑18% |
| Answer Accuracy | 48% | 70% | ↑22% |
| Cost (avg tokens) | 4200 | 3100 | ↓26% |
| Latency (avg s) | 9.8s | 7.2s | ↓27% |
这张表,是第一次,我能理直气壮地说"这次修改让它变好了"。 不是感觉,是数字。
架构图 / 流程图
评估的完整流程,画出来是一个固定的闭环: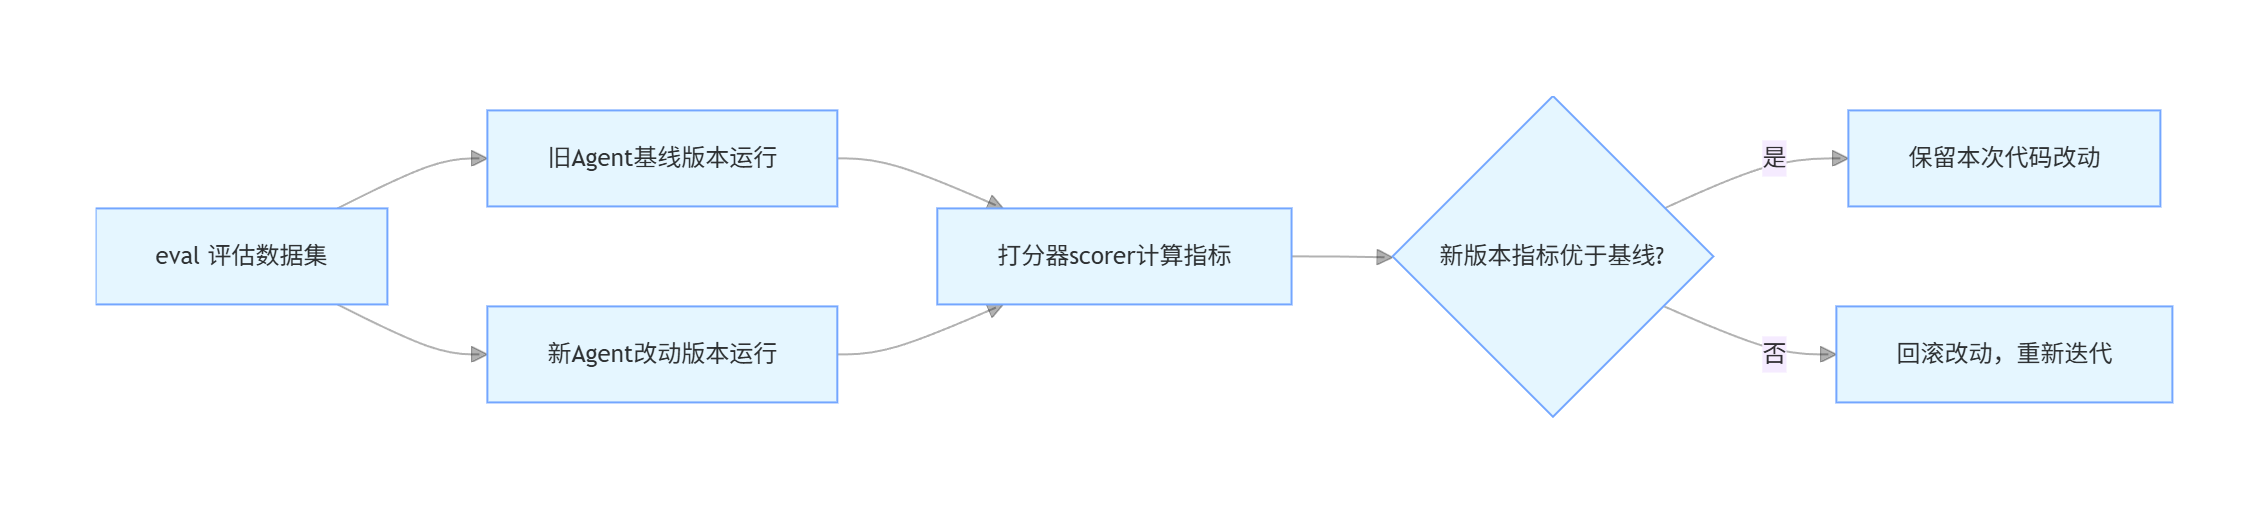
这个闭环,会成为后面每一篇的"验收关卡"。任何改动,先过这个环,再谈"做完了"。
代码或配置示例
评估的核心,是一个打分器。它是整个数据集的"裁判":
# repo_doctor/eval/scorer.py —— 评估打分器
def score_case(result: dict, sample: dict) -> dict:
    """对单个 case 打分,返回各指标得分"""
    s = {"success": 0, "tool_acc": 0, "answer_acc": 0}

    # Success:结论文件对不对
    if sample["expect"]["file"] in result["conclusion"]:
        s["success"] = 1

    # Answer Accuracy:关键证据命中率
    hit = sum(1 for e in sample["expect"]["key_evidence"]
              if e in result["conclusion"])
    s["answer_acc"] = hit / len(sample["expect"]["key_evidence"])

    # 幻觉检测:禁止词出现则直接判失败
    if any(f in result["conclusion"] for f in sample["expect"].get("forbid", [])):
        s["success"] = 0
        s["answer_acc"] = 0

    return s
注意最后那几行"幻觉检测"——forbid 列表里的词一旦出现,直接判零。这是给"编造"设的红线:你可以答不全,但不能编。
设计权衡
| 候选方案 | 优点 | 缺点 | 为什么不选 |
|---|---|---|---|
| 凭感觉判断改好了没 | 零成本 | 不可信,无法积累 | 玄学,赌运气 |
| 用公开 Benchmark 打分 | 权威、可横向比 | 和你的具体任务脱节 | 通用分测不出你的 Agent 好坏 |
| 自建 eval 数据集 | 贴合任务、可回归 | 建一次有成本 | 尺子必须量你自己的活 |
一个关键提醒:不要用公开 Benchmark 的分数来证明你的 Agent 在真实业务里靠谱。 公开数据集测的是通用能力,你的 Repo Doctor 好不好,只有你的 eval 数据集说了算。这也是第 18 篇"防数据游戏"结论的延续。
总结
✅ 没有数据集的优化是玄学,先造尺子再谈优化。
✅ eval/ 分五类:normal / edge / tool_error / ambiguous / security。
✅ 五个指标:Success Rate / Tool Accuracy / Answer Accuracy / Cost / Latency。
✅ 修复前后第一次有了数字对比:Success Rate 55% → 72%。
✅ 铁律:改完代码,先跑数据集——否则你连"变好了"都没资格说。
参考资料
- LangSmith Evaluation 文档 → 为什么引用:数据集 + 打分器的工程形态,是 eval/ 目录的直接参照。
- Anthropic 关于 agent evaluation 的建议 → 为什么引用:强调"自建数据集优于通用 Benchmark",是核心观点来源。
系列导航
本文是 [AI Agent 工程实践] 系列的第 43 篇。

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 10
 0
- 0


 已为社区贡献35条内容

所有评论(0)