金融级 AIOps 架构跃迁(从“1-5-10“快恢目标到 AI Agent 告警收敛的完整技术实践)
上接【百亿交易、618日9亿:16年金融架构老兵的踩坑全记录-CSDN博客】
目录
摘要:金融系统的可用性要求是"几个 9",但传统运维往往是"出了事才知道出了事"。本文从金融架构师视角,把两个看似独立的技术命题串成一条主线——先建基座,再做跃迁:先用"三位一体监控 + 五层监控 + traceId 全链路 + 保留现场"把"1 分钟发现、5 分钟定位、10 分钟解决"的快恢目标做扎实;再直面传统规则引擎在告警收敛上的三大结构性天花板,用 AI Agent 的四层收敛漏斗(语义去重、上下文分组、动态抑制、因果聚合)实现从"规则匹配"到"因果推理"的架构跃迁。全文给出可落地的代码骨架、技术选型与三阶段演进路径。
一、导读:这篇文章要解决什么问题
很多团队做运维转型时容易陷入两个极端:要么迷信工具,上来就堆 Zabbix + Prometheus + ELK + 一堆 Agent,结果告警风暴照样把人淹没;要么迷信 AI,以为接个大模型就能自动运维,结果 Agent 连"现场"都看不到、连拓扑都不准,推理全是幻觉。
本文的核心观点是:这两件事是先后关系,不能跳过任何一步。
下图是贯穿全文的演进主线骨架:
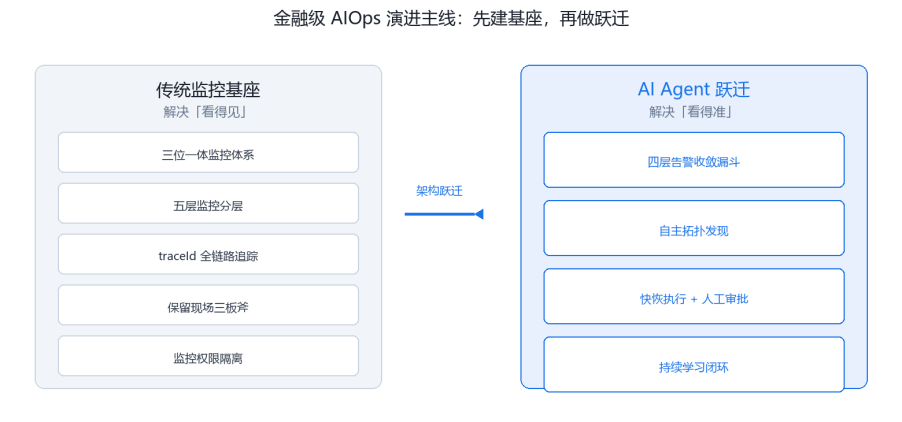
图 1:金融级 AIOps 演进主线——先建基座,再做跃迁
左侧的传统监控基座解决"看得见":三位一体监控体系、五层监控分层、traceId 全链路追踪、保留现场三板斧、监控权限隔离;右侧的 AI Agent 跃迁解决"看得准":四层告警收敛漏斗、自主拓扑发现、快恢执行 + 人工审批、持续学习闭环。没有前者,Agent 拿不到高质量数据、准的拓扑、可回滚的操作对象,推理就是空中楼阁;没有后者,规则引擎会随故障模式增长而不可控地膨胀,1-5-10 目标在告警风暴面前沦为空谈。
二、金融级运维的目标与基座:为什么是"1-5-10"
(一)金融系统的运维难点是"结构性"的
金融系统运维和其他行业有本质区别,四个特点决定了它不能用"出了告警再排查"的被动模式硬撑:
- 交易不可中断:支付、清结算、风控等核心链路,1 分钟宕机可能意味着百万级资金异常;
- 监管合规刚性:银保监会对生产事件有明确的报告时效和定级标准,不是"内部看着办";
- 链路复杂度高:一笔交易从客户端到核心系统,可能跨越网关、微服务、消息队列、数据库、外部接口等 10+ 节点;
- 故障传播快:一个数据库慢查询可能在 30 秒内引发整个服务集群的线程池耗尽。
"1-5-10"快恢目标——1 分钟发现、5 分钟定位、10 分钟解决——已成为金融级运维的标杆实践。但注意,这个目标不是靠加班和经验堆出来的,它需要一套监控体系作为底座。
(二)三位一体监控体系:让"1 分钟发现"成为可能
所谓三位一体,是指监控必须同时覆盖三个维度,缺一不可:
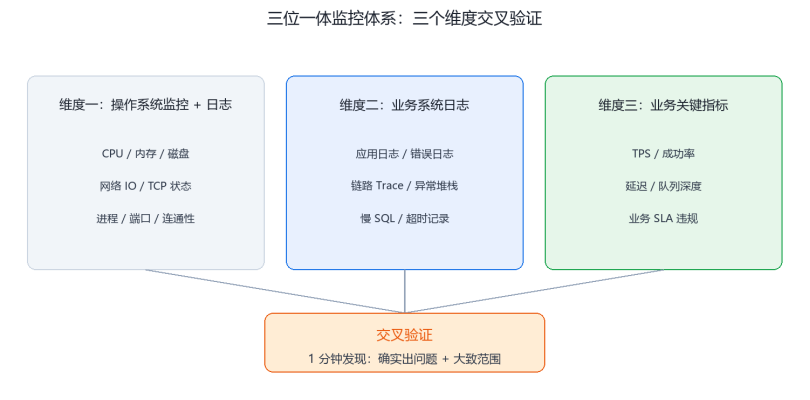
图 2:三位一体监控体系——三个维度交叉验证
为什么必须三位一体?因为只看任何一个维度都会导致"看得见"但"看不全":
- 只看操作系统监控:CPU 100% 告警了,但不知道是哪个业务接口导致的——发现快但定位慢;
- 只看应用日志:应用报错了,但可能是底层网络或磁盘 IO 问题——定位不准;
- 只看业务指标:交易成功率下降了,但不知道是数据库慢还是某个微服务挂了——知道出事但不知道哪里出事。
三个维度交叉验证,才能在 1 分钟内确认"确实出了问题"以及"问题的大致范围"。这是后面 AI Agent 做根因分析的原始养料——没有多维度数据,Agent 连交叉验证的素材都没有。
(三)纵向分层:从硬件到用户体验的五层监控
三位一体是横向维度,纵向还需要分层落地:
| 层级 | 监控对象 | 核心指标 | 典型工具 |
| 硬件基础设施层 | 暖通、电力、安防、网络设备 | 机房温湿度、 UPS 状态、防火墙吞吐 | Zabbix (SNMP/IPMI) |
| 服务器层 | 物理机、虚拟化、存储设备 | CPU 、内存、磁盘 IO 、网络吞吐 | Zabbix / Node Exporter |
| 系统软件层 | OS 、数据库、中间件、消息队列 | DB 响应时间、 MQ 堆积、慢查询 | Prometheus Exporter / JMX |
| 应用服务层 | 微服务实例、 API 接口 | 响应时间、错误率、 QPS | Prometheus + Grafana / SkyWalking |
| 客户体验层 | Web/APP 前端 | 页面加载时间、拨测成功率 | 阿里云拨测 / 自建拨测 |
一个架构师必须理解的判断是:不要试图用单一工具覆盖所有层级。 金融级建议是 Zabbix 管基础设施层 + Prometheus 管应用/容器层 + ELK 管日志层 + Grafana 做统一看板,每层选最合适的,通过 Grafana 统一展示。
三、5 分钟定位与 10 分钟解决的工程底座
(一)traceId 全链路追踪:定位的生命线
发现告警后,5 分钟内定位到具体服务是最大的挑战。核心是全链路 traceId 机制——traceId 从网关入口生成,通过 HTTP Header / MQ Metadata 透传到所有下游服务,最终打入所有日志。金融系统的标准日志格式用管道符分隔,而非 JSON:
<!-- 指标日志:时间|应用名|类名|方法名|响应状态|耗时|traceId|错误码|消息 -->
<property name="METRICS_LOG_PATTERN"
value="%d{yyyy-MM-dd HH:mm:ss.SSS}|${APP_NAME}|%X{className}|%X{methodName}|%X{responseStatus}|%X{timeConsume}|%X{traceId}|%X{errorCode}|%msg%n"/>
<!-- 错误日志:时间|级别|traceId|应用名|服务器IP|租户ID|用户ID|线程|logger|消息 -->
<property name="ERROR_LOG_PATTERN"
value="%d{yyyy-MM-dd HH:mm:ss.SSS}|%-5level|%X{traceId}|${APP_NAME}|%serverIp|%X{tenantId}|%X{accountId}|%thread|%logger{30}|%msg%n"/>
一个容易被忽视的架构决策:日志用管道符分隔,而不是 JSON。 这不是偷懒,而是运维排障的现实——排障时用的是 grep / awk,不是 JSON 解析器。5 分钟定位的标准操作流程:
# Step 1: 从告警中获取异常服务名和错误时间窗口
# Step 2: 在 error.log 中搜索异常类型
cat error.log | grep -n "java.lang.reflect.InvocationTargetException"
# Step 3: 从错误日志中提取 traceId(假设为 489d71fe-67db-4f59-a916-33f25d35cab8)
# Step 4: 用 traceId 在业务日志中还原完整调用链
cat biz.log | grep -n '489d71fe-67db-4f59-a916-33f25d35cab8'
# Step 5: 根据链路日志定位到具体接口、方法、参数、耗时
路径就是:告警 → 错误日志 → traceId → 全链路日志 → 根因定位。
(二)保留现场三板斧:先取证,再动手
10 分钟解决不是"彻底修复",而是"恢复服务"。但在动手前必须先保留现场,否则后续找真因时无据可查:
| 动作 | 命令 | 目的 |
| 线程快照 | jstack <pid> > jstack_$(date +%s).txt | 捕获线程状态,定位死锁 / 阻塞 |
| 堆内存快照 | jmap -dump:format=b,file=heap_$(date +%s).hprof <pid> | 捕获内存对象,定位 OOM/ 内存泄漏 |
| GC 日志 | 确认 -Xloggc 已配置并持续输出 | 分析 GC 停顿导致的服务抖动 |
| 网络状态 | netstat -n | awk '/^tcp/ {++S[$NF]} ...' | 捕获 TCP 连接状态分布 |
关键架构原则:保留现场必须自动化。 等运维人员登录服务器手动执行 jstack 时,现场可能已经变了。应在告警触发时通过 webhook 自动采集线程快照、堆快照、GC 日志。
(三)TCP 连接状态:网络故障的第一信号
金融系统跨机房、跨网络场景多,网络问题是最难定位的故障类型之一。TCP 状态速查:
| 状态 | 含义 | 排查方向 |
| SYN_RECV 大量出现 | 服务端收到 SYN 但未完成握手 | 可能遭受 SYN Flood 攻击,或 backlog 队列满 |
| TIME_WAIT 过多 | 主动关闭方等待 2MSL | 短连接过多,考虑长连接或 tcp_tw_reuse |
| CLOSE_WAIT 过多 | 被动关闭方未调用 close() | 应用代码 Bug ,连接泄漏 |
| ESTABLISHED 异常 | 活跃连接过多 | 检查连接池配置,是否连接泄漏 |
架构师应记住的一个底层知识点:为什么 TIME_WAIT 需要 2MSL? 四次挥手后,主动关闭方进入 TIME_WAIT 并等待 2MSL(最大报文段生存时间)。原因是最后的 ACK 可能丢失,被动关闭方会重发 FIN,等待 2MSL 确保对方有足够时间重发并让自己再次确认。对金融系统的启示是:核心交易链路应优先使用连接池长连接,避免频繁创建/销毁 TCP 连接导致 TIME_WAIT 堆积。
(四)监控权限隔离:安全基座与合规底线
金融系统对监控权限的要求是最小必要权限——监控系统能看到需要的数据,但无法越权操作。
# 创建专用监控用户,限定只能执行白名单命令
useradd -s /bin/bash monitor
mkdir /home/monitor/.bin
chown root. /home/monitor/.bash_profile
chmod 755 /home/monitor/.bash_profile
# 将允许执行的命令软链接到受限目录
ln -s /usr/bin/tail /home/monitor/.bin/tail
ln -s /bin/grep /home/monitor/.bin/grep
ln -s /bin/cat /home/monitor/.bin/cat
# ... 仅白名单命令,不包含 rm / mv / chmod / chown
金融场景的额外加固:监控用户不应有 sudo 权限;日志目录权限用 ACL 精细控制而非 chmod a+rwx 一刀切;SSH 登录限定来源 IP 且用密钥认证;所有操作经堡垒机审计,满足等保/银保监合规要求。
这个"权限最小化"原则,会在后面 AI Agent 的快恢执行中被复用——Agent 的 L1/L2/L3 三级权限模型,本质就是这套权限隔离思想在智能体上的延伸。
四、天花板:传统规则引擎为什么撑不住
到这里,监控基座已经搭好了:能发现、能定位、能恢复。但当故障规模化、复杂化之后,这套传统方案会遇到结构性的天花板。
传统告警收敛架构是 规则引擎 + 图数据库:去重靠配置、分组靠维度、抑制靠规则、根因靠打分。在金融级场景下,有三个结构性瓶颈:
| 瓶颈 | 表现 | 根因 |
| 规则膨胀 | 抑制规则从 20 条膨胀到 500+ 条,维护成本高,规则间冲突频发 | 每种新故障模式都要人工新增规则,无法泛化 |
| 未知故障盲区 | 未预定义的故障模式(如 DNS 间歇性解析失败)不触发任何收敛规则 | 规则引擎只能匹配已知模式,无法推理未知因果关系 |
| 根因打分僵化 | 固定权重打分在高耦合拓扑中频繁误判 | 真实因果链不是线性权重叠加,而是有条件的、上下文相关的 |
这里有一个关键认知,也是本文最想传递的判断:AI Agent 的引入不是替代规则引擎,而是在其上叠加一层自主推理能力。 规则引擎处理已知模式(快、确定、低成本),AI Agent 处理未知和复杂模式(慢、推理、高准确)。两者不是二选一,而是分工。理解这一点,才能避免"为了 AI 而 AI"的陷阱。
五、架构跃迁:AI Agent 赋能的四层收敛漏斗
(一)整体漏斗模型
四层收敛漏斗把 1000 条/分钟的告警风暴收敛为 1-3 个高置信度根因事件,且每一步推理可审计、可回溯、可人工接管:
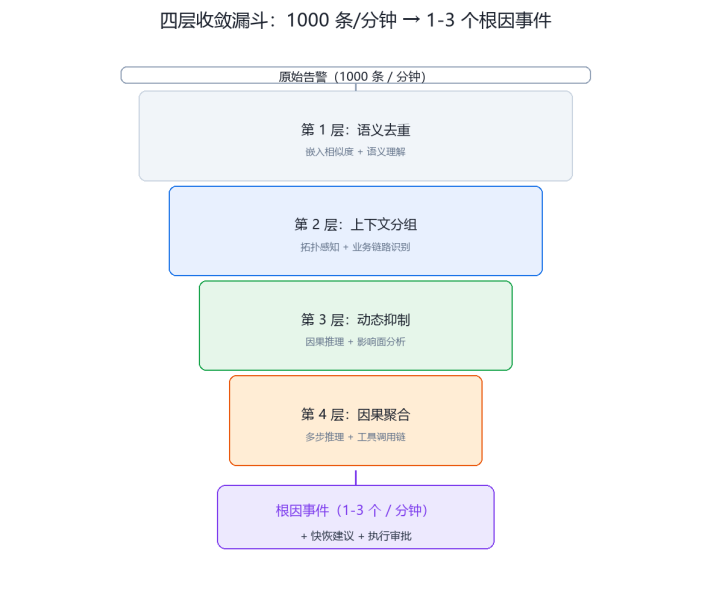
图 3:四层收敛漏斗——1000 条/分钟 → 1-3 个根因事件
(二)第 1 层:语义去重——从字段匹配到语义理解
传统去重靠 alertname + service + labels 字段完全匹配。但同一个故障在不同监控源中的描述可能完全不同:
告警A(Prometheus): "MySQLInstanceDown instance=db-primary:3306"
告警B(Zabbix): "数据库主节点端口3306不可达 db-primary"
告警C(业务监控): "支付核心DB连接池全部超时 production-mysql"
字段匹配认为这是三条不同告警。Agent 通过语义嵌入 + 上下文理解识别它们指向同一事件:
from langchain.embeddings import HuggingFaceEmbeddings
from sklearn.metrics.pairwise import cosine_similarity
class SemanticDeduplicator:
"""Agent驱动的语义去重:超越字段匹配,理解告警语义"""
def __init__(self):
self.embedder = HuggingFaceEmbeddings(
model_name="BAAI/bge-large-zh-v1.5", # 金融运维语料 fine-tune
encode_kwargs={"normalize_embeddings": True}
)
self.similarity_threshold = 0.85
def process(self, alert: dict) -> dict:
semantic_text = self._build_semantic_text(alert) # 完整上下文而非 alertname
embedding = self.embedder.embed_query(semantic_text)
for cached in self.alert_cache:
sim = cosine_similarity([embedding], [cached["embedding"]])[0][0]
if sim >= self.similarity_threshold:
# Agent 进一步验证:时间窗口 + 拓扑位置是否一致
if self._is_temporally_close(alert, cached["alert"], window=120) \
and self._is_topologically_related(alert, cached["alert"]):
return {"action": "deduplicate",
"original_alert_id": cached["alert"]["id"],
"similarity": float(sim)}
# 新告警,加入 5 分钟滑动窗口缓存
self.alert_cache.append({"alert": alert, "embedding": embedding})
return {"action": "new", "alert": alert}
Agent 增值点:传统去重只能识别"长得一样"的告警;Agent 能识别"说的是同一件事"的告警,即使措辞完全不同。
(三)第 2 层:上下文分组——从维度匹配到链路识别
传统分组按 cluster + service + alertname 固定维度。Agent 能基于实时拓扑 + 业务链路语义动态识别分组。以"Redis 集群故障引发支付链路雪崩"为例:
传统分组结果(3个独立组,需人工关联):
组1: redis-cluster-down(基础设施组)
组2: payment-svc-timeout + account-svc-error(应用组)
组3: gateway-5xx-rate-high(网关组)
Agent 分组结果(1个聚合事件,因果链路清晰):
组1: [事件] Redis集群故障引发支付链路雪崩
├── 根因层:redis-cluster-down
├── 传播层:payment-svc-timeout → account-svc-error → risk-svc-latency
├── 表现层:gateway-5xx-rate-high
└── 业务影响:核心支付链路SLA违规(成功率92.3%,阈值99.9%)
Agent 分组通过结构化输出(Pydantic + function calling)保证结果可被下游程序消费,提示词中明确要求"同一拓扑域内告警优先关联、时间越早越可能是根因、基础设施类告警优先于应用类作为根因候选"。
Agent 增值点:传统分组只能按预设维度聚合;Agent 能理解"这些告警虽然分布在不同层级,但属于同一业务链路的级联故障"。
(四)第 3 层:动态抑制——从静态规则到因果推理
传统抑制靠预定义规则(source_match + target_match + equal),规则膨胀且无法覆盖未知模式。Agent 的抑制策略是实时因果推理:收到新告警时,判断它是否是已有活跃事件的衍生告警。核心是 ReAct 模式(Reason → Act → Observe → Conclude),通过工具调用链逐步验证假设:
class DynamicInhibitor:
"""Agent驱动的动态抑制:基于因果推理而非静态规则"""
def _build_tools(self):
return [
{"name": "query_topology", "func": self._tool_query_topology},
{"name": "get_active_incidents", "func": self._tool_get_active_incidents},
{"name": "search_similar_incidents", "func": self._tool_search_similar},
{"name": "query_metrics", "func": self._tool_query_metrics},
]
def evaluate(self, new_alert: dict) -> dict:
# Agent 推理链:ReAct 模式,每步可审计
reasoning_steps = []
active = self._tool_get_active_incidents()
for incident in active:
topo_relation = self._tool_query_topology(
new_alert["service"], incident["root_cause_service"])
causal_prompt = f"""
判断以下告警是否是已有事件的衍生告警:
新告警:{new_alert}
活跃事件:{incident}
拓扑关系:{topo_relation}
推理依据:
1. 新告警的服务是否是根因服务的下游依赖?
2. 新告警类型是否是根因故障的典型传播表现?
3. 时间差是否在合理传播延迟范围内(通常<60秒)?
输出JSON:{{"is_derived": bool, "confidence": float, "reasoning": str}}
"""
result = self.llm.invoke(causal_prompt)
if result["is_derived"] and result["confidence"] > 0.75:
return {"inhibit": True, "parent_incident_id": incident["id"],
"reasoning_trace": reasoning_steps} # 可审计推理链
return {"inhibit": False, "reasoning_trace": reasoning_steps}
Agent 增值点:传统抑制只能匹配预定义规则(MySQLInstanceDown 抑制 ServiceTimeout);Agent 能推理"这个 Redis 集群故障是否会导致支付服务超时"——即使之前没有配过这条抑制规则。
(五)第 4 层:因果聚合——从打分排序到多步推理
传统根因分析是固定权重打分(时间 0.3 + 拓扑 0.3 + 影响面 0.25 + 类型 0.15)。Agent 用多步推理 + 工具调用链替代打分。一段完整的推理链示例:
Thought 1: 收到5条告警,需要找根因
Action 1: query_topology("payment-svc") → 依赖 account-svc, mysql, redis
Thought 2: mysql-down 和 redis-latency 都是底层依赖,需判断哪个是根因
Action 2: query_metrics("mysql-primary", "up") → 0(确认宕机)
Action 3: query_metrics("redis-cluster", "latency_p99") → 2ms(正常)
Thought 3: mysql 确认宕机,redis 正常,mysql-down 是根因候选
Action 4: search_similar_incidents("mysql-down + payment-5xx")
→ 历史事件 INC-20260815-003,根因为 mysql 主节点磁盘满
Action 5: query_metrics("mysql-primary", "disk_usage") → 98.7%
Conclusion: 根因=mysql-primary 磁盘满(置信度94%),建议清理 binlogAgent 的工具箱是可独立验证的操作单元,每个工具封装一个可验证的操作:
class CausalAnalysisAgent:
def _build_tools(self) -> list:
return [
Tool(name="query_topology", description="查询服务拓扑上下游依赖", ...),
Tool(name="query_metrics", description="查询Prometheus实时指标验证假设", ...),
Tool(name="query_logs", description="查询ELK日志,查看错误堆栈", ...),
Tool(name="search_similar_incidents", description="从历史事件库搜索相似故障", ...),
Tool(name="query_trace", description="查询SkyWalking调用链", ...),
Tool(name="check_runbook", description="查询标准处理流程SOP", ...),
]
def _build_prompt(self):
return """
你是金融级运维根因分析Agent。
推理规则:
1. 不要猜测,必须用工具验证每个假设
2. 优先检查基础设施层(网络/DB/中间件),再检查应用层
3. 历史相似事件是重要参考,但必须用实时指标验证
4. 根因必须满足:时间最早 + 拓扑最底层 + 下游影响面最大
5. 无法确定时明确标注"根因未确认"并列出 Top-3 候选
金融场景约束:
- 任何恢复建议必须标注风险等级和影响范围
- 涉及数据操作的建议必须人工审批
"""
这是四层漏斗中最关键的价值点:传统打分给出"mysql-down 置信度 0.92"但无法解释为什么;Agent 给出"mysql-down 置信度 94%,因为实时指标确认宕机 + 磁盘使用率 98.7% + 历史相似事件根因相同",且每步推理可审计。
六、Agent 自主拓扑发现与动态校验
(一)拓扑数据为什么会不准
金融系统的服务拓扑不是静态的——每次发布都可能新增依赖、每次扩容都可能改变调用路径。传统拓扑依赖人工声明或定时采样,存在三种典型不准:
| 不准类型 | 后果 | 传统应对 |
| 漏报依赖 | 告警关联遗漏,根因定位不准 | 人工排查,周期长 |
| 多报依赖 | 误抑制合法告警 | 人工确认,成本高 |
| 拓扑过期 | 关联分析指向错误服务 | 定时全量重扫 |
这是 AI Agent 根因分析能否落地的隐藏前提——如果 Agent 拿到的拓扑是错的,后面的因果推理再强也是"垃圾进、垃圾出"。
(二)Agent 自主发现拓扑
Agent 通过持续分析调用链数据,自主发现未声明的服务依赖:
class TopologyDiscoveryAgent:
def discover_hidden_dependencies(self, service: str) -> list:
# 1. 从调用链存储拉取该服务 24h 内的所有调用记录
raw_traces = self.traces.query(service=service, time_range="24h", limit=10000)
# 2. 提取所有实际被调用的下游服务
actual_downstream = {span.service_name
for trace in raw_traces
for span in trace.spans
if span.service_name != service}
# 3. 与拓扑图中已声明的依赖做差异分析
declared = set(self.topology.get_downstream(service))
undeclared = actual_downstream - declared
# 4. Agent 分析差异原因(不是所有差异都是问题)
for svc in undeclared:
stats = self.traces.get_stats(service, svc)
analysis = self.llm.invoke(f"""
服务 {service} 过去24小时调用了 {svc}({stats['call_count']}次),
但拓扑图中未声明。判断:
1. 新增的正常依赖(需补充声明)?
2. 异常调用(可能 bug 或安全风险)?
输出JSON:{{"action": "add"|"investigate"|"ignore", "priority": "high"|"medium"|"low"}}
""")
return findings
同时配套 TopologyValidator 定期巡检,检查环路依赖(A→B→C→A)、孤立节点(未接入监控的服务)等。
七、Agent 快恢执行与人工审批闭环
(一)设计原则:Agent 建议,人工审批,自动执行
金融场景的核心约束是可控性——Agent 可以分析和建议,但涉及生产环境变更的操作必须人工审批。设计为三级权限模型:
| 权限级别 | Agent 能力 | 审批要求 | 示例操作 |
| L1 自主执行 | 只读查询、指标采集、现场保留 | 无需审批 | jstack/jmap/netstat/ 查 Prometheus |
| L2 建议待批 | 生成恢复方案、预检影响范围 | 人工一键审批 | 重启单实例、清理 binlog 、限流降级 |
| L3 仅建议 | 给方案和风险评估,不提供执行入口 | 需变更流程审批 | DB 主备切换、回滚发布、扩缩容 |
(二)快恢执行引擎
class RemediationAction(Enum):
CAPTURE_THREAD_DUMP = ("L1", "采集线程快照", "jstack {pid} > {output}")
CLEANUP_BINLOG = ("L2", "清理MySQL binlog", "PURGE BINARY LOGS ...")
RESTART_INSTANCE = ("L2", "重启服务实例", "kubectl rollout restart ...")
FAILOVER_DATABASE = ("L3", "数据库主备切换", "/ops/failover/mysql.sh ...")
ROLLBACK_RELEASE = ("L3", "回滚最近发布", "kubectl rollout undo ...")
class RemediationAgent:
def execute(self, root_cause: dict) -> dict:
# Step 1: 查询 Runbook 标准处理流程
# Step 2: Agent 生成恢复方案
# Step 3: 预检——评估影响范围
# Step 4: 按权限级别分流
# L1 → 自主执行;L2 → 推送审批通道(5分钟超时);L3 → 变更工单
# Step 5: L1 执行后验证是否恢复
...
审批通知示例:
【快恢审批请求】事件 INC-20260907-001
根因:mysql-primary 磁盘满(98.7%)
建议操作:清理24小时前的binlog(预计释放12GB)
权限级别:L2(需人工审批)
数据风险:低(仅清理已归档的binlog)
⏱ 审批超时:5分钟内未响应将自动取消
✅ 批准 / ❌ 拒绝
架构师视角的要点:Agent 的每个执行动作,无论 L1/L2/L3,都必须写入审计日志——"批准人、操作细节、执行结果、执行后验证",这样才能满足银保监的变更留痕要求。
八、持续学习闭环
Agent 每次处理告警事件后,自动提取经验并优化三个模型:
| 学习目标 | 优化对象 | 效果 |
| 收敛规则自优化 | 抑制规则库 | 减少误抑制和漏抑制 |
| 根因模式积累 | 历史事件向量库 | 提升相似事件匹配命中率 |
| 恢复方案验证 | Runbook 知识库 | 提升恢复建议的准确性 |
学习闭环的运转方式:事件发生 → Agent 收敛 + 根因分析 + 快恢建议 → 人工确认根因 + 执行恢复 → 事件关闭 → 复盘 Agent 自动分析(配合人工复盘反馈)→ 经验提取(新抑制规则 → 待 SRE 审核 → 规则库;根因模式 → 向量库;Runbook 更新 → 知识库)→ 下次类似事件调用历史经验,更快更准。
关键设计约束:复盘 Agent 提取的抑制规则不直接生效,而是进入 pending_review 状态,需 SRE 审核后才进入规则库。这再次体现了"Agent 建议、人工确认"的金融级可控性原则。
九、技术选型与合规设计
(一)整体技术架构
下图给出从告警源到持续学习的完整技术架构,各层组件与数据流一目了然:
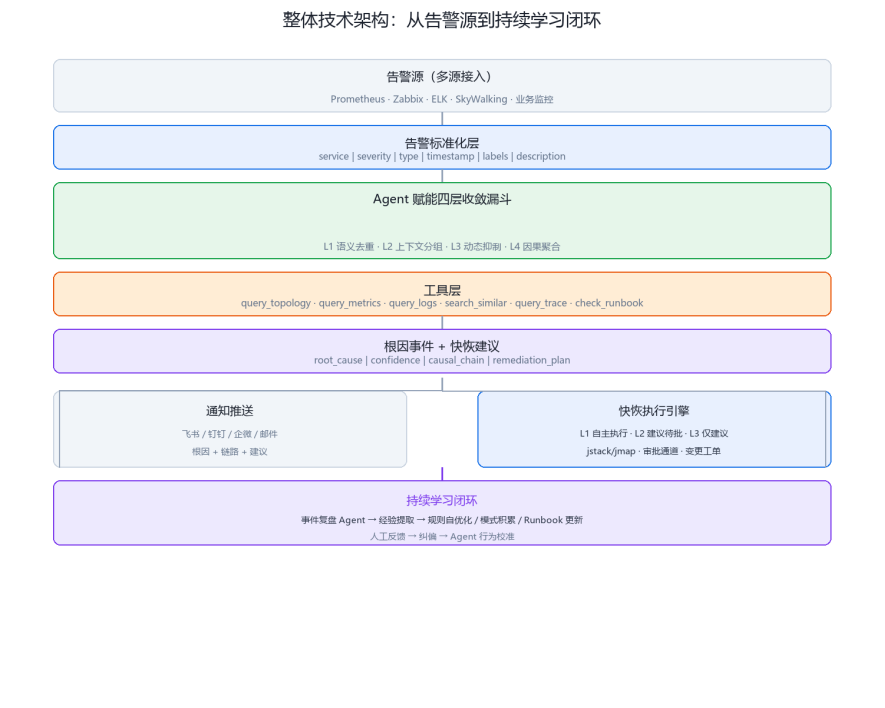
图 4:整体技术架构——从告警源到持续学习闭环
(二)Agent 技术栈
| 层级 | 组件 | 选型建议 | 选型理由 |
| LLM 推理引擎 | 大模型底座 | 混元 / 通义千问(私有部署)或 GPT-4o ( API ) | 金融场景优先私有部署,数据不出域 |
| Agent 框架 | 推理编排 | LangChain ( ReAct ) + LangGraph | ReAct 可审计, LangGraph 支持多 Agent 编排 |
| 结构化输出 | 输出约束 | Pydantic + function calling | 确保输出可被下游程序消费 |
| 工具层 | 工具封装 | LangChain Tools + 自定义 MCP Server | 标准化接口,支持热插拔 |
| 向量存储 | 语义检索 | LanceDB (轻量) / Milvus (大规模) | 语义去重 + 历史事件相似搜索 |
| 拓扑存储 | 图数据库 | Neo4j / ArangoDB | 服务依赖图 + 因果链路查询 |
| 时序数据 | 指标查询 | Prometheus + PromQL | Agent 工具层通过 HTTP API 查询 |
| 审计存储 | 推理审计 | PostgreSQL + JSONB | 存储完整推理链,支持回溯 |
(三)金融场景的合规性设计
| 合规要求 | 工程实现 |
| 推理可审计 | Agent 每步 thought/action/observation 全量写入审计库( JSONB ),支持按事件 ID 回溯完整推理链 |
| 操作可回滚 | L2/L3 操作前自动创建回滚点(如 k8s rollout 前记录 revision 号、 DB 切换前记录 binlog 位点) |
| 数据不出域 | LLM 优先私有部署,向量检索用本地 LanceDB/Milvus |
| 人工兜底 | 置信度低于阈值(如 0.7 )不自动执行,转人工分析; L3 不提供自动执行入口 |
| 变更留痕 | 所有 Agent 触发的操作生成变更工单,关联事件 ID |
| 敏感数据脱敏 | 查询日志 / 指标时通过语义层或脱敏中间件屏蔽敏感字段 |
十、工程落地路径
从金融架构师视角,Agent 化告警收敛的落地建议分三个阶段,不要一上来就"全自动",要渐进式放权:
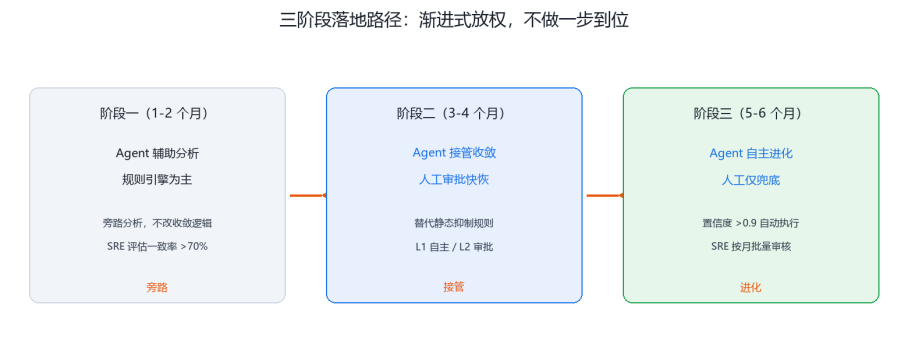 图 5:三阶段落地路径——渐进式放权,不做一步到位
阶段一(1-2 个月):Agent 辅助分析,规则引擎为主。 部署 Agent 工具层(query_topology/query_metrics/query_logs);Agent 只做"旁路分析"——对每批告警生成根因分析报告,不触发改告警收敛逻辑;SRE 团队评估 Agent 与人工判断的一致率,目标 >70%。
阶段二(3-4 个月):Agent 接管收敛,人工审批快恢。 Agent 正式接入告警收敛链路,替代静态抑制规则;L1 操作 Agent 自主执行,L2 走审批通道;持续学习闭环上线,开始积累根因模式。
阶段三(5-6 个月):Agent 自主进化,人工仅兜底。 Agent 置信度 >0.9 的 L2 操作可自动执行(仍记录审计日志);拓扑校验 Agent 定期巡检,自动提议拓扑更新;复盘 Agent 自动提取抑制规则候选,SRE 按月批量审核。
关键指标监控:
| 指标 | 阶段一目标 | 阶段二目标 | 阶段三目标 |
| 告警收敛率 | — | >80% | >90% |
| 根因准确率 | >70% | >80% | >90% |
| 1 分钟发现达成率 | — | >85% | >95% |
| 5 分钟定位达成率 | — | >75% | >90% |
| 10 分钟解决达成率 | — | >60% | >80% |
| 误抑制率 | — | <5% | <2% |
结语:一条主线,两个阶段
回顾全文,金融级 AIOps 的演进可以收敛成一句话:先用传统监控基座把"看得见"做扎实,再用 AI Agent 把"看得准"做跃迁。
给架构师的七条落地建议:
- 先建体系,再上工具。 三位一体监控体系是框架,工具是实现;先梳理业务链路和故障场景,再决定每层用什么工具。
- traceId 是全链路追踪的生命线。 从网关入口生成,透传所有下游,没有 traceId,5 分钟定位就是空谈。
- 日志格式用管道符分隔,不要 JSON。 排障用 grep/awk,不是 JSON 解析器。
- 监控用户权限最小化是合规底线。 白名单不应含任何破坏性命令,所有访问经堡垒机审计。
- 告警收敛比告警产生更重要。 不做收敛,一个数据库故障能触发上百条下游告警,5 分钟定位根本不可能。
- Agent 不是替代规则引擎,而是叠加。 规则处理已知模式,Agent 处理未知复杂模式,两者分工。
- 可控性优先于智能。 L1/L2/L3 三级权限、可审计推理链、数据不出域、人工兜底——金融场景的 AIOps 必须守住这条底线。
元信息
| 目标读者 | 中高级运维 / 架构 / SRE 开发者,关注 AIOps 、智能运维、金融级监控 |
| 前置知识 | Prometheus / Zabbix 基础、微服务拓扑、大模型 Agent ( ReAct/LangChain )基础概念 |
| 技术栈版本 | Spring Boot 4.0.1 、微信小程序基础库 3.x 、 Vue 3 、 LangChain ReAct Agent 、 bge-large-zh-v1.5 、 Neo4j 、 LanceDB |
本文面向 IT 技术人员。如对 AIOps、AI 智能体运维、金融级监控等话题感兴趣,欢迎点赞收藏、评论区交流。

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 14
 0
- 0


 已为社区贡献2条内容

所有评论(0)