AG-07_多智能体协作:模式、框架与挑战
多智能体协作:模式、框架与挑战
系列: AI Agent 工程实践 | 编号: AG-07
关键词: 多智能体系统 (MAS)、主从模式、辩论模式、CrewAI、MetaGPT、AutoGen
前言
单个 Agent 能力再强,也难以胜任需要多角色协作的复杂任务。试想一个软件开发项目:产品经理定义需求、架构师设计系统、程序员编写代码、测试工程师验证质量、运维工程师部署上线——每个角色有不同的专长和视角。多智能体系统(Multi-Agent System, MAS)正是将这种人类协作模式引入 AI Agent 架构的核心范式。
2023 年是多智能体框架爆发的一年:MetaGPT 模拟软件公司、AutoGen 提供灵活的多 Agent 对话框架、CrewAI 以角色扮演驱动协作、AgentVerse 探索大规模 Agent 社会。这些框架背后的协作模式各不相同,但都在回答同一个核心问题:多个 Agent 如何高效协作以完成复杂任务?
本文将系统梳理多智能体协作的理论基础、主流协作模式、关键框架的技术实现,并通过代码实战展示如何构建一个多 Agent 协作系统。
1. 多智能体系统的理论基础
1.1 从分布式 AI 到 LLM-based MAS
多智能体系统的研究可追溯到 1980 年代的分布式人工智能(DAI)。经典 MAS 研究关注:
- 通信:Agent 之间如何交换信息(如 FIPA-ACL 通信语言)
- 协调:如何避免冲突、同步行动
- 协商:如何在利益冲突时达成一致
- 组织:如何形成有效的团队结构
当 LLM 成为 Agent 的认知引擎后,这些经典问题有了新的解答方式:
| 维度 | 经典 MAS | LLM-based MAS |
|---|---|---|
| 通信语言 | FIPA-ACL, KQML | 自然语言 |
| 知识表示 | 本体论, 语义网 | LLM 隐式知识 |
| 决策机制 | 博弈论, 效用函数 | LLM 推理 |
| 组织结构 | 预定义角色和协议 | 动态角色分配 |
| 可扩展性 | 受限于通信开销 | 受限于上下文窗口和成本 |
1.2 为什么需要多 Agent?
单 Agent 架构在以下场景中会遇到瓶颈:
- 认知负载:单个 LLM 的上下文窗口有限,处理过多信息会导致"注意力稀释"
- 专业分工:不同任务可能需要不同的提示词、工具集甚至不同的模型
- 自我纠错:单 Agent 容易陷入"确认偏误",多 Agent 可以互相验证
- 并行处理:独立子任务可以由不同 Agent 并行执行
- 复杂推理:辩论和讨论可以产生比单 Agent 更深入的思考
1.3 协作的理论框架
多 Agent 协作可以从以下理论视角理解:
分布式认知(Distributed Cognition):认知不局限于单个 Agent 的"大脑",而是分布在多个 Agent 的交互过程中。一个 Agent 的输出成为另一个 Agent 的输入,整个系统的认知能力超越任何单个 Agent。
集体智慧(Collective Intelligence):类似蚁群、蜂群的涌现行为,多个简单 Agent 通过局部交互产生全局智能。关键在于设计合适的局部交互规则。
社会选择理论(Social Choice Theory):当多个 Agent 对同一问题有不同意见时,如何通过投票、辩论等机制达成集体决策。
2. 协作模式分类
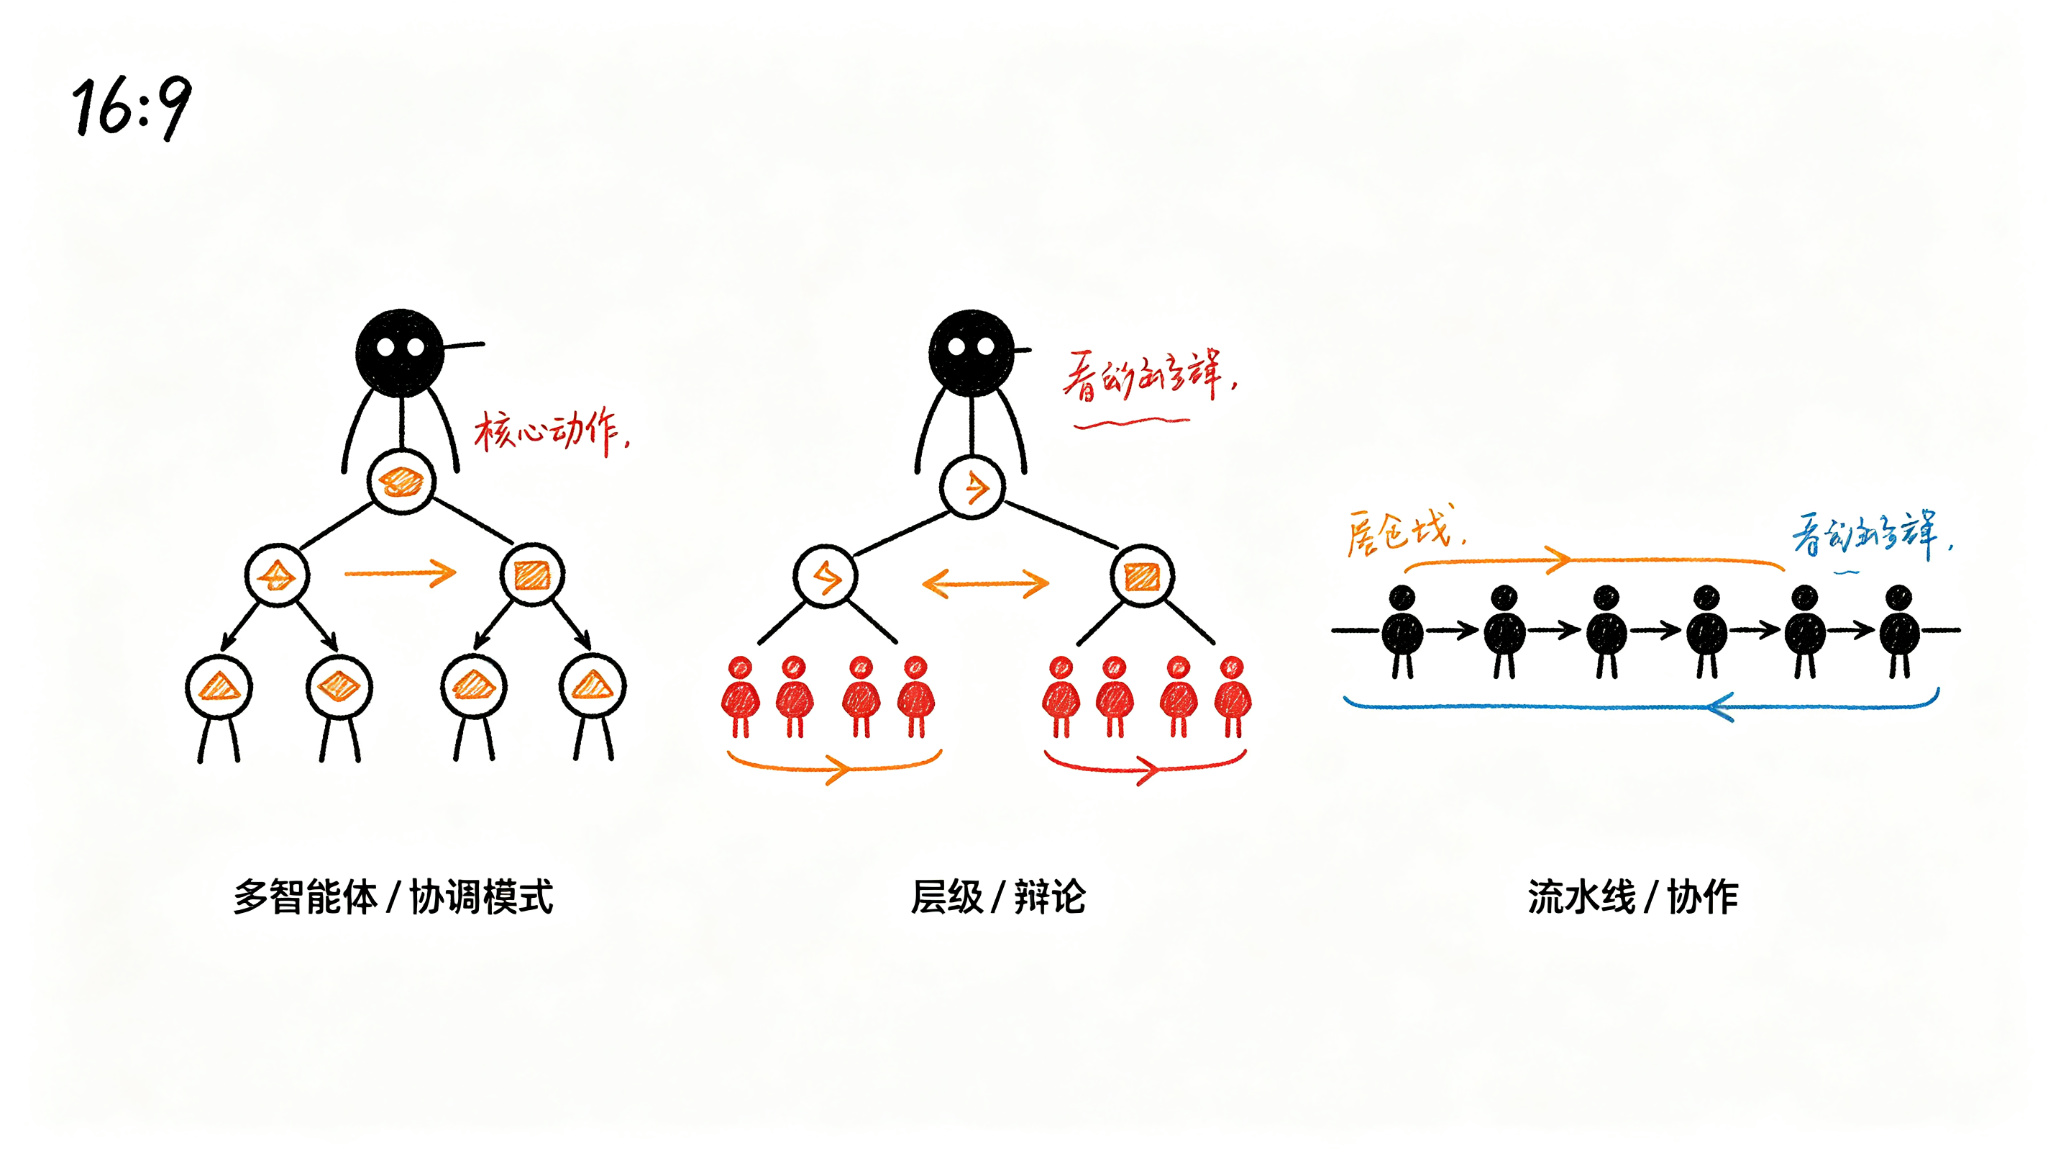
2.1 主从模式(Master-Slave / Orchestrator)
┌──────────────────┐
│   Master Agent   │ ← 任务分配与结果汇总
│  (Orchestrator)  │
└──────┬───────────┘
       │ 分配子任务
   ┌───┼───┬───┐
   ▼   ▼   ▼   ▼
 ┌──┐┌──┐┌──┐┌──┐
 │S1││S2││S3││S4│  ← Slave Agents (各自执行)
 └──┘└──┘└──┘└──┘
   │   │   │   │
   └───┼───┼───┘
       ▼
   汇总结果给 Master
核心思想:一个中心化的 Master Agent 负责任务分解、分配和结果汇总,多个 Slave Agent 各自执行分配到的子任务。
优势:
- 结构清晰,易于实现和调试
- Master 拥有全局视野,可以做出最优分配
- 结果可控,质量有保障
劣势:
- Master 是单点瓶颈
- Slave Agent 之间无直接通信,缺乏横向协作
- 扩展性受限于 Master 的处理能力
适用场景:任务可以清晰分解为独立子任务,子任务之间依赖较少。
2.2 辩论模式(Debate)
┌────────┐   观点    ┌────────┐
│Agent A │ ◄────────► │Agent B │
│(正方)   │   反驳    │(反方)   │
└────┬───┘           └───┬────┘
     │                   │
     └─────┐     ┌───────┘
           ▼     ▼
       ┌────────────┐
       │  Judge /    │  ← 最终裁决或共识
       │  Consensus  │
       └────────────┘
核心思想:多个 Agent 对同一问题提出不同观点,通过多轮辩论逐步收敛到更可靠的答案。
优势:
- 减少单 Agent 的偏见和幻觉
- 辩论过程产生更全面的分析
- 适合需要批判性思维的任务
劣势:
- 多轮辩论的 token 消耗大
- 可能陷入无休止的争论
- 需要设计合理的终止条件
适用场景:决策类问题、代码审查、论文评审、风险评估。
2.3 流水线模式(Pipeline)
┌────────┐    ┌────────┐    ┌────────┐    ┌────────┐
│Agent 1 │───►│Agent 2 │───►│Agent 3 │───►│Agent 4 │
│(需求分析)│    │(设计)   │    │(编码)   │    │(测试)   │
└────────┘    └────────┘    └────────┘    └────────┘
核心思想:任务按阶段流转,每个 Agent 处理一个阶段,输出作为下一阶段的输入。
优势:
- 符合人类工作流的直觉
- 每个 Agent 专注于自己的阶段
- 质量控制可以在每个阶段进行
劣势:
- 单点失败会阻塞整个流水线
- 后续 Agent 无法纠正前序 Agent 的错误
- 总延迟是各阶段延迟之和
适用场景:有明确阶段划分的任务,如内容创作(调研→写作→编辑→发布)。
2.4 投票模式(Voting)
┌────────┐  ┌────────┐  ┌────────┐
│Agent 1 │  │Agent 2 │  │Agent 3 │
│ 答案: A │  │ 答案: A │  │ 答案: B │
└────┬───┘  └────┬───┘  └────┬───┘
     │           │           │
     └─────┬─────┘───────────┘
           ▼
      投票统计: A=2, B=1
      最终答案: A
核心思想:多个 Agent 独立回答同一问题,通过投票选出最终答案。类似集成学习(Ensemble Learning)的思想。
优势:
- 简单高效
- 有效降低随机错误
- 可以并行执行
劣势:
- 需要多个 Agent(成本倍增)
- 如果错误是系统性的(所有 Agent 犯同样的错),投票无效
- 不适合开放性问题
适用场景:有标准答案的事实性问题、分类任务。
2.5 模式对比总结
| 模式 | 通信复杂度 | 适合任务类型 | 典型框架 | 成本 |
|---|---|---|---|---|
| 主从 | O(n) | 可分解的子任务 | CrewAI, LangGraph | 中 |
| 辩论 | O(n²) | 决策、评估 | ChatEval, AgentVerse | 高 |
| 流水线 | O(n) | 阶段性任务 | MetaGPT | 中 |
| 投票 | O(n) | 事实性问答 | Self-Consistency | 高 |
| 混合 | 可变 | 复杂综合任务 | AutoGen | 高 |
3. 主流框架对比
3.1 MetaGPT — 模拟软件公司
MetaGPT 由 Hong et al. (2023) 提出,核心思想是将软件公司的组织结构映射到多 Agent 系统:
- 产品经理:将用户需求转化为 PRD(产品需求文档)
- 架构师:将 PRD 转化为系统设计
- 项目经理:将设计分解为开发任务
- 程序员:编写代码
- 测试工程师:编写测试用例
MetaGPT 的关键创新是标准化操作程序(SOP):每个角色不仅输出自然语言,还输出结构化文档(如需求文档、API 设计文档、代码文件)。这些结构化输出成为角色之间高效协作的"协议"。
3.2 AutoGen — 灵活的多 Agent 对话
AutoGen 由 Wu et al. (2023) 提出,提供了一个高度灵活的多 Agent 对话框架:
- 对话模式:Agent 之间通过对话进行协作
- 人类参与:人类可以作为 Agent 之一参与对话
- 代码执行:内置代码执行能力
- 灵活拓扑:支持任意的 Agent 通信拓扑
AutoGen 的核心抽象是 ConversableAgent,所有 Agent(包括人类)都可以发送和接收消息。通过定义对话规则(如谁先发言、何时结束),可以实现各种协作模式。
3.3 CrewAI — 角色扮演驱动
CrewAI 的设计理念是让 Agent 扮演特定角色(Role),通过角色定义来约束 Agent 的行为:
- 每个 Agent 有明确的角色描述、目标和背景故事
- 任务(Task)有明确的描述和期望输出
- 流程(Process)定义任务的执行顺序
CrewAI 的优势在于简洁的 API 和直觉的角色抽象,适合快速搭建多 Agent 应用。
3.4 AgentVerse — 大规模 Agent 社会
AgentVerse 由 Chen et al. (2023) 提出,探索了大规模 Agent 组成的社会系统:
- 支持数百个 Agent 同时交互
- 研究 Agent 社会中的涌现行为
- 探索集体决策和群体智能
3.5 框架对比
| 特性 | MetaGPT | AutoGen | CrewAI | AgentVerse |
|---|---|---|---|---|
| 核心抽象 | SOP + 角色 | 对话 | 角色 + 任务 | 社会模拟 |
| 通信方式 | 结构化文档 | 自然语言对话 | 任务委派 | 多种 |
| 人类参与 | 可选 | 深度集成 | 可选 | 观察者 |
| 代码执行 | ✅ | ✅ | ✅ | 有限 |
| 主要场景 | 软件开发 | 通用对话 | 通用任务 | 社会研究 |
| 学习曲线 | 中 | 低 | 低 | 高 |
| 社区活跃度 | 高 | 非常高 | 高 | 中 |
4. 代码示例:多 Agent 协作系统
4.1 主从模式实现
"""
主从模式 (Orchestrator) 多 Agent 协作系统
核心思想: Master Agent 负责任务分解和分配,
Slave Agents 专注于各自的子任务执行
"""

import json
from typing import List, Dict, Any, Callable
from dataclasses import dataclass, field
from abc import ABC, abstractmethod

# ============================================================
# 基础抽象
# ============================================================

class BaseAgent(ABC):
    """Agent 基类,定义通用接口"""

    def __init__(self, name: str, role: str, llm_client):
        self.name = name
        self.role = role
        self.llm = llm_client
        self.memory: List[Dict] = []  # 对话历史

    @abstractmethod
    def act(self, input_data: str) -> str:
        """执行动作,返回结果"""
        pass

    def remember(self, message: str, sender: str):
        """记录对话历史"""
        self.memory.append({
            "sender": sender,
            "message": message,
            "timestamp": len(self.memory)
        })

@dataclass
class SlaveAgent(BaseAgent):
    """
    从属 Agent,负责执行具体的子任务

    设计要点:
    - 每个 SlaveAgent 有明确的职责范围
    - 通过 role_prompt 约束行为
    - 工具集决定其能力边界
    """
    tools: Dict[str, Callable] = field(default_factory=dict)

    def act(self, input_data: str) -> str:
        """根据角色和输入执行任务"""
        # 构建角色特定的提示词
        prompt = f"""你是一个{self.role}。
你的职责: {self.name}

可用工具: {list(self.tools.keys())}

任务: {input_data}

请直接输出你的工作成果。如果需要使用工具,以如下格式调用:
TOOL_CALL: tool_name(arg1=value1, arg2=value2)

否则直接输出结果。"""

        response = self.llm.generate(prompt)

        # 解析并执行工具调用
        if "TOOL_CALL:" in response:
            tool_call = response.split("TOOL_CALL:")[1].strip()
            result = self._execute_tool(tool_call)
            return f"{response}\n\n工具执行结果: {result}"

        return response

    def _execute_tool(self, tool_call: str) -> str:
        """解析并执行工具调用"""
        # 简化的工具调用解析
        try:
            func_name = tool_call.split("(")[0].strip()
            if func_name in self.tools:
                return str(self.tools[func_name](tool_call))
            return f"工具 {func_name} 不存在"
        except Exception as e:
            return f"工具执行失败: {str(e)}"

class MasterAgent(BaseAgent):
    """
    主控 Agent,负责任务分解、分配和结果汇总

    核心能力:
    1. 理解复杂任务并分解为子任务
    2. 将子任务分配给合适的 Slave Agent
    3. 汇总各 Slave Agent 的结果
    4. 处理异常和失败情况
    """

    def __init__(self, name: str, llm_client, slaves: List[SlaveAgent]):
        super().__init__(name, "主控协调者", llm_client)
        self.slaves = {s.name: s for s in slaves}

    def act(self, input_data: str) -> str:
        """处理用户请求的完整流程"""
        # 步骤 1: 任务分解
        subtasks = self._decompose_task(input_data)
        print(f"[Master] 任务分解为 {len(subtasks)} 个子任务")

        # 步骤 2: 任务分配与执行
        results = {}
        for subtask in subtasks:
            agent_name = subtask["assigned_to"]
            task_desc = subtask["description"]

            if agent_name in self.slaves:
                print(f"[Master] 分配任务给 {agent_name}: {task_desc[:50]}...")
                agent = self.slaves[agent_name]
                result = agent.act(task_desc)
                results[agent_name] = result
                agent.remember(result, "self")
                print(f"[Master] {agent_name} 完成任务")
            else:
                results[agent_name] = f"错误: Agent {agent_name} 不存在"

        # 步骤 3: 结果汇总
        summary = self._summarize_results(input_data, results)
        return summary

    def _decompose_task(self, task: str) -> List[Dict]:
        """
        使用 LLM 将复杂任务分解为子任务

        关键设计: 提示词中包含可用 Agent 的能力描述,
        让 LLM 在分解时考虑任务分配
        """
        agent_descs = "\n".join(
            f"- {name}: {agent.role}" for name, agent in self.slaves.items()
        )

        prompt = f"""你是一个任务分解专家。请将以下任务分解为子任务,并分配给合适的执行者。

任务: {task}

可用执行者:
{agent_descs}

请以 JSON 格式输出:
{{"subtasks": [
  {{"id": 1, "description": "子任务描述", "assigned_to": "执行者名称", "priority": "high/medium/low"}}
]}}

要求:
1. 每个子任务应该原子化,可独立执行
2. 分配给最合适的执行者
3. 考虑任务之间的依赖关系"""

        response = self.llm.generate(prompt)
        try:
            data = json.loads(response)
            return data.get("subtasks", [])
        except json.JSONDecodeError:
            return [{"id": 1, "description": task, "assigned_to": list(self.slaves.keys())[0]}]

    def _summarize_results(self, original_task: str, results: Dict[str, str]) -> str:
        """汇总所有子任务的结果,生成最终报告"""
        results_text = "\n\n".join(
            f"【{name}】:\n{result}" for name, result in results.items()
        )

        prompt = f"""请根据以下各执行者的输出,汇总生成最终结果。

原始任务: {original_task}

各执行者的结果:
{results_text}

请生成一个完整、连贯的最终报告。"""

        return self.llm.generate(prompt)

# ============================================================
# 使用示例
# ============================================================

if __name__ == "__main__":
    # 创建各角色 Agent
    researcher = SlaveAgent(
        name="研究员",
        role="负责信息搜索和资料收集",
        llm_client=None
    )

    writer = SlaveAgent(
        name="撰稿人",
        role="负责文字撰写和内容组织",
        llm_client=None
    )

    reviewer = SlaveAgent(
        name="审稿人",
        role="负责内容审查和质量把控",
        llm_client=None
    )

    # 创建主控 Agent
    master = MasterAgent(
        name="项目主管",
        llm_client=None,
        slaves=[researcher, writer, reviewer]
    )

    # 执行任务
    # result = master.act("撰写一篇关于 AI Agent 技术趋势的分析报告")
    # print(result)
4.2 辩论模式实现
"""
辩论模式 (Debate) 多 Agent 协作系统
核心思想: 多个 Agent 对同一问题提出不同观点,
通过多轮辩论收敛到更可靠的结论

论文参考: Du et al. "Improving Factuality and Reasoning in Language Models
through Multiagent Debate" (2023)
"""

from typing import List, Dict, Optional
from dataclasses import dataclass

@dataclass
class DebateRound:
    """辩论轮次记录"""
    round_num: int
    agent_name: str
    position: str      # 立场
    argument: str      # 论据
    response_to: Optional[str] = None  # 回应哪个 Agent 的观点

class DebateAgent:
    """辩论 Agent,持有特定立场"""

    def __init__(self, name: str, stance: str, llm_client):
        """
        Args:
            name: Agent 名称
            stance: 初始立场描述 (如 "支持" / "反对" / "中立分析")
            llm_client: LLM 接口
        """
        self.name = name
        self.stance = stance
        self.llm = llm_client
        self.arguments: List[str] = []

    def formulate_argument(
        self, topic: str, debate_history: List[DebateRound]
    ) -> str:
        """
        基于辩论历史形成论点

        关键设计: Agent 不仅表达自己的观点,
        还需要回应其他 Agent 的论点,
        从而实现真正的"辩论"而非"独白"
        """
        # 整理辩论历史
        history_text = ""
        for record in debate_history:
            if record.agent_name == self.name:
                history_text += f"\n[我方 上一轮]: {record.argument}"
            else:
                history_text += f"\n[{record.agent_name}]: {record.argument}"

        prompt = f"""你正在参与一场辩论。

辩题: {topic}
你的立场: {self.stance}

辩论历史:
{history_text if history_text else "(第一轮,尚无历史)"}

请提出你的论点。要求:
1. 基于事实和逻辑推理
2. 如果是后续轮次,必须回应其他参与者的论点
3. 指出对方论点中的漏洞
4. 提供支持你立场的新证据或推理
5. 保持客观理性

输出你的论点:"""

        argument = self.llm.generate(prompt)
        self.arguments.append(argument)
        return argument

    def update_stance(self, topic: str, debate_history: List[DebateRound]) -> bool:
        """
        根据辩论进展更新立场

        设计要点: 允许 Agent 被说服改变立场,
        这是辩论模式的核心价值 —— 通过理性讨论修正观点
        """
        history_text = "\n".join(
            f"[{r.agent_name}]: {r.argument}" for r in debate_history
        )

        prompt = f"""回顾以下辩论,评估你的立场是否需要调整。

辩题: {topic}
你当前的立场: {self.stance}

辩论记录:
{history_text}

你是否需要调整立场?
- 如果不需要,回答 "KEEP"
- 如果需要,回答 "CHANGE: 新立场描述"

回答:"""

        response = self.llm.generate(prompt).strip()
        if response.startswith("CHANGE:"):
            new_stance = response.split(":", 1)[1].strip()
            print(f"[{self.name}] 立场更新: {self.stance} → {new_stance}")
            self.stance = new_stance
            return True
        return False

class DebateOrchestrator:
    """
    辩论协调器

    管理辩论流程:
    1. 初始化辩手
    2. 轮流发言
    3. 中间检查立场变化
    4. 最终裁决或共识生成
    """

    def __init__(self, agents: List[DebateAgent], judge_llm=None):
        self.agents = agents
        self.judge_llm = judge_llm or agents[0].llm  # 默认用第一个 Agent 的 LLM 做裁判
        self.history: List[DebateRound] = []

    def run_debate(self, topic: str, max_rounds: int = 3) -> str:
        """
        运行完整辩论流程

        流程:
        - 每轮所有 Agent 依次发言
        - 每轮结束后检查立场变化
        - 如果所有 Agent 达成共识,提前结束
        - 最多进行 max_rounds 轮
        """
        print(f"{'='*60}")
        print(f"辩论主题: {topic}")
        print(f"参与人数: {len(self.agents)}")
        print(f"{'='*60}")

        for round_num in range(1, max_rounds + 1):
            print(f"\n--- 第 {round_num} 轮辩论 ---")

            # 每个 Agent 依次发言
            for agent in self.agents:
                argument = agent.formulate_argument(topic, self.history)
                record = DebateRound(
                    round_num=round_num,
                    agent_name=agent.name,
                    position=agent.stance,
                    argument=argument
                )
                self.history.append(record)
                print(f"[{agent.name}] ({agent.stance}): {argument[:150]}...")

            # 检查立场变化
            stance_changed = False
            for agent in self.agents:
                if agent.update_stance(topic, self.history):
                    stance_changed = True

            # 检查是否达成共识
            stances = set(a.stance for a in self.agents)
            if len(stances) == 1:
                print(f"\n[共识达成!] 所有参与者立场一致: {stances.pop()}")
                break

        # 生成裁决
        return self._generate_verdict(topic)

    def _generate_verdict(self, topic: str) -> str:
        """
        由裁判 Agent 生成最终裁决

        裁判综合考虑所有论点的质量和说服力,
        而非简单投票
        """
        all_arguments = "\n\n".join(
            f"【{r.agent_name} - 第{r.round_num}轮 - 立场: {r.position}】\n{r.argument}"
            for r in self.history
        )

        prompt = f"""你是一场辩论的裁判。请根据以下辩论记录,做出最终裁决。

辩题: {topic}

辩论记录:
{all_arguments}

请从以下角度进行裁决:
1. 哪方的论据更有说服力?为什么?
2. 有哪些关键分歧点?
3. 综合各方观点,最合理的结论是什么?

裁决结果:"""

        return self.judge_llm.generate(prompt)

# ============================================================
# 使用示例
# ============================================================

if __name__ == "__main__":
    # 创建正反方辩手和中立分析师
    pro_agent = DebateAgent(name="正方", stance="支持", llm_client=None)
    con_agent = DebateAgent(name="反方", stance="反对", llm_client=None)
    analyst = DebateAgent(name="分析师", stance="中立分析", llm_client=None)

    # 创建辩论协调器
    orchestrator = DebateOrchestrator(
        agents=[pro_agent, con_agent, analyst]
    )

    # 运行辩论
    # verdict = orchestrator.run_debate(
    #     "AI Agent 是否会在 5 年内取代大部分软件开发工作?",
    #     max_rounds=3
    # )
    # print(verdict)
4.3 流水线模式实现
"""
流水线模式 (Pipeline) 多 Agent 协作系统
核心思想: 任务按阶段流转,每个 Agent 处理一个阶段
输出作为下一阶段的输入

典型应用: 内容创作流水线
调研 → 大纲 → 撰写 → 编辑 → 审校
"""

from typing import List, Dict, Any, Optional
from dataclasses import dataclass, field

@dataclass
class PipelineStage:
    """流水线阶段定义"""
    name: str
    agent_role: str
    description: str
    input_format: str   # 期望的输入格式描述
    output_format: str  # 承诺的输出格式描述

@dataclass
class StageResult:
    """单个阶段的执行结果"""
    stage_name: str
    input_data: str
    output_data: str
    quality_score: float  # 质量评分 0-1
    feedback: Optional[str] = None

class PipelineAgent:
    """流水线中的阶段 Agent"""

    def __init__(self, stage: PipelineStage, llm_client, quality_checker=None):
        self.stage = stage
        self.llm = llm_client
        self.quality_checker = quality_checker

    def process(self, input_data: str, context: Dict[str, Any] = None) -> StageResult:
        """
        处理输入数据,生成阶段输出

        关键设计:
        1. 明确的输入输出格式约定
        2. 内置质量检查机制
        3. 上下文传递(前面阶段的结果)
        """
        # 构建提示词
        context_text = ""
        if context:
            context_text = "\n\n前序阶段的输出:\n" + "\n".join(
                f"【{k}】:\n{v}" for k, v in context.items()
            )

        prompt = f"""你是一位{self.stage.agent_role}。

任务: {self.stage.description}

输入格式: {self.stage.input_format}
输出格式: {self.stage.output_format}

输入内容:
{input_data}
{context_text}

请按照输出格式要求,生成你的工作成果。"""

        # 调用 LLM 生成
        output = self.llm.generate(prompt)

        # 质量检查
        quality_score, feedback = self._check_quality(input_data, output)

        return StageResult(
            stage_name=self.stage.name,
            input_data=input_data,
            output_data=output,
            quality_score=quality_score,
            feedback=feedback
        )

    def _check_quality(self, input_data: str, output: str) -> tuple:
        """
        质量检查

        如果质量不达标,可以在流水线中触发重试
        """
        if self.quality_checker:
            prompt = f"""评估以下工作成果的质量 (0-10分):

输入: {input_data[:200]}
输出: {output[:500]}

评分标准:
- 是否符合格式要求
- 内容质量
- 与输入的相关性

回答格式: score|feedback"""

            response = self.quality_checker.generate(prompt)
            try:
                parts = response.split("|")
                score = float(parts[0].strip()) / 10
                feedback = parts[1].strip() if len(parts) > 1 else ""
                return score, feedback
            except (ValueError, IndexError):
                return 0.8, ""

        return 1.0, ""

class Pipeline:
    """
    流水线编排器

    核心功能:
    1. 定义阶段和执行顺序
    2. 执行流水线
    3. 处理质量问题(重试、跳过、回退)
    4. 收集中间结果用于上下文
    """

    def __init__(self, stages: List[PipelineStage], llm_client, max_retries: int = 2):
        self.stages = stages
        self.llm = llm_client
        self.max_retries = max_retries
        self.results: List[StageResult] = []

    def run(self, initial_input: str) -> str:
        """
        执行完整流水线

        流程:
        1. 按顺序执行每个阶段
        2. 将前序阶段的结果作为上下文
        3. 质量不达标时重试
        4. 返回最终结果
        """
        current_input = initial_input
        context: Dict[str, str] = {}  # 累积的前序结果

        for i, stage_def in enumerate(self.stages):
            print(f"\n[Pipeline] 阶段 {i+1}/{len(self.stages)}: {stage_def.name}")

            agent = PipelineAgent(stage_def, self.llm)

            # 执行阶段(支持重试)
            for attempt in range(self.max_retries + 1):
                result = agent.process(current_input, context)

                if result.quality_score >= 0.7:
                    print(f"  ✅ 质量评分: {result.quality_score:.2f}")
                    break
                elif attempt < self.max_retries:
                    print(f"  ⚠️ 质量不达标 ({result.quality_score:.2f}),重试 {attempt+1}/{self.max_retries}")
                    # 将反馈注入下一次尝试
                    current_input += f"\n\n[改进要求]: {result.feedback}"
                else:
                    print(f"  ❌ 达到最大重试次数,使用当前结果")

            # 记录结果
            self.results.append(result)

            # 更新上下文和输入
            context[stage_def.name] = result.output_data
            current_input = result.output_data

        # 返回最终阶段的输出
        return self.results[-1].output_data if self.results else ""

    def get_pipeline_report(self) -> str:
        """生成流水线执行报告"""
        report_lines = ["流水线执行报告", "=" * 40]

        for result in self.results:
            status = "✅" if result.quality_score >= 0.7 else "⚠️"
            report_lines.append(
                f"{status} {result.stage_name}: 质量={result.quality_score:.2f}"
            )
            if result.feedback:
                report_lines.append(f"   反馈: {result.feedback}")

        return "\n".join(report_lines)

# ============================================================
# 使用示例: 文章创作流水线
# ============================================================

def create_article_pipeline(llm_client) -> Pipeline:
    """
    创建文章创作流水线

    阶段: 调研 → 大纲 → 撰写 → 编辑 → 审校
    """
    stages = [
        PipelineStage(
            name="调研",
            agent_role="资深研究员",
            description="针对给定主题进行深入调研,收集关键信息和数据",
            input_format="主题描述",
            output_format="调研报告,包含关键发现、数据支撑和引用来源"
        ),
        PipelineStage(
            name="大纲",
            agent_role="内容架构师",
            description="基于调研结果,设计文章的结构和大纲",
            input_format="调研报告",
            output_format="文章大纲,包含各级标题和每节的核心论点"
        ),
        PipelineStage(
            name="撰写",
            agent_role="技术撰稿人",
            description="根据大纲和调研资料,撰写完整文章",
            input_format="文章大纲 + 调研资料",
            output_format="完整的文章正文,3000-5000字"
        ),
        PipelineStage(
            name="编辑",
            agent_role="资深编辑",
            description="审查文章质量,优化表达和结构",
            input_format="文章初稿",
            output_format="编辑后的文章,附修改说明"
        ),
        PipelineStage(
            name="审校",
            agent_role="审校专家",
            description="检查事实准确性、逻辑一致性和格式规范",
            input_format="编辑后的文章",
            output_format="最终定稿,附审校报告"
        ),
    ]

    return Pipeline(stages=stages, llm_client=llm_client)

if __name__ == "__main__":
    pipeline = create_article_pipeline(llm_client=None)
    # final_article = pipeline.run("AI Agent 的技术架构与工程实践")
    # print(pipeline.get_pipeline_report())
5. 挑战与展望
5.1 当前面临的核心挑战
通信效率问题:当 Agent 数量增加时,通信开销呈 O(n2)O(n^2)O(n2) 增长。每个 Agent 的上下文窗口有限,如何在有限的上下文中传递足够的协作信息是一个关键问题。
一致性维护:多个 Agent 可能持有不一致的信息或做出矛盾的决策。经典分布式系统中的一致性问题(CAP 定理)在多 Agent 系统中同样存在。
角色漂移:在长时间对话中,Agent 可能逐渐偏离其预定义角色。例如,一个"代码审查员"可能开始写代码而非审查代码。
成本控制:多 Agent 意味着多次 LLM 调用,token 成本线性甚至超线性增长。在实际应用中,需要在协作质量和成本之间寻找平衡。
评估困难:如何评估多 Agent 系统的整体表现?单个 Agent 的能力评估已经很困难,多 Agent 之间的交互效应使得评估更加复杂。
5.2 改进方向
| 方向 | 思路 | 潜在影响 |
|---|---|---|
| 异步协作 | Agent 之间异步通信,减少等待 | 提升效率,降低延迟 |
| 层次化组织 | 类似公司组织架构,分层管理 | 提升可扩展性 |
| 动态角色 | 根据任务动态调整 Agent 角色 | 提升灵活性 |
| 共享记忆 | Agent 共享知识库而非重复传递 | 减少 token 消耗 |
| 混合模型 | 不同 Agent 使用不同规模的模型 | 优化成本 |
| 人类监督 | 关键节点引入人类决策 | 提升可靠性 |
5.3 涌现行为与集体智能
多 Agent 系统最令人兴奋的前景是涌现行为——多个简单 Agent 通过局部交互产生复杂的全局智能。这种现象在自然界中广泛存在(蚁群、鸟群、神经网络),在 AgentVerse 等研究中已初步观察到类似现象。
例如,当多个 Agent 在模拟社会中交互时,自发形成了分工、贸易、甚至"社会规范"。这些涌现行为可能指向通往更通用人工智能的路径。
6. 工程实践建议
6.1 选择合适的协作模式
- 任务可独立分解 → 主从模式
- 需要批判性思维 → 辩论模式
- 有明确阶段 → 流水线模式
- 需要高可靠性 → 投票模式
- 复杂综合任务 → 混合模式
6.2 通信设计原则
- 结构化 > 自然语言:使用 JSON、Markdown 等结构化格式进行 Agent 间通信
- 最小信息原则:只传递必要的信息,避免上下文膨胀
- 明确角色边界:每个 Agent 的输入输出格式要明确定义
- 错误传播机制:设计清晰的错误上报和处理流程
6.3 成本优化策略
- 分层模型:核心决策用强模型(GPT-4),执行任务用快模型(GPT-3.5)
- 缓存机制:相同输入的 Agent 响应可以缓存
- 提前终止:当质量达到阈值时跳过后续阶段
- 选择性协作:简单任务用单 Agent,复杂任务才用多 Agent
总结
多智能体协作正在成为 AI Agent 工程的核心范式。本文系统梳理了:
- 理论基础:从经典 MAS 到 LLM-based MAS 的演进
- 协作模式:主从、辩论、流水线、投票四大模式的原理和适用场景
- 主流框架:MetaGPT、AutoGen、CrewAI、AgentVerse 的技术特点和对比
- 工程实践:从代码实现到成本优化的实战建议
多 Agent 系统的核心价值在于分工与协作——让每个 Agent 做自己最擅长的事,通过协作产生超越个体的集体智慧。随着 LLM 能力的持续提升和框架生态的成熟,多 Agent 协作将从研究走向大规模工程应用。
参考文献
- Hong, S. et al. (2023). “MetaGPT: Meta Programming for Multi-Agent Collaborative Framework.” arXiv:2308.00352.
- Wu, Q. et al. (2023). “AutoGen: Enabling Next-Gen LLM Applications via Multi-Agent Conversation.” arXiv:2308.08155.
- Chen, W. et al. (2023). “AgentVerse: Facilitating Multi-Agent Collaboration and Exploring Emergent Behaviors.” arXiv:2308.10848.
- Du, Y. et al. (2023). “Improving Factuality and Reasoning in Language Models through Multiagent Debate.” arXiv:2305.14325.
- Qian, C. et al. (2023). “ChatDev: Communicative Agents for Software Development.” arXiv:2307.07924.
本系列覆盖 AI 大模型基础、Agent 开发、MCP 协议、Skill 开发、RAG、模型微调、部署推理 七大方向,从入门到实战的全栈内容持续更新中。
所有文章的 Markdown 源文件、可运行代码、高清配图已整理成完整资料包。
👍 点赞 + ⭐ 关注,评论区扣「1」,挨个发你领取方式 👇

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 4
 0
- 0


 已为社区贡献19条内容

所有评论(0)