Java小白也能看懂!收藏这份AI Agent开发进阶指南,抢占高薪岗位先机!
本文深入探讨了Java AI Agent开发岗位的核心技能需求,指出除了扎实的Java后端基础,还需理解Agent的“思考”与“行动”逻辑,掌握RAG、协议、工作流等关键技术。文章以码神AI Agent一站式开发平台(Faber)为例,详细解析了企业级AI Agent平台的架构设计与实现,并介绍了Agent Skills技能系统等前沿技术。对于Java开发者,本文提供了一条从零到一完整构建企业级AI Agent平台的实战路径,帮助读者系统学习并抓住AI Agent岗位的机遇。
如何入局当下最火热的Java AI Agent开发岗位
最近跟几个做Java后端的朋友聊天,发现大家心里都有同一个焦虑:AI大模型这波浪潮已经吹了两三年了,招聘市场上"AI Agent开发"的岗位越来越多,薪资也水涨船高,但真要问"AI Agent工程师到底要会什么",很多人说不清楚——是不是就是会调个OpenAI API、包一个聊天界面?
如果只是这样,那这个岗位的门槛也太低了,不至于让企业开出这么高的薪资。真正的答案,藏在企业级AI Agent平台的架构设计里。今天就借着码神AI Agent一站式开发平台(Faber)这个真实案例,聊聊这个岗位到底需要哪些硬实力,以及普通Java开发者该怎么补齐这块能力。
岗位门槛第一层:Java后端基本功不能丢
先说个可能反直觉的事:AI Agent开发岗位,本质上招的还是Java后端工程师,只是多了一层AI能力。Faber这套系统底层就是标准的Spring Cloud Alibaba微服务架构——13个模块清晰拆分,网关做统一路由和JWT鉴权,服务间用Feign加Nacos做服务发现,PostgreSQL加Flyway做数据持久化和版本管理。这些东西如果你本来就是做Java后端出身,其实并不陌生。
换句话说,AI Agent岗位不是让你从零转行去学一门新语言,而是在你已有的Java微服务能力基础上,叠加一层AI应用开发的能力。这对大多数Java开发者来说,反而是最容易上手的转型路径。
岗位门槛第二层:真正理解Agent是怎么"思考"和"行动"的
这才是拉开差距的地方。企业要的不是"会调API"的人,而是懂得怎么设计一个Agent的推理和执行链路的人。
以Faber为例,它把Agent分成General、Deep、Supervisor三种模式,简单对话走轻量的ReAct循环,复杂任务走深度编排。Deep模式里有十几个拦截器和钩子在协同工作:任务自动拆解成清单、文件系统读写、工具调用失败自动重试、大结果自动截断防止上下文溢出、超过12万token自动摘要、子Agent动态委派……这些设计背后,都是"怎么让一个Agent在复杂业务场景里稳定可靠地跑下去"的工程经验,不是看几篇公众号文章就能悟出来的,得真正动手写过、踩过坑才有感觉。
岗位门槛第三层:RAG、协议、工作流,一个都不能少
企业级AI Agent岗位的JD里,基本都会出现这几个关键词:
- RAG检索增强:Faber用父子分段策略,子块做向量检索保证精度,父块保证上下文完整,还要针对PDF、Word、Markdown等不同格式设计不同的分块逻辑。
- 协议生态:A2A协议让Agent之间能互相发现调用,MCP协议作为工具接入的标准接口,这两个协议现在几乎是AI Agent领域的"标配词汇",简历上有没有实际做过,面试官一问就知道。
- 可视化工作流:基于StateGraph的图编排引擎,节点、边、共享状态怎么设计,这一套思路和LangGraph是相通的。
- 云原生部署与AI运维:K8s的HPA弹性伸缩、Ingress、GitOps交付,甚至把K8s运维能力做成Agent工具,让Agent能自己查Pod、拉日志、扩缩容。
除了以上这几块,还有一个近半年才真正火起来、但已经被Spring AI Alibaba、LangGraph这些主流框架原生支持的方向,那就是Agent Skills技能系统。这是Anthropic(也就是Claude背后的公司)提出的一套标准,核心思路是把Agent的专业能力做成一个个可复用、可安装、可分享的"技能包"——每个技能就是一个文件夹,里面一个SKILL.md文件用YAML加Markdown的格式声明这个技能是什么、什么时候该用它、具体怎么执行,还可以附带脚本、参考文档、模板资源。
Faber里对这套标准的落地也很有代表性:技能可以从本地公共目录加载,也可以直接从GitHub远程仓库拉取安装;Agent对话启动时,系统会读取用户绑定的技能列表,把SKILL.md里的指令动态注入到System Prompt里,Agent再根据当前对话场景自主判断要不要调用某个技能。这意味着同一个Agent,面对不同任务时可以现场"加载"完全不同的专业能力,而不是把所有工具和提示词一次性堆进去。
这个方向之所以说是"当下最流行",是因为它解决了一个业内一直头疼的问题:怎么让Agent的能力可以像插件一样被复用和分发,而不是每次都在提示词里重新造轮子。会不会设计和落地Skill系统,现在已经慢慢变成简历上一个能明显加分的项。
这几块内容,任何一块单独拎出来学,可能都要花不少时间摸索方向、踩各种环境和版本兼容的坑。这也是为什么很多Java开发者明明技术底子不差,却迟迟没能真正切入AI Agent方向——不是学不会,是缺一条从零到
一、能对应到真实企业级项目的完整路径。
想清楚这条路径之后
AI Agent开发岗位的门槛不低,但也不是遥不可及——它考验的更多是"能不能把一整套工程体系搭起来"的综合能力,而这恰恰是Java开发者最擅长的事情。找对方向,把这块拼图补上,这波岗位红利,你完全有资格去抓。
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

为什么要学习大模型?
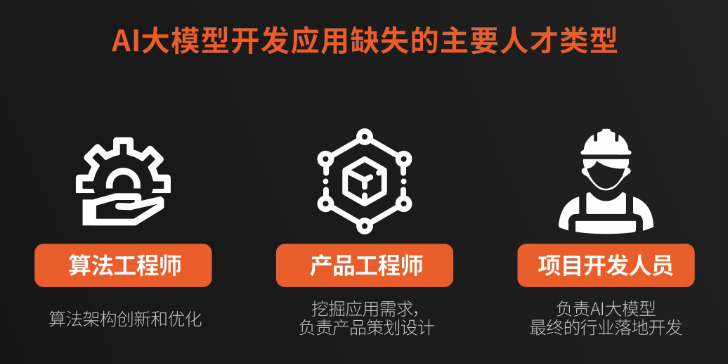
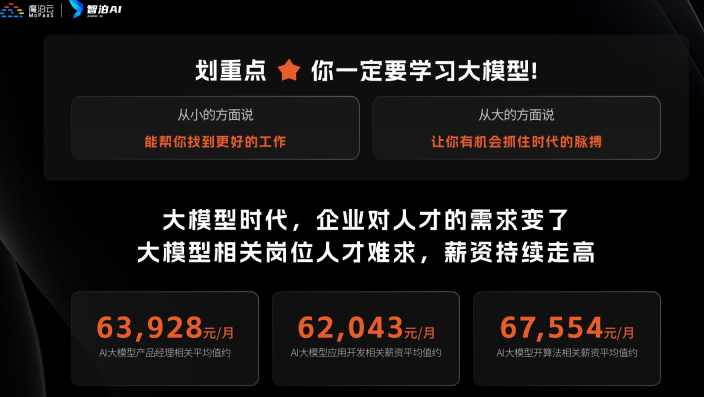
我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。
大模型入门到实战全套学习大礼包
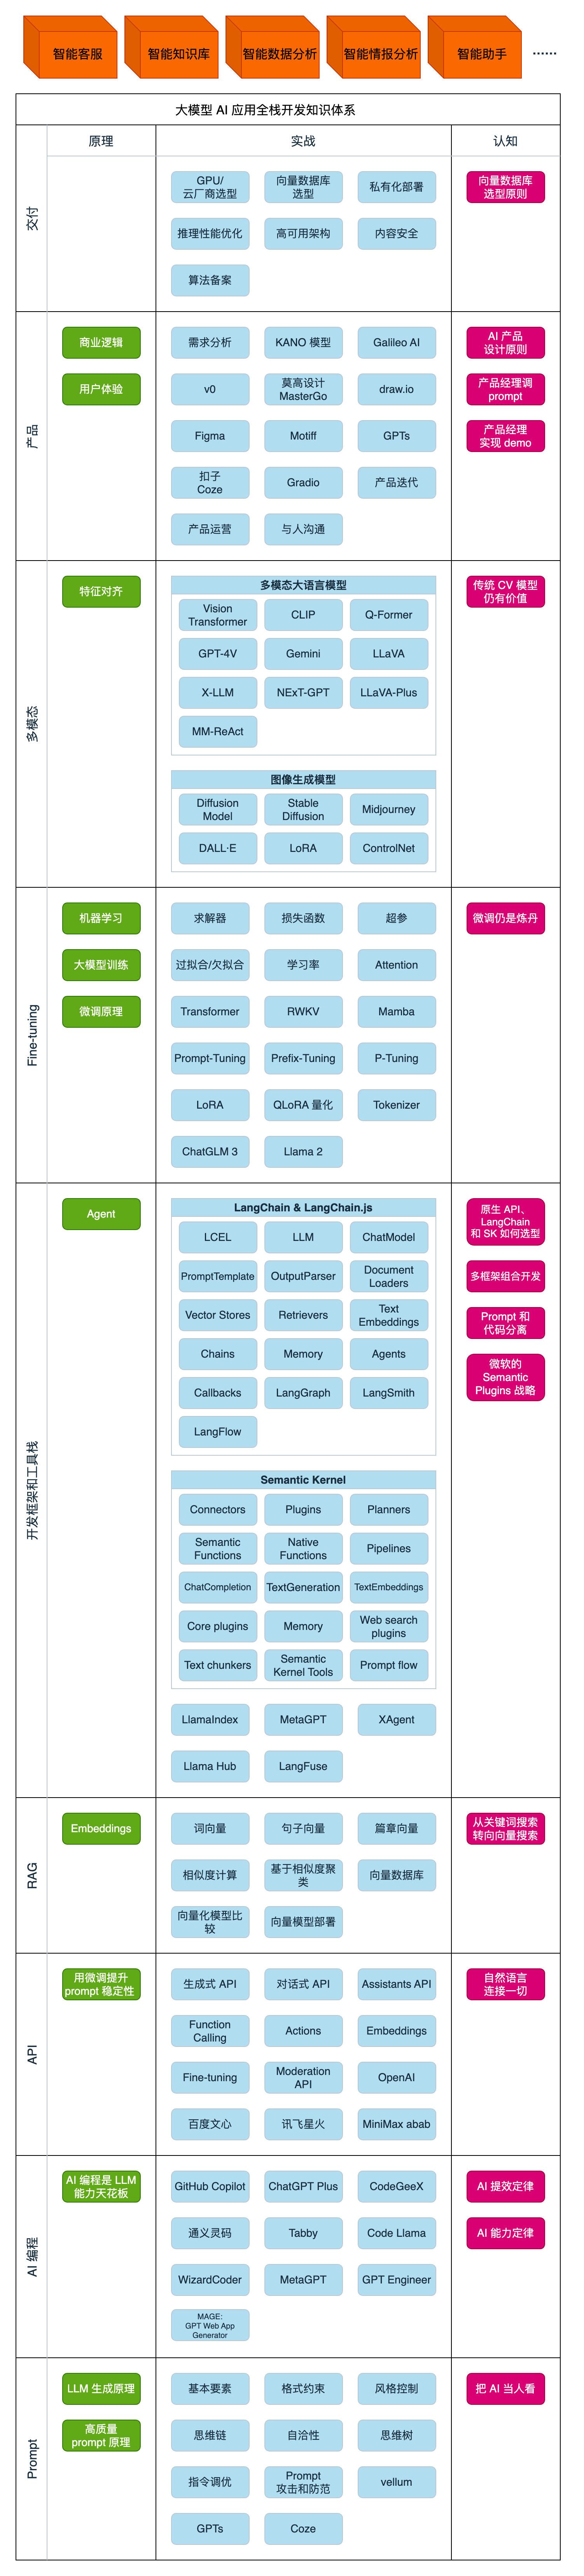
1、大模型系统化学习路线
作为学习AI大模型技术的新手,方向至关重要。 正确的学习路线可以为你节省时间,少走弯路;方向不对,努力白费。这里我给大家准备了一份最科学最系统的学习成长路线图和学习规划,带你从零基础入门到精通!
2、大模型学习书籍&文档
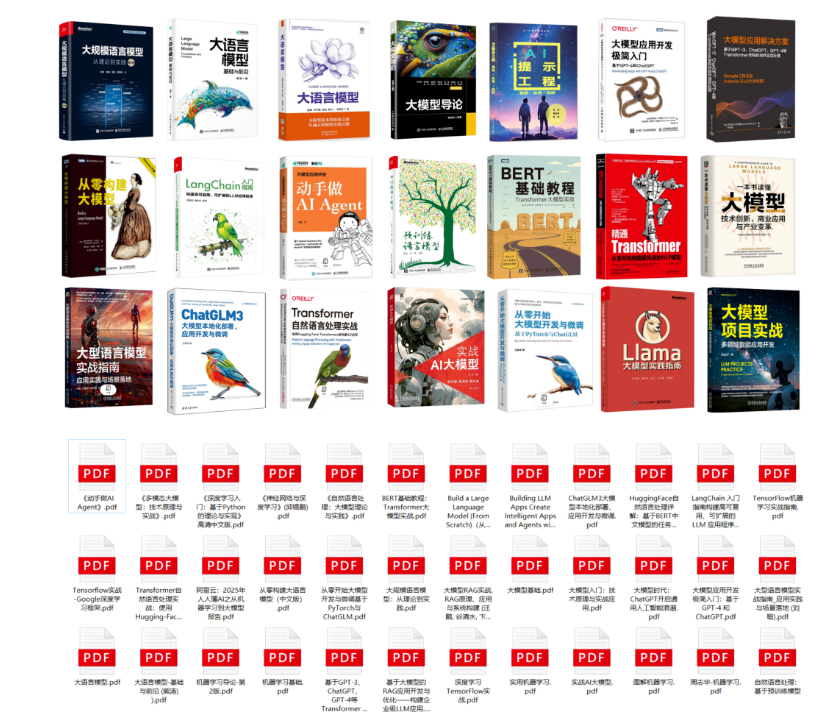
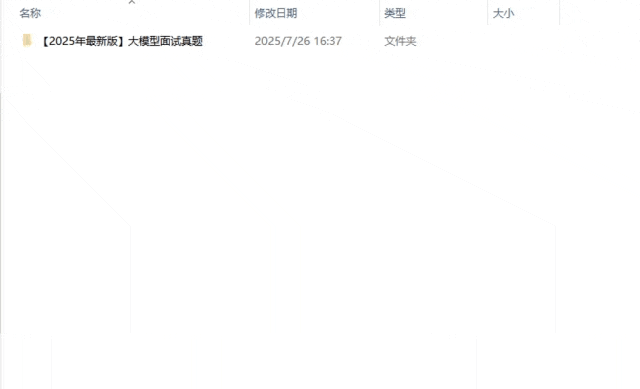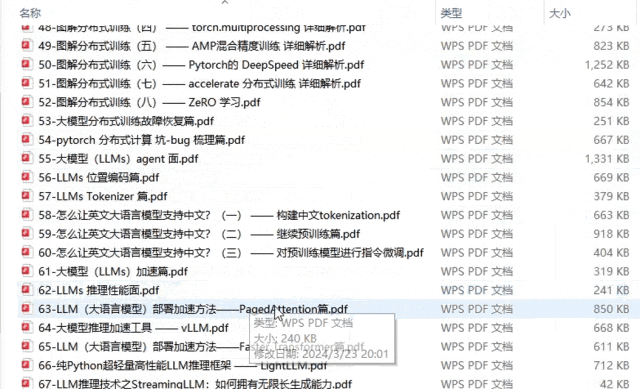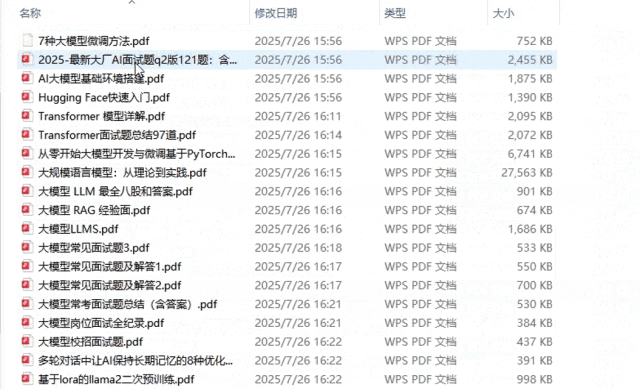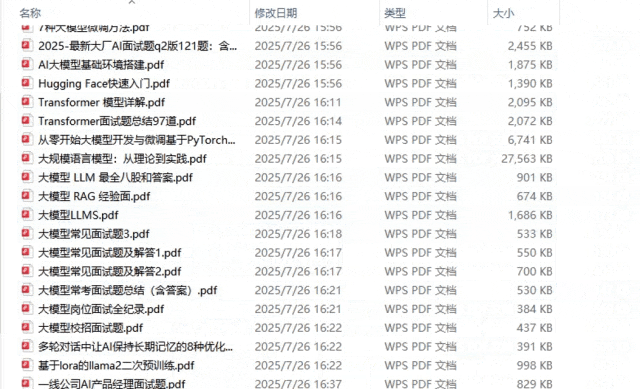
学习AI大模型离不开书籍文档,我精选了一系列大模型技术的书籍和学习文档(电子版),它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。
3、AI大模型最新行业报告
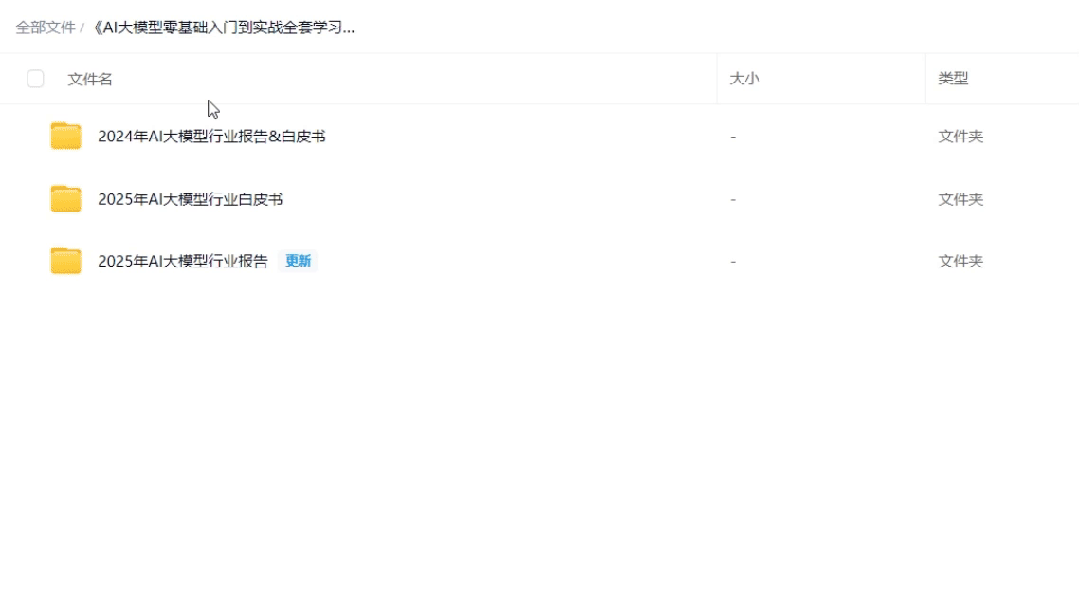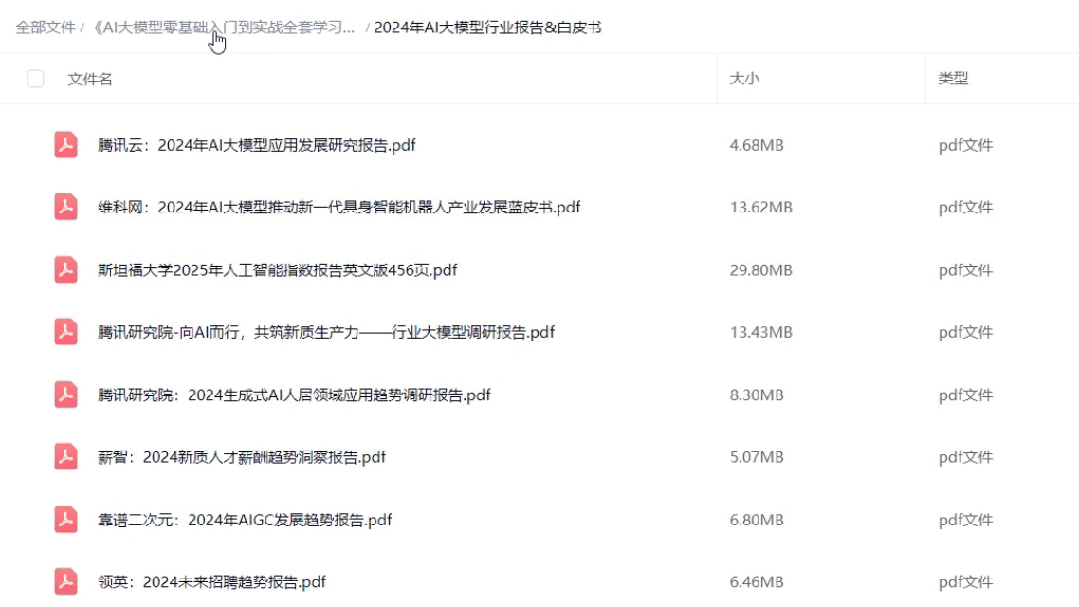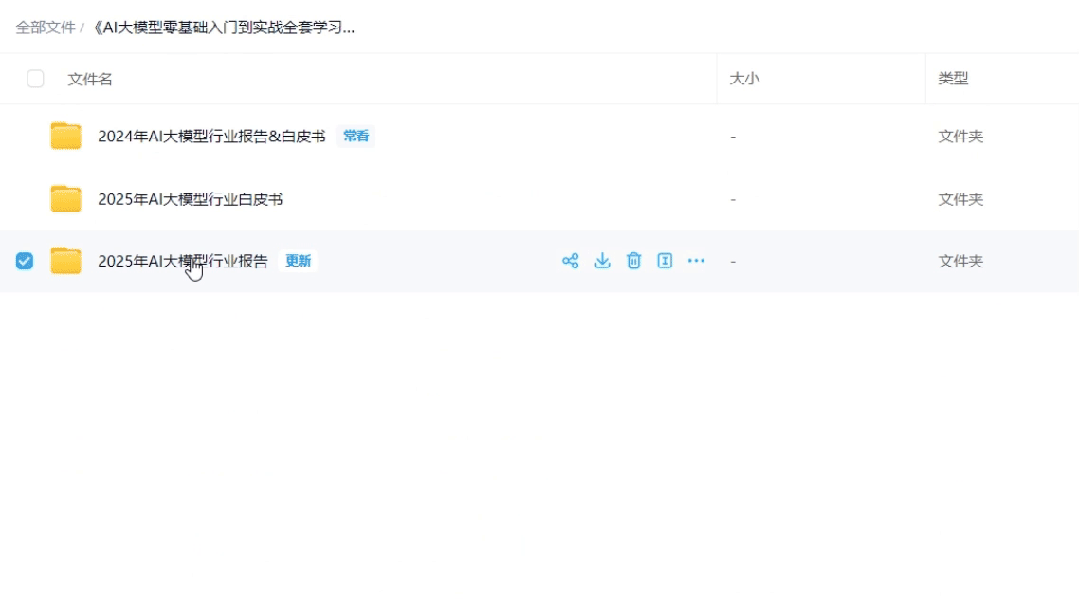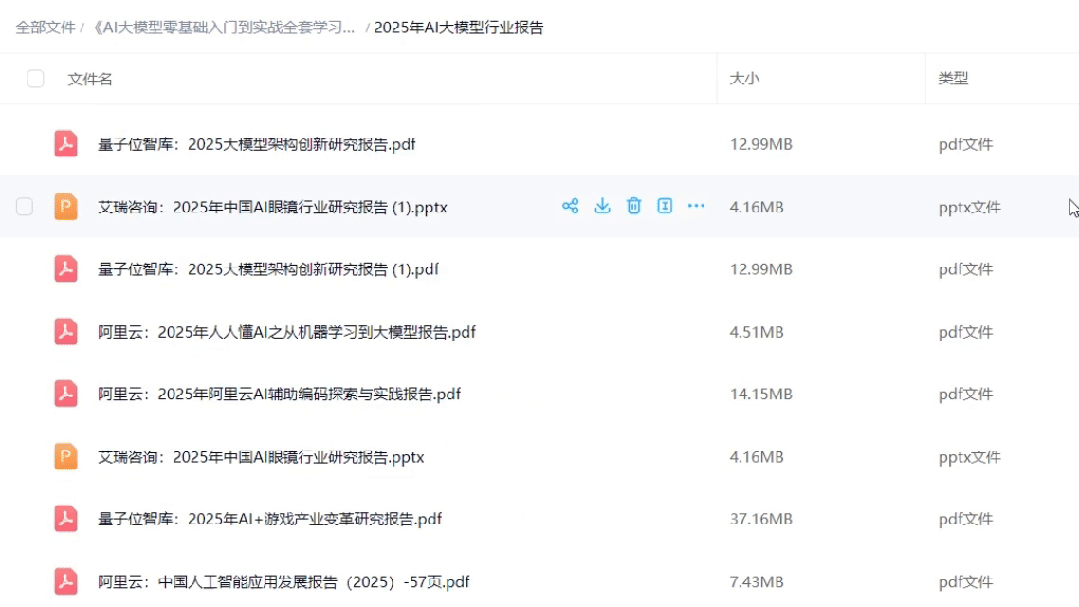
2025最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。
4、大模型项目实战&配套源码
学以致用,在项目实战中检验和巩固你所学到的知识,同时为你找工作就业和职业发展打下坚实的基础。
5、大模型大厂面试真题
面试不仅是技术的较量,更需要充分的准备。在你已经掌握了大模型技术之后,就需要开始准备面试,我精心整理了一份大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。
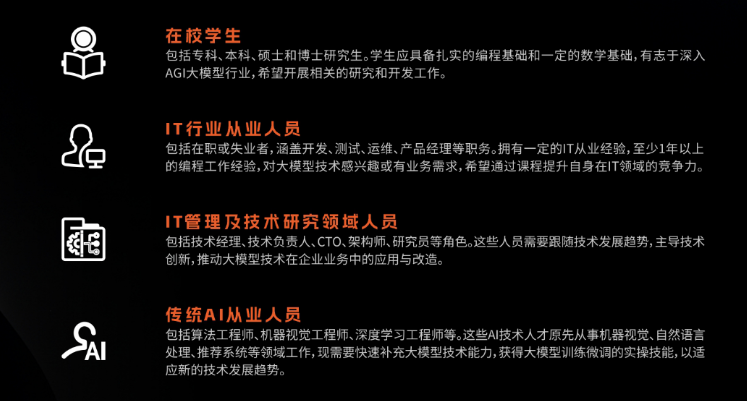
适用人群
第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐
 9
 0
- 0


 已为社区贡献13条内容

所有评论(0)