AI Agent 成本核算:模型降价后,为什么总交付成本可能没降
摘要
模型单价下降不等于 Agent 总交付成本按比例下降。本文给出“成功任务成本”的核算公式,把模型、工具、重试、人工复核、返工与等待纳入同一条事件链,并提供可落地的数据结构、模型分流配置、指标与失败边界,帮助小团队判断下一次成本优化到底该改模型还是改流程。
一次降价,为什么值得先改仪表盘
OpenAI 在 2026 年 8 月 21 日更新 GPT-5.6 页面,称 Sol 的 API 与 credit 价格降低 20% 以上,持续三个月。模型降价本身是明确利好,但它没有自动回答另一个问题:跑完一条 Agent 工作流后,每个合格交付究竟便宜了多少?
官方当前的 API 定价页按每 100 万 Token 报价,还区分输入、缓存、输出、处理模式与上下文长度。即使先不考虑这些差异,Token 也只是 Agent 成本链的一环。
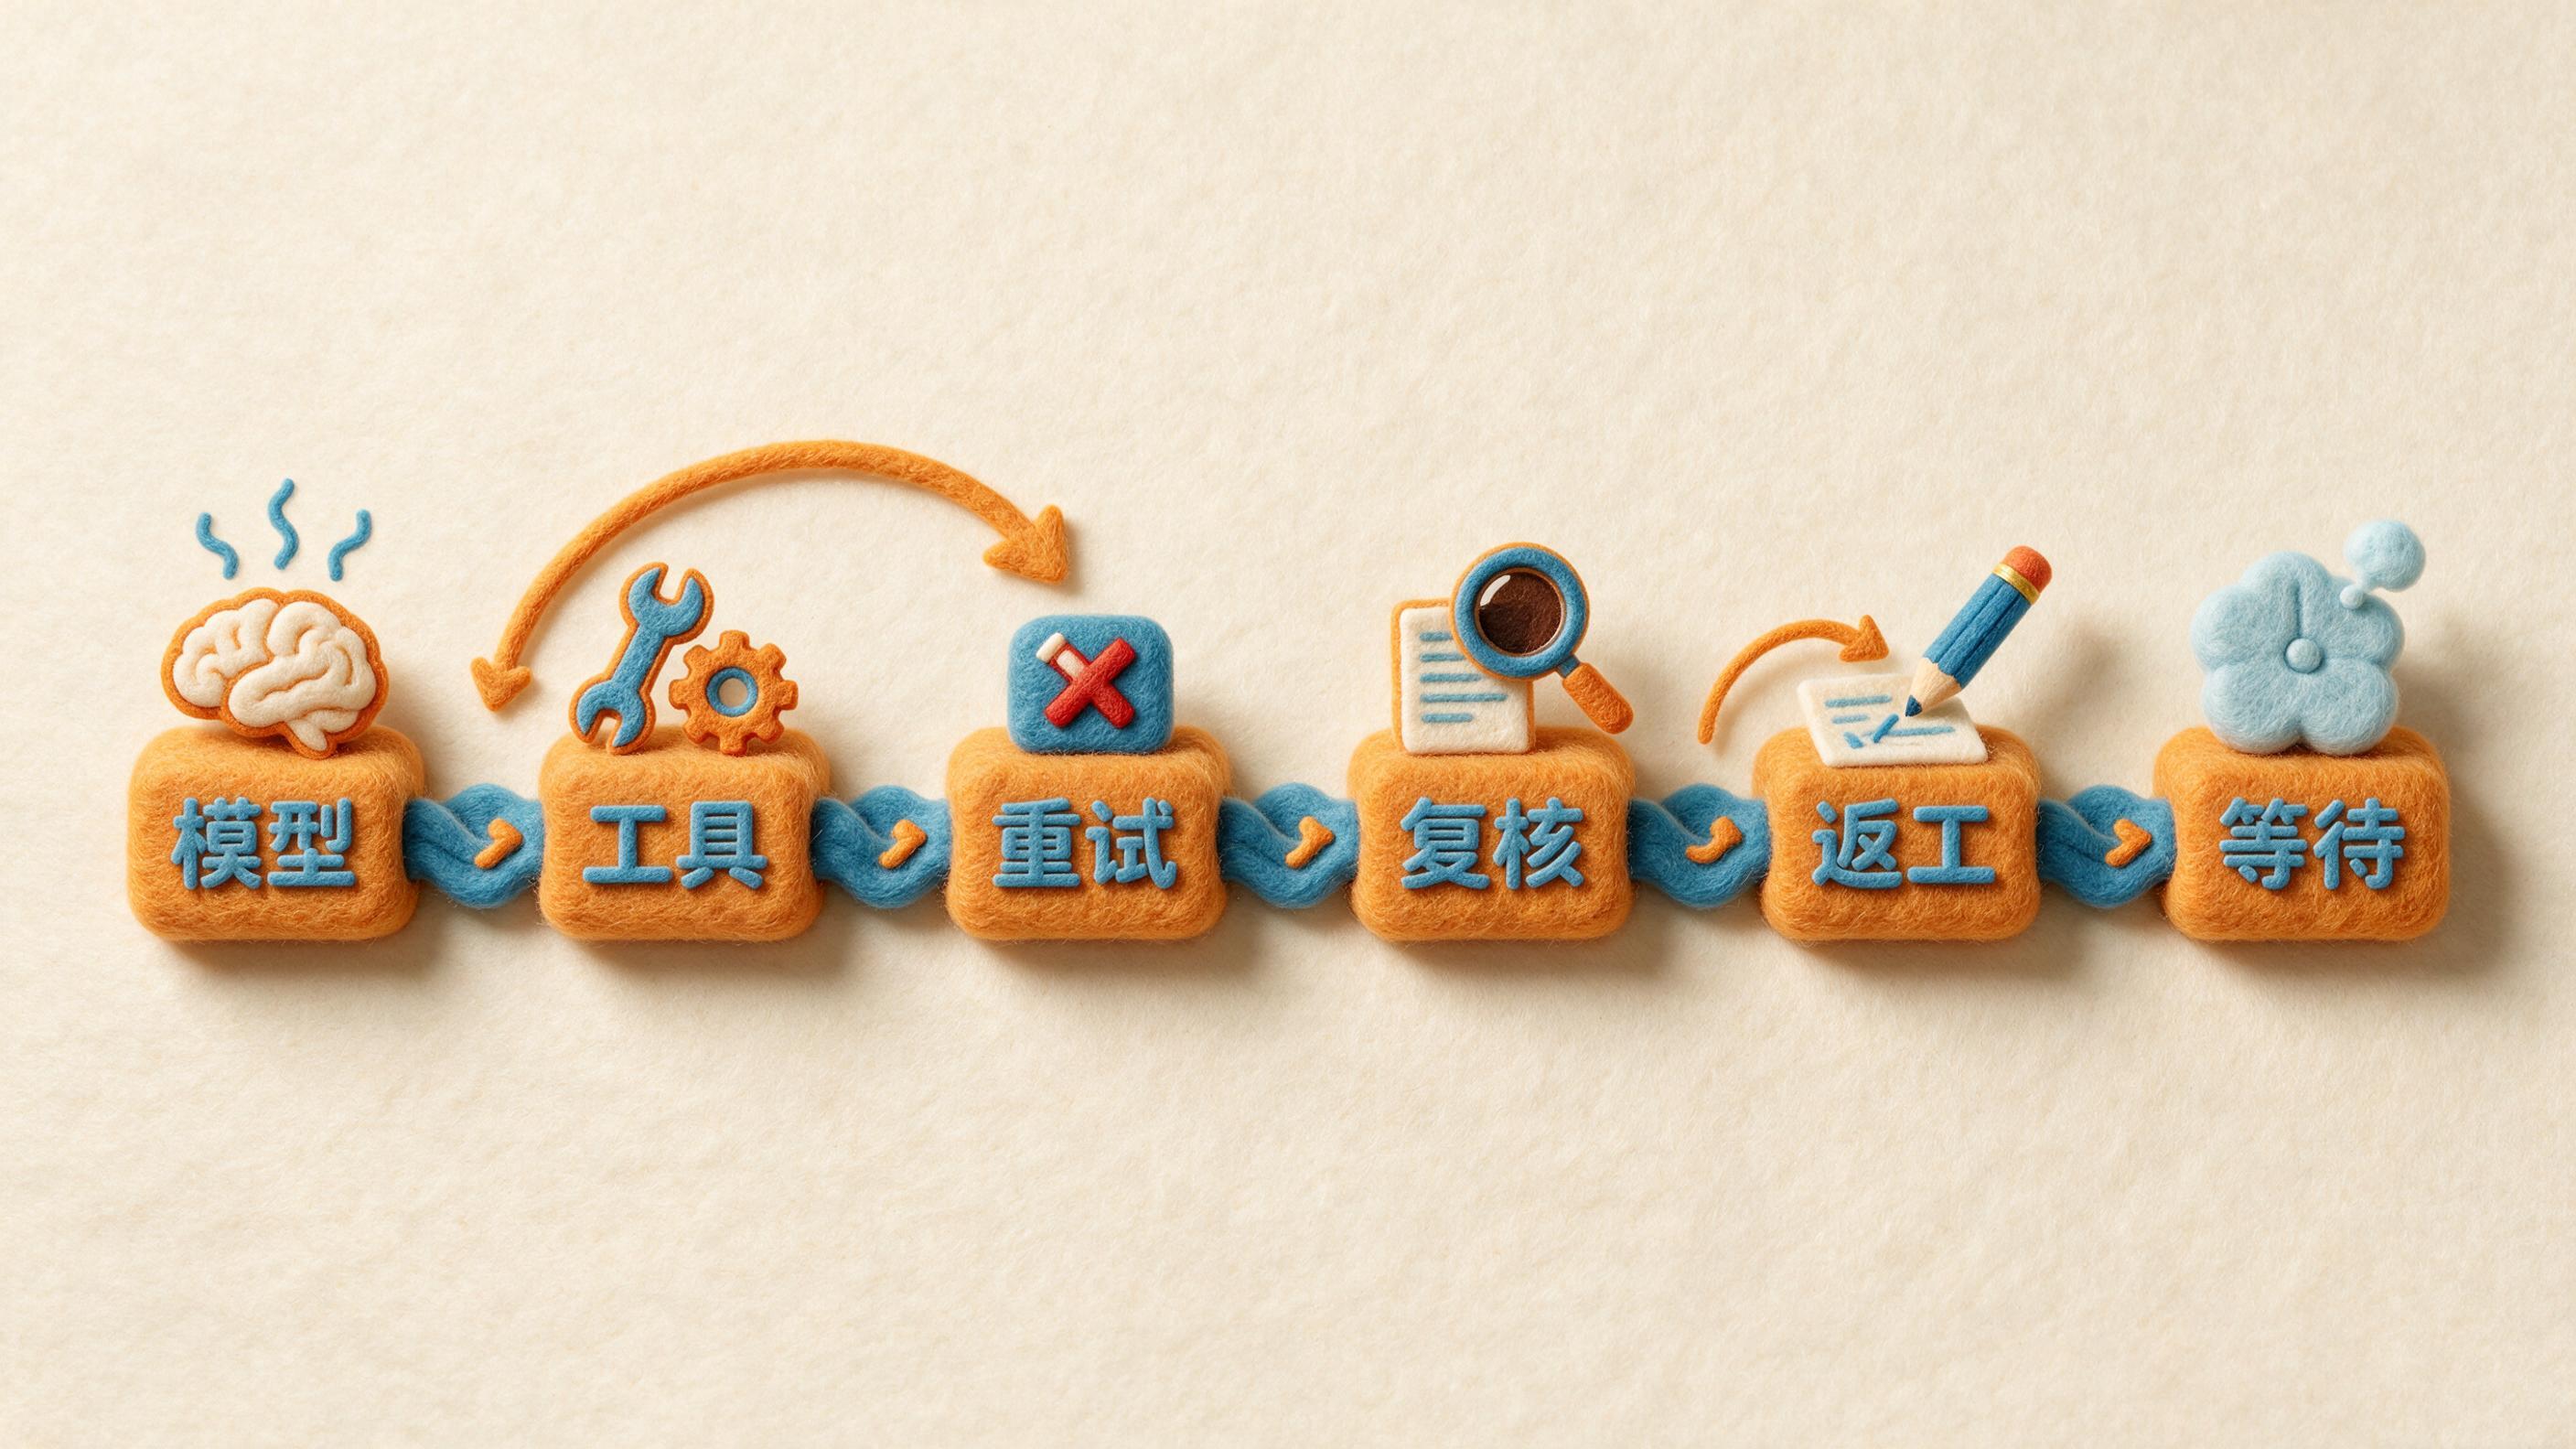
以内容运营为例,“生成文章”之后还可能有:
- 搜索与打开官方资料;
- 图片生成、下载和检查;
- Markdown 转换与文件处理;
- 页面预填、加载等待和字段修正;
- 人工事实复核与品牌复核;
- 失败重试、返工和最终提交确认。
如果最后没有达到发布标准,模型调用成功也不能算一次成功任务。
把核算单位从 Token 换成“合格交付”
OpenAI 在《A scorecard for the AI age》中给出的思路很直接:汇总完成工作的全部成本,统计达到质量门槛的任务数,再计算每个成功任务的成本。
可以把它扩展为一个 Agent 工程公式:
C_success = (
  C_model
  C_tool
  C_compute
  C_retry
  C_review
  C_rework
  C_wait
) / N_pass
其中:
| 字段 | 含义 | 常见来源 |
|---|---|---|
C_model | 输入、缓存、输出与推理费用 | 模型账单 |
C_tool | 搜索、图片、浏览器、存储等费用 | 工具调用日志 |
C_compute | 沙箱、渲染、队列与网络资源 | 基础设施账单 |
C_retry | 失败后重复执行产生的费用 | Run/Attempt 记录 |
C_review | 人工验收时间 | 审批与工时记录 |
C_rework | 根据验收意见修正的成本 | 版本与返工原因 |
C_wait | 等待造成的时间或机会成本 | 队列与端到端延迟 |
N_pass | 在统一门槛下合格的交付数 | 验收结果 |
C_wait 不一定要强行折算成人民币。对小团队,先保留 P50/P95 端到端耗时,通常比拍脑袋给等待定价更可靠。
一个能复现的假设算例
下面的数据只是演示公式,不代表任何产品或客户。
假设一个月处理 100 个同类任务,90 个达到验收标准:
before:
  model: 100
  tools_and_compute: 20
  retry: 50
  human_review_and_rework: 100
  passed: 90
则每个合格任务成本为:
(100 + 20 + 50 + 100) / 90 = 3.00
如果只有模型费用降低 30%,其他指标不变:
(70 + 20 + 50 + 100) / 90 ≈ 2.67
模型费用下降 30%,成功交付成本只下降约 11%。这不是模型降价“没用”,而是模型原本只占总成本的一部分。
更需要警惕的是错误分流:如果团队把高歧义任务也切到最便宜模型,导致重试、复核和返工增加,总成本甚至可能上升。但这只是待验证的风险,不能在没有同任务集回放时直接下结论。
先把事件链记完整
很多团队只能看到 Token 账单,却无法解释一次交付为什么重试。最小事件结构可以这样设计:
{
  "taskId": "post-20260825-001",
  "workflow": "content_publish",
  "attempt": 2,
  "modelTier": "balanced",
  "inputTokens": 18240,
  "cachedInputTokens": 9100,
  "outputTokens": 3360,
  "toolCost": 0.18,
  "latencyMs": 84200,
  "reviewMinutes": 7,
  "reworkReason": "source_missing",
  "qualityGate": "failed",
  "failureStage": "fact_check",
  "artifactVersion": 3
}
至少要保留四个关联键:
taskId:同一业务任务的所有尝试;attempt:防止把重试当成新任务;artifactVersion:知道人工验收的是哪一版产物;qualityGate:区分“模型返回了内容”和“内容已经合格”。
如果有公开发布、付款或删除动作,还要额外记录幂等键和授权状态,避免失败重试造成重复提交。
模型分流不要只看“难不难”
更稳妥的路由至少同时看三个维度:失败代价、自动验收能力、返工成本。
routing:
  - when:
      risk: low
      auto_check: strong
      rework_cost: low
    model_tier: economy
    max_attempts: 1
    fallback: balanced

  - when:
      risk: medium
      auto_check: partial
    model_tier: balanced
    max_attempts: 1
    fallback: strong

  - when:
      risk: high
    model_tier: strong
    require_human_approval: true
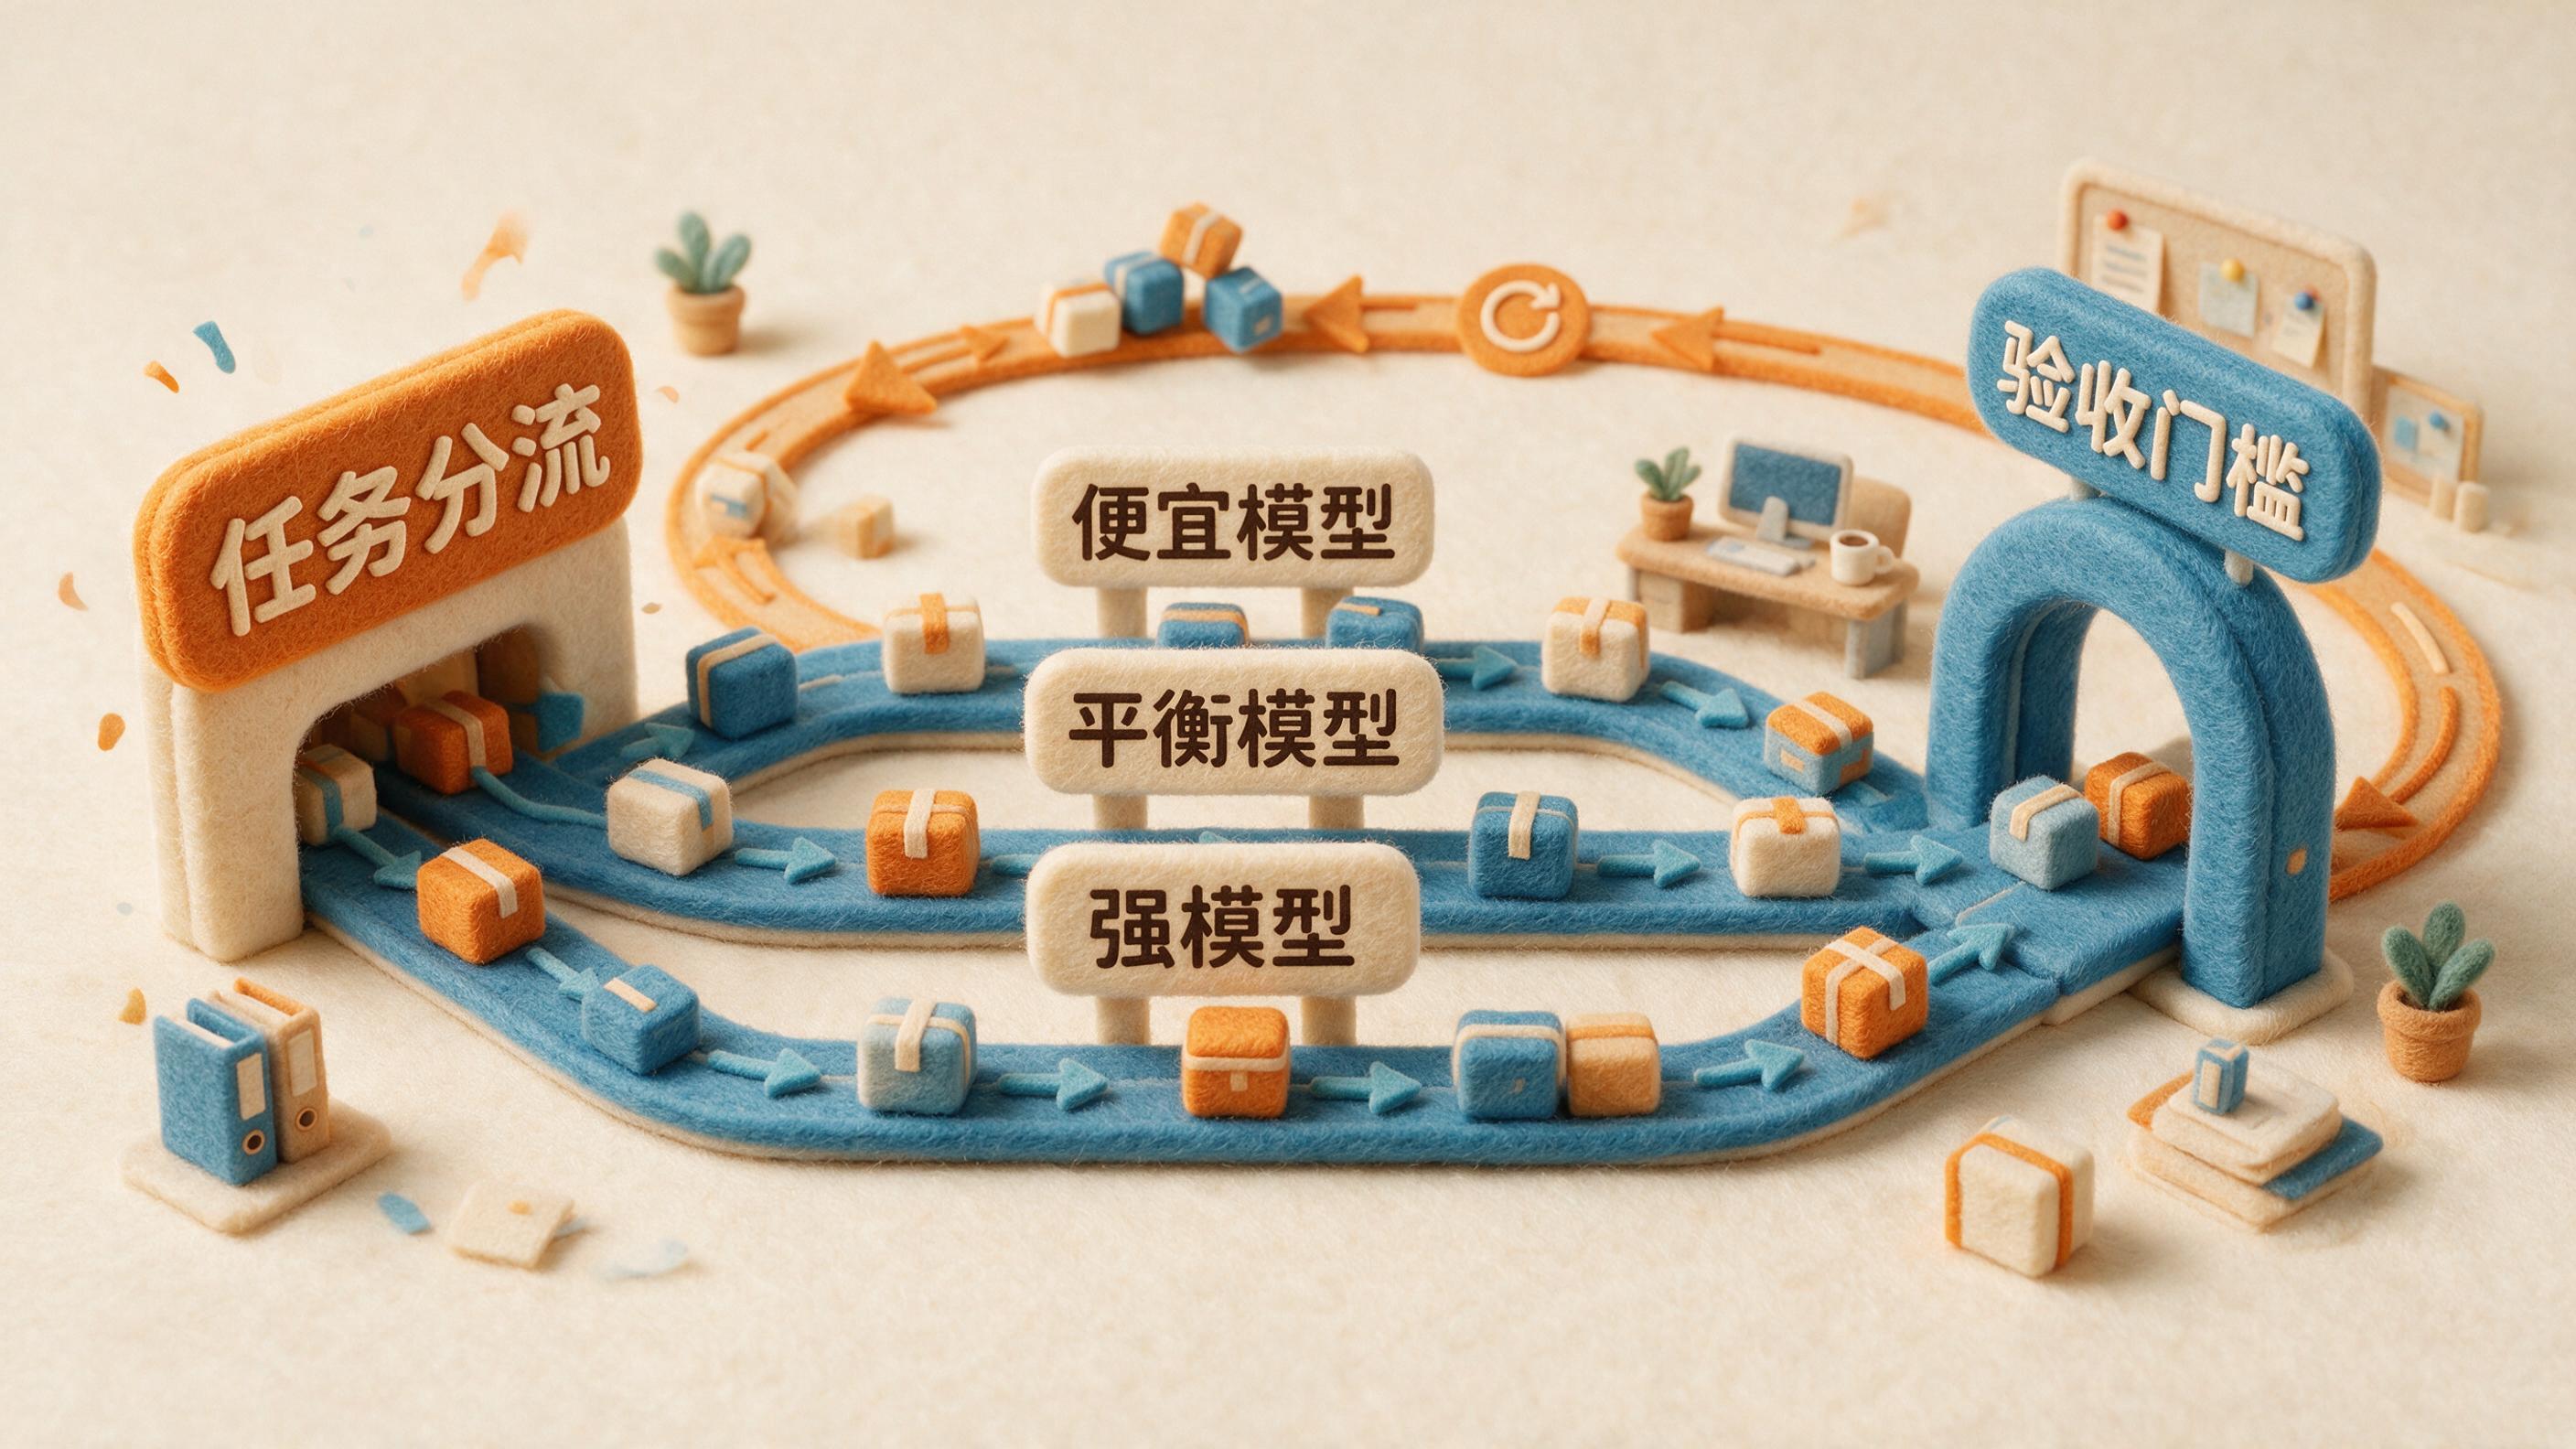
这里的关键不是给模型贴“高低端”标签,而是所有路径都经过同一质量门槛。否则便宜模型负责的任务可能用宽松标准验收,最后得到一个看似更省、其实不可比较的报表。
用代码计算成功任务成本
下面的 TypeScript 只演示核心聚合逻辑:
type DeliveryRun = {
  taskId: string;
  modelCost: number;
  toolCost: number;
  computeCost: number;
  reviewCost: number;
  reworkCost: number;
  passed: boolean;
};

function costPerSuccessfulTask(runs: DeliveryRun[]) {
  const taskCost = new Map<string, number>();
  const passed = new Set<string>();

  for (const run of runs) {
    const cost = run.modelCost + run.toolCost + run.computeCost
      + run.reviewCost + run.reworkCost;
    taskCost.set(run.taskId, (taskCost.get(run.taskId) ?? 0) + cost);
    if (run.passed) passed.add(run.taskId);
  }

  const total = [...taskCost.values()].reduce((a, b) => a + b, 0);
  return passed.size === 0 ? null : total / passed.size;
}
生产实现还要处理撤销、退款、跨周期任务、并行尝试和人工时间重复计算,不能把这段示例直接当财务报表。
一张成本看板至少放六个指标
- 每个合格任务成本;
- 首次通过率;
- 平均尝试次数;
- 人工复核分钟数;
- P50/P95 端到端耗时;
- 按失败原因拆分的返工率。
然后再按 workflow、modelTier 和任务风险分组。只按模型分组会把流程差异误当成模型差异。
小团队如何落地:先选一个高频流程
不必立刻给所有 Agent 做成本平台。可以选一个每周至少重复十次、验收标准相对清楚的流程,连续记录两周:
- 固定任务样本与质量门槛;
- 记录基线模型的完整事件链;
- 只调整一个变量,例如模型档位;
- 设定一次失败后的升级规则;
- 比较合格率、总成本和复核时间,而不是只比 Token。
这也是我们做 Tipkay 时的一个取舍。Tipkay 面向经营者和小团队提供按需 AI 员工,岗位助手带着相应经验、流程与工具工作,并从生成继续做到素材、排版、文件和发布准备。关键操作由用户确认,按实际使用量计费、不使用时不产生消耗。
这个设计并不免除成本观测。恰恰相反,“接手一类工作”之后,更应该把生成、工具、返工与验收放进同一条交付链里。一个人的生意,也能有一支专业团队;前提是团队的产出能够被验收,成本能够被解释。
工程边界与常见误判
- 强模型不保证一次成功:工具、数据和验收定义有问题时,模型升级可能只会放大账单。
- 等待不总等于损失:能并行处理其他工作的异步等待,不宜全部折算为人工成本。
- 人工复核不能无限压缩:公开发布、财务、合规等动作保留人工确认,是风险控制,不是纯浪费。
- 固定成本需要合理分摊:订阅费、服务器和团队建设成本要用稳定口径分配,避免月度波动制造假趋势。
- 一次样本不能下结论:至少在同类任务、同一观察窗口和同一验收标准下比较。
模型降价之后,最值得做的不是立即宣布“成本降低了 20%”,而是回到任务日志里问一句:我们多完成了多少可以真正使用的工作?
参考资料

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐

 7
 0
- 0


 已为社区贡献4条内容

所有评论(0)