Agent长期记忆点生成机制
1. 核心目标
长期记忆点生成的目标,不是把完整对话原样保存,而是从上下文对话、工具执行结果、用户纠正、技术讨论和任务决策中,提炼出未来可复用的知识点。
一个合格的长期记忆点应满足:
稳定 + 可复用 + 可独立理解 + 能影响未来决策
也就是说,长期记忆点应该是一个可以在未来任务中被召回、理解并指导 Agent 行为的知识单元。
2. 输入与输出
2.1 输入
长期记忆点生成的输入通常来自完整对话轨迹:
Conversation Context
  - 用户消息
  - Agent 回复
  - 工具调用结果
  - 文件修改记录
  - 用户纠正与偏好
  - 技术方案讨论
  - 任务执行结论
可以用公式表示为:
候选记忆 = Extract(τ_t, x)
其中:
τ_t:到当前时刻为止的对话轨迹、工具结果和任务过程。x:当前用户任务或讨论主题。
2.2 输出
输出不是长对话,而是结构化 Memory Object:
{
  "title": "长期记忆检索能力三层抽象模型",
  "content": "长期记忆系统描述关键词/全文检索能力时,应区分三层:关键词/全文索引是上层能力,倒排索引是底层数据结构,OpenSearch 是工程实现示例。文档中不应将 OpenSearch 直接等同于倒排索引,而应说明 OpenSearch 提供倒排索引、BM25、多字段权重和结构化过滤能力。",
  "category": "project_introduction",
  "keywords": ["全文索引", "倒排索引", "OpenSearch", "三层抽象"],
  "usage_scenario": [
    "撰写长期记忆技术文档",
    "解释检索层架构设计",
    "评审OpenSearch表述准确性"
  ],
  "project": "xxx",
  "module": "long_term_memory",
  "importance": 0.8,
  "status": "active"
}
3. 总体 Pipeline
长期记忆点生成可以拆成以下流程:
上下文对话 τ_t
  ↓
候选信息识别
  ↓
记忆价值判断
  ↓
知识点归纳与压缩
  ↓
结构化 Memory Object
  ↓
去重 / 合并 / 更新判断
  ↓
写入 canonical memory
  ↓
生成向量索引、关键词/全文索引、结构化索引
工程上可以拆成两个核心模块:
Memory Extractor
  负责从上下文中提取候选记忆点

Memory Curator
  负责判断 create / update / ignore / delete,并进行治理
4. 哪些内容值得生成长期记忆
4.1 用户明确要求记住
例如:
以后都用 xxx
记住这个规则
下次不要再这样
这个项目默认 xxx
这类信息通常应高优先级写入长期记忆。
4.2 用户偏好
例如:
示例里的 project 用 xxx,不要写具体项目名
回答统一中文
文档中不要直接把 OpenSearch 等同于倒排索引
这类信息会影响后续交互方式、文档风格或代码生成风格,适合沉淀为用户偏好或项目偏好。
4.3 项目规则 / 技术规范
例如:
关键词/全文索引是能力
倒排索引是底层数据结构
OpenSearch 是工程实现示例
这类信息稳定、可复用,并且会影响后续技术文档和架构设计。
4.4 重要技术决策
例如:
长期记忆采用一份内容、多种索引
OpenSearch 在一致性可靠时可以作为读模型
关键规则仍需事实源兜底
这类内容属于架构决策或设计约束,应进入长期记忆。
4.5 常见坑点 / 排障经验
例如:
向量召回和关键词召回结果不一致是正常现象
异常不一致应检查 content_hash/version
这类内容适合沉淀为常见问题经验,未来遇到类似问题时可被召回。
4.6 用户纠正信息
用户纠正通常很重要,因为它代表之前理解存在偏差。
例如:
不要直接用 OpenSearch 替代倒排索引
要让读者感知 OpenSearch 做的是倒排索引的事情
可以提炼成:
描述长期记忆检索层时,应区分“能力、数据结构、工程实现”:关键词/全文索引是能力,倒排索引是数据结构,OpenSearch 是实现示例。
5. 哪些内容不应生成长期记忆
以下内容通常不应写入长期记忆:
- 一次性临时状态。
- 普通寒暄。
- 已完成任务的过程性中间步骤。
- 没有未来复用价值的推理草稿。
- 缺少上下文后无法理解的片段。
- 与已有记忆重复、但没有新增信息的内容。
- 短期任务变量,例如某次临时端口、临时文件名、一次性命令输出。
例如:
刚才读取了 1-330 行文档
本次工具调用成功
用户当前正在问某个问题
这些通常只是任务过程,不应长期保存。
6. 记忆价值判断标准
可以给候选信息做打分或规则判断。
| 维度 | 判断问题 | 说明 |
|---|---|---|
| 稳定性 | 未来是否仍然成立 | 临时状态不适合长期记忆 |
| 复用性 | 未来是否会再次用到 | 高频规则、偏好、规范适合记忆 |
| 独立性 | 单独拿出来是否能理解 | 不能依赖大量上下文 |
| 可执行性 | 是否能影响后续行为 | 能指导 Agent 决策更适合记忆 |
| 范围清晰 | 适用于用户、项目、模块还是全局 | 决定 category/project/module |
| 非噪声 | 是否只是一次性过程 | 过程信息不应记忆 |
可以抽象成:
should_remember(candidate) =
  stable(candidate)
  && reusable(candidate)
  && self_contained(candidate)
  && useful_for_future_decision(candidate)
7. 从对话到记忆点的压缩方式
对话通常包含大量过程信息,长期记忆只应保存结论。
7.1 原始上下文
用户:文档前面提到关键词/全文索引,后面写倒排索引/OpenSearch 关联性不足。
用户:调整话说优化文档结构。
Agent:改成关键词/全文索引能力 -> 倒排索引数据结构 -> OpenSearch 工程实现。
7.2 记忆点结果
长期记忆文档中描述检索层时,应采用“能力 -> 数据结构 -> 工程实现”的三层抽象:关键词/全文索引是上层检索能力;倒排索引是底层数据结构;OpenSearch 是工程实现示例,不应直接等同于倒排索引。
7.3 压缩原则
- 去掉工具调用过程。
- 去掉重复表述。
- 保留用户纠正的核心意图。
- 保留未来适用场景。
- 保留可执行约束。
- 将口语化表述转为稳定规范。
8. 记忆点粒度控制
长期记忆点的粒度非常关键。
8.1 不推荐:过大
长期记忆系统完整设计
问题:
- 主题过宽。
- 召回时语义模糊。
- 更新困难。
- 容易把多个规则混在一起。
8.2 不推荐:过小
OpenSearch 不是倒排索引
问题:
- 缺少适用场景。
- 未来召回后不一定知道如何使用。
- 缺少完整约束。
8.3 推荐:一个完整规则
描述长期记忆检索层时,应区分“关键词/全文索引能力、倒排索引数据结构、OpenSearch 工程实现”三层,避免把 OpenSearch 直接等同于倒排索引。
这个粒度具备:
- 单一主题。
- 独立可理解。
- 可复用。
- 有明确适用场景。
9. Memory Object 字段生成规则
9.1 title
title 应该短、准、可检索。
推荐:
长期记忆检索能力三层抽象模型
OpenSearch作为倒排索引层的技术定位
rerank的核心目标与判断依据
不推荐:
刚才用户说的那个点
文档优化事项
一些长期记忆相关内容
9.2 content
content 应该是完整知识点,能够单独理解。
推荐结构:
背景/适用范围 + 规则/结论 + 注意事项
示例:
长期记忆系统描述关键词/全文检索能力时,应区分三层:关键词/全文索引是上层能力,倒排索引是底层数据结构,OpenSearch 是工程实现示例。文档中不应将 OpenSearch 直接等同于倒排索引,而应说明 OpenSearch 提供倒排索引、BM25、多字段权重和结构化过滤能力。
9.3 category
category 用于记忆分类。可以按内容类型决定:
| 内容类型 | 推荐 category |
|---|---|
| 用户偏好 | user_communication / user_behavior |
| 项目定位 | project_introduction |
| 技术栈选型 | project_tech_stack |
| 环境配置 | project_environment_configuration |
| 构建配置 | project_build_configuration |
| 编码规范 | development_code_specification |
| 实践规范 | development_practice_specification |
| 测试规范 | development_test_specification |
| 常见坑点 | common_pitfalls_experience |
| 重要决策 | important_decision_experience |
9.4 keywords
keywords 应覆盖核心实体、技术名词、触发词。
示例:
["全文索引", "倒排索引", "OpenSearch", "三层抽象"]
要求:
- 不要太泛,如“系统”“设计”。
- 不要和 title 完全重复。
- 应包含未来用户可能使用的检索词。
9.5 usage_scenario
usage_scenario 描述未来何时应召回该记忆。
示例:
[
  "撰写长期记忆技术文档",
  "解释检索层架构设计",
  "评审OpenSearch表述准确性"
]
要求:
- 每条场景具体。
- 避免空泛描述。
- 覆盖不同触发维度。
9.6 project / module
project 和 module 用于范围控制。
示例:
{
  "project": "xxx",
  "module": "long_term_memory"
}
如果是全局用户偏好,可以不绑定具体项目;如果是项目内规范,应绑定项目或模块。
9.7 importance
importance 可以用于排序和上下文预算分配。
建议:
| importance | 含义 |
|---|---|
| 0.9 - 1.0 | 安全红线、强约束、用户明确要求 |
| 0.7 - 0.9 | 项目规范、重要技术决策、稳定偏好 |
| 0.5 - 0.7 | 常见经验、一般实践 |
| 0.3 - 0.5 | 低频知识、弱约束 |
10. create / update / ignore / delete 判断
记忆点生成后,不应直接写入,应先判断动作类型。
10.1 create
当前没有相近记忆,且候选信息有长期价值。
新增:长期记忆检索能力三层抽象模型
10.2 update
已有记忆存在,但本次对话提供了补充或纠正。
例如已有:
OpenSearch 作为倒排索引层实现
用户补充:
不要让读者误解 OpenSearch 等同于倒排索引
应更新已有记忆,而不是新建重复记忆。
10.3 ignore
候选内容没有长期价值,或者和已有记忆重复且无新增。
本次读取文档成功
本轮已完成修改
10.4 delete / deprecate
已有记忆已经错误、过期或被用户明确否定。
例如旧记忆:
OpenSearch 就是倒排索引
应修正或废弃。
11. 去重与合并机制
候选记忆进入主存储前,需要检索已有记忆。
候选记忆
  ↓
按 title / keywords / embedding / category 检索已有记忆
  ↓
判断 create / update / ignore / delete
去重维度:
title是否相似。keywords是否高度重叠。contentembedding 是否相近。usage_scenario是否一致。category/project/module是否相同。
合并原则:
- 新候选只是旧记忆的重复:ignore。
- 新候选补充了适用场景:update。
- 新候选纠正了旧结论:update 或 deprecate。
- 新候选是更高层抽象,旧记忆是具体实现:可以同时保留,但要区分 usage_scenario。
12. Memory Extractor Prompt 示例
可以用如下 Prompt 从上下文中提炼候选记忆:
请从以下对话中提取值得长期保存的记忆点。

只保留满足以下条件的信息:
1. 未来可复用;
2. 对用户偏好、项目规范、技术决策、常见坑点或工具经验有影响;
3. 可以独立理解;
4. 不是临时过程、闲聊或一次性状态。

请输出 JSON 数组,每条包含:
- action: create/update/delete/ignore
- title
- content
- category
- keywords
- usage_scenario
- project
- module
- importance
- reason

如果只是临时信息,请 action = ignore。
13. Memory Extractor 输出示例
[
  {
    "action": "create",
    "title": "长期记忆检索能力三层抽象模型",
    "content": "长期记忆系统描述关键词/全文检索能力时,应区分三层:关键词/全文索引是上层能力,倒排索引是底层数据结构,OpenSearch 是工程实现示例。文档中不应将 OpenSearch 直接等同于倒排索引,而应说明 OpenSearch 提供倒排索引、BM25、多字段权重和结构化过滤能力。",
    "category": "project_introduction",
    "keywords": ["全文索引", "倒排索引", "OpenSearch", "三层抽象"],
    "usage_scenario": [
      "撰写长期记忆技术文档",
      "解释检索层架构设计",
      "评审OpenSearch表述准确性"
    ],
    "project": "xxx",
    "module": "long_term_memory",
    "importance": 0.8,
    "reason": "用户明确纠正文档中 OpenSearch 与倒排索引关系的表述方式,该规则未来会影响长期记忆技术文档和架构说明。"
  }
]
14. 写入后的索引生成
Memory Object 写入主存储后,需要生成多种派生索引。
Memory Object
  ↓
主存储:canonical memory 原文
  ↓
向量索引:embedding(title + content + usage_scenario)
  ↓
关键词/全文索引:title/content/keywords/usage_scenario
  ↓
结构化索引:category/project/module/status/importance
  ↓
规则索引:任务类型/触发条件
14.1 向量索引
用于语义召回。即使用户表达和记忆内容不完全一致,也能召回相近知识点。
14.2 关键词/全文索引
用于精确召回。它是一种检索能力,通常基于倒排索引实现。OpenSearch 是一种工程实现示例,提供倒排索引、BM25、多字段权重和结构化过滤能力。
14.3 结构化索引
用于过滤和范围控制,例如:
category = project_introduction
project = xxx
module = long_term_memory
status = active
14.4 规则索引
用于强制召回安全规则、项目约束、用户偏好等高优先级记忆。
15. 与 SAM 的关系
SAM 负责当前上下文状态构造,长期记忆点生成是 SAM 的写入侧能力之一。
对话轨迹 τ_t
  ↓
Memory Extractor 提炼候选记忆
  ↓
Memory Curator 去重、合并、更新
  ↓
写入长期记忆 M
  ↓
未来任务中由 SAM 召回并压缩进入 s_t
也就是说:
写入侧:从上下文中总结出记忆点
读取侧:从长期记忆中召回适合当前任务的记忆点
16. 设计原则
16.1 记结论,不记过程
长期记忆应保存稳定结论,而不是工具调用过程或临时推理过程。
16.2 记可复用知识,不记一次性状态
只有未来可能再次影响决策的内容才值得记忆。
16.3 记用户纠正
用户纠正代表系统理解偏差,应优先沉淀。
16.4 先去重,再写入
候选记忆必须先和已有记忆做相似性检查,避免重复和冲突。
16.5 一条记忆只表达一个知识点
避免把多个规则、多个坑点、多个技术决策混进同一条记忆。
16.6 索引是派生数据
主存储中的 canonical memory 是事实源,向量索引、关键词/全文索引、结构化索引都是派生数据,可以重建。
17. 总结
长期记忆点生成可以概括为:
上下文对话
  ↓
识别候选信息
  ↓
判断长期价值
  ↓
压缩成独立知识点
  ↓
结构化为 Memory Object
  ↓
去重 / 合并 / 更新
  ↓
写入主存储并生成多种索引
最终目标是:
将连续对话中的用户偏好、项目规则、技术决策、常见坑点和纠正信息,沉淀成稳定、可复用、可检索、可独立理解的长期记忆点。
附
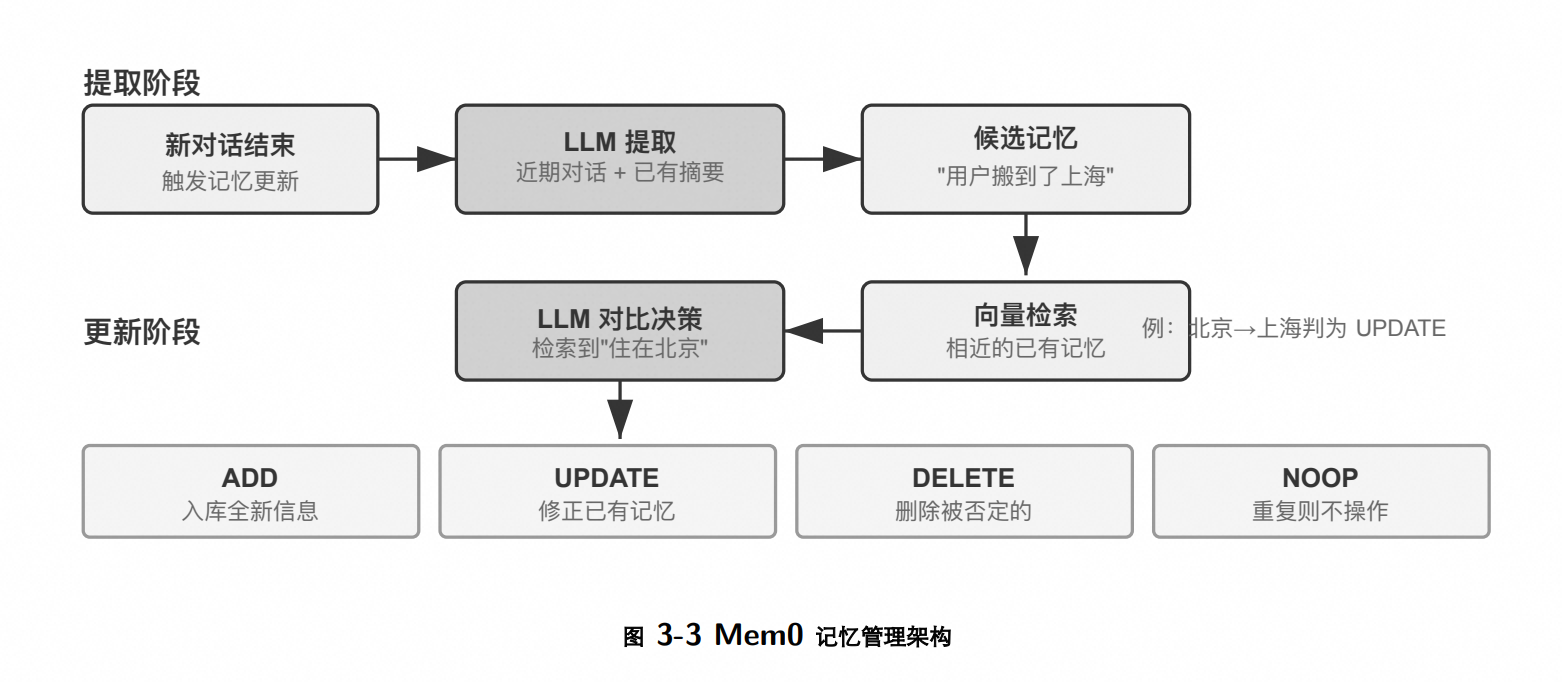
Mem0架构

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐
 6
 0
- 0


 已为社区贡献3条内容

所有评论(0)