百度网盘、夸克网盘、123网盘等备份云网盘,相册、视频文件备份恢复到手机后排序乱解决办法(python版)
·
楼主小米手机的五千多张纪念性照片疑似因系统bug丢失,因开启夸克网盘自动备份,遂清空本地相册,下载备份文件覆盖使用。但部分图片、视频无拍摄时间,导致相册乱序。
楼主结合EXIF信息恢复(无此信息则从文件命名提取时间,如时间戳、日期格式命名的文件),解决该问题。
相较于网上教程,本次脚本优化:采用递归方法,可自动逐级查找文件,无需手动更换路径;新增视频拍摄时间自动提取处理功能;失败文件将导出至桌面,方便二次兼容处理。
直接上教程。
废话不多说,直接上教程
照片存有EXIF信息
可以在这个网站查看是否存有exif
https://exif.tuchong.com/
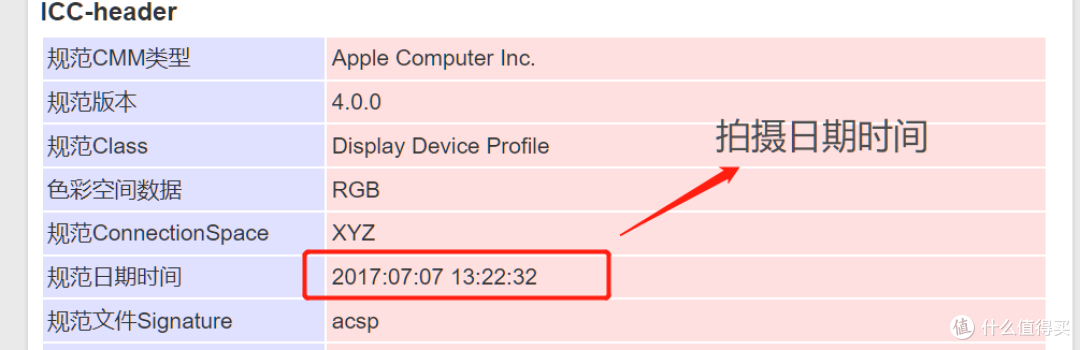
准备工作
首先官网下载vscode,安装
https://code.visualstudio.com/
安装完成后按我的操作进行插件下载
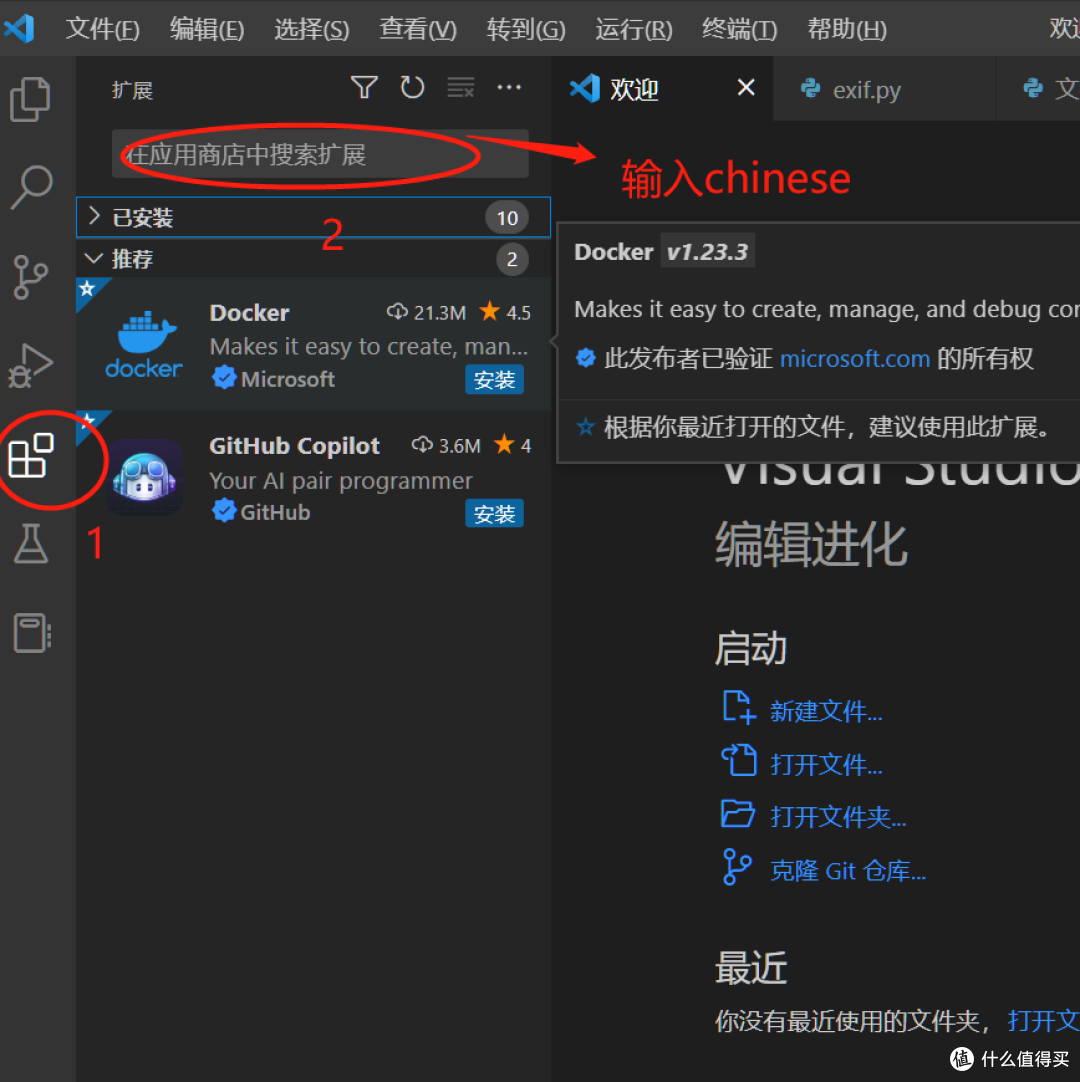
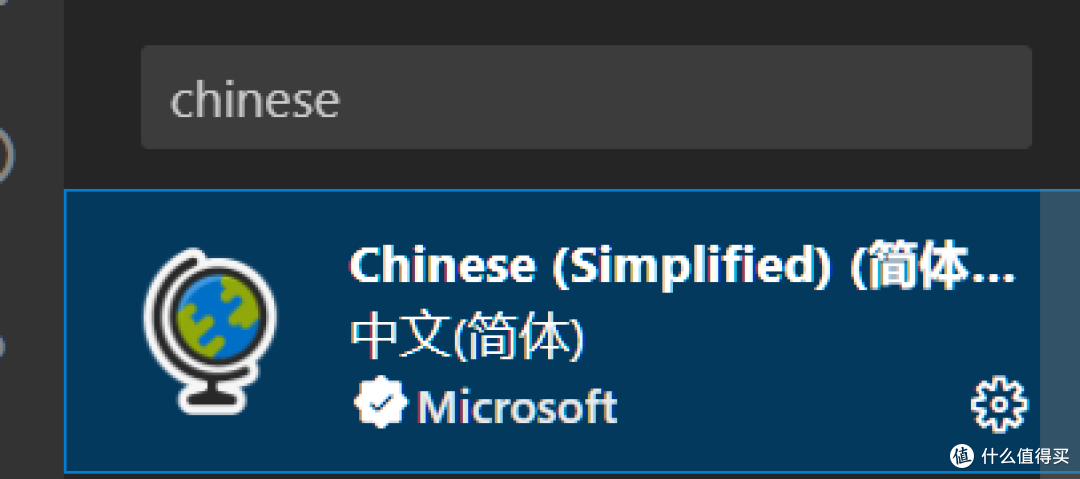
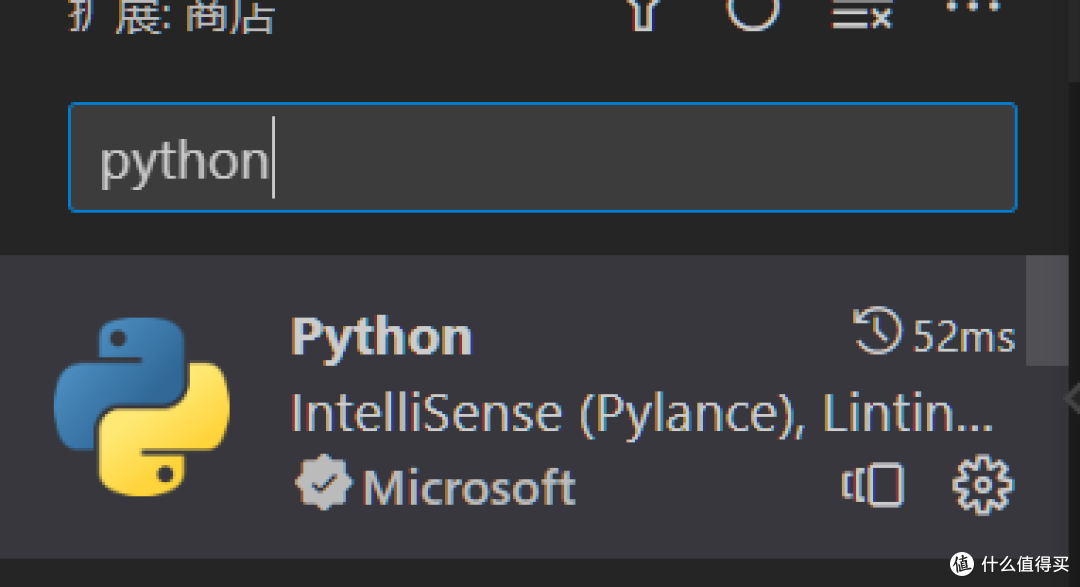
随后打开CMD分别输入
pip install Pillow
pip3 install datetime
在Python中,datetime 模块提供了处理日期和时间的功能。
Pillow库来读取照片的exif信息,并使用os库来更改文件的修改日期。
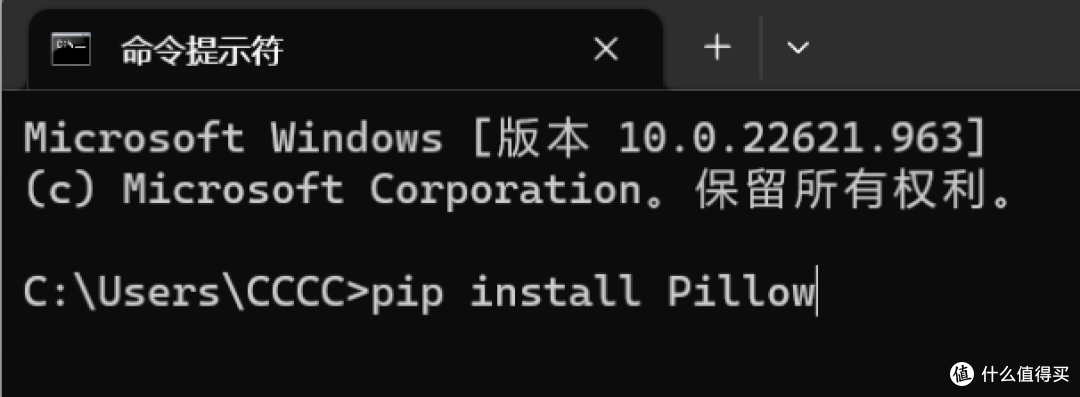

安装完成后会提示成功
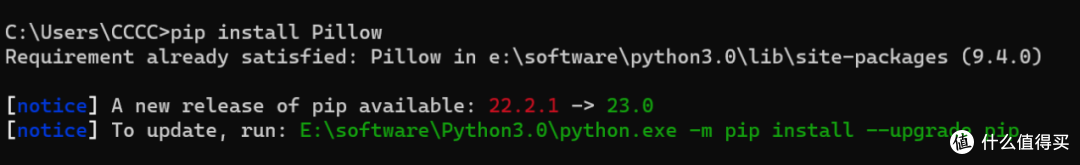
再重新打开vscode,新建一个python文件
文件→新建文件→python文件
配置文件 analyze_failures.py
import os
import datetime
import re
from PIL import Image

dir_path = r"D:\temp"

# 模拟当前的匹配逻辑
def get_date_from_file(file_path, file_name):
    # ... (same logic as before) ...
    dt = None

    # ... (Previous rules omitted for brevity in thought block, but included in execution) ...
    # Rule 1: YYYYMMDD[-_]HHMMSS
    match_date = re.search(r'(\d{4})(\d{2})(\d{2})[-_](\d{2})(\d{2})(\d{2})', file_name)
    if match_date:
        try:
            year, month, day, hour, minute, second = map(int, match_date.groups())
            if 1970 <= year <= 2050:
                return "Rule 1"
        except ValueError:
            pass

    # Rule 2: YYYY-MM-DD-HH-MM-SS-mmm
    match_date_long = re.search(r'(\d{4})-(\d{2})-(\d{2})-(\d{2})-(\d{2})-(\d{2})[-_](\d{3})', file_name)
    if match_date_long:
        try:
            year, month, day, hour, minute, second, microsecond = map(int, match_date_long.groups())
            if 1970 <= year <= 2050:
                return "Rule 2"
        except ValueError:
            pass

    # Rule 3: YYYYMMDDHHMMSS
    match_date_pure = re.search(r'(\d{4})(\d{2})(\d{2})(\d{2})(\d{2})(\d{2})', file_name)
    if match_date_pure:
        try:
            year, month, day, hour, minute, second = map(int, match_date_pure.groups())
            if 1970 <= year <= 2050:
                return "Rule 3"
        except ValueError:
            pass

    # Rule 4: 13-digit timestamp
    match = re.search(r'(\d{13})', file_name)
    if match:
        return "Rule 4 (13-digit)"

    # Rule 5: 10-digit timestamp
    match_10 = re.search(r'(?<!\d)(\d{10})(?!\d)', file_name)
    if match_10:
        try:
            timestamp_s = int(match_10.group(1))
            if 946684800 < timestamp_s < 2524608000:
                return "Rule 5 (10-digit)"
        except Exception:
            pass

    return None

unmatched_files = []

for root, dirs, files in os.walk(dir_path):
    for file_name in files:
        file_path = os.path.join(root, file_name)
        if not file_name.lower().endswith(('.jpg', '.jpeg', '.png', '.heic', '.mp4', '.mov')):
            continue

        result = get_date_from_file(file_path, file_name)
        if result is None:
            unmatched_files.append(file_name)

# Print MORE files to see patterns better
print(f"Found {len(unmatched_files)} unmatched files.")
print("First 50 unmatched files:")
for f in unmatched_files[:50]:
    print(f)
处理主程序-图片 import os.py
import os
import datetime
import re
from PIL import Image
from PIL.ExifTags import TAGS
import openpyxl

# 设置需要处理的根目录路径
# 代码会自动遍历该目录下的所有子文件夹
dir_path = r"D:\temp"

# 用于存储处理失败的文件信息
failed_files = []

# 使用 os.walk 递归遍历目录及其子目录
for root, dirs, files in os.walk(dir_path):
    for file_name in files:
        # 获取文件的完整路径
        file_path = os.path.join(root, file_name)

        # 标记是否成功处理时间
        processed = False
        dt = None
        source = ""

        # 1. 尝试从 EXIF 获取时间
        try:
            # 尝试打开图片文件
            with Image.open(file_path) as img:
                # 获取图片的EXIF信息
                exif_data = img._getexif()

                # 如果图片包含EXIF信息
                if exif_data:
                    # 获取拍摄日期和时间信息 (36867 是 DateTimeOriginal 的标签 ID)
                    datetime_str = exif_data.get(36867)

                    if datetime_str:
                        # 将字符串解析为datetime对象
                        try:
                            dt = datetime.datetime.strptime(datetime_str, "%Y:%m:%d %H:%M:%S")
                            source = "EXIF"
                        except ValueError:
                            # EXIF 日期格式可能不标准
                            pass
        except Exception:
            # 不是图片或无法读取 EXIF,忽略错误,尝试下一步
            pass

        # 2. 如果 EXIF 没有找到时间,尝试从文件名提取时间戳
        if dt is None:
            # 尝试匹配 YYYYMMDD_HHMMSS 格式,例如 IMG_20241003_110253.jpg
            # 兼容 Screenshot_20230726-220119_xxxx.jpg 这种格式 (YYYYMMDD-HHMMSS)
            match_date = re.search(r'(\d{4})(\d{2})(\d{2})[-_](\d{2})(\d{2})(\d{2})', file_name)
            if match_date:
                try:
                    year, month, day, hour, minute, second = map(int, match_date.groups())
                    if 1970 <= year <= 2050:
                        dt = datetime.datetime(year, month, day, hour, minute, second)
                        source = "文件名日期(YYYYMMDD[-_]HHMMSS)"
                except ValueError:
                    pass

            # 尝试匹配 Screenshot_2023-11-03-22-56-14-707_lockscreen.jpg 这种格式
            # (YYYY-MM-DD-HH-MM-SS-mmm)
            if dt is None:
                match_date_long = re.search(r'(\d{4})-(\d{2})-(\d{2})-(\d{2})-(\d{2})-(\d{2})[-_](\d{3})', file_name)
                if match_date_long:
                    try:
                        year, month, day, hour, minute, second, microsecond = map(int, match_date_long.groups())
                        if 1970 <= year <= 2050:
                            # microsecond 是毫秒,需要乘以 1000 转换为微秒
                            dt = datetime.datetime(year, month, day, hour, minute, second, microsecond * 1000)
                            source = "文件名日期(YYYY-MM-DD-HH-MM-SS-mmm)"
                    except ValueError:
                        pass

            # 尝试匹配 YYYYMMDDHHMMSS 格式,例如 beauty_20190608004810.jpg
            if dt is None:
                match_date_pure = re.search(r'(\d{4})(\d{2})(\d{2})(\d{2})(\d{2})(\d{2})', file_name)
                if match_date_pure:
                    try:
                        year, month, day, hour, minute, second = map(int, match_date_pure.groups())
                        # 简单的年份校验,防止匹配到非日期的长数字串
                        if 1970 <= year <= 2050:
                            dt = datetime.datetime(year, month, day, hour, minute, second)
                            source = "文件名日期(YYYYMMDDHHMMSS)"
                    except ValueError:
                        pass

            # 如果没有匹配到日期格式,再尝试匹配 13 位数字 (毫秒级时间戳),例如 mmexport1612110000082.jpg
            if dt is None:
                # 或者匹配 10 位数字 (秒级时间戳) - 这里优先匹配 13 位
                match = re.search(r'(\d{13})', file_name)

                if match:
                    timestamp_str = match.group(1)
                    try:
                        timestamp_ms = int(timestamp_str)
                        # 转换为秒
                        timestamp_s = timestamp_ms / 1000.0
                        dt = datetime.datetime.fromtimestamp(timestamp_s)
                        source = "文件名时间戳(13位)"
                    except Exception:
                        pass

                # 如果没有找到 13 位,也可以尝试找 10 位 (可选,视用户需求而定,用户主要提到 mmexport 格式通常是 13 位)
                if dt is None:
                    match_10 = re.search(r'(?<!\d)(\d{10})(?!\d)', file_name)
                    if match_10:
                        try:
                            timestamp_s = int(match_10.group(1))
                            # 简单的合理性校验:时间戳应该在 1970 年到 2038 年之间 (0 - 2147483647)
                            # 这里放宽一点,排除一些明显不是时间戳的数字(比如单纯的序号)
                            # 2000年是 946684800, 2030年是 1893456000
                            if 946684800 < timestamp_s < 2524608000:
                                dt = datetime.datetime.fromtimestamp(timestamp_s)
                                source = "文件名时间戳(10位)"
                        except Exception:
                            pass

        # 3. 应用修改
        if dt:
            try:
                # os.utime 需要 (atime, mtime)
                os.utime(file_path, (os.path.getatime(file_path), dt.timestamp()))
                print(f"{file_name}: 拍摄日期设置为 {dt} (来源: {source}, 路径: {file_path})")
                processed = True
            except Exception as e:
                print(f"{file_name}: 应用时间修改失败: {e}")
                failed_files.append({"path": file_path, "name": file_name, "reason": f"应用修改失败: {e}"})
        else:
            # 只有当确实无法处理时才打印,或者打印出无法识别的文件以便用户处理
            print(f"{file_name}: 未找到EXIF信息且无法从文件名提取有效时间戳,跳过 (路径: {file_path})")
            failed_files.append({"path": file_path, "name": file_name, "reason": "未找到有效时间信息"})

# 处理完成后,如果有失败的文件,导出到 Excel
if failed_files:
    try:
        # 获取桌面路径
        desktop_path = os.path.join(os.path.expanduser("~"), "Desktop")
        excel_path = os.path.join(desktop_path, "处理失败照片清单.xlsx")

        # 创建一个新的工作簿
        wb = openpyxl.Workbook()
        ws = wb.active
        ws.title = "Failed Files"

        # 添加表头
        ws.append(["文件完整路径", "文件完整名", "失败原因"])

        # 添加数据
        for item in failed_files:
            ws.append([item["path"], item["name"], item["reason"]])

        # 调整列宽(可选,为了美观)
        ws.column_dimensions['A'].width = 50
        ws.column_dimensions['B'].width = 30
        ws.column_dimensions['C'].width = 30

        # 保存文件
        wb.save(excel_path)
        print(f"\n已将 {len(failed_files)} 个处理失败的文件信息导出到: {excel_path}")

    except Exception as e:
        print(f"\n导出 Excel 失败: {e}")
else:
    print("\n所有文件均处理成功!")
处理主程序-视频 vedio.py
import os
import datetime
import re
import openpyxl
from hachoir.parser import createParser
from hachoir.metadata import extractMetadata

# 设置需要处理的根目录路径
# 代码会自动遍历该目录下的所有子文件夹
dir_path = r"D:\temp"

# 用于存储处理失败的文件信息
failed_files = []

# 支持的视频文件扩展名
VIDEO_EXTENSIONS = (
    '.mp4', '.mov', '.avi', '.mkv', '.wmv', '.flv', '.3gp',
    '.mpg', '.mpeg', '.m4v', '.webm', '.vob', '.mts', '.m2ts',
    '.rm', '.rmvb', '.asf', '.ts', '.dat'
)

def get_video_creation_date(file_path):
    """尝试使用 hachoir 库提取视频元数据中的创建时间"""
    parser = None
    try:
        parser = createParser(file_path)
        if not parser:
            return None

        with parser:
            metadata = extractMetadata(parser)
            if not metadata:
                return None

            # 尝试获取创建时间
            # 不同格式的元数据键值可能不同,常见的是 'creation_date'
            if metadata.has('creation_date'):
                return metadata.get('creation_date')
    except Exception:
        pass
    return None

# 使用 os.walk 递归遍历目录及其子目录
for root, dirs, files in os.walk(dir_path):
    for file_name in files:
        # 检查是否为视频文件
        if not file_name.lower().endswith(VIDEO_EXTENSIONS):
            continue

        # 获取文件的完整路径
        file_path = os.path.join(root, file_name)

        # 标记是否成功处理时间
        dt = None
        source = ""

        # 1. 尝试从视频元数据获取时间
        try:
            dt_meta = get_video_creation_date(file_path)
            if dt_meta:
                # 增加年份校验,防止元数据中的时间异常
                if 1970 <= dt_meta.year <= 2050:
                    dt = dt_meta
                    source = "视频元数据(Metadata)"
        except Exception:
            pass

        # 2. 如果元数据没有找到时间,尝试从文件名提取时间戳 (复用图片处理的逻辑)
        if dt is None:
            # 尝试匹配 YYYYMMDD_HHMMSS 格式,例如 IMG_20241003_110253.mp4
            # 兼容 Screenshot_20230726-220119_xxxx.mp4 这种格式 (YYYYMMDD-HHMMSS)
            match_date = re.search(r'(\d{4})(\d{2})(\d{2})[-_](\d{2})(\d{2})(\d{2})', file_name)
            if match_date:
                try:
                    year, month, day, hour, minute, second = map(int, match_date.groups())
                    if 1970 <= year <= 2050:
                        dt = datetime.datetime(year, month, day, hour, minute, second)
                        source = "文件名日期(YYYYMMDD[-_]HHMMSS)"
                except ValueError:
                    pass

            # 尝试匹配 Screenshot_2023-11-03-22-56-14-707_lockscreen.mp4 这种格式
            # (YYYY-MM-DD-HH-MM-SS-mmm)
            if dt is None:
                match_date_long = re.search(r'(\d{4})-(\d{2})-(\d{2})-(\d{2})-(\d{2})-(\d{2})[-_](\d{3})', file_name)
                if match_date_long:
                    try:
                        year, month, day, hour, minute, second, microsecond = map(int, match_date_long.groups())
                        if 1970 <= year <= 2050:
                            # microsecond 是毫秒,需要乘以 1000 转换为微秒
                            dt = datetime.datetime(year, month, day, hour, minute, second, microsecond * 1000)
                            source = "文件名日期(YYYY-MM-DD-HH-MM-SS-mmm)"
                    except ValueError:
                        pass

            # 尝试匹配 TG-2023-10-10-000149612.mp4 这种格式
            # (YYYY-MM-DD-HHMMSSmmm)
            if dt is None:
                match_date_tg = re.search(r'(\d{4})-(\d{2})-(\d{2})-(\d{2})(\d{2})(\d{2})(\d{3})', file_name)
                if match_date_tg:
                    try:
                        year, month, day, hour, minute, second, microsecond = map(int, match_date_tg.groups())
                        if 1970 <= year <= 2050:
                            dt = datetime.datetime(year, month, day, hour, minute, second, microsecond * 1000)
                            source = "文件名日期(YYYY-MM-DD-HHMMSSmmm)"
                    except ValueError:
                        pass

            # 尝试匹配 YYYYMMDDHHMMSS 格式,例如 beauty_20190608004810.mp4
            if dt is None:
                match_date_pure = re.search(r'(\d{4})(\d{2})(\d{2})(\d{2})(\d{2})(\d{2})', file_name)
                if match_date_pure:
                    try:
                        year, month, day, hour, minute, second = map(int, match_date_pure.groups())
                        # 简单的年份校验,防止匹配到非日期的长数字串
                        if 1970 <= year <= 2050:
                            dt = datetime.datetime(year, month, day, hour, minute, second)
                            source = "文件名日期(YYYYMMDDHHMMSS)"
                    except ValueError:
                        pass

            # 如果没有匹配到日期格式,再尝试匹配 13 位数字 (毫秒级时间戳),例如 mmexport1612110000082.mp4
            if dt is None:
                # 针对 mmexport 开头的文件,优先匹配其后的 13 位数字
                # 例如 mmexport1771421845216.mp4
                if 'mmexport' in file_name:
                    match_mm = re.search(r'mmexport(\d{13})', file_name)
                    if match_mm:
                        try:
                            timestamp_str = match_mm.group(1)
                            timestamp_ms = int(timestamp_str)
                            # 转换为秒
                            timestamp_s = timestamp_ms / 1000.0
                            dt_temp = datetime.datetime.fromtimestamp(timestamp_s)
                             # 增加年份校验
                            if 1970 <= dt_temp.year <= 2050:
                                dt = dt_temp
                                source = "文件名时间戳(mmexport+13位)"
                        except Exception:
                            pass

                # 或者匹配 10 位数字 (秒级时间戳) - 这里优先匹配 13 位
                if dt is None:
                    match_13 = re.search(r'(\d{13})', file_name)

                    if match_13:
                        timestamp_str = match_13.group(1)
                        try:
                            timestamp_ms = int(timestamp_str)
                            # 转换为秒
                            timestamp_s = timestamp_ms / 1000.0

                            # 处理可能存在的本地时区问题,这里直接使用 fromtimestamp 获取本地时间
                            # 如果需要 UTC 时间,可以使用 utcfromtimestamp
                            try:
                                dt_temp = datetime.datetime.fromtimestamp(timestamp_s)
                            except (OSError, OverflowError, ValueError):
                                # Windows 上时间戳如果是负数或者太大可能会报错
                                # 对于 1970 年以前的时间戳,或者超大数值,跳过
                                continue

                            # 增加年份校验,防止匹配到非时间戳的长数字串 (如哈希值)
                            # 1970年对应的时间戳是0,2050年对应的时间戳大约是25亿
                            if 1970 <= dt_temp.year <= 2050:
                                dt = dt_temp
                                source = "文件名时间戳(13位)"
                        except Exception:
                            pass

                # 如果没有找到 13 位,也可以尝试找 10 位 (可选,视用户需求而定,用户主要提到 mmexport 格式通常是 13 位)
                if dt is None:
                    match_10 = re.search(r'(?<!\d)(\d{10})(?!\d)', file_name)
                    if match_10:
                        try:
                            timestamp_s = int(match_10.group(1))
                            # 简单的合理性校验:时间戳应该在 1970 年到 2038 年之间 (0 - 2147483647)
                            # 这里放宽一点,排除一些明显不是时间戳的数字(比如单纯的序号)
                            # 2000年是 946684800, 2030年是 1893456000
                            if 946684800 < timestamp_s < 2524608000:
                                dt = datetime.datetime.fromtimestamp(timestamp_s)
                                source = "文件名时间戳(10位)"
                        except Exception:
                            pass

        # 3. 应用修改
        if dt:
            try:
                # 获取文件的当前修改时间作为备选 atime
                # 使用 os.path.getatime 有时会返回 0 或无效值导致 utime 失败
                # 对于整理照片来说,atime 不重要,可以设置为当前时间或与 mtime 一致
                current_timestamp = dt.timestamp()

                # 打印调试信息
                # print(f"Preparing to set time for {file_name}: timestamp={current_timestamp} ({dt})")

                # os.utime 需要 (atime, mtime)
                # 这里我们将访问时间和修改时间都设置为拍摄时间,这是最安全的做法
                os.utime(file_path, (current_timestamp, current_timestamp))

                print(f"{file_name}: 拍摄日期设置为 {dt} (来源: {source}, 路径: {file_path})")
            except Exception as e:
                print(f"{file_name}: 应用时间修改失败: {e} (Attempted timestamp: {dt.timestamp() if dt else 'None'})")
                failed_files.append({"path": file_path, "name": file_name, "reason": f"应用修改失败: {e}"})
        else:
            # 只有当确实无法处理时才打印,或者打印出无法识别的文件以便用户处理
            print(f"{file_name}: 未找到元数据信息且无法从文件名提取有效时间戳,跳过 (路径: {file_path})")
            failed_files.append({"path": file_path, "name": file_name, "reason": "未找到有效时间信息"})

# 处理完成后,如果有失败的文件,导出到 Excel
if failed_files:
    try:
        # 获取桌面路径
        desktop_path = os.path.join(os.path.expanduser("~"), "Desktop")
        excel_path = os.path.join(desktop_path, "视频处理失败清单.xlsx")

        # 创建一个新的工作簿
        wb = openpyxl.Workbook()
        ws = wb.active
        ws.title = "Failed Videos"

        # 添加表头
        ws.append(["文件完整路径", "文件完整名", "失败原因"])

        # 添加数据
        for item in failed_files:
            ws.append([item["path"], item["name"], item["reason"]])

        # 调整列宽(可选,为了美观)
        ws.column_dimensions['A'].width = 50
        ws.column_dimensions['B'].width = 30
        ws.column_dimensions['C'].width = 30

        # 保存文件
        wb.save(excel_path)
        print(f"\n已将 {len(failed_files)} 个处理失败的视频文件信息导出到: {excel_path}")

    except Exception as e:
        print(f"\n导出 Excel 失败: {e}")
else:
    print("\n所有视频文件均处理成功!")
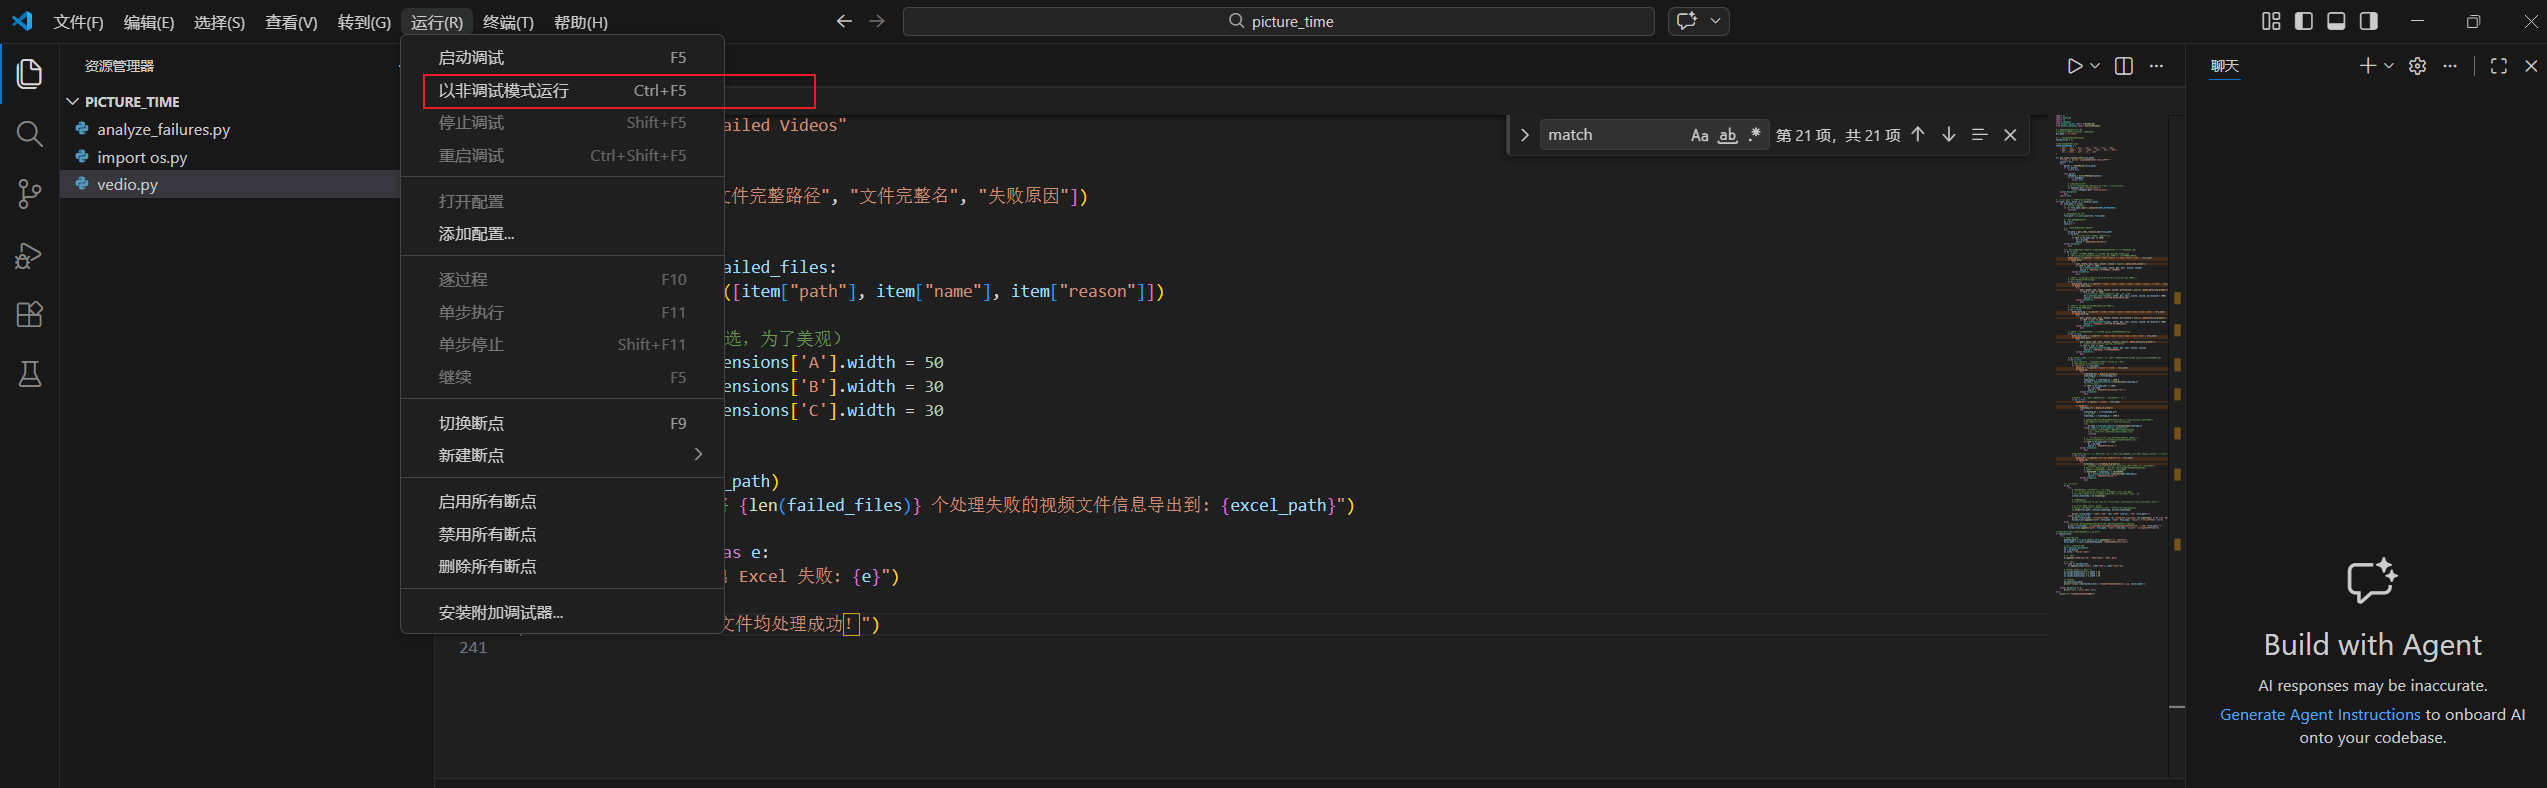
需要处理图片和视频依次点击对应的程序即可 vscode-运行-以非调试模式运行按钮
再点击python debugger即可
------------------------完毕 有疑问可添加企鹅 2466961646 有空会进行解答---------

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 6
 0
- 0


 已为社区贡献1条内容

所有评论(0)