基于K230的视觉数字识别系统(规则法 + AI方案)
·
一、项目背景
本项目基于 K230 视觉模块,实现对 0~9 数字的识别。
目标:
- 使用摄像头实时采集图像
- 提取图像中的数字区域
- 对数字进行识别
- 最终实现稳定识别系统
二、整体技术路线
本项目分为两个阶段:
第一阶段:规则法(传统视觉)
图像 → 阈值分割 → blob检测 → 区域划分 → 特征提取 → 规则分类
第二阶段:AI模型(深度学习)
摄像头采集图像
→ 输入检测模型(kmodel)
→ 模型完成:
- 数字区域定位(bounding box)
- 数字类别预测
→ 在画面中绘制检测框
→ 显示类别 + 置信度
三、规则法实现与分析
1️⃣ 核心思路
将数字区域分为三部分:
┌───────┐
│ 上区   │
├───────┤
│ 中区   │
├───────┤
│ 下区   │
└───────┘
提取特征:
top_ratio = top_pixels / total_pixels
mid_ratio = mid_pixels / total_pixels
bot_ratio = bot_pixels / total_pixels
2️⃣ 分类规则示例
def classify(top, mid, bot):
    if top > 0.20 and mid < 0.15:
        return "1"
    if top < 0.12 and mid > 0.15:
        return "4"
    return "unknown"
3️⃣ 实际问题与调试过程
❗问题1:始终识别为 background
原因:
- 阈值过大
(0,100) - 背景与数字连成一个 blob
解决:
BLACK_THRESHOLD = (0, 70, ...)
本质:分割失败 → blob过大
❗问题2:画面卡住
原因:
- 程序被强制中断
- Display / Sensor 未释放
解决:
try:
    while True:
        ...
except KeyboardInterrupt:
    print("stopped")
finally:
    sensor.stop()
    Display.deinit()
    MediaManager.deinit()
本质:嵌入式资源未释放
❗问题3:识别为 too small
原因:
- ROI变小
- blob面积变小
- 阈值未调整
解决:
if b_area > 500
❗问题4:识别不稳定
原因:
- 只取第一个 blob(顺序不稳定)
解决:
👉 选择最大面积 blob
❗问题5:识别错误
实际现象:
- 7 → 1
- 6 → 4
- 8 → 6
原因:
- 特征维度过低(仅 T/M/B)
- 丢失结构信息
4️⃣ 规则法局限
无法区分:
- 0 / 5 / 8
- 6 / 8
- 7 / 1
本质原因:
👉 特征空间重叠
5️⃣ 结论
规则法适用于:
- 结构简单目标
- 固定环境(如数码管)
不适用于:
- 手写数字
- 印刷字体识别
四、AI方案设计
规则法失败后,采用 AI 目标检测模型进行升级。
1️⃣ 数据采集
- 手机拍摄 0~9 数字
- 每类约 20 张
- 包含:
- 不同角度
- 不同距离
- 不同光照
2️⃣ 数据标注
平台:Kendryte 在线训练平台
操作:
- 创建数据集(图像检测)
- 上传图片
- 对每张图进行画框标注
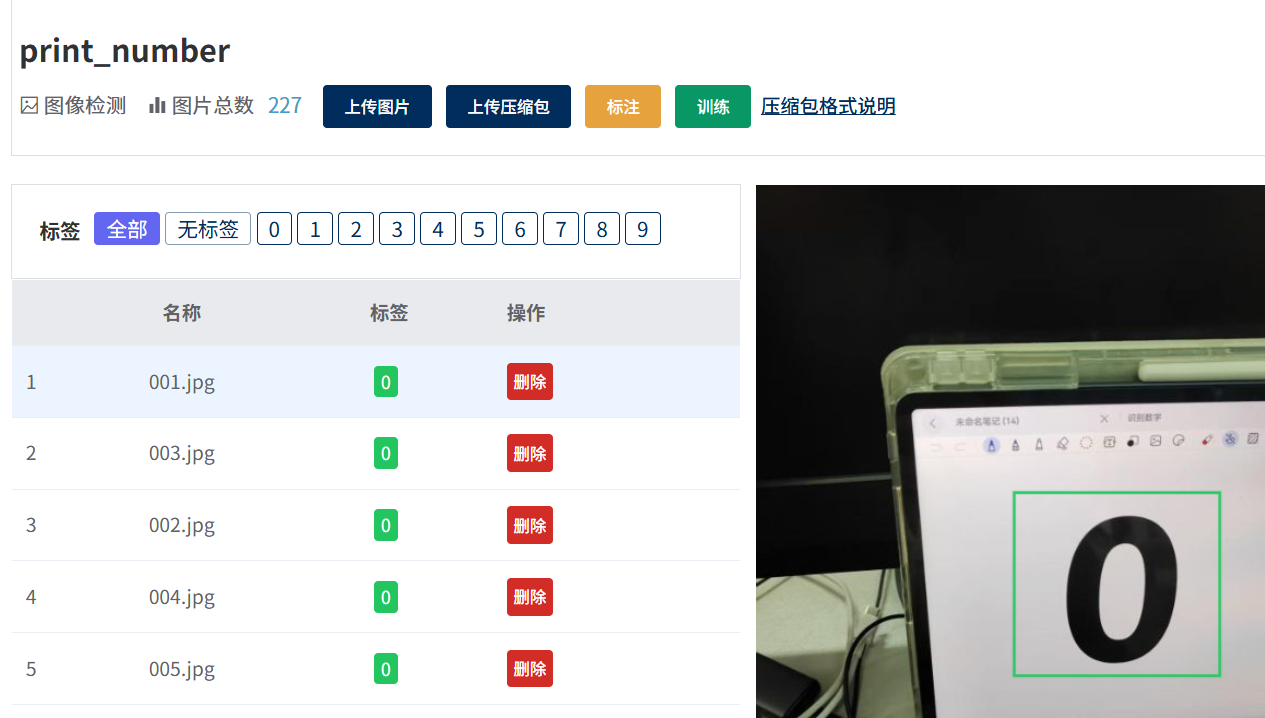
经验:
- 框越紧 → 效果越好
- 标注错误 → 直接影响结果
3️⃣ 模型训练
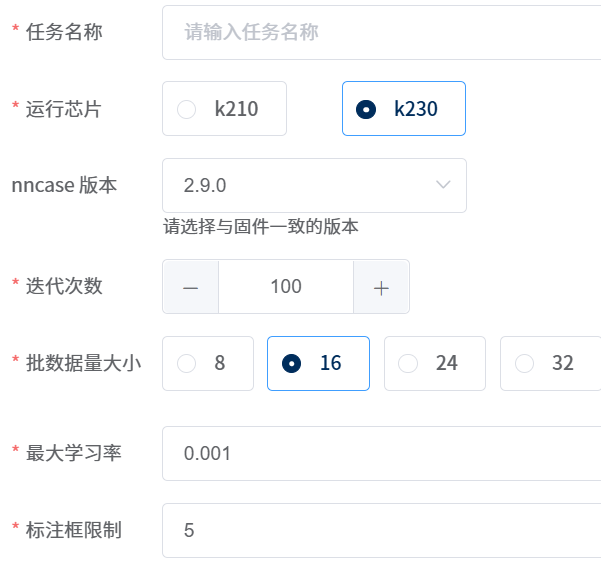
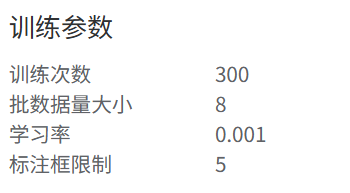
设置参数:
- epoch:300
- batch size:8
- learning rate:0.001
训练过程中:
- loss 逐渐下降
- loss 表示模型预测误差
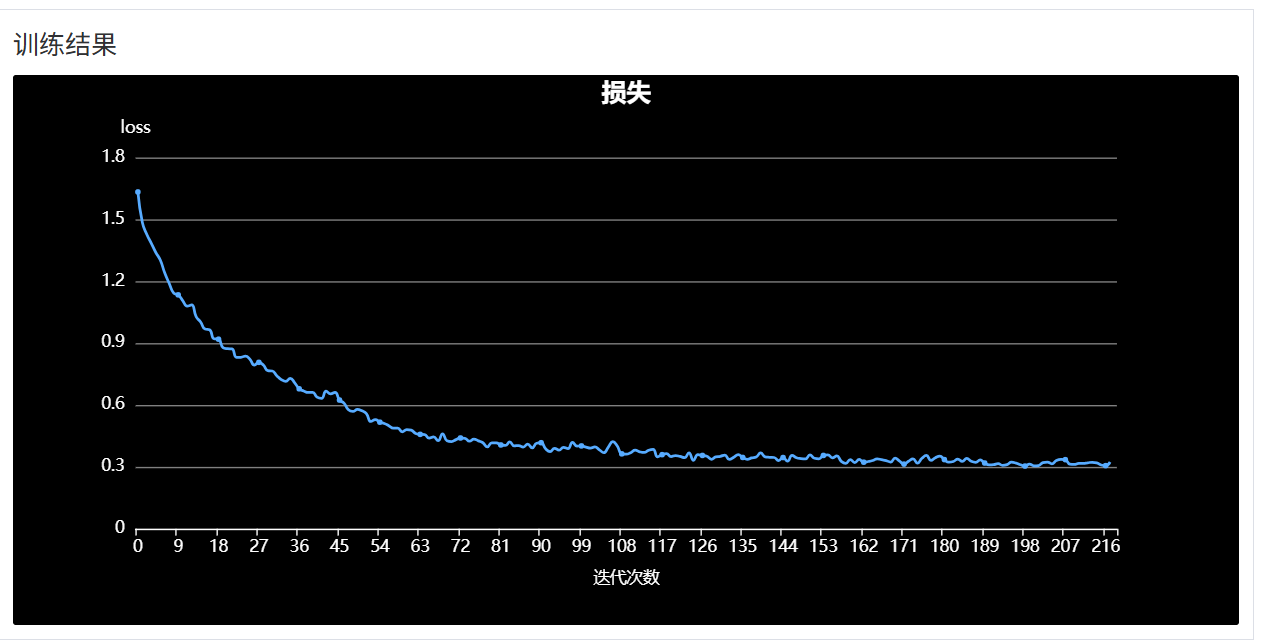
注意:
- loss ≠ 准确率
- loss 下降 ≠ 一定可用
4️⃣ 模型获取
训练完成后平台自动生成:
.kmodel(用于K230)- 推理代码(Python)
无需手动转换 ONNX → kmodel
五、部署与运行
1️⃣ 部署步骤
- 拷贝
.kmodel和代码到开发板 - 运行官方脚本:
det_video_1_3.py
(实现:摄像头 + 推理 + 显示)
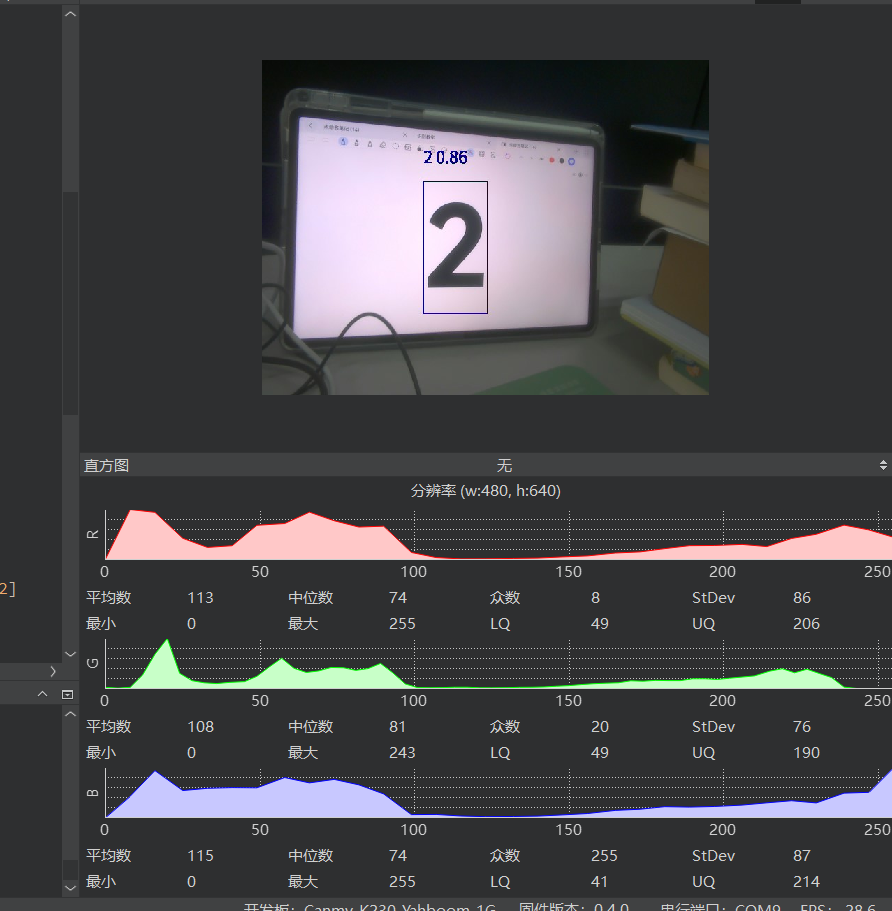
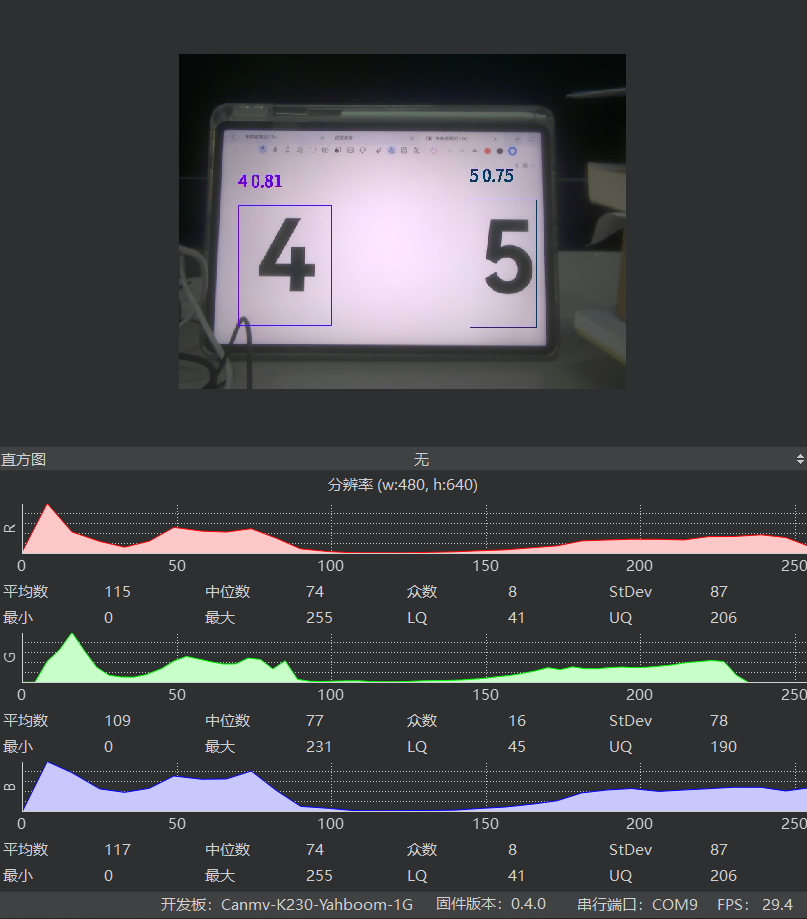
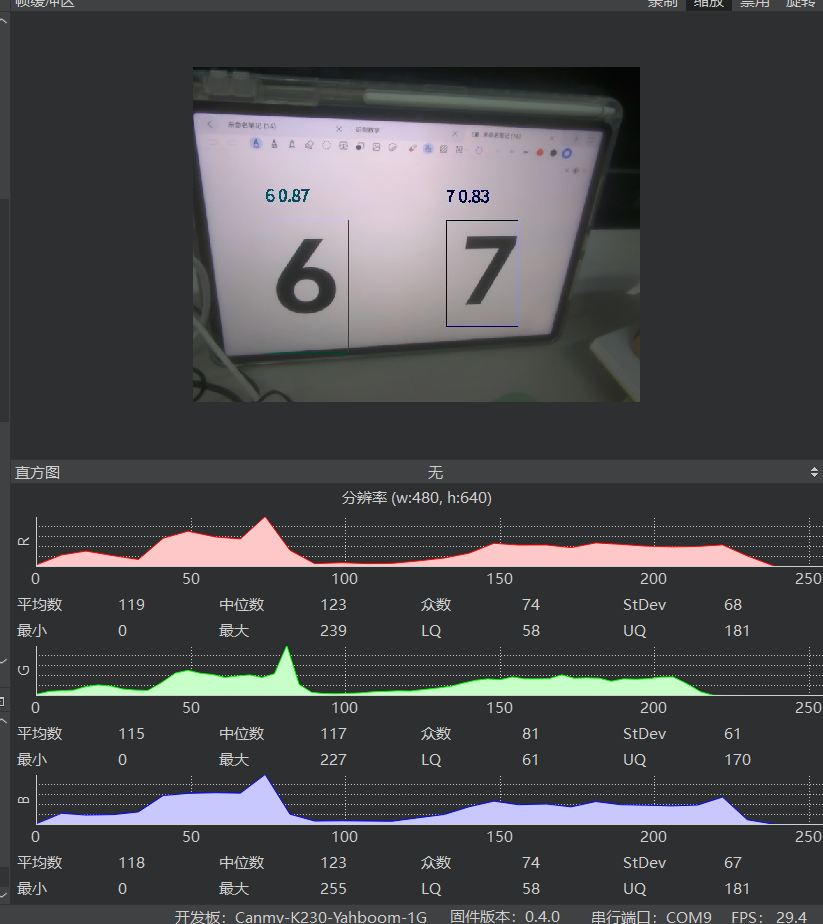
2️⃣ 实时识别流程
运行后:
摄像头画面
→ 模型自动检测数字位置
→ 画框
→ 显示类别 + 置信度
六、核心视觉概念(项目中涉及)
1️⃣ 颜色空间
RGB vs LAB:
- RGB:直接显示
- LAB:更适合分割
本项目使用:
BLACK_THRESHOLD = (0, 70, -128, 127, -128, 127)
本质:筛选暗像素
2️⃣ 阈值分割
根据条件筛选像素:
img.find_blobs(...)
影响:
- 阈值过小 → 数字断裂
- 阈值过大 → 全屏 blob
3️⃣ Blob(连通区域)
表示一块连在一起的区域
包含:
- x, y
- w, h
- area
- cx, cy
4️⃣ ROI(感兴趣区域)
只处理图像局部:
roi = (200, 120, 200, 200)
作用:
- 减少干扰
- 提高稳定性
5️⃣ 特征提取
规则法中:
[T, M, B]
AI中:
👉 自动学习特征
七、规则法 vs AI
| 项目 | 规则法 | AI |
|---|---|---|
| 实现难度 | 低 | 中 |
| 精度 | 低 | 高 |
| 鲁棒性 | 差 | 强 |
| 可扩展性 | 差 | 强 |
八、后续优化方向
1️⃣ 扩充数据集
每类 ≥ 100 张
2️⃣ 增加数据多样性
- 光照
- 角度
- 距离
3️⃣ 提升模型泛化能力
🎯 总结
本项目从规则法出发,逐步过渡到 AI 方案,实现了:
- 视觉分割
- 连通域分析
- 特征提取
- AI模型训练与部署

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐


 11
 0
- 0


 已为社区贡献1条内容

所有评论(0)