JAVA | HashMap 的底层实现原理,如何处理哈希冲突的
·
文章目录
概要 —— HashMap
如果想知道哈希冲突的处理方案,首先要了解 HashMap 数据结构:
- 在Java语言中,集合框架主要分为两大体系
- Collection 接口(存储单个元素)
- List
- Set
- Map接口(存储键值对 key-value)
- HashMap
- Collection 接口(存储单个元素)

根据以上图示,我们可以了解到 HashMap 是Java 集合框架 中 Map接口的实现类。
下面我们会进一步去探索 HashMap 的具体实现原理。
原理介绍
首先要知道的是 HashMap 是基于 哈希表(Hash Table) 实现的。
- HashTable 一个古老(1.1版本)的线程安全的哈希表实现类。(方法级 synchronized),已过时。
- 推荐使用 ConcurrentHashMap 代替(CAS + synchronized)。
当然了,以上内容了解一下就好。并不是本次文章的重点,下面才是:
HashMap 结构:
- 数组 + 链表 + 红黑树 的结构来存储键值对。(key-value pairs)
核心目标
- 实现 平均 O(1) 的时间复杂度进行插入、查找 和删除操作。
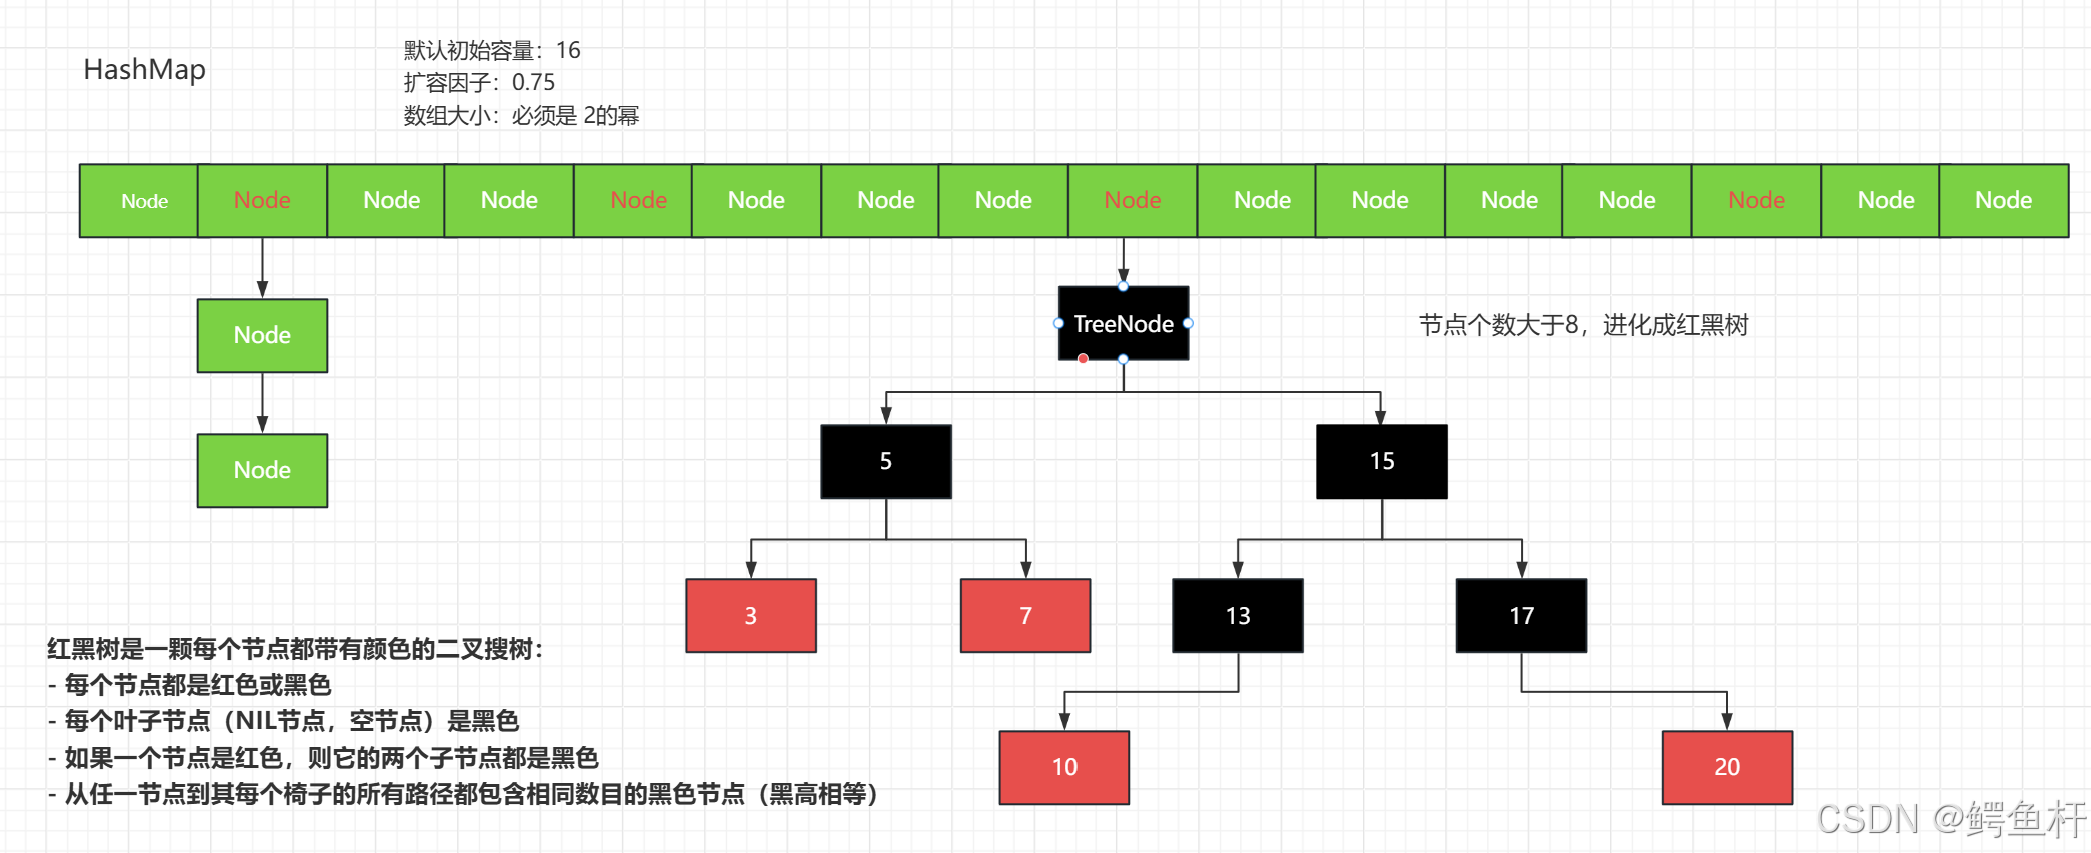
看图的同时,我们还可以小看一下源码,辅助了解。
- 初始容量
- 最大容量
- 扩容因子
- 转红黑树阈值(1.8)
- 退化链表阈值(1.8)
- 最小树化容量(1.8)
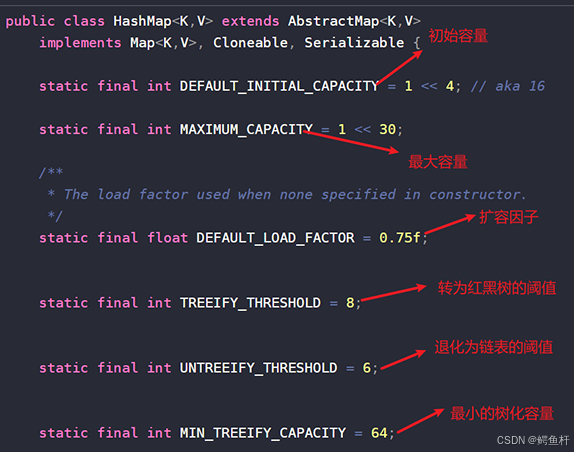
看完上面的内容,能知道 HashMap 是个什么?
- 一个键值对集合( key-value ),由 数组 + 链表 + 红黑树组成。
这就会出现另一个问题:
- 那 Hash冲突 又是什么呢?
- 哈希冲突是指不同的 key 经过哈希计算后,得到了相同的数组索引。
- 简而言之,两个数据抢一个数组位置。
如何处理哈希冲突
不论是,1.8版本之前,还是1.8版本之后,基础的解决办法都是:
-
链地址法(Separate Chaining)也称为 拉链法 来解决冲突:
- 当多个 key 映射到同一个桶(数组位)时,这些 Node 会以 链表 的形式连接起来,形成一个单向链表。
- 每个 Node 包含 key、value、hash 和指向下一个节点的 next 引用。
这样,即使发生冲突,数据也可以通过 链表的形式存储。
JDK 1.8 的关键优化(3)
为什么做优化?
- 这是由于当链表过长,查询 HashMap时,会有很大的概率到 链表 中搜索,这就导致查询效率下降,查找时间复杂度退化为 O(n)。
优化一:引入红黑树(Treeify)
问题背景:
- 在极端情况下,如果大量 key 的哈希值都映射到同一个桶,链表会变得很长,查找时间复杂度退化为 O(n)。
解决方案:
- 当链表的长度达到或超过 8,并且当前数组的长度 大于等于 64 时,HashMap 会将该链表 转为 红黑树(进化阈值)。
好处:
- 红黑树是一种自平衡二叉查找树,查找、插入、删除的时间复杂度 O(log n),远优于长链表的 O(n)。
还原机制:
- 当红黑树中的节点数量减少到 6 个以下 时,会重新转回链表,以节省空间。(退化条件)
优化二:优化了哈希函数(扰动函数)
JDK 1.8 对 hashCode() 的结果进行了更充分的扰动:
static final int hash(Object key) {
    int h;
    //hashCode值右移16位
    //0000 0000 0000 0001 1111 1111 1111 1111
    //                   ^   (异或)
    //0000 0000 0000 0000 0000 0000 0000 0001
    return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}
- 将高 16 位与低 16 位进行异或,使得哈希值的 高位也参与索引计算,减少碰撞概率,尤其是在数组长度较小时。
优化三:链表插入方式从头插法改为尾插法
JDK 1.7 及之前:
- 使用 头插法,在扩容时会反转链表顺序,且在多线程环境下可能导致死循环。
- 在扩容的时候,节点顺序会反转,next会重新更改指向。
- 由于并发问题,可能导致 A 的 next 指向 B,B 的 next 又指向 A,形成环:A <-> B
JDK 1.8:
- 改为 尾插法,保证了链表的顺序不变。
- 扩容时,不会改变原有节点的 next 指向关系,即使在并发环境下,也不会形成环。
应用场景
实际应用建议:
new HashMap<>(32); // 避免频繁扩容,根据需求而定
1、统计与计数(Counting)
- 统计元素出现的次数,如词频统计、用户行为分析。
- 要实现该功能需要了解一个方法:getOrDefault
- 简化“获取值或返回默认值”的逻辑-。
// 1、key:要查找的键  2、defaultValue:如果 key 不存在(即 map.get(key) 返回 null),则返回该默认值。
  public V getOrDefault(Object key, V defaultValue) {
      Node<K,V> e;
      //map.get(key) 为 null,则返回该默认值
      //map.get(key) 不为 null,则返回key的value
      return (e = getNode(key)) == null ? defaultValue : e.value;
  }
实践代码
// 示例:统计订单中每种商品的购买数量
        //1、模拟存储10个订单
        ArrayList<Order> orders = new ArrayList<>();
        for (int i = 0; i < 10 ; i++) {
            orders.add(new Order("商品" + i));
        }
        //2、创建计数map:
        //key:商品名称    value:商品数量
        Map<String, Integer> itemCount = new HashMap<>();

        for (Order orderItem : orders) {
            itemCount.put(
                    orderItem.getProductName(),
                    itemCount.getOrDefault(orderItem.getProductName(), 0) + 1
                    );
        }
        //3、获取所有key,打印输出
        for (Map.Entry<String, Integer> entry : itemCount.entrySet()) {
            System.out.println(entry.getKey() + ": " + entry.getValue());
        }
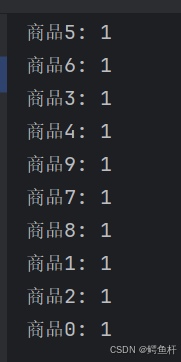
试一下会发现,以上代码会呈现如下情况:
- hashMap 不会保证元素有序。
2、去重(Deduplication)
- 利用 HashMap 的 key 不可重复 特性,快速去重。
- 防止重复提交订单、去重推送消息等。
实践代码
// 示例:去除重复的用户ID
        //1、模拟用户id
        List<Long> userIds = Arrays.asList(1L, 4L, 3L, 2L, 1L);

        //2、去重map
        Map<Long, Boolean> seen = new HashMap<>();

        //3、去重后的用户id
        List<Long> uniqueIds = new ArrayList<>();

        //4、去重操作
        for (Long id : userIds) {
            // put 返回 null 表示 key 不存在,也就是用户id不重复
            if (seen.put(id, true) == null) {
                uniqueIds.add(id);
            }
        }
        for (Long uniqueId : uniqueIds) {
            System.out.println(uniqueId);
        }
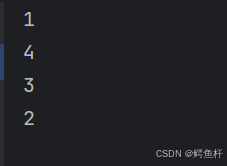
结果肯定也是 去重成功 !可以试一下。
当然,我也有相应的运行结果:
- ArrayList 是有序集合,可以保证元素的插入顺序不会发生改变,是插入顺序。
总结
| 问题 | 简要回答 |
|---|---|
| HashMap 的底层结构? | 数组 + 单向链表 + 红黑树 |
| 如何计算 hash 值? | (h = key.hashCode()) ^ (h >>> 16) |
| 为什么长度是 2 的幂? | 便于用 hash & (length-1) 替代取模运算 |
| 负载因子为什么是 0.75? | 时间与空间的折中,统计学最优值 |
| 为什么链表转红黑树阈值是 8? | 基于泊松分布,概率极低,说明哈希已不均 |
| HashMap 是线程安全的吗? | 不是,可用 ConcurrentHashMap 或 Collections.synchronizedMap() |
| JDK 1.7 与 1.8 的区别? | 1.8 引入红黑树、尾插法、优化 hash 函数,增加扰动 |
各位再见!这里是 鳄鱼杆的空间,钓……鳄鱼的杆儿!
期待下次再会!
愿你的每一次垂钓之旅都能满载而归。

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐

 30
 0
- 0


 已为社区贡献3条内容

所有评论(0)