LangChain 核心组件之---Agent 代理
LangChain Agent 代理
)
一、 Agent 基本概念
在 LangChain 中,Agent(代理) 是一个能够基于用户输入动态决定采取哪些行动的组件。它可以根据当前情况进行推理、规划,并调用工具来完成复杂任务,而不仅仅是执行预定义的流程。
LangChain 框架的 Agent 组件,它是一种高级组件,能将 LangChain 的工具和链整合到一起。总结: agent(代理)是在chain(链)的基础上,能够自主决策并使用tool(工具)的高级组件。
Agent 的核心作用在于:
- 自主决策:根据输入和环境决定下一步行动
- 工具调用:利用外部工具(API、数据库、搜索引擎等)扩展能力
- 流程管理:处理多步骤任务,必要时进行循环或回溯
- 结果整合:将工具返回的信息整理为自然语言回答
在 LangChain 生态中,Agent 处于核心协调者的位置,连接语言模型(LLM)、工具和用户需求,使 AI 系统能够处理超出纯文本生成的复杂任务。
二、 Agent 体系
2.1 Agent 类结构
LangChain 中的 Agent 基类是整个 Agent 体系的核心基础,为各类具体 Agent 实现提供了统一的框架和通用功能。
| 属性 | 类型 | 描述 |
|---|---|---|
| llm_chain | LLMChain | 用于决策的语言模型链 |
| tools | List[Tool] | Agent 可以使用的工具列表 |
| verbose | bool | 是否输出详细日志 |
| return_intermediate_steps | bool | 是否返回中间步骤 |
| 方法名 | 类型 | 作用 | 参数说明 | 返回说明 |
|---|---|---|---|---|
| plan | 核心方法 | 根据历史步骤和当前输入制定下一步行动策略 | intermediate_steps: List [Tuple [Action, str]] - 已执行的动作及观察结果列表inputs: Dict [str, Any] - 当前任务输入参数 | List[Action] :返回包含下一步要执行的动作列表,每个动作指定工具名称和输入参数 |
| act | 核心方法 | 根据工具返回结果决定后续操作 | observation: str - 工具执行后的返回结果 | AgentResult: 返回包含最终结果或下一轮动作的对象,封装了决策结果和日志信息 |
| run | 入口方法 | 启动 Agent 完整工作流程,处理用户输入 | inputs: Union [str, Dict [str, Any]] - 用户输入(字符串或键值对字典) | str:返回任务最终处理结果(自然语言回答),内部协调 plan 和 act 方法完成流程 |
| _fix_text | 辅助方法 | 标准化处理文本格式,确保解析兼容性 | text: str - 需要处理的原始文本 | str: 返回格式化后的文本,通常用于修正换行、特殊字符等可能导致解析错误的问题 |
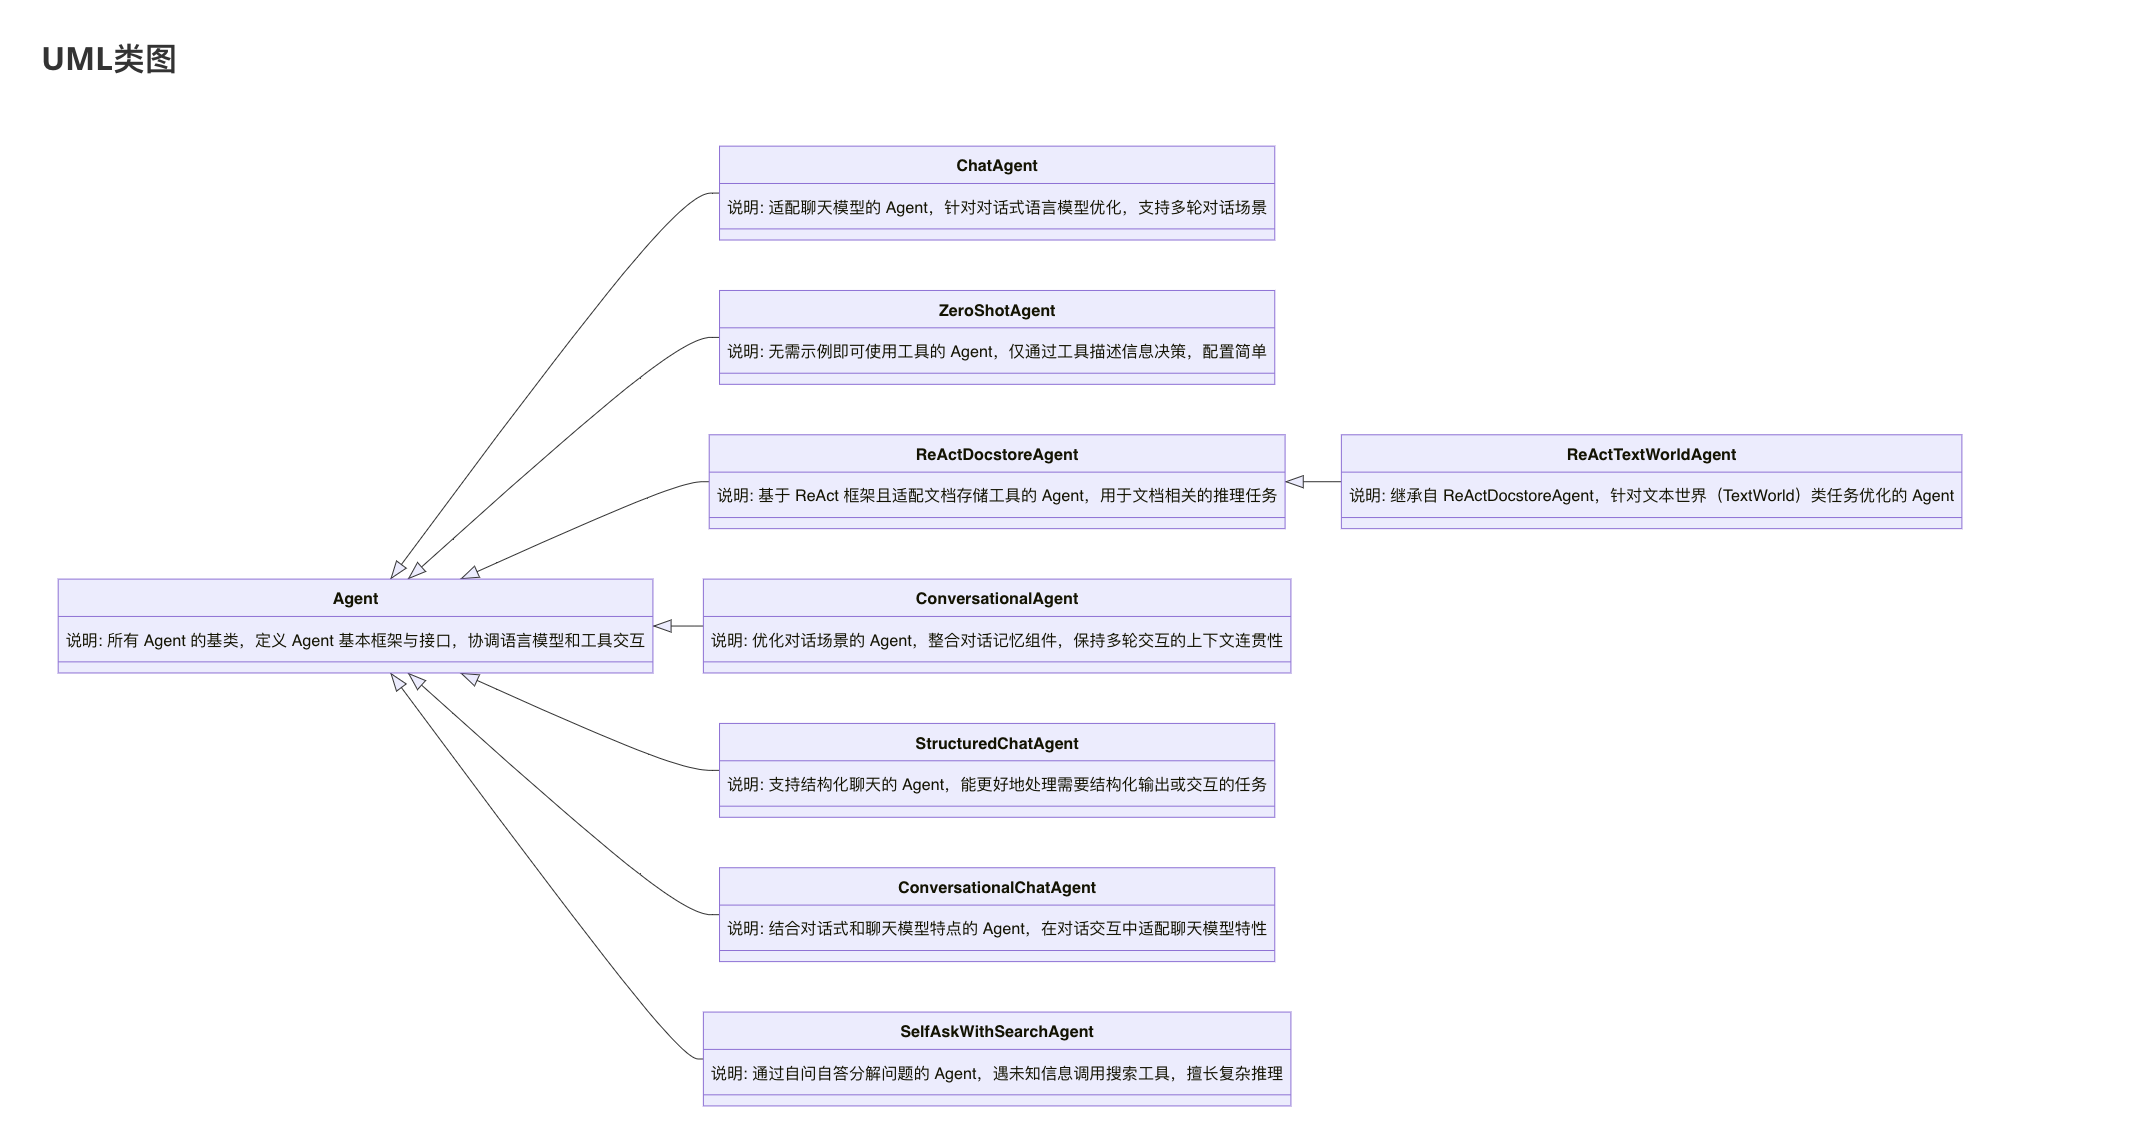
UML类图
2.2 相关子类
| 子类名称 | 核心特性 | 典型应用场景 | 关键优势 |
|---|---|---|---|
ChatAgent | 1. 专为聊天模型设计 2. 支持多轮对话的上下文管理 3. 优化工具调用适配聊天模型输出 | 智能客服、对话式助手、多轮交互任务 | 与聊天模型兼容性好,对话流畅度高,工具调用自然融入交互过程 |
ZeroShotAgent | 1. 无需示例即可调用工具 2. 仅通过工具描述判断调用逻辑 3. 配置简单,开箱即用 | 简单工具调用场景(如单一 API 调用、基础信息查询) | 接入成本低,无需准备示例数据,适合快速搭建基础工具调用能力 |
ReActDocstoreAgent | 1. 遵循 “思考 - 行动 - 观察”(ReAct)框架 2. 原生支持文档存储工具(FAISS、Chroma) 3. 推理过程透明可追溯 | 文档问答、知识库检索、长文本分析 | 决策过程可解释性强,与文档类工具交互高效,适合需要追溯推理依据的场景 |
ReActTextWorldAgent | 1. 继承 ReAct 框架 2. 针对文本世界(TextWorld)游戏 / 任务优化 3. 强化环境交互决策 | 文本冒险游戏、文字类任务自动化、交互式叙事生成 | 擅长处理文本环境中的状态感知与动作决策,能适应动态变化的文本交互场景 |
ConversationalAgent | 1. 集成对话记忆(ConversationBufferMemory)2. 支持上下文指代(如 “它”“前者”) 3. 优化多轮对话连贯性 | 聊天机器人、持续性咨询服务、上下文依赖的交互任务 | 能理解上下文关联,支持长对话场景,可处理指代关系等复杂对话元素 |
StructuredChatAgent | 1. 支持结构化输出(如 JSON、表格) 2. 适配需要格式约束的工具调用 3. 强化参数校验逻辑 | 表单生成、数据查询与格式化输出、API 接口调用(需固定参数格式) | 输出格式规范可控,参数校验严格,适合对结果格式有明确要求的场景 |
ConversationalChatAgent | 1. 融合对话记忆与聊天模型特性 2. 优化聊天模型的对话流畅度 3. 平衡工具调用与自然交互 | 高端对话助手、兼具工具能力的聊天机器人、复杂场景的交互式解决问题 | 兼顾长对话记忆与聊天模型的交互优势,工具调用与自然对话过渡自然 |
SelfAskWithSearchAgent | 1. 通过 “自问自答” 分解复杂问题 2. 仅在遇到未知信息时调用搜索工具 3. 擅长逻辑链较长的推理 | 多步骤推理任务、知识密集型问答(如 “XX 事件的影响及后续发展”)、复杂决策支持 | 能将复杂问题拆解为子问题,推理逻辑性强,搜索工具调用更精准高效 |
关键关系说明
ReActTextWorldAgent继承自ReActDocstoreAgent,保留了 ReAct 框架的核心推理逻辑,同时针对文本世界任务增强了环境交互能力,是对特定场景的深度适配。- 各类 Agent 虽无直接继承关系,但均围绕 “语言模型 + 工具调用” 的核心逻辑展开,只是在推理框架、交互模式、场景适配等方面各有侧重。
2.3 工具组件
在第一章节 我们说明了agent是chain+tool的组合。langchain给我们提供了很多可以使用的tool工具组件,当然你也可以自定义实现工具来丰富它。
- 工具组件(Tools):是 Agent 与外界互动的接口,本质是 Agent 可使用的函数,形式多样,既可以是通用实用程序(如搜索功能),也能是其他工具组件链,甚至是其他 Agent 组件。
- 工具组件包(Toolkits) :是用于完成特定任务的工具组件集合,具有便捷的加载方法,它把一组有共同目标或特性的工具组件整合起来,为用户提供统一且便捷的使用方式,方便用户完成特定任务。
如下是langchain提供给我们可以在agent中使用的工具集合。
| 工具组件名称 | 功能描述 |
|---|---|
| AIPluginTool | 允许用户将其他人工智能模型或服务集成到系统中 |
| APIOperation | 用于调用外部 API |
| ArxivQueryRun | 用于查询 Arxiv 平台内容 |
| AzureCogsFormRecognizerTool | 利用 Azure 认知服务中的表单识别器功能 |
| AzureCogsImageAnalysisTool | 利用 Azure 认知服务中的图像分析功能 |
| AzureCogsSpeech2TextTool | 利用 Azure 认知服务中的语音转文本功能 |
| AzureCogsText2SpeechTool | 利用 Azure 认知服务中的文本转语音功能 |
| BaseGraphQLTool | 用于发送 GraphQL 查询的基础工具组件 |
| BaseRequestsTool | 用于发送 HTTP 请求的基础工具组件 |
| BaseSQLDatabaseTool | 用于与 SQL 数据库交互的基础工具组件 |
| BaseSparkSQLTool | 用于执行 Spark SQL 查询的基础工具组件 |
| BingSearchResults | 用于获取 Bing 搜索结果 |
| BingSearchRun | 用于执行 Bing 搜索 |
| BraveSearch | 用于执行 Brave 搜索 |
| ClickTool | 模拟点击操作 |
| CopyFileTool | 用于复制文件 |
| CurrentWebPageTool | 用于获取当前网页信息 |
| DeleteFileTool | 用于删除文件 |
| DuckDuckGoSearchResults | 用于获取 DuckDuckGo 搜索结果 |
| DuckDuckGoSearchRun | 用于执行 DuckDuckGo 搜索 |
| ExtractHyperlinksTool | 用于从文本或网页中提取超链接 |
| ExtractTextTool | 用于从文本或其他源中提取文本 |
| FileSearchTool | 用于搜索文件 |
| GetElementsTool | 用于从网页或其他源中获取元素 |
| GmailCreateDraft | 用于创建 Gmail 草稿 |
| GmailGetMessage | 用于获取 Gmail 消息 |
| GmailGetThread | 用于获取 Gmail 线程 |
| GmailSearch | 用于搜索 Gmail 内容 |
| GmailSendMessage | 用于发送 Gmail 消息 |
| GooglePlacesTool | 用于搜索 Google Places 内容 |
| GoogleSearchResults | 用于获取 Google 搜索结果 |
| GoogleSearchRun | 用于执行 Google 搜索 |
| GoogleSerperResults | 用于获取 Google SERP(搜索引擎结果页面)内容 |
| GoogleSerperRun | 用于执行 Google SERP 查询 |
| HumanInputRun | 用于模拟人类输入 |
| IFTTTWebhook | 用于触发 IFTTT(If this Then that)服务的工作流程 |
| InfoPowerBITool | 用于获取 Power BI 信息 |
| InfoSQLDatabaseTool | 用于获取 SQL 数据库信息 |
| InfoSparkSQLTool | 用于获取 Spark SQL 信息 |
| JiraAction | 用于在 Jira 上执行操作 |
| JsonGetValueTool | 用于从 JSON 数据中获取值 |
| JsonListKeysTool | 用于列出 JSON 数据中的键 |
| ListDirectoryTool | 用于列出目录内容 |
| ListPowerBITool | 用于列出 Power BI 信息 |
| ListSQLDatabaseTool | 用于列出 SQL 数据库信息 |
这些工具组件的具体实现和功能可能会根据实际的需求和环境进行调整。
三、Agent运行机制
3.1 Agent执行流程
- Agent 负责制定行动计划(调用
plan方法生成含工具名、输入等的AgentAction对象)。 - AgentExecutor 调用 Agent 的
plan方法获取下一步行动。 - AgentExecutor 执行该行动(调用对应工具方法),处理工具执行错误、输出解析错误等复杂情况。
- AgentExecutor 记录行动及执行结果,用于后续决策并生成日志。
- 重复步骤 2 - 4,直至完成任务,可通过调用 AgentExecutor 的
run方法启动流程。
flowchart
    A[创建 Agent 组件]--传递给 AgentExecutor--> C[调用 AgentExecutor 的 run 方法启动流程]
    C --> D[AgentExecutor 调用 Agent 的 plan 方法]
    D --生成 AgentAction(含工具名、输入等)--> F[AgentExecutor 执行 AgentAction(调用对应工具)]
    F --> G[工具执行是否出错?]
    G -- 是 --> H[AgentExecutor 处理错误]
    G -- 否 --> I[记录行动和执行结果]
    H --> I
    I --> J[任务是否完成?]
    J -- 否 --> D
    J -- 是 --> K[流程结束,输出结果]
3.2 AgentExecutor
在 LangChain 中,AgentExecutor 是 Agent 体系里 负责 “执行调度” 的核心组件,是各类 Agent 能完成任务的 “运行载体”。简单来说,Agent 负责 “思考做什么(生成行动决策)”,而 AgentExecutor 负责 “如何做到(管理执行流程)”。
| 特性 | 说明 |
|---|---|
| 解耦设计 | 让 Agent 专注 “决策逻辑”,AgentExecutor 专注 “执行调度”,提升代码可维护性。 |
| 循环控制 | 通过 max_iterations(最大迭代次数)、max_execution_time(最长执行时间)防止 Agent 陷入无限循环。 |
| 异常处理 | 可配置 handle_parsing_errors,自动处理 Agent 输出格式错误(如工具调用指令格式不符合预期)。 |
| 可观测性 | 开启 verbose 后,会打印每一步的决策、工具调用、结果,便于调试。 |
| 中间步骤存储 | 若 return_intermediate_steps=True,会保存 “决策→工具调用→结果” 的完整中间过程,方便结果追溯。 |
- 任何需要 Agent 调用工具的任务:从简单的 “搜索 + 总结”,到复杂的 “多工具协作(搜索→数据分析→文档生成)”,都需
AgentExecutor驱动。 - 需要控制 Agent 行为边界:比如限制 Agent 最多调用工具 10 次,或执行时间不超过 1 分钟,通过
AgentExecutor的参数实现。 - 调试 Agent 流程:开启
verbose和return_intermediate_steps,可清晰看到 Agent 每一步的思考和工具调用,快速定位问题。
通过 AgentExecutor,LangChain 实现了 “决策” 与 “执行” 的分离,让 Agent 更专注于逻辑,也让执行流程更可控、可观测。
四. 相关子类的使用
LangChain 中 Agent 组件的设计高度依赖大语言模型的推理能力,且内置的 Agent 组件都预设了这一前提。正因如此,Agent 组件的效能与状态在很大程度上取决于所使用的提示词策略,而这些内置 Agent 组件大多采用了 ReAct 框架的提示词策略。
子类使用可以考虑使用两种方式
- 子类Agent本身的from_llm_and_tools方法 ,需要自己实现提示词信息,灵活可控
#获取agent
agent = ZeroShotAgent.from_llm_and_tools(llm=llm,
                                         tools=tools,
                                         prefix=PREFIX,
                                         suffix=SUFFIX,
                                         format_instructions=FORMAT_INSTRUCTIONS,
                                         input_variables=["input", "agent_scratchpad"],  # 必须包含的输入变量
                                         verbose=True)
#获取agent_executor 去进行执行
agent_executor = AgentExecutor.from_agent_and_tools(
        agent=agent,
        tools=tools,
        verbose=True,  # 显示详细执行过程
        max_iterations=5,  # 限制最大迭代次数,防止无限循环
        handle_parsing_errors=True  # 自动处理解析错误
    )
- 使用initialize_agent方法,简单,不需要自己实现提示词
zero_shot_agent = initialize_agent(
    tools,
    llm,
    agent=AgentType.ZERO_SHOT_REACT_DESCRIPTION,
    verbose=True,  # 显示详细执行过程
    max_iterations=5,  # 限制最大迭代次数,防止无限循环
    handle_parsing_errors=True  # 自动处理解析错误
)
initialize_agent其实是将agentType对应的class 的from_llm_and_tools 创建agent以及生成对应的AgentExecutor对象。
初始化工具
from bs4 import BeautifulSoup
import requests

def calculator_function(expression: str) -> str:
    """简单的计算器工具,用于执行数学运算"""
    try:
        # 仅支持基础运算,实际使用需考虑安全问题
        result = eval(expression)
        return f"计算结果:{expression} = {result}"
    except Exception as e:
        return f"计算错误:{str(e)}"


def search(query: str) -> str:
    """搜索工具类"""
    print("正在使用搜索...")
    url = f"https://www.bing.com/search?q={query}"
    headers = {"User-Agent": "Mozilla/5.0"}
    response = requests.get(url, headers=headers)
    soup = BeautifulSoup(response.text, "html.parser")
    results = soup.find_all("li", class_="b_algo")[:3]  # 取前3条结果
    list_hrefs = "\n".join([result.find("a")['href'] for result in results if result.find("a") is not None])
    return list_hrefs

def get_tools() -> list[Tool]:
    """获取agent所使用的工具集合"""
    return [
        Tool(
            name="Current Search",
            func=search,
            description="当需要获取最新信息、实时数据或不确定的事实时使用,例如天气、新闻、事件结果等"
        ),
        Tool(
            name="Calculator",
            func=calculator_function,
            description="当需要进行数学计算时使用,接受数学表达式作为输入,例如'2+3*4'、'100/5'"
        )
    ]
4.1 ZeroShotAgent使用
ZeroShotAgent 是 LangChain 中基础且通用的代理类型,核心能力是无需提前针对特定工具训练(零样本),仅通过工具描述和提示词引导,就能基于语言模型推理选择合适工具完成任务。
特点:
- 深度适配文本模型的推理逻辑,对基础文本模型(如 GPT-3.5-turbo-instruct)兼容性好
- 支持工具调用的动态决策,无需预设固定工具调用流程
- 工具调用指令通过标准化提示词格式定义,便于解析和执行
- 适合快速搭建基础工具调用能力,无需复杂配置的场景
ZeroShotAgent代码示例
注意: 重点关注提示词
def test_zero_shot_agent(modelName: str):
    # 1、获取工具
    tools = get_tools()

    # 2、获取chain链
    llm = getChatModel(modelName)

    # 3. 使用 from_llm_and_tools 方法创建 ZeroShotAgent
    # 自定义提示词前缀和后缀(可选,默认使用内置模板)
    PREFIX = "你是一个实用工具助手,可以使用提供的工具回答问题。请根据问题选择合适的工具。"
    SUFFIX = """
    开始处理问题:{input}
    {agent_scratchpad}
    """

    FORMAT_INSTRUCTIONS = """
    如果需要使用工具,请按以下格式输出:
    Action: 工具名称(必须是Weather或Time)
    Action Input: 工具的输入参数(如果工具不需要参数则留空)

    如果不需要使用工具,直接回答问题,请按以下格式输出:
    Final Answer: 你的答案
    """

    # 4、创建ZeroAgent
    agent = ZeroShotAgent.from_llm_and_tools(llm=llm,
                                             tools=tools,
                                             prefix=PREFIX,
                                             suffix=SUFFIX,
                                             format_instructions=FORMAT_INSTRUCTIONS,
                                             input_variables=["input", "agent_scratchpad"],  # 必须包含的输入变量
                                             verbose=True)
    # 5. 创建Agent执行器(必须通过AgentExecutor运行Agent)
    agent_executor = AgentExecutor.from_agent_and_tools(
        agent=agent,
        tools=tools,
        verbose=True,  # 显示详细执行过程
        max_iterations=5,  # 限制最大迭代次数,防止无限循环
        handle_parsing_errors=True  # 自动处理解析错误
    )

    # 6、调用
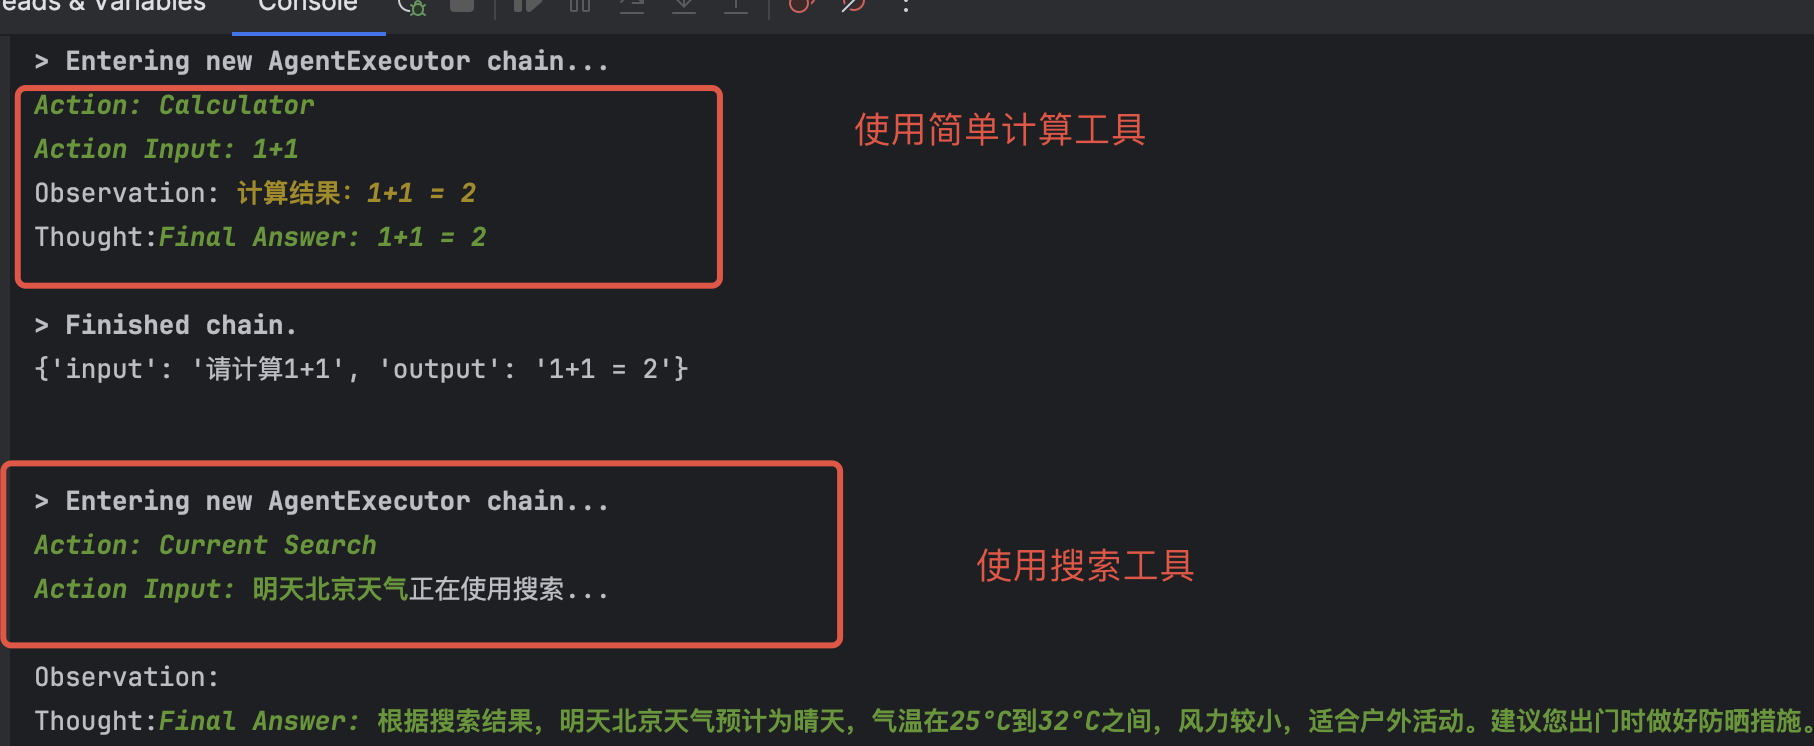
    cal_resp = agent_executor.invoke({"input": "请计算1+1"})
    print(cal_resp)
    search_resp = agent_executor.invoke({"input": "帮我看看明天北京天气是怎么样的"})
    print(search_resp)
注意:在 ZeroShotAgent 的提示词模板中,{agent_scratchpad} 是必须的,它也是 Agent 实现 “多轮推理 - 工具调用循环” 的核心变量
回答结果
4.2 ChatAgent使用
ChatAgent 是专为聊天模型设计的代理,能够自然地将工具调用融入对话流程中。
特点:
- 深度适配聊天模型(如 GPT-3.5/4)的输出格式
- 支持多轮对话的上下文连贯性管理
- 工具调用指令会以自然语言方式嵌入对话中
- 适合需要自然交互体验的对话场景
def test_chat_agent(modelName: str):
    # 声明工具
    tools = get_tools()

    llm = getChatModel(modelName)
    # 初始化Agent
    agent = initialize_agent(
        tools,
        llm,
        agent=AgentType.CHAT_ZERO_SHOT_REACT_DESCRIPTION,
        verbose=True,  # 显示思考过程
        handle_parsing_errors=True
    )
    query = "帮我明天查询一下北京到三亚的机票"
    try:
        response = agent.invoke({"input": query})
        print(response)
    except Exception as e:
        return f"发生错误: {str(e)}"
4.3 ReActDocstoreAgent使用
ReActDocstoreAgent 基于 ReAct 框架,专门优化了与文档存储工具的交互能力。
特点:
- 遵循 “思考 - 行动 - 观察” 的明确推理循环
- 原生支持各类文档存储工具(如 FAISS、Chroma)
- 推理过程完全透明,可追溯每一步决策依据
- 适合需要处理和查询文档内容的场景
使用的核心是让 Agent 按 “思考→选工具→执行→再思考” 逻辑,精准联动 Search(找文档)和 Lookup(提信息)工具
创建向量检索的相关工具
def init_chroma_vectorstore() -> Chroma:
    """省略初始化chroma数据"""
    print(f"Chroma初始化完成,共存储{len(documents)}个文档")
    return chroma_db

def get_doc_search_tool(chroma_db: Chroma) -> list[Tool]:
    """
    创建REACT_DOCSTORE要求的2个工具(Search + Lookup)
    Args:
        chroma_db: Chroma向量库实例(用于检索文档)
    Returns:
        list[Tool]: 符合要求的工具列表
    """
    # 1. Search工具:从Chroma检索与问题相关的文档(核心是“找文档”)
    def search_tool_func(query: str) -> list[Document]:
        """Search工具的执行逻辑:根据查询从Chroma检索文档"""
        retriever = chroma_db.as_retriever(
            search_kwargs={"k": 2, "filter": {"category": "flight_info"}}  # 只检索航班信息,最多返回2个文档
        )
        return retriever.get_relevant_documents(query)

    # 2. Lookup工具:从已检索的文档中提取关键信息(核心是“查内容”)
    def lookup_tool_func(doc_content: str) -> str:
        """Lookup工具的执行逻辑:返回文档内容(复杂场景可加关键词提取逻辑)"""
        return doc_content

    # 定义工具列表(名称必须是"Search"和"Lookup",REACT_DOCSTORE会强制校验)
    tools = [
        Tool(
            name="Search",  # 名称固定,不可自定义
            func=search_tool_func,
            description="当需要查找与航班相关的文档时使用,输入为具体问题(如“北京到三亚航班耗时多久”)"
        ),
        Tool(
            name="Lookup",  # 名称固定,不可自定义
            func=lookup_tool_func,
            description="当需要从已找到的航班文档中提取信息时使用,输入为文档内容"
        )
    ]
    return tools
ReActDocstoreAgent 示例代码
def test_doc_store_agent(modelName: str):
    """ 处理和查询文档内容的场景 """
    chroma = init_chroma_vectorstore()
    # 获取工具
    tools = get_doc_search_tool(chroma)

    # 获取agent
    doc_store_agent = initialize_agent(
        tools,
        getChatModel(modelName),
        agent=AgentType.REACT_DOCSTORE,
        verbose=True,  # 显示详细执行过程
        handle_parsing_errors=True,
        max_iterations=5
    )
    resp = doc_store_agent.invoke({"input": "北京到三亚的直飞航班平均需要多长时间"})
    print(resp)
4.4 ConversationalAgent使用
ConversationalAgent 是专注于对话场景的代理,强化了对话记忆管理能力。
特点:
- 集成对话记忆组件,可保存完整对话历史
- 支持上下文指代理解(如 “它”、“前者” 等代词)
- 能处理跨轮次的上下文依赖问题
- 适合需要持续交互的聊天机器人场景
def test_conversation_agent(modelName: str):
    """
     是专注于对话场景的代理,强化了对话记忆管理能力。
    """
    tools = get_tools()

    # 关键:CONVERSATIONAL_REACT_DESCRIPTION 依赖记忆实现多轮对话连贯性
    memory = ConversationBufferMemory(
        memory_key="chat_history",  # 固定key,与Agent预期的上下文字段匹配
        return_messages=True,  # 返回Message对象(而非纯文本),提升上下文理解精度
        output_key="output"  # 指定记忆中存储Agent输出的字段名
    )
    # 获取agent
    doc_store_agent = initialize_agent(
        tools,
        getChatModel(modelName),
        agent=AgentType.CONVERSATIONAL_REACT_DESCRIPTION,
        verbose=True,  # 显示详细执行过程
        handle_parsing_errors=True,
        max_iterations=5,
        memory=memory
    )
    print("信息助手已启动,输入“退出”结束对话~")
    while True:
        user_input = input("你:")
        if user_input.lower() in ["退出", "结束"]:
            print("助手:再见!")
            break

        # 调用Agent处理请求(自动结合对话历史)
        response = doc_store_agent.invoke(
            input={"input": user_input},
            return_only_outputs=True  # 仅返回最终回答(如需历史可设为False)
        )
        print(f"助手:{response['output']}")
4.5 StructuredChatAgent使用
StructuredChatAgent 是支持结构化输出的代理,特别适合需要格式约束的交互场景。
特点:
- 能生成 JSON、表格等结构化输出内容
- 强化了工具调用的参数校验逻辑
- 可适配需要固定格式输入的 API 接口
- 适合数据查询、表单生成等对输出格式有严格要求的场景
设置定义工具
# 定义工具函数
def get_weather(city: str) -> str:
    """获取指定城市的天气信息(模拟)"""
    # 实际应用中可替换为真实天气API调用
    return f"{city}当前天气:晴朗,25℃,微风"

def calculate(*args, **kwargs) -> float:
    """执行两个数字的数学运算,支持+、-、*、/
    参数:
        a: 第一个数字
        b: 第二个数字
        operation: 运算类型,必须是+、-、*、/中的一个
    """
    # 支持两种参数传递方式:位置参数和关键字参数
    if args and len(args) >= 3:
        a, b, operation = args[0], args[1], args[2]
    else:
        try:
            a = kwargs['a']
            b = kwargs['b']
            operation = kwargs['operation']
        except KeyError as e:
            return f"错误:缺少参数 {e}"

    # 确保参数类型正确
    try:
        a = float(a)
        b = float(b)
    except ValueError:
        return "错误:a和b必须是数字"

    if operation == "+":
        return f"{a} + {b} = {a + b}"
    elif operation == "-":
        return f"{a} - {b} = {a - b}"
    elif operation == "*":
        return f"{a} * {b} = {a * b}"
    elif operation == "/":
        if b == 0:
            return "错误:除数不能为0"
        return f"{a} / {b} = {a / b}"
    else:
        return "错误:不支持的运算类型,仅支持+、-、*、/"


def get_struct_tool() -> list[Tool]:
    # 创建工具列表
    tools = [
        Tool(
            name="GetWeather",
            func=get_weather,
            description="获取指定城市的天气情况,需要传入城市名称作为参数"
        ),
        Tool(
            name="Calculate",
            func=calculate,
            description="进行数学运算,需要提供两个数字和运算类型(+、-、*、/)"
        )
    ]
    return tools
Agent 代理工具
def test_structured_chat_agent(modelName: str):
    # 获取工具
    tools = get_struct_tool()
    # 获取模型
    llm = getChatModel(modelName)
    # 获取对话记忆
    memory = ConversationBufferMemory(
        memory_key="chat_history",
        return_messages=True
    )

    # 使用initialize_agent创建智能体
    agent = initialize_agent(
        tools=tools,
        llm=llm,
        agent=AgentType.STRUCTURED_CHAT_ZERO_SHOT_REACT_DESCRIPTION,
        verbose=True,
        memory=memory,
    )
    # 正常会使用GetWeather的工具 并返回格式化数据
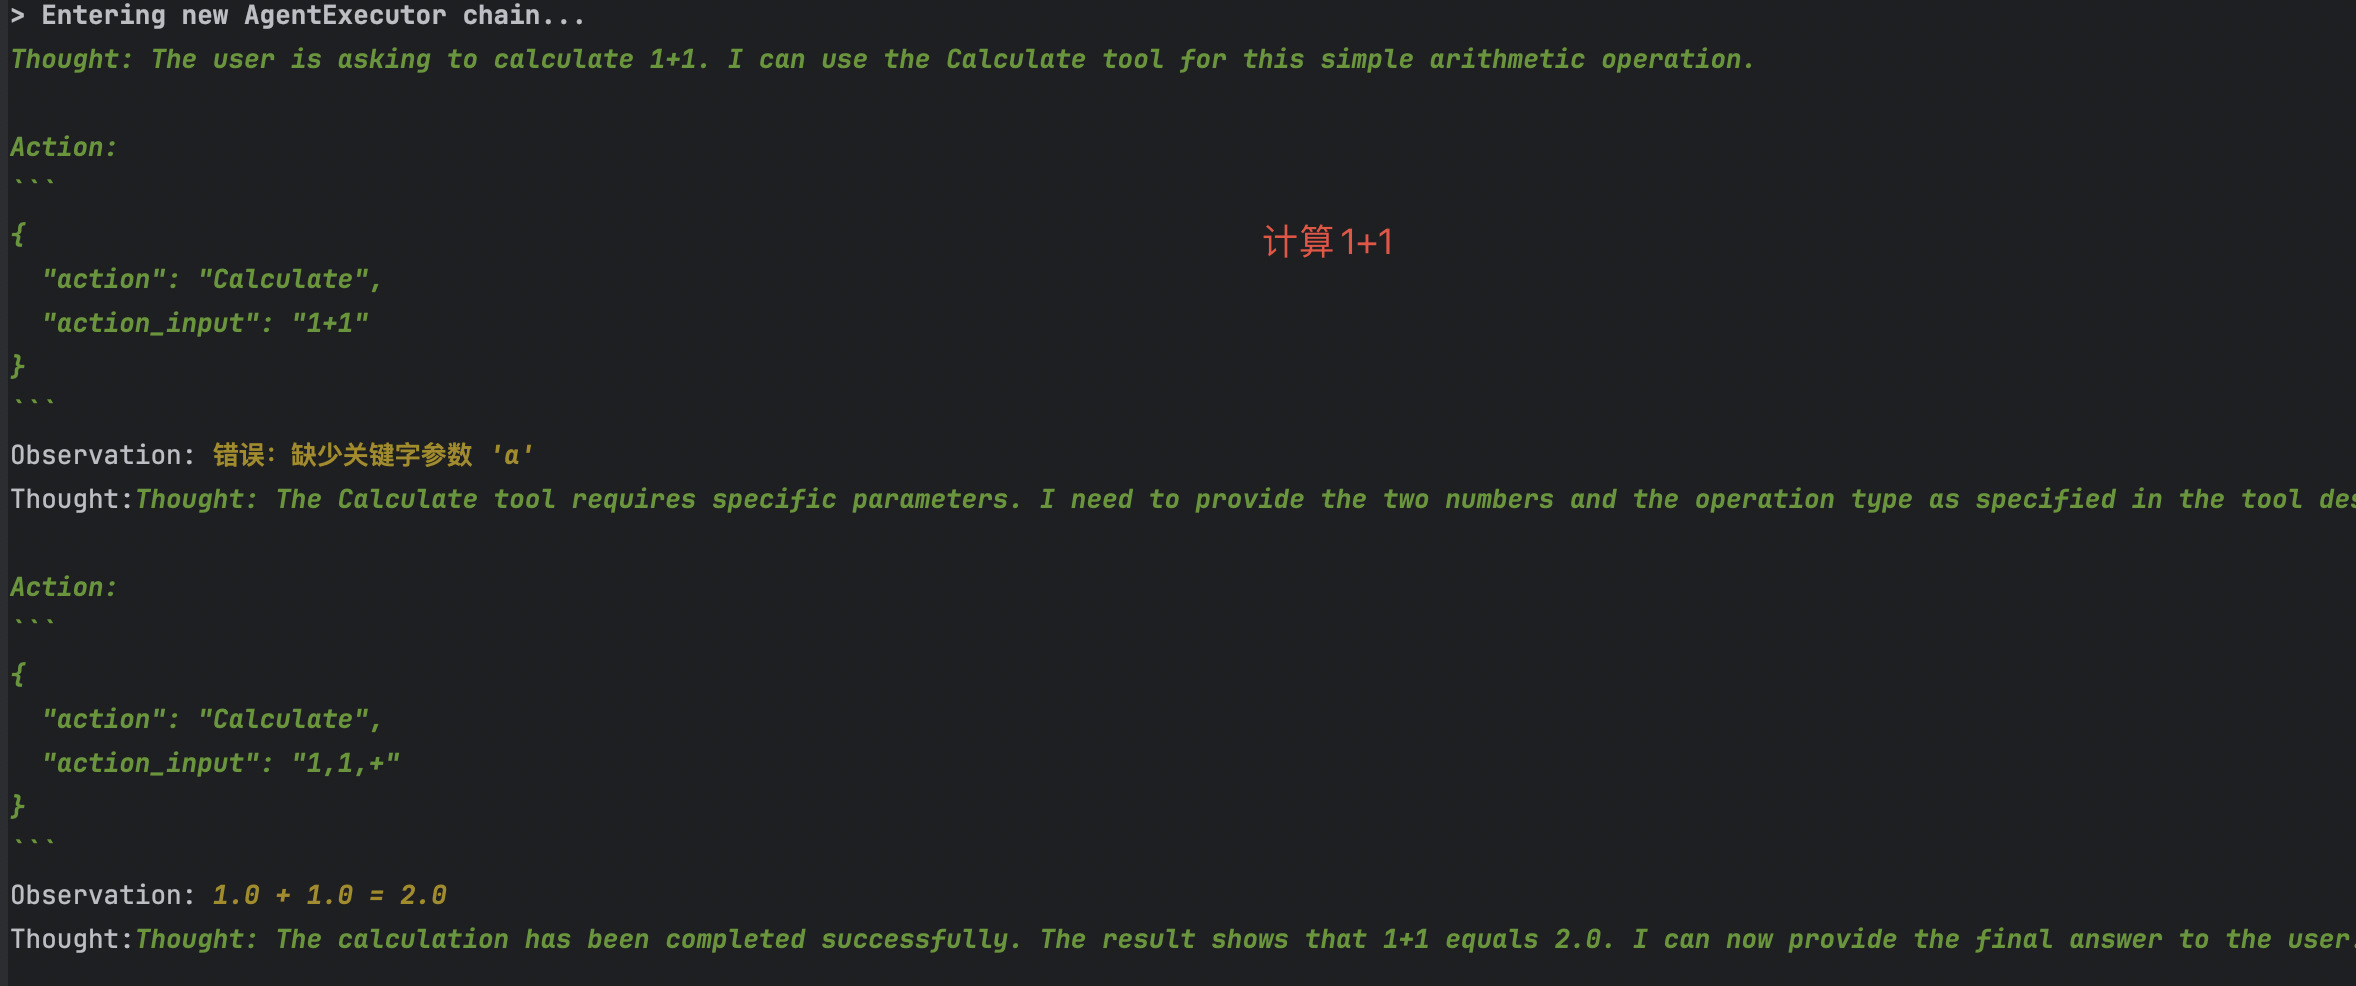
    resp = agent.invoke({"input": "山西运城天气"})
    # 正常会使用calculate的工具,并返回格式化数据
    # resp = agent.invoke({"input": "1+1"})
    print(resp)
4.6 ConversationalChatAgent使用
ConversationalChatAgent 融合了对话记忆管理与聊天模型适配的双重优势。
特点:
- 兼具长对话记忆与聊天模型的交互流畅性
- 工具调用能自然融入对话流程,不显突兀
- 优化了多轮对话中的上下文切换逻辑
- 适合需要复杂工具调用的高端对话助手场景
| 对比维度 | ConversationalAgent | ConversationalChatAgent |
|---|---|---|
| 核心定位 | 工具调用优先的 “任务型助手” | 自然聊天优先的 “类 ChatBot 助手” |
| 对话交互感 | 直接生硬(侧重工具调用过程) | 柔和自然(侧重聊天衔接) |
| 工具调用逻辑 | 主动触发,省略多余对话衔接 | 先承接对话,再后台调用工具 |
| 记忆适配优先级 | 记忆仅辅助工具调用,非核心 | 记忆为对话连贯性核心,优先复用历史 |
| 典型适用场景 | 高频工具调用场景(如查文档、数据计算) | 自然交互场景(如智能客服、个人闲聊助手) |
| 常用 AgentType | CONVERSATIONAL_REACT_DESCRIPTION | CHAT_CONVERSATIONAL_REACT_DESCRIPTION |
4.7 SelfAskWithSearchAgent使用
SelfAskWithSearchAgent 通过自问自答的方式分解复杂问题,仅在必要时调用搜索工具。
特点:
- 能将复杂问题拆解为一系列子问题
- 仅在遇到未知信息时才触发搜索工具调用
- 推理链条清晰,逻辑性强
- 适合知识密集型、需要多步推理的复杂问答场景
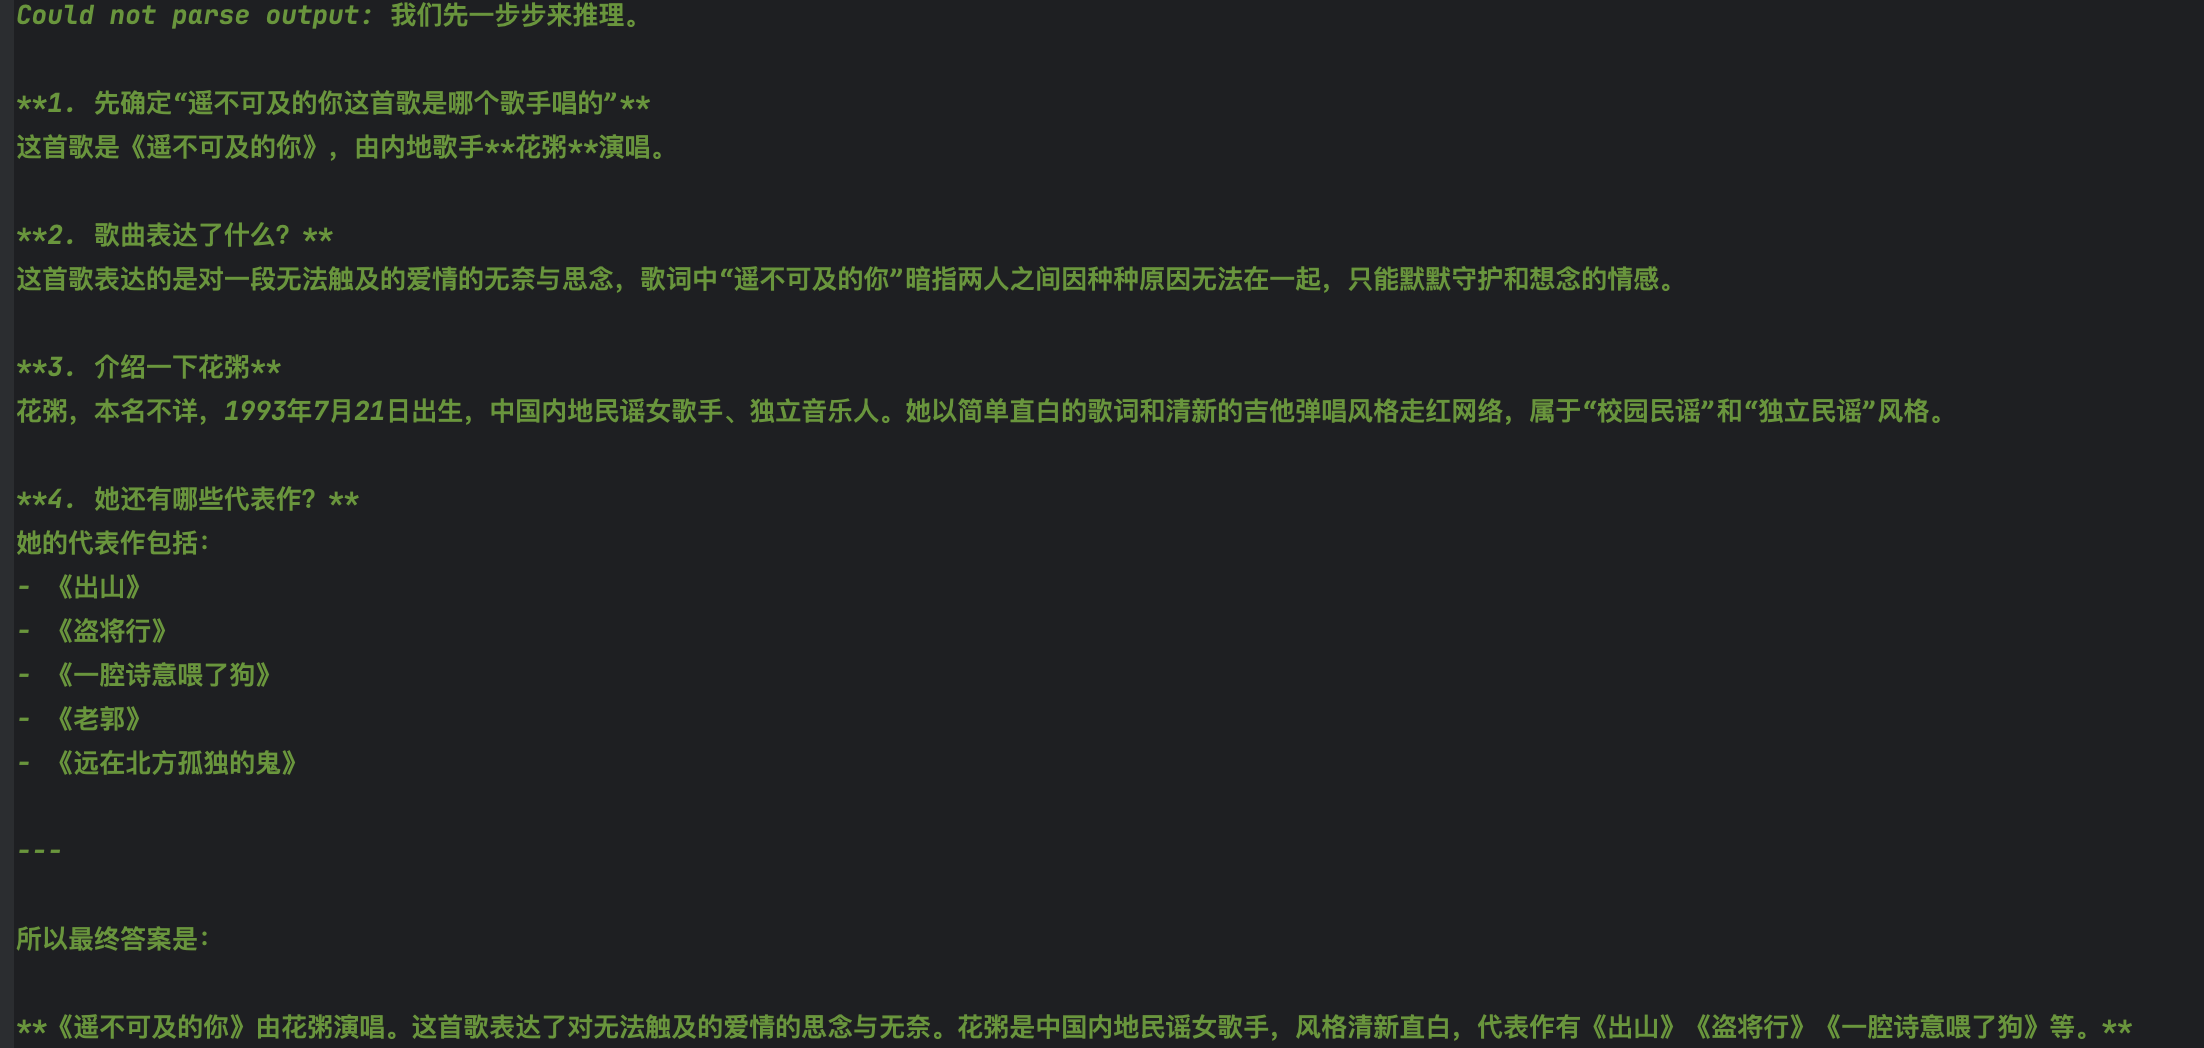
SelfAskWithSearchAgent 的设计限制导致的 —— 它本质上是一种专门为 “搜索型任务” 设计的智能体,只支持单一的搜索工具,且搜索工具名必须为Intermediate Answer
创建搜索工具
我这边使用国内搜索工具实现(博查Search API)
def bocha_search(query: str) -> str:
    load_config()
    BOCHA_API_KEY = os.getenv("BOCHA_API_KEY")
    """使用博查Search API进行搜索,获取中文互联网信息"""
    url = "https://api.bocha.cn/v1/search"  # 博查API端点(示例)
    params = {
        "q": query,
        "api_key": BOCHA_API_KEY,
        "num": 5  # 返回5条结果
    }

    try:
        response = requests.get(url, params=params, timeout=10)
        response.raise_for_status()  # 检查请求是否成功
        results = response.json()

        # 解析搜索结果
        if "data" in results and len(results["data"]) > 0:
            # 提取并格式化结果
            formatted_results = []
            for i, item in enumerate(results["data"], 1):
                title = item.get("title", "无标题")
                snippet = item.get("snippet", "无摘要")
                formatted_results.append(f"{i}. {title}\n   {snippet}")
            return "\n\n".join(formatted_results)
        else:
            return "未找到相关结果"

    except Exception as e:
        return f"搜索出错: {str(e)}"
SelfAskWithSearchAgent使用代码示例
def test_self_ask_agent(modelName: str):
    # 获取工具 只能使用一个工具 搜索
    tools = [
        Tool(
            name="Intermediate Answer",  # 固定名称,适配SelfAskWithSearchAgent
            func=bocha_search,
            description="当需要获取中文互联网的最新信息、新闻、事件结果、实时数据等时使用,支持中文查询"
        )
    ]
    # 获取模型
    llm = getChatModel(modelName)
    # 获取对话记忆
    # 使用 initialize_agent 创建 SelfAskWithSearchAgent
    agent = initialize_agent(
        tools=tools,
        llm=llm,
        agent=AgentType.SELF_ASK_WITH_SEARCH,
        verbose=True,  # 设为 True 可查看详细思考过程
        handle_parsing_errors=True # 自动重试解析失败的情况
    )

    print("与智能体对话(输入exit退出)")
    while True:
        user_input = input("用户: ")
        if user_input.lower() == "exit":
            print("对话结束")
            break
        response = agent.invoke({"input": user_input})
        print(f"智能体: {response}")
五、 Agent 的自定义实现
若要自定义一个 Agent 组件,设置合适的提示词模板是首要且关键的步骤。各种内置 Agent 组件的工作流程大致相似,它们之间的差异主要体现在使用的提示词模板、输出解析器以及工具集的不同上。
要自定义实现一个 Agent,需要继承Agent基类并实现关键方法。以下是实现步骤:
5.1 自定义 Agent 步骤
- 继承
Agent基类 - 实现
_get_default_output_parser()方法,定义输出解析器 - 实现
create_prompt()方法,定义提示词模板 - 需要其它的核心方法比如:_agent_type、observation_prefix、llm_prefix
- 可选)重写
plan()方法,自定义决策逻辑
5.2 自定义 Agent 示例
自定义的输出解析器
class CustomOutputParser(AgentOutputParser):
    def parse(self, llm_output: str) -> AgentAction | AgentFinish:
        # 检查是否完成
        if "Final Answer:" in llm_output:
            return AgentFinish(
                return_values={"output": llm_output.split("Final Answer:")[-1].strip()},
                log=llm_output,
            )

        # 解析工具调用
        regex = r"Action: (.*?)[\n]*Action Input: (.*)"
        match = re.search(regex, llm_output, re.DOTALL)
        if not match:
            return AgentAction("Search", llm_output, llm_output)

        action = match.group(1).strip()
        action_input = match.group(2).strip()

        return AgentAction(tool=action, tool_input=action_input, log=llm_output)
自定义提示词模板
class CustomPromptTemplate(StringPromptTemplate):
    template: str
    tools: list[Tool]

    def format(self, **kwargs) -> str:
        # 获取工具描述
        tool_strings = "\n".join([f"{tool.name}: {tool.description}" for tool in self.tools])
        tool_names = ", ".join([tool.name for tool in self.tools])
        # 格式化模板
        return self.template.format(
            tools=tool_strings,
            tool_names=tool_names, **kwargs
        )
自定义agent核心方法
class MyCustomAgent(Agent):
    llm: BaseLanguageModel = Field(
        ...,  # 表示该字段为必填项
        description="用于处理自然语言任务的语言模型实例"
    )
    #自定义agent输出解析器
    @classmethod
    def _get_default_output_parser(cls, **kwargs: Any) -> AgentOutputParser:
        return CustomOutputParser()

    #创建提示词模板
    @classmethod
    def create_prompt(cls, tools: list[Tool]) -> StringPromptTemplate:
        template = """回答用户问题时,你可以使用以下工具:
        {tools}
        可用工具名称:{tool_names}
        思考过程:
        1. 分析问题是否需要使用工具
        2. 如果需要,选择合适的工具并调用
        3. 根据工具返回结果回答问题
        格式要求:
        如果使用工具:
        Action: 工具名称
        Action Input: 工具输入
        如果可以直接回答:
        Final Answer: 你的答案
        问题:{input}
        {agent_scratchpad}
        """
        return CustomPromptTemplate(
            template=template,
            tools=tools,
            input_variables=["input", "agent_scratchpad"]
        )

    @property
    def _agent_type(self) -> str:
        #非必须 声明一个这个AGent的类型
        return "MY_CUSTOMER_AGENT_TYPE"

    @property
    def observation_prefix(self) -> str:
        """LLM 观察前缀"""
        return "观察: "

    @property
    def llm_prefix(self) -> str:
        """LLM 思考前缀"""
        return "思考:"
}
核心方法
这里重写plan方法,实现 如果是常识性问题让模型自己回答,对于实时问题,使用搜索工具回答,同时为了判断用户问题是常识性还是实时查询 ,又使用模型进行判断
 def plan(
            self,
            intermediate_steps: List[Tuple[AgentAction, str]],
            callbacks: Optional[Any] = None,
            **kwargs: Any
    ) -> AgentAction | AgentFinish:
        """
        核心决策逻辑:判断问题是否需要搜索
        """
        # 1. 获取用户原始问题(首次调用时无中间步骤,从kwargs提取)
        user_question = kwargs.get("input", "")

        # 2. 构建LLM判断prompt:让模型区分常识/非常识问题
        judge_prompt = f"""
        请严格判断以下问题是否属于"非常识性问题",仅需回答"是"或"否",无需额外解释:
        非常识性问题定义:
        - 涉及实时/时效性信息(如2024年后的数据、近期事件)
        - 需特定领域知识(如专业术语、技术参数、行业报告)
        - 答案可能随时间变化(如天气、股价、政策)
        - 非大众普遍知晓的事实(如某小众书籍作者、某公司具体产品参数)

        常识性问题定义:
        - 大众普遍知晓且长期不变的事实(如地球是圆的、1+1=2、人类需要呼吸氧气)

        待判断问题:{user_question}
        """

        # 3. 调用LLM判断问题类型
        judge_result = self.llm.predict(judge_prompt).strip()

        # 4. 根据判断结果决策:非常识问题调用搜索,常识问题直接回答
        if judge_result == "是":
            # 触发搜索工具:返回搜索动作
            return AgentAction(
                tool="Search",
                tool_input=user_question,
                log=f"判断为非常识性问题,调用Search工具查询:{user_question}"
            )
        else:
            # 常识问题:直接让LLM生成答案(无需工具)
            answer = self.llm.predict(f"直接回答以下常识问题:{user_question}")
            return AgentFinish(
                return_values={"output": answer},
                log=f"判断为常识性问题,直接生成答案:{answer}"
            )

    @classmethod
    def from_llm_and_tools(
        cls,
        llm: BaseLanguageModel,
        tools: Sequence[BaseTool],
        callback_manager: Optional[BaseCallbackManager] = None,
        output_parser: Optional[AgentOutputParser] = None,
        **kwargs: Any,
    ) -> Agent:
        """Construct an agent from an LLM and tools.

        Args:
            llm: Language model to use.
            tools: Tools to use.
            callback_manager: Callback manager to use.
            output_parser: Output parser to use.
            kwargs: Additional arguments.

        Returns:
            Agent: Agent object.
        """
        cls._validate_tools(tools)
        llm_chain = LLMChain(
            llm=llm,
            prompt=cls.create_prompt(tools),
            callback_manager=callback_manager,
        )
        tool_names = [tool.name for tool in tools]
        _output_parser = output_parser or cls._get_default_output_parser()
        return cls(
            llm=llm,
            llm_chain=llm_chain,
            allowed_tools=tool_names,
            output_parser=_output_parser,
            **kwargs,
        )
调用自定agent
if __name__ == "__main__":
    # 初始化LLM
    llm = getChatModel("deepseek")
    # 定义工具
    tools = [
        Tool(
            name="Search",
            func=bocha_search,  # 模拟搜索
            description="用于获取最新信息或特定数据"
        )
    ]
    # 初始化Agent和执行器
    agent = MyCustomAgent.from_llm_and_tools(llm=llm, tools=tools)
    agent_executor = AgentExecutor.from_agent_and_tools(
        agent=agent,
        tools=tools,
        verbose=True,  # 显示详细思考过程
        return_intermediate_steps=True
    )
    # 测试用例(覆盖不同类型问题)
    test_questions = [
        "地球是什么形状的?",  # 常识问题(直接回答)
        "2024年诺贝尔物理学奖得主是谁?",  # 非常识问题(需搜索)
        "157乘以23加上458等于多少?",  # 非常识问题(需计算器)
        "《沙丘2》电影的全球票房是多少?",  # 非常识问题(需搜索)
        "水的化学分子式是什么?"  # 常识问题(直接回答)
    ]
    # 执行测试
    for question in test_questions:
        print(f"\n=== 用户问题:{question} ===")
        result = agent_executor.invoke({"input": question})
        print(f"最终回答:{result['output']}")
5.3 自定义注意事项
- 提示词设计:提示词模板对 Agent 行为影响很大,需要清晰定义思考流程和格式要求。
- 输出解析:输出解析器需要能准确识别 Agent 的决策,错误的解析会导致 Agent 无法正常工作。
- 工具调用格式:必须严格定义工具调用的格式,确保 Agent 和执行器能够正确通信。
- 测试迭代:自定义 Agent 通常需要多次测试和调整提示词、解析逻辑才能达到理想效果。
总结:Agent 是借助 LLM 做决策,能调用工具(如搜索、计算),按 “思考 - 行动 - 观察” 流程处理任务,自主解决问题的智能体。

Agent 垂直技术社区,欢迎活跃、内容共建。
更多推荐
 21
 0
- 0


 已为社区贡献3条内容

所有评论(0)